Quale database è il migliore per il vostro carico di lavoro nel 2026
|
6
min di lettura
Ci si continua a chiedere quale sia il database migliore, come se nelle classifiche si nascondesse un vincitore indiscusso. Non c'è. La domanda giusta è quale database sia il migliore per la modalità di guasto che potete accettare, perché è questo a decidere se il vostro sistema resta utile quando in produzione compaiono schema drift, dati in ritardo, vincoli di residenza o un mix di query sfavorevole.
Se volete una risposta concreta, smettete di cercare un campione universale e iniziate ad abbinare il database al carico di lavoro, alla scala, al perimetro di deployment e al tipo di problemi che siete in grado di rilevare e contenere. Per le pratiche di gestione dei database che mantengono onesta questa decisione, questa guida di digna è un utile complemento.
Famiglia di database | Ideale per | Dove di solito vince | Dove di solito perde |
|---|---|---|---|
Database relazionali | Sistemi transazionali strutturati e applicazioni basate su SQL | Forte coerenza, strumenti maturi, ampia diffusione | Non sono la scelta migliore per scansioni analitiche massive |
Sistemi NoSQL documentali e key-value | Dati applicativi flessibili e schemi di prodotto in rapida evoluzione | Flessibilità dello schema e pattern di accesso semplici | Meno naturali per analisi ad hoc complesse |
OLAP colonnari e data warehouse | Reporting, aggregazioni e analytics in tempo reale | Scansioni rapide, raggruppamenti e query analitiche concorrenti | Non sono la prima scelta per carichi di tipo OLTP |
Database a grafo | Query incentrate sulle relazioni e dati connessi | Attraversamento di reti di entità e archi | Eccessivi per i normali carichi tabellari |
Sistemi lakehouse | Analytics miste su grandi dataset | Unificazione di analytics in stile warehouse con pattern di storage più ampi | Possono aggiungere complessità se vi basta un archivio SQL pulito |
Indice
Perché non esiste un unico database migliore
La domanda sul “database migliore” perde senso nel momento in cui trattate ogni carico di lavoro come se avesse la stessa modalità di guasto. Un sistema progettato per l'SQL transazionale è ottimizzato per correttezza, aggiornamenti a livello di riga e scritture prevedibili. Un sistema progettato per l'analytics è ottimizzato per aggregazioni, scansioni e molti lettori che accedono agli stessi dati.
I moderni carichi di analytics e statistica hanno spinto il mercato verso i sistemi colonnari e OLAP, perché questi motori sono progettati per grandi scansioni e letture raggruppate. Le indicazioni attuali citano ClickHouse, Apache Druid e Apache Pinot tra le opzioni più solide per l'analytics in tempo reale, definita da alta freschezza dei dati, bassa latenza delle query, elevata concorrenza delle query e lunga conservazione dei dati (Tencent Cloud TechPedia). È un problema diverso dall'SQL transazionale, quindi richiede un motore diverso.
Una classifica unica nasconde questa divisione. PostgreSQL è spesso la scelta predefinita più sensata per sistemi strutturati incentrati su SQL, mentre i carichi analitici su larga scala sono serviti meglio da ClickHouse o da un cloud data warehouse. Queste scelte non sono sostituibili tra loro, e trattarle come intercambiabili trasforma una decisione tecnica in uno slogan.
Regola pratica: scegliete il database le cui modalità di guasto corrispondono alla vostra tolleranza, non quello che fa la figura migliore in un grafico comparativo.
Questa regola è importante perché la domanda non è “Quale database è il più veloce?” ma “Quale database posso gestire, osservare e governare senza creare un punto cieco che non posso permettermi?” Un sistema che vince un benchmark ma nasconde dati in ritardo, schema drift o violazioni dei vincoli di residenza è una cattiva scelta per la produzione. Se il vostro modello operativo dipende dal sapere che cosa sta facendo il database, le best practice di gestione dei database devono far parte del processo di selezione fin dall'inizio, non arrivare a posteriori.
L'ascesa di PostgreSQL come database open source mainstream dimostra lo stesso punto da un'altra prospettiva. Le guide di benchmark e confronto lo collocano ancora ai vertici per l'uso generico, e un confronto assegna a PostgreSQL 94/100, davanti a MySQL con 87/100, MariaDB con 86/100 e SQLite con 76/100 per i casi d'uso embedded (confronto BenchHub). Anche questa distribuzione dice meno su un vincitore universale e più su tipo di carico, scala e vincoli operativi.
La risposta giusta dipende dal contesto. Se un solo database deve servire ogni attività, state già accettando un compromesso. Dichiarate apertamente il compromesso, poi scegliete il sistema i cui punti deboli potete accettare.
I cinque criteri decisionali che contano
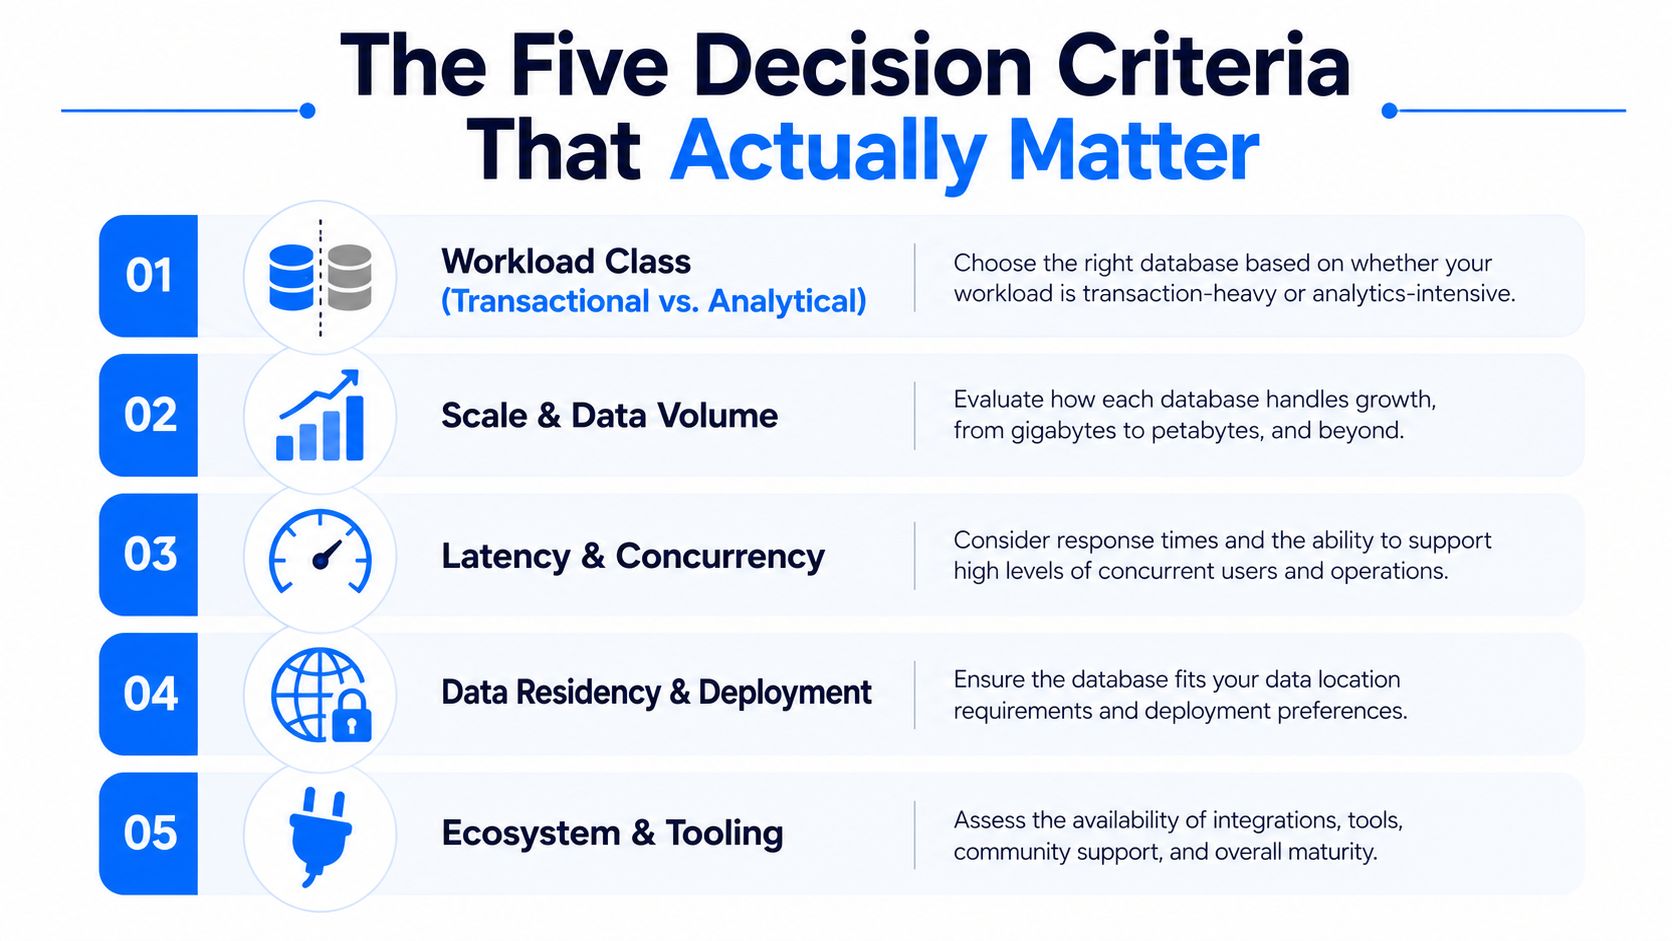
1. Tipo di carico di lavoro
È il primo filtro, ed è quello che si tende a saltare. I sistemi transazionali sono progettati per correttezza, aggiornamenti a livello di riga e scritture prevedibili. I sistemi analitici sono progettati per scansioni, aggregazioni e molti lettori che accedono agli stessi dati.
Ponetevi una domanda più precisa: questo database serve un'applicazione o risponde a domande sulla storia dell'applicazione? Forzare un motore OLTP in un carico da dashboard è un modo comune per creare problemi di concorrenza e poi incolpare il database di fare il lavoro sbagliato.
2. Scala e volume dei dati
La scala non è solo “grande o piccolo”. Comprende la dimensione del dataset, il modello di crescita e quanta parte dei dati dovete toccare contemporaneamente.
Chiedetevi: resterà entro un perimetro operativo ordinato, o mi serve un sistema che gestisca in modo pulito grandi scansioni e conservazione dei dati? L'errore è ottimizzare per la dimensione attuale delle tabelle ignorando dove arriveranno i dati tra sei mesi.
3. Latenza e concorrenza
La latenza è esperienza utente. La concorrenza è la pressione che il sistema assorbe quando più persone o job vi accedono contemporaneamente. Le linee guida sui benchmark indicano di confrontare i sistemi su throughput, latenza, concorrenza e utilizzo delle risorse con mix realistici di letture e scritture, non su un'unica metrica di punta (linee guida di benchmarking di Aerospike).
Chiedetevi: che cosa succede quando lo stesso pattern di query arriva da dieci team contemporaneamente? Il tempo di risposta medio nasconde il comportamento in coda, ed è proprio quel comportamento a fare danni in produzione.
4. Residenza dei dati e modello di deployment
Non è una questione secondaria. Molti acquirenti hanno bisogno di un database che giri nel proprio cloud o in un ambiente on-premises per ragioni di residenza dei dati, latenza e governance, soprattutto in ambito finanziario, sanitario e nel settore pubblico (panoramica di Netlib Security).
Chiedetevi: dove devono risiedere i dati, dal punto di vista legale e operativo? Mettere in lista un servizio gestito prima di verificare che possa restare entro il vostro perimetro è una cattiva abitudine.
5. Observability su schema, tempestività e qualità
Un database può essere veloce e lasciarvi comunque al buio. I team hanno bisogno di visibilità su schema drift, dati in ritardo e anomalie a livello di record, perché questi guasti rompono dashboard e modelli anche quando storage e percorsi di query sono in salute.
Chiedetevi: come saprò che domani i dati saranno ancora affidabili? Trattate il monitoraggio come un criterio di selezione, non come un componente aggiuntivo. Se la piattaforma non riesce a mostrarvi che cosa è cambiato, che cosa è arrivato in ritardo e che cosa sembra sbagliato, state acquistando un rischio nascosto.
Se applicate questi cinque controlli, la shortlist si accorcia molto. È proprio questo lo scopo. Scegliete il database le cui modalità di guasto potete accettare e il cui monitoraggio vi offre abbastanza visibilità da intercettare i problemi prima degli utenti.
Confronto tra le principali famiglie di database
Le famiglie di database in sintesi
Famiglia | Carico di lavoro ideale | Scala tipica | Profilo di latenza | Compatibilità con la residenza | Note sull'observability |
|---|---|---|---|---|---|
RDBMS | OLTP, applicazioni incentrate su SQL, dati operativi misti | Da piccola a molto grande, a seconda del tuning | Prevedibile per il lavoro transazionale | Forte quando serve un deployment self-hosted o controllato | Buon ecosistema, schema chiaro, strumenti operativi solidi |
NoSQL documentali e key-value | Dati di prodotto flessibili, dati di tipo sessione, pattern di accesso semplici | Da media a molto grande | Veloci per lookup mirati, meno adatti a join complessi | Buona se il modello di deployment rispetta il vostro perimetro | La flessibilità dello schema aiuta, ma può nascondere derive |
OLAP colonnari e data warehouse | Reporting, aggregazioni, analytics in tempo reale | Da grande a enorme | Eccellente per scansioni e concorrenza analitica | Spesso forte, ma dipende da deployment gestito o controllato | Valida per l'observability analitica se abbinata al monitoraggio delle pipeline |
Database a grafo | Attraversamento di relazioni, percorsi di frode, reti di dipendenze | Da media a grande, a seconda del carico | Forte per query su dati connessi, non per uso generico | Possono adattarsi a deployment privati, ma gli strumenti variano | Richiede attenzione a lineage e visibilità delle query |
Sistemi lakehouse | Analytics trasversali tra domini, grandi dataset condivisi | Da grande a enorme | Ottimizzati per l'accesso analitico, non per il ricambio transazionale | Spesso forte in cloud privato o con pattern di storage controllati | Utili quando servono insieme governance dello storage e dell'analytics |
Gli RDBMS restano la scelta predefinita più sensata quando l'applicazione è fortemente transazionale e l'SQL conta. PostgreSQL ne è il rappresentante più ovvio, e il motivo per cui continua a comparire è semplice: gestisce bene SQL complesso, vincoli e pattern operativi maturi. Se il vostro sistema è un database di prodotto, un registro di fatturazione o un archivio operativo misto, partite da qui prima di passare a soluzioni esotiche.
I sistemi NoSQL documentali e key-value sono adatti quando la forma dei dati cambia più velocemente di quanto la vostra policy sugli schemi riesca a seguire. MongoDB è l'esempio più evidente, e dà il meglio quando i team di prodotto vogliono documenti flessibili e un recupero semplice. Il rovescio della medaglia è che una struttura flessibile può rendere governance e derive più difficili da notare finché i consumatori a valle non si lamentano.
Gli OLAP colonnari e i data warehouse sono la risposta giusta quando le letture sono soprattutto scansioni, raggruppamenti e aggregazioni. ClickHouse rientra in questo discorso, così come i cloud data warehouse quando il carico è analitico e il team ha bisogno di concorrenza per dashboard o report. La risposta alla domanda sul “database migliore” spesso arriva qui, perché è nell'analytics che le scelte relazionali predefinite iniziano a mostrare i loro limiti.
I database a grafo servono per le domande sulle relazioni che nelle tabelle diventano illeggibili. Se vi interessano reti di frode, reti di identità, catene di dipendenze o attraversamenti multi-hop, sono lo strumento specialistico giusto. Se ne usate uno perché sembra avanzato, probabilmente state pagando una complessità in più senza alcun vantaggio.
I sistemi lakehouse hanno senso quando un team vuole un ampio accesso analitico senza disperdere storage e governance in troppi luoghi. Non sono una risposta magica, né un sostituto di un database transazionale. Sono utili quando l'impronta di storage è così ampia che un modello mentale basato solo sul warehouse risulta troppo ristretto.
La famiglia di database sbagliata non si limita a rallentarvi: cambia il tipo di guasti che ereditate.
Perché i soli numeri dei benchmark sono fuorvianti
I grafici dei benchmark sembrano convincenti, ed è proprio per questo che ingannano così facilmente. Un database può trovarsi in cima a una classifica ed essere comunque la scelta sbagliata per la produzione, se il benchmark nasconde il reale mix di letture e scritture, il pattern di concorrenza o la forma delle query che il vostro team esegue tutto il giorno.
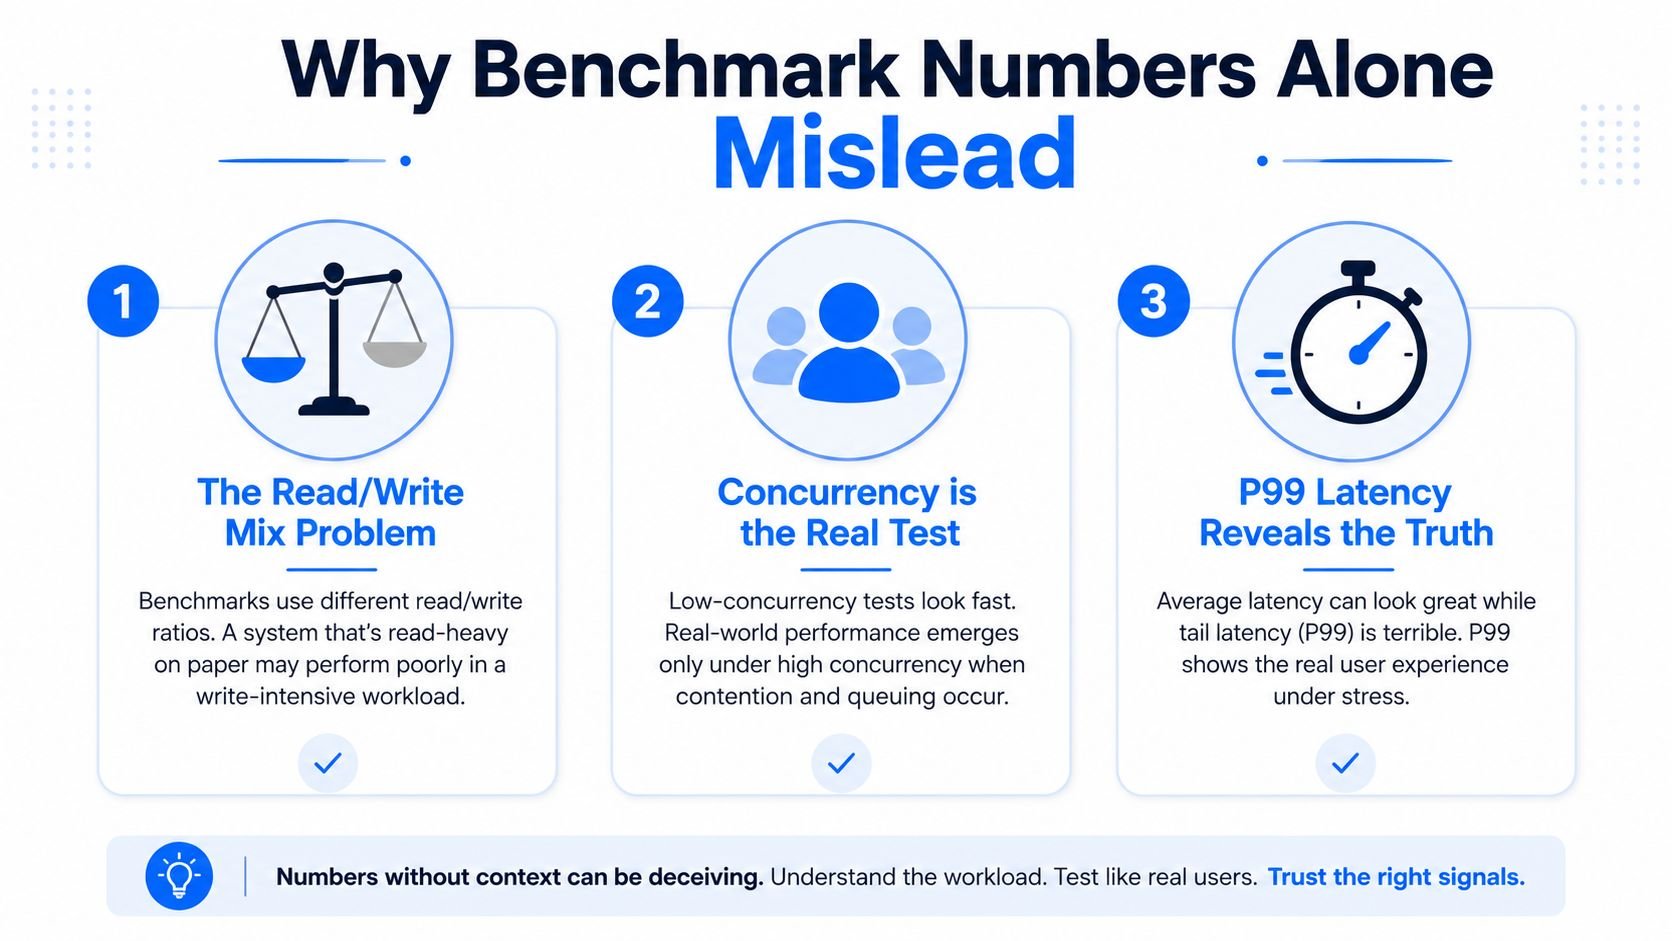
Il throughput non è l'esperienza utente
Le QPS o il throughput grezzo possono sembrare ottimi e mancare comunque il problema centrale. La domanda è se il sistema continua a far scorrere le singole query quando il carico si fa disordinato, perché i valori medi nascondono le code lente, e sono proprio quelle code che gli utenti percepiscono davvero.
Ecco perché la latenza P99 conta più di un singolo dato di throughput. Il glossario di benchmarking di ScyllaDB considera la latenza P99 un segnale migliore perché mostra se quasi tutte le query rispondono in modo rapido e costante (glossario ScyllaDB). Se la mediana sembra a posto ma la coda è pessima, gli utenti delle dashboard percepiscono comunque il database come guasto.
La concorrenza smaschera l'inganno
Un benchmark a thread singolo favorisce sistemi che crollano sotto carico. I team reali non interrogano un database una query alla volta: eseguono insieme dashboard, pipeline, analisi ad hoc e job pianificati.
Le linee guida sul benchmarking indicano anche di valutare throughput, latenza, concorrenza e utilizzo delle risorse con mix realistici di letture e scritture, con dettagli trasparenti sull'hardware e un setup riproducibile (linee guida di benchmarking di Aerospike). Se il fornitore non dice quale hardware ha usato, come ha ottimizzato il sistema o se altri possono riprodurre il risultato, il numero è meno utile di quanto sembri.
Il mix di letture e scritture cambia tutto
Un sistema ottimizzato soprattutto per le letture può sembrare brillante finché il volume delle scritture non aumenta. Un sistema che gestisce bene le scritture può comunque inciampare quando gli analisti eseguono aggregazioni pesanti in parallelo al traffico applicativo.
L'affermazione “il database più veloce” di per sé non significa quasi nulla. È il pattern del carico di lavoro a decidere il vincitore, non il diritto di vantarsi.
Seguite una regola semplice. I punteggi dei benchmark sono uno strumento di screening, non una decisione. L'idoneità alla produzione dipende dal vostro reale mix di query, dal profilo di concorrenza, dall'observability, dal perimetro di residenza dei dati e dalla latenza peggiore che potete tollerare.
Uno scenario di selezione reale per un team finance
Un team finance di medie dimensioni ha bisogno di un database per reporting e scoring con l'AI. Il team ha anche un vincolo di residenza rigido: i dati devono restare all'interno del proprio perimetro cloud. Questo esclude subito molte opzioni gestite molto curate, per quanto possano sembrare valide in una pagina di benchmark pubblica.
Il carico di lavoro indica una direzione precisa. Reporting e scoring sono attività analitiche, quindi un data warehouse colonnare o un sistema OLAP self-hosted è il punto di partenza giusto. Per questo tipo di carico, i sistemi progettati per l'SQL analitico sono più adatti, mentre PostgreSQL resta la scelta più naturale per il lavoro strutturato incentrato su SQL.
Il vincolo di residenza rende la decisione più netta. Un database cloud gestito multi-tenant può essere comodo dal punto di vista operativo, ma se non può risiedere nel cloud o nel perimetro di governance del team, crea un problema di compliance che la pagina del benchmark non menziona mai. Per la finanza, questo è il primo filtro.
Regola pratica: se i dati non possono uscire dal vostro perimetro, il database “migliore” è quello che potete distribuire all'interno di quel perimetro senza eccezioni creative.
Qui vince un data warehouse se supporta le esigenze di SQL, concorrenza e conservazione dei dati del team rispettando il modello di deployment. Vince uno stack OLAP self-hosted se l'organizzazione vuole un controllo più stretto su infrastruttura e percorsi di traffico. Perde la raccomandazione generica del “migliore in assoluto” che ignora dove devono risiedere i dati.
La risposta giusta in questo caso non è una categoria di prodotto appariscente, ma un sistema analitico controllato con una chiara responsabilità operativa. Il vero vincolo del team finance non è la sintassi delle query, ma governance, residenza e observability. Se il database non è in grado di segnalarvi quando la qualità dei dati si rompe, è una scelta inadatta anche se il benchmark sembra ottimo.
Un team serio dovrebbe anche verificare se la piattaforma supporta il monitoraggio nel database e i controlli necessari per intercettare feed obsoleti, schema drift e record errati prima che arrivino al reporting. È un criterio di selezione, non un ripensamento. Come riferimento pratico, consultate le metriche di qualità dei dati per il monitoraggio delle pipeline.
Observability e qualità dei dati come criterio di selezione
Un database può sembrare in salute e alimentare comunque decisioni sbagliate per il business. Se uno schema cambia sotto la pipeline, una sorgente arriva in ritardo o i record perdono coerenza, dashboard e modelli falliscono mentre il database non segnala nulla di evidente. Ecco perché l'observability fa parte della scelta del database, e non della categoria di strumenti che si promette di aggiungere in seguito.
Un modo migliore per formulare la domanda è semplice: quale database può guastarsi in modi che il vostro team è in grado di rilevare, spiegare e contenere?
Le modalità di guasto da intercettare
Quelle comuni sono facili da nominare e difficili da ignorare. Lo schema drift rompe i job a valle quando le colonne compaiono, scompaiono o cambiano tipo. I dati in ritardo fanno sembrare obsolete le dashboard. Le anomalie a livello di record distorcono le metriche senza provocare un'interruzione del servizio.
Vi serve un monitoraggio che giri dove risiedono i dati. Se i controlli vengono eseguiti nell'ambiente del cliente, i dati restano dove sono ed evitate di spostare record sensibili tra sistemi solo per ispezionarli. È lì che vanno mantenuti esecuzione nel database, rilevamento delle anomalie, monitoraggio della tempestività, schema tracking e validazione, perché un team di piattaforma dovrebbe pretendere questo livello di controllo dal proprio stack di observability.
Per i team che vogliono una base pratica, le metriche di qualità dei dati dovrebbero coprire aggiornamento, stabilità dello schema e validità dei record prima che qualcuno approvi il database.
Perché il monitoraggio fa parte della scelta
Il vecchio modello tratta la qualità dei dati come un ripensamento, qualcosa da aggiungere dopo aver scelto lo storage. È un approccio rovesciato. Il database e il modello di monitoraggio devono integrarsi, perché il modo in cui i dati vengono archiviati e interrogati determina la rapidità con cui individuate una rottura.
Una piattaforma che calcola le metriche nel database può analizzare i trend senza inviare dati sensibili altrove. Questo conta per i team con vincoli di residenza o di governance, perché il livello di monitoraggio non dovrebbe diventare il punto più debole dello stack in termini di compliance. La pagina prodotto dell'editore segnala anche il supporto per analisi storiche, calcolo dei tempi di consegna attesi e validazione a livello di record, i controlli che i team usano per mantenere affidabili le pipeline.
Scegliere un database senza observability significa acquistare un punto cieco. La domanda migliore è se saprete, rapidamente e all'interno del vostro ambiente, quando i dati smettono di essere affidabili.
Una breve checklist decisionale riutilizzabile
Prima di scegliere, rispondete a queste quattro domande nell'ordine.
Quale modalità di guasto non potete tollerare? Se la risposta è dashboard obsolete, join rotti o esposizione in termini di compliance, la shortlist cambia immediatamente.
Dove devono risiedere i dati? Se la risposta è all'interno del vostro cloud o del vostro perimetro on-premises, eliminate tutto ciò che non può funzionare lì in modo pulito.
Qual è il vostro target di latenza P99? Se guardate solo le medie, vi sfuggiranno le query lente che infastidiscono gli utenti e minano la fiducia.
Come verificherete nel tempo schema drift, tempestività e qualità? Se la risposta è “ci penseremo più avanti”, la vostra scelta del database è incompleta.
Il database migliore è quello di cui potete osservare e governare il comportamento nel tempo, non quello che vince una classifica generica.
Se state prendendo questa decisione per un team reale, digna vi aiuta a mantenere il database affidabile monitorando anomalie nei dati, tempestività, modifiche dello schema e validazione all'interno del vostro ambiente. Visitate digna se volete un modo pratico per osservare le modalità di guasto che le tabelle dei benchmark tralasciano e costruire uno stack di dati affidabile in produzione.
Qualunque motore scegliate, lo schema drift è una delle modalità di guasto da pianificare fin dall'inizio, e digna Schema Tracker segnala le colonne aggiunte, rimosse o con tipo modificato all'interno del vostro ambiente.
Domande frequenti
Qual è il database migliore nel 2026?
Nessun database vince in assoluto: la scelta giusta dipende dalla modalità di guasto che potete tollerare. PostgreSQL è spesso la scelta predefinita più sensata per sistemi strutturati incentrati su SQL, mentre i grandi carichi analitici sono serviti meglio da ClickHouse o da un cloud data warehouse. Abbinate il motore a carico di lavoro, scala, perimetro di deployment e observability.
Quali criteri usare per scegliere un database?
L'articolo ne indica cinque: tipo di carico di lavoro, scala e volume dei dati, latenza e concorrenza, residenza dei dati e modello di deployment, observability su schema, tempestività e qualità. Il tipo di carico è il primo filtro ed è quello che si tende a saltare, perché forzare un motore OLTP in un lavoro da dashboard crea problemi di concorrenza.
Perché i risultati dei benchmark sui database possono essere fuorvianti?
I benchmark spesso nascondono il reale mix di letture e scritture, il pattern di concorrenza e la forma delle query. Il throughput medio nasconde le code lente, ed è per questo che la latenza P99 è un segnale migliore. I benchmark credibili dichiarano hardware, tuning e un setup riproducibile. Trattate i punteggi come uno strumento di screening, non come una decisione, e fate test con il vostro reale mix di query.
Quale database dovrebbe scegliere un team finance per reporting e scoring con l'AI?
Nello scenario dell'articolo, un data warehouse colonnare o un sistema OLAP self-hosted è il punto di partenza giusto, perché reporting e scoring sono attività analitiche. Il vincolo di residenza del team, che impone di mantenere i dati nel proprio perimetro cloud, esclude molte opzioni gestite multi-tenant indipendentemente dai risultati dei benchmark. Governance e observability decidono il resto.
Perché la data observability dovrebbe far parte della scelta del database?
Un database può sembrare in salute mentre alimenta decisioni sbagliate. Lo schema drift rompe i job a valle, i dati in ritardo rendono obsolete le dashboard e le anomalie a livello di record distorcono le metriche senza alcuna interruzione del servizio. Per questo la checklist riutilizzabile dell'articolo chiede come verificherete nel tempo schema drift, tempestività e qualità prima di impegnarvi su un motore.


