Pulizia dei dati fatta bene: guida pratica per il 2026
|
6
min di lettura

Conoscete la sensazione. Ieri una dashboard sembrava a posto, qualcuno l’ha aggiornata prima di una riunione e ora ricavi, ordini o utenti attivi si sono spostati quel tanto che basta per scatenare il panico. Il problema non è il grafico rotto, ma la corsa affannosa per capire quale tabella a monte ha mentito, quale colonna ha cambiato forma e quale correzione manuale qualcuno ha dimenticato di documentare.
Ecco perché la pulizia dei dati non può restare intrappolata nella logica dello “script veloce prima dell’analisi”. In pratica è una disciplina ingegneristica fatta di pipeline affidabili, regole ripetibili e observability che intercetta i problemi prima che finiscano nei documenti per il consiglio di amministrazione. Persino le statistiche ufficiali trattano la freschezza come un vincolo di progettazione, non come un ripensamento: Eurostat aggiorna il proprio albero di navigazione dei dati due volte al giorno, alle 11:00 e alle 23:00 CET per mantenere le analisi utilizzabili in tutta Europa, e fornisce i database come dataset multidimensionali in più formati, così che possano essere ispezionati, confrontati e riutilizzati correttamente (database e albero di navigazione dei dati di Eurostat).
Per la analytics rivolta ai clienti, la stessa disciplina si ritrova nell’infrastruttura alla base di una customer data platform, dove identità, eventi e reporting restano affidabili solo se i dati sono standardizzati e controllati continuamente. Se la pipeline è fragile, ogni dashboard diventa un’esercitazione antincendio.
Oltre la scopa: perché la pulizia dei dati è un problema di ingegneria
Un team finanziario una volta ha consegnato una presentazione al consiglio di amministrazione un lunedì mattina e ha scoperto che tre grafici si contraddicevano a vicenda. Il problema non era lo strumento di dashboard. Una modifica silenziosa a monte aveva alterato la struttura di un campo e una soluzione manuale provvisoria non era mai stata versionata. È così che di solito si manifesta il problema, perché i dati errati raramente arrivano come un allarme. Si insinuano come una piccola incoerenza, poi si diffondono attraverso join, refresh ed export finché i numeri non tornano più.
Il modello mentale sbagliato
Troppi team trattano ancora la pulizia come un compito una tantum, qualcosa da fare dopo l’estrazione e prima che inizi il “vero lavoro”. Questo approccio crolla non appena i dati si aggiornano ogni giorno, gli schemi cambiano o più sistemi alimentano la stessa metrica. Nelle pipeline operative la domanda cruciale è se il processo continuerà a produrre output affidabili anche domani.
Un modello migliore consiste nel trattare la pulizia come parte della progettazione del sistema. Definite le regole, applicatele automaticamente e mantenete un’observability sufficiente per vedere quando le regole smettono di corrispondere alla realtà. Documentate la differenza tra una correzione, una trasformazione e un’eccezione deliberata, così che nessuno scambi una soluzione provvisoria per uno standard. È anche qui che una customer data platform dimostra il proprio valore, perché identità, eventi e reporting restano affidabili solo quando i dati sono standardizzati e controllati continuamente.
Regola pratica: se un passaggio di pulizia non può essere riprodotto, non fa davvero parte della pipeline. È solo un ricordo nel notebook di qualcuno.
Questo è importante nelle configurazioni che dipendono dal riutilizzo tra sistemi e giurisdizioni diverse. Tempestività, struttura coerente e tracciabilità contano tutte allo stesso tempo, ed è per questo che il lavoro sui dati, sia ufficiale sia aziendale, converge sempre più verso la stessa disciplina: regole versionate, validazione automatizzata e un monitoraggio che mostra quando gli input cambiano forma.
Cosa cambia nel 2026
Il baricentro si è spostato da “sistemare il file” a “proteggere la pipeline”. I team che si occupano di analytics, BI e reporting operativo hanno bisogno del controllo di versione per la logica di pulizia, della validazione al momento dell’ingestion e di alert quando la forma dei dati cambia. Se lavorate in un ambiente regolamentato, o con una piattaforma dati che alimenta contemporaneamente dirigenti e clienti, i problemi nascosti di qualità dei dati costano di solito prima in reputazione e rilavorazioni, e solo dopo in tempo di ingegneria.
Il punto di riferimento utile è la governance. In uno stack moderno, la pulizia dei dati si colloca accanto a ownership, lineage e monitoraggio, non al di sotto. Se l’organizzazione non sa spiegare da dove provenga un numero e perché sia ancora valido, il problema non è mai stato solo la riga. Era l’assenza di disciplina ingegneristica.
Ecco i colpevoli: una guida sul campo ai dati sporchi
I dati sporchi raramente si presentano come un unico errore ordinato. Si manifestano come un insieme di recidivi, e ognuno rompe una parte diversa dello stack. I valori mancanti compromettono la completezza, i formati incoerenti rompono le join, i tipi sbagliati fanno fallire i calcoli e i timestamp anomali rendono difficile fidarsi dello storico. Un audit pratico inizia dando un nome al pattern, perché “disordinato” è troppo vago per poterlo correggere.
Record fantasma e trasformisti
Il Record fantasma è il campo vuoto che sembra innocuo finché non cancella un segmento o non compromette l’input di un modello. L’età mancante di un cliente, una data d’ordine o un codice postale di consegna assenti possono falsare le medie, far collassare le coorti o impedire il funzionamento di un semplice filtro. ACAPS raccomanda di controllare direttamente le variabili e verificare se gli zeri siano zeri reali o valori mancanti travestiti, una distinzione che evita di costruire una pipeline su un’ipotesi sbagliata.
Il Trasformista è lo stesso valore che si presenta con diversi costumi. “USA”, “US” e “United States” possono indicare lo stesso paese, ma se non vengono standardizzati, un’aggregazione per paese si frammenta in qualcosa di insensato. Le date si comportano allo stesso modo, soprattutto quando una fonte invia 01/02/26 e un’altra invia 2026-02-01. Non è una questione estetica, è un errore logico.
Impostori e viaggiatori nel tempo
L’Impostore è un valore memorizzato con il tipo sbagliato. Una colonna dei ricavi che arriva come testo, o un campo quantità che contiene simboli di valuta, può sabotare le aggregazioni. L’età di un cliente pari a 200 è un esempio classico, non perché sia divertente, ma perché dimostra che la validazione degli input non è mai stata applicata.
Il Viaggiatore nel tempo è la riga il cui timestamp viola la cronologia. Una data di fine precedente alla data di inizio, un record creato prima che l’evento sia presumibilmente avvenuto o un aggiornamento anteriore alla sua stessa estrazione dalla fonte possono danneggiare gli audit trail e l’analisi dei trend. Nella regione ES, dove le operazioni digitali sono ormai radicate nelle aziende, questi errori non restano nel warehouse, ma finiscono nei report di servizio e nelle viste rivolte ai clienti (contesto sulla digitalizzazione delle imprese spagnole e sulle anomalie nei dati).
Regola pratica: quando un valore sembra impossibile, verificate se è non valido, raro o semplicemente al di fuori delle vostre ipotesi. Questi tre casi richiedono trattamenti diversi.
I team migliori tengono sotto gli occhi un breve elenco di questi colpevoli durante ogni passaggio di profilazione. Si risparmia tempo e si evita che le persone discutano dei sintomi mentre la causa radice continua a scorrere nel warehouse.
Il playbook della pulizia: dalla diagnosi al trattamento
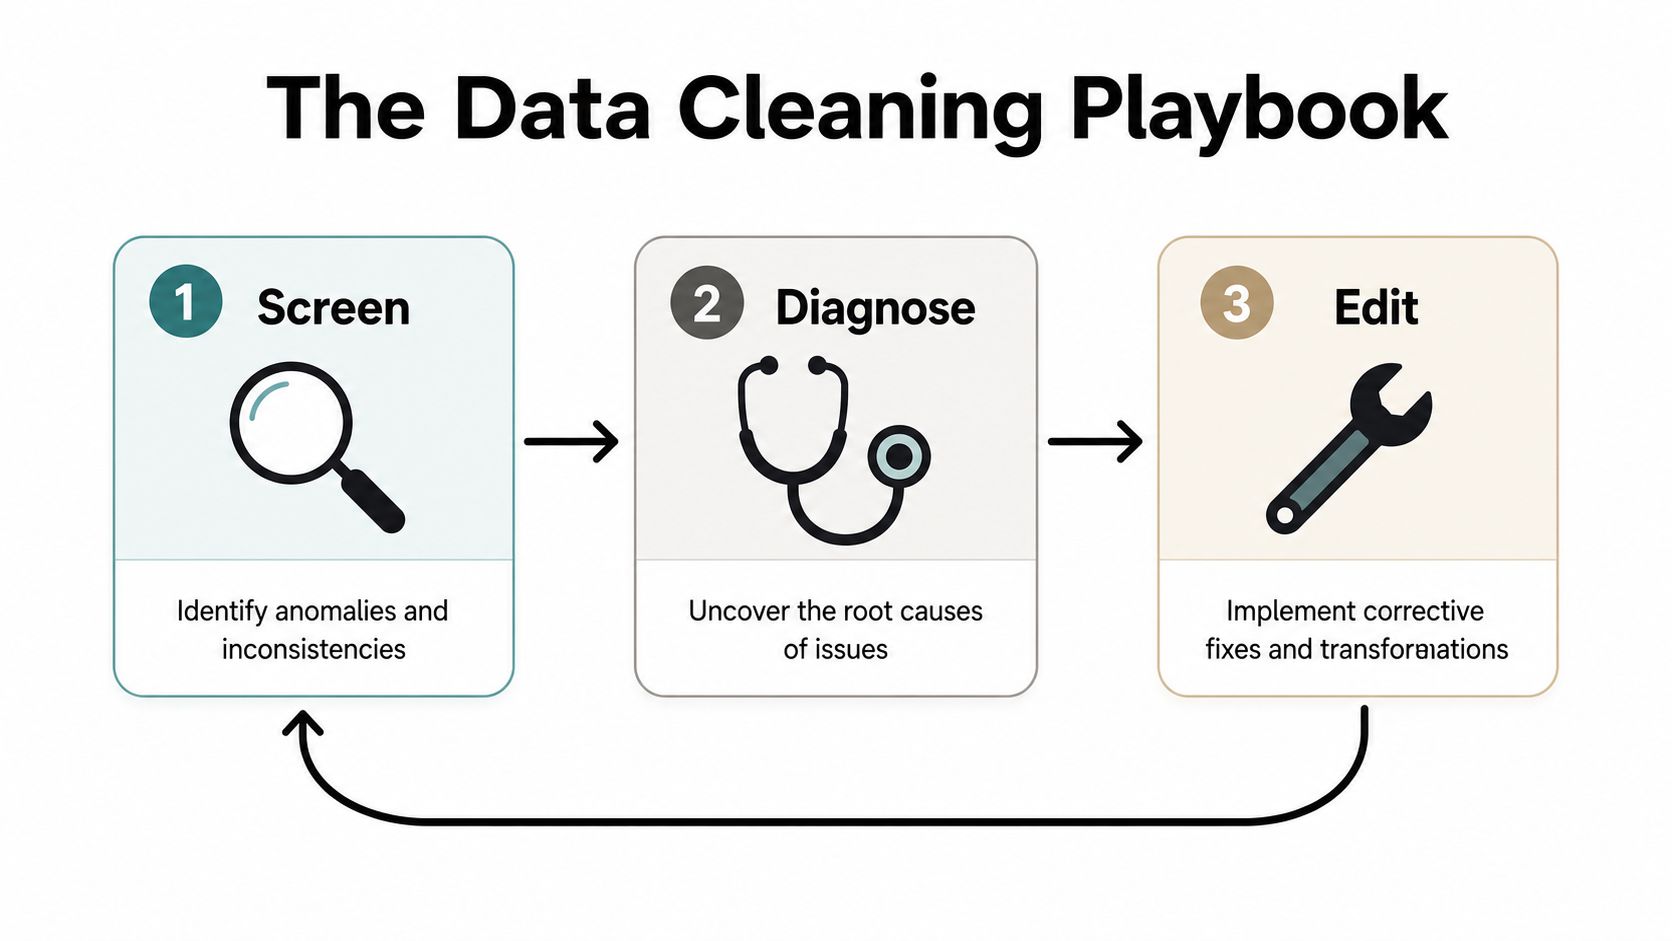
Un export difettoso arriva nella vostra casella di posta, la dashboard è già rossa e qualcuno vuole una risposta prima di pranzo. È lo scenario tipico della pulizia dei dati. La risposta utile non è una correzione una tantum, ma un percorso ripetibile che esamina i dati, diagnostica il problema, interviene con attenzione e mantiene il processo visibile, così che lo stesso caos non si ripresenti la settimana successiva.
I workflow di pulizia più solidi seguono la sequenza screening → diagnosi → modifica, poi ripetono il ciclo. Questo approccio ricorre nelle linee guida pratiche perché una correzione rivela spesso un altro problema nascosto al di sotto. È un lavoro lento, ma evita che i team si limitino a tamponare i sintomi mentre la causa radice continua a scorrere nel warehouse.
Prima lo screening, poi l’indagine
Lo screening consiste nel profilare il dataset prima di toccarlo. Controllate tassi di null, valori univoci, minimi, massimi, moda, media e mediana. Le tabelle di sintesi individuano i pattern più rapidamente che passare subito alle correzioni e mostrano se un errore apparente sia in realtà un valore insolito ma valido.
È qui che il data profiling smette di essere gergo tecnico e diventa un’abitudine di lavoro. La profilazione mostra cosa è presente, cosa manca e quali colonne meritano una revisione umana. Se la saltate, finirete per correggere i sintomi invece delle cause.
Diagnosticare prima di modificare
La diagnosi è la fase che i team affrettano, per poi pentirsene. Un valore andrebbe modificato solo dopo aver capito se si tratta di un’eccezione genuina, di un bug del sistema sorgente o di un campo diverso da quello che vi aspettavate. Lo schema di base è chiaro: individuare le anomalie, diagnosticare gli errori, poi applicare le misure correttive. Una pulizia senza diagnosi è solo ottimismo accompagnato da una query SQL.
Per i valori mancanti e anomali, l’approccio migliore è basato su regole e legato al difetto e alla sua proporzione, non a una cancellazione indiscriminata. I workflow sui dati clinici descrivono una sequenza pratica: stimare prima la quota di dati mancanti, poi scegliere tra cancellazione e imputazione in base a quanto manca, e ripetere il ciclo dopo le correzioni, perché possono emergere nuove incoerenze (workflow sui dati clinici di JMR).
Modificare con tracciabilità
La modifica è la fase in cui i team spesso esagerano. Cancellare i record può essere corretto, ma solo quando l’errore non è riparabile o il record non ha valore analitico. L’imputazione funziona quando le ipotesi sono difendibili, e la standardizzazione è la scelta giusta quando i dati sono validi ma incoerenti nella forma. Per i campi relativi al reddito conta ancora il contesto esterno, poiché le correzioni migliori si basano su fonti ausiliarie invece di appiattire il problema all’interno della pipeline.
Approcci alla pulizia dei dati a confronto | Scalabilità | Riproducibilità | Ideale per |
|---|---|---|---|
Correzioni manuali | Bassa | Bassa | Indagini piccole e una tantum |
Pulizia tramite script | Da media ad alta | Alta | Dataset ricorrenti e job pianificati |
Piattaforma dedicata | Alta | Alta | Pipeline continue, alert, governance |
La regola è semplice. Se la stessa correzione servirà di nuovo, deve stare nel codice o in una piattaforma, non in un foglio di calcolo. Così il lavoro resta verificabile e il vostro team non dovrà rivivere lo stesso incidente il mese successivo.
Costruire pipeline di dati resilienti
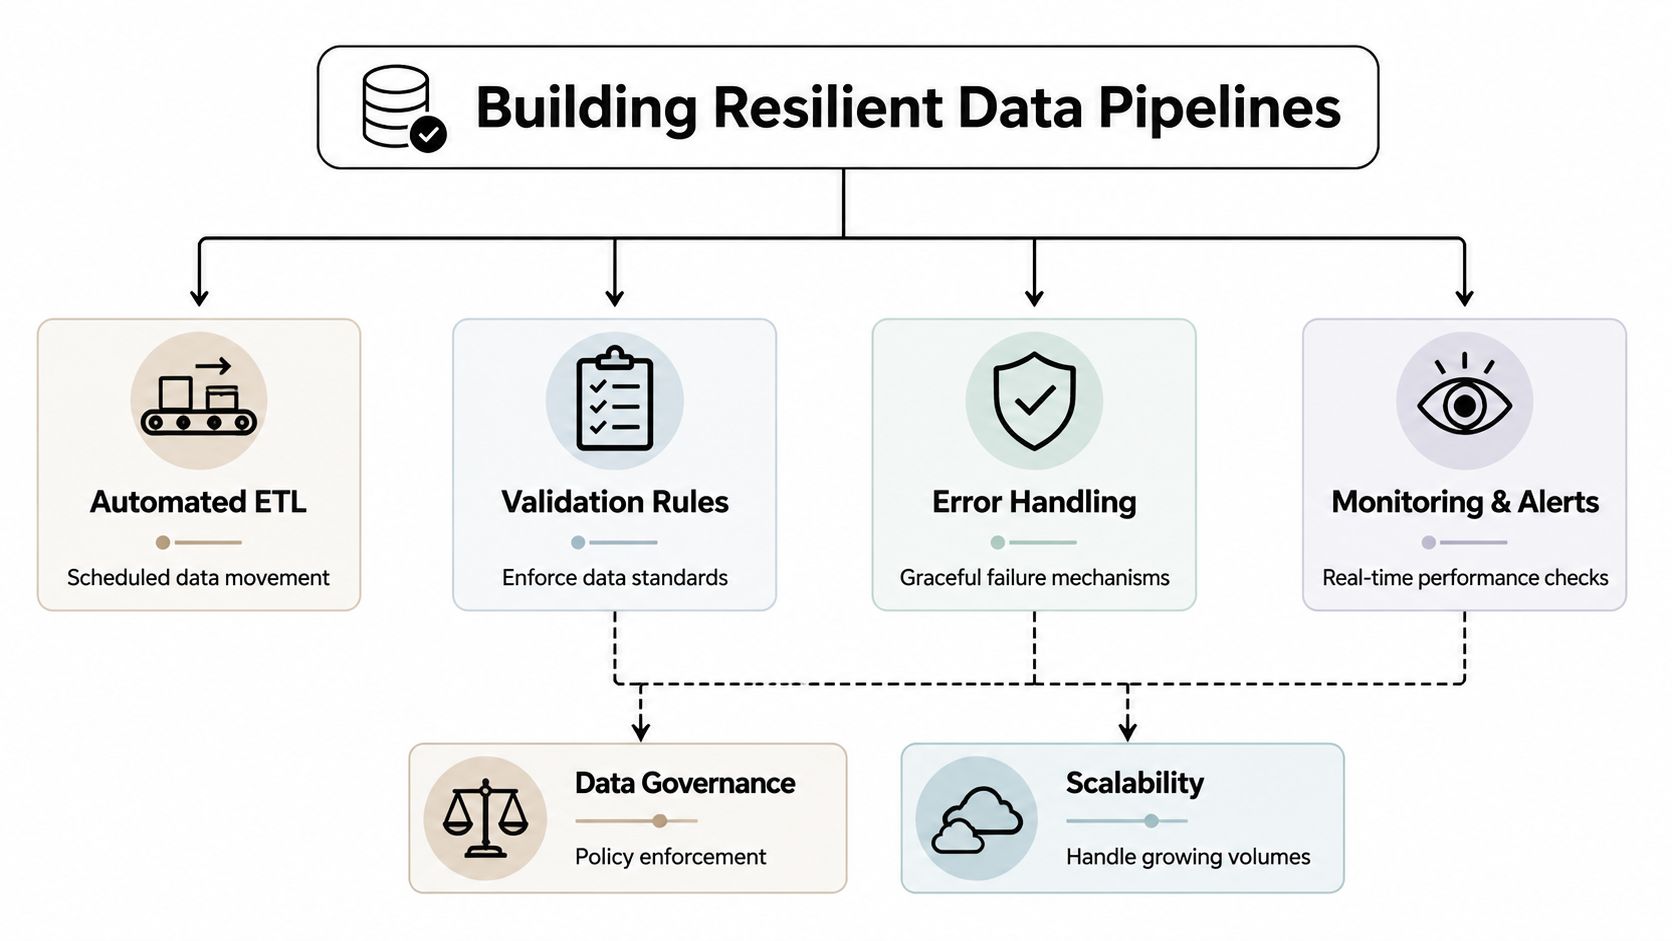
Uno script pulisce un file. Una pipeline resiliente continua a fare il lavoro dopo la prima esecuzione e rende visibili i problemi quando gli input cambiano. È la differenza tra una correzione una tantum e un sistema in grado di sopravvivere a schema drift, arrivi in ritardo e al solito caos che emerge quando le persone iniziano a fare affidamento sul report.
Mettere le regole dove risiedono i dati
Negli ambienti europei regolamentati, spesso i dati non possono uscire dal private cloud o dall’infrastruttura on-premise, quindi trasferire i record in uno strumento di pulizia separato è un pessimo compromesso. Lo schema migliore consiste nel mantenere la validazione vicino alla fonte, così che i controlli di qualità vengano eseguiti dove i dati già risiedono e la pipeline eviti spostamenti inutili. Questo approccio è coerente anche con le best practice per le pipeline di dati, soprattutto quando l’obiettivo è mantenere la pulizia riproducibile all’interno dello stesso percorso operativo di ingestion e trasformazione.
Questa scelta conta per privacy, prestazioni e fiducia. Elaborare i dati all’interno del warehouse consente ai team di applicare gli standard senza copiare dati sensibili in più sistemi del necessario. In pratica, una piattaforma come digna si adatta a questa configurazione perché esegue i controlli all’interno di ambienti controllati dal cliente e supporta il monitoraggio senza trasferire i dati di produzione verso il sistema di un fornitore.
Versionare la logica, non solo le tabelle
Le regole di pulizia cambiano esattamente come gli schemi. Se non le versionate, un futuro engineer non potrà capire se una metrica modificata derivi dalla realtà del business o da una soglia cambiata. Mettete le trasformazioni in modelli dbt o script equivalenti, tenete la logica dei test nello stesso repository e trattate le aspettative sullo schema come codice, non come conoscenza tramandata a voce.
Regola pratica: se un passaggio della pipeline influisce su un KPI, ha bisogno di un test, di un responsabile e di un percorso di rollback.
I controlli automatizzati dovrebbero coprire duplicati, tipi, modifiche dello schema e regole di business di base. L’obiettivo non è bloccare ogni record anomalo, ma impedire che una corruzione silenziosa raggiunga dashboard e modelli. È uno standard più elevato rispetto a una revisione notturna su foglio di calcolo, ed è quello che regge quando volumi, cambi di ownership e pressione degli audit iniziano a crescere.
Rendere utili i fallimenti
Le buone pipeline non si limitano a fallire: falliscono in modo evidente e con dettagli sufficienti per intervenire. Un errore di validazione dovrebbe dirvi cosa si è rotto, dove e se il problema è un’anomalia nei dati, un batch arrivato in ritardo o una modifica dello schema. Lo scopo è far emergere rapidamente la strada giusta per la correzione, non costringere un engineer a ricostruire il problema da zero la mattina successiva.
Il test pratico è semplice. Se un engineer non riesce a riprodurre una correzione a partire dal log, la pipeline è ancora troppo manuale.
Automatizzare la qualità con la data observability
Una dashboard che alle 9 del mattino sembra a posto può rompersi entro l’ora di pranzo se una fonte cambia, un batch arriva in ritardo o una deriva nascosta passa inosservata. La pulizia manuale intercetta solo i problemi che qualcuno si è ricordato di controllare. La data observability cambia il workflow tracciando il comportamento dei dati nel tempo, imparando cosa sia normale e segnalando le derive prima che input errati si diffondano in report e modelli. Questo è importante quando i dati arrivano di continuo, i team dipendono dagli stessi numeri e il costo di un’anomalia non rilevata si manifesta come una decisione sbagliata o un problema di compliance.
Dagli elenchi di regole alle baseline apprese
Il vecchio approccio dice: “scrivi una regola per ogni problema”. Funziona finché i dati non cambiano e le regole iniziano a scattare su comportamenti legittimi. Una configurazione migliore combina la validazione basata su regole con un’anomaly detection che apprende le baseline dallo storico, ed è per questo che i controlli di qualità probabilistici compaiono sempre più spesso rispetto agli elenchi statici di eccezioni. Il materiale di mercato di Digitales sull’anomaly detection nei dati dell’UE rivendica addirittura una precisione del 92% per l’anomaly detection basata sul ML, segno che il settore si sta orientando verso il rilevamento automatico dei segnali invece di infinite regole mantenute a mano.
Le regole contano ancora. Intercettano le violazioni della logica di business, mentre l’anomaly detection coglie gli spostamenti insoliti di volume, distribuzione e tempistiche che spesso sfuggono finché il danno non è già visibile.
Schema tracking e controlli sugli arrivi contano più di quanto si ammetta
Molti problemi iniziano prima ancora che venga analizzata la prima riga. Vengono aggiunte colonne, cambiano i tipi di dato, una fonte arriva in ritardo o un batch non arriva mai. Schema tracking e controlli di tempestività intercettano questi problemi in anticipo, evitando che i consumer a valle diano la caccia a bug fantasma e che le pipeline si discostino dalle specifiche. Questo è importante nei workflow di finanza, sanità, telecomunicazioni e pubblica amministrazione, dove report obsoleti possono causare danni reali.
Il video seguente è un rapido promemoria visivo di come monitoraggio, validazione e anomaly detection si integrino all’interno di una pipeline viva.
Cosa cambia l’observability per il team
Il vantaggio è pratico, non teorico. Invece di passare le mattinate a fare controlli manuali, i data engineer possono concentrarsi su cause radice, trend di qualità e policy sulle eccezioni. Una piattaforma più solida mantiene inoltre i dati all’interno dell’ambiente controllato dal cliente, il che è importante nei contesti regolamentati e nelle organizzazioni che si affidano a privacy by design e minimizzazione dei dati per soddisfare le aspettative in linea con il GDPR, come descritto nel contesto spagnolo su GDPR e privacy by design.
C’è anche un aspetto di governance. La LOPDGDD spagnola integra il quadro del GDPR e riconosce il diritto alla disconnessione digitale all’articolo 88, uno dei motivi per cui verificabilità e ambienti di elaborazione controllati sono così importanti per il lavoro di analytics su dati sensibili. La stessa disciplina fa parte del più ampio approccio di data observability, in cui visibilità, tracciabilità e tempi di risposta sono integrati nella pipeline invece di essere aggiunti dopo un incidente.
L’obiettivo è semplice. Rendere visibili i dati errati abbastanza in fretta da permettere alle persone di intervenire prima che il business ne risenta.
Dati puliti come cultura, non come imposizione
Una pipeline pulita è utile. Una cultura che si aspetta la qualità dei dati è molto meglio. La differenza si vede in chi è responsabile del problema, in quanto rapidamente le persone reagiscono e nel fatto che il team tratti le anomalie come occasioni di apprendimento o come l’ennesimo giro di colpe.
Le organizzazioni più solide non chiedono ai data engineer di ripulire tutto a posteriori. Rendono i produttori responsabili dei dati che emettono, offrono ai consumer un percorso chiaro per segnalare i problemi e mantengono le definizioni di “valido” visibili a tutti coloro che dipendono dai numeri. L’Expert Meeting UNECE 2025 di Lisbona ricorda opportunamente che non si tratta di una preferenza ingegneristica di nicchia: nell’Europa meridionale è considerata un’infrastruttura fondamentale per le statistiche ufficiali (riunione UNECE 2025 di Lisbona).
La responsabilità batte l’eroismo
Quando nessuno è responsabile della qualità dei dati, gli stessi errori continuano a ripresentarsi sotto nomi diversi. Assegnare responsabili per tabelle, metriche e feed critici crea un vero ciclo di feedback, soprattutto quando questi responsabili possono vedere errori di validazione e modifiche dello schema come parte del lavoro quotidiano. È così che la qualità dei dati diventa una caratteristica del prodotto anziché un ticket di pulizia.
Il cambiamento culturale protegge inoltre i team da una pulizia eccessiva. Non ogni valore strano deve sparire. Alcuni sono outlier di business legittimi, altri sono segnali che il business stesso sta cambiando. È per questa distinzione che observability e governance vanno di pari passo.
Rendere visibile la qualità
L’abitudine più pratica è pubblicare le regole, le eccezioni e i risultati. Un team in grado di spiegare cosa è stato modificato, perché e cosa resta incerto è un team di cui ci si può fidare. Se vi serve un punto di partenza per questa conversazione, vale la pena consultare la guida per costruire una cultura della qualità dei dati di digna insieme ai vostri standard interni.
In definitiva, la pulizia dei dati non è un lavoro da addetti alle pulizie. È una pratica di affidabilità, e l’affidabilità è ciò che evita che le dashboard vi mettano in imbarazzo davanti a chi le paga.
Se il vostro team combatte ancora ogni settimana con gli stessi problemi sui dati, smettete di trattarli come bug isolati e iniziate a considerarli problemi di progettazione della pipeline. Rivedete le vostre regole di pulizia, aggiungete la validazione nel punto in cui i dati entrano nel vostro stack e scoprite come digna può aiutarvi a monitorare, validare e governare la qualità all’interno del vostro ambiente.
Domande frequenti
Che cos’è la pulizia dei dati nel data engineering?
La pulizia dei dati è una disciplina ingegneristica basata su pipeline affidabili, regole ripetibili e observability, non uno script veloce prima dell’analisi. La regola della guida: se un passaggio di pulizia non può essere riprodotto, non fa davvero parte della pipeline. Documentate correzioni, trasformazioni ed eccezioni deliberate, così che nessuno scambi una soluzione provvisoria per uno standard.
Quali sono i tipi più comuni di dati sporchi?
La guida individua quattro colpevoli: i Record fantasma (valori mancanti, come una data d’ordine assente), i Trasformisti (un valore in più forme, come USA, US e United States), gli Impostori (tipi sbagliati, come ricavi memorizzati come testo o un’età pari a 200) e i Viaggiatori nel tempo (timestamp che violano la cronologia).
Quali sono le fasi del processo di pulizia dei dati?
Seguite la sequenza screening, diagnosi, modifica, poi ripetete il ciclo, perché una correzione rivela spesso un altro problema. Lo screening consiste nel profilare tassi di null, valori univoci, minimi, massimi, moda, media e mediana. La diagnosi distingue le eccezioni genuine dai bug delle fonti e la modifica applica cancellazione, imputazione o standardizzazione a seconda del difetto.
È meglio cancellare o imputare i valori mancanti?
Dipende dal difetto e dalla sua proporzione, quindi evitate cancellazioni indiscriminate. Stimate prima la quota di dati mancanti, scegliete tra cancellazione e imputazione in base a quanto manca e ripetete il ciclo dopo le correzioni, perché possono emergere nuove incoerenze. Cancellate i record solo quando l’errore non è riparabile o il record non ha valore analitico.
Come si automatizza la pulizia dei dati in una pipeline?
Mettete le trasformazioni in modelli dbt o script equivalenti, tenete i test nello stesso repository e trattate le aspettative sullo schema come codice. I controlli automatizzati dovrebbero coprire duplicati, tipi, modifiche dello schema e regole di business, mentre le baseline apprese intercettano gli spostamenti di volume, distribuzione e tempistiche. Ogni passaggio che influisce su un KPI ha bisogno di un test, di un responsabile e di un percorso di rollback.


