Protezione dei dati dei clienti: guida 2026 per le aziende
|
6
min di lettura

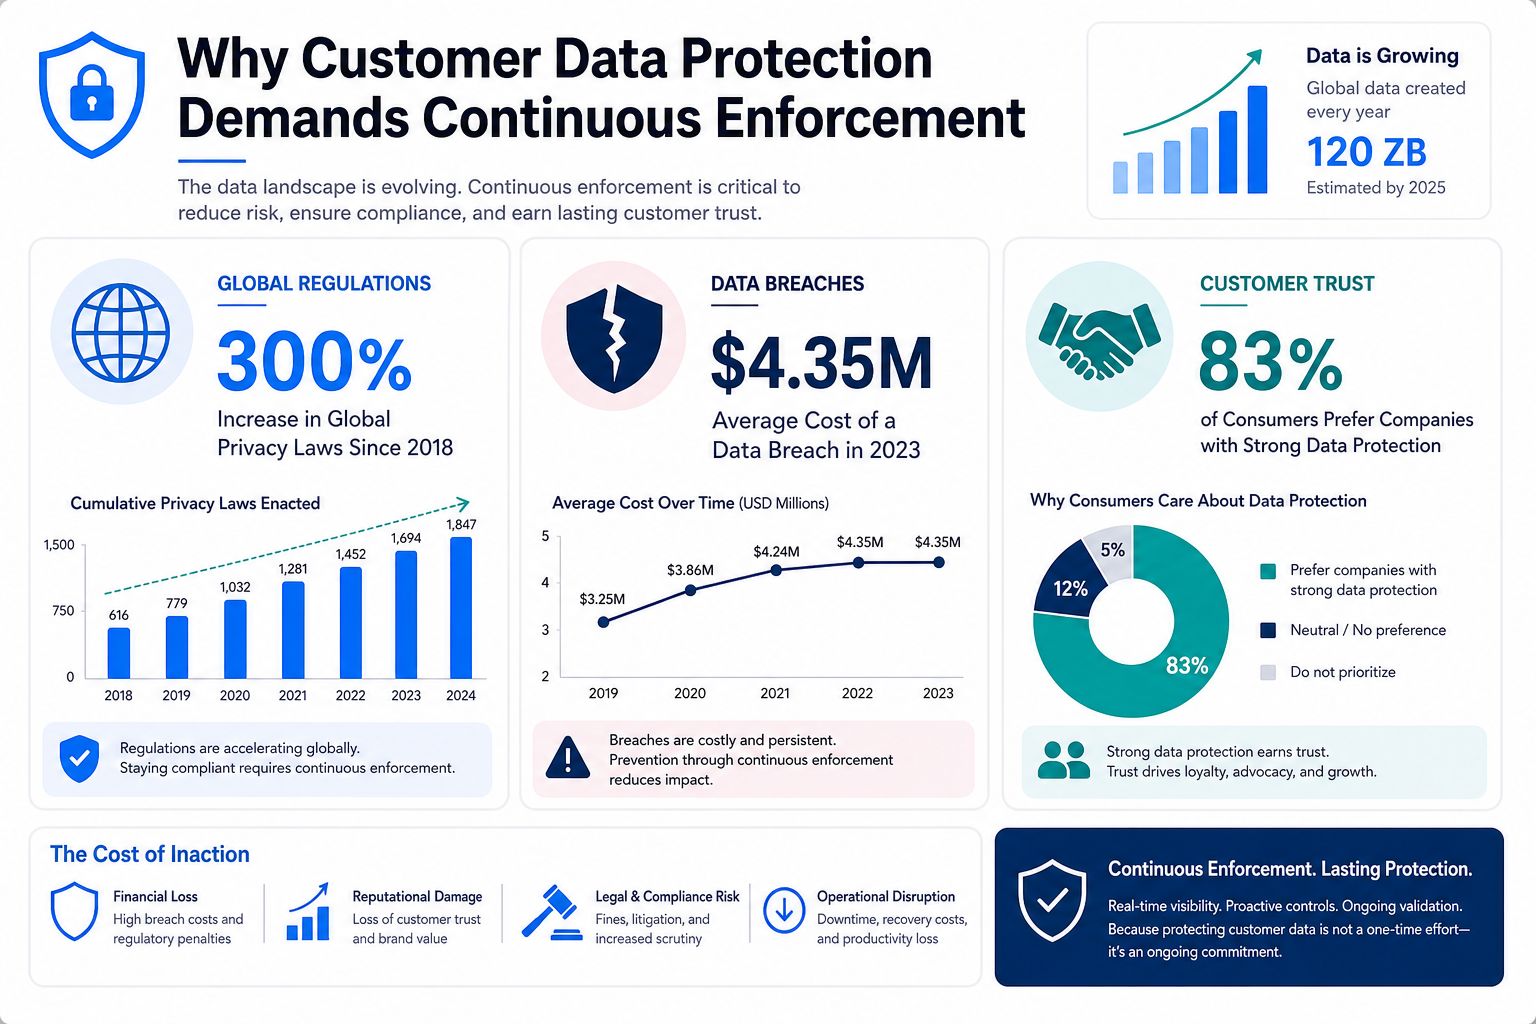
La protezione dei dati dei clienti ha smesso da anni di essere un esercizio da raccoglitore di policy. Considerando solo l'applicazione del GDPR, l'Europa aveva raggiunto circa 7,1 miliardi di euro di sanzioni cumulative entro gennaio 2026, e le autorità ricevevano in media oltre 400 notifiche di violazione dei dati personali al giorno, un aumento del 22% su base annua e la prima volta che la media giornaliera superava quota 400 dall'entrata in vigore del GDPR, secondo i dati citati nel riepilogo delle statistiche GDPR 2026 di PrivacyEngine. È questa oggi la realtà operativa: la protezione è una disciplina continua, non un'attività da completare al lancio.
Il lato commerciale è altrettanto spietato. Una sintesi di Termly riporta che il 75% dei consumatori non acquista da organizzazioni a cui non affiderebbe i propri dati personali, che il 63% degli utenti di internet ritiene che la maggior parte delle aziende non sia trasparente sull'uso dei dati e che il 48% ha smesso di acquistare da un'azienda per timori legati alla privacy. Anche il costo dell'errore è tutt'altro che astratto: i dati basati su IBM citati da fonti del 2025 e del 2026 indicano un costo medio di una violazione di circa 4,4 milioni di dollari come riassunto da Termly. In pratica, una protezione debole colpisce contemporaneamente ricavi, reputazione e gestione degli incidenti.
Indice
Perché la protezione dei dati dei clienti richiede un'applicazione continua
La fiducia è una leva sui ricavi, non uno slogan
La protezione deve essere un ciclo di controllo attivo
I requisiti normativi che definiscono le strategie di protezione
Tradurre le regole in obblighi operativi
I controlli tecnici che riducono davvero il rischio
Il controllo degli accessi limita il raggio d'impatto
La minimizzazione è un controllo, non un compromesso
La lacuna di protezione nelle pipeline di AI e analytics
I dati derivati creano problemi di applicazione
I controlli organizzativi che rendono la protezione applicabile
La responsabilità funziona solo se ha dei titolari
Observability nel database senza spostare i dati
Perché mantenere i controlli nel database cambia il profilo di rischio
Implementare la protezione su piattaforme dati eterogenee
Una sequenza di rollout praticabile
Perché la protezione dei dati dei clienti richiede un'applicazione continua
Le regole sulla privacy contano solo se vengono applicate dove si muovono i dati dei clienti. Secondo il report 2026 di PrivacyEngine le leggi sulla privacy coprono ormai gran parte della popolazione mondiale e oltre 140 paesi hanno adottato normative sulla protezione dei dati o sulla privacy. L'implicazione pratica è semplice: la protezione dei dati dei clienti fa ormai parte dell'accesso al mercato, dell'approvazione dei fornitori e della progettazione quotidiana dei sistemi.
La fiducia è una leva sui ricavi, non uno slogan
I programmi più solidi che ho visto trattano la fiducia come un vincolo operativo. Quando i clienti esitano a condividere i dati, o smettono del tutto di farlo, l'impatto si vede su conversione, fidelizzazione e qualità delle decisioni a valle. Una protezione debole cambia anche il modo in cui i team di vendita, assistenza, antifrode e analytics usano gli stessi record, ed è lì che il compromesso diventa visibile in produzione.
Regola pratica: se la protezione dei dati dei clienti compare solo nelle revisioni legali, è già troppo tardi. Deve essere visibile ogni giorno nel controllo degli accessi, nel logging, nel monitoraggio e nella risposta agli incidenti.
Il problema non si limita ai titoli sulle violazioni. La pressione normativa continua ad arrivare attraverso nuovi sistemi, nuove integrazioni e nuove decisioni sulla conservazione, il che significa che i team raramente dispongono di una finestra di implementazione pulita. Un aggiornamento del data warehouse, un nuovo set di feature per un modello o un elenco clienti esportato possono esporre record che l'approvazione originale non aveva mai previsto. Ecco perché gli approfondimenti sulla protezione dei dati dei clienti provenienti dai servizi finanziari regolamentati sono rilevanti: la lezione operativa è la stessa anche al di fuori del settore bancario.
La protezione deve essere un ciclo di controllo attivo
La verifica continua è l'unico modello che regge. I team di sicurezza non possono dare per scontato che le regole di accesso corrispondano ancora alle mansioni, i team dati non possono dare per scontato che ogni pipeline rispetti ancora i limiti di conservazione e i team di compliance non possono dare per scontato che un processo approvato in passato sia ancora quello in uso. La protezione dei dati dei clienti funziona solo quando i controlli vengono verificati rispetto ai reali movimenti dei dati, non solo rispetto ai documenti di policy.
Questo significa anche verificare il comportamento dei sistemi, non solo l'esistenza delle policy. Una policy può affermare che i record dei clienti sono riservati, ma se strumenti a valle, estrazioni o dataset condivisi continuano a diffonderli, il controllo è già fallito. In pratica, il divario si chiude quando i team possono vedere l'applicazione delle regole all'interno del database e lungo la pipeline, correggendo le derive prima che diventino incidenti. Per le organizzazioni che devono gestire regole di hosting regionale e di residenza, i requisiti di residenza dei dati aggiungono un ulteriore livello di controllo da applicare in modo continuo, non una volta sola in fase di configurazione.
I requisiti normativi che definiscono le strategie di protezione
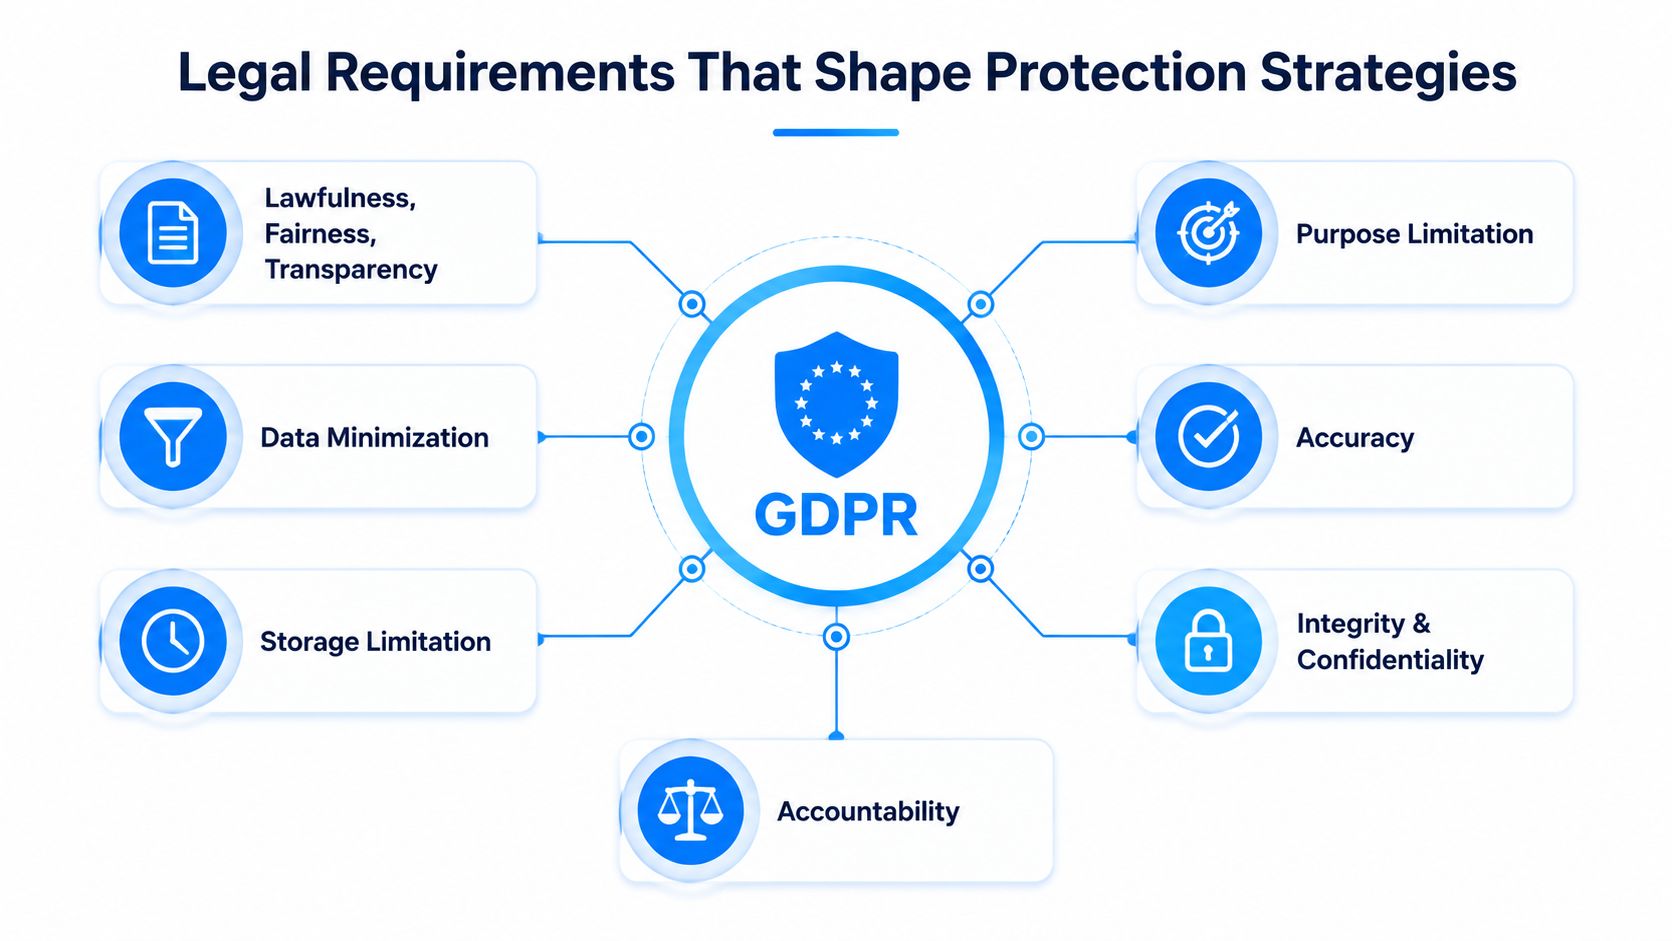
Le leggi sulla privacy diventano gestibili una volta tradotte in obblighi operativi. Il GDPR richiede che i dati personali siano trattati in modo lecito, corretto e trasparente, raccolti per finalità determinate, esplicite e legittime, limitati a quanto necessario, mantenuti esatti e aggiornati, conservati solo per il tempo necessario e protetti con misure di sicurezza adeguate come indicato nella guida della Banca Mondiale sulle leggi sulla protezione dei dati. Non è linguaggio astratto da policy: si traduce direttamente in moduli di raccolta, regole di conservazione, ambiti di accesso e workflow di cancellazione.
Tradurre le regole in obblighi operativi
Un modello di compliance funzionante parte di solito dalla classificazione dei dati, perché non si possono minimizzare o conservare correttamente i dati se non si sa che cosa si detiene. Dopodiché, la limitazione della finalità diventa un vincolo di progettazione. Ogni dataset, integrazione e input di modello dovrebbe avere un uso giustificato, non una vaga etichetta di “analytics futura”.
Il modo più rapido per non superare una revisione privacy è trattare tutti i dati dei clienti allo stesso modo. I campi sensibili richiedono una gestione più rigorosa, e il business deve giustificare perché esistono.
Il CCPA aggiunge un insieme di diritti dei consumatori diverso ma complementare. I residenti in California possono sapere quali informazioni personali sono state raccolte, chiederne la cancellazione, ordinare a un'azienda di non venderle né condividerle, correggere le informazioni inesatte e limitare l'uso e la divulgazione delle informazioni personali sensibili come descritto dal California Attorney General. Si applica a determinate imprese a scopo di lucro che operano in California se superano le soglie di fatturato o di volume di dati previste dalla legge, quindi la lezione operativa è che l'ambito di applicazione va verificato presto, non dato per scontato.
Un'ulteriore complicazione operativa negli Stati Uniti riguarda l'informativa. Le privacy policy e le informative equivalenti devono in genere indicare quali informazioni vengono raccolte, come vengono usate e divulgate, le scelte a disposizione degli interessati e i recapiti di contatto come riassunto nella panoramica di DLA Piper sulla normativa privacy statunitense. Questo livello di trasparenza è importante perché le promesse esterne ora condizionano l'architettura interna. Se l'informativa dice una cosa e la pipeline ne fa un'altra, la discrepanza ricade sull'azienda.
Per i team che gestiscono vincoli di archiviazione e trasferimento regionali, questa guida interna sui requisiti di residenza dei dati è un utile complemento, perché residenza, limitazione della finalità e conservazione spesso si scontrano nella stessa implementazione. La risposta pratica è allineare il luogo in cui risiedono i dati con quello in cui possono essere spostati, e poi far rispettare questo allineamento nei sistemi che trattano i record.
Una prospettiva esterna utile sono gli approfondimenti sulla protezione dei dati dei clienti, che ribadiscono un punto già noto a molte banche: se il cliente non riesce a capire come vengono gestiti i dati, la fiducia si erode rapidamente. È una lezione che vale ben oltre il settore bancario.
I controlli tecnici che riducono davvero il rischio
La crittografia è necessaria, ma non è l'intera risposta. I dati dei clienti possono essere comunque esposti se l'accesso alle chiavi è troppo ampio, se i backup sono raggiungibili da un ambiente di produzione compromesso o se il ripristino non è stato testato dopo un guasto. Le linee guida sulla sicurezza dei dati dei clienti indicano costantemente crittografia dei dati a riposo e in transito, archiviazione sicura delle chiavi, backup offsite crittografati e test di ripristino regolari come i dettagli operativi che rendono la crittografia reale anziché simbolica come illustrato da CDP.

Il controllo degli accessi limita il raggio d'impatto
L'accesso con privilegi minimi svolge un ruolo diverso dalla crittografia. Se una credenziale viene rubata, la portata dell'attaccante dovrebbe fermarsi al dataset minimo necessario per quel ruolo, senza estendersi a tutte le tabelle clienti dell'ambiente. Le linee guida indipendenti raccomandano di classificare i dati per sensibilità, limitare l'accesso a ciò che serve a ciascun ruolo e usare SSO con MFA per i sistemi che archiviano o trattano dati secondo le linee guida di Fullstory sulla protezione dei dati.
Questa differenza conta in produzione. La crittografia protegge il contenuto, ma il controllo degli accessi determina chi può anche solo tentare di raggiungerlo. In un incidente reale, è la sovrapposizione tra i due a ridurre il raggio d'impatto.
La minimizzazione è un controllo, non un compromesso
La minimizzazione dei dati può sembrare restrittiva finché non si vede quanto rischio scompare quando si smette di creare copie non necessarie. Meno file esportati, meno permessi ampi sul data warehouse e meno dataset secondari riducono tutti il numero di luoghi in cui i record dei clienti possono essere divulgati o usati in modo improprio. I team più solidi con cui ho lavorato trattano la minimizzazione come uno standard di sviluppo, non come una pulizia successiva alla revisione.
Regola pratica: se una pipeline non ha bisogno di un campo per svolgere il proprio compito, non spostate quel campo, non rendetelo persistente e non esponetelo a valle.
L'audit appartiene allo stesso livello di difesa. Le tecniche di monitoraggio e audit dei database sono importanti perché i controlli tecnici funzionano solo se i team possono vedere come i dati vengono effettivamente utilizzati. Questa visibilità diventa ancora più utile quando gli alert sono legati a tabelle specifiche, modifiche dello schema e pattern di utilizzo, anziché allo stato generico del sistema.
Lo stack giusto è a più livelli. La crittografia riduce l'esposizione, il controllo degli accessi limita chi può agire, la minimizzazione riduce la quantità di dati a rischio e l'audit logging fornisce una traccia di ciò che è accaduto. Nessuno di questi controlli sostituisce gli altri. In un ambiente di produzione, è la loro combinazione a impedire che un piccolo errore si trasformi in un grave incidente.
La lacuna di protezione nelle pipeline di AI e analytics
Il punto debole di molti programmi emerge dopo la raccolta. Una volta che i dati dei clienti finiscono in feature store, pesi dei modelli, dataset derivati o livelli di contesto per l'AI, diventa molto più difficile tracciarli, cancellarli o spiegarli su richiesta. Questa lacuna è particolarmente importante perché l'analisi di Glean sui rischi per la privacy nell'AI osserva che i sistemi di AI possono memorizzare dati rari, dedurre attributi sensibili da input innocui e rendere più difficile il rispetto dei diritti degli interessati quando le organizzazioni non riescono a trovare tutte le copie a valle.
Molti playbook sulla privacy diventano obsoleti. Insistono sulle regole di raccolta e sulla sicurezza dell'archiviazione, poi presumono che la parte difficile sia fatta. Negli stack di dati moderni, la parte difficile inizia quando i record grezzi vengono trasformati, incorporati, replicati e riutilizzati da sistemi di analytics o di machine learning.
I dati derivati creano problemi di applicazione
Un record può essere cancellato dal sistema di origine e sopravvivere comunque in più forme a valle. Non è una preoccupazione teorica: è così che funzionano le pipeline di feature, le estrazioni BI e le finestre di contesto. Una volta che i dati sono incorporati in artefatti derivati, l'organizzazione deve sapere dove si trovano questi artefatti e come vengono aggiornati prima di poter rispondere in modo pulito a una richiesta di cancellazione o di accesso.
Questo crea anche problemi di spiegabilità. Se un modello risponde a un input in un modo che lascia intendere di aver appreso qualcosa di sensibile, i team devono capire se il percorso di addestramento ha portato i dati personali più lontano del previsto. Ecco perché, nell'AI, la protezione non può fermarsi ai controlli in fase di ingestione.
La risposta pratica è governare la pipeline stessa. Validazione, lineage, mascheramento e restrizioni di accesso devono applicarsi non solo alla tabella grezza, ma anche ai prodotti trasformati che ne derivano. Altrimenti l'azienda si ritrova con una policy che dice una cosa e una pipeline che continua a distribuire copie nascoste.
I controlli organizzativi che rendono la protezione applicabile
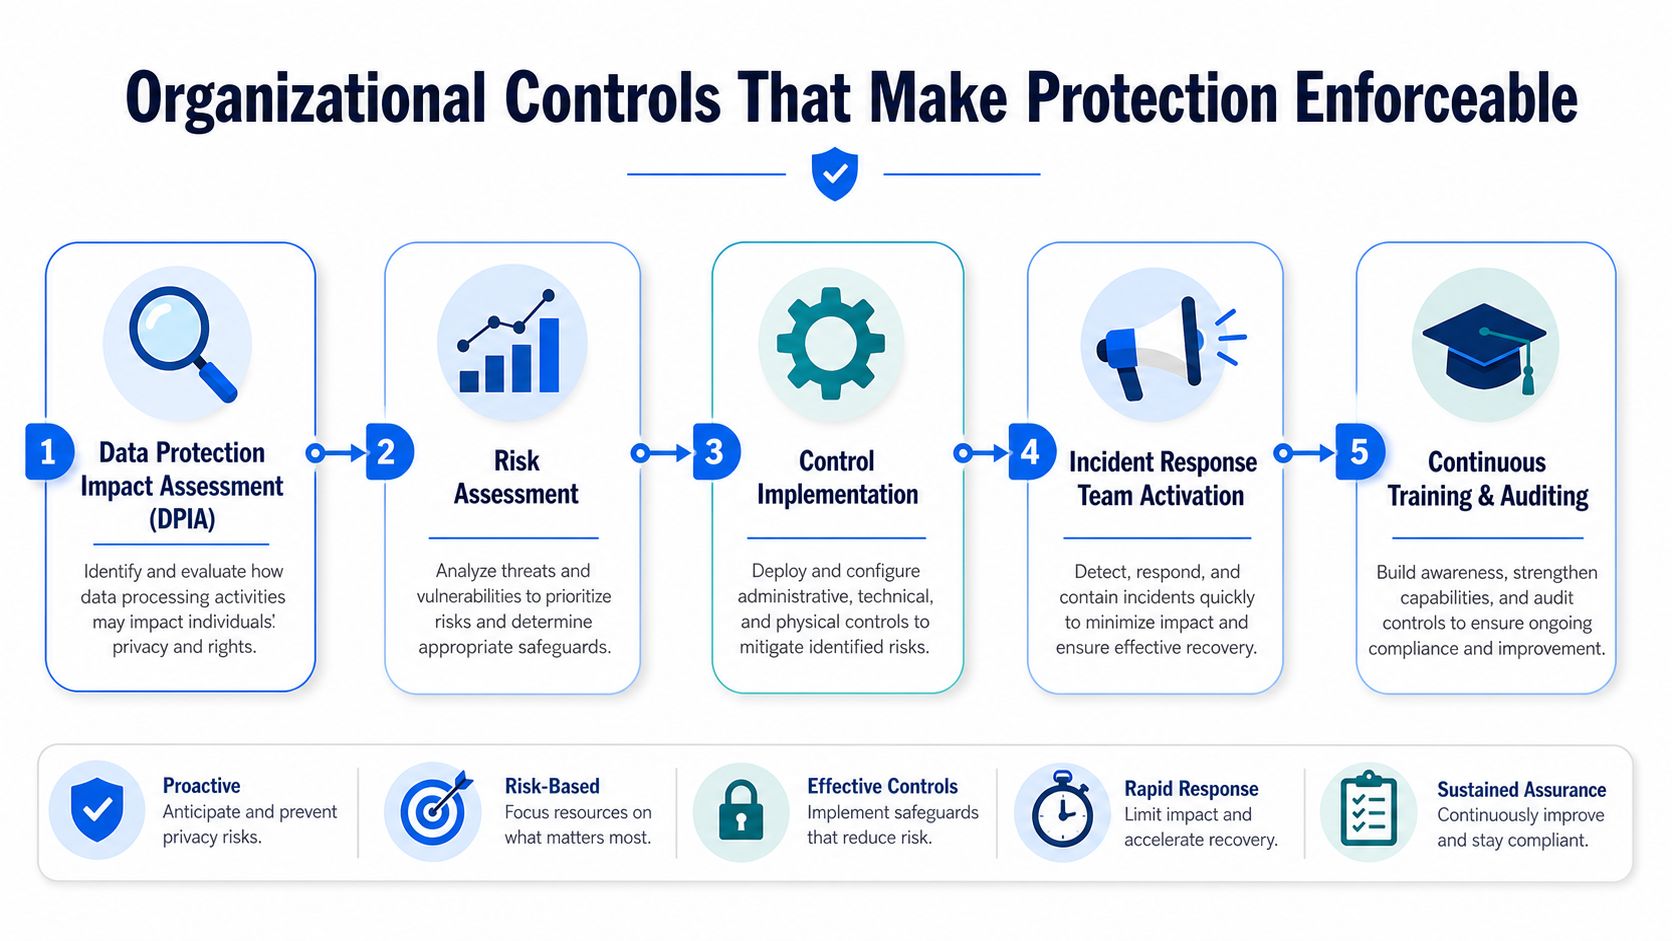
Il problema che vedo più spesso non è uno strumento mancante, ma una catena di responsabilità interrotta. I team di sicurezza gestiscono i controlli, i team dati le pipeline, la compliance i registri, e nessuno è responsabile dell'intero ciclo che va dalla policy all'applicazione. Una valutazione d'impatto sulla protezione dei dati (DPIA) aiuta perché obbliga a identificare, esaminare e documentare un processo ad alto rischio prima che entri in funzione.
La responsabilità funziona solo se ha dei titolari
Una DPIA conta solo se qualcuno risponde del risultato. In pratica, data owner, responsabile della sicurezza e revisore della compliance devono avere responsabilità separate, e il percorso di escalation deve essere definito prima che il sistema cambi. Se il titolare del controllo non è chiaro, la correzione slitta e le eccezioni restano aperte molto più a lungo del dovuto.
La stessa disciplina sulle responsabilità deve applicarsi alla risposta agli incidenti. Le violazioni fanno meno danni quando i team sanno già chi recupera i log, chi isola il sistema, chi comunica all'esterno e chi verifica il ripristino. Il playbook in sé conta meno del fatto che esista, sia aggiornato e sia stato provato rispetto a modalità di guasto operative reali.
Il monitoraggio impedisce che questa responsabilità diventi un esercizio burocratico. Se le evidenze vengono raccolte solo dopo che qualcosa è andato storto, l'organizzazione sta già reagendo in ritardo. I team hanno bisogno di registrazioni che mostrino come si sono comportati i controlli in produzione, non solo di un documento di policy che dice che avrebbero dovuto funzionare.
La formazione deve corrispondere all'ambiente di controllo. Gli ingegneri devono sapere quali dataset sono sensibili, gli analisti quali campi sono mascherati e chi risponde agli incidenti quali sistemi fanno fede durante un incidente. È questo che rende la protezione dei dati dei clienti applicabile anziché solo un'aspirazione. Significa anche che chi gestisce la pipeline deve capire dove avvengono concretamente i controlli, ed è per questo che i team che verificano il trattamento all'interno dell'ambiente, anziché dopo che i dati sono stati spostati altrove, tendono a colmare il divario più rapidamente, come mostra l'approccio di digna all'esecuzione nel database.
Observability nel database senza spostare i dati
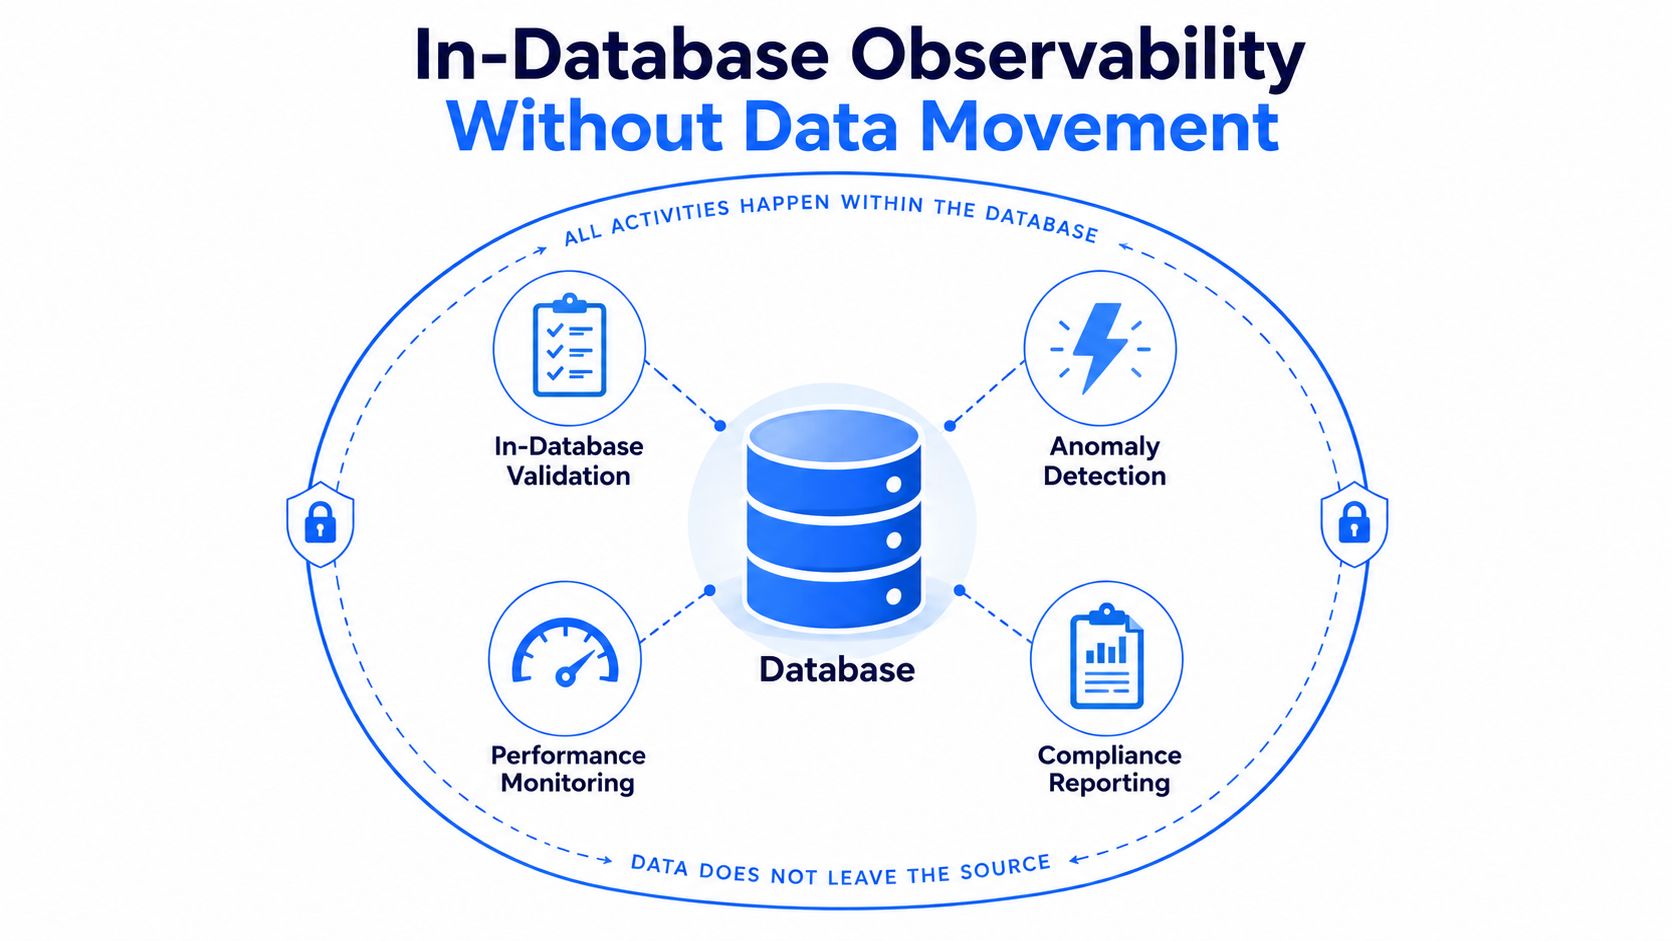
La scelta architetturale che ricorre negli ambienti regolamentati è semplice: mantenere l'observability dove i dati già risiedono. Eseguire validazione, rilevamento delle anomalie, schema tracking e reporting all'interno dell'infrastruttura del cliente evita l'esposizione che deriva dall'invio dei record a un'altra piattaforma solo per ispezionarli. Questo conta nei settori in cui residenza dei dati, controllo degli accessi e verificabilità sono essenziali.
Perché mantenere i controlli nel database cambia il profilo di rischio
Il vantaggio operativo è evidente non appena si considera il compromesso. Gli strumenti esterni richiedono spesso estrazioni, replica o un ampio accesso tramite connettori per ispezionare a fondo i dati, e ognuno di questi percorsi crea un ulteriore punto in cui i dati dei clienti possono essere esposti. L'esecuzione nel database riduce questi spostamenti e mantiene la superficie di osservazione all'interno del perimetro che l'azienda già controlla.
digna è un esempio di questo schema, perché viene eseguito nell'ambiente del cliente, inclusi i deployment in cloud privato o on-premises, ed esegue i controlli nel database, così che il fornitore non abbia bisogno di accedere ai dati di produzione. Il suo monitoraggio modulare si adatta inoltre agli ambienti in cui team diversi hanno bisogno di rilevamento delle anomalie, validazione, monitoraggio della tempestività e schema tracking senza introdurre un'ulteriore copia dei dati.
Protezione e observability non devono necessariamente essere in competizione. Se il monitoraggio può essere eseguito dove già si trovano i record, i team ottengono le evidenze di cui hanno bisogno senza ampliare la superficie di esposizione.
Questo conta soprattutto nei settori regolamentati. I team di servizi finanziari, sanità, telecomunicazioni e pubblica amministrazione spesso non possono accettare spostamenti di dati disinvolti solo per ottenere visibilità. Hanno bisogno di controlli che restino entro il perimetro, generino evidenze per l'audit e consentano comunque agli ingegneri di vedere se qualcosa ha subito una deriva, si è rotto o è arrivato in ritardo.
Per approfondire come questo schema si applica alle pipeline esterne, questa guida sull'esecuzione della qualità dei dati nel database è pertinente, perché la stessa logica di tutela del perimetro vale per qualità, observability e governance.
Implementare la protezione su piattaforme dati eterogenee
Il modo più sicuro per introdurre la protezione dei dati dei clienti in una grande azienda è partire dai dataset di maggior valore ed espandersi da lì. Un programma realistico inizia di solito in un data warehouse o in una pipeline operativa, per poi estendersi ai sistemi adiacenti una volta che il team vede monitoraggio, alerting e audit trail funzionare senza interrompere i workflow esistenti. È uno schema migliore che cercare di standardizzare ogni piattaforma fin dal primo giorno.
I dettagli di implementazione contano più dello slogan. Le aziende hanno bisogno di controlli che possano essere distribuiti in cloud privato, on-premises o in ambienti cloud controllati, e poi collegati alle piattaforme dati che già utilizzano. Se un livello di controllo funziona solo dopo una migrazione importante, l'adozione si blocca.
Una sequenza di rollout praticabile
Una sequenza pratica di solito si presenta così:
Partite dalle tabelle critiche: concentratevi prima sui dataset relativi a clienti, obblighi normativi, fatturazione o rischio, perché sono quelli con la maggiore esposizione se qualcosa deriva.
Collegate il monitoraggio dove risiedono i dati: mantenete validazione e rilevamento delle anomalie vicini alla fonte, così che i team non debbano duplicare i record per ispezionarli.
Integratevi con l'alerting esistente: indirizzate gli incidenti verso gli strumenti che gli ingegneri già usano, così che i nuovi controlli si adattino alle abitudini di risposta attuali.
Espandete modulo per modulo: aggiungete schema tracking, controlli di tempestività o validazione delle regole di business come livello successivo, una volta che il primo controllo è stabile.
Questo approccio funziona perché rispetta il modo in cui crescono le piattaforme dati. Data warehouse, data lake e pipeline raramente sono identici, e non hanno bisogno di strumenti identici per offrire una protezione utile. Un monitoraggio modulare è più facile da adottare di una riscrittura della piattaforma, soprattutto quando l'obiettivo è un rapido valore operativo.
I deployment più solidi evitano anche di trasformare l'observability in un ulteriore silo. Data engineer, analisti e team di governance hanno bisogno di una visione condivisa di che cosa è cambiato, che cosa è fallito e che cosa richiede attenzione. Quando tutti vedono le stesse evidenze, la protezione smette di essere un artefatto di compliance e inizia a comportarsi come un controllo operativo.
Se state integrando la protezione dei dati dei clienti in pipeline reali, e non solo nelle policy, visitate digna per vedere come il monitoraggio all'interno del vostro ambiente e l'esecuzione nel database possono inserirsi nel vostro stack di dati esistente. È un modo pratico per mantenere l'observability vicina ai dati, riducendo spostamenti ed esposizioni non necessari.
Se l'obiettivo è verificare i controlli rispetto ai reali movimenti dei dati senza creare nuove copie, l'observability della piattaforma dati eseguita all'interno del vostro ambiente mostra come validazione, rilevamento delle anomalie e schema tracking possano restare entro il perimetro che già proteggete.
Domande frequenti
Quale importo hanno raggiunto le sanzioni GDPR entro il 2026?
Le sanzioni GDPR cumulative in Europa hanno raggiunto circa 7,1 miliardi di euro entro gennaio 2026. Le autorità ricevevano inoltre in media oltre 400 notifiche di violazione dei dati personali al giorno, un aumento del 22 per cento su base annua e la prima volta che la media giornaliera superava quota 400 dall'entrata in vigore del GDPR, secondo i dati di PrivacyEngine citati nell'articolo.
Che cosa impone il GDPR alle aziende riguardo ai dati dei clienti?
Il GDPR richiede che i dati personali siano trattati in modo lecito, corretto e trasparente, raccolti per finalità determinate e legittime, limitati a quanto necessario, mantenuti esatti, conservati solo per il tempo necessario e adeguatamente protetti. L'articolo collega questi principi direttamente a moduli di raccolta, regole di conservazione, ambiti di accesso e workflow di cancellazione.
Quali controlli tecnici proteggono meglio i dati dei clienti?
Funziona meglio una combinazione a più livelli. La crittografia a riposo e in transito richiede archiviazione sicura delle chiavi, backup offsite crittografati e ripristini testati; l'accesso con privilegi minimi tramite SSO e MFA limita il raggio d'impatto; la minimizzazione elimina le copie non necessarie; e l'audit logging registra ciò che è accaduto. Nessuno di questi controlli sostituisce gli altri.
Perché i dati dei clienti sono più difficili da proteggere nelle pipeline di AI e analytics?
Una volta che i record finiscono in feature store, pesi dei modelli, dataset derivati o livelli di contesto per l'AI, diventano difficili da tracciare, cancellare o spiegare. Un record cancellato alla fonte può sopravvivere a valle, quindi validazione, lineage, mascheramento e restrizioni di accesso devono coprire anche i prodotti trasformati, non solo la tabella grezza.
In che modo l'observability nel database riduce il rischio per la protezione dei dati?
Mantiene i controlli dove i dati già risiedono. Gli strumenti esterni richiedono spesso estrazioni, replica o un ampio accesso tramite connettori, e ognuno di questi crea un ulteriore punto di esposizione. Eseguire validazione, rilevamento delle anomalie, schema tracking e reporting all'interno della vostra infrastruttura, incluso il cloud privato o l'on-premises, evita di inviare altrove i record dei clienti solo per ispezionarli.


