Perché la qualità dei dati è importante per un'organizzazione
|
8
min di lettura

Un team dirigenziale inizia la mattinata con una routine familiare. La finanza esamina la dashboard dei ricavi, le operations controllano i volumi di evasione degli ordini, le vendite studiano la pipeline e il servizio clienti si prepara alla domanda della giornata. Nel pomeriggio qualcuno scopre che una fonte ha consegnato in ritardo, un'altra ha cambiato il nome di un campo e una terza contiene record cliente duplicati. La dashboard sembrava precisa, ma l'organizzazione stava prendendo decisioni sulla base di un quadro incompleto.
Di solito il problema non è un clamoroso guasto del database. È un campo mancante, un'estrazione obsoleta, una definizione incoerente o una modifica dello schema che nessuno ha notato. Questi difetti finiscono in previsioni, report normativi, workflow dei clienti e sistemi di AI prima che qualcuno li ricolleghi alla fonte originale.
Ecco perché capire perché la qualità dei dati è importante per un'organizzazione è una questione di business, non soltanto tecnica. Dati affidabili aiutano le persone a decidere, agire, spiegare e rispettare gli obblighi con sicurezza. Dati scadenti costringono i team a mettere in dubbio i report, ripetere il lavoro, rimandare le iniziative e difendere numeri che non riescono a ricostruire fino in fondo. Questa guida spiega come la qualità dei dati crei controllo organizzativo su decisioni, compliance e rischio legato all'AI, e come i leader possano trasformarla in una capacità operativa duratura. Per una panoramica pratica del suo valore di business, consultate i vantaggi organizzativi della qualità dei dati.
Indice
Introduzione: perché la qualità dei dati determina il successo di un'organizzazione
Che cosa significa qualità dei dati all'interno di un'organizzazione
Il vero costo della scarsa qualità dei dati per le organizzazioni
Come la scarsa qualità dei dati mina decisioni, fiducia e AI
Come le organizzazioni costruiscono qualità dei dati e osservabilità affidabili
Esempi reali dell'impatto della qualità dei dati nei diversi settori
Introduzione: perché la qualità dei dati determina il successo di un'organizzazione
Una previsione può fallire anche quando il calcolo è corretto. Supponiamo che un team di pianificazione preveda un aumento degli ordini e programmi di conseguenza scorte, personale e trasporti. La previsione usa un modello valido, ma un sistema regionale invia in ritardo le transazioni del giorno prima e un altro registra i resi sotto una categoria modificata. Il team di pianificazione non sta guardando dati privi di senso. Sta guardando dati che non rappresentano più il business nel suo complesso.
Questa distinzione è importante. La maggior parte delle decisioni organizzative dipende dall'unione di più sistemi: anagrafiche clienti, ordini, pagamenti, magazzino, interazioni con il servizio clienti, dati sul personale e informazioni esterne. Un difetto in un singolo flusso può alterare il significato di un risultato combinato. La finanza può vedere ricavi che non quadrano, il servizio clienti può contattare la persona sbagliata e i dirigenti possono passare una riunione a discutere su quale foglio di calcolo sia giusto anziché decidere cosa fare.
I problemi di qualità oltrepassano i confini tra funzioni
La qualità dei dati riguarda ogni team che utilizza informazioni:
La finanza li usa per i processi di chiusura, la pianificazione, i controlli e il reporting.
Le operations si basano su record tempestivi e completi per coordinare il lavoro.
Vendite e marketing hanno bisogno di dati coerenti su clienti e account per dare priorità alle opportunità.
Il servizio clienti dipende da identità, storici e dettagli delle pratiche accurati.
Rischio e compliance richiedono evidenze tracciabili a supporto degli obblighi formali.
I team dati e AI hanno bisogno di input affidabili per dashboard, modelli e workflow automatizzati.
Il team dati può individuare il difetto, ma spesso è il business ad assorbirne le conseguenze. Una consegna in ritardo può tradursi in una decisione operativa mancata. Un account duplicato può portare a un trattamento confuso del cliente. Una colonna rinominata può far sì che un report a valle mostri una misura vuota o fuorviante senza generare alcun errore evidente.
Regola pratica: trattate ogni dataset critico come parte di un processo operativo, non come un asset tecnico passivo.
Spesso le organizzazioni iniziano a occuparsi di qualità dopo un incidente visibile. Un report si rompe, un'autorità di vigilanza chiede evidenze o un modello produce un risultato non plausibile. Questa reazione è comprensibile, ma costringe i leader a pagare scoperta, indagine, correzione e comunicazione nel punto più costoso del ciclo di vita.
Un approccio più solido pone le domande prima. Chi è il responsabile dei dati? Che cosa significa “completo” per questo caso d'uso? Quanto devono essere aggiornati? Quali modifiche devono fermare una pipeline e quali devono generare un avviso? Una volta che queste risposte sono esplicite, la qualità dei dati diventa qualcosa che l'organizzazione può gestire anziché qualcosa su cui può solo discutere.
Che cosa significa qualità dei dati all'interno di un'organizzazione
Pensate ai dati dell'organizzazione come a un sistema di approvvigionamento idrico. Le informazioni nascono da molte fonti, attraversano punti di trattamento e distribuzione e alla fine arrivano a un rubinetto dove qualcuno le usa. Un bicchiere d'acqua dall'aspetto pulito non dimostra che l'intera filiera sia in salute. L'organizzazione deve anche sapere se l'acqua è arrivata in tempo, se a monte sono entrati contaminanti e se la pressione è sufficiente per l'uso previsto.
La qualità dei dati funziona allo stesso modo. Un dataset è idoneo allo scopo quando possiede le caratteristiche richieste da una determinata decisione o da un determinato processo. Un report strategico mensile può tollerare un breve ritardo, mentre un processo antifrode o un alert operativo potrebbero non tollerarlo. Un dataset di addestramento per l'AI può richiedere una lineage solida ed etichette coerenti, oltre alle qualità attese in una dashboard.
Sei controlli rendono la qualità concreta
Partite dalle dimensioni che descrivono se i dati possono supportare un utilizzo in modo sicuro:
Accuratezza significa che il valore riflette l'entità reale che rappresenta. L'indirizzo attuale di un cliente deve indicare dove il cliente può essere raggiunto.
Completezza significa che non mancano informazioni critiche. Un ordine senza identificativo di prodotto può esistere nel sistema, ma non può supportare un'analisi di prodotto affidabile.
Coerenza significa che i sistemi collegati usano valori e definizioni compatibili. Se un team classifica un cliente come attivo mentre un altro usa uno stato contrastante, gli utenti non possono interpretare con sicurezza il record combinato.
Tempestività significa che le informazioni arrivano e restano aggiornate quando il processo ne ha bisogno. Un valore corretto consegnato dopo la finestra decisionale può essere comunque inutile dal punto di vista operativo.
Validità significa che i dati rispettano i formati, gli intervalli e le regole di business richiesti. Una data, un identificativo o una categoria possono essere presenti ma non superare le regole necessarie per elaborarli.
Unicità significa che l'organizzazione non conta più volte la stessa entità reale. Record duplicati di clienti o transazioni possono distorcere volumi, valori e priorità.

L'idoneità conta più della perfezione
Nessuna organizzazione ha bisogno che ogni campo sia perfetto per poter operare. La domanda utile è se i dati siano abbastanza affidabili per lo scopo previsto, con limiti noti e responsabili chiaramente individuati. Un workflow del servizio clienti può dare priorità all'accuratezza e alla completezza delle identità, mentre un report sui trend per il management può dare priorità alla coerenza e alla comparabilità storica.
Ecco perché i requisiti di qualità vanno definiti insieme agli utenti di business. Chiedetevi quale decisione supportano i dati, quanto costerebbe un errore, con quale rapidità va rilevato un problema e di quali evidenze hanno bisogno gli utenti per fidarsi del risultato. Il significato della qualità dei dati diventa più chiaro quando i team collegano ogni dimensione a un processo reale anziché trattarla come un punteggio astratto.
Il vero costo della scarsa qualità dei dati per le organizzazioni
La scarsa qualità dei dati genera perdite visibili, come pagamenti errati o report non riusciti. Il suo costo maggiore, però, si manifesta spesso come attrito accumulato. Gli analisti riconciliano manualmente i file, gli ingegneri indagano su modifiche inspiegabili alle pipeline e i manager rimandano le decisioni mentre i team verificano i numeri. I team commerciali perdono fiducia in record che dovrebbero guidare l'azione.
IBM cita una ricerca di Gartner secondo cui le organizzazioni perdono in media 12,9 milioni di USD all'anno a causa della scarsa qualità dei dati, come riportato nell'analisi di IBM sul costo della scarsa qualità dei dati. La stessa analisi afferma che il 43% dei chief operations officer considera i problemi di qualità dei dati la propria priorità più importante in materia di dati. Oltre un quarto delle organizzazioni stima perdite annue superiori a 5 milioni di USD, mentre il 7% riporta perdite pari o superiori a 25 milioni di USD.
Queste cifre descrivono un'esposizione su scala enterprise, ma il meccanismo è familiare in organizzazioni di ogni dimensione. Un record difettoso genera rilavorazione. La rilavorazione consuma capacità, e la capacità persa ritarda le iniziative da cui ci si attende valore. I team possono anche stimare la propria esposizione con questo calcolatore del costo del data downtime.
Il conto va oltre la correzione
L'executive brief 2024 di Anomalo riporta che il 95% dei dirigenti ha vissuto un problema di qualità dei dati con un impatto diretto sui risultati di business, secondo lo State of Enterprise Data Quality report. L'impatto può assumere diverse forme:
Lavoro manuale: i team confrontano estrazioni, correggono record e spiegano discrepanze invece di migliorare prodotti o servizi.
Perdita di ricavi: informazioni errate su clienti, prodotti o account possono impedire che l'offerta, la fattura o il follow-up giusti arrivino nel posto giusto.
Latenza decisionale: i leader attendono la riconciliazione prima di approvare azioni, lanci o investimenti.
Freno alla trasformazione: i programmi di modernizzazione si bloccano quando le vecchie definizioni e le nuove piattaforme producono risultati contrastanti.
Costi di controllo: i team di compliance e audit dedicano più tempo a raccogliere evidenze e a indagare sulle eccezioni.
Un report del 2025 sulla gestione dei dati CRM ha rilevato che il 76% delle organizzazioni dichiara che meno della metà dei propri dati CRM è accurata e completa. Lo stesso report indica che il 37% ha identificato la scarsa qualità dei dati come causa diretta di perdita di ricavi e che il 37% ha affermato che ha ritardato iniziative chiave per la generazione di ricavi, come riportato nel comunicato di Validity sullo State of CRM Data Management 2025.
Perché i costi si sommano
I difetti nei dati raramente restano nel sistema in cui nascono. Un identificativo mancante può rompere un join, distorcere una metrica, alterare una previsione e influenzare una decisione sul personale o sugli investimenti. Ogni team a valle può poi effettuare la propria correzione, moltiplicando lo sforzo iniziale.
Ricerche indipendenti citate nella letteratura recente riportano perdite annue medie di circa 12,9 milioni di USD per organizzazione. Altri studi stimano che i dati di cattiva qualità possano assorbire dal 15% al 25% dei ricavi in molte aziende tra rilavorazioni, correzione di errori, opportunità perse e decisioni sbagliate, come discusso nella ricerca pubblicata sui costi della qualità dei dati.
La questione dell'investimento è quindi più ampia del costo di una piattaforma per la qualità. Le organizzazioni finanziano anche il lavoro ricorrente di correzione, le decisioni ritardate, le attività di controllo e l'esposizione che si crea quando responsabilità, tempestività o modifiche dello schema passano inosservate.
Come la scarsa qualità dei dati mina decisioni, fiducia e AI
Una dashboard finanziaria mostra ricavi in crescita, quindi il management approva nuove assunzioni. Più tardi il team scopre che una tabella sorgente è arrivata in ritardo ed escludeva le transazioni recenti. Sullo schermo nulla sembrava rotto. Eppure la decisione era stata costruita su evidenze incomplete.
Un report può essere visualizzato normalmente mentre il suo significato è cambiato. Un campo rinominato, uno schema modificato o una definizione di business rivista possono attraversare la pipeline senza alcun errore evidente. Il risultato è più pericoloso di un report vuoto, perché numeri familiari spingono all'azione prima che qualcuno indaghi.
La fiducia si indebolisce allora in tutta l'organizzazione. I leader mettono in dubbio le metriche ufficiali, gli analisti difendono cifre che non hanno creato e i team mantengono fogli di calcolo personali o spiegazioni verbali per colmare le lacune. La qualità dei dati è diventata una questione di controllo organizzativo, non soltanto un problema delle dashboard.
I guasti silenziosi danneggiano la fiducia
Diversi percorsi di guasto meritano attenzione:
I dati obsoleti fanno apparire storiche le condizioni attuali.
Lo schema drift modifica campi, tipi o strutture che gli utenti a valle possono interpretare in modo errato.
Le consegne incomplete rimuovono da una misura una parte della popolazione o del periodo di riferimento.
Gli spostamenti di distribuzione non osservati fanno sì che i dati si comportino diversamente dalla baseline usata da un report o da un modello.
Le definizioni incoerenti portano due team credibili a dare risposte diverse alla stessa domanda di business.
Ricerche e materiali di settore associano i dati di cattiva qualità a una minore accuratezza delle decisioni, a una minore fiducia nel reporting e a risposte più lente. Una fonte basata su sondaggi ha identificato la qualità dei dati come il secondo ostacolo più citato alla creazione di valore da dati e analytics. Un'altra ha riportato che il 91% dei leader afferma che investire nella qualità dei dati ha avuto un effetto positivo sulla crescita del business, come sintetizzato nella trattazione di O'Reilly sulla qualità dei dati.
Questi guasti creano anche lacune nei controlli. Se nessuno è responsabile di una definizione, monitora l'aggiornamento dei dati o esamina le modifiche dello schema, l'organizzazione potrebbe non essere in grado di spiegare perché un numero è cambiato né di dimostrare quali dati abbiano supportato una decisione.
L'AI alza l'asticella
I sistemi di AI riutilizzano i dati con grande velocità e su larga scala. Un modello può imparare da record incompleti, un agente può interrogare una colonna rinominata e un workflow automatizzato può agire su uno stato obsoleto. L'output può sembrare sicuro anche quando le sue evidenze sono sbagliate. Per una spiegazione pratica di questa dipendenza, leggete perché i modelli di AI dipendono dalla qualità dei dati.
La norma ISO/IEC 5259-5:2025 presenta la governance della qualità dei dati come un framework organizzativo che copre l'intero ciclo di vita dei dati per analytics e machine learning, come descritto nella panoramica della norma ISO/IEC 5259-5:2025. La domanda per il management va quindi oltre l'accuratezza delle dashboard: chi ha governato i dati, quali controlli sono stati applicati e i dati sono rimasti idonei per l'addestramento, l'inferenza e le evidenze normative?
Spunto di governance: il rischio dell'AI inizia a monte, dove i team definiscono, raccolgono, trasformano, descrivono e approvano i dati che un sistema automatizzato utilizzerà.
La qualità funziona come un piano di controllo che collega correttezza operativa, fiducia nelle decisioni, evidenze di compliance e responsabilità dell'AI. Monitorare soltanto gli output dei modelli o la disponibilità delle dashboard significa osservare la fase finale, quando i guasti precedenti potrebbero essere già passati inosservati.
Come le organizzazioni costruiscono qualità dei dati e osservabilità affidabili
La pulizia reattiva e l'osservabilità proattiva risolvono problemi diversi. La pulizia ripara i difetti noti dopo che hanno raggiunto un utilizzatore. L'osservabilità aiuta i team a capire che cosa è cambiato, quando è cambiato, quali asset sono coinvolti e se il comportamento si discosta da una baseline attesa.
Un programma sostenibile usa entrambe, ma colloca prevenzione e rilevamento precoce più vicino alla fonte. Lo scopo non è creare regole all'infinito. È rendere espliciti i requisiti importanti, monitorarli in modo continuo e indirizzare i problemi alle persone in grado di correggerli.
Partite da responsabilità e finalità
Assegnate un responsabile per ogni dominio di dati critico. Questa persona deve lavorare con data engineer, analisti, team di gestione del rischio e utenti operativi per definire la qualità accettabile per i processi che dipendono da quei dati.
Una scheda di responsabilità utile comprende:
Finalità di business: quale decisione, interazione con il cliente, controllo o modello utilizza il dataset?
Requisiti di qualità: quali campi devono essere completi, validi, coerenti, univoci, accurati o tempestivi?
Livello di impatto: che cosa succede se il dataset è errato o in ritardo?
Percorso di risposta: chi indaga, chi approva una soluzione temporanea e chi conferma la risoluzione?
Evidenze: quali controlli, dettagli di lineage e registrazioni degli incidenti dimostrano il controllo?
Senza responsabilità, il monitoraggio diventa un servizio di notifiche. Gli alert arrivano, ma nessuno ha l'autorità o il contesto per decidere se il problema sia rilevante.
Confrontate la pulizia reattiva con il controllo continuo
Pulizia reattiva | Qualità e osservabilità proattive |
|---|---|
Individua i difetti dopo che un report o un utente li ha notati | Rileva comportamenti insoliti prima dell'utilizzo a valle |
Si concentra su singoli record o regole note | Combina la validazione con segnali di aggiornamento, volume, lineage e schema |
Ripara i sintomi a valle | Aiuta i team a correggere i problemi alla fonte |
Produce spiegazioni una tantum | Costruisce evidenze ripetibili per governance e audit |
Misura gli incidenti dopo il disservizio | Traccia pattern e degrado nel tempo |
I controlli continui devono coprire le regole di business a livello di record, le tempistiche di consegna, l'andamento dei volumi e le modifiche strutturali. L'esecuzione in-database consente inoltre di mantenere i dati all'interno dell'ambiente del cliente, mentre metriche e analisi vengono eseguite dove i dati risiedono già.
Usate l'osservabilità come livello operativo condiviso
digna offre una piattaforma modulare per la qualità e l'osservabilità dei dati che gira all'interno dell'ambiente del cliente. Le sue funzionalità comprendono rilevamento delle anomalie, analisi storica delle metriche, monitoraggio della tempestività, validazione a livello di record, tracciamento delle modifiche dello schema, esecuzione in-database, deployment privato o on-premises e una dashboard condivisa per data engineer, analisti e stakeholder. I team possono approfondire la data observability come disciplina operativa e poi valutare quali controlli si adattano alla propria architettura e al proprio profilo di rischio.
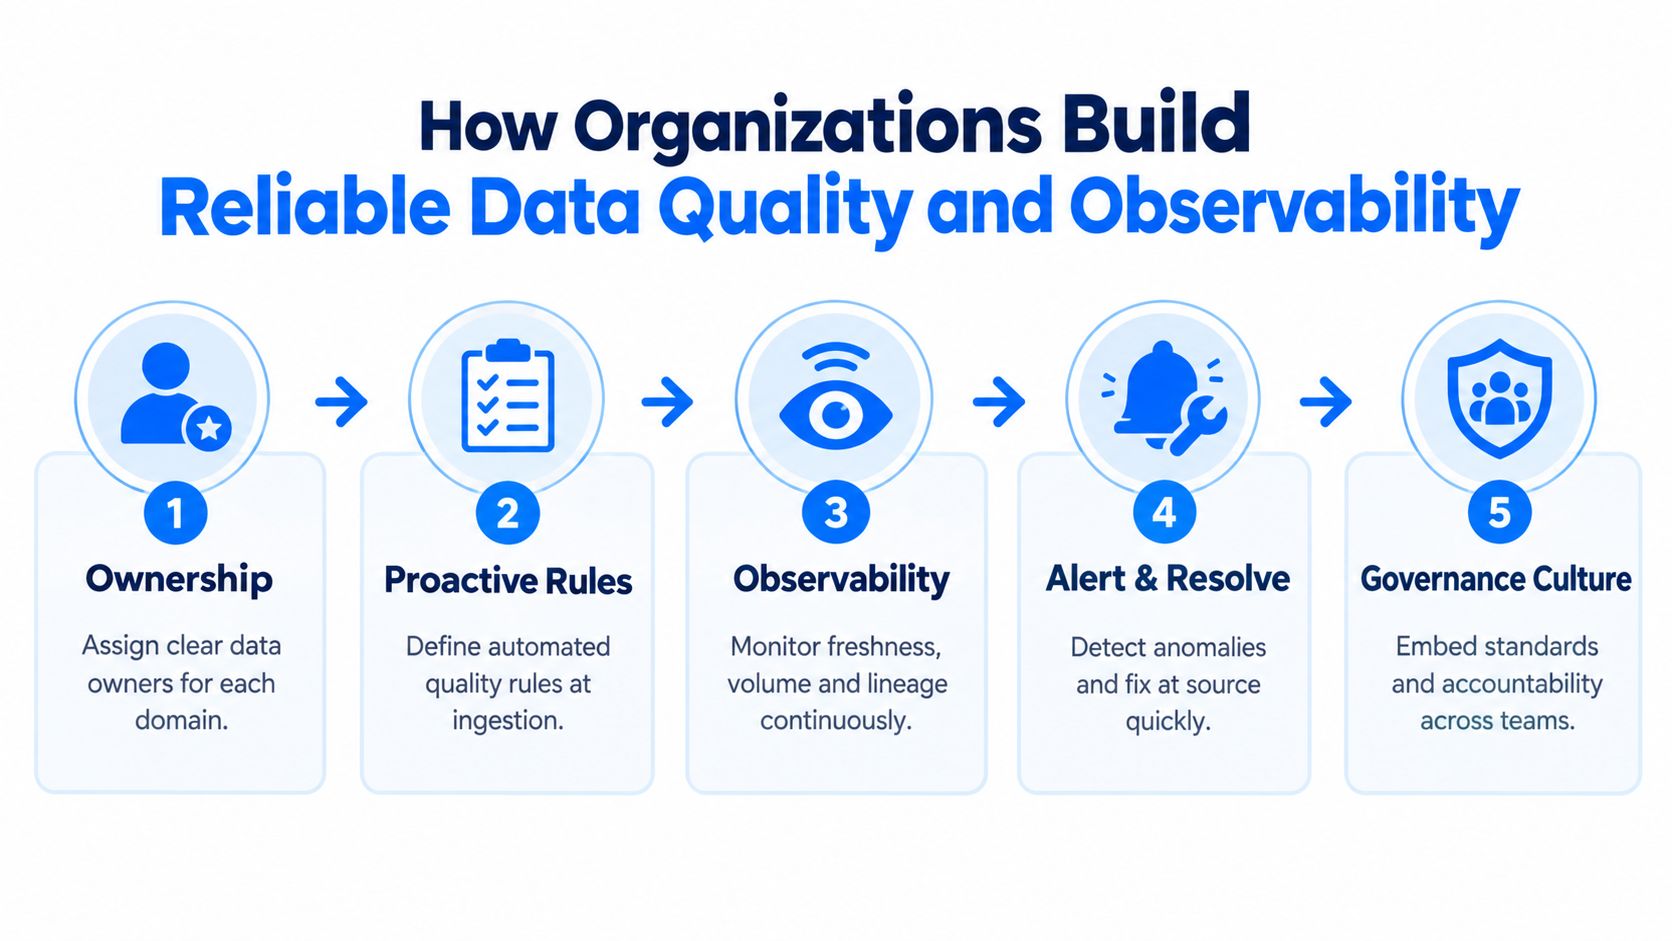
La piattaforma è solo una parte del programma. I leader hanno comunque bisogno di definizioni chiare, accordi sulla risposta e incentivi che premino la prevenzione anziché la silenziosa riparazione a valle. L'osservabilità dà alle persone visibilità. La governance dà loro autorità e responsabilità.
Esempi reali dell'impatto della qualità dei dati nei diversi settori
Le stesse dimensioni della qualità generano rischi diversi a seconda del settore. Un flusso di transazioni in ritardo può influire sul reporting dei rischi nei servizi finanziari, mentre un valore clinico mancante può influire sul coordinamento dell'assistenza in sanità. Lo schema di controllo resta riconoscibile, ma cambiano le conseguenze di business e le evidenze richieste.
Servizi finanziari
Una banca può dipendere da dati su transazioni, clienti, rischi e obblighi normativi che passano attraverso diverse piattaforme. Se una modifica dello schema altera il tipo di un campo o un flusso arriva in ritardo, i team di reporting possono ritrovarsi a riconciliare i numeri manualmente mentre i team di rischio si chiedono se stiano usando la stessa popolazione. I controlli di qualità devono validare le regole di business, tracciare le consegne, rilevare pattern insoliti e conservare evidenze che mostrino che cosa è cambiato e come l'organizzazione ha risposto.
Sanità
Le organizzazioni sanitarie combinano record clinici, amministrativi, di rimborso e operativi. Identificativi incoerenti possono separare eventi correlati, mentre informazioni incomplete o in ritardo possono rendere più difficile per i team comprendere un paziente o un episodio di cura. Qui completezza e coerenza supportano un coordinamento sicuro, mentre tempestività e tracciabilità supportano i processi operativi e normativi.
Telecomunicazioni
I team delle telecomunicazioni lavorano con grandi volumi di dati su clienti, rete, fatturazione e utilizzo. Una variazione improvvisa nel volume dei record può indicare un problema di pipeline, una modifica del sistema sorgente o un cambiamento reale dell'attività. Monitorare le consegne attese, i comportamenti insoliti e le modifiche strutturali aiuta i team a distinguere i movimenti del business dai guasti dei dati prima che report o workflow operativi reagiscano in modo errato.
Settore pubblico
Le organizzazioni del settore pubblico devono spesso combinare record di diversi dipartimenti preservando la verificabilità e definizioni coerenti. Una lacuna nella lineage può rendere difficile spiegare come è stato prodotto un dato. Validazione, responsabilità ed evidenze contano perché i decisori potrebbero dover giustificare non solo il risultato, ma anche il processo che lo ha prodotto.
Principio di settore: il controllo di qualità giusto è quello legato a una decisione, a un obbligo o a un risultato di servizio reale.
Questi esempi mostrano anche perché un unico punteggio aziendale raramente racconta tutta la storia. Un dataset può essere accettabile per un'analisi generale dei trend e inadatto a un calcolo regolamentato. I programmi di qualità dovrebbero quindi classificare i dati per utilizzo, rischio e risposta richiesta, anziché applicare un'unica soglia universale.
Costruire una cultura della qualità dei dati che duri
Un programma di qualità dei dati duraturo si basa su tre abitudini: responsabilità, visibilità continua e accountability di business.
Responsabilità significa che ogni dataset critico ha una persona o un team designato, responsabile della sua definizione, della condizione accettabile e del percorso di risoluzione. La responsabilità non deve scomparire quando i dati passano da un sistema operativo a un data warehouse, un data lake, una dashboard, un modello o un workflow di AI.
Visibilità continua significa che i team monitorano più delle semplici regole superato/non superato. Osservano aggiornamento, volume, completezza, validità, comportamenti insoliti e modifiche strutturali. Conservano inoltre abbastanza lineage e contesto sugli incidenti per spiegare quali utilizzatori potrebbero essere coinvolti.
Accountability di business significa che le misure di qualità sono collegate ai risultati. Invece di segnalare soltanto che un controllo non è stato superato, i team dovrebbero spiegare se il problema minaccia un processo cliente, un controllo finanziario, una segnalazione normativa, una previsione o un caso d'uso di AI.
Una checklist pratica per iniziare si presenta così:
Scegliete gli asset critici: individuate i dataset che supportano decisioni e obblighi importanti.
Definite l'idoneità: concordate che cosa significano accurato, completo, coerente, valido, univoco e tempestivo per ogni utilizzo.
Assegnate la risposta: stabilite chi riceve gli alert e chi può risolvere i problemi alla fonte.
Monitorate in modo continuo: rilevate il degrado prima che raggiunga report, modelli o azioni automatizzate.
Valutate il valore: tracciate la riduzione delle rilavorazioni, la risoluzione più rapida dei problemi, evidenze più solide e una maggiore fiducia negli analytics.
La lezione centrale è semplice. La qualità dei dati non è una rifinitura finale applicata prima del reporting. È il livello di controllo che aiuta un'organizzazione a decidere in modo responsabile, a dimostrare la compliance e a usare l'AI senza affidare il proprio giudizio a input inaffidabili.
digna aiuta le organizzazioni a monitorare il comportamento dei dati, validare i record, tracciare la tempestività, rilevare le modifiche dello schema e osservare le metriche di business e di piattaforma all'interno del proprio ambiente. Visitate digna per scoprire come la sua piattaforma modulare per la qualità e l'osservabilità dei dati può offrire una base più affidabile per analytics e AI.
Per il modello operativo che trasforma questi requisiti in controlli continui anziché in pulizie periodiche, leggete data quality management.
Domande frequenti
Quanto costa a un'organizzazione la scarsa qualità dei dati?
IBM cita una ricerca di Gartner che stima la perdita media in 12,9 milioni di USD all'anno. Oltre un quarto delle organizzazioni stima perdite annue superiori a 5 milioni di USD e il 7% riporta perdite pari o superiori a 25 milioni di USD, mentre il 43% dei chief operations officer considera la qualità dei dati la propria principale priorità in materia di dati.
Perché piccoli difetti causano danni sproporzionati?
Perché si propagano. Un campo mancante, un'estrazione obsoleta, una definizione incoerente o una modifica dello schema non notata raggiungono previsioni, report normativi, workflow dei clienti e sistemi di AI prima che qualcuno li ricolleghi alla fonte. La perdita visibile è la rilavorazione; quella più grande è l'attrito accumulato e le decisioni ritardate.
Qualità dei dati e data observability sono la stessa cosa?
Rispondono a domande diverse. La pulizia ripara i difetti noti dopo che un utilizzatore li ha visti, mentre l'osservabilità spiega che cosa è cambiato, quando, quali asset sono coinvolti e se il comportamento si discosta da una baseline attesa. Un programma duraturo usa entrambe, ma sposta prevenzione e rilevamento più vicino alla fonte.
Da dove dovrebbe iniziare un'organizzazione?
Dalla responsabilità, non dalle regole. Assegnate un responsabile per ogni dominio di dati critico, poi registrate la finalità di business, i requisiti di qualità per ciascun campo, il livello di impatto se i dati sono errati o in ritardo e il percorso di risposta, indicando chi indaga, chi approva una soluzione temporanea e chi conferma la risoluzione.
Il rischio cambia a seconda del settore?
Le dimensioni della qualità restano costanti; le conseguenze no. Nei servizi finanziari un flusso in ritardo o un tipo di campo modificato impone riconciliazioni manuali in tutto il reporting dei rischi. In sanità, identificativi incoerenti separano eventi correlati e ritardano il coordinamento dell'assistenza. Le evidenze da conservare dipendono dall'autorità di vigilanza, non dalla pipeline.


