Perché i workload Teradata diventano instabili e come i team lo rilevano per tempo
|
6
min di lettura
I sistemi Teradata sono progettati per la stabilità. Da decenni le aziende si affidano a Teradata per ottenere analytics prevedibili e ad alte prestazioni su larga scala. Nei settori regolamentati come banche, assicurazioni, telecomunicazioni e pubblica amministrazione, Teradata resta una spina dorsale fondamentale per i processi decisionali.
Eppure, anche in questi ambienti maturi, i data team si scontrano con un problema familiare: carichi di lavoro un tempo stabili diventano gradualmente imprevedibili.
Il consumo di CPU oscilla. L'utilizzo di IO tende a salire. I job di lunga durata consumano più risorse mese dopo mese. I costi aumentano, non perché qualcosa si sia rotto, ma perché qualcosa è cambiato silenziosamente.
Capire perché i workload Teradata diventano instabili, e come rilevare per tempo questa instabilità, è essenziale per mantenere prestazioni, efficienza dei costi e fiducia operativa.
In Teradata l'instabilità raramente compare dall'oggi al domani
A differenza delle moderne piattaforme cloud, gli ambienti Teradata tendono a evolvere lentamente. Le modifiche sono deliberate, controllate e ben documentate. Di conseguenza, l'instabilità raramente si manifesta come un guasto improvviso.
Si presenta invece come una deriva comportamentale:
I job continuano a completarsi correttamente
Gli SLA sono tecnicamente rispettati
Le dashboard non mostrano evidenti campanelli d'allarme
Eppure, sotto la superficie, il comportamento dei workload cambia. L'utilizzo della CPU aumenta leggermente. I pattern di IO diventano più irregolari. Le finestre di elaborazione si restringono. Col tempo, queste piccole deviazioni si accumulano fino a diventare un rischio operativo.
Quando l'instabilità diventa visibile, porvi rimedio è spesso costoso e dirompente.
Cause comuni dell'instabilità dei workload Teradata
1. Crescita dei dati che altera i piani di esecuzione
La crescita dei dati è inevitabile, ma il suo impatto è raramente lineare.
Man mano che le tabelle crescono:
Le strategie di join cambiano
L'utilizzo dello spool aumenta
I costi di redistribuzione salgono
Il bilanciamento del carico tra gli AMP si sposta2
Query un tempo efficienti iniziano a consumare più CPU e IO anche se l'SQL in sé non è cambiato. Poiché la crescita è graduale, gli alert tradizionali basati su soglie raramente generano allarmi precoci.
2. Logica SQL in lenta evoluzione
I workload Teradata non sono statici.
Nel tempo:
Vengono introdotti join aggiuntivi
Vengono selezionati nuovi attributi
I filtri vengono allentati
I requisiti di reporting si ampliano
Ogni modifica sembra minima, ma nel complesso alterano le caratteristiche del workload. I job durano di più, consumano più risorse e diventano meno prevedibili.
Senza un'analisi storica, questi cambiamenti vengono spesso scoperti solo dopo le lamentele degli utenti o l'aumento dei costi.
3. Skew e cambiamenti nella distribuzione
Lo skew dei dati è una sfida ben nota in molti sistemi MPP come Teradata.
Lo skew può emergere a causa di:
Migrazioni di dati
Cambiamenti demografici
Crescita del business concentrata in segmenti specifici
Cambiamenti nelle ipotesi di modellazione dei dati
Con l'aumentare dello skew, la distribuzione del carico tra gli AMP diventa disomogenea. Alcuni AMP consumano una quota sproporzionata di CPU e IO, degradando le prestazioni complessive del sistema.
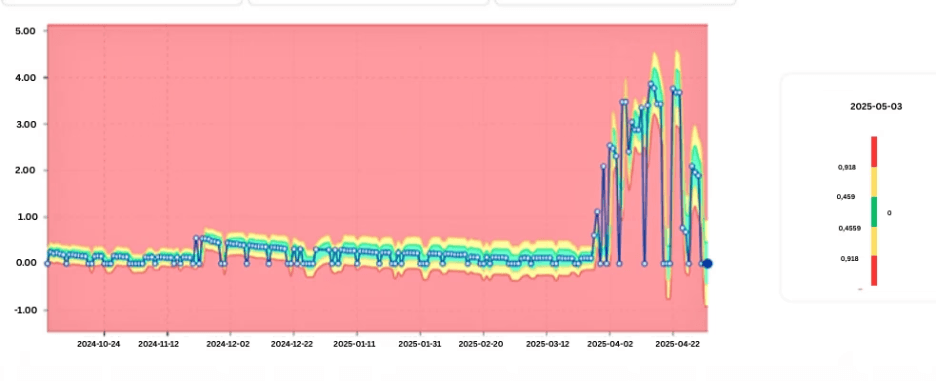
Visualizzazione dei dati che mostra lo skew della CPU a livello di AMP in aumento nel tempo.
4. Interventi su infrastruttura e configurazione
Anche i sistemi Teradata ben gestiti evolvono.
Cambiamenti come:
Aggiornamenti hardware
Riconfigurazione della piattaforma
Tuning del sistema
Prioritizzazione dei workload misti
possono influenzare in modo sottile il comportamento dei workload. Un job eseguito in modo costante per anni può mostrare all'improvviso una varianza maggiore, non a causa di problemi nei dati, ma perché è cambiato l'ambiente di esecuzione.
5. Elaborazioni cicliche e stagionali
Molti workload Teradata seguono cicli prevedibili:
Chiusura di fine mese
Reporting regolamentare
Riconciliazioni periodiche
Senza modellare esplicitamente la stagionalità, il normale comportamento ciclico può oscurare anomalie reali o generare alert inutili.
Distinguere la variazione attesa dalla vera instabilità richiede un contesto storico.
Perché il monitoraggio tradizionale di Teradata non coglie i segnali precoci
Gli ambienti Teradata vengono tipicamente monitorati con:
Alert su CPU e IO basati su soglie
Limiti sul tempo di esecuzione delle query
Dashboard sull'utilizzo del sistema
Questi strumenti sono efficaci nell'individuare i guasti acuti, ma faticano con i cambiamenti graduali.
Rispondono a domande come:
La CPU ha superato un limite?
Un job è fallito?
Non rispondono a:
Questo job sta diventando più costoso nel tempo?
Il suo comportamento sta diventando meno stabile?
Il workload di oggi è plausibile rispetto ai pattern storici?
L'instabilità si nasconde proprio in queste domande senza risposta.
Il ruolo dell'analisi delle serie temporali nelle operations Teradata
Il rilevamento precoce richiede di trattare le metriche dei workload come segnali di serie temporali, non come valori statici.
Le metriche Teradata principali includono:
CPU Time
IO Count
Utilizzo dello spool
Tempo di esecuzione delle query
Crescita delle tabelle
Analizzate nel tempo, queste metriche rivelano:
Trend di lungo periodo
Volatilità crescente
Cambiamenti strutturali successivi a deployment o migrazioni
Deviazioni rispetto alle norme stagionali
Questa prospettiva sposta il monitoraggio dei workload dalla risoluzione reattiva dei problemi al controllo proattivo.
Rilevare l'instabilità prima che diventi un problema
Apprendere il comportamento normale dei workload
Invece di definire soglie statiche, gli approcci moderni osservano il comportamento storico dei workload e apprendono che aspetto ha la “normalità” per ogni job, classe di query o componente di sistema.
Man mano che i pattern si stabilizzano, gli intervalli accettabili diventano più chiari. Le deviazioni da questi pattern appresi segnalano potenziali problemi, anche se i valori assoluti restano entro i limiti nominali.
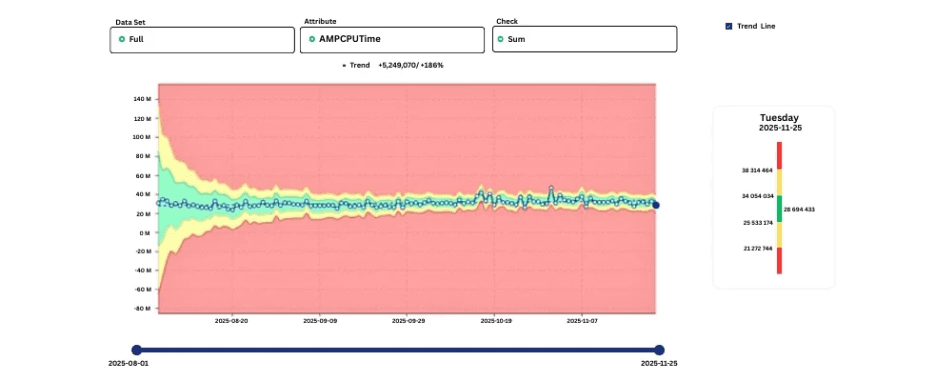
Grafico che mostra le bande di comportamento normale apprese e una deviazione emergente.
Individuare la deriva graduale
La deriva graduale è una delle forme di instabilità più costose.
Classificando i job in base a:
Aumento assoluto della CPU
Variazione relativa nel tempo
i team possono individuare rapidamente quali workload contribuiscono di più all'aumento del carico di sistema.
Questo consente un'ottimizzazione mirata invece di interventi di tuning generalizzati.
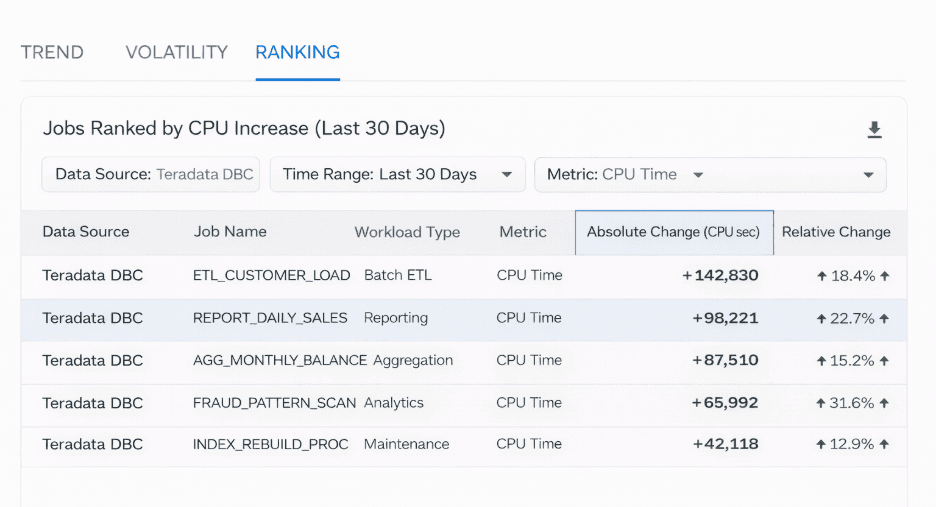
Elenco dei job classificati per aumento della CPU rispetto al mese precedente.
Misurare la volatilità
La stabilità non riguarda solo le medie.
I job con un consumo di CPU o IO molto variabile sono più difficili da pianificare e hanno maggiori probabilità di causare problemi a valle. Misurare la volatilità mette in evidenza i workload che si comportano in modo imprevedibile, anche quando il loro utilizzo medio sembra accettabile.
Tenere conto della stagionalità
Un rilevamento efficace tiene conto dei cicli noti.
Apprendendo i pattern settimanali e mensili, i sistemi evitano i falsi positivi pur restando sensibili alle deviazioni che rompono il comportamento consolidato.
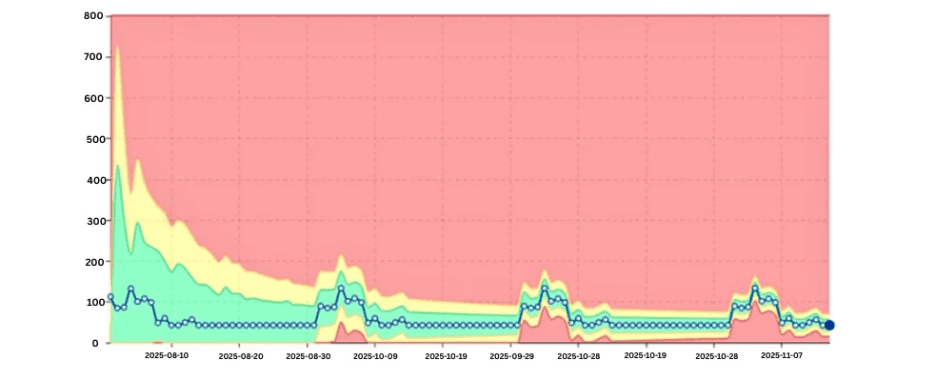
Trend della CPU che tiene conto della stagionalità e mostra i picchi attesi di fine mese.
Il ruolo di digna nell'analisi dei workload Teradata
Alcuni approcci di monitoraggio si basano sull'esportazione delle metriche verso sistemi esterni per l'analisi. Altri operano direttamente all'interno dell'ambiente del database.
digna legge le tabelle di sistema di Teradata (DBC) lasciando ai clienti la possibilità di definire come accede a queste fonti di metadati; le metriche dei workload vengono poi convertite in dati di serie temporali. Grazie a modelli basati sull'AI, apprende il comportamento normale e rileva le deviazioni statisticamente implausibili, che si tratti di picchi improvvisi o di una deriva lenta.
Poiché digna si concentra sul comportamento anziché su soglie statiche, aiuta i team a rilevare per tempo l'instabilità, prima che si trasformi in problemi di prestazioni o di costi.
Una panoramica di questo approccio basato sulle anomalie è disponibile qui, oppure potete prenotare una demo.
I vantaggi operativi del rilevamento precoce
Le organizzazioni che rilevano per tempo l'instabilità dei workload Teradata ottengono benefici misurabili:
Minore consumo di CPU e IO grazie a un'ottimizzazione tempestiva
Maggiore prevedibilità dei costi
Meno riunioni di escalation
Migliore collaborazione tra i team di piattaforma e di business
Maggiore fiducia nei risultati degli analytics
Soprattutto, la stabilità diventa gestibile anziché reattiva.
Guardando avanti: la stabilità come disciplina operativa
Poiché Teradata continua a supportare analytics e workload di AI mission-critical, la stabilità diventa una questione strategica.
La deriva silenziosa dei workload mina la fiducia, aumenta i costi e accresce il rischio operativo. Rilevare per tempo l'instabilità richiede:
Analisi delle serie temporali
Apprendimento comportamentale
Alerting consapevole del contesto
Overhead operativo minimo
In questo senso, la stabilità dei workload non è più solo una metrica di prestazione: è un elemento centrale dell'affidabilità dei dati aziendali.
Considerazioni finali
I workload Teradata non diventano instabili dall'oggi al domani. L'instabilità emerge gradualmente, spinta dalla crescita dei dati, dalle modifiche alla logica e dall'evoluzione delle condizioni di sistema.
I team che si affidano solo al monitoraggio statico rilevano i problemi troppo tardi. Quelli che analizzano il comportamento dei workload nel tempo possono intervenire per tempo, preservando sia le prestazioni sia la prevedibilità.
Man mano che gli ambienti Teradata continuano a evolvere, il rilevamento precoce dell'instabilità dei workload definirà la maturità operativa.
Guardate come lo fa digna nella pratica: monitoraggio della data quality per Teradata.
Domande frequenti
Perché i workload Teradata diventano instabili?
L'instabilità si accumula gradualmente invece di comparire dall'oggi al domani. Le cause tipiche sono la crescita dei dati che modifica i piani di esecuzione, la logica SQL che evolve di release in release, lo skew e i cambiamenti nella distribuzione, gli interventi su infrastruttura o configurazione e i picchi di elaborazione ciclici.
Quali sono i segnali precoci dell'instabilità di Teradata?
Piccoli spostamenti costanti: un aumento di AMPCPUTime per la stessa query, IO in crescita su un workload invariato, uno skew in aumento o un job che termina qualche minuto più tardi ogni notte. Presi singolarmente sembrano rumore, ed è per questo che di solito passano inosservati.
Perché il monitoraggio tradizionale di Teradata non coglie questi segnali?
Il monitoraggio basato su soglie scatta solo quando una metrica supera una linea fissa. Un workload può degradare per settimane restando entro la soglia ed essere comunque tecnicamente conforme, quindi l'alert arriva solo quando il danno è già visibile.
In che modo l'analisi delle serie temporali aiuta le operations Teradata?
Trattare ogni metrica come una serie anziché come un'istantanea consente di confrontare la giornata odierna con il comportamento normale per quel workload, inclusi i cicli settimanali e mensili, così che una deriva graduale diventi visibile quando c'è ancora tempo per agire.
L'instabilità dei workload può influire sulla data quality?
Sì, indirettamente. I job che durano di più spingono i caricamenti verso la finestra di reporting, e un caricamento in ritardo o completato solo in parte significa che i report vengono eseguiti su dati incompleti o non aggiornati.


