Analisi moderna dei workload su Teradata Vantage con digna: ottimizzazione guidata dall'AI per CPU, IO ed efficienza dei costi
|
7
min di lettura
Teradata Vantage resta una delle piattaforme più importanti per l'analisi aziendale su larga scala, perché è potente, scalabile e collaudata. Ma man mano che i workload diventano più complessi, i team si trovano davanti a una sfida costante:
Come monitorare in modo continuo CPU, IO, skew e andamento dei workload senza controlli manuali, decine di query SQL o interventi d'emergenza dopo gli incidenti?
È qui che digna porta un salto di qualità.
Leggendo le tabelle di sistema DBC di Teradata, trasformandole in metriche intelligenti sotto forma di serie temporali e applicando il rilevamento delle anomalie basato sull'AI, digna offre ai team di ingegneria una visione automatizzata e in tempo reale del comportamento dei workload, senza esportare dati e senza mantenere regole a mano.
Questo articolo spiega come digna potenzia il Workload Management di Teradata grazie all'AI, come rileva le anomalie di CPU e IO e come le organizzazioni possono usare digna per ridurre i rischi, migliorare la stabilità e abbassare i costi.
Perché digna è la scelta naturale per il monitoraggio dei workload Teradata
Teradata resta una delle piattaforme di analisi più stabili e affidabili. digna completa l'affidabilità di Teradata offrendo:
Apprendimento dei trend basato sull'AI
Nessuna soglia. Nessuna regola. digna impara automaticamente come appaiono valori "normali" di CPU, IO, perm usage e pattern dei workload.
Rilevamento delle anomalie in tempo reale
Non appena un job si discosta dai valori attesi, digna lo segnala, prima che diventi un problema per l'intero sistema.
Visibilità end-to-end sui workload
Tutti gli insight vengono generati all'interno di Teradata, utilizzando:
Tabelle DBC
AMPCPUTime
Istogrammi IO
Perm usage
Metriche di skew
Dati QryLog
Tabelle DBQL
Alert dove lavorano i team
Email, Slack, Jira e notifiche per modulo garantiscono che nessun problema passi inosservato.
Zero spostamento di dati
Tutti i calcoli vengono eseguiti all'interno del database: escono dal sistema solo le metriche.
Come digna impara il comportamento dei workload Teradata
digna inizia raccogliendo metriche operative direttamente da Teradata tramite query SQL eseguite nel vostro ambiente. Dal vostro sistema escono soltanto le metriche calcolate. Ma questo è solo l'inizio: la vera intelligenza entra in gioco quando digna trasforma questi segnali grezzi in profili di comportamento in continua evoluzione.
Invece di apprendere all'interno del database, digna invia queste metriche al digna AI Engine, dove i modelli si adattano continuamente al modo in cui il vostro sistema Teradata si comporta nel tempo. In questo modo digna comprende non solo i singoli punti dati, ma i pattern: come cresce la CPU durante la giornata lavorativa, come si comporta l'IO durante i batch notturni e come i workload oscillano nell'arco di settimane o mesi.
A differenza degli strumenti tradizionali per i workload, che richiedono la configurazione di regole, la piattaforma apprende automaticamente la stagionalità giornaliera, settimanale e mensile. Per esempio:
Un maggiore utilizzo della CPU ogni lunedì
Un carico IO aggiuntivo il 10 di ogni mese
Picchi di fine mese normali per la vostra organizzazione
Riconoscendo i ritmi operativi naturali della vostra organizzazione, digna distingue con precisione i cicli attesi dalle vere anomalie. È così che digna evita i falsi allarmi, concentra l'attenzione sulle deviazioni significative e vi offre una comprensione dello stato di salute dei workload che si adatta di continuo.
Apprendimento del trend di AMPCPUTime
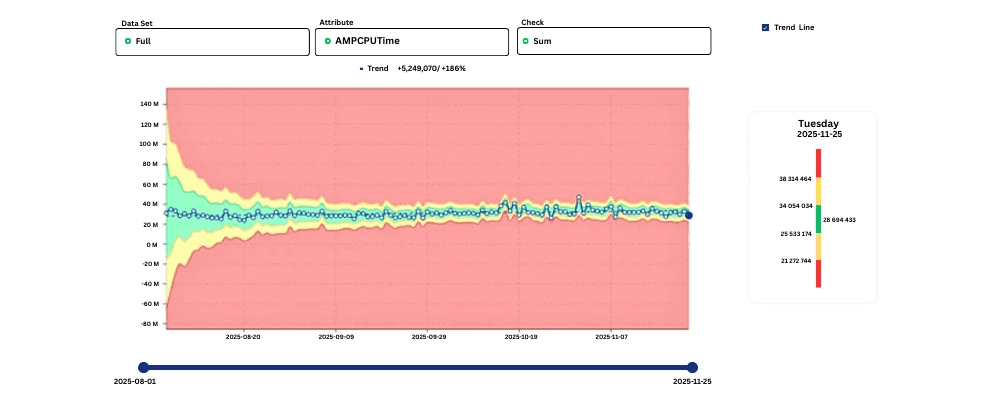
Uno degli esempi più significativi è il modo in cui digna apprende l'AMPCPUTime dell'intero sistema Teradata.
All'inizio l'intervallo accettato (verde) è ampio, perché digna sta ancora osservando la variabilità. Con il tempo, più il consumo è stabile, più l'area verde si restringe. Questa banda più stretta significa che digna sa esattamente come appare una CPU "sana" e può quindi segnalare le anomalie reali con grande precisione.
Valore chiave: digna riduce le escalation legate alla CPU e aiuta i team ad anticipare la crescita dei workload prima che causi incidenti.
Rilevare in anticipo gli outlier di IO
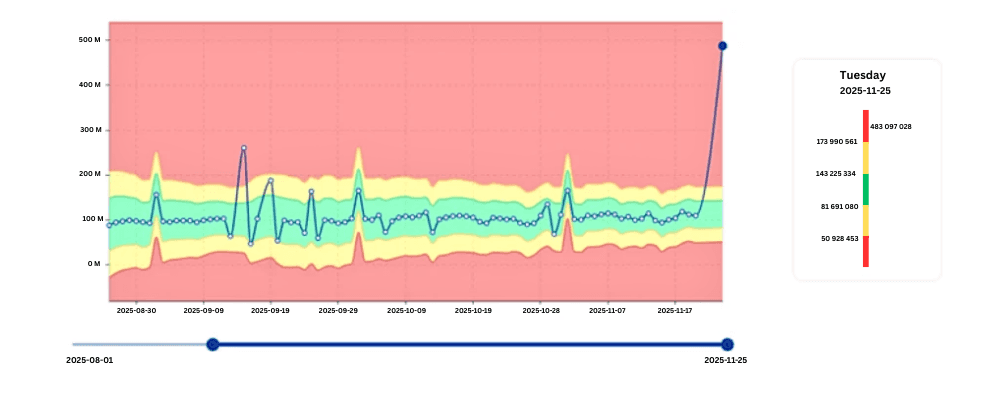
I picchi di IO sono tra i primi indicatori di workload problematici.
Nell'esempio qui riportato, digna individua un job che all'improvviso mostra un IO molto al di fuori del suo pattern normale, anche se la CPU può sembrare nella norma.
Questo rilevamento precoce permette ai team di indagare su:
Cambiamenti nella distribuzione dei dati
Scansioni di tabelle
Join sbilanciati (skewed)
Crescita inattesa dei dati
Logica dei workload non ottimizzata
Valore chiave: digna aiuta i team a evitare colli di bottiglia di IO che rallentano l'intero sistema.
Individuare i consumatori di CPU instabili
Non tutti i job si comportano in modo costante. Alcuni mostrano una volatilità inattesa nell'utilizzo della CPU che, nel tempo, porta all'instabilità del cluster.
L'immagine qui sotto mostra come digna evidenzia queste anomalie.
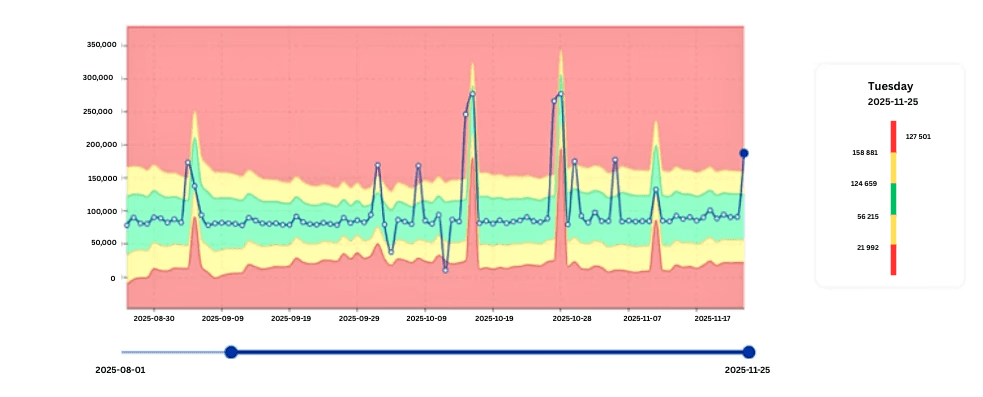
I workload con CPU volatile indicano spesso:
Piani di query inefficienti
Modifiche al modello dati
Ottimizzazioni sensibili ai parametri
Drift nelle dimensioni delle tabelle
Skew in join o aggregazioni
Con digna questi pattern vengono rilevati molto prima che diventino un incidente grave.
Valore chiave: digna fa emergere presto i workload rumorosi, consentendo un'ottimizzazione della CPU che riduce direttamente i costi di licenza e di infrastruttura.
Rilevare un'improvvisa instabilità della CPU nei job critici
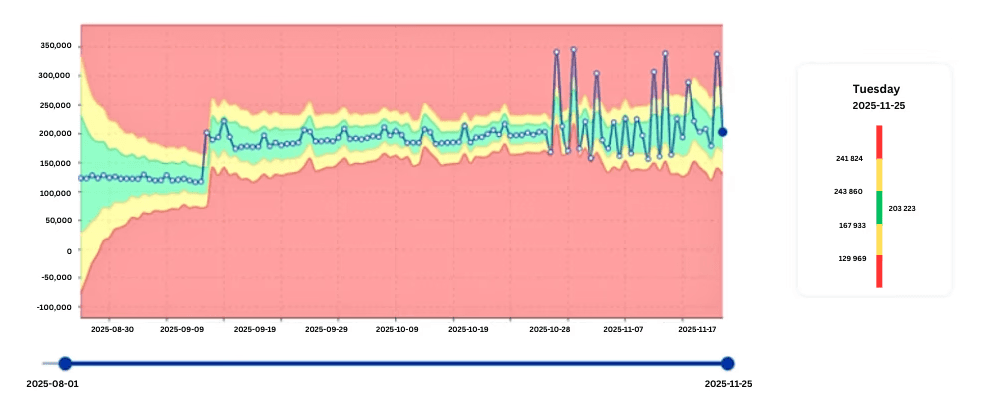
A volte il consumo di CPU resta stabile per mesi e poi, all'improvviso, diventa irregolare.
È proprio il tipo di workload che digna è progettata per intercettare.
Questi cambiamenti derivano spesso da:
Migrazioni di dati
Nuove demografie o distribuzioni
Modifiche alla logica ETL
Schema drift
Scarsa manutenzione degli indici
digna segnala immediatamente questi pattern, contrassegnando i workload interessati come ad alta priorità per l'analisi.
Impatto sul business: il rilevamento precoce previene i picchi di CPU che possono degradare le prestazioni per centinaia di utenti e workload.
Riconoscere e rispettare i pattern stagionali
Non tutti i picchi sono anomalie.
Alcuni workload cambiano in modo naturale:
Chiusura di fine mese
Cicli di fatturazione settimanali
Reportistica del lunedì
Caricamenti di dati a inizio trimestre
Aggregazioni di fine giornata
L'immagine mostra come digna apprende automaticamente i pattern stagionali.
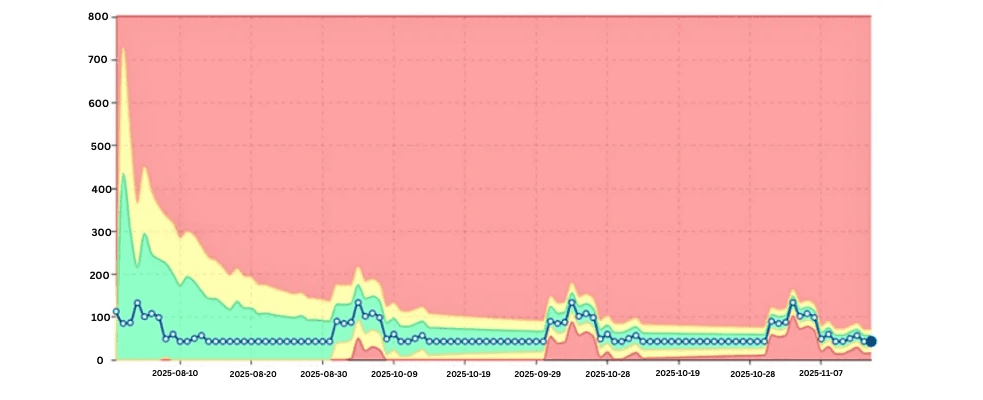
Invece di generare alert errati, digna comprende:
Quando determinati workload devono avere un picco
Quanto deve essere ripido il picco
Quali pattern si ripetono nel tempo
Valore chiave: digna elimina i falsi positivi distinguendo le anomalie dalla stagionalità naturale.
Monitorare la crescita del database con i trend di perm usage
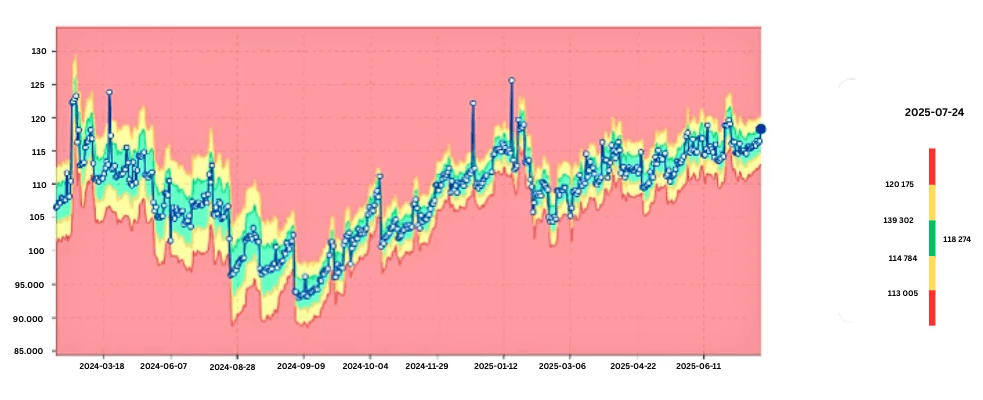
La perm usage è una metrica fondamentale per la gestione della capacità di Teradata. digna:
Apprende la normale traiettoria delle dimensioni
Segnala gli aumenti improvvisi
Individua una crescita anomala delle tabelle
Rileva i picchi di consumo dello storage
Questo aiuta a prevenire:
Errori di spazio
Full table scan inattesi
Workload ELT fuori controllo
Valore chiave: digna dà ai team il tempo di reagire prima che il consumo di storage incida sulle prestazioni.
Rilevamento dello skew: individuare una distribuzione non uniforme dei dati
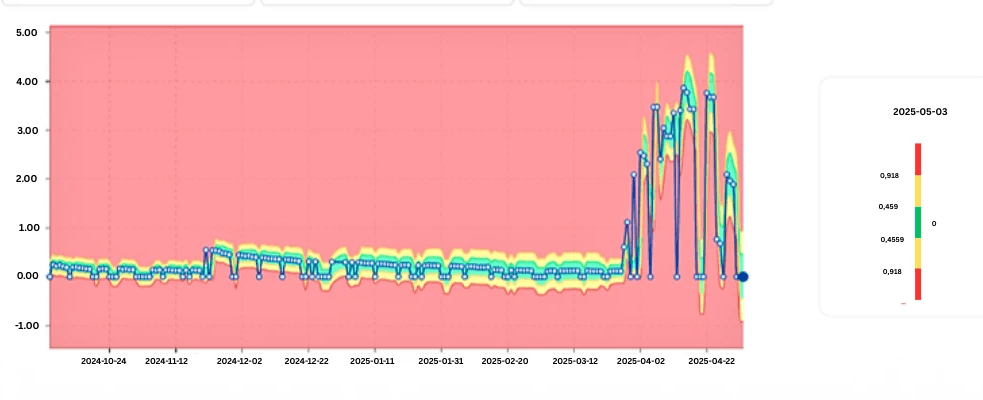
Lo skew è uno dei problemi di prestazioni più comuni, e più costosi, in Teradata.
Lo skew si verifica quando i dati non sono distribuiti in modo uniforme tra gli AMP, causando:
Colli di bottiglia
Cicli di CPU lunghi
Join lenti
Prestazioni incostanti
digna analizza automaticamente nel tempo i trend di skew per mostrare:
Quando una tabella diventa sbilanciata
Se lo skew sta peggiorando
Quali AMP sono interessati
Se modifiche recenti ai dati hanno causato nuovo skew
Valore chiave: digna individua con precisione il degrado legato allo skew prima che incida sulle prestazioni dell'intera piattaforma.
digna converte tutte le metriche DBC in serie temporali
È questo l'elemento abilitante di tutto ciò che è descritto sopra. Convertendo le metriche delle tabelle DBC in serie temporali, digna può:
Funzionalità AI
Apprendere i pattern della CPU
Rilevare le anomalie di IO
Modellare le fluttuazioni stagionali
Monitorare la volatilità a livello di job
Rilevare il lento drift dei dati
Monitorare la capacità del sistema nel lungo periodo
Funzionalità di observability
Confrontare i workload tra giorni diversi
Monitorare le variazioni delle prestazioni delle query
Fornire trend storici
Individuare le regressioni
Monitorare i pattern di crescita
Alerting e integrazioni
Email
Slack
Jira
Webhook
Notifiche a livello di modulo
Valore chiave: il motore di serie temporali di digna trasforma i metadati grezzi di Teradata in insight concreti.
L'impatto concreto: più stabilità, costi più bassi, meno escalation
In base a come i team usano digna oggi, la piattaforma offre:
Meno riunioni di escalation: perché le anomalie vengono rilevate prima che i problemi si aggravino.
Maggiore prevedibilità: workload stabili = utilizzo delle risorse prevedibile = controllo dei costi più semplice.
Minore consumo di CPU e IO: grazie all'individuazione precoce dei workload inefficienti.
Collaborazione più solida con i team di business: i problemi vengono risolti prima che gli utenti di business se ne accorgano.
Meno emergenze per i team di ingegneria: l'AI si occupa del monitoraggio, così il team può concentrarsi sulle attività ad alto valore.
Conclusione
Teradata Vantage costituisce la base per i dati e l'analisi aziendali. digna porta questa base a un livello superiore aggiungendo un layer di monitoraggio AI automatizzato che trasforma le metriche grezze di sistema in intelligence operativa in tempo reale.
Analizzando in modo continuo CPU, IO, skew, perm usage e comportamento dei job, digna consente ai team di ingegneria di:
Migliorare le prestazioni
Prevenire i downtime
Ridurre i costi cloud/on-prem
Lavorare in modo proattivo anziché reattivo
È la nuova generazione della Teradata Workload Analysis: guidata dall'AI, automatizzata e progettata per la scala enterprise.
Guardate la nostra demo e scoprite l'ottimizzazione guidata dall'AI per CPU, IO ed efficienza dei costi nel vostro ambiente Teradata, oppure contattateci.
Vedete come digna lo fa nella pratica: data quality per Teradata.
Domande frequenti
Che cos'è l'analisi dei workload Teradata?
L'analisi dei workload Teradata consiste nel monitorare nel tempo come le query consumano CPU, IO, spool e spazio permanente, così da individuare inefficienze e instabilità prima che violino gli SLA. L'analisi tradizionale è reattiva; digna apprende il pattern normale e segnala le deviazioni da esso.
Quali metriche di Teradata analizza digna?
digna legge le metriche dalle tabelle DBC, tra cui AMPCPUTime, IO, skew e utilizzo dello spazio perm, e le converte in serie temporali, in modo che ogni metrica possa essere confrontata con la propria baseline appresa.
Come rileva digna lo skew in Teradata?
Lo skew si manifesta come una distribuzione non uniforme del lavoro tra gli AMP. Poiché digna monitora la distribuzione nel tempo e non in un singolo istante, può segnalare il momento in cui una tabella o un workload ha iniziato a distribuirsi in modo diverso.
Il monitoraggio dei workload Teradata richiede di spostare i dati fuori dal sistema?
No. L'analisi viene eseguita sulle metriche all'interno dell'ambiente Teradata, quindi nulla viene copiato in una piattaforma esterna per essere esaminato.
In che cosa l'analisi dei workload è diversa dal monitoraggio della data quality?
L'analisi dei workload osserva come il sistema esegue il lavoro: CPU, IO, skew e spazio. Il monitoraggio della data quality osserva i dati stessi: volumi, valori, tempi di arrivo e schemi. Un sistema Teradata può essere perfettamente ottimizzato mentre i dati al suo interno sono errati, ed è per questo che la maggior parte dei team ha bisogno di entrambi.


