Ottimizzazione delle query SQL: una guida diagnostica per il 2026
|
6
min di lettura

La query sembrava innocua quando è arrivata nella revisione del mattino. La settimana scorsa funzionava bene, poi dopo pranzo una dashboard è andata in timeout, e il primo istinto è ancora lo stesso: dare la colpa al testo SQL, aggiungere un indice e sperare che il problema sparisca. Questo approccio fa perdere tempo, perché l'ottimizzazione delle query SQL è di solito un problema di diagnosi, non un gioco di ipotesi, e il database contiene già gli indizi se sapete dove cercarli.
Indice
Oltre le congetture: perché l'ottimizzazione SQL è una scienza
Trovare il colpevole: gli anti-pattern più comuni nelle query
Scegliere gli strumenti: strategie di indicizzazione e partizionamento
Quando le buone query vanno male: statistiche e hint dell'optimizer
Dalla gestione delle emergenze alla prevenzione: un workflow di ottimizzazione continua
Oltre le congetture: perché l'ottimizzazione SQL è una scienza
Un report lento di solito crea un falso senso di urgenza attorno al livello sbagliato. Un ingegnere fissa l'SQL, un altro vuole un nuovo indice e un terzo inizia a modificare le impostazioni perché la produzione è rumorosa. La mossa migliore è trattare il problema come un'indagine, perché l'optimizer prende già le sue decisioni in base alla distribuzione dei dati, alla forma del piano e alle evidenze di runtime, non in base a sensazioni o abitudini.
Partire dal processo decisionale reale del database
Gli optimizer moderni non sono manuali di regole con qualche scorciatoia aggiunta. Riscrivono l'SQL in un piano logico, enumerano i piani candidati, stimano la selettività dei predicati e le cardinalità dei join, quindi scelgono la strategia fisica più economica tra alternative come i nested loop o i sort-merge join, come mostrato in una panoramica sulla riscrittura delle query e sull'enumerazione dei piani tratta dal materiale delle lezioni sugli optimizer. Questo conta perché un'istruzione che sembra semplice può comunque essere costosa se il motore valuta male il numero di righe o sceglie il percorso di accesso sbagliato.
Regola pratica: se non sapete spiegare perché l'optimizer ha scelto un piano, non state ancora facendo tuning, state ancora osservando.
Un utile cambio di mentalità è smettere di chiedersi “Che cosa c'è di sbagliato in questa query?” e iniziare a chiedersi “Quale stima o ipotesi è venuta meno?”. La documentazione di Microsoft sulle statistiche le descrive come metadati basati su BLOB usati per stimare la cardinalità, cioè il numero di righe che una query restituirà, che a sua volta orienta scelte come un index seek rispetto a un index scan quando quest'ultimo è più economico nella documentazione sulle statistiche di SQL Server. I metadati per la selezione dei piani di InterSystems aggiungono gli ingredienti pratici alla base di queste stime, tra cui numero di righe, selettività dei campi, dimensione media dei campi, selettività degli outlier e istogrammi nella sua documentazione sull'optimizer.
Ecco perché il tuning peggiora quando i team si fidano troppo a lungo dell'ultimo piano buono. Quando la distribuzione dei dati cambia e le statistiche diventano obsolete, l'optimizer può iniziare a fare scelte costose che sembravano ragionevoli con le ipotesi precedenti. La risposta giusta sono le evidenze, non la superstizione, e la via più breve verso quelle evidenze è un workflow diagnostico ripetibile. Tengo a portata di mano una risorsa come il riconoscimento statistico dei pattern quando voglio che il team ragioni per pattern, non per aneddoti.
Leggere i segnali: scomporre il piano di esecuzione

Il piano di esecuzione è il punto in cui il database si tradisce. Mostra come si muovono le righe, dove avvengono i filtri, quali join vengono scelti e dove il motore ritiene che si concentri il costo. Se siete alle prime armi con la lettura dei piani, partite dagli operatori che toccano più dati, non dalle parti più belle del diagramma.
Seguire le righe, non la sintassi
Un ciclo pratico per una query lenta è semplice. Acquisite la query con i suoi parametri reali, eseguite EXPLAIN ANALYZE, individuate il nodo collo di bottiglia nell'albero di esecuzione, apportate esattamente una modifica, aggiornate le statistiche con ANALYZE, quindi rieseguite e confrontate il nuovo piano con quello precedente come descritto nel workflow di tuning. La regola della singola modifica è importante perché evita attribuzioni errate. Se riscrivete il predicato e aggiungete un indice nello stesso passaggio, non saprete mai quale modifica ha fatto la differenza.
I campanelli d'allarme più rapidi di solito sono evidenti, una volta che sapete che cosa cercare. Una Table Scan dove vi aspettavate un Index Seek significa che il motore ha deciso che leggere l'intera struttura era più economico che usare l'indice. Un join Nested Loops su input di grandi dimensioni può andare bene per un risultato esterno molto piccolo, ma diventa pesante quando il motore deve ripetere molte volte il lavoro interno. Il piano è anche il punto in cui si individuano gli scarti tra righe stimate ed effettive, che spesso indicano direttamente un problema di cardinalità più che un problema di formattazione dell'SQL.
Leggere il piano come una mappa dei costi
Ecco il pattern che cerco nella pratica:
Grande flusso di righe all'inizio: se il primo operatore restituisce molte più righe del previsto, il filtro non è abbastanza selettivo oppure le statistiche mentono.
Ramo di join ad alto costo: se un ramo del join domina il piano, l'ordine dei join potrebbe essere sbagliato o la chiave di join potrebbe non essere indicizzata in modo utile.
Icone di avviso o conversioni: le conversioni implicite e le statistiche mancanti spesso spiegano perché un'istruzione apparentemente corretta si comporta male.
Scansioni non necessarie di tabelle larghe: le letture di tabelle larghe sono spesso la tassa nascosta quando la query ha bisogno solo di poche colonne.
Gli strumenti di runtime aiutano a confermare che il piano non mente. Le indicazioni di tuning orientate a Microsoft evidenziano SET STATISTICS IO come strumento diagnostico fondamentale, perché espone scan count, logical reads, physical reads, read-ahead reads e le varianti LOB, così da poter quantificare direttamente il costo di I/O nella guida al tuning di SQL Server di Red Gate. La stessa abitudine di partire dalle evidenze si ritrova negli ecosistemi PostgreSQL con pg_stat_statements, che fa emergere il numero di esecuzioni e l'attività basata sui tempi per classificare i carichi di lavoro.
Se avete bisogno di un modo strutturato per correlare il comportamento delle query con segnali di sistema più ampi, vale la pena integrare nello stesso ciclo di revisione le tecniche di monitoraggio e auditing dei database. Un piano da solo vi dice che cosa voleva fare l'optimizer, ma le metriche di runtime vi dicono quanto ha pagato il motore.
Trovare il colpevole: gli anti-pattern più comuni nelle query
A volte il problema è il testo della query, non l'indice. Vedo team passare ore a discutere della disposizione dello storage quando il problema di fondo è che l'SQL stesso impedisce all'optimizer di usare il percorso di accesso che vorrebbe. I risultati più rapidi arrivano di solito eliminando il lavoro superfluo prima di toccare il design dello schema.
Correggere le strutture che impongono lavoro costoso
SELECT * è il classico errore da principiante, ma compare ancora in codebase mature perché sembra innocuo. Non lo è quando la query ha bisogno solo di poche colonne, perché il motore potrebbe leggere e spostare molti più dati di quelli usati dal passaggio successivo. Una proiezione più ristretta riduce la pressione sull'I/O e alleggerisce il lavoro dell'operatore successivo.
Le funzioni nelle clausole WHERE creano un freno di tipo diverso. Un filtro come WHERE DATE(order_date) = '2026-01-01' trasforma la colonna prima del confronto, il che può impedire l'uso diretto dell'indice perché il motore non riesce ad applicare in modo pulito il predicato ai valori memorizzati. La soluzione è scrivere la condizione in modo che la colonna resti a sinistra in una forma comprensibile per l'indice.
Filtrare presto e ridurre la quantità di dati che scorre a valle resta uno dei modi più puliti per aiutare l'optimizer a lavorare meno.
Attenzione alle query che nascondono un'elaborazione riga per riga
Le subquery correlate possono sembrare eleganti e comportarsi comunque come un ciclo riga per riga quando l'optimizer non riesce ad appiattirle bene. Non sempre è un bug, ma spesso si traduce in lavoro ripetuto che un join o un passaggio di pre-aggregazione potrebbe evitare. Anche UNION può essere più pesante di quanto si pensi, perché deve garantire l'unicità, mentre UNION ALL evita questo costo aggiuntivo di deduplicazione quando i duplicati non sono un problema.
Le indicazioni di Tinybird per un SQL più veloce sottolineano l'ordine utile filtrare, unire, aggregare e descrivono le letture sequenziali come notevolmente più veloci dei pattern di accesso casuale nelle sue regole sulle prestazioni SQL. È questa la ragione meccanica per cui una struttura favorevole ai predicati è importante. Se la query può eliminare presto le righe, ogni passaggio successivo diventa più economico.
Una semplice riscrittura spesso rende evidente la differenza:
Struttura più lenta | Struttura migliore |
|---|---|
|
|
|
|
Subquery correlata ripetuta per ogni riga | Join o pre-aggregazione eseguiti una sola volta |
Quando struttura della query e indicizzazione devono essere valutate insieme, costruire modelli di dati affidabili diventa rilevante, perché lo stesso design delle tabelle che supporta in modo pulito l'analytics può anche rendere filtri e join più facili da interpretare per l'optimizer. Uso questo link come promemoria del fatto che le prestazioni SQL sono spesso un problema di modellazione travestito da problema di query.
Scegliere gli strumenti: strategie di indicizzazione e partizionamento
L'indicizzazione cambia il modo in cui il motore trova le righe, ma cambia anche la quantità di lavoro che ogni scrittura deve svolgere. È per questo compromesso che un nuovo indice non è la risposta predefinita a una query lenta. La scelta giusta dipende dai pattern di lettura, dal volume di scritture e dal fatto che l'optimizer disponga già di un piano sufficientemente efficiente.
Adattare il percorso di accesso alla domanda
Un indice clustered cambia il modo in cui i dati sono organizzati fisicamente, mentre un indice non-clustered aggiunge un percorso di ricerca separato. Un covering index può essere migliore per le query con molte letture, perché contiene le colonne di cui la query ha bisogno ed evita ricerche aggiuntive nella tabella. Questo conta soprattutto quando le stesse colonne filtrate vengono interrogate ripetutamente da dashboard, chiamate API o report pianificati.
Il lato dei costi è facile da ignorare finché la tabella non inizia a cambiare spesso. Ogni nuovo indice aggiunge lavoro a insert, update e delete, e questo overhead emerge rapidamente sulle tabelle con molte scritture. La vera domanda non è se una query può usare un indice, ma se quell'indice si guadagna il suo posto sull'intero carico di lavoro.
Un modello di costo è utile solo quando le sue statistiche sono aggiornate. Le indicazioni di Microsoft nella documentazione sulle statistiche di SQL Server spiegano che l'optimizer usa le statistiche per stimare la cardinalità e selezionare i percorsi di accesso, e che statistiche obsolete o mancanti possono spingerlo verso scelte sbagliate quando la distribuzione dei dati cambia. Anche costruire modelli di dati affidabili conta in questo caso, perché un layout delle tabelle che corrisponde alla struttura delle query fornisce all'optimizer segnali più chiari e riduce la probabilità che un buon indice venga ignorato.
Usare il partizionamento quando il nemico è la scansione
Il partizionamento conta quando la tabella è così grande che il problema è leggere tutto. Le tabelle di serie temporali e le query basate su intervalli sono il caso più evidente, perché il partition pruning può evitare che il motore scansioni dati al di fuori della porzione attiva. In un cloud data warehouse o in un motore di tipo lakehouse, questo spesso conta più che limare qualche millisecondo da un singolo join.
Il contesto della piattaforma cambia i compromessi. Negli ambienti gestiti, calcolo e storage non si comportano come in un classico RDBMS a nodo singolo, quindi la vecchia abitudine di aggiungere indici ovunque può essere uno spreco di energie o perfino ridurre il throughput. Se dovete decidere se ottimizzare l'SQL, il layout delle tabelle o le policy sui carichi di lavoro, le best practice di gestione dei database aiutano a inquadrare il lato operativo, mentre il design fisico deve comunque essere guidato dal pattern di accesso.
Indirizzo i team anche verso servizi professionali di gestione dei database quando indicizzazione, revisione operativa e regressioni ricorrenti richiedono attenzione tutte insieme. Il tuning delle query raramente resta isolato una volta che il traffico di produzione inizia a cambiare, e l'obiettivo è sempre ridurre la quantità di dati elaborati a valle, non far sembrare brillante una singola istruzione.
Quando le buone query vanno male: statistiche e hint dell'optimizer
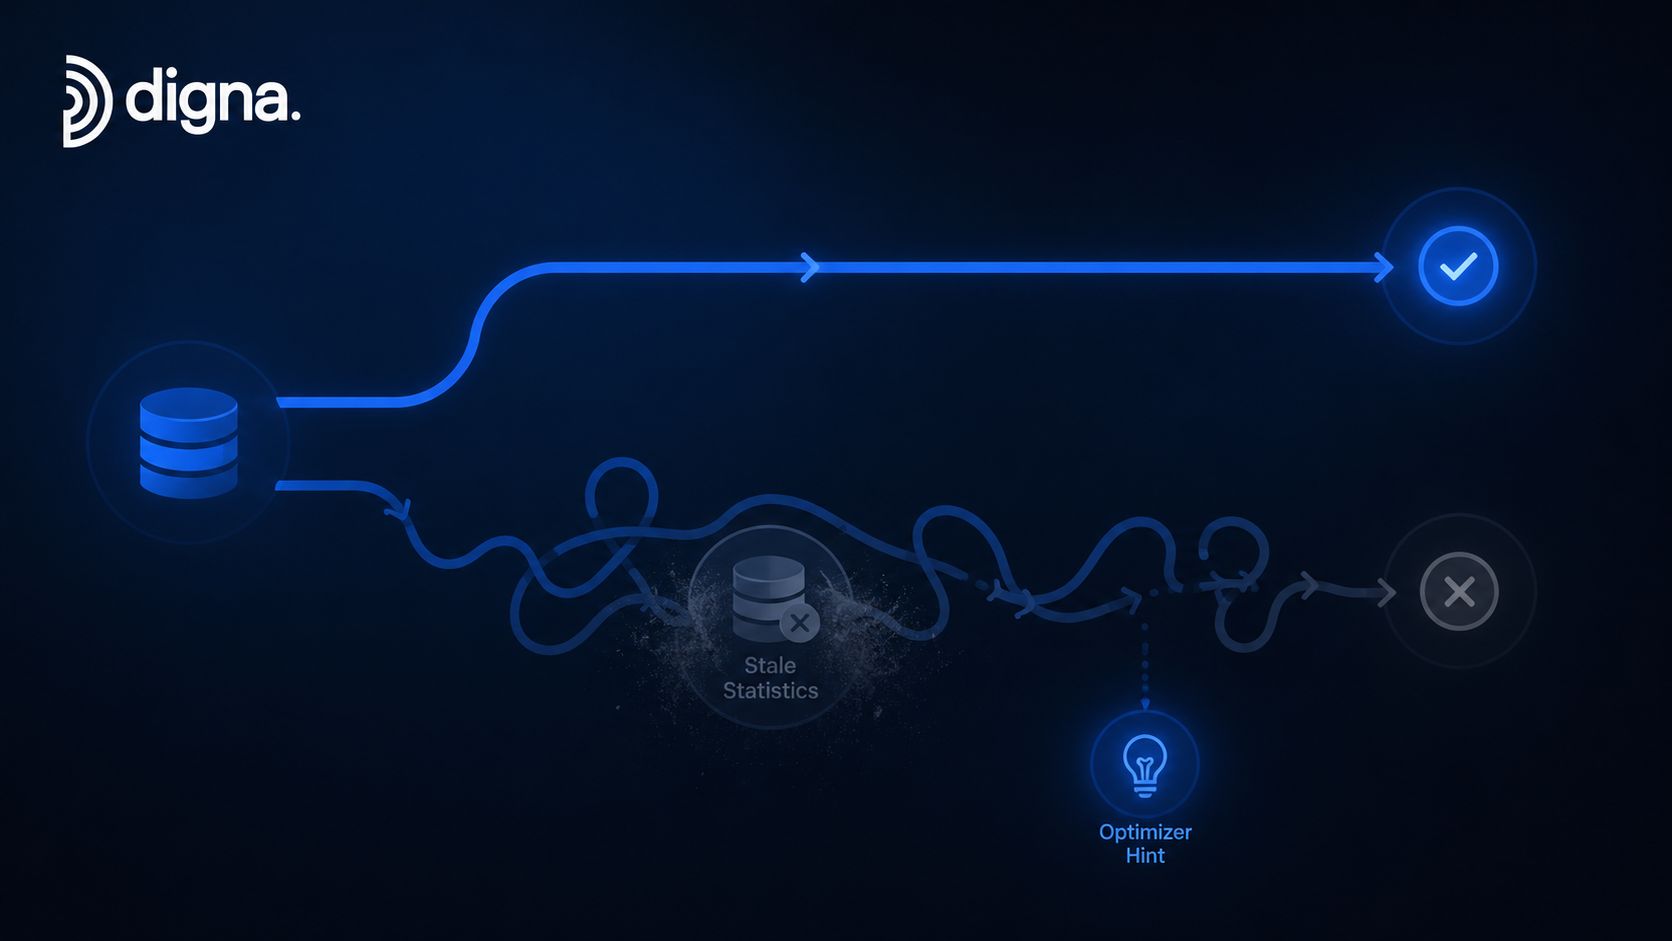
Una query pulita può comunque funzionare male. È la parte che molti team faticano ad accettare, perché è rassicurante credere che un SQL ordinato garantisca un buon piano. In realtà, l'optimizer funziona bene solo quanto i suoi metadati, e gli errori di cardinalità possono mandarlo nella direzione sbagliata.
Le statistiche obsolete possono sabotare un buon piano
La stima della cardinalità è uno dei principali colli di bottiglia nell'ottimizzazione delle query. Un'indagine sugli optimizer dei DBMS descrive stima della cardinalità, modellazione dei costi ed enumerazione dei piani come i tre componenti fondamentali, e spiega che gli errori di selettività possono propagarsi a cascata in ordini di join sbagliati e operatori fisici errati nell'indagine sugli optimizer dei DBMS. Questo effetto a cascata è il motivo per cui un filtro dall'aspetto semplice può comunque produrre tempi di esecuzione pessimi.
La soluzione pratica non è misteriosa. Aggiornate regolarmente le statistiche, soprattutto dopo una crescita dei dati, cambiamenti nelle distribuzioni o caricamenti massivi. Se l'optimizer dispone di istogrammi e conteggi di righe aggiornati, può stimare con maggiore precisione le dimensioni intermedie e scegliere operatori migliori. Altrimenti, gli state chiedendo di prendere una decisione basata sui costi con fatti obsoleti.
È anche per questo che gli hint dell'optimizer vanno tenuti ai margini della cassetta degli attrezzi, non al centro. Un hint può forzare l'ordine dei join o il percorso di accesso quando l'optimizer sbaglia ripetutamente su un carico di lavoro noto, ma può anche cristallizzare nel codice un'ipotesi sbagliata. Usateli solo dopo aver controllato il piano, confermato il pattern dei dati e deciso che il controllo manuale è giustificato.
Regola pratica: gli hint sono un meccanismo di correzione, non una strategia di tuning.
Il workflow della sezione precedente vale anche qui. Cambiate una cosa, aggiornate le statistiche, rieseguite e confrontate. Se il piano sbagliato scompare dopo ANALYZE, il problema era la freschezza dei metadati, non la struttura della query. Altrimenti, avete imparato qualcosa di utile sul confine decisionale del motore, ed è meglio che aggiungere un indice alla cieca.
Dalla gestione delle emergenze alla prevenzione: un workflow di ottimizzazione continua
I team che smettono di inseguire sempre la stessa query lenta di solito integrano un ciclo di feedback nella piattaforma. Non aspettano che una dashboard fallisca prima di verificare se un carico di lavoro è cambiato. Tengono d'occhio le istruzioni più costose, confrontano i tempi di esecuzione nel tempo e trattano le regressioni come qualcosa da intercettare presto anziché da recuperare tardi.
Rendere le evidenze di runtime parte della routine
Il tuning moderno dipende da ciò che il motore ha fatto, non da ciò che il piano prometteva. SET STATISTICS IO di SQL Server espone logical reads, physical reads, scan count e i relativi dettagli di I/O. In PostgreSQL, pg_stat_statements fa emergere il numero di esecuzioni e i segnali di tempo che aiutano a classificare i carichi di lavoro più costosi. Per una visione più ampia di come tutto questo si inserisce nelle operazioni continuative sui database, la discussione sui servizi professionali di gestione dei database è utile, perché la stessa disciplina si applica sia quando il collo di bottiglia è una singola query sia quando si tratta di un cambiamento più ampio del carico di lavoro. Sono queste evidenze a fare la differenza tra “sembra lenta” e “questa istruzione è quella che consuma più risorse”.
Un modello operativo pratico si presenta così:
Controllate regolarmente le query più pesanti: esaminate le query più costose invece di aspettare i reclami degli utenti.
Confrontate con il comportamento precedente: se un'istruzione che era stabile inizia a peggiorare, trattatelo come un segnale di regressione.
Verificate il livello prima di modificare il codice: chiedetevi se il problema riguarda la struttura dell'SQL, la freschezza delle statistiche, la pressione sulla memoria o il riutilizzo dei piani.
Mantenete piccole le modifiche: una riscrittura, una decisione sugli indici o un aggiornamento delle statistiche per ogni ciclo rende il risultato interpretabile.
In questo contesto le piattaforme di observability dimostrano il loro valore. Un sistema come digna può far parte della stessa conversazione operativa del monitoraggio dei carichi di lavoro e della qualità, perché le regressioni delle query spesso si manifestano come sintomi della piattaforma molto prima che qualcuno apra un ticket. Se il team utilizza già un processo più ampio di data operations, l'approccio di monitoraggio di digna si affianca in modo naturale alla revisione a livello di query, ed è più facile mantenere disciplinato il tuning quando tutti i segnali si trovano in un unico posto.
Lo scopo non è trasformare ogni ingegnere in un archeologo delle query. Lo scopo è rendere le query lente visibili, spiegabili e correggibili in modo ripetibile. Una volta che la piattaforma fa emergere le evidenze giuste, l'ottimizzazione delle query SQL smette di essere una corsa affannosa e diventa parte della normale pratica di data engineering.
Se il vostro team insegue ancora le query lente a istinto, visitate digna e guardate come il monitoraggio in-database può far emergere i cambiamenti nei carichi di lavoro prima che gli utenti se ne accorgano. Lo stesso approccio basato sulle evidenze che aiuta nel tuning delle query aiuta anche i team a tenere prestazioni, affidabilità e visibilità operativa in un unico posto.
Domande frequenti
Quale domanda dovrebbe sostituire "che cosa c'è di sbagliato in questa query?"
"Quale stima o ipotesi è venuta meno?" Gli optimizer moderni non sono manuali di regole con qualche scorciatoia aggiunta, quindi il tuning inizia individuando la stima che ha portato l'optimizer in una direzione poco utile.
Quando state davvero facendo tuning invece di limitarvi a osservare?
Quando sapete spiegare perché l'optimizer ha scelto un piano. Fino ad allora state guardando una query lenta invece di diagnosticarla, e qualsiasi modifica è un'ipotesi su una decisione che non avete compreso.
Che ruolo hanno le statistiche?
Sono loro a guidare il piano. La documentazione di Microsoft descrive le statistiche come metadati basati su BLOB usati per stimare la cardinalità, cioè il numero di righe che una query restituirà, che a sua volta orienta scelte come un index seek rispetto a un index scan quando la scansione è più economica.
Perché il tuning peggiora nel tempo?
Perché i team si fidano troppo a lungo dell'ultimo piano buono. Volume e distribuzione dei dati cambiano sotto un piano che era corretto quando è stato scelto, e l'ipotesi che lo rendeva veloce smette silenziosamente di valere.
Perché un report lento crea urgenza attorno al livello sbagliato?
Perché il sintomo compare dove si trovano gli utenti. Il report è la superficie visibile, quindi l'attenzione si concentra lì, mentre la stima errata che ha prodotto il piano si trova diversi livelli più in basso.


