Ottimizzazione delle prestazioni del database: padroneggiate il vostro sistema
|
8
min di lettura
Il vostro dashboard non ha smesso di funzionare all'improvviso. È diventato un po' più lento ogni settimana. Un report finanziario che prima si caricava all'istante ora si blocca nelle ore di punta. Un refresh di BI inizia a sforare la sua finestra. Una pipeline di feature per il ML continua a girare, ma il profilo dei dati alla base è cambiato quanto basta perché i piani di esecuzione non si comportino più come quando avete ottimizzato il sistema l'ultima volta.
È proprio lì che si trovano molti team in questo momento. Trattano l'ottimizzazione delle prestazioni del database come un esercizio sulle query lente, mentre il vero problema è la deriva. Non solo la deriva del carico di lavoro, ma la deriva dei dati. Il numero di righe cambia, le distribuzioni si sbilanciano, un campo nullable inizia ad arrivare con nuovi pattern, un aggiornamento di schema passa inosservato e la baseline di cui vi fidavate smette di descrivere la realtà.
L'ottimizzazione tradizionale conta ancora. Servono ancora piani di esecuzione, revisioni degli indici, impostazioni della memoria e rollback disciplinati. Ma l'ottimizzazione statica è incompleta nei sistemi in cui la forma dei dati cambia ogni giorno.
Indice
Oltre le query lente: la vera origine dei problemi di prestazioni
Definire una baseline: come misurare e diagnosticare i problemi
Dare priorità agli hotspot per ottenere i risultati migliori
Oltre le query lente: la vera origine dei problemi di prestazioni
La maggior parte degli incidenti di prestazioni non inizia con una singola query palesemente difettosa. Inizia con un sistema che diventa meno prevedibile. Un dashboard è veloce al mattino e irregolare a mezzogiorno. Un job di warehouse che rientrava comodamente nella sua finestra batch inizia a scontrarsi con altri carichi di lavoro. Nessuno ha modificato l'SQL ieri, eppure gli utenti percepiscono comunque il peggioramento.
Il vecchio manuale dice di trovare la query più lenta e ottimizzarla. Ha ancora valore, ma trascura una categoria crescente di problemi in cui l'SQL è solo il sintomo. Analisi recenti mostrano che il 68% del degrado delle prestazioni dei database nel 2024–2025 non deriva dall'inefficienza delle query, ma da problemi di qualità dei dati a monte che alterano inaspettatamente i pattern di accesso, eppure solo il 12% dei contenuti sull'ottimizzazione collega le metriche di osservabilità al tuning delle prestazioni, secondo l'analisi di Last9 sull'ottimizzazione delle prestazioni dei database.
Perché i sistemi stabili diventano instabili
Una query può essere perfettamente ragionevole per la forma dei dati del mese scorso e inadatta a quella di oggi. PostgreSQL è un buon esempio. Una tabella può accumulare modifiche, l'autovacuum resta indietro, il bloat cresce e quella che sembrava una scansione modesta si trasforma in un pessimo comportamento di I/O. I team SQL Server osservano una deriva simile nella contesa su tempdb e nella scelta dei piani al variare dei pattern di carico. Gli ambienti Teradata possono sembrare sani a livello di sistema mentre una classe di workload cambia in modo impercettibile, quanto basta per distorcere code e tempi di risposta.
L'ottimizzazione statica presuppone che i dati restino simili. I sistemi di produzione raramente rispettano questa ipotesi.
Ecco perché l'ottimizzazione delle prestazioni del database richiede una prospettiva più ampia. Non gestite soltanto il testo delle query e le impostazioni del motore. Gestite le condizioni in cui quelle query vengono eseguite.
Un modo pratico di vederla è questo:
SQL lento spesso significa percorsi di accesso inefficienti, join errati, statistiche obsolete o letture eccessive.
Deriva delle prestazioni spesso significa che il carico di lavoro è cambiato perché sono cambiati i dati.
L'impatto sul business si manifesta prima in report non aggiornati, dashboard in ritardo e output dei modelli meno affidabili.
I team che lavorano sulle prestazioni full-stack per sviluppatori sanno già che la latenza di solito coinvolge più livelli. Il lavoro sul database non fa eccezione. Se un caricamento a monte introduce record duplicati, sposta la cardinalità o cambia il pattern di arrivo dei dati freschi, il vostro piano di esecuzione può degradarsi anche quando il codice applicativo è intatto.
La falla nascosta nella maggior parte dei processi di ottimizzazione
Le baseline tradizionali sono spesso istantanee. Catturano un periodo buono, magari uno cattivo, e poi li confrontano. È utile, ma non vi dice quando la baseline stessa non è più affidabile perché schema, volume, freschezza o distribuzione sono andati alla deriva.
È in questo divario che si annidano molti incidenti ricorrenti. Il database non è peggiorato all'improvviso. L'ambiente intorno a esso è cambiato, e il team ha continuato a ottimizzare sulla base di un quadro superato.
Definire una baseline: come misurare e diagnosticare i problemi
L'ottimizzazione delle prestazioni del database parte dalle evidenze. Se non sapete descrivere lo stato normale del sistema, non potete capire se una modifica ha migliorato qualcosa o ha solo spostato il problema altrove.
Il flusso di lavoro di base non è cambiato, perché funziona. Il ciclo "misurare, analizzare, ottimizzare, validare" è lo standard universale e richiede di registrare latenza, throughput e utilizzo delle risorse prima di qualsiasi ottimizzazione, così da validare le modifiche rispetto a una baseline, come illustrato in questa panoramica del ciclo di ottimizzazione delle prestazioni.
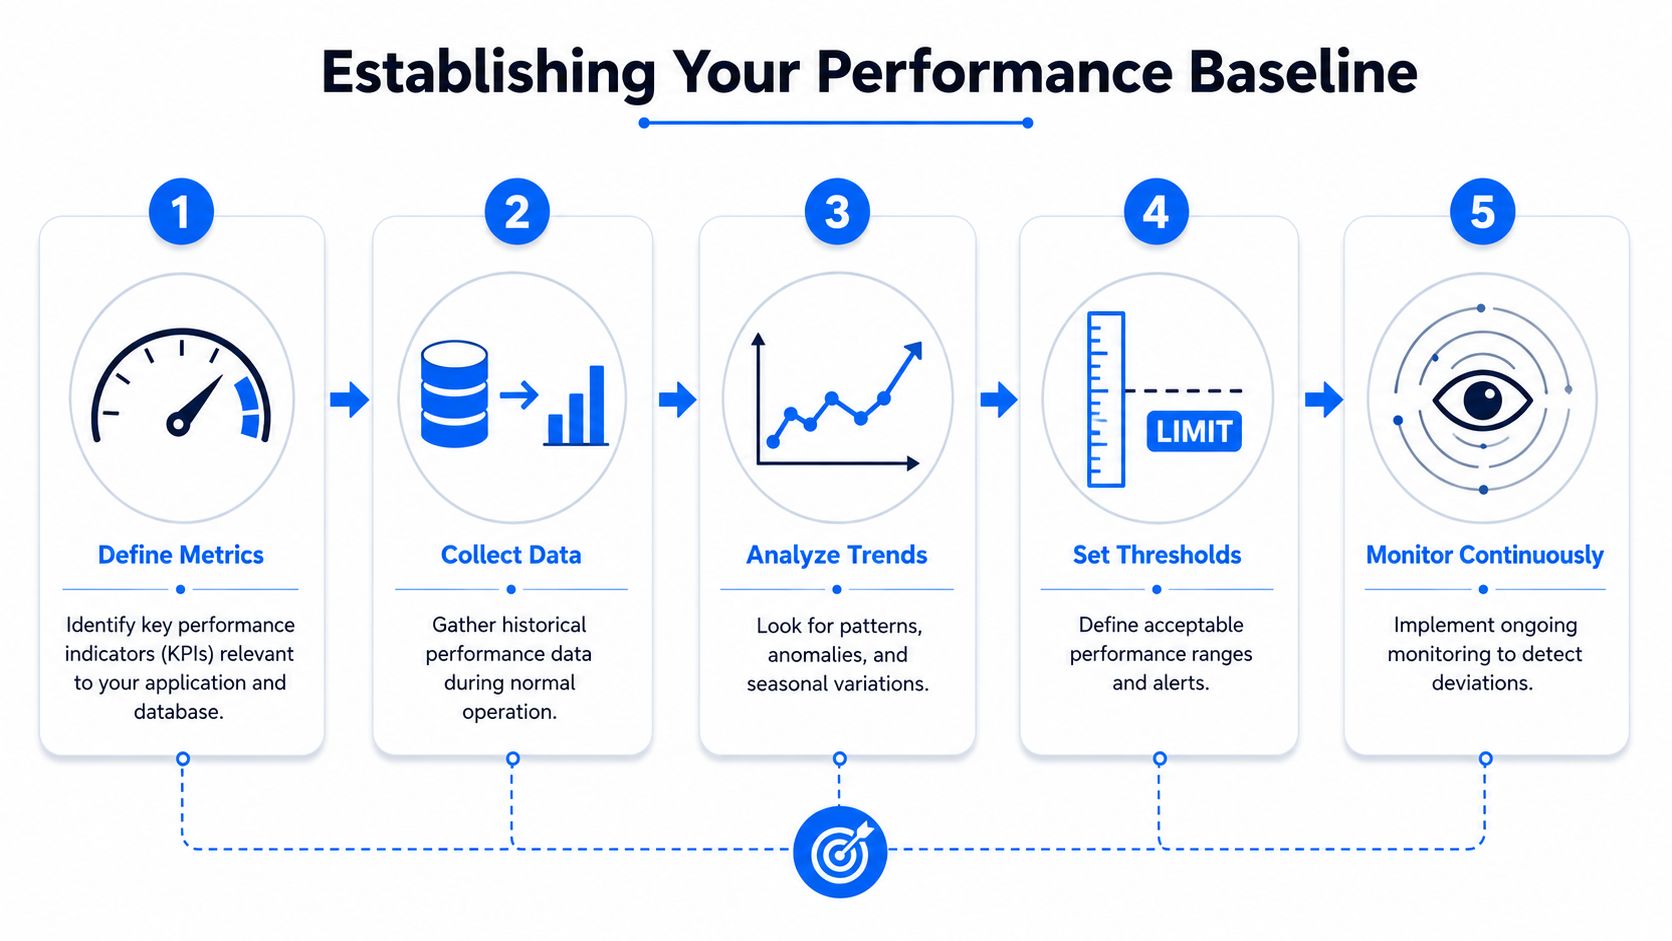
Prima misurare, poi intervenire sul sistema
Qui anche i team migliori diventano impazienti. È comprensibile. Gli utenti aspettano e c'è pressione per “aggiungere un indice e basta” o “dargli più memoria”. Resistete a questo impulso finché non avete registrato una baseline sia dei periodi sani sia di quelli problematici.
Le linee guida di Oracle sul tuning restano utili su questo punto, perché insistono nel raccogliere statistiche complete del sistema operativo, del database e dell'applicazione sia negli stati buoni sia in quelli cattivi. Questa disciplina conta. Le statistiche mancanti non sono un problema burocratico. Trasformano l'analisi delle cause radice in un tirare a indovinare.
Regola pratica: se non avete registrato lo stato precedente, non potete dimostrare che quello successivo sia migliore.
La raccolta della baseline dovrebbe includere l'intero profilo operativo del carico di lavoro, non solo una singola istruzione lenta. Ciò significa misurare cosa fa il sistema per modulo, finestra temporale e tipo di risorsa.
Per i team che vogliono rendere più rigorosa la propria pratica di monitoraggio, vale la pena rivedere queste tecniche di monitoraggio e auditing dei database insieme agli strumenti nativi del motore.
Cosa registrare nella baseline
Gli strumenti esatti variano a seconda della piattaforma, ma le categorie sono costanti. Query Store in SQL Server e Azure SQL, pg_stat_statements in PostgreSQL, le viste delle prestazioni di Oracle e le tabelle di sistema di Teradata aiutano tutti a far emergere le stesse classi di evidenze.
Segnale | Cosa cercare | A cosa rimanda di solito |
|---|---|---|
Latenza | Latenza di coda in aumento e tempi di risposta instabili | Cambi di piano, pressione sull'I/O, blocchi, cache miss |
Throughput | Meno lavoro completato per modulo o finestra di job | Contesa, code, amplificazione delle scritture |
CPU e memoria | Saturazione, variazioni improvvise, cattivo comportamento della cache | Piani errati, sovrallocazione, cache sottodimensionate |
I/O e attese | Picchi di lettura, spill, pressione sullo storage, wait event | Indici mancanti, pressione sugli ordinamenti, bloat, lavoro temporaneo |
Errori e tentativi ripetuti | Timeout, continue riconnessioni, refresh falliti | Esaurimento delle risorse, pool dimensionati male, catene di lock |
Quando possibile, registrate queste metriche con un carico riproducibile. Se campionate solo durante un'interruzione, non saprete se il problema è eccezionale o parte di una tendenza.
Una baseline solida di solito risponde a quattro domande operative:
Cosa era lento. Non un singolo aneddoto, ma le classi di query, i job e i percorsi utente coinvolti.
Dove si concentrava la pressione. CPU, memoria, storage, spazio temporaneo o concorrenza.
Quando è cambiato. Dopo un deployment, dopo l'arrivo dei dati, durante una finestra di reportistica o durante la manutenzione in background.
Se il business se n'è accorto. Dashboard in ritardo, analisi non aggiornate, SLA violati o scoring dei modelli ritardato.
Le baseline richiedono contesto, non solo metriche
Una baseline troppo ristretta può trarvi in inganno. Supponiamo che una query di warehouse abbia rallentato dopo che una modifica di schema ha aggiunto una nuova colonna e l'ETL a valle ha iniziato a popolarla con pattern di null inattesi. Il piano di esecuzione potrebbe essere il meccanismo immediato, ma la diagnosi non è completa finché non collegate la variazione delle prestazioni alla variazione nella forma dei dati.
Ecco perché un'ottimizzazione matura delle prestazioni del database non si ferma a “raccogliere metriche”. Collega le metriche di sistema alla tempistica dei carichi di lavoro, allo stato dello schema e al comportamento di arrivo dei dati. Altrimenti la vostra baseline è precisa ma incompleta.
Dare priorità agli hotspot per ottenere i risultati migliori
Una volta misurato il sistema, la trappola successiva è l'ottimizzazione casuale. I team annegano nei grafici e poi passano una settimana a rifinire query a basso impatto mentre il vero collo di bottiglia continua a bruciare CPU o a saturare l'I/O.
Il modo più rapido per uscirne è dare priorità in base all'impatto. Non in base a quale query sembra peggiore. Non in base a quale alert è scattato per primo. Ma in base a quale hotspot consuma le risorse più significative o crea il disagio più ampio per gli utenti.
Classificare per impatto, non per fastidio
Una query eseguita di continuo che spreca risorse moderate può contare più di un report occasionale molto pesante. SQL Server Query Store, le visualizzazioni di Azure SQL, le viste dei workload di Oracle, pg_stat_statements di PostgreSQL e le metriche dei workload di Teradata aiutano tutti a rispondere alla stessa domanda: cosa è ripetutamente abbastanza costoso da condizionare il comportamento del sistema?
Partite da un semplice modello di classificazione:
La frequenza conta. Una piccola inefficienza eseguita tutto il giorno può dominare il carico totale.
L'ampiezza conta. Le query legate a dashboard condivisi o API centrali meritano più attenzione dei job amministrativi di nicchia.
Il tipo di risorsa conta. Gli hotspot pesanti sulla CPU e quelli pesanti sull'I/O richiedono interventi diversi.
La tempistica conta. Un job che si sovrappone alla reportistica del mattino può essere più urgente di un'attività più lenta eseguita di notte.
Non ottimizzate per prima la query più rumorosa. Ottimizzate quella che distorce di più la piattaforma.
È nei piani di esecuzione che tutto diventa concreto. Cercate full scan su relazioni di grandi dimensioni, join costosi con stime di righe sbagliate, spill sullo storage temporaneo o key lookup ripetuti che gonfiano le letture. In PostgreSQL, verificate se la pressione dei checkpoint o il ritardo dell'autovacuum coincidono con il rallentamento. In SQL Server, esaminate il comportamento di tempdb e i pattern delle memory grant. In Teradata, esaminate quali classi di workload sono in coda e se una famiglia di query sta monopolizzando le risorse.
Come si presenta un vero hotspot
Un vero hotspot di solito ha una di queste forme:
Una query di reportistica che andava bene su una tabella di medie dimensioni ma che ora scansiona molti più dati perché la distribuzione è cambiata.
Un'istruzione transazionale eseguita frequentemente che ha perso un percorso di accesso efficiente dopo la deriva delle statistiche.
Una trasformazione di warehouse il cui volume di ordinamento intermedio è cresciuto fino a provocare spill.
Un ampio join di BI che era accettabile prima che lo schema drift introducesse chiavi duplicate o orfane a monte.
Ragionate in termini di sforzo rispetto all'impatto prima di iniziare a modificare gli oggetti. Alcuni risultati sono semplici: aggiornare le statistiche, rimuovere un indice chiaramente inutilizzato che aumenta il costo delle scritture o correggere un predicato che impedisce l'uso di un indice. Altri richiedono più attenzione perché cambiano il comportamento dell'applicazione o il design dello storage.
Lo scopo non è costruire un backlog perfetto. È individuare le poche modifiche che riporteranno la piattaforma verso report stabili, finestre batch prevedibili e consumatori a valle affidabili.
Ottimizzare il nucleo con il tuning di query e schema
Dopo aver classificato gli hotspot, ottimizzate prima il percorso principale. Di solito ciò significa pattern delle query, indici, statistiche e solo dopo modifiche di schema più pesanti. La maggior parte dei sistemi offre ancora un sorprendente margine di miglioramento a basso rischio prima che sia necessario parlare di ripartizionamento o di una riprogettazione importante.
Iniziare con modifiche a basso rischio
Un flusso di lavoro disciplinato parte in piccolo. Aggiornate le statistiche se sono obsolete. Rivedete i piani di esecuzione. Aggiungete o modificate indici solo quando il piano e il pattern di accesso lo giustificano. Piccole riscritture SQL, correzioni dei connection pool e la validazione dei piani di solito vengono prima di una riprogettazione strutturale.
Un errore pratico compare ovunque: i team continuano ad aggiungere indici senza verificare se quelli esistenti si sovrappongono già o se il percorso di scrittura può sostenere un costo di manutenzione maggiore. Le indicazioni riassunte in questa panoramica sull'ottimizzazione delle prestazioni dei database vanno nella giusta direzione. Rimuovere indici inutilizzati o ridondanti può ridurre l'overhead di scrittura e il costo dello storage, mentre aggiungerne altri alla cieca può spingere l'ottimizzatore verso scelte sbagliate o maggiori oneri di manutenzione.
Alcuni interventi di tuning ripagano costantemente:
Fate pulizia nella proliferazione degli indici. Gli indici ridondanti aumentano il costo delle scritture e possono confondere il troubleshooting.
Preferite indici brevi e mirati. I campi lunghi di tipo testuale sono di solito pessimi candidati per gli indici, perché ne gonfiano la dimensione e il costo computazionale.
Verificate il comportamento della cache dopo le modifiche alle query. I buffer pool dovrebbero contenere il working set senza consumare tutta la memoria di sistema.
Eseguite audit regolari. La revisione degli indici e l'igiene della configurazione prevengono il lento degrado che si insinua nei sistemi maturi.
Usare con cautela le riscritture tramite IA
La riscrittura delle query tramite IA è allettante perché promette risultati rapidi. A volte aiuta. Può suggerire semplificazioni dei join, pulizia dei predicati o formulazioni alternative che le persone potrebbero non vedere sotto pressione.
Ma nei database di produzione l'IA ha un lato tagliente. Un sondaggio di settore del 2025 ha rilevato che il 44% delle ottimizzazioni di query generate dall'IA ha introdotto bug sottili in dataset finanziari e sanitari a causa di un'errata interpretazione della gestione dei null o della semantica degli intervalli di date, secondo questa sintesi di un sondaggio di settore sul tuning guidato dall'IA.
Il risultato coincide con ciò che gli ingegneri esperti sanno già. La velocità di una query non equivale alla sua correttezza.
Usate i suggerimenti dell'IA come la bozza di un revisore junior:
Verificate la modifica del piano di esecuzione.
Validate la semantica a livello di record.
Confrontate i result set su casi limite rappresentativi.
Controllate da vicino la gestione dei null, i limiti delle date e il comportamento con i duplicati.
Un SQL più veloce che restituisce le righe sbagliate è un difetto di produzione, non un'ottimizzazione.
Questo conta ancora di più nei sistemi di analytics e di ML. Un sottile errore semantico in una query di reportistica può diventare un KPI non aggiornato o fuorviante. Una cattiva riscrittura in una pipeline di feature può modificare gli input del modello facendo sembrare il warehouse “più veloce”.
Capire quando le modifiche di schema valgono la pena
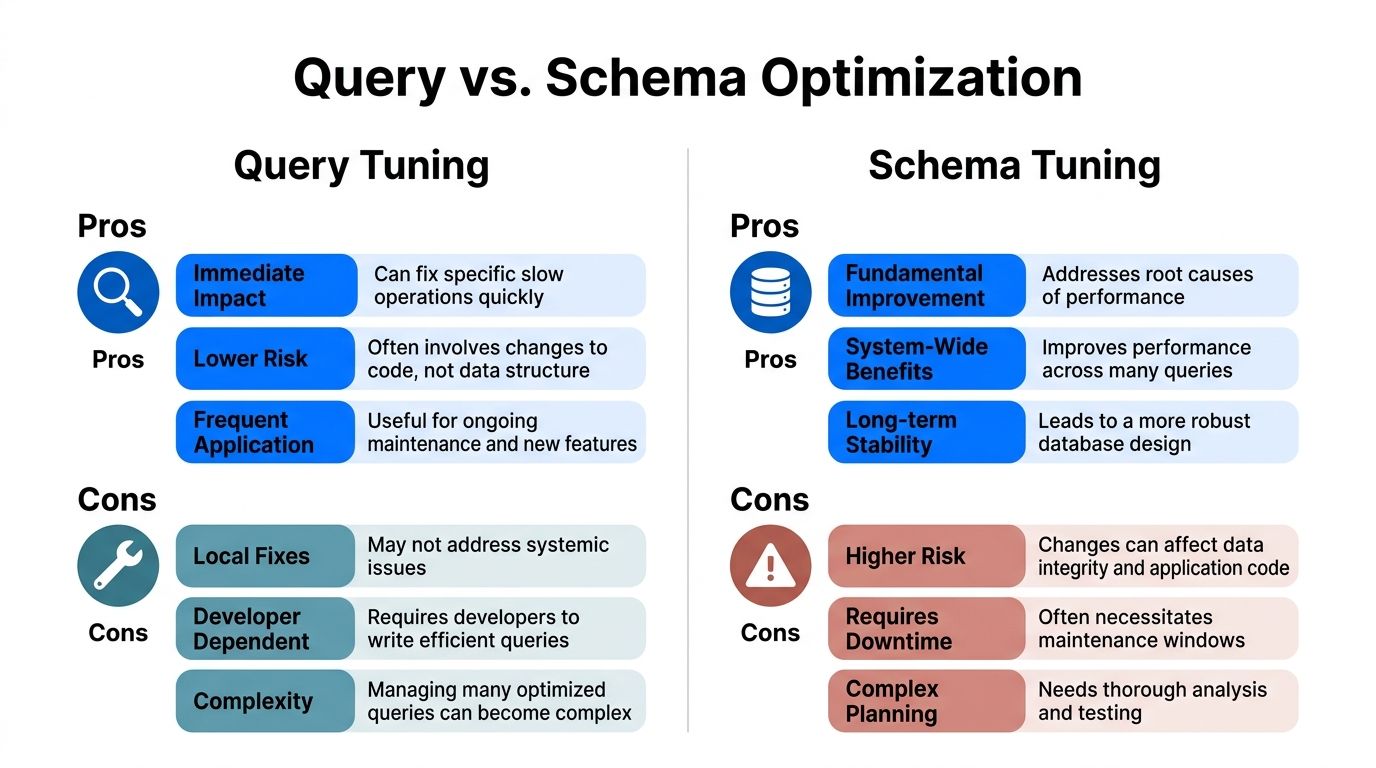
Il tuning delle query è locale. Il tuning dello schema è sistemico. Per questo le modifiche di schema possono produrre benefici ampi, ma comportano anche più rischi.
Ricorrete alle modifiche di schema quando il problema è strutturale, non estetico. Ad esempio tabelle che hanno chiaramente superato il loro layout attuale, percorsi di join che dipendono ripetutamente da chiavi dalla forma scomoda o carichi di lavoro che richiedono partizionamento e gestione del ciclo di vita piuttosto che un altro giro di cerotti sulle query.
Un modo utile per inquadrare la scelta:
Opzione | Ideale quando | Principale compromesso |
|---|---|---|
Tuning delle query | Il problema è causato da un piccolo insieme di istruzioni | Potreste risolvere solo sintomi locali |
Tuning degli indici | I percorsi di accesso sono sbagliati o incompleti | Le scritture diventano più costose |
Tuning dello schema | Molte query soffrono dello stesso vincolo di design | Rischio di modifica più alto e maggiore coordinamento |
La sequenza conta. Partite dall'opzione meno invasiva che possa plausibilmente risolvere il problema. Se non cambia nulla, tornate indietro in modo pulito e passate al livello successivo.
Questo approccio evita che l'ottimizzazione delle prestazioni del database si trasformi in una riprogettazione involontaria.
Ottimizzare il motore con configurazione e risorse
Una volta avviato il lavoro su query e schema, spostate l'attenzione sul motore stesso, una fase in cui molti team esagerano o fanno troppo poco. O girano ogni manopola che trovano, oppure lasciano intatti evidenti problemi di risorse perché danno per scontato che “sarà l'SQL”.
Sono entrambi errori.
Trattare la configurazione come un esperimento
Il tuning della configurazione funziona solo se segue un rigoroso metodo a modifica singola. La metodologia di tuning di Oracle è esplicita su questo punto nelle sue indicazioni su un metodo di tuning passo dopo passo. Modificate un parametro o un oggetto alla volta, registrate le metriche prima e dopo, e non dichiarate il successo se il nesso causale non è chiaro.
Questo vale per le impostazioni della memoria, i connection pool, il parallelismo, il posizionamento dello storage e gli strumenti diagnostici. Vale anche per il piccolo ma comune errore di lasciare attivi in produzione il tracing o le sessioni di Extended Events dopo un'indagine. Questi strumenti possono entrare a far parte del profilo di latenza se nessuno li disattiva.
Un ordine di intervento utile è il seguente:
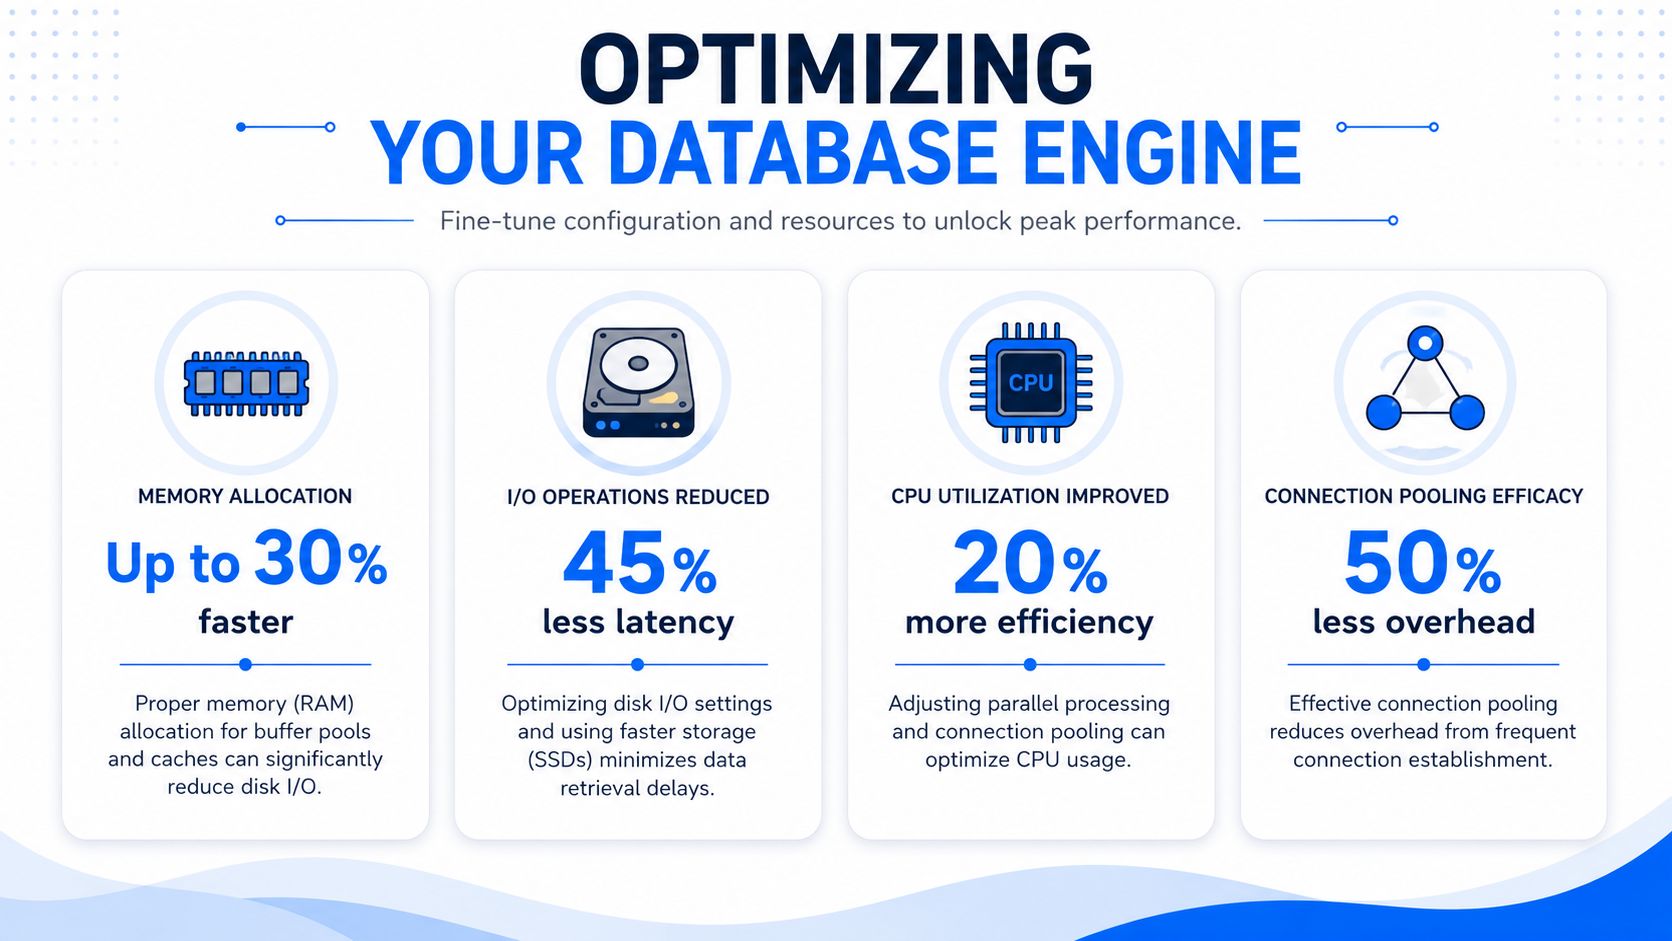
Prima la memoria. Verificate se il buffer pool o gli shared buffers possono contenere il working set senza togliere risorse al resto dell'host.
Poi il comportamento delle connessioni. Troppe sessioni attive possono creare una contesa artificiale e pressione sullo scheduler.
Quindi il percorso di I/O. Cercate pattern di spill temporanei, profondità delle code o un posizionamento inadeguato dei file critici.
Solo allora regolate le manopole più profonde. Parallelismo, impostazioni dei worker e comportamenti avanzati del motore richiedono evidenze più solide.
Controlli specifici per piattaforma che contano
I dettagli del motore variano, ma alcuni controlli sono troppo importanti per essere saltati.
Interazione tra Oracle e sistema operativo
Una regola storica fondamentale di Oracle è ancora valida: se l'utilizzo del kernel del sistema operativo supera il 40%, la causa probabile è una contesa a livello di sistema operativo, come paging, swapping, overhead di trasferimento di rete o thrashing dei processi, e non solo difetti dell'SQL, come documentato nella guida all'ottimizzazione delle prestazioni di Oracle. Quando si raggiunge quella soglia, smettete di fingere che il problema riguardi soltanto una query.
SQL Server e tempdb
Se tempdb è posizionato male o sottodimensionato per il carico di lavoro, il resto della discussione sul tuning diventa rapidamente confuso. Spill, pressione del versioning e attività temporanee concorrenti rendono i sintomi di “query lenta” peggiori di quanto sembrino.
PostgreSQL e comportamento della manutenzione
Sorvegliate da vicino checkpoint e autovacuum. Se l'autovacuum resta indietro, il bloat delle tabelle può trasformare normali letture in I/O costoso. Se le impostazioni dei checkpoint non sono adatte al pattern di scrittura, la latenza diventa irregolare.
Teradata e classi di workload
Su Teradata, le medie di sistema possono nascondere i problemi. La vista utile è il comportamento a livello di workload, le code e quanto consuma una singola classe di attività durante le finestre critiche.
Il tuning del motore è il punto in cui la disciplina conta di più. Una modifica, un ciclo di misurazione, un percorso di rollback.
Senza questo rigore, l'ottimizzazione delle prestazioni del database diventa superstizione. Non saprete se la modifica alla memoria ha aiutato, se quella al pool ha danneggiato la concorrenza o se un intervento sullo storage ha mascherato per una settimana un problema di piano.
Dall'ottimizzazione reattiva all'osservabilità continua
Le sessioni di tuning occasionali sono ancora necessarie. Semplicemente non sono più sufficienti.
Il motivo è semplice. La vostra piattaforma dati continua a cambiare dopo la fine della sessione di tuning. Le tabelle crescono. I job a monte arrivano in ritardo. Gli schemi vanno alla deriva. Le distribuzioni dei record si spostano. Una baseline registrata in un periodo pulito smette lentamente di rappresentare la realtà della produzione.
Le baseline statiche invecchiano
Se tornate sulle prestazioni solo quando gli utenti si lamentano, lavorate sempre in rincorsa. A quel punto il problema si è già propagato in report non aggiornati, dashboard rotti, analisi in ritardo o funzionalità di IA inaffidabili.
L'osservabilità continua colma questo divario. Il cambiamento importante è osservare non solo le metriche del motore, ma anche le condizioni dei dati che invalidano le ipotesi sulle prestazioni:
Anomalie di volume che rimodellano i pattern di accesso
Modifiche di schema come colonne aggiunte, campi rimossi o cambi di tipo
Deriva della tempestività quando i dati attesi arrivano in ritardo o non arrivano affatto
Problemi di qualità a livello di record tra cui duplicati, anomalie nei null e relazioni interrotte
L'IA può aiutare in questo caso, se applicata al rilevamento delle anomalie piuttosto che alla riscrittura cieca delle query. Il rilevamento delle anomalie basato sull'IA può ridurre fino al 90% l'onere di manutenzione manuale delle regole quando metodi non supervisionati apprendono il comportamento normale e impostano automaticamente soglie adattive, secondo la descrizione della piattaforma dati enterprise di digna. È importante perché le soglie mantenute a mano invecchiano male nei warehouse dinamici.
Cosa cambia con l'osservabilità continua
L'elemento architetturale che rende tutto ciò praticabile è l'analisi nel database. Il calcolo delle metriche nel database elimina i costi di spostamento dei dati eseguendo l'ispezione direttamente nei database sorgente, consentendo il monitoraggio in tempo reale e l'apprendimento della baseline e garantendo che i dati dei clienti restino privati nel loro ambiente, come descritto in questa panoramica sull'analisi dei workload nel database.
Questo modello è particolarmente utile negli ambienti di cloud privato e on-premise, dove i team hanno bisogno di visibilità senza esportare dati di produzione sensibili. Si adatta anche al modo di lavorare dei data engineer. Se l'osservabilità può girare vicino alle tabelle dei workload di Teradata, alle statistiche di sistema di PostgreSQL o alla logica di validazione residente nel warehouse, potete intercettare la deriva prima che diventi un incidente visibile agli utenti.
Un modello operativo più solido combina:
telemetria delle query e del motore,
tracciamento dello schema,
monitoraggio della freschezza,
rilevamento delle anomalie sulla forma dei dati,
e validazione a livello di record legata alle regole di business.
Se desiderate un'introduzione più ampia a questo modello operativo, questa panoramica sull'osservabilità dei dati nella pratica è un utile punto di partenza.
L'ottimizzazione delle prestazioni del database funziona meglio quando si evolve da attività di salvataggio a ciclo di controllo continuo. È così che proteggete non solo la latenza delle query, ma anche la fiducia negli output che il vostro database fornisce.
Se il vostro team sta cercando di collegare le prestazioni del database con la deriva dei dati, le modifiche di schema, la tempestività e la validazione a livello di record in un unico modello operativo, digna è costruita per questo. Esegue le analisi all'interno del vostro ambiente, aiuta a far emergere le anomalie prima che diventino report non aggiornati o input di IA inaffidabili e offre agli ingegneri un modo per mantenere oneste le baseline delle prestazioni man mano che i dati cambiano.
Per sorvegliare le condizioni dei dati che invalidano silenziosamente una baseline di tuning, come variazioni di volume, modifiche di schema e caricamenti in ritardo, scoprite come digna affronta l'osservabilità della piattaforma dati all'interno del vostro database.
Domande frequenti
Cosa causa il degrado delle prestazioni di un database nel tempo?
Spesso i dati, non l'SQL. L'analisi di Last9 citata nell'articolo attribuisce il 68% del degrado delle prestazioni dei database nel 2024-2025 a problemi di qualità dei dati a monte che alterano i pattern di accesso, come variazioni nel numero di righe, distribuzioni sbilanciate, nuovi pattern di null o aggiornamenti di schema passati inosservati che rendono obsoleta una vecchia baseline.
Cosa dovrebbe includere una baseline delle prestazioni del database?
Una baseline utile registra latenza, throughput, CPU e memoria, I/O e wait event, oltre a errori e tentativi ripetuti, misurati sia nei periodi sani sia in quelli problematici. Dovrebbe rispondere a quattro domande: cosa era lento, dove si concentrava la pressione, quando è cambiato e se il business se n'è accorto tramite dashboard in ritardo o SLA mancati.
Come decidere quali query lente ottimizzare per prime?
Classificate gli hotspot in base all'impatto, non in base a quale query sembra peggiore o ha generato il primo alert. Valutate frequenza, ampiezza, tipo di risorsa e tempistica: una piccola inefficienza eseguita tutto il giorno può dominare il carico totale, e un job che si sovrappone alla reportistica del mattino può contare più di un'attività notturna più lenta. Query Store e pg_stat_statements aiutano.
È sicuro usare l'IA per riscrivere le query SQL?
Solo con una revisione attenta. Un sondaggio di settore del 2025 citato nell'articolo ha rilevato che il 44% delle ottimizzazioni di query generate dall'IA ha introdotto bug sottili in dataset finanziari e sanitari, soprattutto nella gestione dei null e degli intervalli di date. Trattate i suggerimenti come la bozza di un junior: verificate il piano, confrontate i result set e testate i casi limite.
Come andrebbero testate le modifiche alla configurazione del database?
Modificate un parametro alla volta, registrate le metriche prima e dopo e mantenete un percorso di rollback, seguendo il metodo passo dopo passo di Oracle. Procedete in ordine: prima la memoria, poi il comportamento delle connessioni, poi il percorso di I/O e solo allora parallelismo o impostazioni dei worker. Oracle segnala inoltre un utilizzo del kernel del sistema operativo superiore al 40% come indice di contesa a livello di sistema operativo.


