Orchestrazione delle pipeline: guida pratica a dati affidabili
|
6
min di lettura

Potete avere un warehouse pieno di dati, uno scheduler che non manca mai un cron, e svegliarvi comunque con una dashboard del management non aggiornata. Il file è arrivato in ritardo. Un job a monte è fallito a metà. Nessuno se n'è accorto finché qualcuno non ha chiesto perché i numeri di ieri sera non corrispondessero alla realtà di stamattina. È in quel divario tra “il job è stato eseguito” e “l'output è affidabile” che l'orchestrazione delle pipeline inizia a contare.
Molti team riconoscono questo divario solo dopo un incidente. A quel punto il problema è diventato più grande di un'esecuzione mancata, perché report, modelli e alert a valle sono stati costruiti su dati incompleti o in ritardo. L'orchestrazione coordina i passaggi, le dipendenze, i retry e il monitoraggio che mantengono coerente una pipeline quando lo stack è distribuito e i guasti sono parziali, non totali, ed è per questo che è diventata centrale man mano che i flussi di dati si sono estesi tra sistemi cloud e di analytics (Atlan sui pattern di orchestrazione delle pipeline).
Indice
Il problema della pipeline alle 3 di notte che conoscete già
KPI, pratiche di runbook e come si presenta un buon risultato
Il problema della pipeline alle 3 di notte che conoscete già
Una dashboard smette di essere aggiornata, e la prima reazione di solito è dare la colpa al warehouse, al livello BI o all'analista che se n'è accorto. Il vero problema è spesso più banale: un caricamento a monte è arrivato in ritardo, mancava un file o una partizione non è mai stata sottoposta a backfill. Se nulla nello stack sorveglia questa condizione, la pipeline può sembrare in salute mentre produce output incompleti.
È per questo che si cerca l'orchestrazione delle pipeline dopo un incidente. L'orchestratore si colloca tra i job grezzi e gli output affidabili, e decide cosa viene eseguito, cosa attende, cosa viene ritentato e cosa si ferma quando qualcosa a monte si rompe. Nei sistemi di produzione, questo livello di controllo conserva lo stato del ciclo di vita lungo i passaggi distribuiti, gestisce retry e backfill e blocca le trasformazioni a valle quando i dati prerequisiti non sono pronti (DataOps School sull'orchestrazione delle pipeline).
Regola pratica: se un consumatore a valle non sa distinguere tra “in ritardo”, “mancante” e “fallito”, il vostro control plane è troppo sottile.
È anche qui che molti team sopravvalutano ciò che il loro scheduler attuale offre. Un timer che avvia un job non è la stessa cosa di un sistema che impone le dipendenze, gestisce i guasti parziali e registra lo storico delle esecuzioni in un modo su cui gli operatori possano agire. Il modello mentale giusto è semplice: l'orchestrazione è il livello di coordinamento, non il livello di trasformazione, e questa distinzione conta quando lo stack è sotto stress.
Definire l'orchestrazione delle pipeline
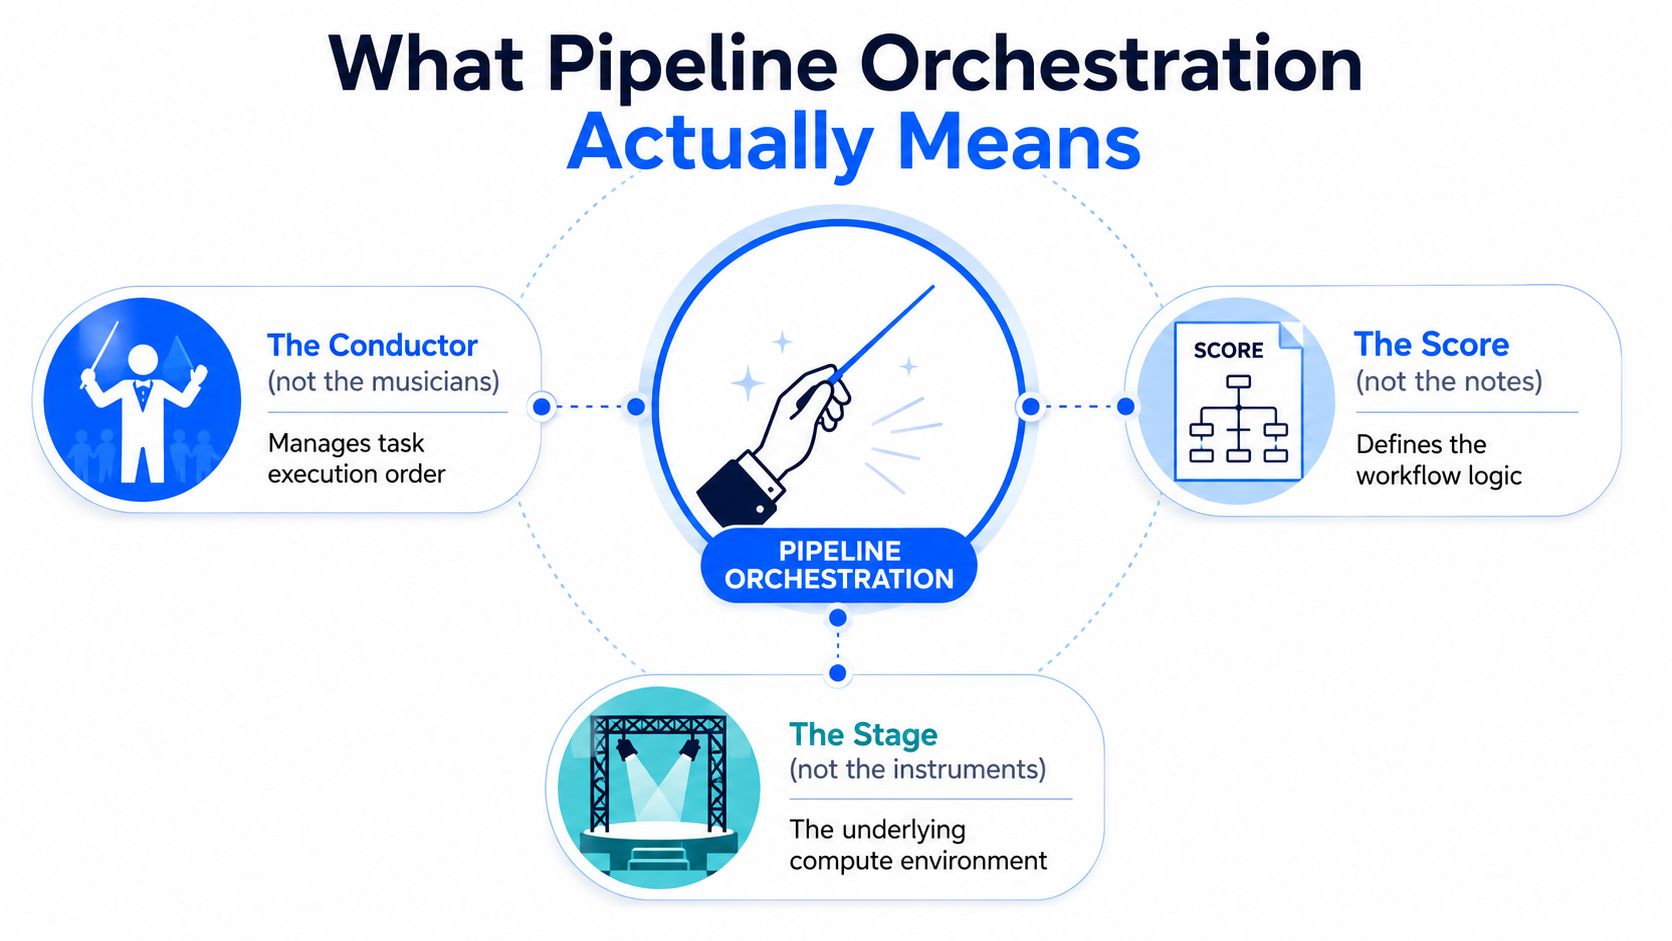
Una pipeline può spostare dati e deludere comunque il business. Un file arriva in ritardo, una partizione viene saltata o un modello a valle parte prima che il caricamento a monte sia terminato, e la dashboard sembra ancora normale finché qualcuno non ci fa affidamento. L'orchestrazione è il livello di controllo che decide quale passaggio viene eseguito, quale attende e quale si ferma quando la condizione a monte non è corretta.
La definizione pratica di orchestrazione delle pipeline è il livello che decide quando, in quale ordine e a quali condizioni viene eseguito ogni passaggio di una pipeline di dati, imponendo le dipendenze, gestendo i guasti e monitorando l'esecuzione tra sistemi collegati (Beta Systems sull'orchestrazione delle pipeline di dati). Si colloca sopra motori di esecuzione come Spark, dbt o job nativi del warehouse, e sotto la logica di business che dipende da dati affidabili.
Un modo utile per separare i pezzi è questo. L'orchestrazione coordina il lavoro, mentre l'observability dice agli operatori se il lavoro ha prodotto dati di cui possono fidarsi. Negli ambienti private cloud e on-prem questa distinzione conta ancora di più, perché l'accesso ai dati gestito dal fornitore è spesso limitato, quindi la piattaforma deve far emergere lo stato di salute da log, stato dei task, controlli di freschezza, controlli sul numero di righe e altri segnali che potete raccogliere all'interno del vostro perimetro. Se questi segnali non vengono progettati insieme, l'orchestratore può sapere che un job è terminato mentre il team non riesce ancora a capire se l'output sia sicuro da usare.
Cosa fa e cosa non fa
I compiti principali sono chiari. Pianifica il lavoro, attende le dipendenze a monte, ritenta i task falliti, esegue backfill su intervalli storici e reagisce a eventi esterni come l'arrivo di un file o di un messaggio in una coda. Sono problemi di coordinamento, non di trasformazione.
La separazione conta in produzione perché i team cercano spesso di far fare tutto a un unico strumento. Il risultato sono DAG fragili, job sovradimensionati e guasti che richiedono troppo tempo per essere diagnosticati. Una progettazione migliore mantiene l'orchestrazione concentrata sul flusso di controllo, lascia la trasformazione ai motori di calcolo e affida al livello di observability un compito chiaro: verificare se i dati sono freschi, completi e coerenti prima che i consumatori a valle agiscano.
L'orchestrazione risponde alla domanda “questo passaggio deve essere eseguito ora?”. Non risponde a “i dati sono abbastanza buoni da potersene fidare?”.
Le componenti fondamentali di un orchestratore
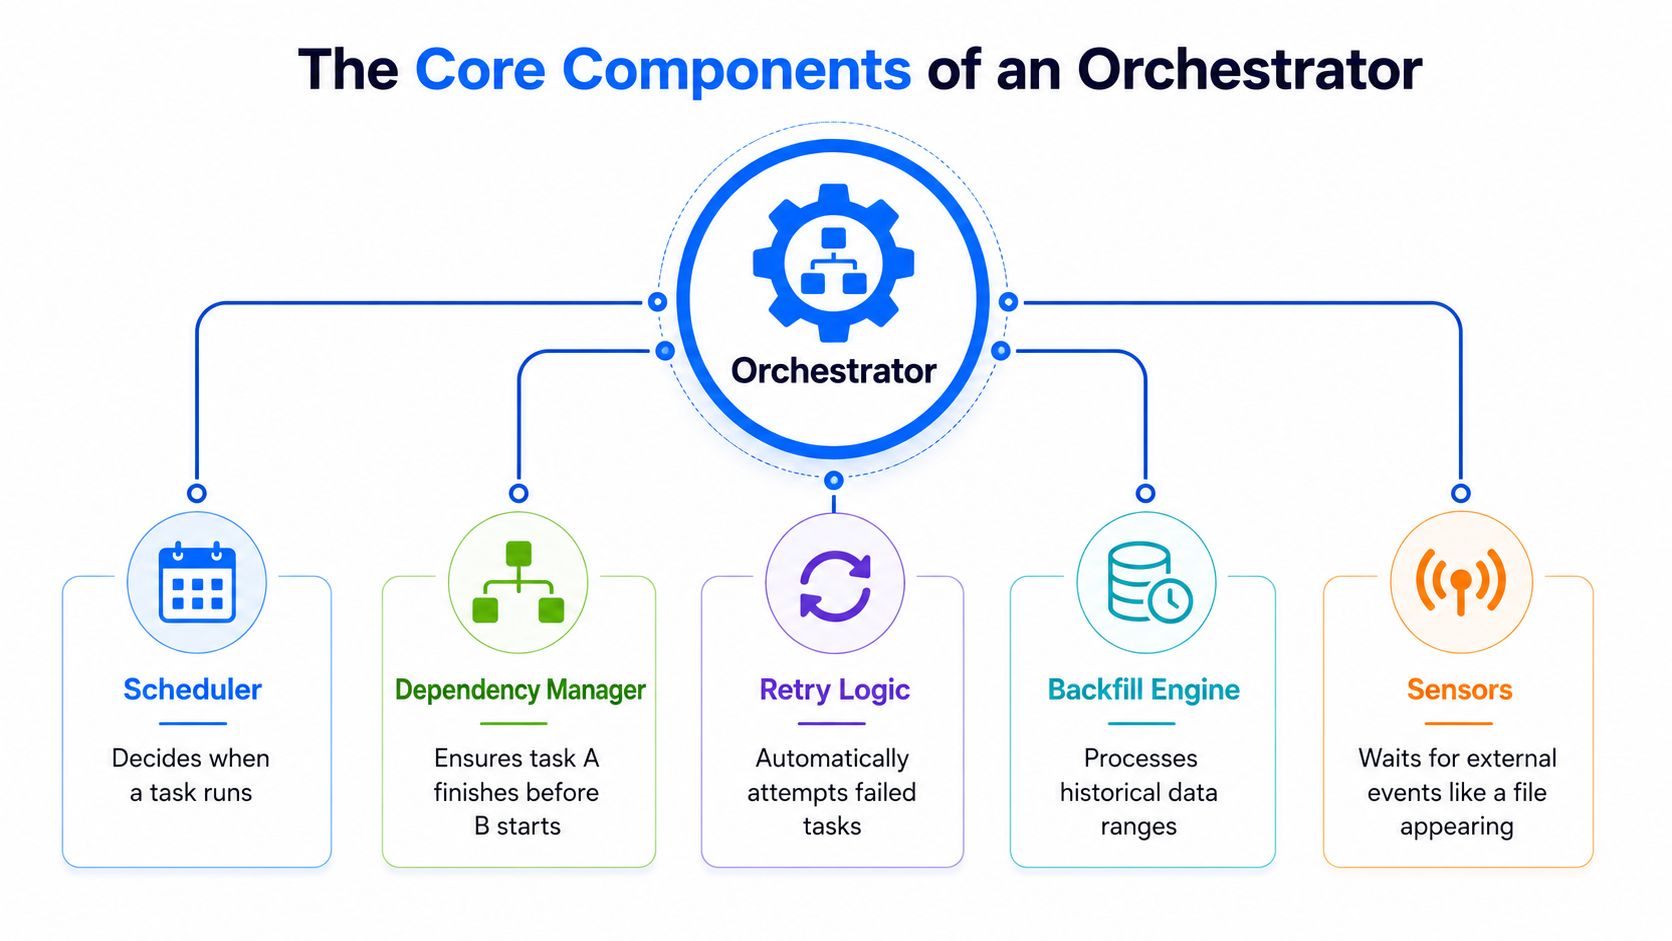
Una pipeline può essere piena di job e fallire comunque nel punto che conta: la produzione. Ciò che distingue un calendario da un orchestratore sono lo stato, la consapevolezza delle dipendenze e la gestione dei guasti. In pratica, significa che il control plane deve sapere cosa è stato eseguito, cosa è bloccato, cosa può essere ritentato in sicurezza e cosa deve attendere una partizione a monte in ritardo prima che contamini l'output a valle.
Questa scelta progettuale conta ancora di più negli ambienti private cloud e on-prem, dove non potete contare sull'accesso ai dati gestito dal fornitore per spiegare a posteriori cosa è successo. I team hanno bisogno di segnali raccolti all'interno del proprio perimetro, quindi orchestrazione e observability devono essere progettate insieme. Se l'orchestratore sa solo che un task è terminato, ma la piattaforma non può confermare freschezza, completezza o coerenza, gli operatori finiscono comunque per tirare a indovinare alle 3 di notte.
Scheduling e gestione delle dipendenze
Lo scheduling decide quando un task diventa idoneo all'esecuzione. La gestione delle dipendenze decide se può essere eseguito del tutto. In una pipeline di warehouse, l'ingestion dei dati grezzi dovrebbe terminare prima che inizi la trasformazione, e la trasformazione dovrebbe terminare prima che un passaggio di pubblicazione scriva nello schema di reporting. Sembra semplice finché una partizione in ritardo non compare nel bel mezzo di una finestra di rilascio.
Il valore di controllo qui è causale. Se un'estrazione a monte fallisce, il lavoro a valle può essere bloccato o ripianificato invece di produrre una tabella parziale che a prima vista sembra valida. È la differenza tra un sistema di controllo e un mucchio di job indipendenti.
Retry, backfill e sensori
I retry servono per i guasti transitori, non per nascondere difetti di progettazione. Un retry controllato può salvare un'esecuzione quando una dipendenza ha un problema occasionale. Se lo stesso passaggio fallisce ogni notte, il problema sta nella progettazione della pipeline o nel sistema sorgente, non nella policy di retry.
I backfill gestiscono le correzioni storiche senza rieseguire l'intero grafo. Questo conta quando i dati arrivati in ritardo riguardano un intervallo di date circoscritto, perché la correzione più pulita di solito consiste nel ricalcolare solo le partizioni interessate.
I sensori colmano il divario tra orchestrazione basata sul tempo e orchestrazione event-driven. Possono attendere un file, un oggetto o un altro segnale esterno prima di avviare il lavoro a valle. In un ambiente misto questo conta, perché feed batch, micro-batch e quasi in tempo reale raramente condividono la stessa tolleranza alla latenza.
Un orchestratore moderno dovrebbe supportare sia trigger basati sul tempo sia trigger event-driven, perché gli ambienti che combinano caricamenti nel warehouse, input in streaming e arrivi di file hanno bisogno di entrambi gli stili di coordinamento, e i team che confrontano le opzioni di control plane finiscono comunque per valutare dbt vs Airflow in questo percorso decisionale (DataOps School sull'orchestrazione delle pipeline).
Pattern e architetture di orchestrazione comuni
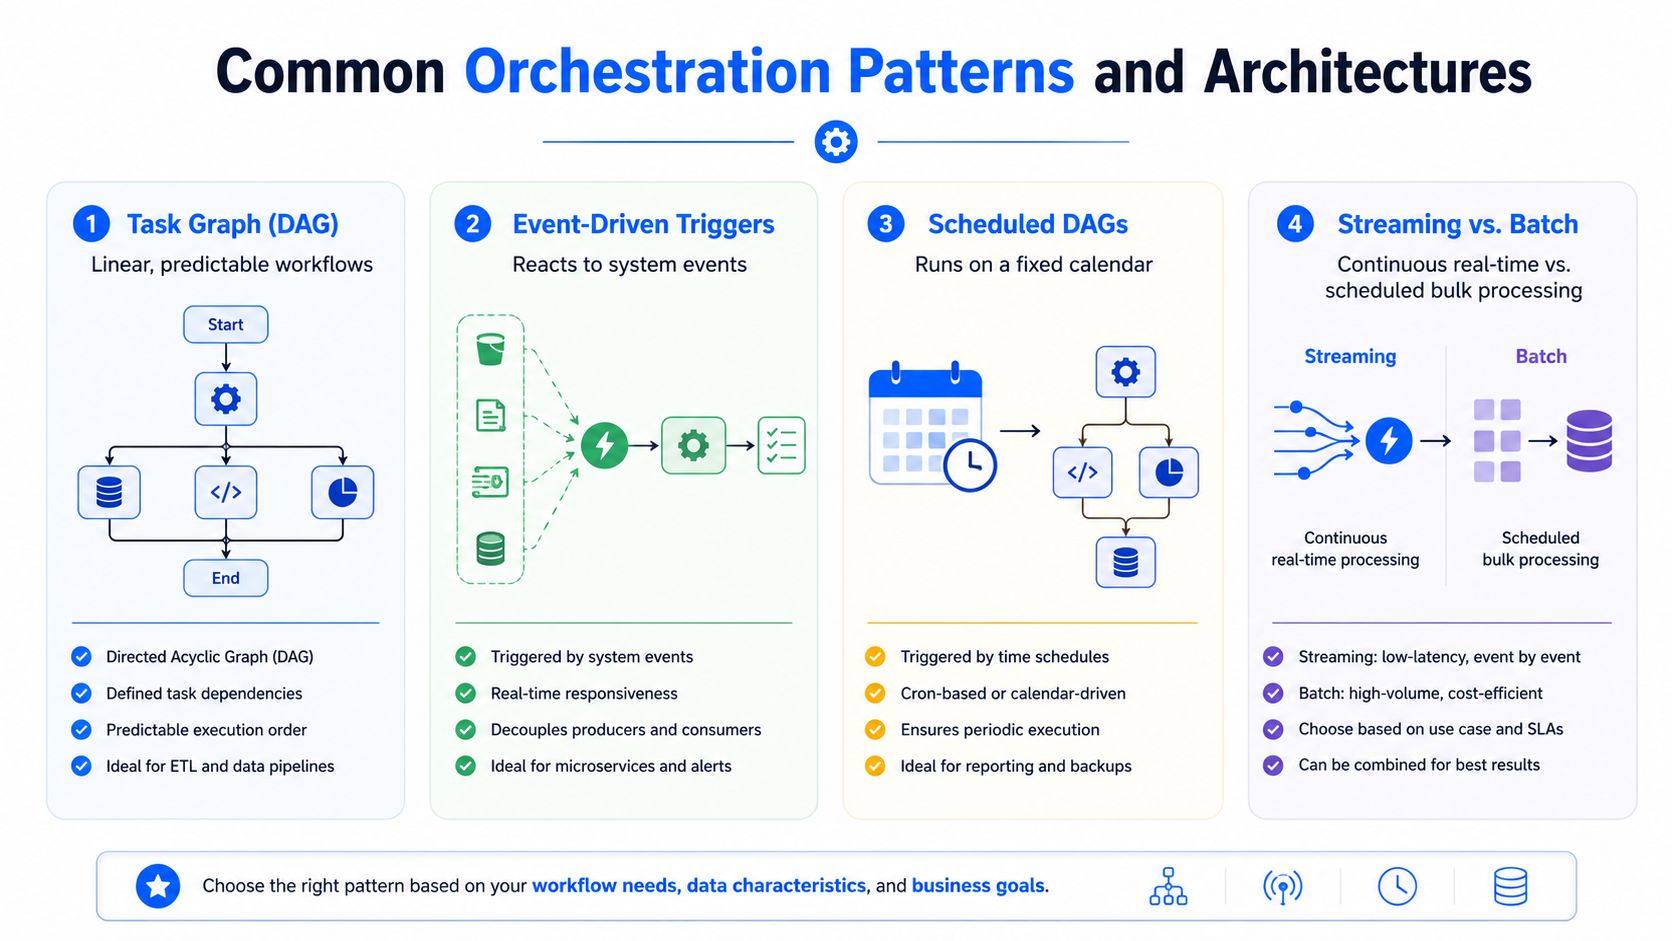
Pipeline con forme diverse richiedono pattern di orchestrazione diversi. Una catena ETL strettamente accoppiata richiede un ordinamento prevedibile. Un sistema che reagisce all'arrivo di file o di messaggi in coda richiede trigger event-driven. Una piattaforma che combina job di warehouse e feed in streaming ha bisogno di entrambi, a volte nello stesso ambiente.
Grafi di task e scheduling basato su DAG
I grafi di task funzionano meglio quando il workflow è esplicito e l'ordine conta. È per questo che i DAG sono diventati il modello mentale predefinito per molti data engineer: rendono visibili le dipendenze e rendono più facile ragionare sui guasti. Apache Airflow ha portato questo pattern nel mainstream, e la maggior parte degli stack di orchestrazione maturi prende ancora in prestito la stessa logica a grafo anche quando l'implementazione è diversa.
Il vantaggio pratico è la tracciabilità. Quando un nodo fallisce, gli operatori possono vedere esattamente quali task a valle sono stati bloccati e perché.
Event-driven, streaming e batch
L'orchestrazione event-driven dà il meglio quando il sistema deve reagire agli arrivi invece che a un orologio. Arriva un file, compare un messaggio, scatta un webhook, e la pipeline risponde. Questo pattern è comune anche nelle configurazioni private cloud e on-prem, perché l'evento scatenante avviene spesso all'interno del perimetro del cliente, non in un control plane gestito dal fornitore.
Lo streaming cambia la pressione progettuale. Il batch può tollerare la latenza in cambio della semplicità, mentre lo streaming richiede un movimento continuo e un feedback operativo più stretto. La maggior parte degli ambienti reali combina i due, ed è per questo che l'orchestratore deve supportare comportamenti basati sul tempo ed event-driven fianco a fianco.
Se state confrontando il controllo dei workflow per sistemi incentrati sulla trasformazione, vale la pena mappare con attenzione il compromesso tra la modellazione in stile dbt e un controllo incentrato sull'orchestrazione, e questa guida interna è utile: il confronto di digna tra dbt e Airflow.
Gli aspetti operativi che decidono se funziona
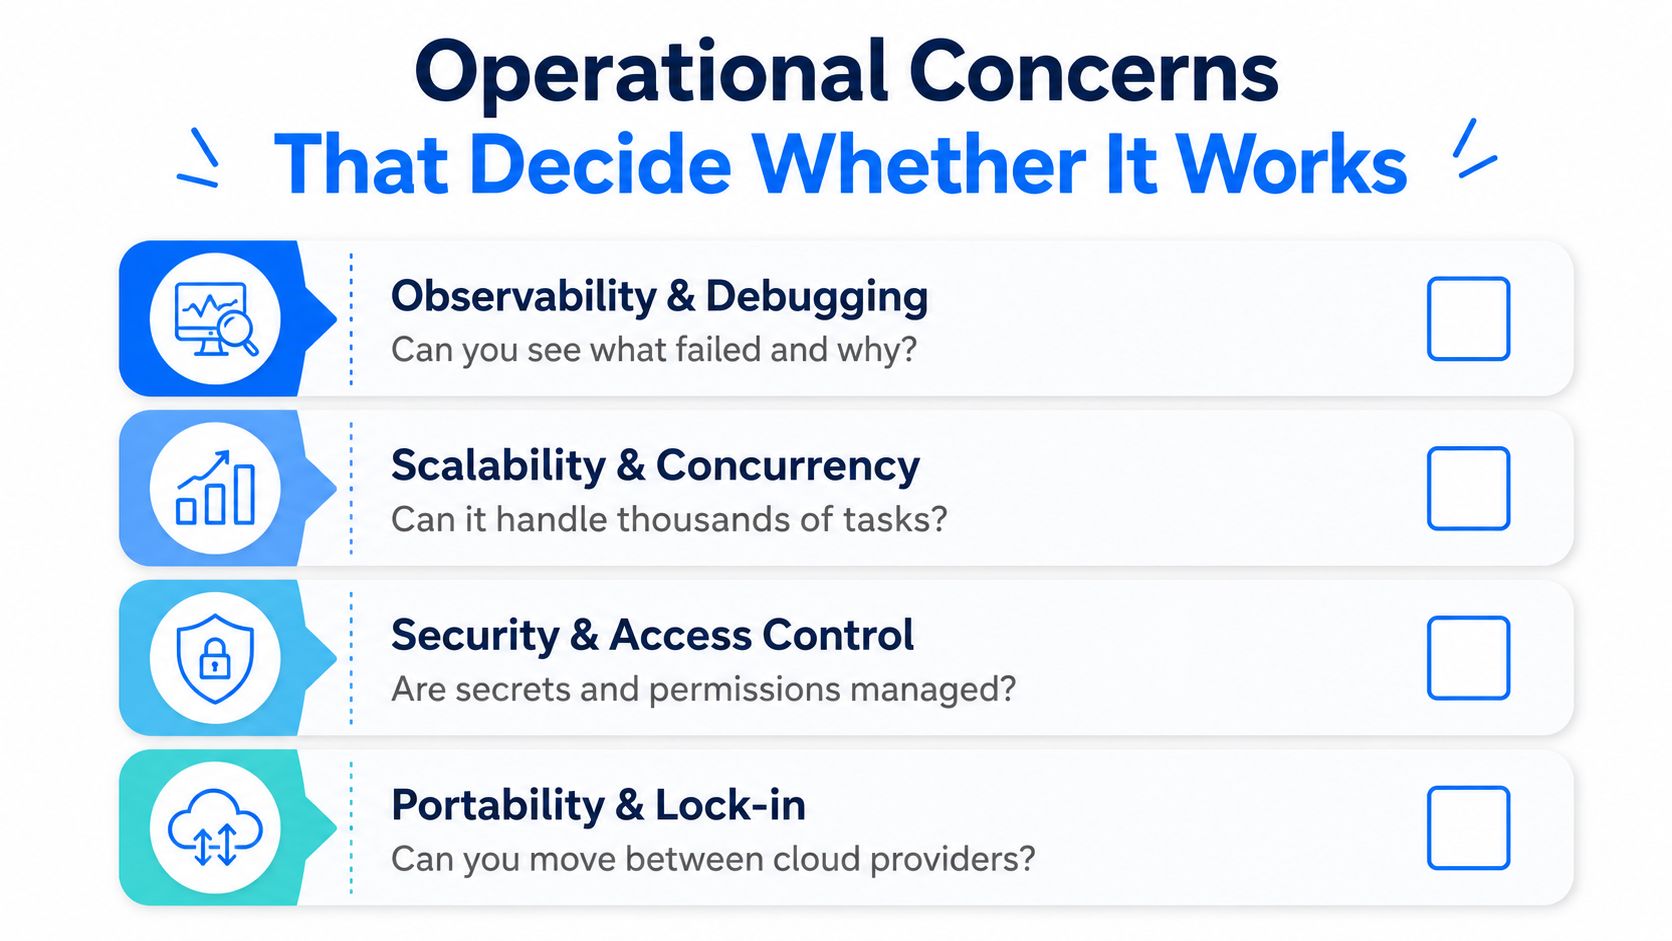
Uno strumento può avviare job e fallire comunque come piattaforma. La differenza emerge in quattro ambiti: scalabilità, observability, sicurezza e multi-tenancy. Negli ambienti private cloud e on-prem ciascuno di essi presenta spigoli più vivi, perché non potete ripiegare su un control plane gestito dal fornitore quando qualcosa va storto.
Scalabilità e observability
La scalabilità riguarda il comportamento dell'orchestratore quando il grafo diventa grande, rumoroso o soggetto a picchi. Alcuni sistemi gestiscono bene una manciata di job curati e poi vanno in difficoltà quando i team aggiungono decine di pipeline, sensori e backfill. La risposta di solito non è “più retry”, ma un controllo migliore su concorrenza, stato e isolamento dei task.
L'observability è il punto in cui molti stack di orchestrazione ricevono una fiducia eccessiva. L'orchestratore può mostrare storico delle esecuzioni, log, stato degli SLA e alert in un unico posto, ma questo non vi dice comunque se i dati erano corretti. La sezione seguente sull'observability è importante perché orchestrazione e affidabilità dei dati sono correlate, non identiche.
Sicurezza e deployment multi-tenant
La sicurezza deve adattarsi al modello di rete e di identità che già utilizzate. Nei deployment on-prem e private cloud, ciò significa che service account, secret e policy di accesso devono vivere all'interno dei perimetri esistenti, non in un control plane SaaS separato che vede i dati di produzione per impostazione predefinita.
La multi-tenancy diventa una vera questione progettuale quando più team condividono lo stesso livello di orchestrazione. Pianificazioni, credenziali e visibilità operativa hanno bisogno di un isolamento chiaro, altrimenti il backfill di un team diventa l'incidente di un altro. In pratica, l'architettura più sicura è quella che mantiene ridotto il raggio d'impatto e i dati di produzione residenti dove la policy lo richiede.
Se state costruendo la parte di observability di questo control plane, questo riferimento interno mappa bene lo spazio del problema: data observability di digna.
Perché l'orchestrazione da sola non basta
L'orchestrazione può dirvi che un caricamento è terminato. Non può dirvi se è terminato con dati errati. È la lacuna che la maggior parte delle guide sulle pipeline lascia aperta, ed è per questo che una piattaforma affidabile ha bisogno di un secondo livello dedicato a qualità e observability.
La tempestività è il primo punto cieco. Una pipeline può essere eseguita con successo e arrivare comunque troppo tardi per la dashboard, il modello o il report che alimenta. Le modifiche di schema sono un altro punto cieco, perché un cambio di tipo di una colonna o un campo mancante possono attraversare un DAG in salute e fallire solo più tardi, al momento del consumo. Anomaly detection e validazione intercettano classi diverse di problemi, gli spostamenti di distribuzione nelle metriche chiave e le violazioni delle regole a livello di record, entrambi invisibili alla sola orchestrazione.
Il pattern di integrazione pratico è semplice. L'orchestratore emette metadati di esecuzione e segnali di contratto, poi un livello di data observability consuma questi segnali e verifica arrivo, struttura e qualità prima che gli utenti a valle vedano il risultato. Questa separazione è particolarmente importante nei deployment private cloud e on-prem, dove le analisi devono avvenire all'interno dell'ambiente del cliente e il fornitore non ottiene accesso diretto ai dataset di produzione.
Regola pratica: lasciate che sia l'orchestrazione a decidere se la pipeline è stata eseguita, e che sia l'observability a decidere se i dati meritano di essere pubblicati.
È anche il punto in cui i team evitano una falsa sicurezza. Un DAG verde non è la stessa cosa di un dataset affidabile. Se la tabella sorgente è in ritardo, se lo schema è cambiato o se un record viola una regola di business, la risposta giusta è fermare la promozione o mettere in quarantena l'output, non congratularsi con lo scheduler per aver finito in tempo.
Esempi di architettura enterprise che potete adattare
Un'architettura utile parte da dove vivono i dati, non dallo strumento che volete usare. Negli ambienti cloud-native, l'orchestratore spesso avvia le trasformazioni, emette metadati e passa i risultati a un livello di observability che sorveglia freschezza, schema e anomalie. Negli ambienti regolamentati, lo stesso pattern deve di solito girare all'interno di un'infrastruttura controllata dal cliente.
Lakehouse cloud-native
In uno stack lakehouse, i sistemi sorgente depositano i dati in un object storage o in un'area di staging del warehouse. L'orchestratore coordina il passaggio di trasformazione, poi emette metadati sull'esecuzione, sugli input e sulla tabella o partizione di output. Sono questi metadati che gli strumenti di observability usano per tracciare freschezza e lineage.
L'abitudine progettuale importante è non trattare l'orchestratore come l'unica fonte di verità. Dovrebbe produrre segnali leggibili dal monitoraggio a valle, mentre il livello di qualità convalida il risultato in modo indipendente.
Private cloud e on-prem
Le architetture on-prem hanno bisogno dello stesso flusso di controllo, ma con un perimetro più stretto. L'orchestratore e la piattaforma di observability devono girare all'interno di ambienti controllati dal cliente, e i dati di produzione devono restare residenti lì. È per questo che piattaforme come digna sono progettate per eseguire le analisi all'interno del database del cliente, così che tempestività, modifiche di schema, anomalie e validazione a livello di record restino all'interno del perimetro.
Il pattern si applica anche alle pipeline di ML. Generazione delle feature, orchestrazione del training, promozione nel model registry e deployment richiedono tutti passaggi di consegna controllati. Se il passaggio non è affidabile, il modello eredita la stessa fragilità del warehouse.
Una buona progettazione enterprise rende esplicito il passaggio di consegna. Una debole presume che un job riuscito significhi che il livello successivo possa consumare il risultato in sicurezza.
KPI, pratiche di runbook e come si presenta un buon risultato
Una configurazione di orchestrazione affidabile va misurata, non ammirata. I KPI più importanti sono freschezza, tasso di successo, tasso di retry, tempo medio di rilevamento e numero di violazioni degli SLA. La freschezza riflette di solito observability e tempestività. Tasso di successo e tasso di retry riflettono la stabilità della pipeline. Tempo medio di rilevamento e violazioni degli SLA mostrano se gli operatori riescono a vedere i problemi abbastanza presto da agire.
KPI | Cosa misura | Aspetto operativo | Dove guardare |
|---|---|---|---|
Freschezza | Quanto sono aggiornati i dati | Observability | Controlli di arrivo, finestre di consegna |
Tasso di successo | Quanto spesso le esecuzioni si completano senza errori | Scalabilità | Storico delle esecuzioni dell'orchestratore |
Tasso di retry | Quanto spesso i task richiedono un altro tentativo | Affidabilità | Log dei task e pattern di guasto |
Tempo medio di rilevamento | Con quanta rapidità notate un problema | Observability | Alert e dashboard delle anomalie |
Numero di violazioni degli SLA | Quanto spesso la consegna manca la finestra concordata | Tempestività | Stato degli SLA e report di esecuzione |
Prima di un backfill, verificate l'intervallo di date interessato, le dipendenze a monte e se i consumatori a valle hanno bisogno di una pausa coordinata. Dopo un guasto, controllate il primo task fallito, la forma dei dati a monte e se il problema è transitorio o strutturale. Se sta per arrivare una modifica dello schema, introducetela con controlli di contratto e validazione già attivi, non dopo che la dashboard si è rotta.
I team che restano fuori dai guai fanno alcune cose con costanza. Mantengono separate orchestrazione e observability. Limitano il raggio d'impatto nei deployment on-prem e private cloud. Rendono i retry intenzionali, non automatici. E mantengono i dati di produzione all'interno dell'ambiente in cui la policy dice che devono stare.
Se le vostre pipeline si basano ancora su passaggi di consegna fragili, alert mancanti o uno scheduler che non sa spiegare cosa si è rotto, digna si inserisce naturalmente in questa lacuna. Gira all'interno di ambienti controllati dal cliente, sorveglia insieme tempestività, modifiche di schema, anomalie e validazione, e offre ai team un modo per confermare che una pipeline orchestrata ha prodotto dati affidabili. Visitate digna se volete confrontare questo modello con lo stack che utilizzate oggi.
Poiché un DAG verde può comunque consegnare i dati troppo tardi per la dashboard che alimenta, digna Timeliness verifica l'arrivo dei dati rispetto alle finestre di consegna previste accanto al vostro orchestratore.
Domande frequenti
Che cos'è l'orchestrazione delle pipeline?
L'orchestrazione delle pipeline è il livello di controllo che decide quando, in quale ordine e a quali condizioni viene eseguito ogni passaggio della pipeline. Impone le dipendenze, gestisce i guasti e monitora l'esecuzione, collocandosi sopra motori come Spark, dbt o job nativi del warehouse e sotto la logica di business che dipende da dati affidabili.
Qual è la differenza tra uno scheduler e un orchestratore?
Uno scheduler avvia i job in base a un timer, mentre un orchestratore tiene traccia di stato, dipendenze e gestione dei guasti. Sa cosa è stato eseguito, cosa è bloccato, cosa può essere ritentato in sicurezza e cosa deve attendere una partizione a monte in ritardo, così un'estrazione fallita blocca il lavoro a valle invece di produrre una tabella parziale.
Quando conviene usare retry, backfill e sensori?
Usate i retry per i guasti transitori, non per nascondere un passaggio che fallisce ogni notte. I backfill ricalcolano solo le partizioni interessate dai dati arrivati in ritardo invece di rieseguire l'intero grafo. I sensori attendono un file, un oggetto o un altro segnale esterno prima di avviare il lavoro a valle, collegando l'orchestrazione basata sul tempo e quella event-driven.
Perché l'orchestrazione da sola non basta per avere dati affidabili?
L'orchestrazione può confermare che un caricamento è terminato, ma non se è terminato con dati errati. Arrivi in ritardo, modifiche di schema come il cambio di tipo di una colonna, anomalie nelle distribuzioni e violazioni delle regole a livello di record possono tutti attraversare un DAG verde, quindi dovrebbe essere un livello di observability separato a decidere se i dati meritano di essere pubblicati.
Quali KPI conviene monitorare per l'orchestrazione delle pipeline?
L'articolo ne raccomanda cinque: freschezza, tasso di successo, tasso di retry, tempo medio di rilevamento e numero di violazioni degli SLA. La freschezza riflette observability e tempestività, i tassi di successo e di retry riflettono la stabilità della pipeline, e il tempo medio di rilevamento insieme alle violazioni degli SLA mostrano se gli operatori vedono i problemi abbastanza presto da agire.


