Monitoraggio dei dati in tempo reale: guida agli elementi essenziali e alle best practice
|
6
min di lettura

Probabilmente state osservando lo stesso schema in cui si imbattono molti team dati quando la piattaforma matura. Le pipeline terminano in orario. L'orchestrazione è verde. Le dashboard si aggiornano. Poi qualcuno del finance, delle operations o del team ML chiede perché un numero chiave è cambiato, perché un segmento è sparito o perché un modello ha iniziato a prendere decisioni sbagliate. L'infrastruttura dice “sano”, ma il data product è già sbagliato.
È in questo divario che conta il monitoraggio dei dati in tempo reale. Non come una funzionalità appariscente della dashboard, né come l'ennesimo flusso di alert rumorosi, ma come un modo per intercettare i problemi mentre i dati stanno ancora attraversando il sistema. Negli ambienti regolamentati c'è un secondo requisito che la maggior parte delle guide sfiora appena. Questa visibilità vi serve senza inviare dati sensibili a un ambiente controllato dal fornitore.
I team del settore sanitario, finanziario, delle telecomunicazioni e della pubblica amministrazione non possono scegliere tra velocità e privacy. Devono garantire entrambe.
Indice
Quando la pipeline di dati sembra sana ma sta fallendo in silenzio
Le principali architetture di monitoraggio e i loro compromessi
Quando la pipeline di dati sembra sana ma sta fallendo in silenzio
Una modalità di guasto comune, all'inizio, sembra noiosa.
I job di ingestion sono stati eseguiti. Il lag di Kafka è rimasto entro i limiti normali. Airflow, Dagster o lo scheduler gestito hanno segnato i task come completati con successo. Il warehouse ha partizioni aggiornate. Eppure la dashboard delle vendite perde una regione, oppure un modello antifrode inizia ad assegnare punteggi troppo aggressivi, oppure un report per il management mostra il valore di ieri con il timestamp di oggi. Nessuno vede il problema finché non lo vede un utente business.
È questo il punto debole dei controlli a posteriori. I workflow tradizionali di data quality spesso validano i dati a riposo, dopo il caricamento, dopo la trasformazione o dopo che un report si è rotto. Sono utili, ma non vi dicono cosa sta succedendo durante il transito. Quando qualcuno apre un ticket, la fiducia è già compromessa.
Perché le pipeline di dati falliscono in produzione e come rilevare i problemi in anticipo è un buon esempio di questa realtà produttiva. La maggior parte dei guasti non sono crash clamorosi. Sono cambiamenti sottili che attraversano una pipeline dall'aspetto sano senza far scattare allarmi operativi.
Un'infrastruttura verde può comunque trasportare dati errati
La lezione più dura è che lo stato della pipeline e lo stato dei dati sono due cose diverse. Un task può completarsi con successo mentre elabora payload incompleti, timestamp spostati, eventi duplicati o record strutturalmente validi ma semanticamente sbagliati.
Oggi questo conta ancora di più perché il 63% dei casi d'uso aziendali richiede l'elaborazione dei dati entro pochi minuti per essere utile a livello operativo, secondo dati IDC 2025 citati da Fortune Business Insights. Se la finestra utile si misura in minuti, aspettare una riconciliazione di fine giornata non è un approccio operativo serio.
Il monitoraggio in tempo reale inizia a ripagare prima che una dashboard diventi rossa. Ripaga quando i dati sbagliati non raggiungono mai la dashboard.
Cosa sfugge di solito ai team
I primi problemi a sfuggire raramente sono interruzioni totali. Di solito si tratta di cose come:
Dati in ritardo che finiscono comunque nella stessa partizione e sembrano attuali.
Variazioni inattese della distribuzione che restano entro ampi intervalli storici ma violano i presupposti a valle.
Picchi di valori null a livello di campo nascosti all'interno di tabelle per il resto valide.
Modifiche silenziose dello schema che non rompono l'ingestion ma rompono i consumatori.
Se monitorate solo il successo dei job, la crescita dello storage e la disponibilità delle dashboard, vi sfuggirà il problema che conta davvero. Il monitoraggio dei dati in tempo reale colma questo divario controllando freschezza, tempestività, drift e struttura mentre la pipeline è ancora abbastanza attiva da permettere agli ingegneri di intervenire.
Cosa significa davvero monitoraggio dei dati in tempo reale
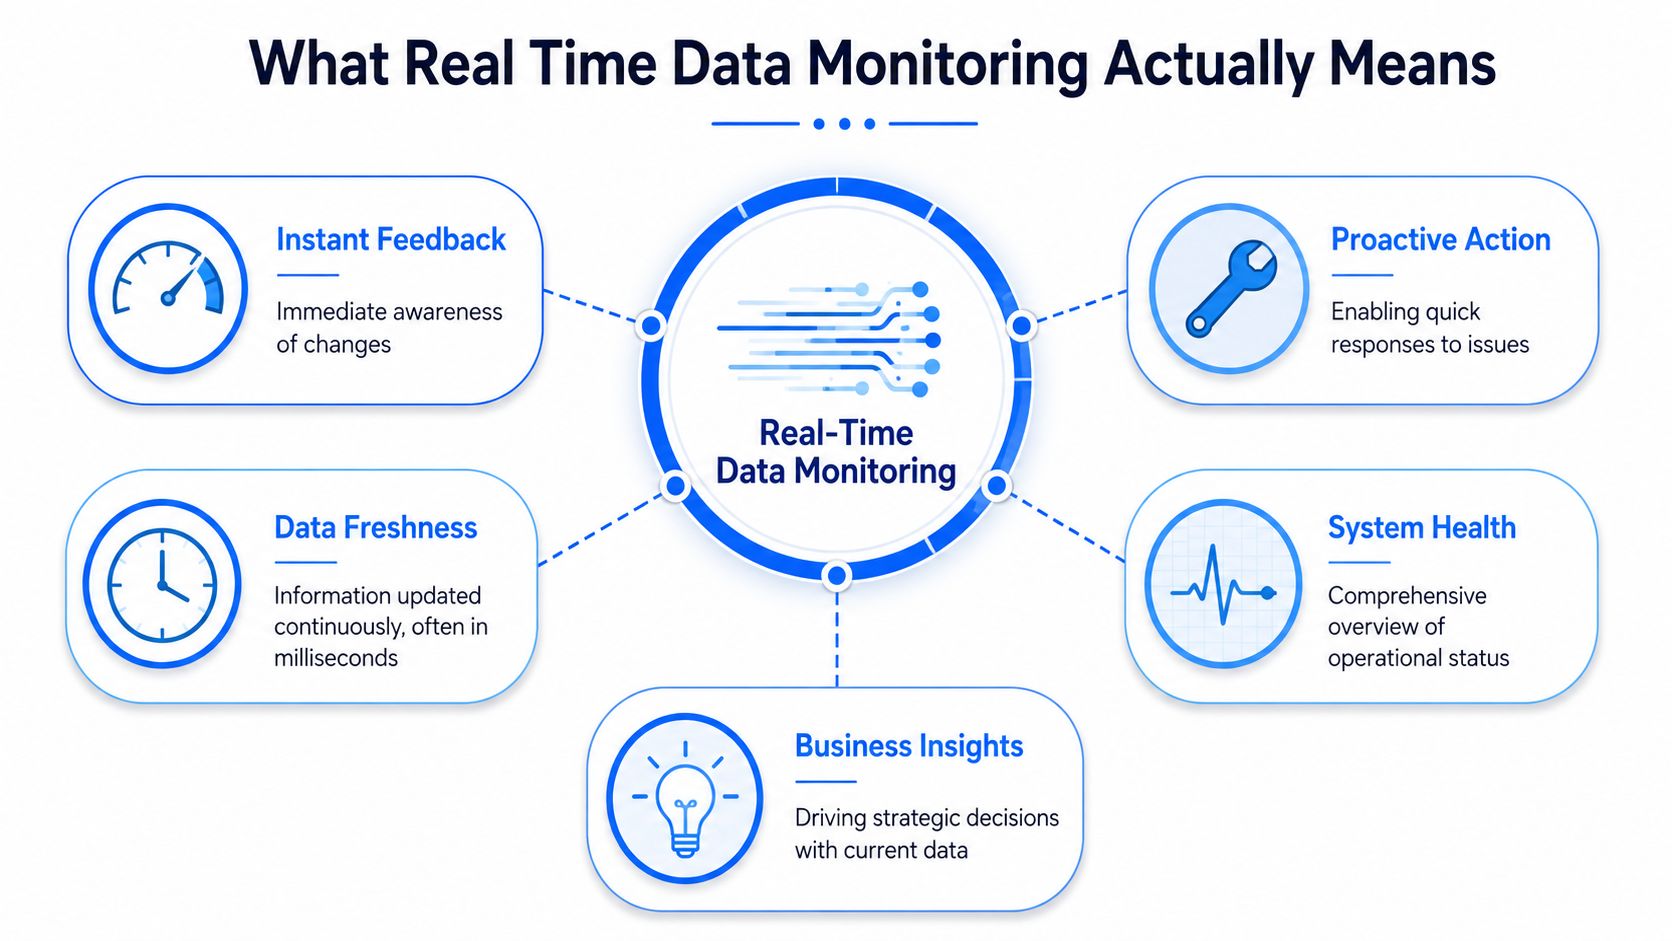
I team usano spesso il termine “tempo reale” in modo approssimativo. E questo porta a decisioni architetturali sbagliate.
Un'analogia migliore è il cruscotto di un'auto rispetto al rapporto del meccanico. Il cruscotto vi dice in questo momento se il motore si sta surriscaldando o se il carburante è in riserva. Il rapporto del meccanico vi dice cosa non andava dopo l'ispezione. Entrambi contano, ma solo uno vi aiuta a reagire mentre state ancora guidando.
Tempo reale effettivo e quasi tempo reale
Non tutti i casi d'uso di monitoraggio richiedono lo stesso obiettivo di latenza. È qui che i team tendono a sovradimensionare.
L'elaborazione dei dati in tempo reale produce output con una latenza di secondi o millisecondi. Il tempo reale effettivo indica risposte al di sotto del secondo per casi come il rilevamento delle frodi. Il quasi tempo reale copre da alcuni secondi ad alcuni minuti, il che di solito è sufficiente per le dashboard di analytics e il monitoraggio operativo, come illustrato nella panoramica di Splunk sull'elaborazione dei dati in tempo reale.
In pratica:
Usate il tempo reale effettivo quando il sistema deve reagire immediatamente. Pensate a pagamenti, eventi di sicurezza o protezione dei macchinari.
Usate il quasi tempo reale quando le persone prendono decisioni operative a partire da una dashboard live.
Non imponete lo stream processing ovunque se il business può tollerare un ritardo nell'ordine dei minuti.
Molti sprechi nascono dal trattare ogni tabella come se alimentasse il rilevamento delle frodi.
Il ciclo di monitoraggio di base
Il monitoraggio dei dati in tempo reale prevede di solito quattro livelli che lavorano insieme:
Ingestion
Gli eventi arrivano da app, API, sensori, flussi CDC o aggiornamenti del warehouse.Elaborazione
Un livello di streaming filtra il rumore, calcola aggregati, esegue join con i dati di riferimento e valuta le anomalie man mano che i dati arrivano.Stato e storage
Serve un luogo in cui conservare metriche, finestre recenti e contesto storico per il confronto.Azione
Il sistema aggiorna una dashboard, apre un incidente, invia una notifica o blocca un'azione errata a valle.
Il punto importante non è il marchio dello strumento. È il ciclo di feedback. Un sistema di monitoraggio è in tempo reale solo se riesce a rilevare, valutare e far emergere un problema quando c'è ancora tempo per agire.
Una breve panoramica aiuta a fissare l'architettura:
Cosa viene spesso confuso con il monitoraggio
Una dashboard di BI non è la stessa cosa del monitoraggio. Una dashboard presenta metriche. Il monitoraggio stabilisce se quelle metriche indicano un problema e se qualcuno deve intervenire.
Regola pratica: se il vostro team viene a sapere di un problema nei dati da uno stakeholder, avete un sistema di reporting. Non avete ancora un sistema di monitoraggio.
Questa distinzione è importante perché cambia il modo in cui progettate il sistema. Il reporting è ottimizzato per la visibilità. Il monitoraggio è ottimizzato per un intervento tempestivo.
Le principali architetture di monitoraggio e i loro compromessi
Le scelte architetturali per il monitoraggio dei dati in tempo reale sono per lo più compromessi. Latenza, costi, controllo, privacy e complessità operativa spingono in direzioni diverse. Non esiste un pattern migliore in assoluto.
Stream processing e micro-batching
La prima decisione riguarda di solito se elaborare in modo continuo o a brevi intervalli.
Lo stream processing è la scelta giusta quando il segnale di monitoraggio perde rapidamente valore. Gli eventi vengono elaborati man mano che arrivano con strumenti come Apache Flink, Spark Structured Streaming, Kafka Streams o Apache Beam. Si ottiene una latenza più bassa, ma ci si fa carico anche di una maggiore gestione dello stato, della logica di ordinamento e della complessità di runtime.
Il micro-batching è spesso sufficiente per i team incentrati sul warehouse. Si elabora ogni minuto o ogni pochi minuti, spesso con un'orchestrazione più semplice e costi inferiori. Lo svantaggio è evidente: i problemi si vedono solo al confine del batch.
Ecco la visione pratica.
Approccio | Ideale per | Latenza | Sicurezza e privacy |
|---|---|---|---|
Stream processing | Alert operativi, telemetria dei macchinari, eventi di prodotto in rapida evoluzione | Da secondi a millisecondi | Dipende da dove avviene l'elaborazione e dal fatto che i dati grezzi lascino o meno l'ambiente |
Micro-batching | Monitoraggio del warehouse, controlli di freschezza delle dashboard, data product ricorrenti | Da secondi a minuti | Spesso più facile da mantenere all'interno dell'infrastruttura controllata esistente |
Monitoraggio SaaS esterno | Configurazione rapida, ampie integrazioni, minore carico operativo interno | Varia in base al design del prodotto | Può entrare in conflitto con requisiti rigorosi di residenza dei dati o di accesso da parte di terzi |
Esecuzione in-database | Dati regolamentati, monitoraggio nativo nel warehouse, governance rigorosa | Spesso quasi in tempo reale, a seconda di capacità di calcolo e schedulazione | Ideale quando i dati devono restare nell'ambiente del cliente |
SaaS esterno ed esecuzione in-database
Per i settori regolamentati, di solito è questa la vera decisione.
Le piattaforme di monitoraggio esterne possono essere adottate rapidamente. Possono offrire interfacce curate, molti connettori e un onboarding più semplice per i team che hanno bisogno di copertura in fretta. Ma spesso richiedono di inviare metadati, campioni o persino payload di dati più ampi verso un ambiente controllato dal fornitore. È lì che le revisioni di sicurezza si bloccano.
Un modello in-database o in-environment ribalta lo schema. L'analisi viene eseguita dove i dati risiedono già: nel vostro warehouse, lakehouse, private cloud o stack on-premises. Questo riduce gli spostamenti dei dati e semplifica il discorso sulla privacy, ma può richiedere maggiore disciplina nell'implementazione, perché bisogna riflettere con più attenzione su dove collocare il calcolo, sui permessi e sulla responsabilità operativa.
Data observability e data quality è l'inquadramento giusto, perché il compromesso non riguarda solo la visibilità. Riguarda la possibilità che l'observability coesista con la governance invece di aggirarla.
Cosa funziona nella pratica
Per la maggior parte dei team enterprise, l'architettura che supera il procurement e la revisione di sicurezza ha queste caratteristiche:
La logica di monitoraggio viene eseguita vicino ai dati, così gli ingegneri non devono duplicare dataset sensibili.
Le metriche vengono calcolate su archivi governati invece di esportare all'esterno ampi flussi di dati grezzi.
Solo alert, riepiloghi e metadati di indagine escono dall'ambiente, quando necessario.
Tracciamento degli schemi e rilevamento delle anomalie condividono il contesto, così i team non hanno bisogno di strumenti separati per ogni modalità di guasto.
Una configurazione rapida è allettante. Ma se il design richiede eccezioni al vostro modello di privacy, non sopravvivrà alla produzione in un ambiente regolamentato.
L'architettura migliore è quella che i vostri ingegneri possono gestire, il vostro team di sicurezza può approvare e il vostro business può considerare affidabile quando qualcosa di sottile si rompe alle 2 di notte.
Le metriche fondamentali da monitorare
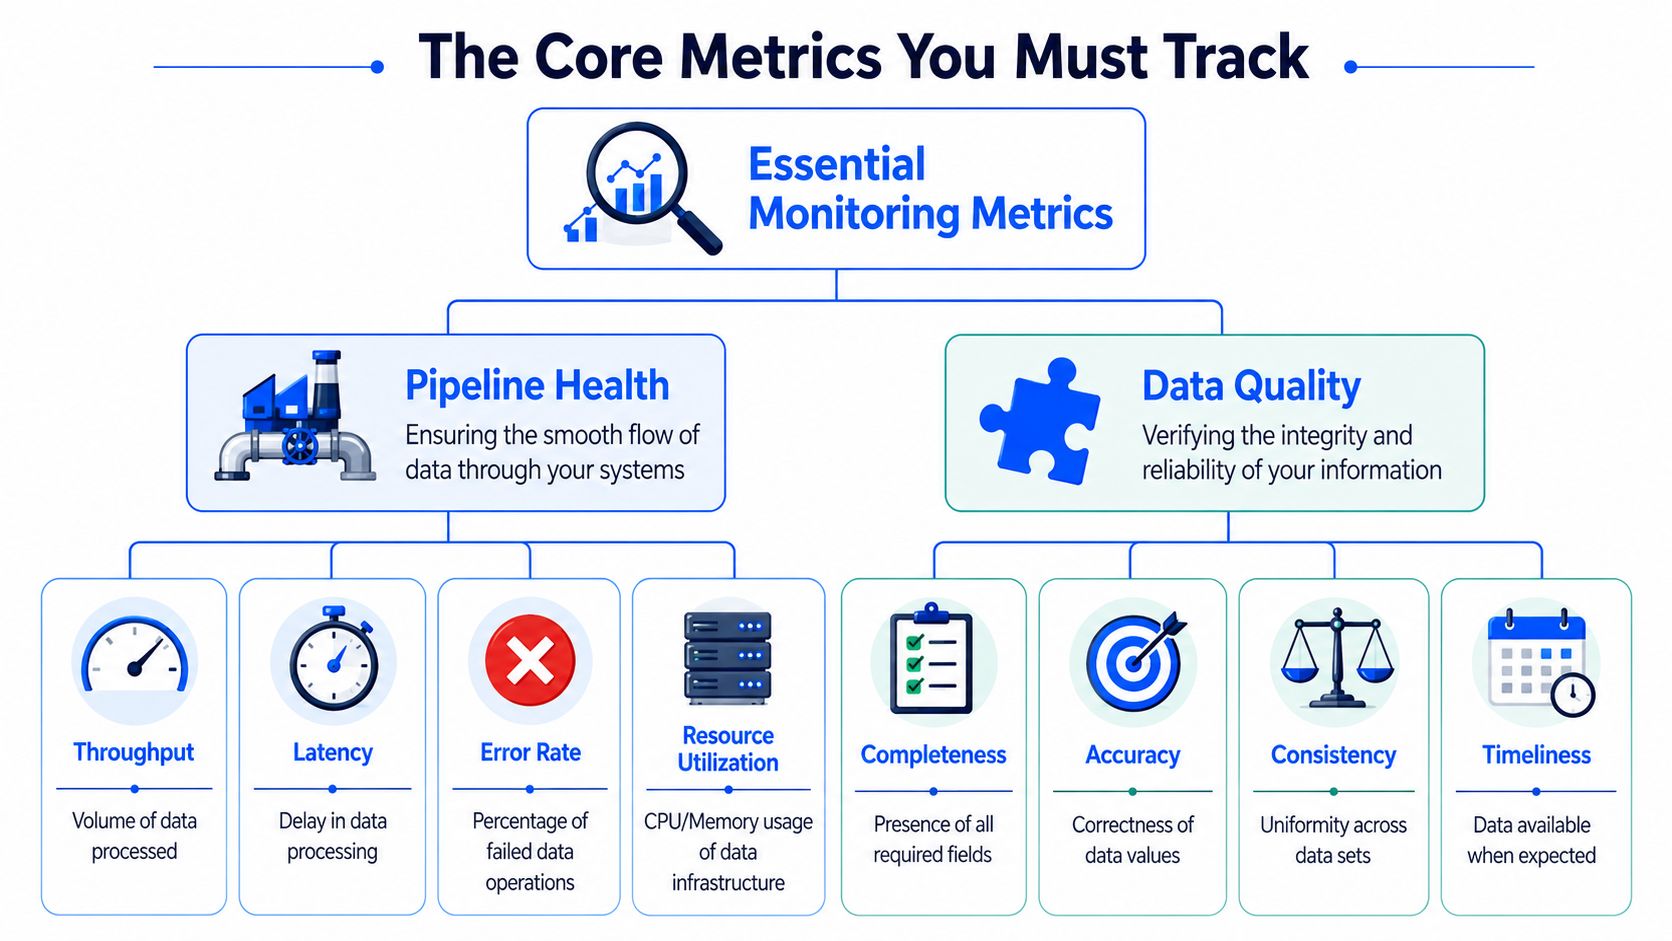
I team raccolgono spesso troppe metriche infrastrutturali e troppo pochi segnali sui dati. Il monitoraggio dei dati in tempo reale diventa utile quando si separa lo stato della pipeline dallo stato dei dati e si trattano entrambi come prioritari.
Segnali sullo stato della pipeline
Questi segnali vi dicono se il sistema sta spostando i dati quando e come dovrebbe.
La freschezza conta perché il “dato più recente disponibile” è spesso ciò che interessa agli utenti a valle. Una tabella può essere popolata e comunque obsoleta.
La tempestività misura se i dati sono arrivati quando il business se li aspettava, non solo se esistono. Il monitoraggio della tempestività nella pratica è utile perché i pattern di arrivo attesi sono spesso più informativi di un semplice timestamp di “ultimo aggiornamento”.
La latenza vi dice quanto dura il percorso dall'evento alla sorgente fino all'output utilizzabile.
Il throughput aiuta a individuare cali, picchi o colli di bottiglia nel flusso di eventi.
Il comportamento degli errori dovrebbe includere scritture fallite, retry, volume della dead-letter queue e consumer lag, dove rilevante.
Queste metriche rispondono a una domanda di base: la piattaforma è in grado di consegnare il data product in tempo?
Segnali sullo stato dei dati
Questi segnali vi dicono se i contenuti restano affidabili una volta consegnati.
Le anomalie di volume sono la parte facile. Un calo improvviso del numero di righe si rileva senza difficoltà. La parte più difficile è intercettare cambiamenti che sembrano ancora accettabili dal punto di vista strutturale ma ne alterano il significato.
Ecco perché lo schema drift merita un posto a sé. Un punto cieco critico nel monitoraggio in tempo reale è lo schema drift. Il 58% dei team dati aggiorna manualmente le regole per adattarle alle nuove pipeline, le baseline basate sull'AI possono ridurre l'alert fatigue del 65% e solo il 15% di questi sistemi avanzati rileva anche in tempo reale cambiamenti strutturali come colonne aggiunte o modifiche di tipo, secondo l'analisi di Streamkap sui casi d'uso delle analytics in tempo reale.
La lista essenziale su cui insisterei
Se un team parte da zero, richiederei il monitoraggio di:
Comportamento di arrivo per le tabelle e i flussi critici.
Drift della distribuzione sui campi numerici e categoriali importanti.
Variazioni di null e completezza sulle colonne obbligatorie.
Modifiche dello schema, inclusi campi aggiunti, rimossi o con tipo modificato.
Integrità dei join per le relazioni di riferimento chiave.
Freschezza lato consumatore a livello di tabella pubblicata o di API.
Per i team applicativi, la stessa logica vale anche al di fuori del warehouse. Se vi serve un esempio concreto di strumentazione del comportamento degli aggiornamenti, questa guida su come monitorare in tempo reale gli aggiornamenti delle app Capacitor è utile perché mostra come i segnali operativi diventino azionabili solo quando si monitorano insieme stato della consegna, errori e tempistiche.
Se guardate solo il numero di righe, intercetterete le interruzioni. Non intercetterete la corruzione dei dati.
È questa la linea di demarcazione. Il monitoraggio di base rileva l'assenza. Un buon monitoraggio rileva l'errore.
Progettare alert più intelligenti e SLA sui dati
Nessun sistema di monitoraggio fallisce per mancanza di alert. Fallisce perché le persone smettono di fidarsi degli alert.
La causa abituale sono le soglie statiche. Una regola fissa come “invia un alert se il volume scende sotto X” sembra sensata, ma ignora stagionalità, lanci di prodotto, cicli regionali e cambiamenti naturali di comportamento. Gli ingegneri finiscono per regolare le soglie a mano e poi silenziare gli alert a cui non credono.
Perché le baseline dinamiche funzionano meglio
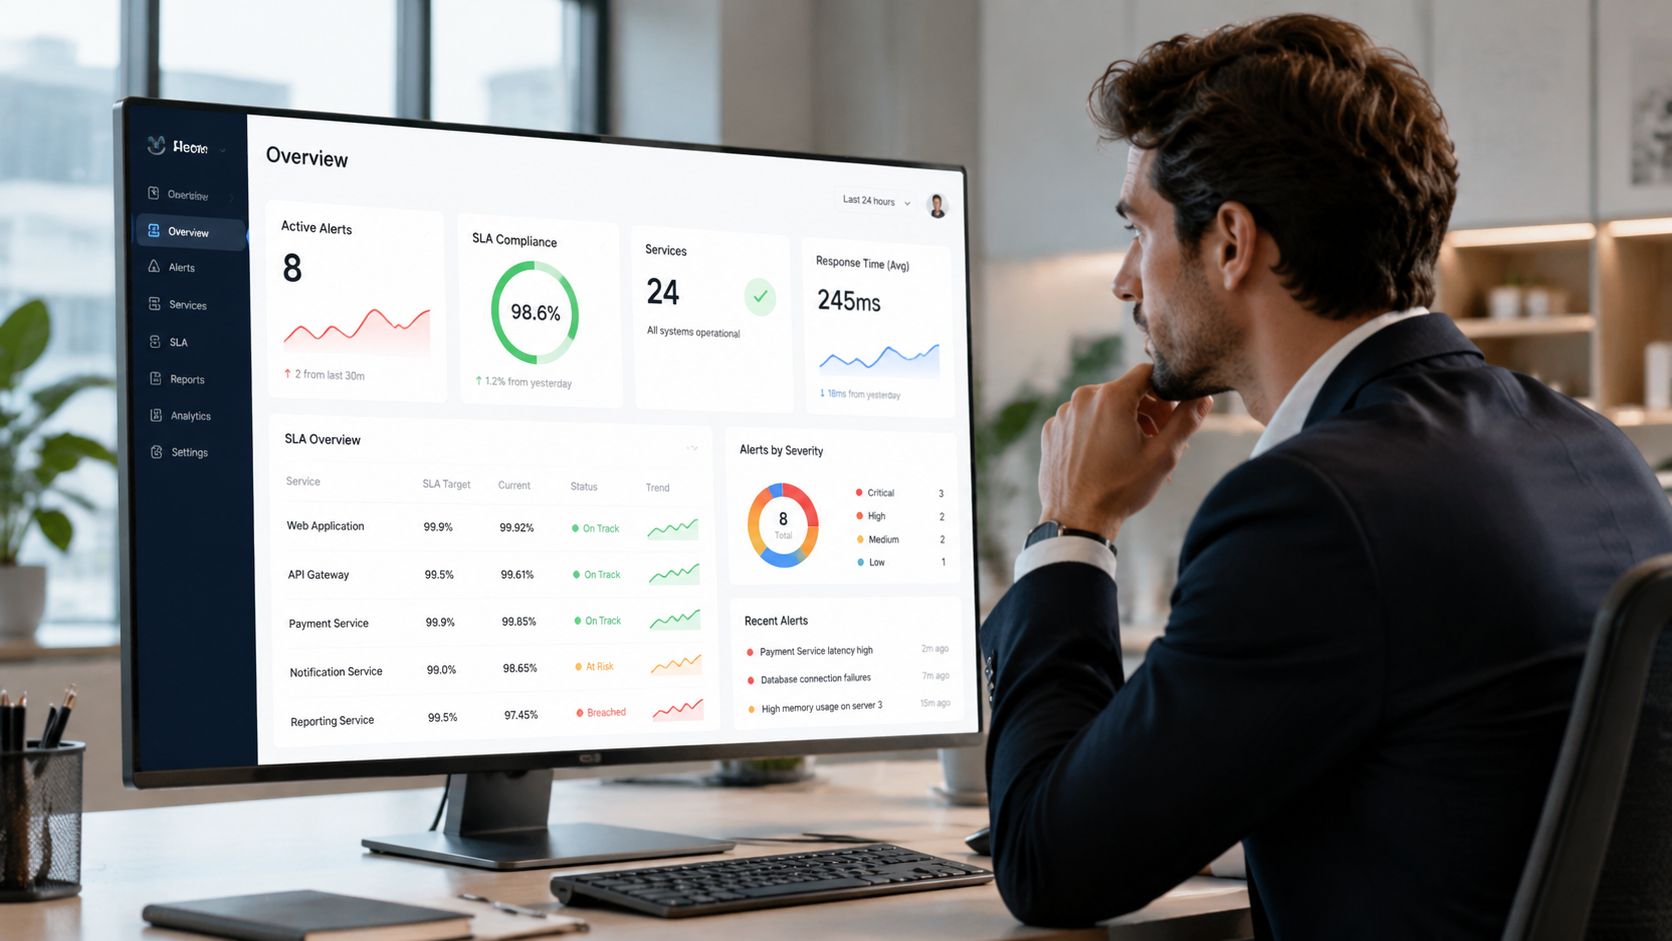
Un approccio più intelligente è l'apprendimento delle baseline. Il sistema impara qual è il comportamento normale di una metrica in un dato momento e in un dato pattern operativo, e invia un alert quando il comportamento si discosta in modo significativo. Questo riduce il rumore e rende gli alert rimanenti degni di essere letti.
Non è teoria. Nel monitoraggio della produzione in tempo reale, le architetture event-driven acquisiscono i cambiamenti di stato dei macchinari in millisecondi, il che consente aggiornamenti istantanei delle dashboard e notifiche mobili quando le soglie vengono superate, come descritto nella spiegazione di Symestic sul monitoraggio della produzione in tempo reale. La lezione operativa vale anche per le piattaforme dati. La velocità conta, ma alert utili contano ancora di più.
Cosa dovrebbe contenere un alert utile
Un buon alert dovrebbe rispondere immediatamente a quattro domande:
Cosa è cambiato
Dove è cambiato
Quanto è grave
Quali prodotti a valle sono esposti
Se l'alert dice solo “anomalia rilevata”, l'ingegnere deve ancora fare manualmente il triage iniziale. È tempo sprecato.
Trasformare gli alert in SLA
Il passo successivo è convertire i segnali di monitoraggio in SLA sui dati comprensibili per gli stakeholder.
Definite SLA su aspetti che le persone possono valutare:
SLA di freschezza per tabelle o dashboard pubblicate
SLA di tempestività per gli arrivi attesi
SLA di stabilità dello schema per i dataset sensibili ai contratti
SLA di qualità per i campi obbligatori o gli esiti delle validazioni
Non rendete tecnico ogni SLA. Ai team business non interessa il consumer lag, a meno che non modifichi la tempestività del data product che utilizzano.
Uno SLA sui dati dovrebbe descrivere l'esperienza su cui i consumatori possono contare, non la metrica interna che gli ingegneri si trovano a raccogliere.
Questo cambio di prospettiva è importante. Il monitoraggio è interno. Gli SLA sono promesse. Se segnali e promesse non sono allineati, sia l'engineering sia il business perdono fiducia.
Come scegliere e rendere operativa una soluzione
La selezione degli strumenti va male quando i team valutano solo il numero di connettori, la cura delle dashboard o la rapidità con cui riescono a far girare una demo. Sono aspetti importanti, ma non sono la parte difficile. La parte difficile è capire se la soluzione si adatta alla vostra architettura, al vostro modello di governance e alle vostre abitudini operative.
Partire dai requisiti irrinunciabili
Nel settore finanziario e sanitario, di solito è la privacy a decidere la shortlist, prima ancora delle funzionalità. Oltre il 70% delle aziende del settore finanziario e sanitario rifiuta l'accesso di terzi ai dati per l'observability in tempo reale. Il 62% dei nuovi strumenti di data quality offre l'esecuzione in-database, ma solo il 12% la combina con l'apprendimento delle baseline basato sull'AI, secondo l'analisi citata sull'observability in ambienti privati.
Questo dice qualcosa di importante. “Viene eseguito nel vostro ambiente” e “supporta il rilevamento moderno delle anomalie” ancora non vanno spesso di pari passo. Se vi servono entrambi, dovete verificarlo presto.
Valutare il modello operativo, non solo il prodotto
Ponete domande pratiche:
Dove viene eseguito il calcolo
Nel vostro warehouse, nel vostro VPC, on-premises o nel cloud del fornitore?Cosa esce dal vostro ambiente
Righe grezze, metadati, campioni, metriche o solo alert?Come rileva le anomalie
Solo regole statiche, baseline apprese o entrambe?È in grado di monitorare la struttura oltre ai valori
Molti strumenti gestiscono male il drift quando lo schema cambia.Chi è responsabile delle operations quotidiane
Data engineering, team di piattaforma, governance o un modello condiviso?
Se il vostro team monitora anche sistemi rivolti ai clienti oltre alla piattaforma dati, contano anche gli strumenti operativi adiacenti. Ad esempio, quando dovete diagnosticare problemi di deliverability delle email, i prodotti utili sono quelli che espongono chiaramente i segnali sulla causa radice invece di limitarsi a riportare invii e aperture. Lo stesso criterio vale qui.
Un pattern di deployment adatto ai team regolamentati
Per gli ambienti regolamentati, il pattern più difendibile è di solito:
Calcolare le metriche dove risiedono i dati.
Apprendere le baseline senza esportare i dati di produzione.
Esporre dashboard e incidenti attraverso un'interfaccia controllata.
Limitare l'accesso del fornitore al supporto software, non ai dataset.
Un'opzione in questa categoria è digna, che esegue le analisi all'interno dei database e degli ambienti privati del cliente, coprendo in un'unica piattaforma rilevamento delle anomalie, monitoraggio della tempestività, validazione e tracciamento degli schemi. Questo approccio è rilevante quando i team di sicurezza non approvano un ampio accesso esterno ai dati, ma l'engineering ha comunque bisogno di funzionalità di monitoraggio moderne.
Rendere operativa la soluzione è meno affascinante che sceglierla. Iniziate con alcune pipeline critiche, definite le responsabilità, collegate gli alert ai canali che gli ingegneri già usano e fate in modo che ogni alert corrisponda a un'azione. Se non c'è un'azione, non dovrebbe esserci un alert.
Domande frequenti
Il monitoraggio dei dati in tempo reale è la stessa cosa del reporting BI?
No. Il reporting BI mostra metriche agli utenti. Il monitoraggio valuta se il comportamento dei dati o della pipeline indica un problema e deve far scattare un'azione.
Serve un monitoraggio al di sotto del secondo ovunque?
No. Alcuni casi d'uso richiedono una risposta al di sotto del secondo. Molti no. Il monitoraggio quasi in tempo reale è sufficiente per buona parte dei workflow di warehouse e analytics.
Qual è la prima cosa da monitorare?
Iniziate dai data product che causano più problemi operativi quando sono in ritardo, obsoleti o errati. Di solito si tratta di dashboard per il management, tabelle di reporting finanziario, API rivolte ai clienti o dataset di input dei modelli.
Qual è la modalità di guasto più trascurata?
Lo schema drift è in cima alla lista, soprattutto quando l'ingestion continua ad andare a buon fine e i consumatori a valle falliscono senza che nessuno se ne accorga.
Riguarda solo i sistemi industriali o IoT?
No. Lo schema si presenta ovunque sia necessario agire rapidamente sui dati, dalle product analytics alla sanità. La scala è già ampia. Entro il 2027, il numero previsto di pazienti nel mondo che utilizzano soluzioni di monitoraggio remoto è di 115,5 milioni, secondo la raccolta di statistiche RPM di HealthArc. Un deployment di questo tipo dipende da un monitoraggio tempestivo e affidabile.
Da dove dovrebbe iniziare un team?
Scegliete una pipeline critica. Monitorate freschezza, tempestività, alcuni segnali di qualità e le modifiche dello schema. Indirizzate gli alert al team in grado di intervenire. Ottimizzate per l'azionabilità, non per il volume di alert.
Se il vostro team ha bisogno di un monitoraggio dei dati in tempo reale che funzioni all'interno di ambienti private cloud o on-premises, vale la pena valutare digna. È pensato per i team che hanno bisogno di rilevamento delle anomalie, monitoraggio della tempestività, validazione e tracciamento degli schemi senza concedere a un fornitore l'accesso ai dati di produzione.