Modellazione dei dati nel data warehouse: dai concetti alla produzione
|
11
min di lettura

Le vostre dashboard si caricano, ma nessuno si fida di loro. La finanza dice che i ricavi non tornano. Le operations vedono record mancanti. Gli analisti passano più tempo a spiegare perché una metrica si è mossa che a decidere cosa fare. Di solito è in quel momento che i team capiscono che il data warehouse non sta fallendo per la sintassi SQL o per gli strumenti di BI. Sta fallendo perché il modello sottostante non è mai diventato un sistema duraturo.
Una buona modellazione dei dati nel data warehouse trasforma dati operativi sparsi in qualcosa che le persone possono interrogare, comprendere e di cui possono fidarsi. Determina anche quanto saranno dolorosi i cambiamenti futuri. Un modello che appare pulito in un diagramma può comunque crollare sotto il peso di dati in ritardo, definizioni poco chiare, join lenti e schema drift. Un modello che funziona in produzione deve resistere a tutte queste pressioni contemporaneamente.
Indice
Perché la modellazione dei dati nel data warehouse è la base della vostra analisi
Principi di progettazione di un data warehouse ad alte prestazioni
Perché la modellazione dei dati nel data warehouse è la base della vostra analisi
Quando un team dice “i nostri dati sono disordinati”, il problema di fondo è di solito strutturale. Le tabelle riflettono il comportamento delle applicazioni invece del significato di business. Le metriche vengono calcolate in tre modi diversi. Le modifiche storiche vengono sovrascritte, quindi nessuno sa dire com'erano un cliente, un prodotto o un contratto in un momento precedente.
È qui che la modellazione dei dati nel data warehouse fa la differenza. Offre agli analisti un linguaggio stabile per descrivere il business. Invece di ricucire ordini grezzi, anagrafiche clienti, fatture e log di stato ogni volta che serve un report, il data warehouse mette a disposizione entità durature, join coerenti e definizioni condivise.
La fiducia si rompe prima delle pipeline
Una pipeline può terminare con successo e produrre comunque analisi sbagliate. I dati possono arrivare in orario, ma il modello può ancora nascondere duplicazioni, appiattire le relazioni in modo errato o cancellare lo storico che gli utenti a valle utilizzano per analisi dei trend e attività di audit.
La conseguenza pratica è semplice. I modelli scadenti generano discussioni. I buoni modelli generano decisioni.
Regola pratica: se un utente di business ha bisogno di un data engineer che gli spieghi ogni join di una dashboard, il modello è ancora troppo vicino ai sistemi sorgente.
Un solido modello di data warehouse svolge tre compiti contemporaneamente:
Crea coerenza: le definizioni di cliente, prodotto e ricavi smettono di cambiare da una dashboard all'altra.
Supporta l'analisi storica: i team possono rispondere non solo a che cosa è vero oggi, ma a che cosa era vero in un momento specifico.
Migliora la manutenibilità: gli ingegneri possono aggiungere nuove sorgenti e metriche senza riscrivere l'intero livello analitico.
La modellazione è una disciplina antica con conseguenze moderne
Il data warehousing non è nato con le piattaforme cloud. L'architettura che lo sostiene risale a decenni fa. La storia dell'architettura del data warehouse fa risalire la disciplina agli anni '80, quando fu sviluppato l'approccio di base per trasformare i dati operativi in sistemi di supporto alle decisioni. Quel cambiamento diede alle organizzazioni un modo per consolidare i dati provenienti da domini operativi separati e renderli utili all'analisi.
Il passaggio dallo storage orientato al mainframe ai data warehouse cloud e ibridi ha cambiato i dettagli implementativi, ma non ha eliminato la necessità di modellare. Ha alzato la posta in gioco. I data warehouse moderni devono assorbire più dati, più cambiamenti e più utenti, preservando al contempo il contesto storico.
Ecco perché i team che corrono direttamente all'ingestione e alle dashboard spesso si bloccano. Caricare i dati non equivale a organizzarli. Un data warehouse diventa utile solo quando il modello rispecchia il modo in cui il business pone le domande.
Scegliere il progetto: Star, Snowflake o Data Vault
Il modo più semplice per spiegare gli stili di modellazione è paragonarli alla progettazione di una biblioteca. Una biblioteca è organizzata per una consultazione rapida. Un'altra è organizzata per una catalogazione precisa. Una terza è costruita come un archivio, dove preservare la provenienza conta quanto il recupero.
I modelli di data warehouse fanno gli stessi compromessi.
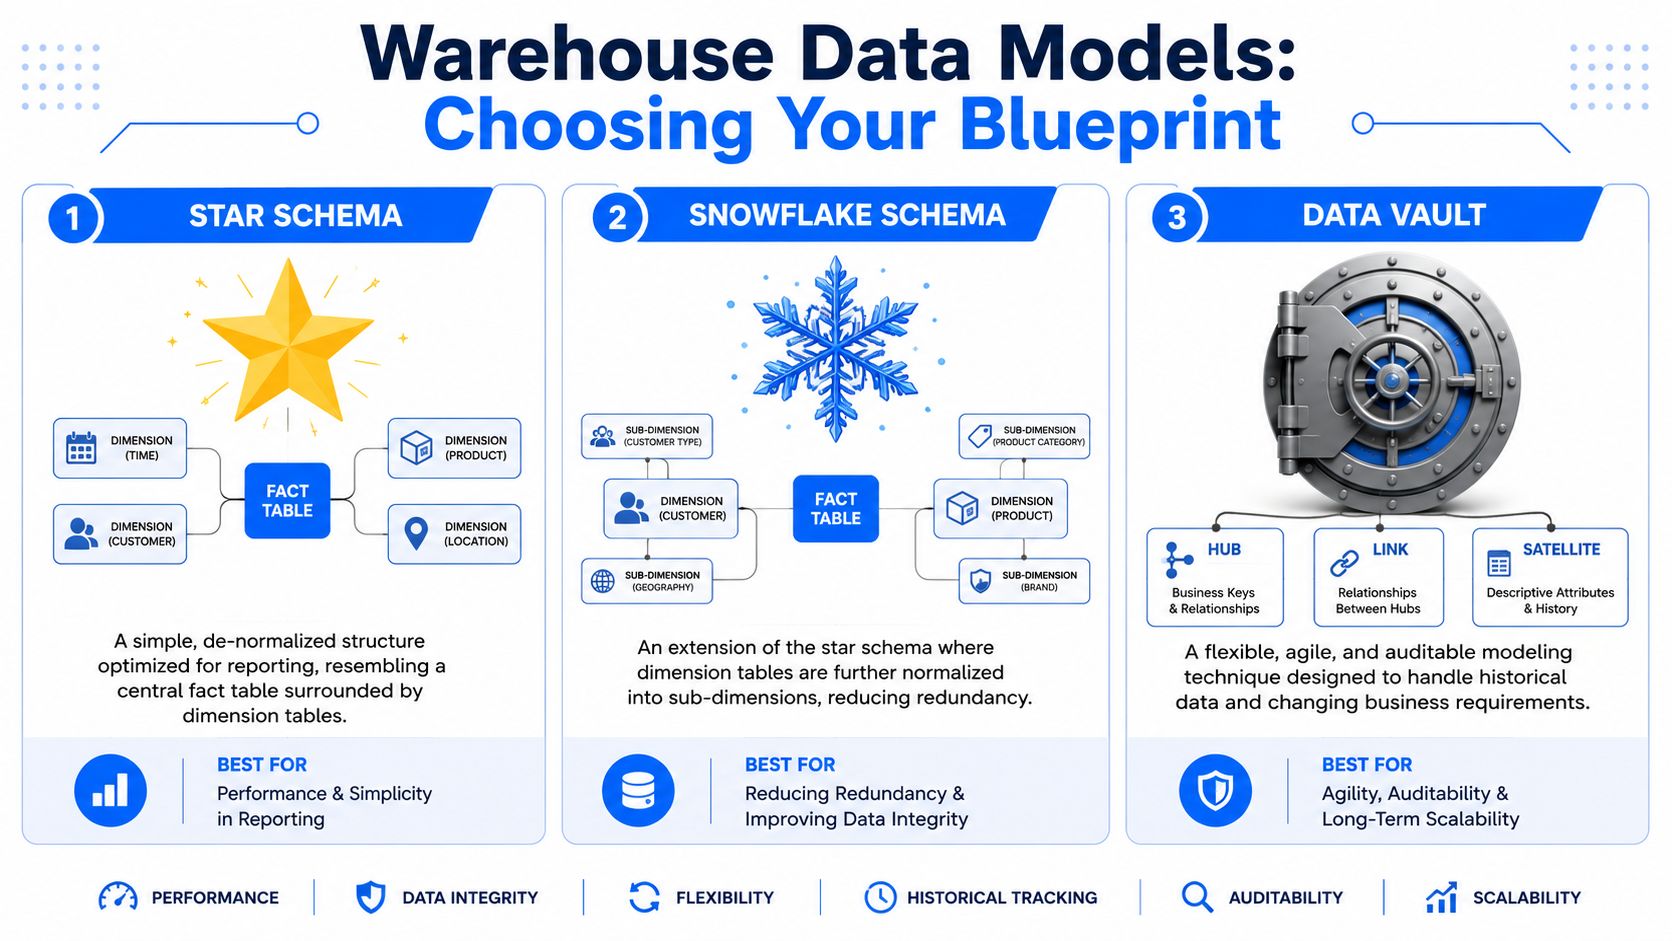
Pensate al modello come a una biblioteca
Uno Star Schema è la biblioteca facile da consultare. Una tabella dei fatti centrale contiene eventi misurabili come ordini, sinistri, visualizzazioni di pagina o fatture. Le tabelle delle dimensioni forniscono il contesto, ad esempio cliente, prodotto, regione e data. È facile da insegnare, facile da interrogare e di solito è la scelta giusta quando il carico di lavoro principale è la BI.
Uno Snowflake Schema parte dalla stessa idea dimensionale, ma normalizza alcune dimensioni in sotto-dimensioni. Il prodotto può suddividersi in tabelle di marchio, categoria e fornitore. La geografia può suddividersi in città, regione e paese. Si riduce la ridondanza, ma si aggiunge complessità nei join.
Un Data Vault è più vicino a un sistema di archiviazione. Separa chiavi di business stabili, relazioni e storico descrittivo in strutture distinte. Secondo la panoramica di ER/Studio sui pattern di modellazione del data warehouse, lo Star Schema domina quando contano semplicità e velocità, mentre il Data Vault non ha rivali per le aziende che operano in ambienti in rapido cambiamento e con requisiti normativi stringenti. La stessa fonte descrive il Data Vault come una struttura composta da hub per le entità di business principali, link per le relazioni e satellite per gli attributi descrittivi e lo storico delle modifiche.
Per i team che abbozzano le opzioni in forma visiva, un riferimento sui diagrammi di architettura dei dati può aiutare a chiarire come differiscono questi pattern quando si passa dalla lavagna all'implementazione.
Che cosa ottimizza ciascun pattern
Ecco che cosa funziona di solito nella pratica.
Lo Star Schema funziona meglio quando gli analisti hanno bisogno di report rapidi e prevedibili e il business può allinearsi su fatti e dimensioni chiari.
Lo Snowflake funziona meglio quando il riutilizzo delle dimensioni e una normalizzazione più rigorosa contano più della semplicità per gli analisti.
Il Data Vault funziona meglio quando i sistemi sorgente cambiano spesso, la provenienza conta e preservare lo storico grezzo è essenziale.
I modelli 3NF sono più adatti quando serve fedeltà operativa in un livello di integrazione centrale, ma di solito richiedono un ulteriore livello di presentazione prima che la maggior parte degli analisti possa usarli comodamente.
La trappola è scegliere in base all'ideologia. Molti team scelgono il Data Vault perché suona “enterprise”, poi scoprono di aver comunque bisogno di data mart dimensionali per il reporting. Altri appiattiscono tutto in schemi a stella troppo presto e se ne pentono quando i sistemi a monte cambiano ogni trimestre.
Star per l'usabilità. Snowflake per una normalizzazione più rigorosa. Data Vault per adattabilità e verificabilità.
Un'architettura pratica spesso combina più pattern. I livelli raw e core possono preservare la fedeltà alla sorgente e lo storico delle modifiche. I data mart rivolti all'analisi possono comunque presentare uno star schema, perché è ciò che gli strumenti di BI e gli analisti utilizzano più facilmente.
A questo punto è utile vedere i compromessi in concreto:
Approcci di modellazione dei dati a confronto
Criterio | Star Schema | Snowflake Schema | Data Vault |
|---|---|---|---|
Prestazioni delle query | Di solito elevate per le query di BI perché i join sono semplici | Può essere più lento da navigare perché le dimensioni sono più normalizzate | Forte per provenienza e pattern di ingestione, ma di solito non è la forma finale per il reporting |
Usabilità per gli analisti | Alta. Gli utenti di business lo comprendono rapidamente | Media. Più join e passaggi tra tabelle | Più bassa per gli utenti self-service, a meno di costruirci sopra dei data mart |
Efficienza dello storage | Inferiore rispetto ai design più normalizzati | Migliore dello star in alcune dimensioni perché la ridondanza è ridotta | Variabile, spesso con più tabelle e più record storici |
Flessibilità al cambiamento | Media | Media | Alta |
Tracciamento storico | Buono se modellato in modo consapevole | Buono se modellato in modo consapevole | Eccellente per progettazione |
Governance e verificabilità | Buone, dipendono dalla disciplina | Buone | Elevate |
Complessità di implementazione | Più bassa | Media | Alta |
La decisione dovrebbe dipendere dal vostro carico di lavoro, non dalle mode. Se i dirigenti hanno bisogno ogni mattina di dashboard KPI affidabili, partite dalla forma che rende semplici quelle query. Se sono autorità di regolamentazione, revisori o programmi ad alta intensità di integrazione a guidare il design, ottimizzate prima per la provenienza e per un cambiamento controllato.
Principi di progettazione di un data warehouse ad alte prestazioni
Un modello di data warehouse può usare pattern diversi e fallire comunque per le stesse ragioni. I punti di rottura più comuni sono quasi sempre strategici. Granularità sbagliata. Design centrato sulle sorgenti. Nomenclatura poco chiara. Nessun piano per la crescita. Nessuna responsabilità sulle definizioni.

Partite dai processi di business, non dai sistemi sorgente
Il data warehouse dovrebbe modellare ciò che l'organizzazione fa. Ordini. Spedizioni. Sinistri. Pagamenti. Sessioni applicative. Ticket di assistenza. Se il design parte dalle tabelle che si è trovato ad avere da Salesforce, SAP o da un database di prodotto, si ereditano le stranezze delle applicazioni invece della logica di business.
Ho trovato una regola particolarmente affidabile: definite prima l'evento di business, poi decidete come il data warehouse lo rappresenterà. In questo modo le tabelle dei fatti restano ancorate a qualcosa di misurabile e ripetibile.
Un data warehouse dura più a lungo quando le sue entità principali sopravvivono alla migrazione di un sistema.
Progettate per chi legge, per la crescita e per il controllo
Analisti e sviluppatori BI sono i lettori del modello. I data engineer ne sono i manutentori. I team di governance ne sono i responsabili del rischio. Un buon design rispetta tutti e tre.
Usate questa checklist essenziale:
Chiarezza prima dell'ingegnosità: preferite nomi di tabelle e colonne che un nuovo analista possa capire senza aprire cinque file di trasformazione.
Granularità stabile: ogni tabella dei fatti ha bisogno di una definizione esplicita a livello di riga. Se non riuscite a descrivere la granularità in una frase, la tabella non è pronta.
Scalabilità fin dal primo giorno: date per scontato che volumi, concorrenza e nuove aree tematiche cresceranno. Adattare la scalabilità a posteriori è costoso.
Attenzione alle prestazioni: l'eleganza logica non basta. Se le query più comuni richiedono scansioni e join eccessivi, gli utenti esporteranno i dati in fogli di calcolo e aggireranno il data warehouse.
Governance integrata: regole di accesso, provenienza, controlli di qualità e responsabilità non possono essere rimandati a “più tardi”.
Anche le competenze del team contano. Spesso i team hanno ottimi ingegneri di pipeline, ma nessuno in grado di fare da ponte tra modellazione, vincoli della piattaforma e semantica di business. Se state costruendo o rivedendo un programma di data warehouse, un partner specializzato nel recruiting di Cloud Data Architect può essere utile, perché gli errori di architettura di solito emergono molto tempo dopo la decisione di assunzione.
Il modello dovrebbe anche lasciare spazio a un design a livelli. I livelli raw, staging, core, analytics e aggregati risolvono ciascuno un problema diverso. L'errore è comprimerli in uno solo perché sembra più veloce. All'inizio lo è. Ogni mese successivo è più lento.
Dalle domande di business agli schemi del data warehouse
I migliori modelli logici nascono da conversazioni scomode. Gli stakeholder chiedono spesso “una dashboard delle vendite” o una “vista cliente a 360 gradi” quando in realtà hanno bisogno di supportare bene una manciata di decisioni molto specifiche. Il vostro compito è imporre precisione prima ancora di progettare una sola tabella dei fatti.
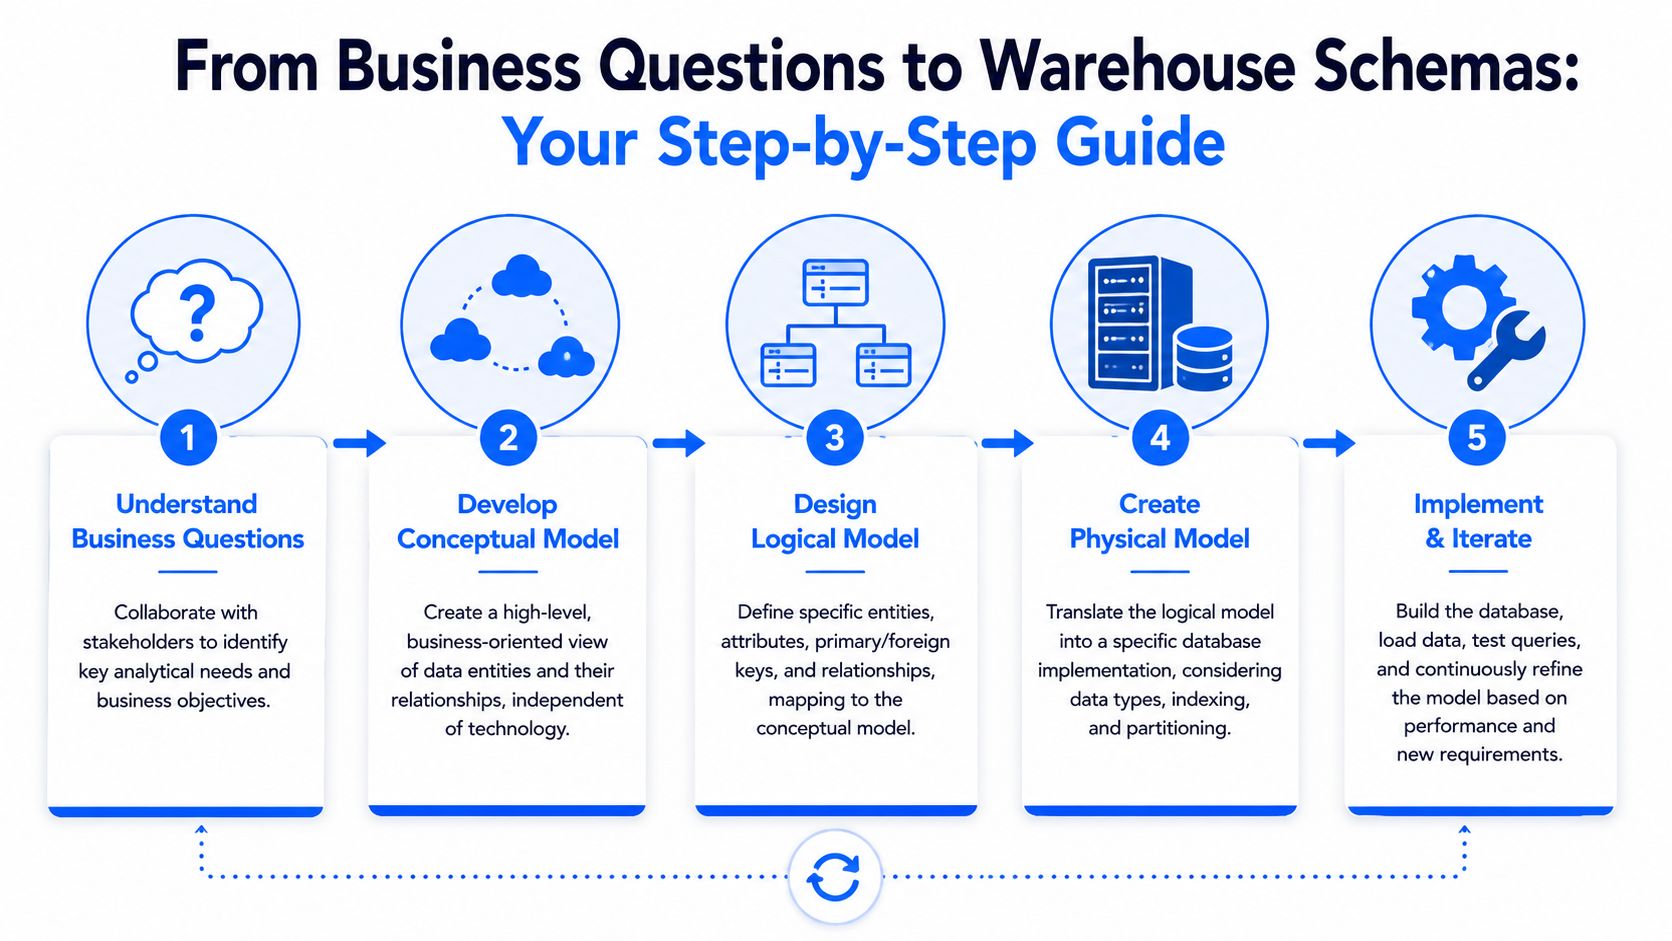
Trasformate le domande in granularità
Prendete una domanda di business come: “Qual è stato il ricavo mensile per prodotto e per regione?”
Quella domanda suggerisce già la struttura:
Il processo di business è la vendita o la fatturazione.
La misura è il ricavo.
La prospettiva temporale è mensile.
Le dimensioni di analisi sono prodotto e regione.
Ma il modello non dovrebbe passare direttamente a una tabella mensile. Il primo compito è definire la granularità utile più bassa. Una riga è una riga d'ordine, una riga di fattura, una spedizione o un record riepilogativo giornaliero? Nella maggior parte dei data warehouse, scegliere l'evento di business affidabile più atomico lascia aperte le analisi future.
Una sequenza pratica è la seguente:
Intervistate sulle decisioni, non sulle dashboard: chiedete quale azione segue alla metrica. Se nessuno agisce in base a essa, non modellatela per prima.
Elencate i processi principali: vendite, resi, abbonamenti, sinistri, ticket o eventi dei sensori di solito diventano domini di fatti separati.
Dichiarate presto la granularità: “una riga per riga di fattura” è chiaro. “Una riga per riepilogo delle transazioni del cliente” di solito non lo è.
Date alle dimensioni nomi del linguaggio di business: cliente, prodotto, regione, canale, agente di vendita e data sono più facili da governare rispetto a etichette specifiche della sorgente.
Risolvete la semantica delle metriche prima di costruire: ricavi, cliente attivo e churn sono noti per sembrare semplici mentre nascondono scelte di policy.
Nota dal campo: la maggior parte delle rilavorazioni avviene perché i team hanno saltato la definizione della granularità e hanno scoperto in seguito che una tabella mescolava eventi, snapshot e riepiloghi derivati.
Una guida dedicata alla pianificazione dell'integrazione del data warehouse è utile in questa fase, perché l'onboarding delle sorgenti incide su scelte di design fondamentali come le chiavi di business, i record in ritardo e la conformità tra sistemi.
Dalle entità a schemi utilizzabili
Una volta chiarite le domande, mappate prima i concetti in un modello concettuale. Mantenetelo orientato al business. Il cliente acquista il prodotto. L'ordine appartiene a una regione. La fattura fa riferimento a un contratto. Il ragionamento entità-relazione aiuta in questo processo, anche se il data warehouse finale non sarà un puro design ER.
Poi viene il modello logico. È lì che si definiscono chiavi, attributi e relazioni con una precisione sufficiente perché l'ingegneria possa implementarli. I fatti ricevono chiavi esterne verso le dimensioni. Le dimensioni ricevono identificatori stabili e attributi descrittivi. Le dimensioni condivise diventano conformi, in modo che lo stesso cliente o prodotto abbia lo stesso significato in tutti i data mart.
Una buona sessione di revisione in questa fase pone domande come:
Domanda di revisione | Perché è importante |
|---|---|
Che cosa rappresenta una riga di questa tabella? | Evita la confusione tra granularità diverse |
Quale processo di business rappresenta? | Mantiene i modelli ancorati alla realtà |
Quali dimensioni vengono riutilizzate altrove? | Favorisce conformità e coerenza |
Quale storico deve essere conservato? | Evita sovrascritture distruttive |
Quali metriche vanno a monte e quali nella BI? | Riduce la logica duplicata |
Il modello fisico viene dopo. Ma se il modello logico è vago, l'ottimizzazione fisica non lo salverà.
Implementazione fisica e ottimizzazione delle prestazioni
Un design logico può essere perfettamente sensato e comunque avere prestazioni scadenti quando incontra i pattern di query reali. A questo punto la modellazione dei dati nel data warehouse smette di essere concettuale e diventa ingegneria.
I modelli logici non garantiscono query veloci
Il livello fisico conta perché i motori non eseguono diagrammi. Eseguono layout di storage, pattern di clustering, regole di partition pruning e strategie di materializzazione. Le indicazioni di modellazione fisica sulle scelte di design specifiche del motore lo rendono concreto: partizionare una tabella dei fatti per data può ridurre l'overhead di scansione del 60–80% per le query che filtrano i record recenti, e il clustering su chiavi di dimensione ad alta cardinalità può migliorare l'efficienza dei join fino al 45% nelle implementazioni a star schema.
Questo cambia il modo in cui dovreste pensare all'implementazione. Una tabella dei fatti con un filtro su order_date in quasi ogni dashboard dovrebbe di solito essere organizzata fisicamente per sfruttare quel pattern di accesso. Uno star schema che esegue continuamente join su customer_id o su un'altra chiave di dimensione selettiva dovrebbe rifletterlo nel clustering o in un design equivalente specifico del motore.
Le priorità pratiche di ottimizzazione sono di solito:
Partizionate sui filtri temporali più comuni: se gli utenti interrogano costantemente i periodi recenti, il partizionamento per data è spesso il primo vantaggio.
Applicate il clustering ai join selettivi: le chiavi ad alta cardinalità possono migliorare la località dei join ripetuti.
Materializzate con intenzione: non tutte le trasformazioni devono restare viste. Un forte riutilizzo e join costosi spesso giustificano la materializzazione in tabella.
Separate i livelli di servizio dall'ingestione grezza: le tabelle raw preservano la fedeltà. Le tabelle di reporting dovrebbero servire la forma del carico di lavoro.
Per i team che affrontano scelte di ottimizzazione specifiche della piattaforma, questa guida per ottimizzare il data warehouse per la massima efficienza con strumenti moderni di Data Quality è un utile complemento al lavoro di design logico.
Gestite lo storico in modo consapevole
Il tracciamento storico è uno dei primi ambiti in cui le scorciatoie di design diventano costose. Se un cliente cambia regione, segmento o fascia di prezzo, dovete sapere se i report devono riflettere il valore attuale o quello in vigore al momento dell'evento.
Nei modelli dimensionali, le Slowly Changing Dimension di Tipo 2 sono il meccanismo standard per preservare lo storico. L'idea di base è semplice: chiudere la vecchia riga della dimensione, inserirne una nuova e usare date di validità o finestre di validità in modo che i fatti possano collegarsi alla versione storica corretta.
Un pattern semplice si presenta così:
Questo pattern non è affascinante, ma protegge l'analisi dei trend, il reporting point-in-time e la verificabilità. I team che sovrascrivono le dimensioni perché sembra più semplice di solito finiscono per ricostruire la logica storica in seguito, sotto la pressione delle scadenze.
Mantenere sano il modello dei dati con l'osservabilità
Un modello di data warehouse non resta affidabile solo perché il design originale era solido. Si degrada attraverso i normali cambiamenti operativi. Un team sorgente aggiunge una colonna. Un job di ingestione arriva in ritardo. Un campo inizia a derivare in modo sottile. Un join funziona ancora, ma il significato di business cambia.
Un modello di data warehouse si degrada in silenzio
Ecco perché l'osservabilità fa parte del ciclo di vita della modellazione dei dati nel data warehouse, e non è un ripensamento. Il modello che avete progettato è utile solo se rimane strutturalmente stabile, tempestivo e semanticamente credibile in produzione.
Il rischio operativo è più grande di quanto molti team ammettano. L'impatto documentato dei problemi di qualità dei dati sui sistemi di IA indica che i problemi di qualità dei dati causano in media il 15–30% dei fallimenti dei modelli di IA, con il data drift silenzioso e le modifiche di schema tra le cause principali. Le stesse modalità di guasto colpiscono i modelli di data warehouse molto prima che si manifestino come incidente di IA. Le dashboard si rompono. I confronti storici si distorcono. I job a valle iniziano a riuscire tecnicamente mentre falliscono dal punto di vista analitico.
Un data warehouse sano non è quello con lo schema più bello. È quello che vi avvisa rapidamente quando la realtà non corrisponde più al modello.
Che cosa monitorare dopo il go-live
Una volta che un modello è in produzione, quattro categorie di monitoraggio contano più della maggior parte delle altre.
Stabilità dello schema: tenete d'occhio colonne aggiunte o rimosse, cambi di tipo e campi rinominati che possono invalidare le trasformazioni o alterarne il significato.
Tempestività: sappiate quando i caricamenti attesi sono in ritardo, mancanti o incompleti, così che dashboard obsolete non vengano scambiate per verità.
Comportamento delle metriche: monitorate variazioni insolite di volumi, tassi di null, distribuzioni e pattern di relazione che i controlli standard delle pipeline non intercettano.
Conformità alle regole: applicate i vincoli di business a livello di record dove i requisiti di governance o di audit richiedono precisione.
È qui che le moderne piattaforme di osservabilità dimostrano il loro valore. Secondo la descrizione verificata della piattaforma, digna combina il rilevamento delle anomalie basato sull'IA, il monitoraggio della tempestività, la validazione a livello di record e il tracciamento dello schema, eseguendo le analisi all'interno di ambienti controllati dal cliente. La sua architettura è progettata per l'esecuzione in-database, il deployment in private cloud o on-premises e zero accesso ai dati da parte del fornitore.
Questo conta a livello operativo, perché l'osservabilità dovrebbe stare vicino al data warehouse, senza dipendere dall'estrazione di dataset sensibili verso l'ennesimo strumento. Cambia anche la risposta agli incidenti. Invece di scoprire i problemi dopo che un CFO ha messo in discussione una dashboard, gli ingegneri possono intercettare prima i problemi strutturali e comportamentali.
Il punto più profondo è architetturale. Un modello di data warehouse è un asset vivo. Se non monitorate se le ipotesi alla base del modello sono ancora valide, non avete davvero un data warehouse governato. Avete un diagramma e un po' di fortuna.
Modellare per oggi e per domani
La modellazione dei dati nel data warehouse non riguarda mai solo la scelta di un pattern di schema. Si tratta di allineare domande di business, struttura logica, prestazioni fisiche e fiducia operativa in un unico sistema capace di sopravvivere al cambiamento.
Il vero risultato è la fiducia
I team che lo fanno bene non sono ossessionati dalla purezza da manuale. Fanno compromessi consapevoli. Scelgono lo Star quando gli analisti hanno bisogno di velocità e chiarezza. Usano pattern core più flessibili quando contano la volatilità delle sorgenti e la provenienza. Definiscono presto la granularità, preservano lo storico di proposito e ottimizzano il livello fisico per le query che le persone eseguono davvero.
Altrettanto importante, trattano il data warehouse come qualcosa che richiede cure continue. I modelli derivano. Le definizioni si ampliano. Le piattaforme evolvono. Un design che funzionava l'anno scorso può essere ancora logicamente corretto ma fragile dal punto di vista operativo.
Ecco perché i programmi di data warehouse più solidi ragionano sull'intero ciclo di vita. Scegliete il progetto giusto. Costruite per la leggibilità e la scalabilità. Implementate in base alla realtà del carico di lavoro. Monitorate il modello dopo il go-live. Quando questi elementi restano collegati, il data warehouse diventa una fonte di verità duratura invece di un progetto di pulizia ricorrente.
Se cercate un modo pratico per proteggere il data warehouse che avete già costruito, digna aiuta i team a monitorare modifiche di schema, anomalie nei dati, tempestività e validazione direttamente all'interno di ambienti controllati dal cliente, così che i problemi dei dati emergano prima di danneggiare dashboard, analisi o modelli a valle.
Per intercettare colonne aggiunte, rimosse o con tipo modificato prima che rompano silenziosamente le vostre tabelle dei fatti e delle dimensioni, scoprite come digna Schema Tracker monitora i cambiamenti strutturali nel data warehouse.
Domande frequenti
Che cos'è la modellazione dei dati nel data warehouse?
La modellazione dei dati nel data warehouse trasforma dati operativi sparsi in entità durature, join coerenti e definizioni condivise che le persone possono interrogare, comprendere e di cui possono fidarsi. Secondo l'articolo, un modello solido crea coerenza, supporta l'analisi storica e migliora la manutenibilità. La disciplina risale agli anni '80, quando fu sviluppata per i sistemi di supporto alle decisioni.
Star schema, snowflake schema o data vault: quale usare?
Decidete in base al carico di lavoro, non all'ideologia. Uno star schema, con una tabella dei fatti e le dimensioni intorno, è adatto a un reporting BI veloce. Uno snowflake schema normalizza le dimensioni per ridurre la ridondanza, al costo di più join. Un data vault, costruito con hub, link e satellite, è adatto a sorgenti volatili e a una verificabilità rigorosa.
Come si definisce la granularità di una tabella dei fatti?
Partite dal processo di business e scegliete l'evento affidabile più atomico che sia ancora utile. Per il ricavo mensile per prodotto e regione, decidete prima se una riga è una riga d'ordine, una riga di fattura o una spedizione. Se non riuscite a descrivere la granularità in una frase, la tabella non è pronta.
Come si possono migliorare le prestazioni delle query in un data warehouse?
Ottimizzate il livello fisico in base ai pattern di query reali. L'articolo cita il partizionamento per data delle tabelle dei fatti, che riduce l'overhead di scansione del 60-80 percento per le query sui record recenti, e il clustering su chiavi di dimensione ad alta cardinalità, che migliora l'efficienza dei join fino al 45 percento negli star schema. Materializzate in modo consapevole le trasformazioni molto riutilizzate.
Come si conserva lo storico in una dimensione del data warehouse?
Usate le Slowly Changing Dimension di Tipo 2. Quando un attributo come la regione di un cliente cambia, chiudete la vecchia riga impostandone la data valid_to, quindi inserite una nuova riga con valid_from impostato alla data corrente. I fatti si collegano così alla versione corretta, preservando il reporting point-in-time e la verificabilità.


