Metodi statistici per l'analisi dei dati: guida 2026
|
5
min di lettura

Con ogni probabilità vi trovate in questo momento in una di queste due situazioni.
Una dashboard che venerdì sembrava stabile il lunedì non ha più alcun senso. Oppure un modello che in staging si comportava bene in produzione prende decisioni sbagliate, anche se nessuno ha toccato il codice. In entrambi i casi il colpevole abituale non è un guasto clamoroso del sistema. È qualcosa di più silenzioso. Un caricamento in ritardo, uno schema rotto, una distribuzione che deriva o una colonna che esiste ancora ma non significa più ciò che la logica a valle presuppone.
È qui che i metodi statistici smettono di essere teoria e iniziano a funzionare come controlli operativi. In un moderno data stack aiutano i team a distinguere tra fluttuazioni normali e veri guasti. Trasformano i segnali grezzi di observability in decisioni utilizzabili. E offrono ai data engineer un modo per monitorare lo stato di salute dei dati senza codificare a mano infinite regole per ogni pipeline, tabella e metrica.
Indice
Perché i metodi statistici sono la vostra prima linea di difesa
Statistica descrittiva per data profiling e anomaly detection
Statistica inferenziale per previsioni e root cause analysis
Perché i metodi statistici sono la vostra prima linea di difesa
Molti team scoprono il valore della statistica per la prima volta durante un incidente.
La dashboard dei ricavi crolla durante la notte. La product analytics mostra all'improvviso tassi di conversione impossibili. Un feature store si aggiorna ancora secondo programma, ma gli input del modello sono cambiati abbastanza da rendere le previsioni non più affidabili. I log possono dirvi che i job sono stati eseguiti. L'orchestrazione può dirvi che i task sono andati a buon fine. Nessuno dei due vi dice se i dati hanno ancora l'aspetto giusto.
I guasti dei dati sono spesso dati validi
Questa è la trappola. La pipeline può concludersi con successo mentre i dati diventano inutilizzabili dal punto di vista operativo.
Una colonna può passare da un significato di business a un altro senza far fallire i controlli sui tipi. I volumi di eventi possono restare entro un intervallo storico approssimativo mentre la freschezza peggiora quanto basta per invalidare la reportistica. Una distribuzione può derivare gradualmente, ed è proprio per questo che i rozzi alert a soglia “maggiore di” o “minore di” spesso non colgono il problema di fondo.
Regola pratica: se il vostro monitoraggio verifica solo il successo del sistema, state monitorando il calcolo, non i dati.
La prima linea di difesa è il monitoraggio statistico dei dati stessi. Significa stabilire il comportamento normale, misurare la variazione e segnalare le deviazioni rilevanti. Nelle piattaforme di observability questi metodi diventano controlli automatici su numero di record, tassi di valori nulli, segnali di freschezza, modifiche allo schema e comportamento delle metriche nel tempo.
Perché servono agli engineer, non solo agli analisti
I metodi statistici per l'analisi dei dati hanno radici profonde. Il percorso storico va dai primi lavori di stima demografica ed economica fino alla moderna big data analytics, dove machine learning, modellazione predittiva ed elaborazione del linguaggio naturale sono diventati standard e l'analytics è diventata accessibile anche oltre la cerchia degli statistici specializzati, come descritto in questa storia dell'analytics.
Questa storia è importante perché la stessa idea di fondo vale ancora oggi. Raccogliere dati in modo sistematico. Analizzarli per guidare l'azione.
Per i data engineer l'azione è raramente accademica. Si tratta di decidere se fidarsi di una pipeline, fermare un rilascio, mettere in quarantena un feed o escalare un incidente prima che gli utenti di business vedano il danno.
I concetti fondamentali dell'analisi statistica
In un sistema di dati la statistica ha due scopi operativi. Riassume il comportamento attuale e aiuta a decidere se un cambiamento osservato è segnale o rumore.
I due compiti della statistica
La statistica descrittiva riassume ciò che è già presente nei dati. In una pipeline o in un warehouse si tratta di solito di numero di righe, medie, mediane, tassi di valori nulli, dispersione della distribuzione, cardinalità e outlier. Sono le prime metriche che gli strumenti di observability calcolano, perché stabiliscono una baseline del comportamento normale.
La statistica inferenziale stima, verifica o prevede al di là della porzione di dati osservata. I team la usano per valutare se uno scostamento è probabilmente casuale, se una differenza tra gruppi è significativa o se il comportamento recente indica un problema più ampio. In pratica compare nel change detection, nell'analisi del drift, nel triage degli incidenti e nelle previsioni.
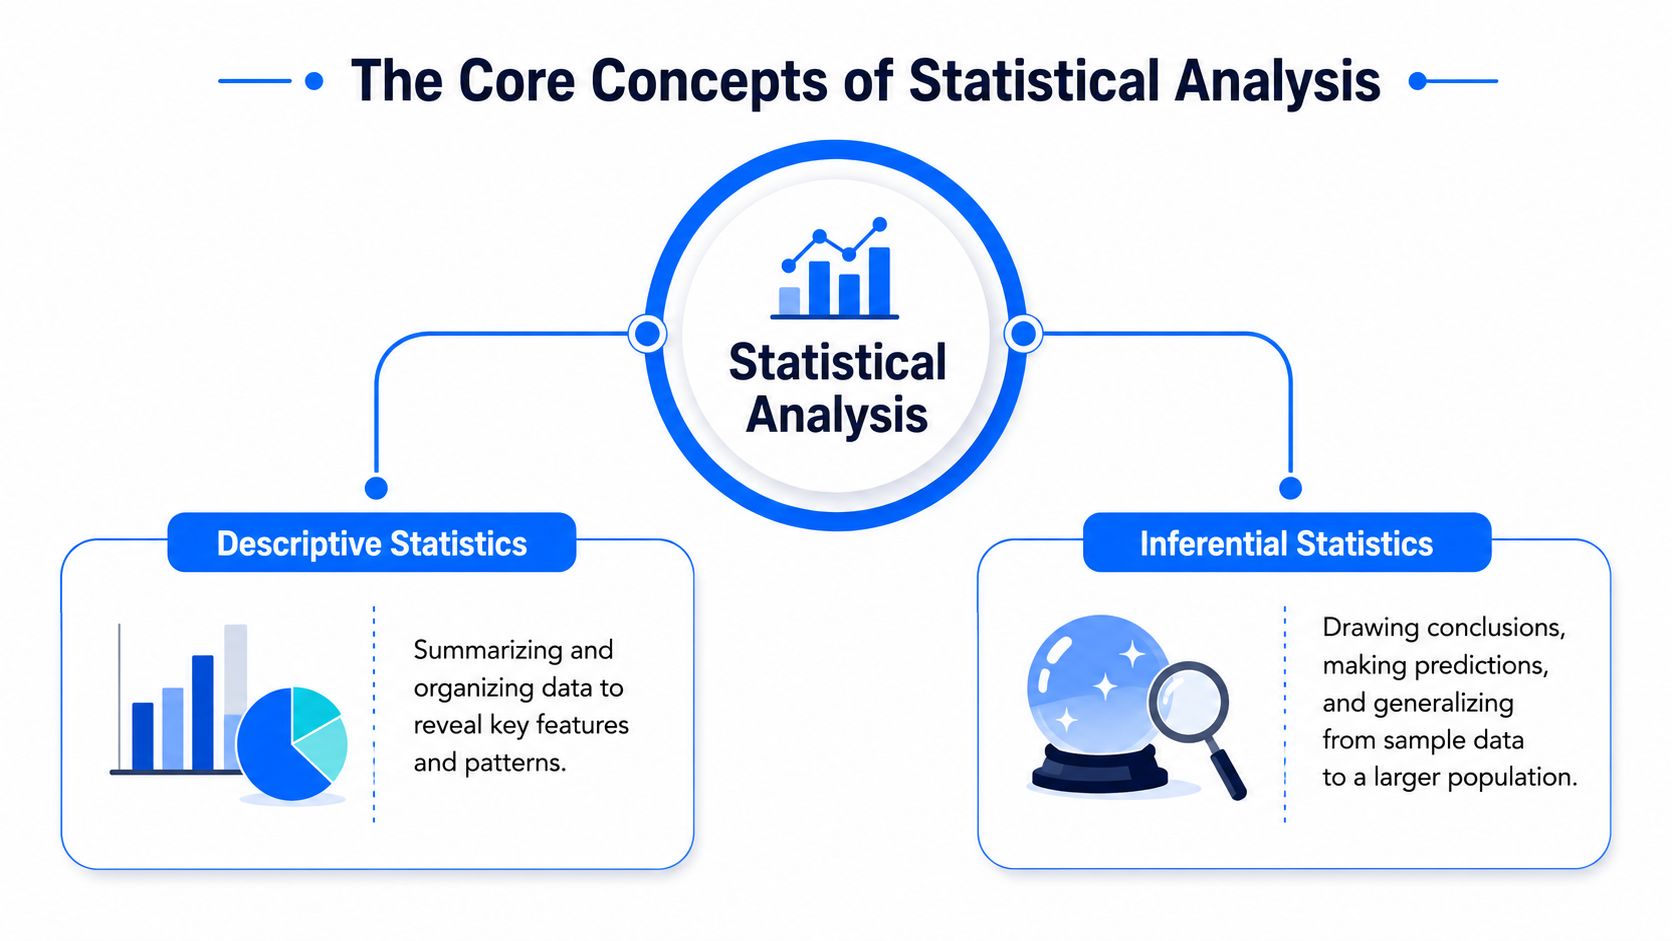
La distinzione è pratica. Se il numero giornaliero di ordini ha un picco, la statistica descrittiva individua la deviazione. Se il team deve capire se il picco riflette una variazione casuale, un problema di deployment o un evento di business reale, sono i metodi inferenziali a fare il lavoro più pesante.
Sotto entrambi c'è un secondo concetto: popolazione e campione. Nel data engineering la popolazione può essere ogni evento prodotto da un servizio, ogni riga caricata in una tabella dei fatti o ogni record elaborato in una finestra batch. Il campione è il sottoinsieme usato per stimare le proprietà dell'insieme completo. Il campionamento diventa utile quando l'analisi dell'intera tabella è troppo costosa, quando la validazione deve girare rapidamente all'interno di una pipeline o quando i team stanno verificando delle ipotesi prima di scansionare miliardi di record.
I metodi descrittivi sono i vostri indicatori. I metodi inferenziali sono il modo in cui decidete se indagare, sopprimere o escalare.
I team usano spesso in modo scorretto anche la significatività statistica. Un p-value non indica una probabilità fissa che il risultato sia corretto, e trattare un'unica soglia come regola universale di superamento o fallimento porta a decisioni sbagliate. Le linee guida dell'American Statistical Association su p-value e significatività statistica restano uno dei riferimenti più chiari su questo punto. Nel lavoro di observability, comunque, conta di solito di più la significatività pratica. Uno scostamento minimo ma statisticamente rilevabile può essere irrilevante in un flusso di eventi rumoroso, mentre una variazione più piccola nei pagamenti falliti o nel ritardo di freschezza può giustificare un intervento immediato.
Come si sceglie davvero un metodo
La scelta del metodo dipende dalla forma dei dati e dal costo della decisione. Conta il tipo di dato. Conta la struttura temporale. Contano anche la dimensione del campione, la stabilità della baseline e il costo di non accorgersi di un problema reale.
Per questo un picco nel tasso di valori nulli può richiedere semplici soglie descrittive, mentre uno spostamento graduale della distribuzione richiede un test d'ipotesi, una carta di controllo o un modello di serie temporali. La stessa logica vale anche al di fuori della Data Observability. Nella finanza quantitativa, per esempio, le strategie di trading market-neutral si basano sulla stima delle relazioni normali tra asset e intervengono quando tali relazioni si discostano abbastanza da giustificarlo.
All'interno delle pipeline moderne non si tratta tanto di categorie da manuale quanto di implementazione. Il controllo può girare in SQL sulle tabelle di produzione? Tollera la stagionalità? Sa distinguere una partizione in ritardo da un evento di drift a livello di sistema? Una solida analisi statistica in ambito engineering parte da qui.
Come scegliere il metodo statistico giusto
Una pipeline manca lo SLA delle 6 del mattino, il numero di righe è calato e i valori nulli schizzano in una colonna critica per il business. La prima domanda non è quale test eseguire. La prima domanda è quale decisione il team deve prendere prima che parta il prossimo job a valle.
Questa impostazione cambia la scelta del metodo. Nel data engineering i metodi statistici non sono categorie accademiche esterne allo stack. Sono controlli incorporati in SQL, modelli del warehouse, stream processor e regole di observability. Il metodo giusto è quello che corrisponde alla decisione, si adatta alla forma dei dati e può girare in modo affidabile alla cadenza della produzione.
Partite dalla decisione, non dal metodo
La scelta del metodo diventa di solito più chiara una volta esplicitato il compito operativo.
Se il team ha bisogno di una baseline del comportamento normale, la statistica descrittiva di solito basta. Se il team deve decidere se un cambiamento è probabilmente reale e non semplice rumore di routine, i metodi inferenziali sono più adatti. Se il problema riguarda schemi ricorrenti orari, giornalieri o settimanali, i metodi che tengono conto del tempo vanno inclusi fin dal primo passaggio, non aggiunti in un secondo momento.
In pratica uso un filtro semplice:
Riassumere lo stato attuale: usate la statistica descrittiva per conteggi, distribuzioni, tassi di valori nulli, cardinalità e dispersione.
Confrontare gruppi o periodi: usate un t-test per confrontare le medie di due gruppi quando le ipotesi sono ragionevoli e l'ANOVA quando confrontate più gruppi.
Stimare relazioni: usate la regressione quando un risultato può variare in funzione di uno o più input, come variazioni di volume dopo un deployment o cambiamenti di latenza per sistema sorgente.
Ridurre la proliferazione di metriche: usate la PCA o l'analisi fattoriale quando decine di segnali correlati devono essere ridotti a un insieme di monitoraggio più piccolo.
Gestire la dipendenza temporale: usate l'analisi delle serie temporali quando stagionalità, trend, ritardi o baseline mutevoli influenzano ciò che si considera normale. Per i team che costruiscono controlli di produzione attorno a comportamenti ciclici, questa guida al rilevamento delle anomalie nelle serie temporali è un riferimento pratico.
Il compromesso è di solito tra precisione, interpretabilità e costo operativo. Una semplice regola basata sui percentili è facile da spiegare ed economica da eseguire nel database. Un modello di serie temporali può individuare guasti più sottili, ma richiede più storico, più tuning e una gestione migliore di partizioni mancanti, festività e backfill.
Abbinate il metodo alla modalità di guasto
Problemi di dati diversi richiedono strumenti statistici diversi.
Un estrattore a monte guasto si manifesta spesso prima con record mancanti, chiavi duplicate o un aumento dei valori nulli. Questo di solito porta a metriche di profiling, limiti di controllo e change detection su semplici aggregati. Un cambiamento di business che non tocca lo schema è diverso. I conteggi possono restare stabili mentre il mix di categorie, le distribuzioni dei valori o il comportamento dei join derivano. È lì che il confronto tra distribuzioni, la segmentazione o l'analisi basata sulla regressione dimostrano il loro valore.
Le soglie statiche hanno ancora un ruolo. Funzionano bene per vincoli rigidi come freschezza, univocità e valori impossibili. Funzionano male per metriche con forti cicli settimanali o chiusure mensili. Gli engineer si mettono nei guai quando ogni problema viene forzato nello stesso formato di regola perché il sistema di alerting supporta un solo schema.
Una guida pratica alla scelta
Obiettivo dell'analisi | Metodi comuni | Domanda di esempio |
|---|---|---|
Riassumere il comportamento del dataset | Media, mediana, moda, deviazione standard, grafici di distribuzione | Come appare di solito una normale attività giornaliera di iscrizioni? |
Confrontare due gruppi | t-test | Il comportamento di conversione è cambiato tra due coorti di rilascio? |
Confrontare più gruppi o fattori | ANOVA, regressione | Quali fattori sono associati alla variazione del valore degli ordini? |
Ridurre la complessità ad alta dimensionalità | PCA, analisi fattoriale | Quali metriche si possono comprimere in un insieme di segnali più piccolo per il monitoraggio? |
Esplorare schemi senza un'ipotesi fissa | Analisi esplorativa dei dati | Ci sono cluster, anomalie o forme strane in questa tabella prima dei test formali? |
Analizzare il comportamento nel tempo | Analisi delle serie temporali, modelli previsionali | Il volume di dati di oggi è coerente con il comportamento storico appreso? |
Un metodo valido sulla carta può comunque essere una cattiva scelta operativa. Prima di impegnarvi ponete alcune domande di implementazione:
Il controllo può girare vicino ai dati, idealmente in SQL o all'interno del warehouse?
Il metodo tollera dati in arrivo tardivo, backfill e storico scarso?
Le ipotesi sono abbastanza comprensibili perché un engineer di turno si fidi dell'alert?
Qual è il costo di un mancato rilevamento rispetto al costo del rumore?
Quest'ultimo punto è importante. Nell'observability un falso negativo può far arrivare dati corrotti a dashboard, modelli o sistemi rivolti ai clienti. Un falso positivo può inondare Slack e abituare gli engineer a ignorare gli alert. La scelta del metodo si colloca in questo compromesso, non in una definizione da manuale.
La scelta è di solito iterativa. I team partono spesso dal profiling descrittivo perché è rapido da implementare e facile da validare rispetto agli incidenti di produzione. Man mano che gli schemi storici diventano più chiari, aggiungono confronti tra gruppi, test di drift, regressione o modelli temporali là dove i controlli più semplici non bastano più.
Statistica descrittiva per data profiling e anomaly detection
Il monitoraggio affidabile inizia dalla statistica descrittiva.
Prima di poter rilevare un'anomalia, un team ha bisogno di una baseline di ciò che è normale. Questa baseline parte di solito da misure familiari. Numero medio di righe per batch. Valore mediano degli ordini. Distribuzione dei tipi di evento. Deviazione standard delle iscrizioni giornaliere. Percentuale di valori mancanti in un campo critico.
Costruite una baseline prima degli alert
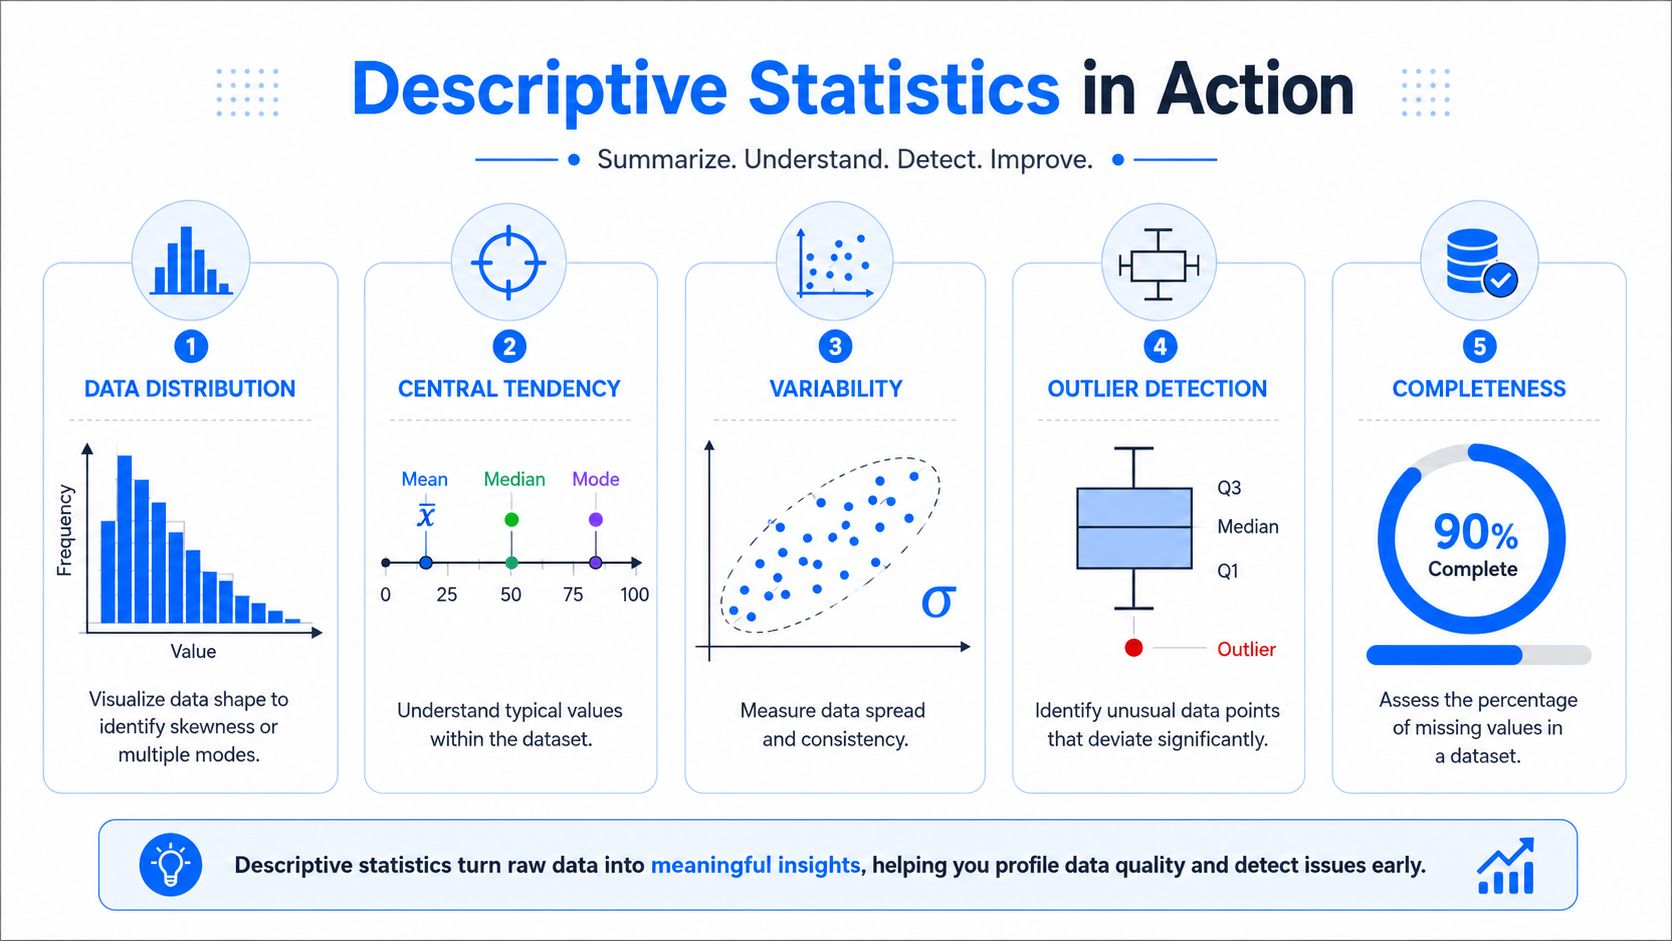
Un dataset sano ha un'impronta digitale. Di solito la si riconosce in cinque dimensioni di profiling:
Forma della distribuzione: i dati sono più o meno simmetrici, asimmetrici o multimodali?
Valore tipico: media e mediana aiutano a individuare il centro.
Dispersione: deviazione standard e intervallo mostrano quanta variazione è normale.
Valori estremi: i controlli sugli outlier individuano record o batch insoliti.
Completezza: i valori mancanti segnalano spesso un guasto a monte prima che i conteggi si muovano.
Se monitorate le iscrizioni giornaliere degli utenti, per esempio, il solo conteggio non basta. Dovete sapere se un conteggio più basso è normale per quel giorno della settimana, se una fonte di referral è sparita e se sono aumentati i valori nulli nei metadati di acquisizione.
Una guida pratica a questo tipo di monitoraggio si trova in questo articolo sul rilevamento delle anomalie nelle serie temporali, particolarmente utile per i team che passano dalle metriche di reporting all'anomaly detection operativa.
Dove gli Z-score funzionano e dove no
Lo Z-score è uno dei test di anomalia utili più semplici. Misura quanto un valore dista dalla media in unità di deviazione standard. Il metodo segnala un punto come outlier quando supera una soglia di deviazioni standard dalla media; una soglia comune nel settore è di 3,0 deviazioni standard, ovvero |Z| > 3, per le anomalie estreme in dati con distribuzione normale, come descritto in questo articolo sull'anomaly detection con Z-score.
In ambienti orientati a SQL questo rende l'implementazione semplice. Si calcolano media e deviazione standard di una metrica su una finestra di riferimento, poi lo Z-score di ogni riga, e si segnalano le righe o i giorni che superano la soglia scelta.
Dove funziona bene:
Metriche numeriche stabili: numero giornaliero di righe per pipeline mature.
Riepiloghi operativi: latenza media, conteggi di valori nulli, spesa aggregata.
Livelli di allerta precoce: screening rapido prima di un'analisi più approfondita.
Dove non funziona:
Distribuzioni non normali: una forte asimmetria compromette la logica della soglia.
Forte stagionalità: il normale comportamento del lunedì può sembrare anomalo rispetto a una media centrata sul fine settimana.
Problemi a livello di schema: una colonna rinominata non compare in uno Z-score.
Uno Z-score è un utile rilevatore di fumo. Non è un'indagine sull'incendio.
Per questo la statistica descrittiva è il primo livello, non l'intero sistema.
Statistica inferenziale per previsioni e root cause analysis
Una volta che sapete che qualcosa è cambiato, i metodi inferenziali aiutano a rispondere a due domande più difficili. Che cosa l'ha probabilmente causato e che cosa sarebbe dovuto succedere invece?

La regressione per spiegare
La regressione è uno dei metodi più pratici dell'analytics applicata, perché costringe i team a esplicitare le relazioni.
Supponiamo che le vendite calino dopo una modifica a una campagna. Una vista descrittiva vi dice che il calo c'è stato. Un modello di regressione può aiutare a verificare se spesa di marketing, mix di canali, variazioni di prezzo o effetti regionali sono associati al risultato. Il valore non sta solo nella previsione. Sta nella spiegazione strutturata.
Nel lavoro sulle piattaforme dati la stessa mentalità si applica all'analisi degli incidenti. Se la freschezza peggiora, potete modellare se latenza a monte, dimensione delle partizioni, carichi di lavoro concorrenti o frequenti modifiche allo schema sono legati al problema. L'obiettivo è passare da “qualcosa non va” a “queste variabili sono probabilmente collegate allo schema del guasto”.
Modelli di serie temporali per previsioni operative
Per l'observability lo strumento inferenziale più potente è spesso la previsione delle serie temporali.
L'anomaly detection sulle serie temporali usa spesso modelli ARIMA per prevedere i valori attesi e segnalare deviazioni significative. Un punto viene considerato anomalo se cade al di fuori dell'intervallo di confidenza del modello, che è tipicamente del 95%, secondo questa spiegazione dell'anomaly detection basata su ARIMA.
Questo è importante perché il comportamento atteso nelle pipeline è raramente piatto. L'arrivo dei dati segue degli orari. I volumi salgono e scendono con il ciclo di business. Alcune metriche crescono nel tempo pur restando perfettamente sane.
Un caso d'uso operativo forte è il monitoraggio dell'arrivo atteso. Se un feed arriva di solito entro una finestra appresa e la consegna di oggi cade al di fuori di quello schema previsto, l'alert è significativo anche se il job non ha ancora tecnicamente violato uno SLA statico. La stessa logica vale per i conteggi di eventi, le dimensioni dei payload delle API o i tassi di ingestione del warehouse.
Per i team che lavorano sull'analisi degli schemi storici e sull'interpretazione dei trend, questa risorsa sulla data trend analysis è utile perché collega i concetti di previsione al comportamento delle pipeline e non solo alle dashboard di business.
Applicare la statistica nella moderna Data Observability
Un caricamento nel warehouse termina in orario, le dashboard si aggiornano e la pipeline risulta verde. Due ore dopo il reparto finanza si accorge che i ricavi per regione sono sbagliati, perché un sistema a monte ha cambiato lo schema di un campo senza far fallire il job. È questa la realtà operativa che la moderna Data Observability deve gestire. I metodi statistici non sono separati dalla piattaforma. Sono il meccanismo con cui la piattaforma decide se i dati di oggi assomigliano ancora a sani dati di produzione.
Le moderne piattaforme di observability applicano i metodi statistici in modo continuo, su larga scala e il più vicino possibile ai dati. Questa scelta architetturale incide su velocità, costi e governance. Se il monitoraggio richiede di esportare ampie porzioni di dati di produzione in un ambiente separato del vendor, i team aggiungono latenza, aumentano lo spostamento dei dati e creano oneri di approvazione. Eseguire i controlli nel warehouse o in un'infrastruttura privata cambia questo compromesso e rende più facile fare dell'analisi statistica una parte integrante della pipeline.
Le baseline adattive battono le soglie statiche
Il cambiamento pratico è il passaggio da regole di alert fisse a baseline apprese.
L'analisi delle serie temporali per l'anomaly detection scompone spesso il comportamento in componenti di trend, stagionale e residua. La dispersione dei residui può fungere da baseline dinamica e il metodo IQR segnala anomalie quando i valori superano Q3 + 1,5×IQR o scendono sotto Q1 - 1,5×IQR, come spiegato in questa panoramica sui metodi statistici nell'analisi delle anomalie dei dati. Molte metriche delle pipeline non sono affatto gaussiane. Seguono orari, cicli di business, backfill e un'attività degli utenti irregolare che le semplici medie non colgono.
Lo si vede in casi familiari:
Volumi di ingestione notturni che salgono e scendono a seconda del giorno della settimana
Finestre di freschezza legate agli schemi di consegna dei sistemi sorgente
Metriche di latenza modellate da comportamenti ricorrenti di calcolo e code
Tabelle di utilizzo che hanno picchi durante i periodi di fatturazione o reporting
Le soglie statiche funzionano ancora per i vincoli rigidi. Un campo obbligatorio non può essere nullo. A uno schema bloccato non dovrebbe aggiungersi una nuova colonna senza revisione. Ma le metriche comportamentali hanno bisogno di una baseline che si adatti ai cambiamenti normali, altrimenti i team finiscono per ricevere alert su variazioni sane e per non accorgersi del drift lento.
Consiglio operativo: usate regole rigide per gli invarianti. Usate baseline statistiche per il comportamento.
L'esecuzione nel database migliora ulteriormente le cose. Addestramento della baseline, aggregazione delle metriche e scoring delle anomalie avvengono dove i dati sorgente risiedono già, così i team ottengono un rilevamento più rapido senza creare un ulteriore archivio di monitoraggio copiato. Negli ambienti regolamentati questa è spesso la differenza tra un'architettura praticabile e una che si arena nella revisione di sicurezza.
Validazione statistica dentro il warehouse
La statistica può dire a un team che la forma di una tabella è cambiata. Da sola non può dirgli se un ordine è passato da pending a refunded senza mai essere stato paid, o se la data di un sinistro assicurativo ora precede la data di inizio della polizza.
Per questo le piattaforme di observability hanno bisogno sia di controlli statistici sia di validazione a livello di record.
Le guide di statistica tradizionali dedicano molto spazio a t-test, ANOVA e test del chi quadrato. Nei sistemi di dati di produzione la domanda più difficile è di solito più ristretta e più operativa: come individuare un drift silenzioso in dati non normali applicando al tempo stesso regole di business specifiche per tabella? La risposta è combinare il monitoraggio delle distribuzioni con asserzioni esplicite su record, campi e relazioni.
Più avanti nel flusso di monitoraggio, un video può aiutare a mostrare come questi controlli si integrano dal punto di vista operativo.
Un'opzione in questa categoria è digna, che esegue anomaly detection, validazione, monitoraggio della tempestività, schema tracking e calcolo delle metriche nel database all'interno di ambienti controllati dal cliente. Questo modello si adatta ai team che vogliono observability senza spostare i dati di produzione al di fuori del proprio warehouse o della propria infrastruttura privata.
Le sei categorie di anomalie che i team monitorano
In produzione gli engineer monitorano modalità di guasto distinte, non un unico contenitore generico di anomalie.
Secondo questa panoramica sull'anomaly detection nella Data Observability, il lavoro di observability si concentra comunemente su anomalie di volume, anomalie di schema, anomalie di freschezza, anomalie di distribuzione, record duplicati o mancanti e outlier delle metriche. I problemi di freschezza vengono spesso rilevati confrontando gli orari di consegna effettivi con gli schemi appresi e gli orari previsti.
Ciò corrisponde da vicino a ciò che si guasta nei data stack:
Anomalie di volume: un feed arriva, ma il numero di record crolla o schizza in alto.
Anomalie di schema: colonne aggiunte, rimosse o modificate nel tipo.
Anomalie di freschezza: i dati arrivano più tardi del previsto e minano la fiducia nella reportistica.
Anomalie di distribuzione: i valori continuano a essere caricati, ma la loro forma è cambiata abbastanza da influire sulla logica a valle.
Record duplicati o mancanti: i soli conteggi possono nascondere duplicazioni e omissioni.
Outlier delle metriche: gli indicatori di business aggregati si muovono in modi che richiedono un'indagine.
Per i team che costruiscono una pratica operativa più ampia su log, metriche e segnali di runtime, questa guida di Webtwizz sullo stato di salute delle app è utile insieme al materiale sulla Data Observability. Salute delle applicazioni e salute dei dati si trovano su livelli diversi, ma gli incidenti spesso li attraversano entrambi.
La sfida operativa è l'implementazione. I team hanno bisogno che i metodi statistici siano collegati a job pianificati, query sul warehouse, instradamento degli alert e flussi di triage, in modo che il comportamento sano venga appreso automaticamente e le deviazioni vengano intercettate prima che gli stakeholder smettano di fidarsi dei dati.
Conclusione: dai metodi a dati affidabili
I sistemi di dati affidabili non nascono dalle sole dashboard. Nascono da un rilevamento disciplinato.
È questo il valore pratico dei metodi statistici per l'analisi dei dati. La statistica descrittiva offre ai team un rapido controllo dello stato di salute. I metodi inferenziali aiutano a spiegare i cambiamenti e a prevedere il comportamento atteso. L'anomaly detection basata sul tempo trasforma gli schemi ricorrenti in baseline. La validazione a livello di record copre i casi in cui la statistica da sola non basta.
Le data operations non richiedono che ogni data engineer diventi uno statistico. Richiedono però sistemi che applichino un ragionamento statistico solido in modo automatico e coerente. Questo include il monitoraggio di tempestività, schema drift, spostamenti di distribuzione, duplicati, record mancanti e comportamenti inspiegati delle metriche all'interno degli ambienti in cui i dati risiedono già.
I dati affidabili non sono un'abitudine manuale. Sono un modello operativo. Quando i team incorporano il monitoraggio statistico nelle pipeline e nei flussi di observability, riducono la distanza tra “il job è andato a buon fine” e “i dati sono sicuri da usare”.
Se volete rendere operative queste idee nel vostro ambiente, digna è pensato per i team che hanno bisogno di anomaly detection, validazione a livello di record, monitoraggio della tempestività e schema tracking all'interno di database controllati dal cliente e di infrastrutture private.
Per vedere come le baseline apprese sostituiscono le soglie Z-score e IQR tarate a mano sulle tabelle di produzione, guardate come digna Data Anomalies applica questo tipo di monitoraggio statistico direttamente all'interno del vostro database.
Domande frequenti
Qual è la differenza tra statistica descrittiva e inferenziale nell'analisi dei dati?
La statistica descrittiva riassume ciò che è già presente nei dati, come numero di righe, mediane, tassi di valori nulli e cardinalità, e stabilisce una baseline. La statistica inferenziale stima, verifica o prevede al di là dei dati osservati, aiutando i team a valutare se un picco negli ordini giornalieri è una variazione casuale, un problema di deployment o un evento di business reale.
Come scegliere il metodo statistico giusto per l'analisi dei dati?
Partite dalla decisione che dovete prendere, non dal metodo. Usate la statistica descrittiva per riassumere lo stato attuale, un t-test o l'ANOVA per confrontare gruppi, la regressione per stimare relazioni, la PCA o l'analisi fattoriale per ridurre la proliferazione di metriche e l'analisi delle serie temporali quando stagionalità o trend definiscono ciò che è normale.
Quale soglia di Z-score si usa per l'anomaly detection?
Una soglia comune è di 3,0 deviazioni standard dalla media per le anomalie estreme in dati con distribuzione normale. Gli Z-score funzionano bene per metriche stabili come il numero giornaliero di righe di pipeline mature, ma faticano con distribuzioni asimmetriche, forte stagionalità settimanale e problemi a livello di schema come una colonna rinominata.
Come rileva le anomalie il metodo IQR?
Il metodo IQR segnala un valore quando supera Q3 più 1,5 volte lo scarto interquartile o scende sotto Q1 meno 1,5 volte lo stesso scarto. Nel monitoraggio delle serie temporali viene spesso applicato alla componente residua dopo aver separato trend e stagionalità, ottenendo una baseline dinamica per metriche di pipeline non gaussiane.
Quali tipi di anomalie dei dati dovrebbero monitorare i data team?
Il lavoro di observability copre comunemente sei categorie: anomalie di volume, anomalie di schema, anomalie di freschezza, anomalie di distribuzione, record duplicati o mancanti e outlier delle metriche. I problemi di freschezza vengono tipicamente intercettati confrontando gli orari di consegna effettivi con gli schemi appresi e gli orari previsti, mentre gli invarianti rigidi, come i campi obbligatori non nulli, richiedono comunque regole esplicite.


