7 liste di stop word per ricerca e NLP
|
7
min di lettura

Eliminare le parole comuni non è una vittoria universale. Una stop word può essere rumore in un workflow e un segnale fondamentale in un altro, quindi la configurazione giusta delle liste di stop word dipende da ciò che volete migliorare: pertinenza della ricerca, feature NLP, elaborazione nativa nel database o significato dei testi di dominio. I sistemi di information retrieval storici trattavano le stop list come una scorciatoia di indicizzazione, non come una regola generale, e le pipeline moderne affrontano ancora lo stesso compromesso, perché eliminare i termini comuni può ridurre gli indici e velocizzare l'elaborazione, ma anche penalizzare la ricerca per frase e le query critiche per il business (storia delle stop word e compromessi nel retrieval). La regola pratica è semplice: misurate pertinenza, qualità dei modelli ed esiti di qualità dei dati a valle prima e dopo il filtraggio, poi documentate ogni aggiunta o esclusione personalizzata.
Nei testi in inglese, le stop word costituiscono spesso una parte consistente del linguaggio comune, e questo rende la decisione operativa, non estetica. Le indicazioni di NVIDIA riassumono studi secondo cui un tipico testo inglese contiene circa il 30-40% di stop word, il che significa che le scelte di filtraggio possono modificare in modo sostanziale dimensione degli indici, velocità di elaborazione e comportamento dei modelli (indicazioni di NVIDIA sulle stop word). Per questo le sette risorse che seguono vanno lette in base al compito, non al marchio. Alcune sono pensate per l'NLP generico, altre per i motori di ricerca, altre per il machine learning e altre ancora per la gestione dei testi nativa nel database, dove i dati devono restare dove sono.
Indice
1. Stop word inglesi di NLTK
Usatela quando il testo supporta un workflow di monitoraggio
2. Stop word native di Snowflake
Gestite i testi del data warehouse vicino ai dati
3. Stop word di Apache Lucene
Usate Lucene quando il comportamento della ricerca conta più dell'NLP generico
4. Stop word predefinite di spaCy
Usate spaCy quando il significato dipende da grammatica e contesto
5. Dizionari di stop word personalizzati in PostgreSQL e BigQuery
Costruite i dizionari pensando ad audit e riutilizzo
6. Liste di stop word specifiche per settore
Trattate il vocabolario di dominio come parte della progettazione dei controlli
7. Stop word inglesi di scikit-learn
Usatela come punto di partenza per le feature testuali
Confronto tra 7 liste di stop word
Scegliete la lista che preserva il significato
1. Stop word inglesi di NLTK
NLTK è un solido punto di partenza quando il compito è l'NLP generico in Python. La sua lista di stop word inglesi è molto usata nel preprocessing perché offre ai team un modo rapido per eliminare le parole riempitive prima della tokenizzazione, dell'analisi delle frequenze o della classificazione dei testi. Per i team digna, questo la rende utile quando descrizioni di regole di business in linguaggio naturale, tag di metadati o note sugli incidenti devono essere ripulite prima della convalida o dell'analisi delle anomalie. Lo scopo non è fidarsi per sempre dell'impostazione predefinita, ma ottenere rapidamente una base leggibile.
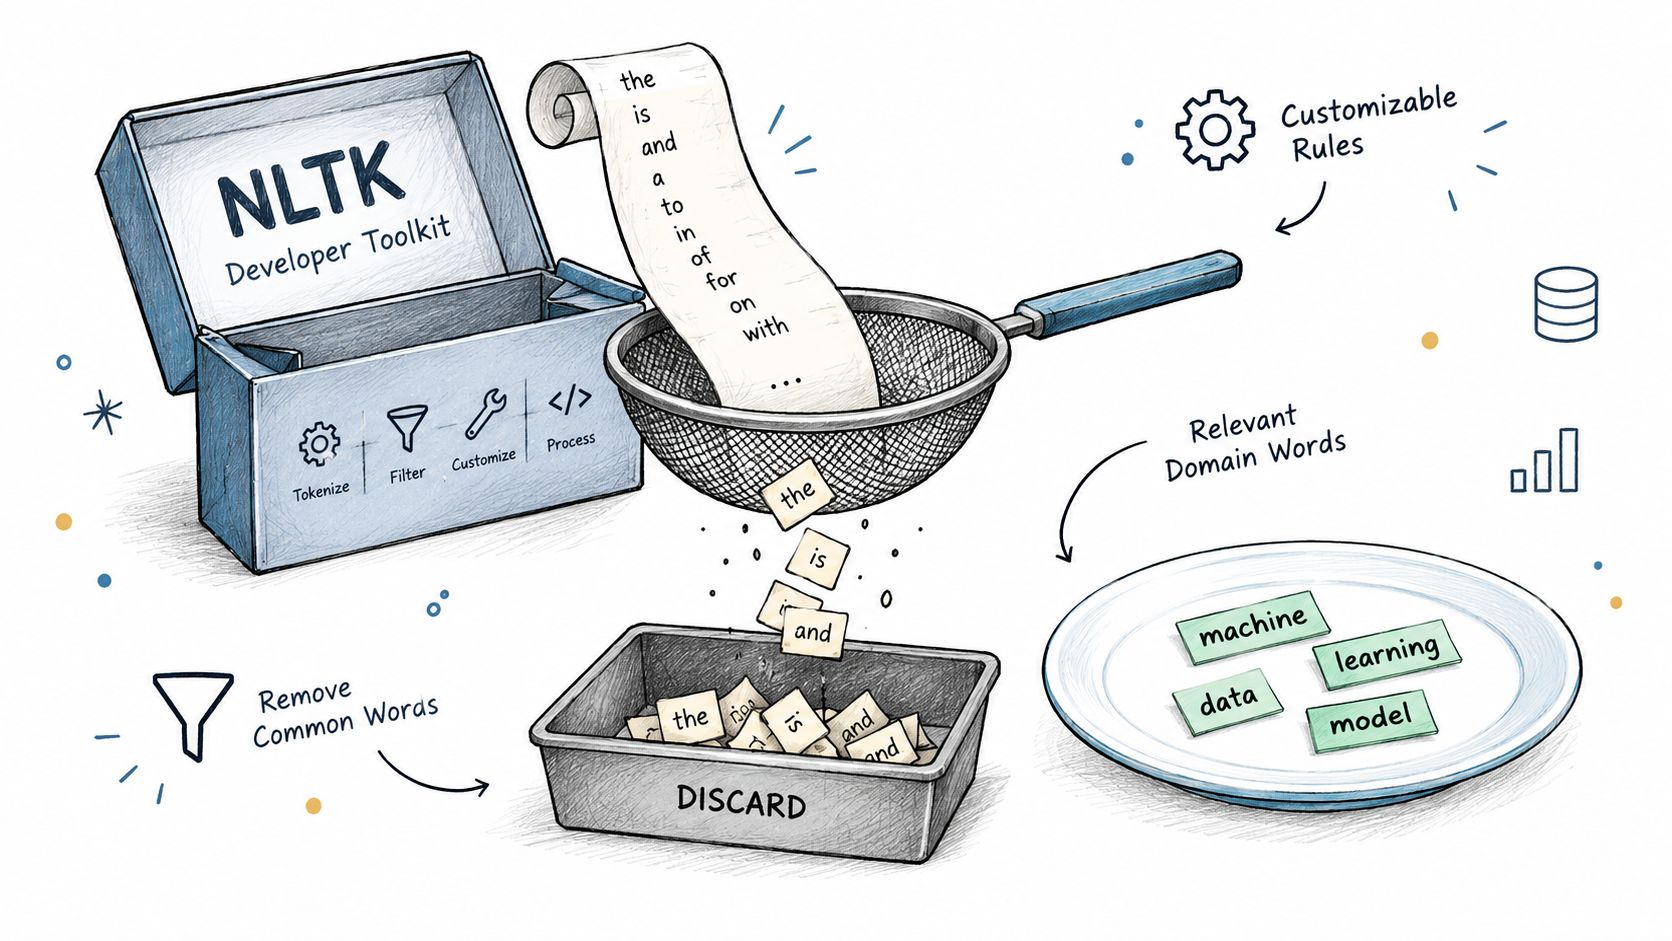
NLTK funziona meglio se la trattate come una lista di partenza, non come una policy definitiva. Se il vostro team di qualità dei dati vede termini come credito, paziente o abbonato ricorrere nel testo delle regole, quelle parole possono avere più significato di quanto presupponga una lista generica. Una lista personalizzata è spesso la scelta più sicura nei servizi finanziari, nella sanità o nelle telecomunicazioni, perché il linguaggio di dominio può essere più importante delle parole riempitive grammaticali.
Usatela quando il testo supporta un workflow di monitoraggio
Un uso pratico è filtrare le descrizioni delle regole in linguaggio naturale, come nelle indicazioni di digna sulla pulizia dei dati, dove l'obiettivo è separare la sintassi dal segnale prima dell'analisi. La stessa lista può aiutare a ripulire note di lineage o riepiloghi di incidenti prima di raggrupparli o conteggiarli. Può anche ridurre il rumore nei campi di testo libero che gli analisti usano per il triage dei problemi sui dati.
Regola pratica: partite dalla lista predefinita, poi aggiungete o rimuovete termini solo dopo averla testata sul vocabolario delle vostre regole di business.
Preservate i termini di dominio: mantenete le parole che cambiano significato nel vostro settore, anche se sono comuni nella lingua generale.
Testate prima del rilascio: confrontate il testo filtrato e non filtrato su campioni reali di incidenti e regole.
Documentate ogni modifica: annotate ogni aggiunta personalizzata, così la logica di convalida resta coerente tra i team.
2. Stop word native di Snowflake
Snowflake entra in gioco quando l'elaborazione dei testi deve restare all'interno del data warehouse. La gestione nativa delle stop word si adatta al lavoro sui dati in cloud perché evita di spostare i testi verso uno stack NLP esterno solo per eliminare i termini comuni. Per i deployment di digna su Snowflake, ciò è in linea con l'esecuzione in-database, poiché il testo resta vicino ai record, alla lineage e ai metadati di schema analizzati.
Questo è importante nei workflow di observability. Se la descrizione di un data catalog o una nota su un incidente viene elaborata dove già risiede, i team evitano orchestrazioni aggiuntive e mantengono più semplice l'audit trail. Nella pratica, il caso d'uso più forte è filtrare i metadati scritti da persone che accompagnano gli schemi, perché il contesto circostante conta spesso quanto l'elenco grezzo dei token.
Snowflake ricorda anche che le stop word non sono solo una questione di NLP. Possono far parte della stessa logica di data warehouse che supporta la ricerca testuale, il triage degli incidenti e la revisione delle modifiche allo schema. Quando lo stesso ambiente gestisce sia lo storage sia l'analisi, una lista di stop word nativa diventa parte del modello operativo anziché un passaggio di preprocessing nascosto in un notebook.
Gestite i testi del data warehouse vicino ai dati
Per i team che monitorano le modifiche al catalogo, questo design è in linea con le indicazioni di digna su Snowflake, soprattutto quando la dashboard deve mostrare cosa è cambiato senza esportare testi sensibili. Una tabella di lookup personalizzata è spesso l'integrazione giusta quando i testi del data warehouse includono termini di business che le liste predefinite eliminerebbero. Questo approccio semplifica anche il versioning tra ambienti.
Usate prima il filtraggio nativo: mantenete la trasformazione all'interno di Snowflake quando i dati risiedono già lì.
Integrate i termini di business: aggiungete un livello specifico per dominio per il vocabolario regolamentato o tecnico.
Verificate le modifiche nei rilasci: esaminate gli aggiornamenti delle stop word prima che incidano su regole esistenti o ricerche salvate.
3. Stop word di Apache Lucene
Lucene è la scelta più mirata quando il compito è l'indicizzazione per la ricerca. La sua lista di stop word inglesi è compatta e ottimizzata per l'information retrieval, il che la rende adatta alla ricerca nel catalogo, alla consultazione della lineage e al recupero di metadati su larga scala. Questo tipo di lista è di solito migliore quando l'obiettivo è una ricerca rapida e mirata piuttosto che un'analisi linguistica ampia.
Il compromesso è facile da trascurare. Una lista più piccola può essere ottima per le prestazioni, ma la pertinenza della ricerca dipende da come le persone interrogano i vostri dati. Un termine che sembra banale in un corpus generico può essere importante nel nome di una tabella, nella descrizione di uno schema o nel titolo di un incidente. Se i vostri utenti cercano frasi esatte, eliminare i termini sbagliati può far sembrare il sistema meno preciso anche se l'indice diventa più piccolo.
Usate Lucene quando il comportamento della ricerca conta più dell'NLP generico
Lucene si adatta ai casi in cui molte persone effettuano ricerche sulla stessa superficie di metadati, come un data catalog con migliaia di tabelle. Nei deployment di digna è particolarmente rilevante per l'esplorazione di schemi e lineage, dove velocità di ricerca e qualità del ranking fanno entrambe parte dell'esperienza utente. Più l'indice è pulito, più è facile far emergere rapidamente l'oggetto giusto.
Lucene dà il meglio quando trattate le stop word come uno strumento di ottimizzazione della ricerca, non come un generico passaggio di pulizia.
Per questo le indicazioni di digna sulla ricerca con caratteri jolly rientrano nello stesso workflow. La ricerca con caratteri jolly e il filtraggio delle stop word agiscono su parti diverse del retrieval, ma nella pratica interagiscono quando gli utenti digitano nomi parziali, frasi miste o etichette di metadati rumorose. Se la superficie di ricerca è importante dal punto di vista operativo, testatela sui log delle query reali prima di standardizzare la lista.
4. Stop word predefinite di spaCy
spaCy è più adatto quando la pipeline richiede una copertura linguistica più ampia e un'elaborazione linguistica più accurata. Il suo set predefinito di stop word inglesi è più ampio delle liste orientate alla ricerca e supporta inoltre risorse di stop word per molte lingue. Questo è importante quando il testo viene analizzato sintatticamente, lemmatizzato ed esaminato, non solo tokenizzato.
Per gli utenti di digna, il test pratico è capire se il linguaggio porta ancora segnali di rischio nelle regole di qualità dei dati, nei riepiloghi degli incidenti e nelle descrizioni degli schemi. La spiegazione di una regola può dipendere da una formulazione, ad esempio se un campo è obbligatorio solo in determinate condizioni. In questo contesto, eliminare le parole comuni in modo troppo aggressivo può cancellare la logica che gli analisti devono esaminare.
Usate spaCy quando il significato dipende da grammatica e contesto
spaCy funziona bene per estrarre concetti chiave dalle descrizioni degli incidenti e individuare pattern ricorrenti nel testo delle regole. È adatto anche ai team che necessitano di una gestione coerente tra lingue diverse o di una configurazione centralizzata per un framework di qualità dei dati più ampio. Negli ambienti regolamentati, questa coerenza può contare quanto la qualità del modello in sé.
Il pattern migliore è estendere la lista predefinita solo dopo averla testata su testi reali. Nel settore finanziario, termini come credito e debito potrebbero dover restare. Nella sanità, paziente e farmaco possono essere troppo importanti per essere eliminati. Nelle telecomunicazioni, abbonato può essere un segnale fondamentale anziché una parola riempitiva.
Buona pratica: usate insieme la pipeline linguistica e le stop word di spaCy, poi decidete se il vocabolario di dominio richiede un livello di esclusione separato.
Questo approccio è in linea con le indicazioni di digna sui dati storici quando il testo delle regole di business deve restare interpretabile per analisti e auditor.
5. Dizionari di stop word personalizzati in PostgreSQL e BigQuery
I dizionari nativi del database sono la scelta giusta quando l'elaborazione dei testi deve restare all'interno della piattaforma. La ricerca full-text di PostgreSQL e le funzioni testuali configurabili di BigQuery consentono ai team di collocare le regole sulle stop word più vicino ai dati, riducendo gli spostamenti e rendendo la governance più facile da tracciare. Per i team che lavorano già su questi sistemi, questa collocazione spesso determina il design.
Il compromesso è semplice: la gestione delle stop word passa dalla pulizia linguistica generica al controllo della piattaforma. Un team sanitario può mantenere i termini clinici in un dizionario ed eliminare le parole generiche in un altro. Un team dei servizi finanziari può documentare ogni modifica ai fini della compliance. Il valore non è solo il filtraggio, ma mantenere la policy sui testi allineata all'ambiente in cui i testi vengono interrogati.
Costruite i dizionari pensando ad audit e riutilizzo
Per i deployment di digna, le liste native del database si adattano bene al modello di esecuzione in-database. Supportano inoltre workflow ripetibili per descrizioni delle modifiche allo schema, testi delle regole di business e metadati del catalogo che altrimenti verrebbero copiati in strumenti separati. Questo li rende più facili da sottoporre ad audit e da mantenere allineati tra gli ambienti. Per i workflow specifici di BigQuery, la pagina di digna sulla qualità dei dati in BigQuery è un utile punto di riferimento, mentre i team PostgreSQL possono usare la pagina di digna sulla qualità dei dati in PostgreSQL per mantenere filtraggio e convalida nello stesso flusso operativo.
Suddividete per dominio: usate dizionari separati per testi operativi, regolamentati e analitici.
Tracciate le modifiche in modo formale: versionate le modifiche ai dizionari così che revisioni e rollback siano semplici.
Testate con testi rappresentativi: convalidate su descrizioni reali, non su esempi di prova.
Il vantaggio principale è il controllo. I team sanno quali regole sono attive, dove vengono eseguite e come influenzano i risultati. Questo è importante perché eliminare la parola sbagliata può danneggiare la pertinenza della ricerca o offuscare il significato di business, soprattutto quando lo stesso termine ha un peso diverso nei workflow di database, analytics e compliance.
6. Liste di stop word specifiche per settore
Le liste generiche mostrano i loro limiti più rapidamente nei settori regolamentati. Una parola che sembra irrilevante nel linguaggio comune può essere centrale per il reporting finanziario, la sicurezza dei pazienti o il monitoraggio dei KPI nelle telecomunicazioni. Per questo le liste di stop word specifiche per settore non servono tanto a eliminare più parole, quanto a preservare i termini che portano significato di business.
I servizi finanziari di solito hanno bisogno che termini come debito, credito, transazione e regolamento restino visibili. I team sanitari spesso hanno bisogno che paziente, diagnosi, trattamento e farmaco sopravvivano al filtraggio. I team delle telecomunicazioni possono contare su parole come abbonato, churn, ricavi e arpu per un monitoraggio accurato. In ogni caso, la stop list sbagliata può offuscare il segnale di cui gli operatori hanno bisogno.
Trattate il vocabolario di dominio come parte della progettazione dei controlli
Qui la governance è importante. I team di compliance dovrebbero esaminare la lista, perché la decisione di mantenere o eliminare un termine può incidere su audit trail, interpretazione dei KPI e rilevamento delle anomalie. Se una regola di business o una soglia di monitoraggio dipende da una formulazione di dominio, quella parola non dovrebbe essere eliminata con leggerezza dall'analisi.
Se una parola comune cambia l'interpretazione di una metrica regolamentata, per il vostro caso d'uso non è una stop word.
Questo principio si sposa naturalmente con le indicazioni di digna sulla governance in ambito finanziario, poiché i team finance hanno spesso bisogno di un controllo rigoroso su terminologia, convalida e verificabilità. La stessa logica si estende ai dati della sanità e del settore pubblico, dove la tracciabilità può contare quanto la comodità.
7. Stop word inglesi di scikit-learn
scikit-learn appartiene al livello di machine learning, non a quello di ricerca. Le sue stop word inglesi sono pensate per la feature extraction, il che le rende una base sensata per vettorizzazione, classificazione e feature testuali legate alle anomalie. Se il compito è trasformare note sugli incidenti o descrizioni degli schemi in feature, questa è la lista adatta alla pipeline.
Il grande vantaggio è la compatibilità. Le stop word di scikit-learn si integrano facilmente nei workflow di ML in Python, soprattutto quando i team costruiscono feature TF-IDF o altre rappresentazioni sparse. Per gli utenti di digna, questo le rende utili per l'apprendimento della baseline, l'analisi statistica dei pattern e il triage basato su modelli dei testi che accompagnano gli eventi di qualità dei dati.
Usatela come punto di partenza per le feature testuali
La chiave è ragionare come chi costruisce modelli, non come un ingegnere della ricerca. Una pipeline di machine learning trae spesso vantaggio dall'eliminazione delle parole riempitive ad alta frequenza, ma il valore dipende dal fatto che i termini rimanenti migliorino previsione, clustering o rilevamento delle derive. Se il filtro è troppo aggressivo, il modello può perdere distinzioni utili. Se è troppo permissivo, le feature restano rumorose.
Per questo la best practice è partire dalla lista di base e aggiungere termini di dominio solo dopo aver verificato il comportamento del modello su esempi reali del vostro ambiente. Una nota sulla modifica di uno schema in un'azienda può usare un linguaggio che in un'altra è generico, e la lista dovrebbe riflettere questa differenza.
Usate prima una baseline: mantenete la lista predefinita prima di introdurre termini personalizzati.
Allineatevi alla vettorizzazione: abbinatela a TF-IDF o a metodi di feature extraction simili.
Esaminate l'output del modello: verificate se i termini eliminati hanno cambiato le previsioni, non solo il numero di token.
Confronto tra 7 liste di stop word
Elemento | Complessità di implementazione 🔄 | Requisiti di risorse ⚡ | Risultati attesi 📊 & qualità ⭐ | Casi d'uso ideali 💡 | Vantaggi principali ⭐ |
|---|---|---|---|---|---|
Stop word inglesi di NLTK | Bassa, lista semplice; facile da personalizzare | Bassi, pacchetto Python leggero | Impatto moderato; riduce il rumore ma richiede tuning, ⭐⭐⭐ | Preprocessing NLP generico, pulizia dei metadati | Open source, ampiamente adottata, facile da personalizzare |
Stop word native di Snowflake | Bassa, configurazione nativa, setup minimo | Minimi, in-database, nessuna dipendenza esterna, throughput elevato | Alti per il filtraggio nel data warehouse; rapido & favorevole alla governance, ⭐⭐⭐⭐ | digna su Snowflake; filtraggio e tokenizzazione dei testi in-database | Nessuno spostamento dei dati, prestazioni ottimizzate, i dati restano dove sono |
Stop word di Apache Lucene | Bassa, si integra facilmente negli stack di ricerca | Bassi, lista piccola, overhead minimo | Alti per pertinenza della ricerca ed efficienza dell'indicizzazione, ⭐⭐⭐⭐ | Ricerca full-text, ottimizzazione di indici su larga scala (ES/Solr) | Lista molto compatta, migliora la velocità di ricerca e riduce la dimensione dell'indice |
Stop word predefinite di spaCy | Media, richiede l'installazione di spaCy e dei modelli | Medi, Python + modelli NLP; più potenza di calcolo | Alti per attività linguistiche e filtraggio consapevole delle entità, ⭐⭐⭐⭐ | NLP avanzato, analisi della complessità delle regole di business, parsing semantico | Curata, integrata nella pipeline NLP, personalizzabile a runtime |
Dizionari personalizzati PostgreSQL & BigQuery | Media–alta, setup specifico per database e diritti di amministrazione | Risorse in-database; richiede competenze da DBA | Alti per un'elaborazione conforme e scalabile nel data warehouse, ⭐⭐⭐⭐ | Ambienti regolamentati, dizionari personalizzati per tabella/schema | Completamente personalizzabili nel database, nessuna dipendenza esterna, adatti agli audit |
Liste di stop word specifiche per settore (finanza, sanità, telecomunicazioni) | Alta, richiede competenze di dominio e manutenzione continua | Medi, team dedicati, possibili costi di fornitori/licenze | Precisione di dominio molto alta; riduce i falsi positivi, ⭐⭐⭐⭐⭐ | Rilevamento delle anomalie in settori regolamentati, convalida delle regole, monitoraggio dei KPI | Preservano i termini critici, migliorano precisione del rilevamento e compliance |
Stop word inglesi di scikit-learn | Media, integrata nelle pipeline di ML | Medi, stack ML Python (TF-IDF, modelli) | Alti per la feature extraction di ML e la preparazione dei modelli, ⭐⭐⭐⭐ | Rilevamento delle anomalie basato su ML, feature engineering, workflow TF-IDF | Ottimizzata per il ML, riproducibile, compatibile con gli strumenti di scikit-learn |
Scegliete la lista che preserva il significato
La scelta migliore tra le liste di stop word dipende dal compito che avete davanti. Usate Lucene quando la priorità è un'indicizzazione di ricerca mirata. Usate NLTK o spaCy per l'NLP generico in Python, soprattutto quando ripulite metadati, testi di incidenti o descrizioni di regole. Usate scikit-learn quando il testo alimenta un modello, non una casella di ricerca. Usate i dizionari nativi del database quando l'elaborazione deve restare dove sono i dati. Aggiungete estensioni specifiche per settore ogni volta che i termini di business portano un segnale che le liste generiche cancellerebbero.
Il processo di selezione deve restare pragmatico. Testate precision, recall, pertinenza della ricerca, comportamento dei modelli ed esiti di qualità dei dati a valle prima di standardizzare qualsiasi cosa. Poi versionate la lista, esaminate le modifiche e tenete le parole critiche per il dominio fuori dal set di stop word, a meno che non abbiate dimostrato che non contano nei vostri dati.
Questa disciplina è esattamente il motivo per cui la gestione delle stop word rientra nella stessa discussione di observability e convalida. Se una parola cambia il ranking della ricerca, l'output di un modello o l'interpretazione di un incidente, appartiene alla governance, non a una lista predefinita. Mantenete la policy vicino alle persone che sono responsabili dei dati e aggiornatela quando cambia il vocabolario di business.
digna aiuta i team a mantenere questa disciplina all'interno dello stesso ambiente in cui i dati già risiedono. I suoi moduli di qualità dei dati, schema tracking, monitoraggio della tempestività e rilevamento delle anomalie rendono più facile testare le regole testuali su dati operativi reali invece di procedere per ipotesi. Visitate digna se volete collegare le scelte sulle stop word a monitoraggio, convalida e observability in-database in un'unica piattaforma.
Se il vostro filtraggio delle stop word viene eseguito all'interno del data warehouse, come raccomandato nella sezione su Snowflake, il monitoraggio della qualità dei dati per Snowflake può essere eseguito nello stesso luogo, così le regole testuali e le tabelle che descrivono vengono verificate senza esportare dati.
Domande frequenti
A cosa serve una lista di stop word?
Una lista di stop word indica a un motore di ricerca o a una pipeline NLP quali parole comuni scartare prima dell'indicizzazione o dell'analisi. Un tipico testo inglese è composto per circa il 30-40% da stop word, quindi la lista scelta può modificare in modo sostanziale dimensione degli indici, velocità di elaborazione e comportamento dei modelli.
Quale lista di stop word usare per l'indicizzazione della ricerca?
Apache Lucene è la scelta più adatta quando il compito è l'indicizzazione per la ricerca. La sua lista inglese è compatta e ottimizzata per l'information retrieval, ideale per la ricerca nei cataloghi e la consultazione dei metadati. Testatela prima sui log delle query reali, perché eliminare i termini sbagliati può penalizzare le ricerche per frase esatta.
Qual è la differenza tra le stop word di NLTK, spaCy e scikit-learn?
Ogni libreria è pensata per un compito diverso. NLTK è una base rapida per l'NLP generico in Python, spaCy offre un set predefinito più ampio e molte lingue per pipeline attente alla grammatica, mentre la lista di scikit-learn è costruita per la feature extraction, come la vettorizzazione TF-IDF, quando il testo alimenta un modello anziché una casella di ricerca.
Conviene eliminare come stop word termini di dominio come credito o paziente?
Di solito no. Le liste generiche possono eliminare termini che portano significato di business, come debito, credito e regolamento nella finanza, paziente e diagnosi nella sanità, o abbonato, churn e ARPU nelle telecomunicazioni. Se una parola comune cambia l'interpretazione di una metrica regolamentata, per voi non è una stop word.
Come personalizzare una lista di stop word in sicurezza?
Partite da una lista predefinita, poi aggiungete o rimuovete termini solo dopo aver testato il testo filtrato e non filtrato su campioni reali. Misurate pertinenza, qualità dei modelli ed esiti a valle, documentate ogni modifica personalizzata e versionate i dizionari, ad esempio quelli di PostgreSQL o BigQuery, così che revisioni e rollback restino semplici.


