dbt Semantic Layer: guida ad architettura e vantaggi nel 2026
|
6
min di lettura

Conoscete bene questa riunione. La finanza ha un dato di fatturato nella presentazione per il consiglio, il marketing ne ha un altro in Tableau e il team di prodotto sta guardando una terza versione in Power BI. Tutti osservano la stessa azienda, lo stesso mese, eppure tre dashboard raccontano tre storie diverse. È in quel momento che il dbt semantic layer smette di essere un'idea architetturale interessante e inizia a sembrare un requisito di base per la fiducia.
Nella sua forma migliore, un semantic layer offre al vostro team un'unica definizione governata di una metrica e consente poi a molti strumenti di utilizzarla senza ricreare la logica in ciascuno di essi. dbt descrive questo approccio come una rappresentazione unificata e comprensibile per il business dei dati e un repository centralizzato per la logica delle metriche, così che i consumatori possano accedere a dati coerenti e governati attraverso più endpoint (introduzione al semantic layer). La parte difficile non è la definizione in sé. È fare in modo che quella definizione sopravviva alla realtà disordinata dei dati di produzione, alla proliferazione degli strumenti e alle regole di business che cambiano.
Indice
dbt Semantic Layer, LookML e semantic layer degli strumenti di BI a confronto
Perché le query tramite AI e LLM hanno bisogno di un semantic layer
Rendere affidabili le metriche con observability e validazione
I costi nascosti e la realtà dell'adozione di cui nessuno parla
I primi 30 giorni con il dbt Semantic Layer: un piano pratico
Perché tre dashboard mostrano tre dati di fatturato diversi
Il disaccordo di solito nasce in una sala riunioni, non in un diagramma. Un CFO chiede perché il monthly recurring revenue di una dashboard non coincide con quello di un'altra, e tre analisti iniziano a ricostruire la logica attraverso toolchain separate. Un report esclude i rimborsi, un altro li conteggia in seguito e un terzo suddivide i dati in base a un campo data completamente diverso. Nessuno sta mentendo. Le definizioni si sono semplicemente allontanate l'una dall'altra.
Il vero problema è la logica duplicata
Questa deriva si verifica perché ogni superficie di analytics tende a reimplementare la regola di business a modo suo. Uno strumento di BI riceve un'espressione, un'app integrata un'altra, e una query SQL veloce in un notebook diventa la versione “temporanea” che, chissà come, resta in circolazione per mesi. Una volta iniziato questo processo, l'azienda non misura più davvero il fatturato: misura l'interpretazione locale del fatturato di ciascun team.
L'impostazione di dbt è utile perché tratta questo tema come un problema di governance, non come una funzionalità di comodo. Descrive il semantic layer come un framework per creare una rappresentazione unificata e comprensibile per il business dei dati e un repository centralizzato per la logica delle metriche, così che i consumatori possano accedere a dati coerenti e governati attraverso più endpoint (introduzione al semantic layer). È proprio questo il punto: una sola definizione deve alimentare molti consumatori senza costringere ciascuno di essi a gestire i calcoli.
Regola pratica: se due dashboard non concordano ed entrambe sono tecnicamente “corrette”, la causa principale è di solito una logica delle metriche duplicata, non un grafico sbagliato.
Cosa risolve e cosa no
Un semantic layer non sistema magicamente tabelle sorgente disordinate o una progettazione dei modelli approssimativa. Fa qualcosa di più circoscritto e di maggior valore: definisce centralmente la logica delle metriche, così che alla stessa domanda di business si possa rispondere in modo coerente in strumenti di BI, app e API. Questa coerenza conta perché la stessa definizione di metrica può servire più endpoint senza che ciascuno debba reimplementare da zero join, filtri e logica temporale.
Cambia anche la conversazione all'interno dei team di analytics. Invece di chiedere “Quale dashboard è giusta?”, potete chiedere “Quale definizione è approvata?”. Sembra poco, ma è la differenza tra una riconciliazione infinita e un data product di cui le persone possono fidarsi. Il limite è operativo: il semantic layer riduce la duplicazione solo quando il team è abbastanza disciplinato da mantenere un'unica fonte di verità.
Come è realmente costruito il dbt Semantic Layer
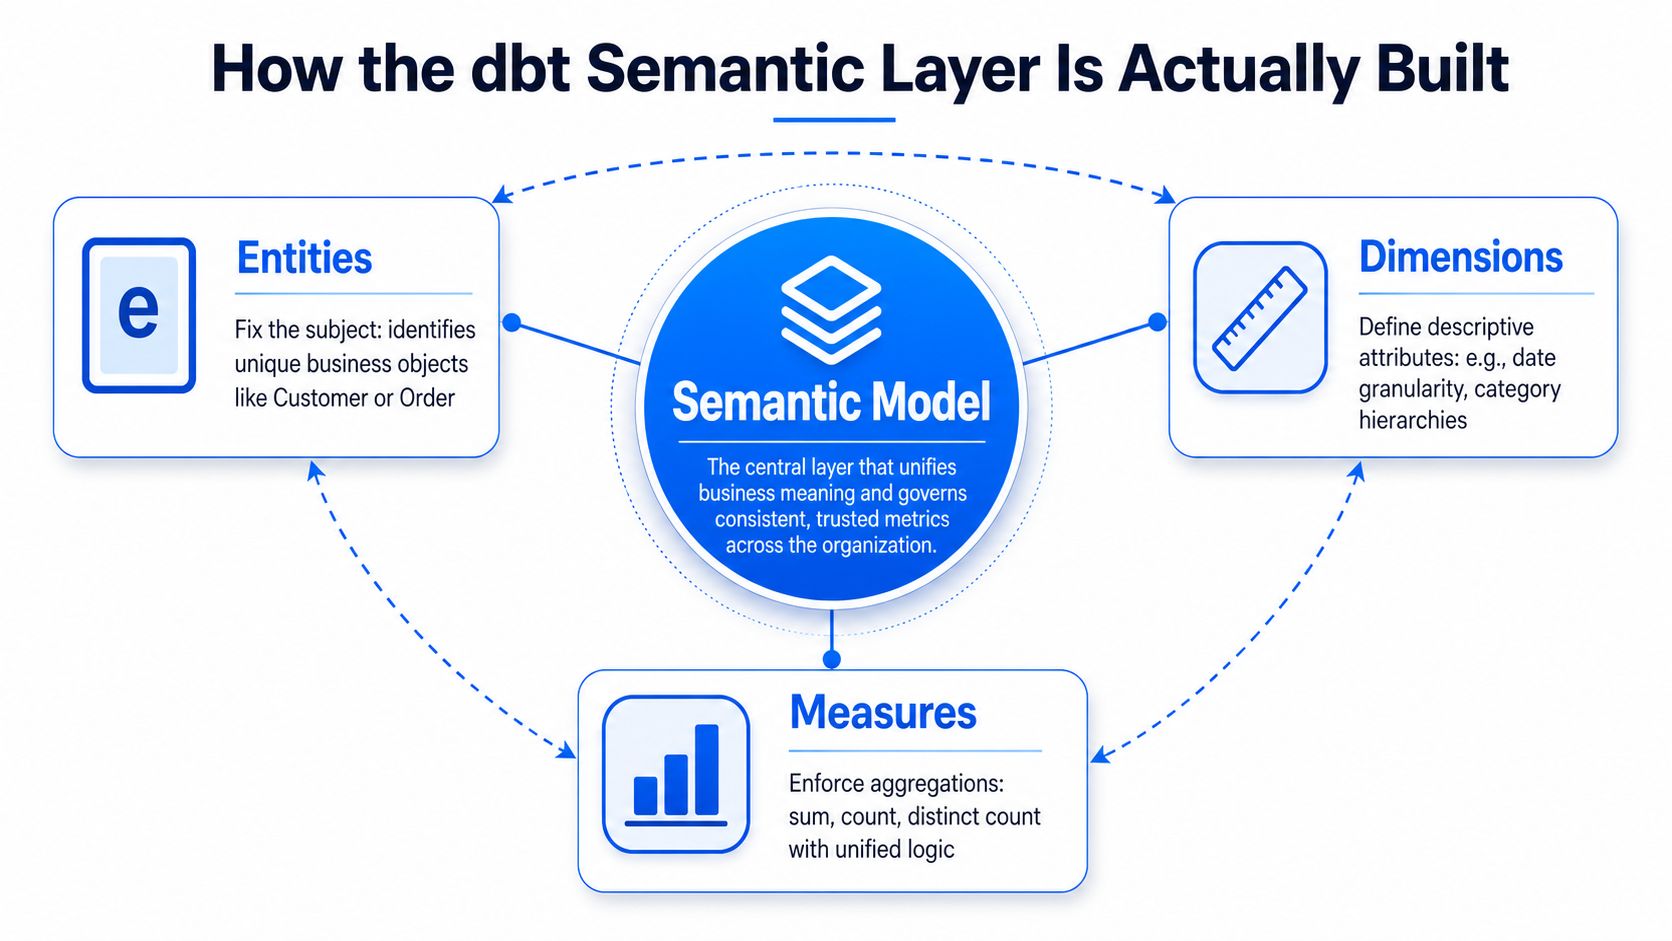
Le tre componenti che mantengono corretta la logica delle metriche
La documentazione di dbt suddivide i semantic model in tre componenti distinte: entità, dimensioni e misure (componenti del semantic model). Ciascuna serve a tenere un diverso tipo di errore fuori dalla definizione della metrica.
Le entità definiscono relazioni e granularità. In parole semplici, indicano quale oggetto rappresenta una riga e come questo modello si collega agli altri. Le dimensioni sono i campi che le persone usano per suddividere, raggruppare e filtrare i risultati. Le misure sono i valori quantitativi destinati a essere aggregati. Questa separazione conta perché vi obbliga a considerare identità, descrizione e calcolo come problemi distinti, invece di comprimerli in un'unica espressione approssimativa.
Perché MetricFlow è importante
Il dbt Semantic Layer non è solo un catalogo di metadati affiancato al vostro warehouse. dbt lo descrive come un livello di costruzione delle query che prende le definizioni governate delle metriche e genera l'SQL per il warehouse, compresa la logica dei join, prima che la query venga eseguita (documentazione dell'architettura). MetricFlow è il motore che svolge questo lavoro nell'architettura di dbt Labs, dopo l'acquisizione di Transform da parte di dbt Labs all'inizio del 2023, ed è il componente che trasforma una richiesta come “clienti attivi mensili” in vero SQL.
Questa distinzione è facile da trascurare. Un catalogo vi dice cosa esiste. Il semantic layer dice al warehouse come calcolarlo. Risolve i join, applica la granularità temporale corretta ed emette SQL ottimizzato, così che lo strumento che lo utilizza non debba conoscere i dettagli interni del modello.
Un esempio semplice
Supponiamo che qualcuno richieda monthly_active_customers in Tableau, tramite un'API o in una dashboard integrata. Il consumatore non ha bisogno di sapere dove si trovano gli identificativi dei clienti, quale tabella contiene gli eventi di attività o come è definita la finestra temporale. MetricFlow prende la richiesta della metrica, consulta il semantic model, risolve il percorso di join necessario e genera la query sul warehouse che restituisce il valore.
Ecco perché il semantic layer è diverso dalle viste SQL costruite a mano. La logica risiede in un unico punto, ma la superficie di consumo può variare. In pratica, uno sviluppatore BI, un ingegnere di applicazioni e un analista possono usare tutti la stessa definizione di metrica senza portarsi dietro copie separate del calcolo. Il vantaggio non è solo il riutilizzo. È un riutilizzo controllato.
dbt Semantic Layer, LookML e semantic layer degli strumenti di BI a confronto
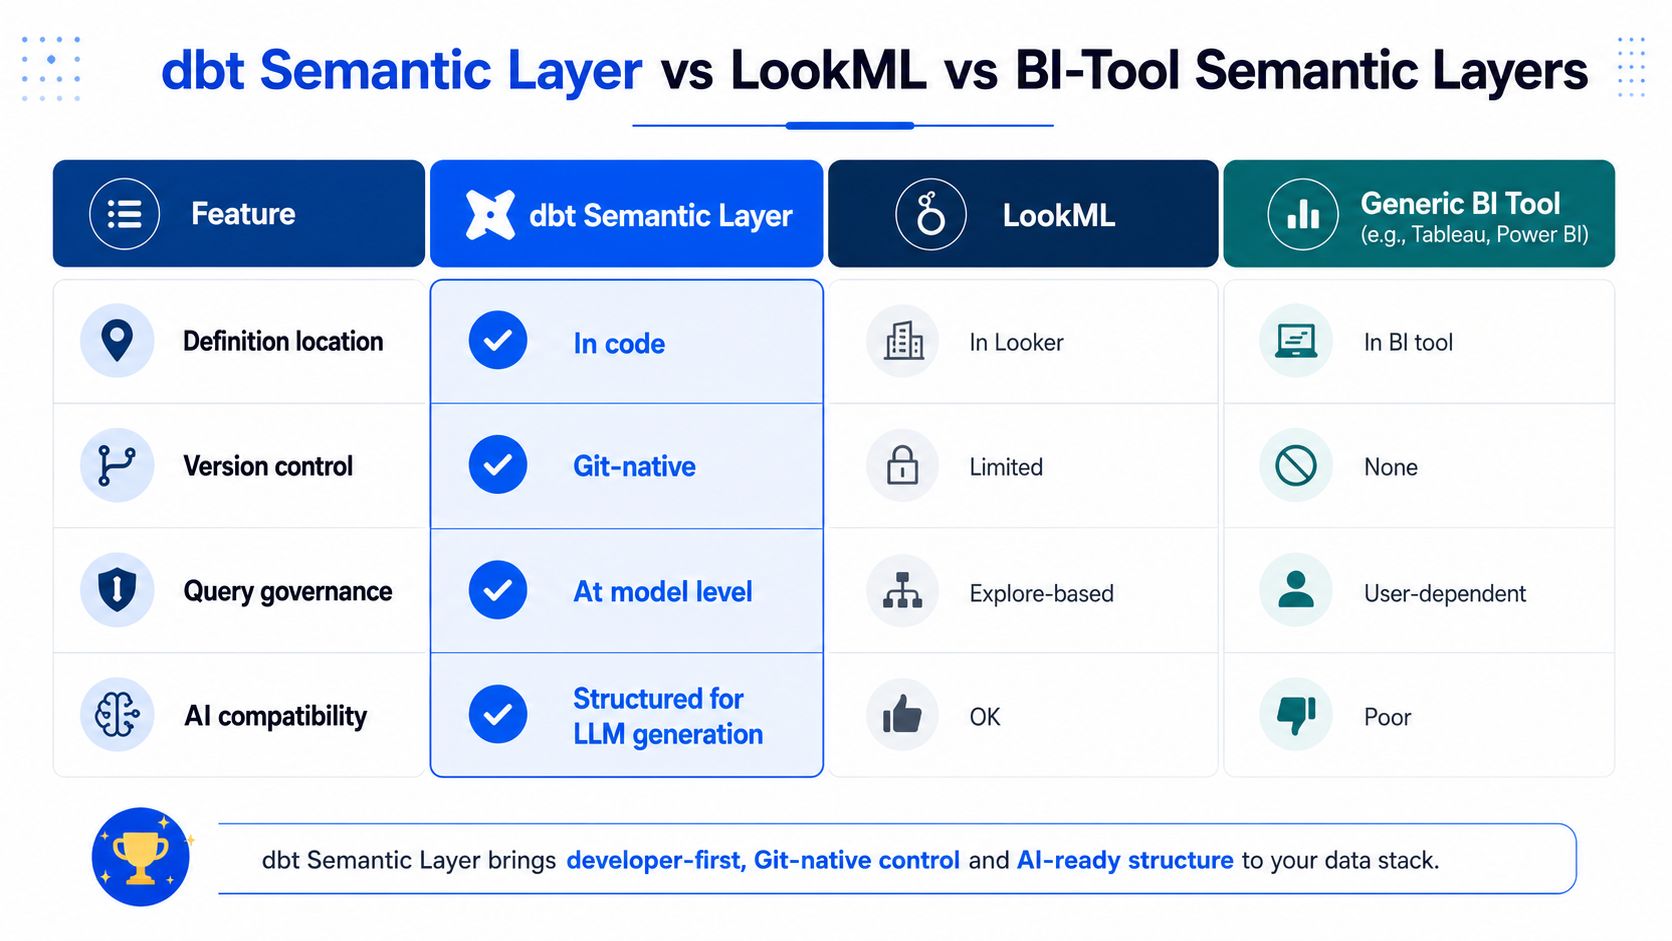
Dove risiede la logica cambia tutto
Il modo più semplice per confrontare questi layer è porsi una domanda: dove risiede la definizione della metrica? In dbt risiede nel codice insieme ai vostri modelli, il che la rende parte dello stesso workflow sotto controllo di versione del resto del livello di trasformazione. In LookML risiede all'interno del livello di modellazione di Looker. In uno strumento di BI generico, di solito risiede nel modello di dati o nel sistema di calcolo di quello strumento.
Questa scelta di collocazione incide sulla governance. Il Semantic Layer di dbt è progettato per essere nativo Git, il che significa che le modifiche passano attraverso pull request, peer review e job di deploy, come il resto del progetto. I semantic layer degli strumenti di BI sono comodi quando a un team interessa una sola interfaccia, ma legano la governance a quell'interfaccia. Se in seguito l'organizzazione vuole la stessa metrica in un'API, in un'app integrata o in un altro strumento di BI, spesso il modello deve essere ripensato o duplicato.
In cosa eccelle ciascun layer
LookML è forte quando Looker è il baricentro. Offre ai team un ambiente di modellazione semantica all'interno di quella piattaforma, e molti team apprezzano la rapidità di restare in un unico prodotto. I layer generici degli strumenti di BI vanno bene per calcoli ad hoc e per la comodità del reporting locale, soprattutto quando al business serve una sola superficie.
L'approccio di dbt è diverso perché si colloca al di sotto dei consumatori. Ciò significa che la stessa definizione può alimentare Tableau, Mode, un'API o una dashboard integrata senza modificare la logica della metrica per ogni endpoint. La documentazione dell'architettura di dbt afferma che il layer genera l'SQL, compresa la logica dei join, prima dell'esecuzione, così che un unico semantic model possa servire BI, API e altri consumatori (documentazione dell'architettura).
Una buona regola empirica: se la governance deve sopravvivere alla dashboard, tenete la definizione fuori dalla dashboard.
Il compromesso da tenere presente
Il principale vantaggio del modello di dbt è il disaccoppiamento. Il costo principale è che i team devono prendere sul serio la disciplina di modellazione, perché un layer centralizzato non può salvare definizioni incoerenti che non sono mai state standardizzate. I layer degli strumenti di BI possono sembrare più semplici all'inizio perché sono vicini al consumatore, ma questa comodità crea spesso un lock-in più forte verso un'unica interfaccia e minori possibilità di riutilizzare le metriche.
Perché le query tramite AI e LLM hanno bisogno di un semantic layer
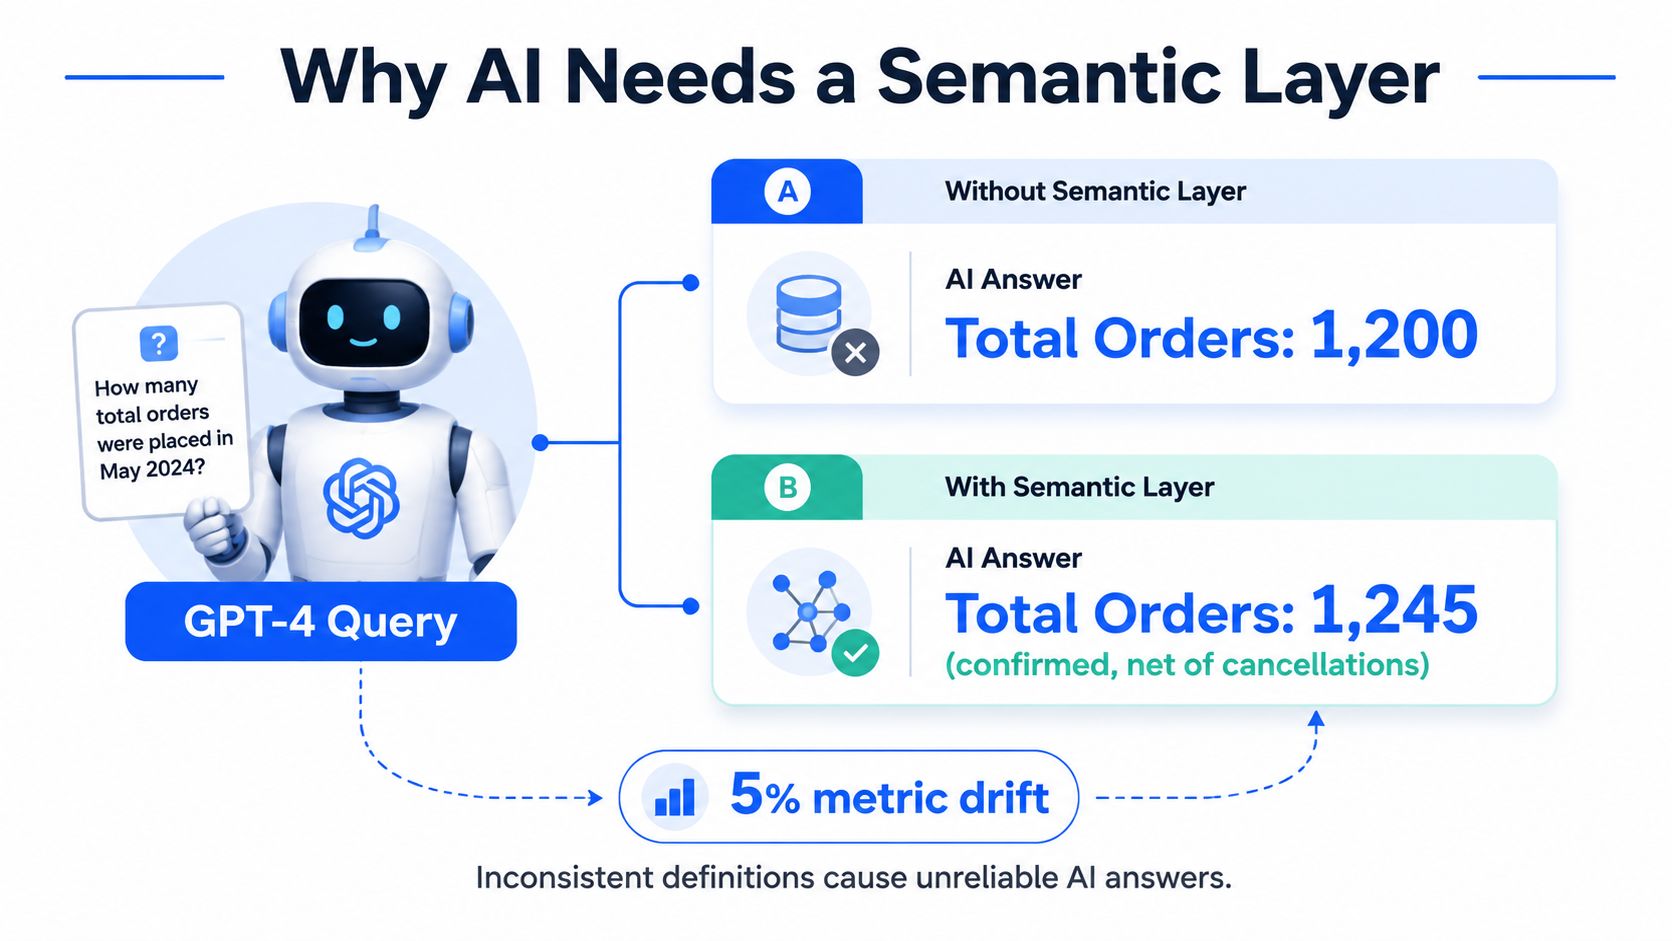
Il linguaggio naturale non è la definizione di una metrica
Oggi gli LLM sono consumatori di analytics, il che sembra utile finché non si ricorda con quanta facilità possono confondere colonne simili, campi data incompatibili o termini di business ambigui. dbt ha documentato un esperimento in cui GPT-4, rispondendo a domande aziendali in linguaggio naturale su database SQL, ha raggiunto un'accuratezza del 16,7%, mentre una rappresentazione a knowledge graph l'ha portata al 54,2%, con un guadagno di 37,5 punti percentuali e un miglioramento di oltre 3 volte. dbt ha inoltre riferito che l'approccio con semantic layer ha raggiunto un'accuratezza dell'83% su un sottoinsieme di otto domande gestibili (esperimento sull'interfaccia dati per LLM).
Questi numeri contano perché mostrano la natura del problema. Un LLM che scrive SQL liberamente su un warehouse può essere brillante e sbagliare comunque esattamente nei modi che i team finanziari detestano di più. Un'interfaccia di metriche governate offre al modello un percorso vincolato verso la risposta.
Perché le metriche governate aiutano l'AI a comportarsi bene
Un LLM in grado di interrogare un semantic layer non ha bisogno di dedurre il significato di business di ogni colonna. Richiede una metrica, ottiene una definizione governata e la usa in modo coerente in tutte le risposte. Questo rende l'assistente meno un improvvisatore e più un front end di interrogazione controllato.
La conclusione operativa è semplice. Se l'AI deve dire ai manager qual è il numero, quel numero ha bisogno di una definizione più solida di un prompt. Il semantic layer diventa il contratto tra intenzione umana ed esecuzione da parte della macchina.
Ecco perché il tema va oltre i chatbot. Qualsiasi sistema che traduce linguaggio comune in query di analytics trae vantaggio da una logica delle metriche centralizzata ed esplicita. Meno il modello deve tirare a indovinare, meno spazio c'è per la deriva.
Configurare il dbt Semantic Layer nella pratica
Partite dal warehouse e dal YAML
Un rollout pratico parte dal warehouse, perché le indicazioni di configurazione di dbt richiedono un'esecuzione di dbt già completata con successo su un warehouse supportato come Snowflake, BigQuery, Databricks o Redshift (guida alla configurazione). Da lì, le definizioni delle metriche risiedono in file YAML accanto al YAML dei modelli dbt, il che mantiene il semantic layer nella stessa struttura di progetto del resto delle trasformazioni. Questa collocazione conta perché lega la logica delle metriche alle stesse abitudini di revisione, versionamento e deployment che il team usa già per i modelli.
Il workflow è volutamente controllato. Effettuate il commit della modifica, ottenete l'approvazione della pull request da parte di un altro membro del team, create un job di deploy ed eseguitelo per pubblicare il nuovo semantic model e la relativa documentazione. Questo livello di attrito è appropriato per un layer che alimenterà dashboard, reporting pianificato e applicazioni a valle. La definizione di una metrica non è uno schizzo su una lavagna, ma parte del contratto di produzione.
Migrate come professionisti, non come in una demo
dbt raccomanda uno schema di migrazione per fasi: partite da un data product circoscritto e di alto valore, create una versione parallela e poi spostate gli strumenti esterni sugli artefatti del Semantic Layer una volta verificati. Un rollout per fasi riduce il rischio, perché confrontate un percorso governato con un altro prima che qualcuno dipenda dal nuovo risultato.
Una metrica di retention rivolta ai clienti è un buon esempio. Se la dashboard attuale è stabile ma disordinata, duplicate solo quel percorso di metrica, confrontate gli output e solo allora spostate i consumatori. Lo scopo è mantenere ridotto il raggio d'impatto mentre verificate che il semantic model corrisponda alle aspettative del business. È lo stesso motivo per cui i team spesso confrontano gli output tra i diversi layer prima di fidarsi di quello nuovo in produzione.
Per i team che devono decidere come le persone utilizzeranno la nuova superficie delle metriche, conta anche la scelta dell'interfaccia. Se state valutando un front end conversazionale rispetto al reporting classico, un confronto tra strumenti di chat AI per i blog WordPress può aiutarvi a capire se quel livello debba poggiare su metriche governate o restare limitato a workflow di reporting più leggeri (confronto tra strumenti di chat AI per blog WordPress).
Mantenete stretto il ciclo di implementazione
Il ciclo di implementazione dovrebbe risultare familiare a qualsiasi analytics engineer. Definite il semantic model, testatelo, revisionatelo, distribuitelo e poi verificatelo con query reali a valle. Se il processo sembra più lento della modifica rapida di una dashboard, è normale. Un semantic layer comporta più responsabilità di un singolo grafico, quindi i controlli devono intercettare errori di nomenclatura, lacune nella logica delle misure e discrepanze tra intenzione e output prima che si propaghino.
La stessa disciplina vale per la freshness e l'affidabilità delle sorgenti. Un modello può essere definito perfettamente e poggiare comunque su input obsoleti o danneggiati, quindi i controlli sulle sorgenti devono far parte del piano di rollout. Per i team che vogliono rafforzare questa parte dello stack, questa guida alla source freshness di dbt è un utile complemento quando volete che i controlli di freshness alimentino lo stesso modello di fiducia.
Rendere affidabili le metriche con observability e validazione
Una metrica definita può comunque essere sbagliata in produzione
Definire una metrica una volta non impedisce ai dati che la alimentano di derivare. Le tabelle arrivano in ritardo, gli schemi cambiano, una colonna cambia tipo o una sorgente inizia a violare una regola che prima era rispettata. Quando succede, il semantic layer può comunque generare SQL corretto su input errati, il che significa che il numero risultante è calcolato in modo impeccabile ma resta fuorviante.
È qui che observability e validazione diventano il livello di fiducia attorno al semantic layer. L'anomaly detection segnala cambiamenti inattesi nelle tabelle sottostanti. Il monitoraggio della tempestività verifica se i dati sono arrivati quando previsto. Lo schema tracking intercetta colonne aggiunte o rimosse e cambi di tipo prima che interrompano la compilazione. La validazione a livello di record verifica le regole di business e i requisiti di audit che rendono una metrica difendibile davanti a uno stakeholder.
Perché il runtime conta quanto la definizione
Se il semantic layer è il contratto per la logica delle metriche, l'observability è il sistema d'allarme per gli input di quel contratto. Senza di essa, i team scoprono i problemi solo quando una dashboard sembra strana o un analista finanziario invia uno screenshot. Con essa, i team possono vedere trend, pattern e segnali statistici prima che il problema diventi una contestazione.
È anche qui che conta un modello di esecuzione in-database. digna, ad esempio, mantiene l'analisi all'interno dell'ambiente del cliente: i dati restano nel warehouse o nell'ambiente privato mentre la piattaforma evidenzia trend, tempestività e modifiche allo schema attraverso un'interfaccia unificata. Questa architettura è utile perché offre a engineering e utenti di business lo stesso quadro operativo senza portare i dati di produzione fuori dal perimetro controllato dal cliente.
Regola pratica: la fiducia nasce da due livelli, la definizione della metrica e il monitoraggio dei dati che la alimentano.
Quali lacune colma una buona validazione
La validazione colma il divario tra “la metrica è stata compilata” e “ci si può fidare della metrica”. Intercetta gli spostamenti silenziosi prima che si traducano in una riscrittura della definizione o in una discussione sulle responsabilità. Se una pipeline inizia a consegnare record in ritardo, o se una tabella sorgente cambia struttura, il numero nella dashboard deve fallire in modo abbastanza evidente da permettere al team di reagire.
Per i team che costruiscono sul dbt semantic layer, è questa la disciplina operativa. Il semantic model vi dà un'unica definizione. Observability e validazione vi dicono se gli input meritano ancora di essere misurati in quel modo. Per approfondire questo modello operativo, leggete l'approccio di digna alla data observability.
I costi nascosti e la realtà dell'adozione di cui nessuno parla
Il materiale pubblico più autorevole sui semantic layer di solito mette in risalto coerenza e self-service. Ciò che non sottolinea abbastanza è il lavoro necessario per arrivarci in un'organizzazione matura. Se avete già molte dashboard, query ad hoc e definizioni informali delle metriche, la migrazione non è solo un esercizio di modellazione. È un problema di coordinamento.
Cosa sottovalutano di solito i team
Il primo costo nascosto è il tempo di engineering. Un livello di metriche maturo esiste già da qualche parte, anche se sparso tra formule di BI e notebook degli analisti. Spostare quella logica in dbt significa riesprimere il comportamento esistente, confrontare gli output e decidere quale versione fa fede. Non è un'attività di pulizia teorica, è vero lavoro di produzione.
Il secondo costo nascosto è il carico di governance. Se mantenete in parallelo il vecchio e il nuovo percorso delle metriche, qualcuno deve verificare le differenze, gestire le aspettative degli stakeholder e occuparsi del piano di rollback se un consumatore a valle si rompe. Il terzo costo è sociale. Gli analisti abituati a modificare i calcoli direttamente negli strumenti di BI possono vedere il semantic layer come un'astrazione in più prima di percepirne i benefici.
Quando l'astrazione aggiunge prima complessità
Un semantic layer può sembrare più pesante, non più leggero, quando la vostra organizzazione non ha ancora standardizzato dimensioni o confini dei modelli. In quel contesto, la centralizzazione non elimina la confusione: la fa emergere. Non è un difetto del concetto. Significa solo che il layer vi costringe a dare un nome all'incoerenza che avevate già.
Qui è utile una lettura controcorrente. Il semantic layer riduce la deriva delle metriche solo dopo che un team ha già acquisito la disciplina di modellazione necessaria per supportarlo. Se lo stack è pieno di misure ad hoc, logiche temporali incoerenti e formule di dashboard isolate, le prime settimane possono essere più complesse del vecchio status quo.
La domanda giusta non è se una logica delle metriche centralizzata sia una buona cosa. Lo è. La domanda giusta è quanta pulizia serve alla vostra organizzazione prima che la centralizzazione ripaghi in termini di fiducia, riutilizzo e minori costi di riconciliazione.
I primi 30 giorni con il dbt Semantic Layer: un piano pratico

Dalla prima alla quarta settimana
Settimana 1: verificate le metriche attuali. Fate l'inventario delle definizioni esistenti, individuate i duplicati e segnalate i casi in cui lo stesso termine di business ha logiche in conflitto. Scegliete un progetto pilota di alto valore che interessi più di un consumatore, ma non così ampio che una discrepanza blocchi il rollout.
Settimana 2: definite i semantic model principali. Partite in piccolo, con due o tre entità di business ad alta priorità, e scrivete entità, dimensioni e misure in YAML. Mantenete netti i confini del modello, così che la prima versione sia comprensibile per chi dovrà mantenerla.
Settimana 3: validate con gli stakeholder. Confrontate i nuovi output con la dashboard o la risposta API attuali e fate confermare i numeri agli utenti di business. Non trattate l'approvazione come una formalità, perché è il momento in cui di solito emergono le differenze di definizione nascoste.
Settimana 4: distribuite e monitorate. Attivate il semantic layer per un consumatore di BI e un consumatore API, poi osservate il comportamento delle query e l'utilizzo. Aggiungete il monitoraggio, così che ogni nuova metrica venga controllata fin dal primo giorno per anomalie, tempestività, modifiche allo schema e violazioni delle regole.
Gli errori che rallentano i team
Il primo errore è modellare troppo nel progetto pilota. I team spesso cercano di sostituire l'intero livello di BI in un solo passaggio, rendendo impossibile il debug. Il secondo errore è saltare la peer review, il che trasforma il livello delle metriche in un altro luogo in cui le ipotesi di una sola persona diventano verità di produzione. Il terzo errore è dimenticare di monitorare i dati che alimentano la metrica, per cui il numero può sembrare stabile anche quando la sorgente si è già guastata.
Mantenete il primo rollout abbastanza circoscritto da poter spiegare ogni campo, ogni join e ogni consumatore che ne dipende.
Un buon primo mese non punta a una copertura perfetta. Serve a dimostrare che una metrica governata può passare dalla definizione alla dashboard senza derivare lungo il percorso. Se riuscite a farlo con un caso d'uso piccolo ma reale, vi siete guadagnati il diritto di estendere il layer con attenzione.
Se siete pronti a consolidare le definizioni delle vostre metriche e a renderle affidabili in produzione, iniziate mappando una metrica critica per il business dalla tabella sorgente alla dashboard, poi aggiungete l'observability attorno a essa prima di scalare. Per i team che vogliono abbinare metriche governate a un'anomaly detection rigorosa, schema tracking, controlli di tempestività e validazione a livello di record, digna è un punto di partenza concreto.
Per i controlli delle regole a livello di record che mantengono difendibile una metrica governata quando i dati di produzione iniziano a derivare, scoprite come digna Data Validation applica le regole di business alle tabelle che la alimentano.
Domande frequenti
Perché dashboard diverse mostrano dati di fatturato diversi?
Le dashboard di solito non concordano perché ogni strumento reimplementa la stessa regola di business a modo suo. Nell'esempio dell'articolo, un report esclude i rimborsi, un altro li conteggia in seguito e un terzo suddivide i dati per un campo data diverso, così tre definizioni si allontanano tra loro anche se tecnicamente nessuno sbaglia.
Quali sono le componenti principali di un semantic model di dbt?
Un semantic model di dbt ha tre componenti distinte: entità, dimensioni e misure. Le entità definiscono relazioni e granularità, le dimensioni sono i campi usati per suddividere, raggruppare e filtrare i risultati, e le misure sono i valori quantitativi destinati a essere aggregati. Separarle obbliga i team a trattare identità, descrizione e calcolo come problemi distinti.
Cosa fa MetricFlow nel dbt Semantic Layer?
MetricFlow è il motore di costruzione delle query che trasforma la richiesta di una metrica governata in SQL per il warehouse. Data una richiesta come monthly_active_customers, consulta il semantic model, risolve il percorso di join, applica la granularità temporale corretta e genera la query, così che Tableau, un'API o una dashboard integrata non debbano mai conoscere i dettagli interni del modello.
Come migliora un semantic layer l'accuratezza degli LLM sulle domande di business?
In un esperimento di dbt, GPT-4 che rispondeva a domande in linguaggio naturale direttamente su database SQL ha raggiunto solo il 16,7% di accuratezza, mentre l'approccio con semantic layer ha raggiunto l'83% su un sottoinsieme di otto domande gestibili. Le metriche governate offrono al modello un percorso vincolato verso la risposta, invece di costringerlo a indovinare il significato di ogni colonna.
Come dovrebbe un team introdurre il dbt Semantic Layer nei primi 30 giorni?
Distribuite il rollout su quattro settimane. Nella settimana 1 si verificano le metriche esistenti e si sceglie un progetto pilota, nella settimana 2 si definiscono in YAML due o tre entità principali, nella settimana 3 si validano gli output con gli stakeholder e nella settimana 4 si distribuisce a un consumatore di BI e a un consumatore API, con il monitoraggio di anomalie, tempestività e modifiche allo schema.


