Gestione della qualità dei dati: una roadmap pratica
|
8
min di lettura
Il pacchetto per il consiglio di amministrazione è già in circolazione quando qualcuno si accorge del problema. Il fatturato appare più debole del previsto, una previsione non centra l'obiettivo e l'analista FP&A riesegue la query, poi la riesegue di nuovo. Nulla nella dashboard dice "guasto". Il data warehouse ha accettato il caricamento, la pipeline ha segnalato il successo e il report si è aggiornato puntualmente.
È questa la realtà operativa della gestione della qualità dei dati. I dati errati raramente arrivano con un messaggio di errore chiaro. Si presentano come un trend discutibile, una riconciliazione fallita, un'eccezione regolamentare o un output di IA che sembra plausibile finché qualcuno non controlla i record sottostanti. Un programma di DQM efficace intercetta questi errori dove nascono, all'interno dei sistemi e delle tabelle che producono i dati, invece di aspettare che sia un consumatore a scoprirli.
Indice dei contenuti
Quando la fiducia nei dati si incrina in silenzio
Cosa significa davvero gestione della qualità dei dati
Misurate il flusso, non solo il punto finale
Sostituite i progetti di pulizia con controlli operativi
Dimensioni fondamentali e KPI che dimostrano la qualità
La governance e il flusso di lavoro operativo intorno alla qualità
Costruite un catalogo delle policy
Gestite un ciclo di risposta condiviso
Una roadmap di implementazione che produce risultati
Iniziate con controlli di cui le persone possano fidarsi
Modalità di errore comuni e schemi di rimedio che funzionano
Casi d'uso di settore per dati regolamentati e ad alto volume
La finanza ha bisogno di controlli oltre i confini dei sistemi
La sanità ha bisogno di rigore su identità e arrivi
Le telco hanno bisogno di vicinanza all'ingestion
La pubblica amministrazione ha bisogno di evidenze difendibili
Dalla pulizia periodica a operazioni continue e affidabili
Una checklist operativa compatta
Quando la fiducia nei dati si incrina in silenzio
Il team FP&A ha consegnato la presentazione per il consiglio. Il dato di fatturato è sottostimato dell'8% perché una tabella di fatturazione ha perso righe dopo la ridenominazione di uno schema, la sera prima del caricamento. Il dirigente che esamina la presentazione nota che la linea di tendenza piega nella direzione sbagliata, ma la prima reazione non è "incidente di qualità dei dati". È "il business non ha raggiunto il piano".
L'analista controlla la query sorgente. Poi la query di reporting. Poi una versione con una join diversa. Il risultato continua a sembrare sbagliato. Alla fine un engineer trova una colonna orfana rimasta dopo la ridenominazione, con la logica a valle che si aspettava ancora il campo precedente. Il VP pone la domanda che prima o poi ogni responsabile dei dati si sente rivolgere: come ha fatto a superare il QA?
Questa domanda mette a nudo il punto debole dei test sul solo output. Un report può superare un controllo di aggiornamento pur contenendo dati incompleti. Una pipeline può completarsi con successo consegnando una partizione obsoleta. Un modello può produrre previsioni tecnicamente valide a partire da una tabella di feature il cui significato è cambiato a monte. L'errore diventa visibile solo dopo che i dati hanno attraversato diversi confini.
Regola pratica: trattate ogni tabella critica come un servizio di produzione con un responsabile, un comportamento atteso e un percorso di gestione degli incidenti.
Le conseguenze per il business dei problemi persistenti di qualità dei dati vanno oltre una dashboard inesatta. I dirigenti ereditano numeri inaffidabili, gli analisti perdono tempo a dimostrare fatti elementari, le autorità di regolamentazione possono ricevere evidenze errate e i clienti possono imbattersi in flussi interrotti costruiti sugli stessi record. Gartner stima che le organizzazioni perdano in media 12,9 milioni di dollari all'anno a causa di problemi di qualità dei dati, mentre le sintesi di settore citano comunemente dati errati che incidono su circa il 31% dei ricavi aziendali. Questi dati sono riassunti nella ricerca di mercato sulla gestione della qualità dei dati.
La risposta pratica è strumentare la pipeline stessa. Verificate modifiche strutturali, pattern di arrivo, comportamento dei record, regole di business e impatto a valle prima che i consumatori agiscano sul risultato. Ogni report, feature di ML, segnalazione regolamentare e processo rivolto ai clienti eredita la fiducia a monte che i vostri controlli si guadagnano o non riescono a proteggere.
Cosa significa davvero gestione della qualità dei dati
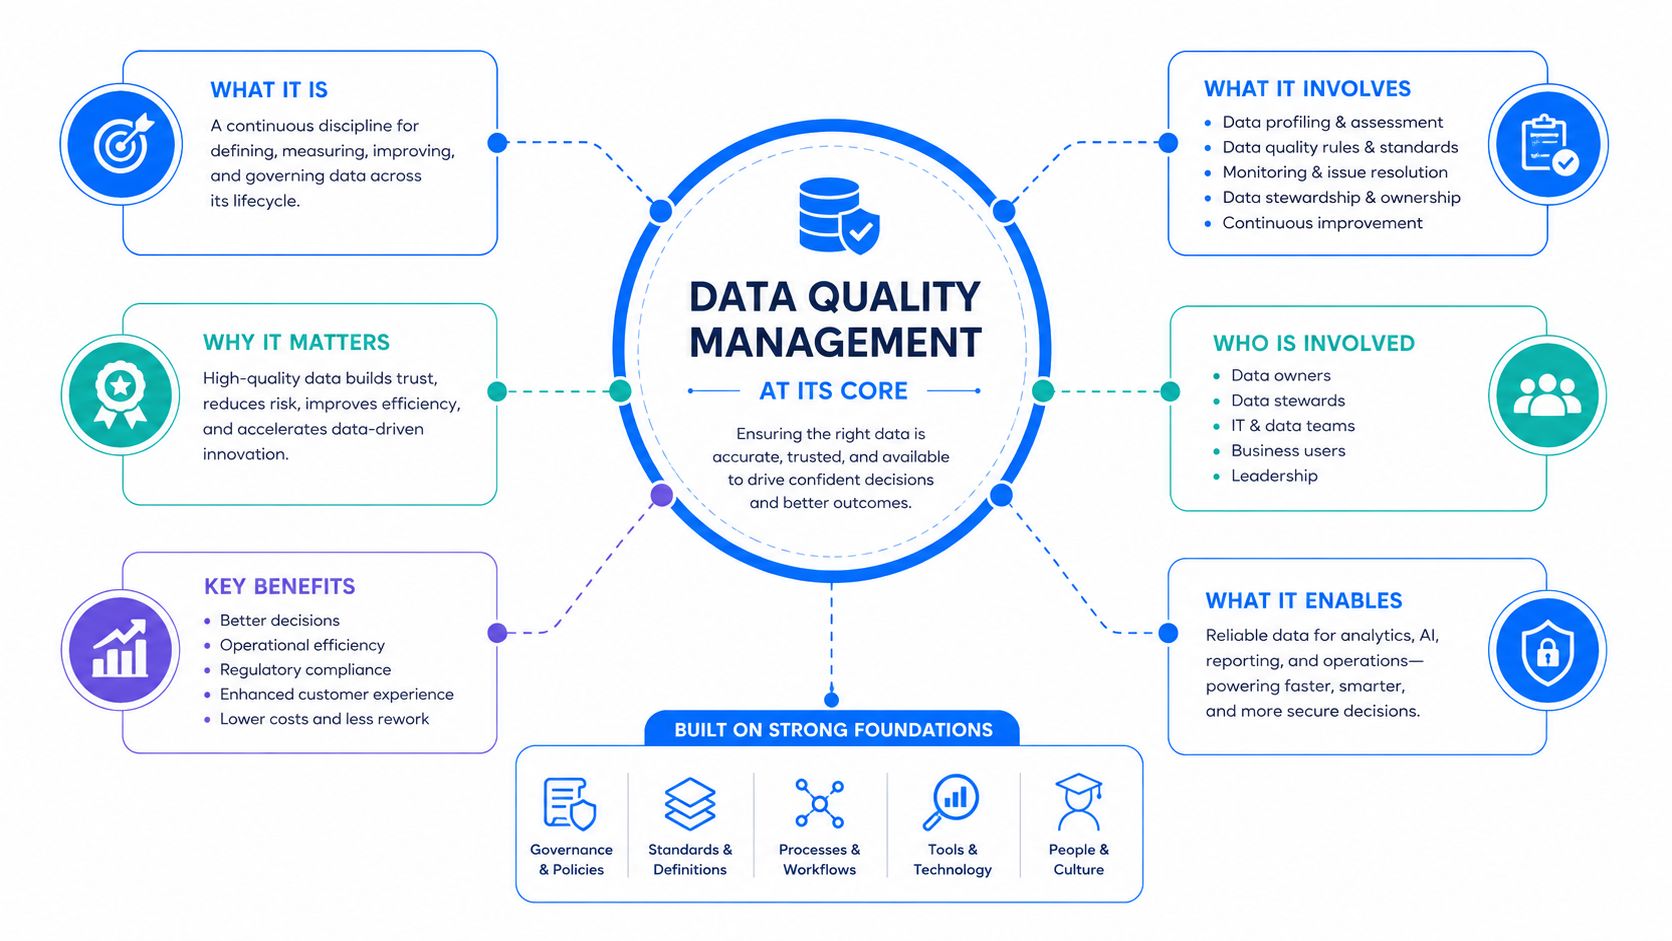
La gestione della qualità dei dati è la pratica continua di misurare, controllare e correggere i dati rispetto a standard definiti lungo tutto il loro ciclo di vita. Questo ciclo di vita inizia con l'ingestion, prosegue con trasformazione e archiviazione e termina quando un report, un modello, un'applicazione o un processo operativo utilizza i dati.
Il confine tra DQM e le discipline adiacenti è importante:
La data governance definisce policy, responsabilità, utilizzi consentiti e diritti decisionali.
La data observability fa emergere segnali su freschezza, volumi, schema e comportamento.
La DQM converte queste aspettative in controlli eseguibili che rilevano i difetti e supportano la correzione.
La relazione è operativa. La governance può richiedere che un identificativo cliente sia univoco e disponibile prima dell'esecuzione della fatturazione. L'observability può mostrare che il volume di una tabella è cambiato inaspettatamente. La DQM applica le regole di univocità e completezza, registra l'eccezione e la indirizza a un responsabile. Questo confronto tra qualità dei dati e data governance chiarisce il confine.
Misurate il flusso, non solo il punto finale
Il controllo qualità nella manifattura offre un confronto utile. Il controllo statistico di processo sulla linea di produzione intercetta i difetti prima che un prodotto lasci la fabbrica. Ispezionare i prodotti finiti sulla banchina di carico identifica comunque i problemi, ma non può evitare sprechi di materiale, rilavorazioni o una spedizione difettosa già in viaggio.
I controlli di qualità dei dati vanno collocati ai confini di ingestion, trasformazione e consumo, non solo nella dashboard finale. Un record può rispettare lo schema pur arrivando in ritardo, omettendo valori obbligatori, comparendo più di una volta o risultando in disaccordo con un sistema correlato. Il punto di controllo deve corrispondere alla modalità di errore e al costo di scoprirla più tardi.
Sostituite i progetti di pulizia con controlli operativi
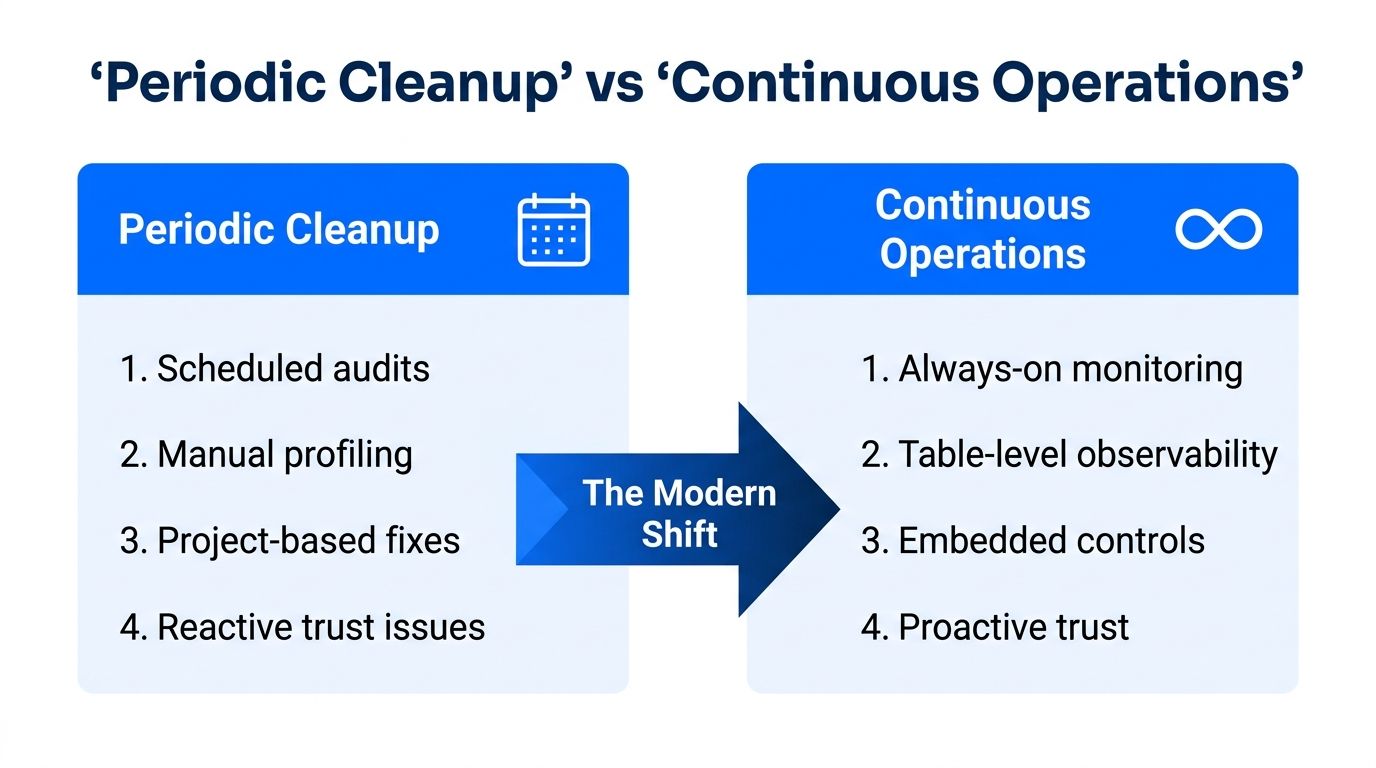
Un intervento di pulizia produce un'istantanea. Può standardizzare i valori, rimuovere i duplicati e correggere difetti noti, ma questi difetti ritornano quando il processo sorgente cambia. La DQM fornisce i controlli sempre attivi che verificano se i dati restano adatti all'uso previsto.
Negli ambienti regolamentati, i controlli dovrebbero essere eseguiti all'interno del database del cliente ogni volta che l'architettura lo consente. Regole e controlli sulle anomalie valutano le tabelle attive, preservano il contesto locale e riducono gli spostamenti di dati non necessari. Il compromesso è che i team devono gestire costi delle query, permessi e responsabilità delle regole nello stesso ambiente operativo. Questa disciplina rende le eccezioni più facili da tracciare, perché il team responsabile può esaminare comportamento, storico ed errori della tabella là dove risiedono già i dati protetti.
Dimensioni fondamentali e KPI che dimostrano la qualità
Un programma di DQM ha bisogno di dimensioni che le persone possano misurare e su cui possano agire. Sei dimensioni forniscono una base pratica, ma la soglia deve riflettere l'uso del dataset. Un obiettivo di completezza per un attributo di marketing facoltativo non va trattato come un obiettivo di completezza per un campo regolamentare.
Dimensione | KPI | Soglia tipica | Ruolo responsabile |
|---|---|---|---|
Accuratezza | Tasso di corrispondenza con una fonte attendibile o con una distribuzione attesa | 99,5% sui campi critici | Data steward |
Completezza | Tasso di valori nulli e di default per colonna, segmentato per livello dei dati | Prossimo allo zero per i campi critici obbligatori | Responsabile del sistema sorgente |
Coerenza | Tasso di riconciliazione tra sistemi, ad esempio la corrispondenza degli ID cliente tra CRM e fatturazione | Tutte le riconciliazioni critiche risolte prima del reporting | Team di integrazione |
Tempestività | Ritardo tra il momento dell'evento e il momento della disponibilità | Minuti per l'operatività, fino a 24 ore per il reporting | Team di piattaforma |
Validità | Conformità allo schema, ai pattern regex e agli elenchi di valori ammessi | Tutte le regole obbligatorie superate | Engineering |
Univocità | Tasso di duplicati su chiavi naturali e surrogate | Nessun duplicato inspiegato sulle chiavi critiche | Team MDM |
La misura dell'accuratezza ha bisogno di un punto di riferimento. Confrontate i valori critici con una fonte attendibile, un golden record approvato o una distribuzione attesa. Il data steward dovrebbe essere responsabile della definizione di "attendibile", perché gli engineer possono calcolare un tasso di corrispondenza senza sapere se il riferimento stesso è adatto allo scopo.
La completezza va segmentata per colonna e per livello. Un tasso di valori nulli può nascondersi dietro una media di tabella accettabile, mentre un singolo campo critico manca in una porzione significativa di record. I responsabili delle sorgenti devono correggere la raccolta e i valori di default a monte, non chiedere agli analisti di rattoppare il livello di reporting.
La coerenza mette in luce i conflitti tra sistemi. La corrispondenza dell'identità dei clienti tra un CRM e una piattaforma di fatturazione è un esempio immediato, ma la stessa logica vale per dati di prodotti, conti, fornitori e sedi. I team di integrazione sono responsabili del mapping e del contratto di riconciliazione.
La tempestività misura se le informazioni arrivano in tempo per la decisione che ne dipende. Un documento tecnico del benchmark globale sulla gestione dei dati dell'EDM Council descrive la tempestività come un valore normalizzato nell'intervallo (0,1], dove i valori più vicini a 1 rappresentano una freschezza migliore. Questa impostazione è utile perché un record può avere un contenuto corretto ed essere comunque inutilizzabile dopo la chiusura della finestra decisionale.
Validità e univocità completano l'insieme dei controlli. L'engineering è responsabile delle regole su formato e valori ammessi, mentre i team MDM si occupano della risoluzione dei duplicati. Non ottimizzate la validità in modo isolato. Dati perfettamente formattati che arrivano in ritardo, o dati freschi che contengono chiavi di business duplicate, creano comunque un rischio operativo.
Per un insieme più ampio di misure orientate all'implementazione, consultate questa guida alle metriche di qualità dei dati.
La governance e il flusso di lavoro operativo intorno alla qualità
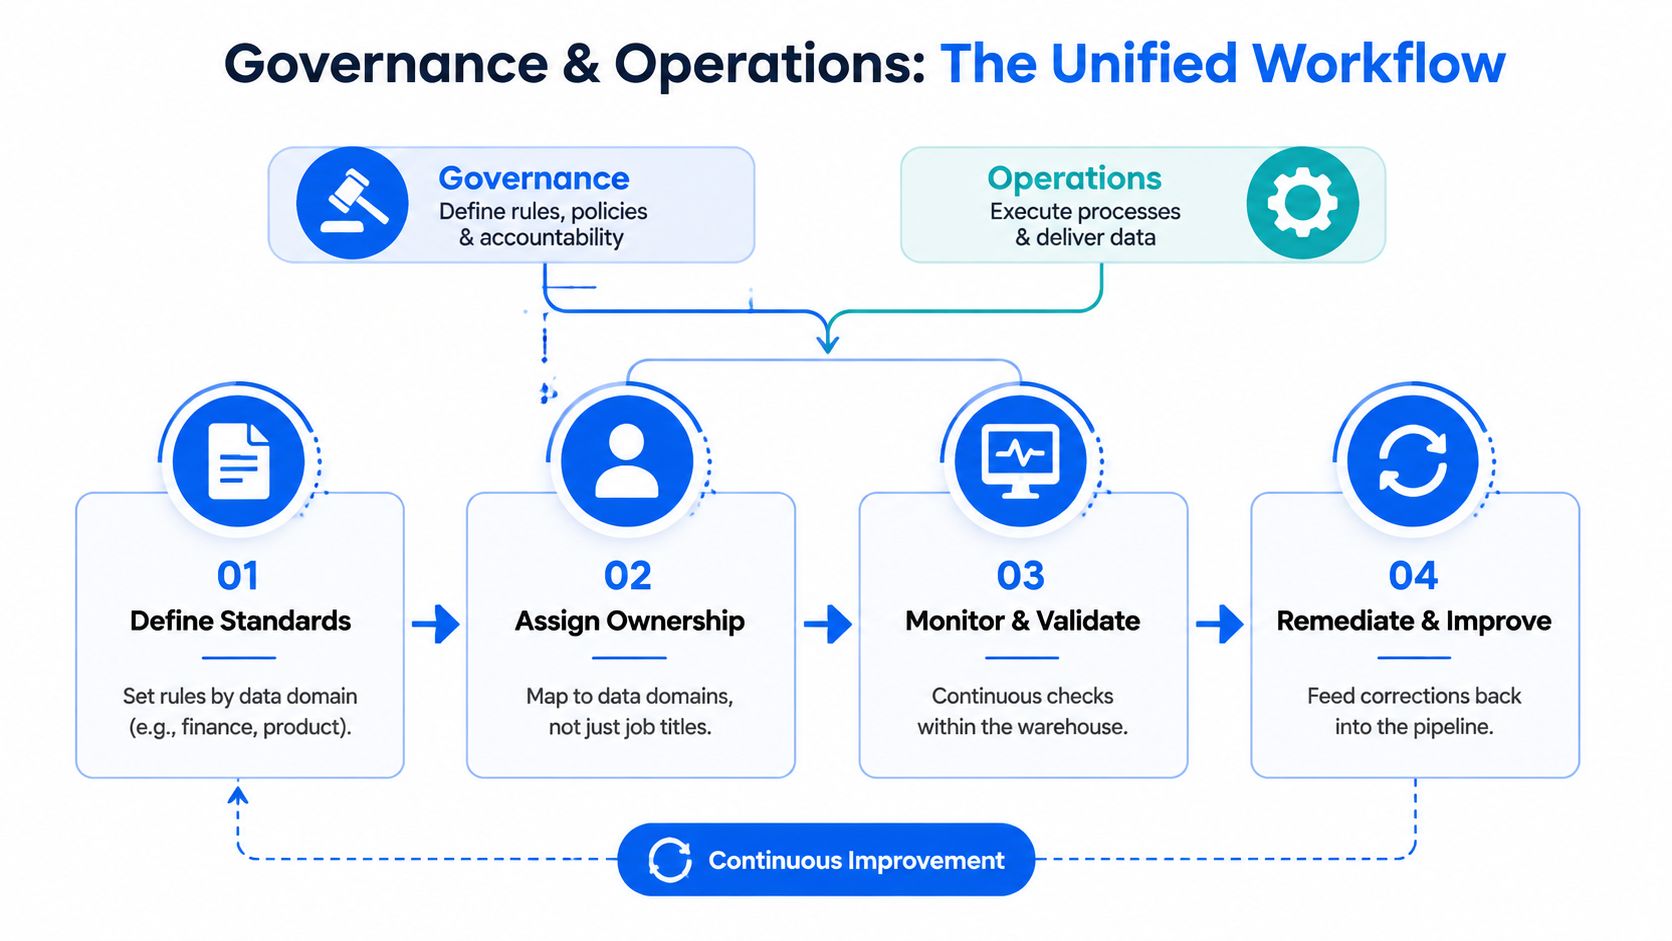
Governance e operazioni falliscono quando vivono in riunioni separate. Una policy che non produce un controllo è documentazione. Un alert senza un responsabile è rumore.
Assegnate le responsabilità per dominio di dati, non solo per qualifica. Un analista finanziario può essere responsabile delle tabelle dei ricavi, un esperto di informatica clinica delle cartelle dei pazienti e un product manager degli eventi comportamentali. Le loro responsabilità sono diverse, ma ciascuno ha bisogno dell'autorità per definire i valori accettabili, approvare le soglie e richiedere modifiche ai sistemi sorgente.
Costruite un catalogo delle policy
Ogni responsabile di dominio dovrebbe mantenere un catalogo versionato contenente:
Regole di business: quali valori, relazioni e stati sono ammessi.
Soglie: quanta deviazione è accettabile prima di intervenire.
SLA di freschezza: quando i dati devono arrivare per ciascun processo che li consuma.
Requisiti di evidenza: quali log, risultati e approvazioni servono per un audit o per la revisione di un incidente.
L'instradamento degli incidenti deve riflettere l'impatto sul business. Un P1 può compromettere il reporting per il management o un processo regolamentato. Un P2 può corrompere un singolo dominio. Un P3 può ridurre la fiducia senza causare danni operativi immediati. Queste categorie sono importanti perché evitano che ogni eccezione svegli l'intero team dati.
Gestite un ciclo di risposta condiviso
Gli steward monitorano le dashboard, esaminano le eccezioni e affinano le policy. Gli engineer collocano controlli di validazione e sulle anomalie nei punti di ingestion e trasformazione. I comitati di governance esaminano i pattern ricorrenti, le responsabilità non assegnate e le metriche di trend, invece di indagare ogni singolo alert.
Le indicazioni sulla strategia di data governance sono più utili quando vengono tradotte in questo ciclo operativo. In pratica, il rilevamento delle anomalie e i monitor di tempestività di digna vengono eseguiti in-database sulle tabelle sorgente, mentre il tracciamento dello schema segnala la deriva strutturale nel momento in cui si verifica. Il ruolo della piattaforma è fornire segnali ed evidenze. L'organizzazione ha comunque bisogno di responsabili in grado di decidere se rifiutare, mettere in quarantena, correggere o accettare un'eccezione.
Una roadmap di implementazione che produce risultati
I programmi di DQM si arenano quando i team monitorano tutto prima di aver dimostrato che qualcuno risponderà a un alert. Una roadmap efficace parte dalle tabelle in cui dati errati possono interrompere un processo regolamentato, distorcere il reporting per il management o influire su un modello di ML.
Fate prima l'inventario delle tabelle critiche. Valutate accuratezza, completezza, coerenza, tempestività, validità e univocità, quindi classificate ogni asset in base all'impatto sul business. Eseguite controlli continui all'interno del database del cliente dove possibile. In questo modo i controlli restano vicini alla sorgente, si evita un percorso separato di spostamento dei dati e si conservano le evidenze per le indagini.
Fase | Durata | Deliverable principali | Moduli digna utilizzati |
|---|---|---|---|
Valutazione e definizione delle priorità | Definita dal team di delivery | Inventario delle tabelle critiche, valutazione delle dimensioni, classificazione per impatto sul business | Data Analytics, Data Catalog |
Risultati rapidi | Definita dal team di delivery | Controlli sui valori nulli, rilevamento dei duplicati, monitoraggio della freschezza per le tabelle prioritarie | Data Validation, Timeliness |
Estensione dei controlli | Definita dal team di delivery | Tracciamento dello schema, monitoraggio delle distribuzioni, contratti tra sistemi, instradamento degli incidenti | Schema Tracker, Data Anomalies, Data Validation |
Scalabilità | Definita dal team di delivery | Template riutilizzabili, onboarding dei domini, revisioni operative | Combinazione modulare selezionata |
Iniziate con controlli di cui le persone possano fidarsi
Il primo rilascio dovrebbe puntare a modalità di errore che i team sono in grado di spiegare e risolvere. Attivate controlli sui campi obbligatori, rilevamento dei duplicati e monitoraggio della freschezza sulle tabelle a più alto rischio. La definizione delle priorità conta più di un'ampia copertura. Un controllo che riceve una risposta vale più di un insieme di regole più ampio che produce eccezioni lasciate senza seguito.
Una volta che questi controlli funzionano in modo affidabile, formalizzate le responsabilità. Pubblicate gli SLA, nominate gli steward, definite i percorsi di escalation e testate il processo con eccezioni reali. Una violazione della tempestività su una tabella regolamentata deve raggiungere il suo responsabile, non un canale generico in cui nessuno ne risponde.
Aggiungete controlli avanzati quando il ciclo di risposta funziona. Il tracciamento dello schema può segnalare colonne aggiunte o rimosse e modifiche ai tipi di dato. Il rilevamento delle anomalie può identificare variazioni nel numero di righe o nelle distribuzioni. Le regole di validazione possono far rispettare i contratti tra sistemi, soprattutto quando la trasformazione di un dominio dipende dai dati di un altro.
Iniziate con un perimetro abbastanza ristretto da garantire una risposta a ogni alert. Estendetelo solo dopo che il ciclo di risposta funziona.
Scalate tramite template dopo che i controlli si sono dimostrati utili. Uno schema finanziario per freschezza e univocità delle chiavi può fare da guida per un altro dominio, ma copiarlo senza revisione crea soglie che non corrispondono al processo locale. Ogni responsabile dovrebbe confermare il significato di business della regola e fissarne la soglia in base alla finestra decisionale dell'asset.
I team che valutano le opzioni di rollout possono usare questa roadmap di implementazione della qualità dei dati come punto di partenza, adattando poi la sequenza alla propria architettura di data warehouse, data lake o pipeline. Il criterio pratico è semplice: date priorità ai dati con le conseguenze operative più rilevanti, mantenete il monitoraggio vicino alla sorgente ed estendetelo solo quando responsabilità e risposta sono visibili.
Modalità di errore comuni e schemi di rimedio che funzionano
Gli errori più dannosi sono spesso quelli che superano un controllo di base della pipeline. Un job può segnalare il successo mentre il suo output ha la forma sbagliata, l'orario di arrivo sbagliato o una distribuzione inattesa.
Modalità di errore | Sintomo | Schema di rimedio | Modulo digna |
|---|---|---|---|
Deriva silenziosa dello schema | Campi aggiunti, rimossi o con tipo modificato interrompono inaspettatamente i consumatori | Confrontare la struttura attuale con una baseline nota e affidabile e generare alert sulle modifiche | Schema Tracker |
Feed obsoleto | La pipeline va a buon fine, ma l'ultimo evento di business manca | Monitorare i timestamp di business e i pattern di consegna attesi | Timeliness |
Affaticamento da regole | Grandi raccolte di controlli statici producono eccezioni che nessuno calibra | Combinare regole deterministiche con baseline comportamentali apprese | Data Anomalies, Data Validation |
Rumore degli alert | I team sopprimono o ignorano notifiche ripetute di scarso valore | Applicare livelli di gravità, responsabilità, finestre di soppressione e raggruppamento degli incidenti | Dashboard incentrata sull'utente |
La deriva dello schema merita attenzione precoce, perché i controlli sul numero di righe non rilevano ogni rottura strutturale. Un team sorgente può aggiungere una colonna nullable, rimuovere un campo o cambiare un tipo di dato mantenendo invariato il numero di righe. SQL a valle, logica di BI o feature di ML possono quindi fallire in modi che sembrano scollegati dalla modifica alla sorgente.
Il monitoraggio della freschezza deve usare timestamp significativi per il business. Un task di orchestrazione completato con successo dimostra che il codice è stato eseguito, non che sono arrivati dati utili. Confrontate il momento dell'evento con il momento della disponibilità e con il comportamento di consegna atteso, in modo che anche una pipeline tecnicamente "verde" possa sollevare un incidente utile.
La validazione statica resta importante per le violazioni esplicite delle policy. Diventa inefficace quando i team codificano ogni possibile fluttuazione come soglia rigida. Il rilevamento delle anomalie può far emergere deviazioni da distribuzioni e volumi normali, ma ha bisogno del contesto delle responsabilità e di un percorso di risposta. Nessuno dei due approcci sostituisce l'altro.
Il design più solido stratifica i controlli. I controlli sullo schema intercettano le modifiche strutturali, quelli sulla tempestività i feed in ritardo o mancanti, quelli su volumi e distribuzioni le variazioni di comportamento e la validazione deterministica fa rispettare le regole di business. Una dashboard condivisa aiuta chi interviene a capire se questi segnali descrivono un unico incidente o diversi problemi non correlati.
Casi d'uso di settore per dati regolamentati e ad alto volume
Le priorità della DQM cambiano in base allo scopo dei dati. Un team finance può tenere soprattutto a riconciliazione ed evidenze per l'audit, mentre un operatore telco può avere bisogno di individuare un problema di ingestion regionale prima che una dashboard operativa diventi fuorviante.
Settore | Priorità di qualità principali | Esempi di KPI principali | Modulo digna di riferimento |
|---|---|---|---|
Finanza | Tempestività, univocità, riconciliazione, stabilità dello schema | Univocità delle chiavi di registrazione, riconciliazione trade-rischio, ritardo di consegna | Timeliness e Schema Tracker |
Sanità | Integrità delle identità, validità delle richieste di rimborso, freschezza dei feed | Identificativi paziente duplicati, conformità dei campi obbligatori, ritardo di arrivo | Data Validation e Data Anomalies |
Telecomunicazioni | Freschezza ad alto volume, stabilità dei volumi, coerenza regionale | Comportamento di arrivo degli eventi, variazioni di volume, cambiamenti nella distribuzione regionale | Timeliness e Data Analytics |
Pubblica amministrazione | Verificabilità, completezza, coerenza, tracciabilità delle eccezioni | Conformità dei campi obbligatori, riconciliazione, stato documentato delle eccezioni | Data Validation |
La finanza ha bisogno di controlli oltre i confini dei sistemi
I record di trade e di rischio attraversano spesso sistemi di front, middle e back office. Un insieme pratico di controlli verifica l'univocità delle chiavi di registrazione, riconcilia gli identificativi critici tra i sistemi e sorveglia le modifiche alla struttura dell'anagrafica prodotti prima che l'attribuzione del P&L si interrompa. La tempestività è importante perché un record di rischio corretto che arriva dopo una finestra di reporting o decisionale ha un valore limitato.
La sanità ha bisogno di rigore su identità e arrivi
I record di identità dei pazienti e i dati delle richieste di rimborso richiedono una validazione rigorosa, perché duplicati e identificativi malformati possono distorcere le misure a valle. Gli MRN duplicati, ad esempio, dovrebbero generare un flusso di indagine anziché un'attività di pulizia invisibile. Anche i feed HL7 in ritardo hanno bisogno di alert di tempestività, in particolare quando le metriche operative dipendono da una sequenza completa di eventi.
Le telco hanno bisogno di vicinanza all'ingestion
I call detail record e la telemetria di rete arrivano in volumi elevati e possono variare per regione. I controlli in-database vicini all'ingestion possono monitorare freschezza e volumi senza creare un ulteriore processo di spostamento dei dati. Le viste di analytics possono poi aiutare i team a capire se un pattern insolito è generalizzato o concentrato in una specifica area operativa.
La pubblica amministrazione ha bisogno di evidenze difendibili
I dati su prestazioni sociali e censimenti possono essere riesaminati molto tempo dopo il caricamento originale. Le regole di validazione devono produrre risultati tracciabili, responsabilità sulle eccezioni e uno storico delle correzioni. Queste evidenze fanno parte della qualità dei dati, non sono un ripensamento amministrativo. Un controllo che rileva un problema ma non può mostrare chi lo ha esaminato o cosa è cambiato lascia l'organizzazione esposta durante audit o attività di vigilanza.
Dalla pulizia periodica a operazioni continue e affidabili
La pulizia periodica resta utile per correzioni, migrazioni e creazione di baseline. Ma non è un modello operativo. I dati possono rompersi tra un intervento programmato e l'altro, e le responsabilità non assegnate fanno accumulare eccezioni finché qualcuno non ha urgente bisogno dei dati.
I dati di indagine di Monte Carlo illustrano la pressione operativa. Gli incidenti mensili sui dati sono passati da 59 nel 2022 a 67 nel 2023, e un benchmark successivo ha riportato circa un problema di qualità dei dati ogni 10 tabelle all'anno, rispetto a circa uno ogni 15 tabelle nelle misurazioni precedenti, come documentato nelle statistiche sulla qualità dei dati di Monte Carlo. L'implicazione è chiara: il monitoraggio a livello di tabella deve essere continuo negli ambienti in cui schemi, freschezza e comportamento delle metriche cambiano regolarmente.
Una checklist operativa compatta
Strumentate prima le tabelle prioritarie: iniziate da asset regolamentati, reporting per il management e input di ML.
Assegnate la responsabilità dei dataset: nominate la persona o il team responsabile di ciascun dominio critico.
Concordate le soglie prima degli alert: gli stakeholder dovrebbero definire il comportamento accettabile prima che gli engineer calibrino le notifiche.
Instradate le eccezioni in un'unica coda: offrite a chi interviene un luogo condiviso per classificare, assegnare e documentare gli incidenti.
Monitorate rilevamento e risoluzione: usate il tempo medio di rilevamento e il tempo medio di risoluzione come segnali operativi.
Rivedete regolarmente la copertura: rivalutate regole, baseline e responsabilità durante le revisioni trimestrali dei controlli.
Per il 2026, tre priorità meritano attenzione. Primo, codificare gli SLA di qualità come contratti espliciti tra produttori e consumatori. Secondo, aggiungere ai playbook di correzione un ragionamento sulle anomalie assistito dall'IA, mantenendo però i responsabili umani titolari delle decisioni. Terzo, trattare schema e lineage come asset di livello sicurezza, con una disciplina di revisione paragonabile a quella del codice di produzione.
Il cambiamento non è solo dal lavoro manuale all'automazione. È il passaggio da una responsabilità incerta sui dati a una responsabilità operativa visibile. Quando i controlli vengono eseguiti dove risiedono i dati, i team possono rilevare i problemi prima, conservare le evidenze e decidere se un dataset è adatto al processo che ne dipende.
digna offre la gestione della qualità dei dati in-database tramite rilevamento delle anomalie, validazione, monitoraggio della tempestività e tracciamento dello schema, con deployment nel vostro cloud, nella vostra VPC o nel vostro data center. Visitate digna per valutare un piano di monitoraggio mirato per le vostre tabelle più critiche e costruire a partire da lì.
Domande frequenti
In cosa differisce la gestione della qualità dei dati da governance e observability?
In ciò che produce. La governance definisce policy, responsabilità, utilizzi consentiti e diritti decisionali; l'observability fa emergere segnali su freschezza, volumi, schema e comportamento; la gestione della qualità dei dati converte queste aspettative in controlli eseguibili che rilevano i difetti e supportano la correzione.
Cosa sfugge ai test sul solo output?
La causa. In un esempio, un dato di fatturato era sottostimato dell'8% perché una tabella di fatturazione aveva perso righe dopo la ridenominazione di uno schema la sera prima del caricamento. Controllare solo l'output vi dice che il numero sembra strano; non vi dice quale modifica lo ha prodotto.
Come va trattata una tabella critica?
Come un servizio di produzione con un responsabile, un comportamento atteso e un percorso di gestione degli incidenti. È questa impostazione a portare un dataset fuori dalla manutenzione "best effort" e a dargli una risposta definita quando si comporta in modo anomalo.
Quanto costano questi errori?
Gartner stima che le organizzazioni perdano in media 12,9 milioni di dollari all'anno a causa di problemi di qualità dei dati, mentre le sintesi di settore citano comunemente dati errati che incidono su circa il 31% dei ricavi aziendali. Questi numeri sono un argomento a favore della strumentazione della pipeline anziché della sola ispezione dell'output.
Da dove dovrebbe partire una roadmap?
Dai dataset il cui malfunzionamento ha conseguenze, affrontando prima per questi standard, controlli eseguibili, misurazione e correzione. Una roadmap che parte da una copertura dell'intero patrimonio dati di solito produce un backlog anziché un controllo.


