Errore di validazione dei dati: cause, esempi e soluzioni
|
9
min di lettura
Probabilmente vi è già capitato: il refresh della dashboard termina, i numeri sembrano plausibili e poi qualcuno chiede perché il churn sia cambiato all'improvviso. L'analista controlla la visualizzazione, l'SQL e il job pianificato. Ore dopo si scopre che il problema è un singolo valore malformato, entrato nella pipeline nelle prime fasi, che ha cambiato il modo in cui un sistema a valle interpretava il record.
Un errore di validazione dei dati è più di una cella di un foglio di calcolo rifiutata. Può essere un campo mancante, una data non valida, un codice al di fuori del dominio ammesso o una relazione che non esiste. La sfida pratica è trovare il punto in cui il contratto è stato violato, decidere se la riga si può correggere in sicurezza e impedire che lo stesso difetto si ripresenti.
Indice
Quando una sola riga errata rompe l'intera dashboard
Che cosa significa davvero un errore di validazione dei dati
Il controllo superficiale
Il controllo approfondito
I principali schemi alla base dei fallimenti di validazione
Valori mancanti
Errori di formato
Violazioni di intervallo
Errori di codifica e di dominio
Rotture di coerenza
Esempi a livello di record da individuare nei vostri dati
Esportazioni da fogli di calcolo
Ingestion tramite API
Record nel data warehouse
Perché la maggior parte degli errori di validazione nasce a monte
Riparate il contratto, non solo l'output
Un workflow pratico per rilevare e correggere gli errori
Acquisizione
Ingestion
Data warehouse
Consumo
Punti chiave per operazioni sui dati affidabili
Quando una sola riga errata rompe l'intera dashboard
Un team finance riceve ogni notte un CSV dal portale di un fornitore. I record sembrano normali finché un campo di cancellazione non contiene una data malformata. Il loader del data warehouse non riesce a convertirla in data, quindi scrive NULL invece di interrompere il caricamento.
Il modello di churn tratta una data di cancellazione mancante come una condizione a sé. Quella singola conversione cambia la coorte assegnata al cliente, e la dashboard per il management mostra un aumento inatteso. La pipeline segnala il successo, il grafico viene visualizzato e il risultato è comunque sbagliato.
L'analista parte dalla dashboard e risale il risultato attraverso tre report, due viste SQL e un task di Airflow. La riga di origine malformata compare alla fine nel log dei valori rifiutati. La dashboard era solo il primo sintomo visibile.
Regola pratica: un'esecuzione riuscita della pipeline dimostra che l'elaborazione è terminata. Non dimostra che ogni record abbia rispettato le regole su cui si basa il business.
La validazione deve quindi arrivare al livello del singolo record. Un solo valore non valido può alterare aggregati, feature di machine learning, report finanziari o workflow operativi senza causare alcun disservizio. Il benchmark di Gartner, ampiamente citato, stima che la scarsa qualità dei dati costi alle organizzazioni in media 12,9 milioni di dollari all'anno (benchmark Gartner), mentre la ricerca IBM del 2025 ha rilevato che oltre un quarto delle organizzazioni stima perdite annue superiori a 5 milioni di dollari, con il 7% che dichiara perdite oltre i 25 milioni di dollari (ricerca IBM). Il whitepaper DCI sul costo nascosto dei dati errati approfondisce ulteriormente il costo operativo della scarsa qualità dei dati.
L'indagine ha bisogno anche di contesto. Un'anomalia nei dati può rappresentare un comportamento reale dei clienti, mentre un fallimento di validazione significa che un valore viola una struttura o una regola attesa. Un foglio di calcolo può segnalare un valore tramite un menu a tendina, un'importazione enterprise può rifiutarlo in base a uno schema governato e una pipeline di data warehouse può forzarlo in un NULL fuorviante. Fallimenti ripetuti su questi livelli indicano di solito un difetto nella mappatura della sorgente, nella trasformazione o nel contratto, piuttosto che una serie di righe sfortunate. Per capire come distinguere i valori insoliti dalle violazioni delle regole, consultate la guida di digna alle anomalie nei dati.
Per i team che pubblicano dashboard tramite Power BI, la guida di Tutorial AI al connettore Power BI può chiarire il livello di reporting. La configurazione del connettore non può riparare un valore di origine non valido. La correzione affidabile inizia nel punto in cui il record viola per la prima volta il suo contratto.
Che cosa significa davvero un errore di validazione dei dati
Un errore di validazione dei dati si verifica quando un valore osservato non rispetta una regola, uno schema, una relazione o un'aspettativa di business. La regola può essere semplice, come “questo campo deve contenere una data”, oppure relazionale, come “questo ordine deve fare riferimento a un cliente esistente”.
Pensate alla validazione come al contratto d'ingresso di un club. Un buttafuori potrebbe prima controllare che il documento d'identità abbia il formato corretto. Un controllo più approfondito conferma che il nome compaia nella lista degli invitati, che l'evento sia valido per quel biglietto e che la prenotazione corrisponda alla persona che la presenta. I sistemi di dati funzionano allo stesso modo.
Il controllo superficiale
Un controllo di formato verifica se un valore può essere interpretato correttamente:
2025-04-18sembra una rappresentazione di data valida.jdoe@somiglia a un campo email ma non rispetta un pattern email completo.42può essere un valore numerico valido.Closed Wonpuò comunque fallire se il codice ammesso èclosed_won.
Questi controlli evitano errori di parsing, ma non stabiliscono se il record abbia senso nel suo contesto.
Il controllo approfondito
La validazione a livello di record esamina relazioni e regole di business:
customer_ididentifica un cliente presente nella dimensione clienti?Lo sconto è consentito per questo segmento di clientela?
Il totale dell'ordine è uguale alla somma delle sue righe?
La data dell'evento è successiva alla creazione dell'account?
Lo stato appartiene al dominio approvato per questo workflow?
Un menu a tendina in un foglio di calcolo, una risposta API come HTTP 422, una violazione di vincolo nel data warehouse e una suite di test di Great Expectations implementano tutti la stessa idea di fondo a livelli diversi. Ognuno confronta i dati con un contratto concordato.
La Banca Mondiale descrive la validazione attraverso tecniche come controlli di intervallo, controlli di coerenza interna e rilevamento degli outlier, e sottolinea l'importanza di documentare la validazione nei metadati. Queste indicazioni compaiono nella sua lezione sulla validazione dei dati. Un errore di validazione non è quindi solo un messaggio fastidioso. È la prova che un record, un file o un dataset non corrisponde più alle ipotesi fatte dal sistema successivo.
Otterrete risultati migliori se vi ponete due domande separate:
Quale regola è stata violata?
Quale livello ha permesso al valore non valido di arrivare fin qui?
La prima domanda ripara il record. La seconda ne impedisce la ricomparsa.
Per una spiegazione più ampia di validità, dimensioni e misurazione, confrontate questa definizione con la spiegazione di digna sulla validità dei dati.
I principali schemi alla base dei fallimenti di validazione
La maggior parte degli incidenti di validazione rientra in un piccolo insieme di schemi strutturali. Classificare prima il fallimento vi aiuta a scegliere la correzione giusta, invece di trattare ogni riga rifiutata come un mistero a sé stante.
La Banca Mondiale individua valori mancanti, problemi di formato, problemi di codifica, controlli di intervallo, controlli di coerenza e rilevamento degli outlier come parti importanti della pratica di validazione. Una ricerca precedente della Society of Actuaries ha inoltre rilevato che gli errori di validità sono più comuni e diffusi degli errori di accuratezza, con valori mancanti, errori di formato dei dati ed errori di codifica tra i principali problemi di validità. Le indicazioni sono riassunte nella ricerca sulla qualità dei dati della Society of Actuaries.
Schema | Esempio di valore errato | Regola violata |
|---|---|---|
Valore mancante |
| L'identificatore obbligatorio deve essere presente |
Errore di formato |
| Il valore deve usare un formato di data interpretabile |
Violazione di intervallo |
| L'età deve restare entro l'intervallo consentito |
Errore di codifica o di dominio |
| Il valore deve corrispondere a un dominio approvato |
Rottura di coerenza |
| Il totale di testata deve essere uguale al totale di dettaglio |
Valori mancanti
Un valore mancante diventa un errore quando il campo è necessario per l'elaborazione o l'interpretazione. Un interno telefonico vuoto può essere accettabile, mentre un identificatore cliente mancante può rendere impossibile il join del record. Questi fallimenti emergono di solito nei log di ingestion, nei controlli NOT NULL o in report con popolazioni inaspettatamente incomplete.
Errori di formato
Gli errori di formato si verificano quando il sistema non riesce a interpretare il valore come il tipo dichiarato. Una data memorizzata come testo libero, un importo numerico con un simbolo inatteso o un'email senza dominio possono passare attraverso un'esportazione poco controllata e fallire dentro un'API o in un cast nel data warehouse.
Violazioni di intervallo
I controlli di intervallo intercettano valori strutturalmente numerici ma logicamente impossibili o non consentiti. Un'età negativa, una data di nascita nel futuro o una percentuale oltre il massimo consentito possono essere numeri sintatticamente validi. Il riferimento sulla validazione dei dati della Banca Mondiale spiega come i controlli di intervallo e di coerenza interna aiutino a localizzare gli errori prima dell'analisi o dell'uso in produzione.
Errori di codifica e di dominio
Un dominio è l'insieme dei valori accettati per un campo. I campi paese, stato, tipo di prodotto e categoria di rischio falliscono spesso perché sistemi diversi usano ortografia, maiuscole, abbreviazioni o codici legacy differenti. Questi errori possono non provocare un errore di parsing, ma frammentano i conteggi e rompono i filtri.
Rotture di coerenza
Le regole di coerenza confrontano campi all'interno dello stesso record o tra record correlati. Rientrano qui un paese di spedizione in conflitto con la regione assegnata, una fattura le cui righe di dettaglio non corrispondono al totale di testata o una transazione collegata a un cliente sconosciuto. Spesso sono gli utenti di business ad accorgersi per primi di questi errori, perché l'output contraddice ciò che sanno del processo.
Abitudine diagnostica: non iniziate modificando il valore. Iniziate dando un nome allo schema violato. Lo schema indica di solito il livello responsabile.
Esempi a livello di record da individuare nei vostri dati
Lo stesso difetto appare diverso a seconda di dove lo incontrate. Un foglio di calcolo può mostrare una stringa sospetta, un'API può restituire un rifiuto strutturato e un test nel data warehouse può segnalare una relazione non rispettata. Il problema di fondo può comunque essere identico.
Esportazioni da fogli di calcolo
Un'esportazione dal CRM contiene questa riga:
customer_email | phone | stage |
|---|---|---|
|
|
|
L'email non supera un controllo strutturale di base perché manca di un dominio completo. Il numero di telefono può essere utilizzabile per un processo ma incoerente con un altro che si aspetta un formato normalizzato come (555) 123-4567. I valori di stage closed-won, Closed Won e CLOSED_WON possono rappresentare per una persona lo stesso stato di business, ma apparire come tre categorie distinte in una tabella pivot.
Un menu a tendina potrebbe bloccare nuove varianti, ma non normalizzerà i valori storici già esportati. Né spiegherà se la differenza sia stata introdotta dal CRM di origine, dal template di esportazione o da una modifica manuale.
Ingestion tramite API
Un'API riceve questo payload:
Qui customer_id viola una regola di campo obbligatorio. order_total è una stringa anche se il contratto di ricezione si aspetta un numero. created_at non è una data valida perché la combinazione di mese e giorno non può essere interpretata come una data reale del calendario.
Una risposta HTTP 422 è utile quando identifica esattamente il campo e la regola violati. Se dice solo “unprocessable entity”, esaminate il body della richiesta, il body della risposta, il content type e la specifica dell'API. La guida di Postman agli errori HTTP 422 offre un contesto pratico per il debugging di questi casi.
Record nel data warehouse
Una fact table del data warehouse contiene una riga con tre problemi distinti:
order_dateè precedente acustomer_signup_date.customer_idnon punta ad alcuna riga indim_customer.discount_percent = 150, al di fuori dell'intervallo consentito.
Il primo è un fallimento di coerenza temporale. Il secondo è un fallimento di integrità referenziale. Il terzo è una violazione di intervallo. Nessuno è un semplice problema di formattazione, e correggere il formato di visualizzazione non renderà il record affidabile.
Ambiente | Esempio di campo | Valore errato del record | Classe di difetto |
|---|---|---|---|
Foglio di calcolo |
|
| Formato |
Payload API |
|
| Campo obbligatorio |
Payload API |
|
| Tipo non corrispondente |
Fact table del data warehouse |
| Chiave di dimensione sconosciuta | Referenziale |
Fact table del data warehouse |
| Precedente alla data di registrazione | Temporale |
Fact table del data warehouse |
|
| Intervallo |
Questi esempi sono più facili da analizzare se separate la validità dalla ragionevolezza. Un valore può corrispondere a un tipo di dato e apparire comunque poco plausibile nel suo contesto. La guida di digna alla ragionevolezza dei dati approfondisce questa distinzione.
Perché la maggior parte degli errori di validazione nasce a monte
Correggere le celle errate una alla volta sembra produttivo perché il numero di errori cala subito. Spesso però cura il sintomo e lascia invariati il produttore, il contratto o lo schema.
Un menu a tendina in un foglio di calcolo governa solo ciò che un utente può inserire tramite quell'interfaccia. Non controlla i valori generati da un'integrazione CRM, da un'esportazione massiva, da un client API, da una migrazione di database o da un job di trasformazione. La validazione più solida si colloca vicino al punto in cui i dati vengono creati e scambiati.
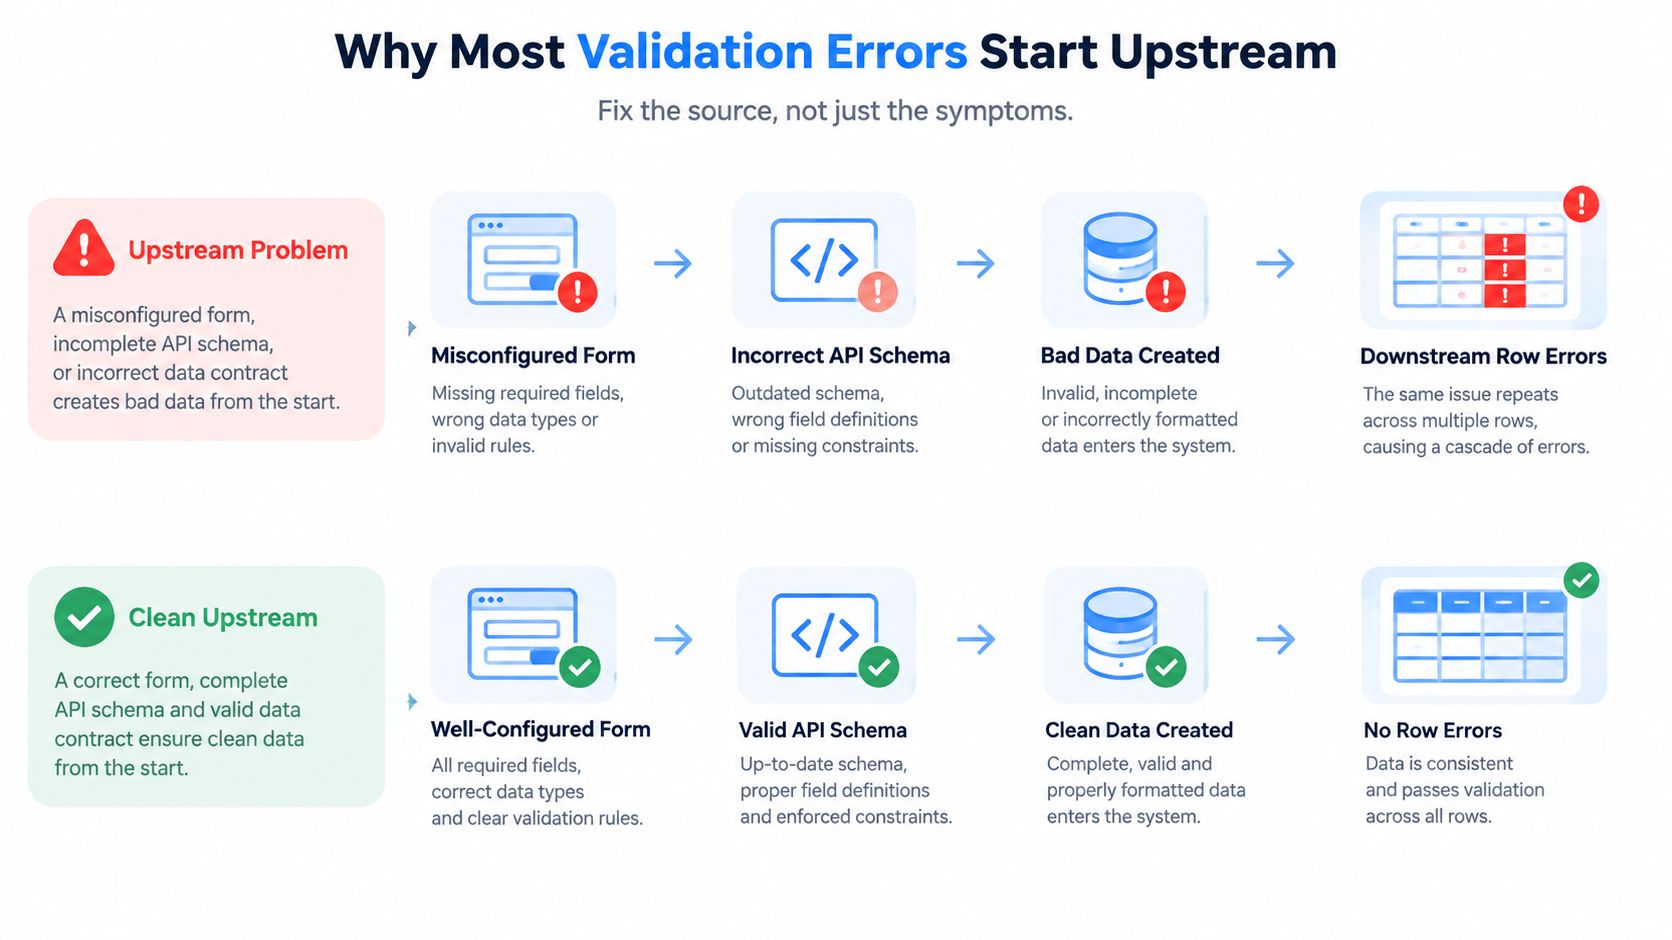
Considerate un campo API che passa da customer_id ad account_id senza un contratto versionato. La trasformazione ricevente può popolare customer_id con NULL su ogni record in arrivo. Il data warehouse segnala allora identificatori mancanti, i join delle dashboard perdono righe e gli analisti iniziano a correggere manualmente gli output. Il fallimento ripetuto non è la prova di un inserimento dati negligente. È la prova che due sistemi non concordano sullo schema.
Lo stesso schema si presenta quando cambia un template di esportazione del CRM, viene allentato un vincolo del database o una migrazione elimina una regola di campo obbligatorio. Una modifica alla sorgente può generare migliaia di fallimenti a valle che sembrano singole righe errate.
Riparate il contratto, non solo l'output
Usate lo schema del fallimento per scegliere l'intervento:
Nome di campo cambiato: versionate il payload e aggiornate il consumer in modo deliberato.
Campo facoltativo che deve esistere: rendete il campo obbligatorio nel contratto della sorgente e rifiutate le richieste incomplete.
Valore numerico non valido: aggiungete un vincolo
CHECKa livello di sorgente o una validazione equivalente.Stato non riconosciuto: mantenete un dominio o un'enumerazione condivisi invece di affidarvi al testo libero.
Relazione errata: validate gli identificatori referenziati prima di caricare il record dipendente.
La guida di digna alla data ingestion offre un contesto utile per trattare l'ingestion come un movimento controllato dei dati anziché come un semplice passaggio di trasferimento di file.
Test della causa principale: se lo stesso fallimento di validazione compare su molte righe dopo una modifica alla sorgente, indagate sul contratto prima di ripulire i record.
Rifiutare i dati non validi in fase di ingestion è di solito più sicuro che lasciarli arrivare come NULL, stringa vuota o valore di default forzato. Se il rifiuto non è praticabile, mettete in quarantena la riga con il suo identificatore di origine, la regola violata e il timestamp di ingestion, così che i consumer a valle non scambino un valore danneggiato per uno reale.
Un workflow pratico per rilevare e correggere gli errori
Un workflow affidabile colloca i controlli dove forniscono il segnale più chiaro e richiedono meno rilavorazioni. Partite dall'acquisizione, poi passate all'ingestion, ai controlli nel data warehouse e al consumo.
Acquisizione
Validate tipi, campi obbligatori, valori ammessi e intervalli in moduli, API e database di origine. Le maschere di input possono guidare gli utenti, mentre i vincoli di schema impediscono ai produttori di inviare valori che i sistemi a valle non sono in grado di interpretare.
Un database di origine dovrebbe applicare le regole che contano indipendentemente da chi scrive il record. Un'API dovrebbe restituire errori a livello di campo che indichino al client cosa correggere. Un modulo dovrebbe bloccare un valore non valido prima dell'invio, invece di affidarsi a un analista che lo trovi in seguito.
Ingestion
Trattate ogni file o payload in arrivo come un contratto. Validate ogni record rispetto allo schema atteso, mettete in quarantena i fallimenti ed emettete eventi di errore strutturati che contengano file di origine, identificatore del record, campo, valore osservato e regola violata.
Non sovrascrivete il valore originale durante la pulizia. Conservatelo accanto al valore normalizzato, così che il team possa verificare cosa è arrivato e quale trasformazione è avvenuta.
Data warehouse
Eseguite controlli continui su null, unicità, integrità referenziale, freschezza, variazioni nelle distribuzioni e logica tra campi. Un test nel data warehouse dovrebbe distinguere una singola riga rifiutata da un fallimento esteso dello schema e conservare contesto sufficiente perché il responsabile possa riprodurre il problema.
Le indicazioni della Banca Mondiale su inserimento e validazione dei dati sottolineano controlli come la limitazione delle opzioni di risposta e l'uso di verifiche basate sui conteggi per ridurre le voci saltate o non valide. Questi principi valgono ben oltre i sondaggi. Applicate i vincoli il prima possibile, poi verificate in modo indipendente il dataset risultante.
Consumo
Dashboard e modelli hanno bisogno di asserzioni proprie. Confrontate il numero di righe atteso, rilevate le partizioni mancanti, controllate la copertura dei join e segnalate le metriche che cambiano all'improvviso senza una corrispondente spiegazione legata alla qualità dei dati.
Quando le formule vengono modificate nei fogli di calcolo, la validazione può comportarsi in modo inatteso. Microsoft Q&A osserva che errori di formula come #REF! o #DIV/0! possono far ignorare la validazione, mentre le operazioni di copia e riempimento possono aggirare o alterare il comportamento atteso. Consultate la discussione di Microsoft sugli errori di validazione legati alle formule quando un menu a tendina sembra corretto ma le celle trasformate falliscono comunque.
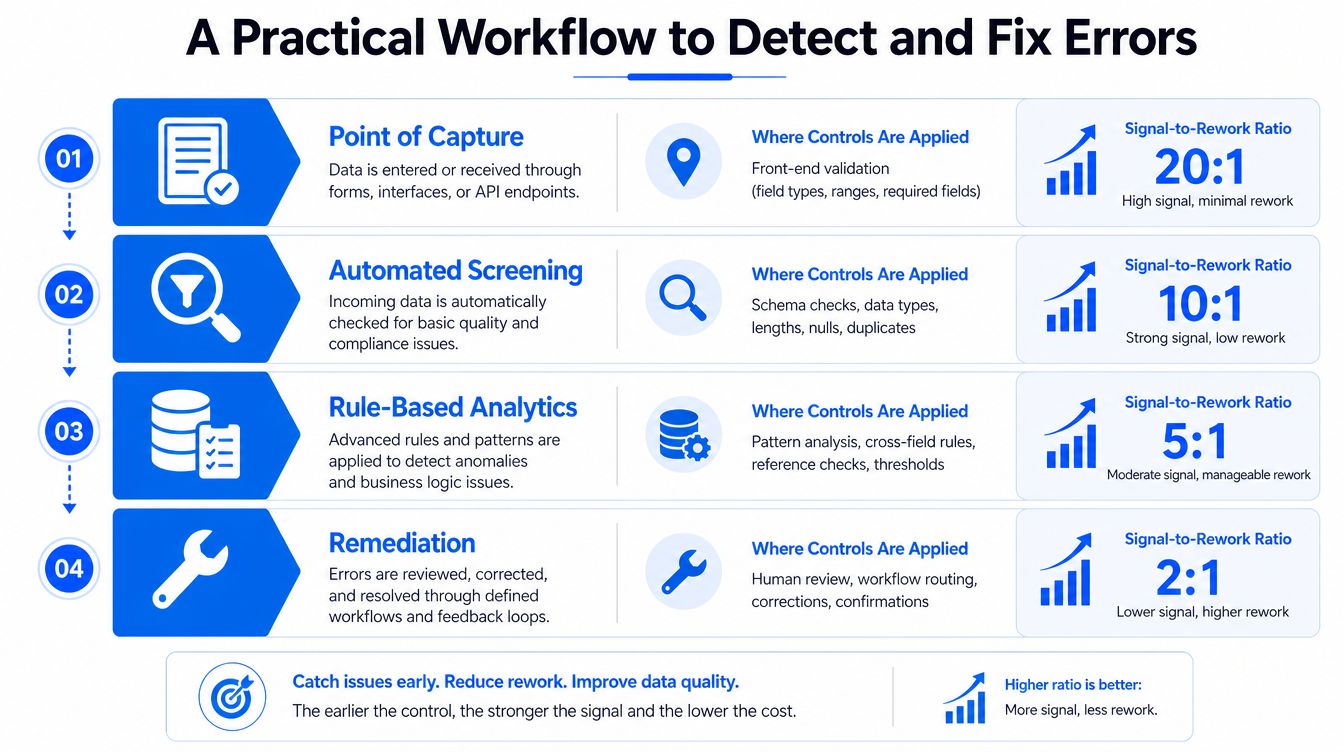
Seguite questo ordine di correzione:
Correggete prima i contratti a monte. Correggete la regola della sorgente, lo schema, la mappatura o il comportamento del produttore.
Intervenite poi sul data warehouse. Isolate, ricaricate o normalizzate i record quando la sorgente non può essere modificata subito.
Ripulite nel livello analitico solo se necessario. Rendete la trasformazione visibile, documentata e reversibile.
Per controlli continui che combinano regole a livello di record con un'osservabilità più ampia, consultate le indicazioni di digna su validazione dei dati e data quality continua. La piattaforma gira all'interno dell'ambiente del cliente, calcola le metriche nei database del cliente e può monitorare validazione, tempestività, anomalie e modifiche agli schemi senza spostare i dati di produzione al di fuori di quell'ambiente.
Punti chiave per operazioni sui dati affidabili
Operazioni sui dati affidabili dipendono meno da un'unica pulizia perfetta e più da una risposta ripetibile ai fallimenti ricorrenti. Usate questa checklist quando compare un alert di validazione:
Classificate il difetto. Stabilite se si tratta di un valore mancante, malformato, fuori intervallo, fuori dominio, incoerente, temporalmente impossibile o referenzialmente non valido.
Risalite al primo punto di fallimento. Individuate il produttore, l'esportazione, la mappatura API, la migrazione o la trasformazione che ha introdotto la discrepanza.
Riparate il contratto a monte. Modificate lo schema, la regola di campo obbligatorio, il vincolo, la mappatura o il payload versionato prima di intervenire su grandi quantità di righe a valle.
Stratificate i controlli. Validate in fase di acquisizione, ingestion, data warehouse e consumo, così che una conversione silenziosa non possa passare inosservata.
Monitorate le ricorrenze. Registrate campo, regola, sorgente, pipeline e andamento dei fallimenti. I fallimenti ripetuti meritano un lavoro di ingegneria, non pulizie manuali ripetute.
Conservate le evidenze. Conservate record rifiutati, esiti delle regole, timestamp e decisioni di correzione a fini di indagine e verificabilità.
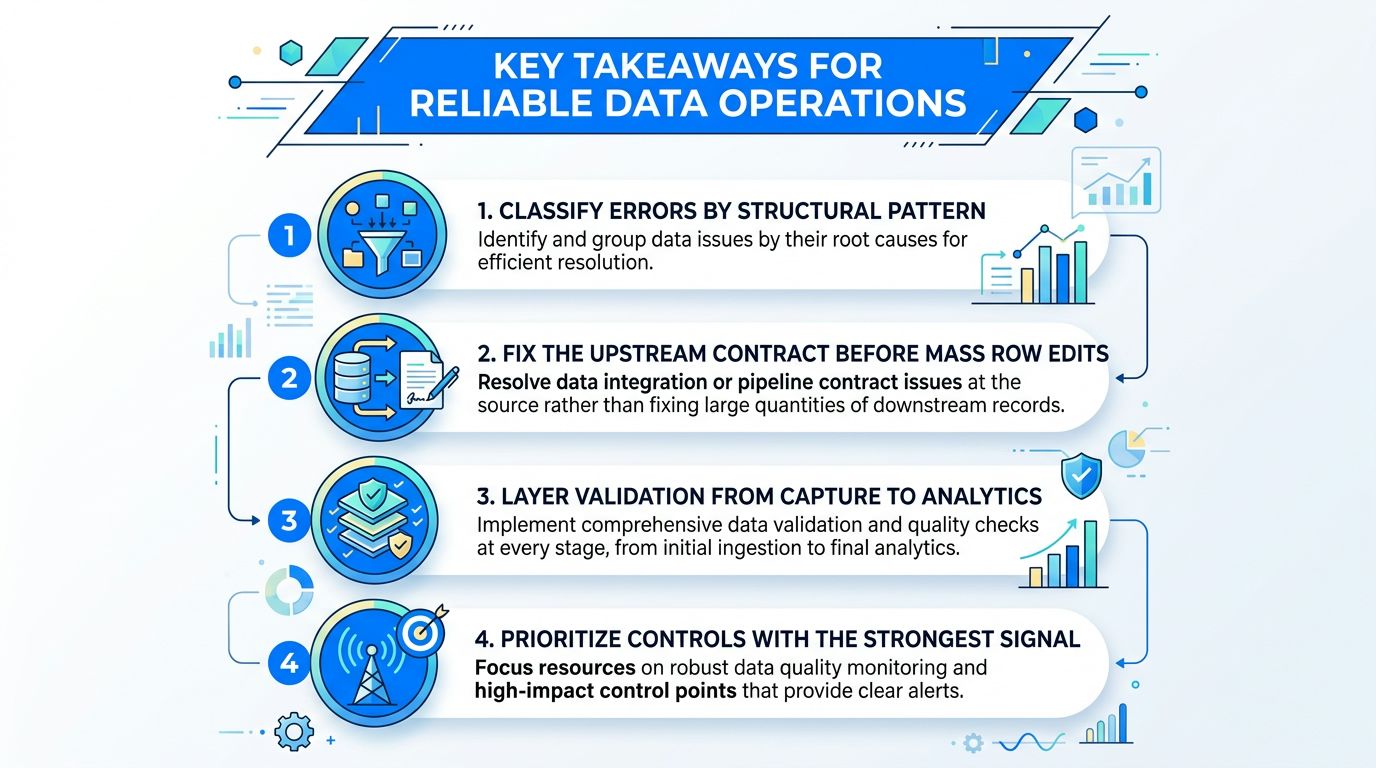
La lezione centrale è semplice: gli errori di validazione ricorrenti indicano di solito un processo difettoso, non un utente distratto. Una singola riga può essere il fallimento visibile, ma le righe ripetute rivelano una debolezza a monte nel contratto, nello schema, nella mappatura o nel monitoraggio.
La validazione dovrebbe quindi essere osservabile. I team devono sapere quali regole falliscono, dove falliscono, se i fallimenti sono isolati o sistemici e quali asset a valle dipendono dai dati interessati. Questa visibilità trasforma una confusa discrepanza in una dashboard in un incidente di ingegneria su cui si può agire.
digna aiuta i team dati a definire regole di validazione a livello di record, monitorare le modifiche agli schemi, tenere sotto controllo la tempestività e rilevare comportamenti insoliti in data warehouse e pipeline, mantenendo i dati all'interno dell'ambiente del cliente. Visitate digna per vedere come sostituire la pulizia ricorrente riga per riga con controlli di data quality e osservabilità tracciabili.
Domande frequenti
Che cos'è un errore di validazione dei dati?
Si verifica quando un valore osservato non rispetta una regola, uno schema, una relazione o un'aspettativa di business. È più di una cella di un foglio di calcolo rifiutata: un'esecuzione riuscita della pipeline dimostra che l'elaborazione è terminata, non che ogni record abbia rispettato le regole su cui si basa il business.
Qual è la differenza tra un controllo di formato e la validazione a livello di record?
La profondità. Un controllo di formato verifica se un valore può essere interpretato, quindi 2025-04-18 viene riconosciuto come data mentre jdoe@ non rispetta un pattern email. La validazione a livello di record esamina invece le relazioni: customer_id identifica un cliente reale, il totale dell'ordine è uguale alla somma delle righe, la data dell'evento è successiva alla creazione dell'account?
Quali sono gli schemi di fallimento della validazione più comuni?
Ricorre un piccolo insieme: valori mancanti, problemi di formato, problemi di codifica, controlli di intervallo non superati, violazioni di coerenza e outlier. La Banca Mondiale individua queste stesse categorie e sottolinea l'importanza di documentare la validazione nei metadati, così che la regola e la sua motivazione sopravvivano alla persona che l'ha scritta.
Quanto costa davvero un errore di validazione?
Il benchmark di Gartner, ampiamente citato, stima il costo della scarsa qualità dei dati in media in 12,9 milioni di dollari all'anno per organizzazione. La ricerca IBM del 2025 ha rilevato che oltre un quarto delle organizzazioni stima perdite annue superiori a 5 milioni di dollari, con il 7% che dichiara perdite oltre i 25 milioni di dollari.
Come si indaga su un errore di validazione?
Ponetevi due domande separate. Quale regola è stata violata, il che ripara il record, e quale livello ha permesso al valore non valido di arrivare fin qui, il che ripara la pipeline. Rispondere solo alla prima lascia lo stesso difetto libero di ripresentarsi domani.


