Dati AI-ready spiegati: dai dati grezzi a un'AI affidabile
|
8
min di lettura

Un progetto di AI sembra spesso in salute fino al momento in cui tocca i dati di produzione.
Il team ha un'idea di modello, un budget, un ambiente cloud e persone che sanno costruire pipeline. Poi il lavoro rallenta. I campi significano cose diverse in sistemi diversi. La modifica dello schema di ieri ha rotto una feature table. Le etichette provengono da un processo manuale di cui nessuno si fida completamente. I dati esistono, ma nessuno sa dire con certezza se siano sicuri per il retrieval, la previsione o le azioni automatizzate.
È a questo punto che molti team si rendono conto di non essere stati bloccati dalla scelta del modello. Erano bloccati dalla preparazione dei dati.
Un sondaggio globale del 2024 ha fotografato chiaramente questo divario. Solo il 12% delle organizzazioni ha dichiarato che i propri dati avevano qualità e accessibilità sufficienti per un'implementazione efficace dell'AI, nonostante il 60% affermasse che l'AI era diventata un'influenza chiave sui programmi relativi ai dati, in aumento del 46% rispetto al 2023. Lo stesso sondaggio ha rilevato che il 64% indicava la qualità dei dati come la principale sfida di integrità dei dati, mentre il 77% valutava la qualità dei propri dati nella media o peggio (ricerca globale sulla preparazione all'AI).
Indice
Introduzione: perché i progetti di AI si bloccano prima del modello
Pronti per cosa? Definire l'idoneità per il vostro caso d'uso AI
Come le piattaforme di observability mantengono i dati AI-ready a runtime
Conclusione: il vostro percorso verso dati AI-ready affidabili
Introduzione: perché i progetti di AI si bloccano prima del modello
In molti data team si ripete uno schema familiare. Il prodotto vuole un copilot per l'assistenza. Il risk management vuole il rilevamento delle anomalie. Le operations vogliono previsioni. L'engineering riesce a mettere insieme lo stack abbastanza in fretta, ma il primo test serio fa emergere il problema. Nessuno è d'accordo su quale tabella sia quella autorevole, se l'ultimo caricamento sia completo o se le etichette riflettano il risultato di business che il modello dovrebbe imparare.
Ecco perché dati AI-ready è un'espressione più utile di “dati puliti”. La pulizia suona come un'attività di igiene una tantum. La preparazione è più rigorosa. Chiede se un dataset sia idoneo a uno specifico compito di AI, nelle attuali condizioni operative, con un livello di fiducia sufficiente a supportare le decisioni.
Se avete visto esperimenti di modellazione funzionare bene in un notebook e fallire una volta collegati ai sistemi live, avete già incontrato questo problema. Il fallimento di solito non è misterioso. Si nasconde in entità duplicate, input obsoleti, trasformazioni non documentate o passaggi fragili tra team. Una base solida parte dal comprendere perché la qualità dei dati è importante per un'organizzazione, ma l'AI alza l'asticella perché i dati devono funzionare sia per le persone sia per le macchine.
Lo stallo di solito inizia a monte
Molti team non iniziano ponendo la domanda sbagliata. Pongono una domanda troppo ampia: “I nostri dati sono pronti per l'AI?”. Sembra sensata, ma nasconde i dettagli importanti. Essere pronti per la ricerca su documenti è diverso dall'essere pronti per la previsione della domanda. Essere pronti per un assistente con supervisione umana è diverso dall'essere pronti per un agente che avvia azioni.
I progetti di AI raramente si bloccano perché mancano i dati. Si bloccano perché i dati disponibili non sono abbastanza affidabili per il flusso di lavoro specifico che si sta costruendo.
Questa distinzione cambia il modo in cui valutate la preparazione. Smettete di considerare il volume come una prova. Iniziate a verificare idoneità, tracciabilità e sicurezza a runtime.
La fiducia deve resistere al contatto con i sistemi live
I controlli di qualità storici sono importanti, ma non bastano. Un dataset di training può sembrare ben preparato e diventare comunque insicuro quando gli schemi cambiano, i caricamenti arrivano in ritardo o la logica a monte cambia senza preavviso. Nella pratica, la preparazione all'AI vive in due luoghi contemporaneamente:
Qualità della preparazione significa che il dataset è definito, convalidato e documentato abbastanza bene da poter essere usato.
Fiducia a runtime significa che siete in grado di rilevare quando quello stato non è più valido.
È questa la lente da usare. Non “Abbiamo molti dati?”, ma “Questi dati possono supportare questo comportamento dell'AI, oggi, con controlli che intercettano il drift prima che il modello agisca?”
Che cosa significano davvero i dati AI-ready
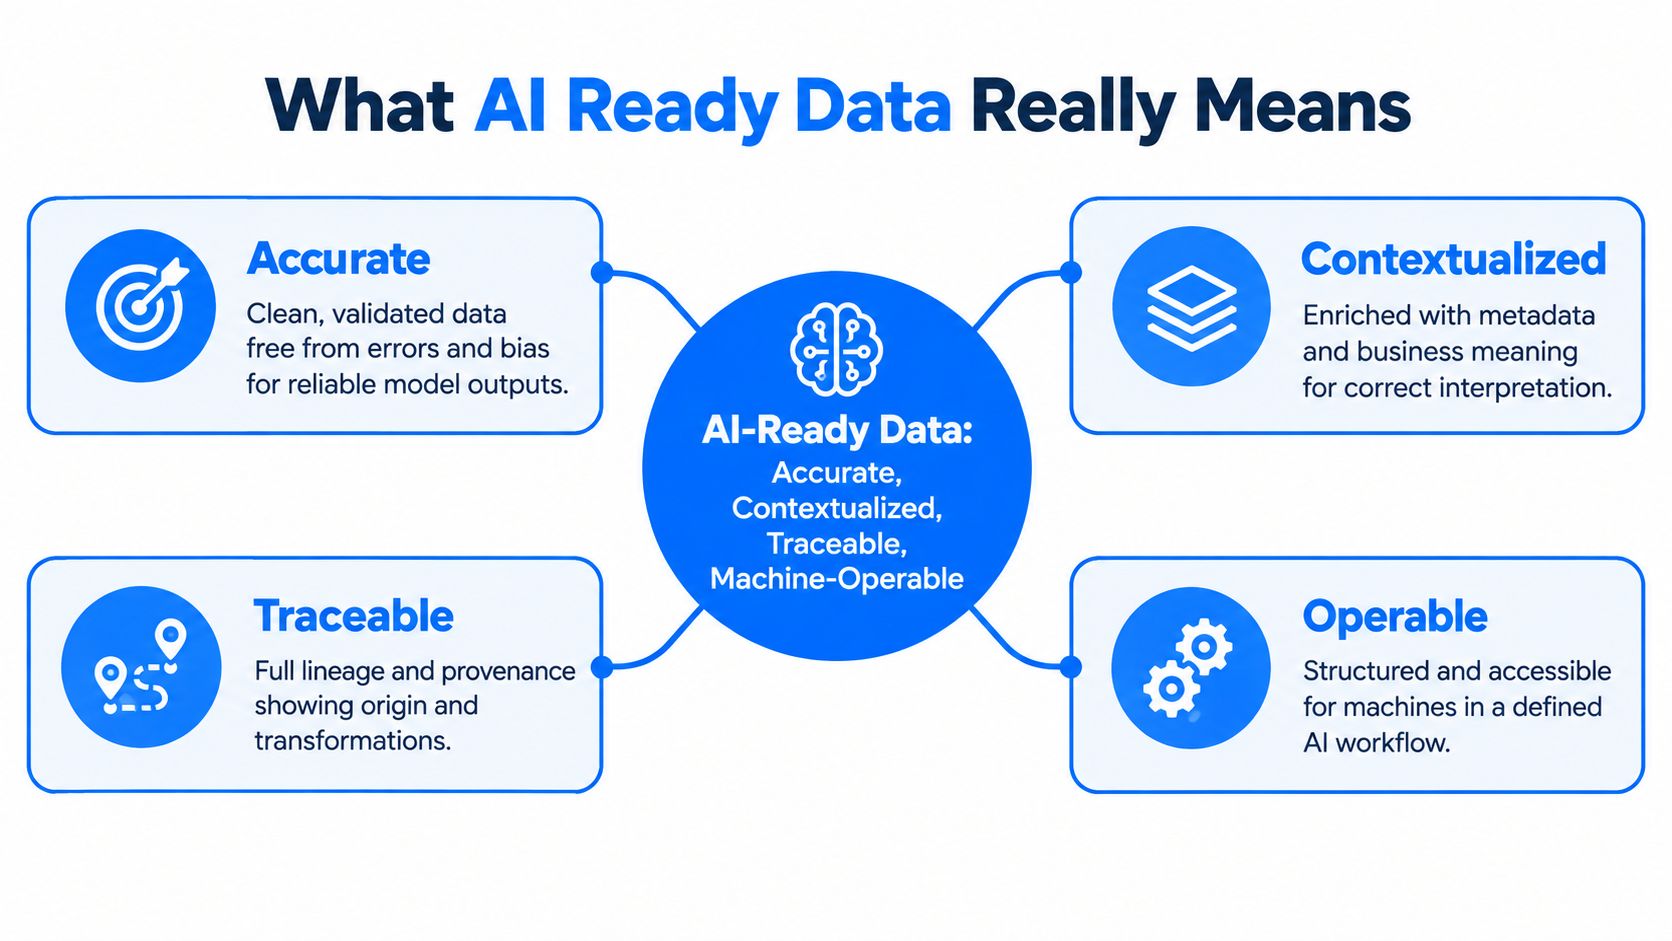
I dati AI-ready non sono solo dati con meno valori nulli e valori più puliti. Sono dati che una macchina può interpretare, tracciare e usare correttamente per un flusso di lavoro definito.
Un'analogia con la cucina aiuta. Gli ingredienti crudi in frigorifero non sono la stessa cosa degli ingredienti preparati per una ricetta. Potete avere cipolle, pomodori e spezie, ma questo non significa che la cena sia pronta. Qualcuno deve ancora lavare, tagliare, dosare, etichettare e organizzare tutto per il piatto specifico da cucinare. Con i dati funziona allo stesso modo. Archiviare non significa essere pronti. Essere pronti significa che il dataset è stato preparato per un tipo specifico di elaborazione.
L'accuratezza è solo il primo livello
Partite dalla qualità dei valori, ed è giusto farlo. I valori errati rompono i modelli in modi evidenti. Timestamp sbagliati distorcono le feature sequenziali. Clienti duplicati gonfiano l'esposizione. Etichette incoerenti avvelenano i target di training. Se vi serve un buon ripasso delle componenti alla base di tutto questo, le dimensioni della qualità dei dati sono il fondamento giusto.
Ma l'accuratezza da sola non rende i dati AI-ready. Una colonna perfettamente valida fallisce comunque se il modello non riesce a capire cosa significa, da dove proviene o se si applica al compito attuale.
Il contesto trasforma i valori in segnali utilizzabili
I dati diventano più utili quando portano con sé metadati che le macchine possono interpretare, non solo commenti leggibili dalle persone. Le indicazioni indipendenti della comunità statistica delle Nazioni Unite e del governo del Regno Unito sottolineano che i dataset AI-ready richiedono metadati leggibili dalle macchine, garanzia della qualità, formati interoperabili e controlli di governance. Il framework ONU evidenzia metadati azionabili dalle macchine, controllo della qualità, licenze aperte, accesso responsabile abilitato dall'AI e collaborazione strutturata. Le linee guida britanniche del 2026 affermano che un dataset AI-ready deve rispettare standard di ottimizzazione tecnica, accuratezza, completezza, coerenza, metadati, monitoraggio della qualità in tempo reale e conformità normativa (linee guida ONU e britanniche sui dati AI-ready).
Sembra astratto finché non lo si traduce in lavoro di engineering:
Il significato di business dice al team di modellazione che cosa rappresenta un campo.
I metadati tecnici dicono ai sistemi come interpretarlo e metterlo in join.
Il contesto d'uso dice agli utenti downstream quando è appropriato usarlo.
Tracciabili e utilizzabili dalle macchine significa sicuri per la produzione
Un articolo di esperti del 2026 descrive i dati AI-ready come dati supportati da metadati strutturati che consentono discovery automatizzata, allineamento semantico, tracciamento della provenienza e uso computazionale riproducibile. Osserva inoltre che i metadati a livello di dataset devono essere associati ai dati e interpretabili dalle macchine, perché interoperabilità e tracciabilità dipendono da essi (discussione di esperti su metadati strutturati e provenienza).
Regola pratica: considerate metadati, lineage e provenienza parte del contratto di input del modello, non come documentazione di governance opzionale.
È questa la definizione di base che uso nel lavoro di piattaforma: i dati AI-ready sono accurati, contestualizzati, tracciabili e utilizzabili dalle macchine per uno specifico compito di AI. Se manca uno di questi elementi, il modello può comunque funzionare. Semplicemente, non sarà affidabile.
I sei pilastri che rendono i dati AI-ready
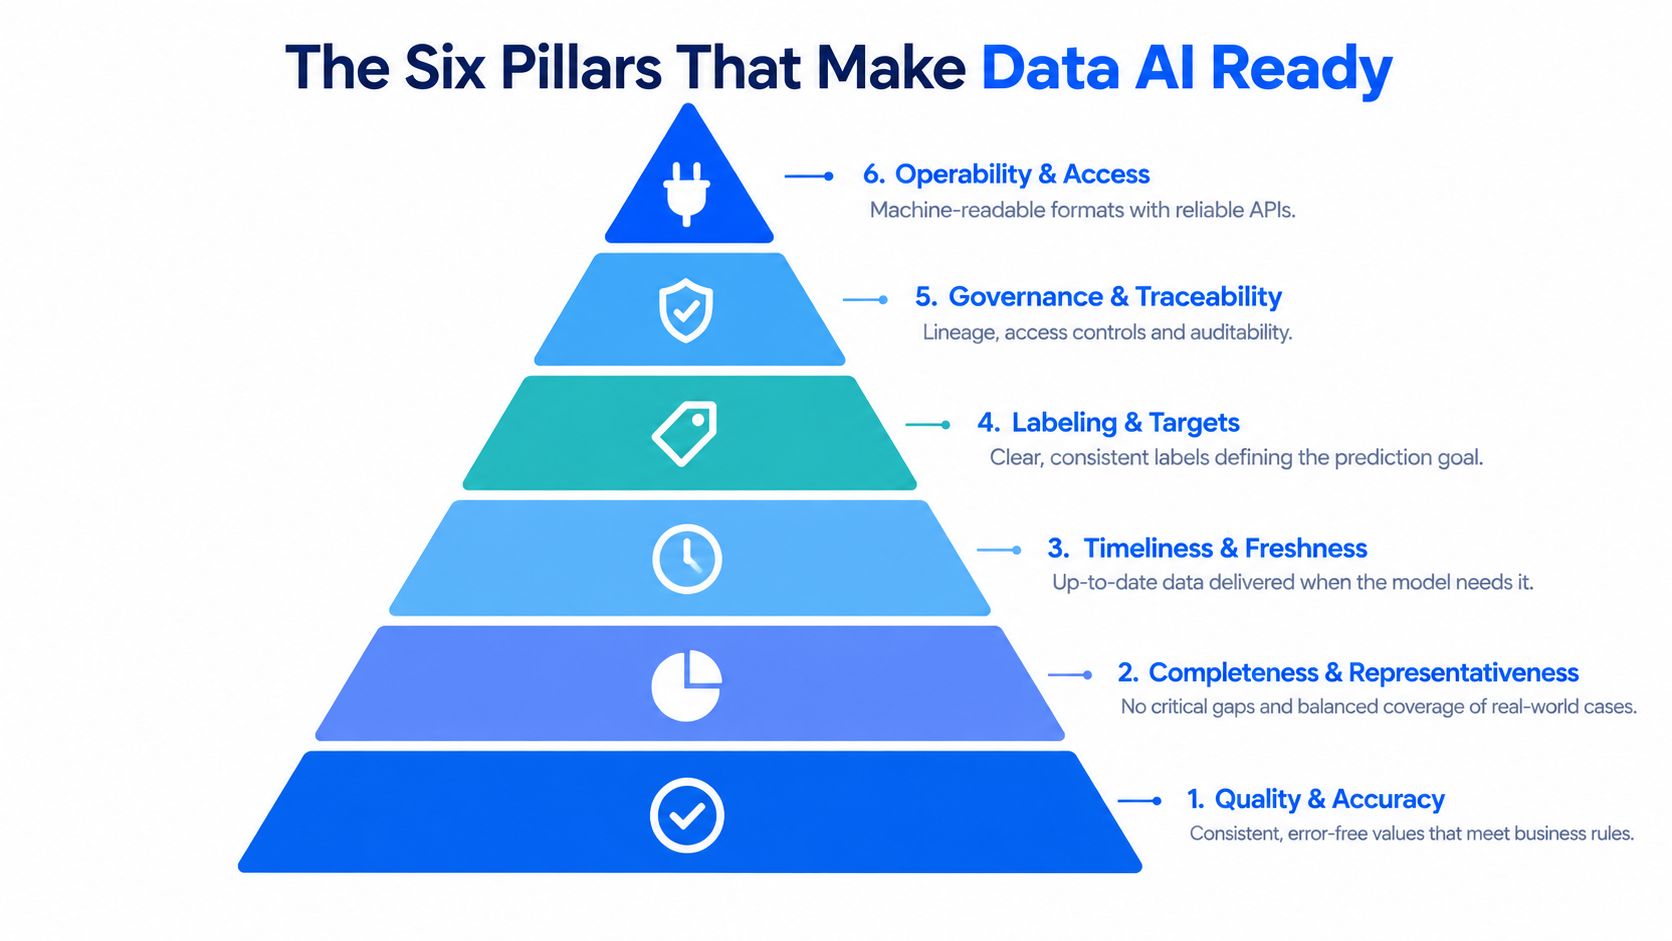
Una checklist pratica va oltre “puliti e governati”. Sei pilastri sono utili perché coprono sia le prestazioni del modello sia la fiducia operativa.
Qualità e accuratezza
Partite dai valori stessi. I record sono validi? I formati sono coerenti? Date, identificativi e campi categoriali rispettano le regole di business?
Non si tratta solo di ortodossia del data management. Una ricerca empirica ha esaminato sei dimensioni della qualità dei dati su 19 diffusi algoritmi di machine learning per classificazione, regressione e clustering, proprio per spiegare le prestazioni attraverso la qualità dei dati. Un successivo articolo sulla data-centric AI ha ripreso sei dimensioni: rappresentazione coerente, completezza, accuratezza delle feature, accuratezza del target, unicità e bilanciamento delle classi target (ricerca sulle dimensioni della qualità dei dati e sui risultati del ML).
L'implicazione pratica è semplice. Duplicati, target etichettati in modo errato e rappresentazioni incoerenti cambiano il comportamento del modello.
Completezza e rappresentatività
Un dataset completo potrebbe comunque non rappresentare il mondo che il vostro modello dovrà affrontare. È qui che i team spesso inciampano. Convalidano il numero di righe e le percentuali di null, poi scoprono che il modello rende poco su casi rari ma importanti.
La rappresentatività verifica se i dati includono gli eventi, gli utenti, i casi limite e le condizioni operative che il sistema di AI deve gestire. Se addestrate un classificatore per l'assistenza su ticket ben formati ma in produzione arrivano abbreviazioni, log copiati e testi multilingue, il vostro campione pulito non è abbastanza rappresentativo.
Una checklist aziendale utile include spesso:
Copertura dei casi limite rilevanti per il business, non solo del percorso più comune
Esempi bilanciati quando lo squilibrio tra classi distorcerebbe il training
Diversità delle fonti quando la stessa entità compare in sistemi frammentati
Tempestività e freschezza
Alcuni dati sono corretti ma comunque inutilizzabili perché arrivano in ritardo. Per l'AI questo conta più di quanto molti team si aspettino.
Un modello di raccomandazione costruito sull'inventario di ieri può suggerire articoli non disponibili. Un segnale antifrode costruito su transazioni in ritardo diventa meno utile proprio quando la velocità conta. Per i sistemi di retrieval, una conoscenza obsoleta può essere più pericolosa di una conoscenza mancante, perché l'output suona comunque sicuro.
La freschezza non è una nota a piè di pagina dello SLA. Per molti flussi di lavoro di AI fa parte della correttezza.
Etichettatura e integrità del target
Le etichette di training meritano un pilastro a sé perché definiscono ciò che il modello impara a ottimizzare. Se i team non concordano sul significato di “abbandonato”, “approvato” o “ad alto rischio”, il modello codificherà quell'ambiguità.
Una buona etichettatura non riguarda solo la coerenza. Riguarda anche l'allineamento operativo. Il target deve riflettere la decisione che il business vuole supportare. Altrimenti il modello diventa eccellente nel prevedere un proxy che nessuno dovrebbe usare.
Governance e tracciabilità
Quando l'output di un modello va spiegato, i team hanno bisogno del lineage in fretta. Quale sistema sorgente ha fornito il valore? Quali trasformazioni lo hanno modificato? Chi ha approvato il dataset per questo uso?
Un framework aziendale per la qualità dei dati è utile qui perché la governance diventa concreta quando è legata a controlli specifici: ownership, regole di accesso, evidenze di convalida e storico del lineage. Senza tracciabilità, anche un dataset solido è difficile da sottoporre ad audit e difficile da considerare affidabile.
Operabilità e accesso
L'ultimo pilastro è spesso sottovalutato. I dati possono essere di alta qualità e fallire comunque perché sono intrappolati in formati scomodi, schemi di archiviazione poco documentati o passaggi fragili.
Operabilità significa che i dati sono disponibili in formati leggibili dalle macchine, accessibili tramite interfacce stabili e strutturati in modo che le pipeline possano consumarli in modo affidabile. In termini di produzione, schemi, API, tabelle e servizi di metadati smettono di essere semplice infrastruttura e diventano parte integrante della preparazione all'AI.
Pronti per cosa? Definire l'idoneità per il vostro caso d'uso AI
Una checklist generica di preparazione crolla nel momento in cui si confrontano compiti di AI diversi.
Un sistema di retrieval ha bisogno di documenti ricercabili, di una strategia di chunking, di tag di metadati e di provenienza. Un modello di previsione ha bisogno di serie temporali stabili, granularità coerente e timestamp affidabili. Un flusso di lavoro autonomo richiede controlli ancora più rigorosi, perché può agire sui dati senza revisione umana.
Gartner lo afferma in modo esplicito. I leader devono prima definire cosa si intende per dati AI-ready, e quei dati devono essere rappresentativi del caso d'uso, inclusi casi limite, outlier e pattern inattesi necessari per addestrare o eseguire il modello. La stessa analisi osserva che le organizzazioni spesso confondono la scala con la qualità del segnale adatta allo scopo, mentre le indicazioni attuali sottolineano dati ricercabili, contestuali e affidabili su asset strutturati, non strutturati e in streaming (Gartner sulla definizione dei dati AI-ready per caso d'uso).
Più dati non rispondono alla domanda giusta
I team dicono spesso: “Abbiamo moltissimi dati”. Può essere vero e comunque irrilevante.
La domanda migliore è: quale errore danneggerebbe di più questo sistema di AI? Se il sistema riassume documenti di policy, le versioni obsolete sono un rischio importante. Se valuta eventi creditizi, provenienza e stato di approvazione contano più del puro volume di testo. Se alimenta un agente operativo, la freschezza a runtime e i limiti dei permessi diventano centrali.
Caso d'uso AI | Criteri di preparazione più critici | Errore tipico se mancano |
|---|---|---|
Retrieval su documenti | Metadati ricercabili, provenienza, versioning, controlli di accesso | Il sistema recupera contenuti obsoleti o privi di contesto |
Modellazione predittiva | Copertura rappresentativa, integrità del target, coerenza, completezza | Il modello apprende pattern distorti e trascura casi importanti |
Supporto decisionale in tempo reale | Freschezza, tempestività, schemi stabili, accesso a bassa latenza | L'output riflette eventi in ritardo o incompleti |
Flussi di lavoro autonomi | Governance, tracciabilità, controlli di policy, rilevamento delle modifiche | Il sistema compie azioni non sicure basate su input non affidabili |
Usate i critical data element per ponderare la checklist
Molti team traggono vantaggio dal definire i critical data element prima di iniziare a ottimizzare i modelli. Non tutti i campi meritano gli stessi controlli. L'ID cliente in un flusso di deduplicazione ha un peso diverso rispetto a un campo di commento descrittivo in un flusso di ricerca semantica.
Un modo pratico per valutare l'idoneità è porsi tre domande:
Quale decisione o output dipende esattamente da questi dati?
Quale modalità di errore è meno accettabile?
Quali campi, metadati e percorsi di aggiornamento determinano quel rischio?
Una volta risposto a queste domande, la preparazione smette di essere uno slogan e diventa una specifica di engineering.
Come preparare i dati per l'AI nella pratica
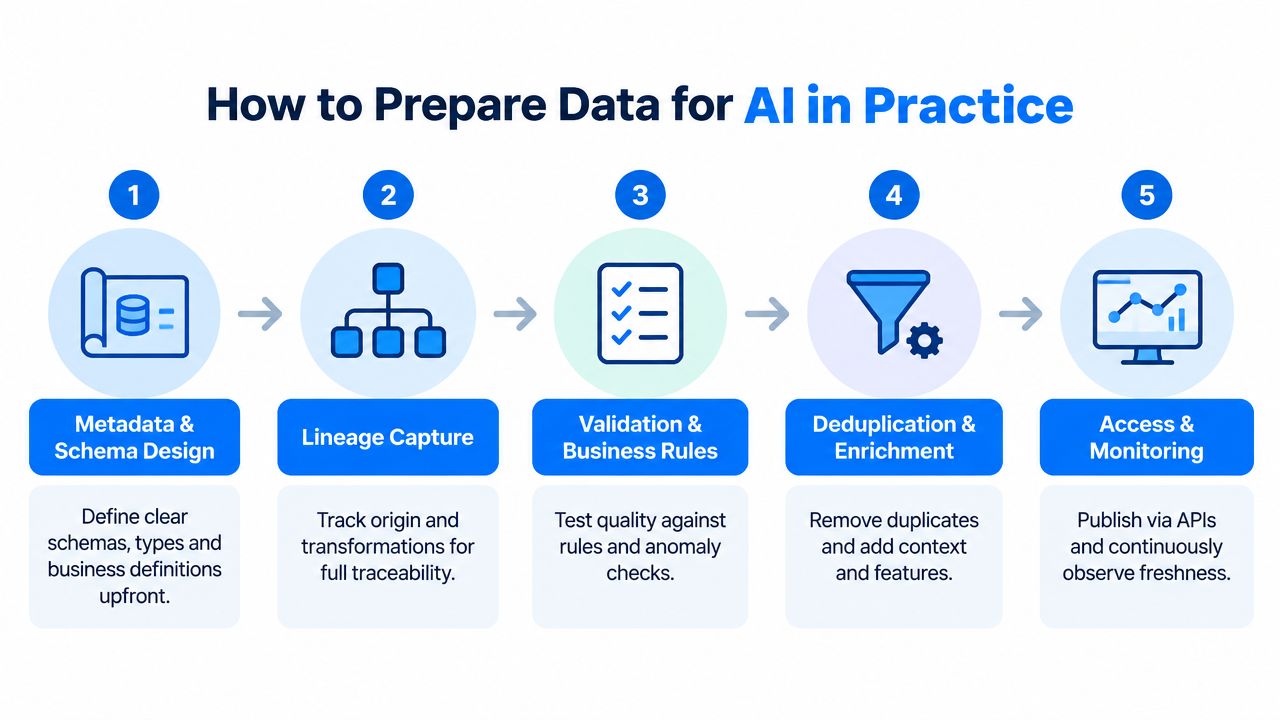
La preparazione funziona meglio come flusso di lavoro connesso, non come un insieme di attività di pulizia isolate. L'ordine conta perché le prime scelte progettuali determinano quanta fiducia potrete preservare in seguito.
Partite da schemi e metadati
Prima di convalidare i valori, definite che cosa dovrebbe essere il dataset. Ciò significa nomi dei campi, tipi, definizioni di business, ownership, uso approvato e aspettative di aggiornamento. Se un campo cambia significato senza cambiare nome, ogni modello downstream opera ora con un rischio silenzioso.
Buoni metadati devono rispondere alle domande sia delle persone sia delle macchine. Una persona deve comprenderne il significato di business. Una pipeline deve poterne interpretare automaticamente struttura, relazioni e vincoli d'uso.
Registrate il lineage mentre le trasformazioni sono ancora visibili
Il lineage è più facile da registrare nel momento in cui i dati si spostano, non mesi dopo durante un audit. Tracciate da dove provengono i dati, quali join e filtri li hanno toccati e quale job o persona li ha promossi in un livello che serve l'AI.
Il modo più rapido per perdere fiducia in un modello è scoprire un output sospetto e non avere un percorso chiaro per risalire ai record di origine.
Non serve un enorme programma di governance. Serve disciplina nella progettazione delle pipeline, nel logging delle trasformazioni e nella registrazione dei dataset.
Convalidate le regole di business prima di scalare il training
Una volta definiti significati e lineage, applicate controlli basati su regole. Convalidate gli ID, imponete gli intervalli consentiti, verificate l'integrità referenziale e, ove possibile, confrontate le etichette con la verità della fonte.
Poi affrontate i problemi che spesso hanno un impatto sproporzionato sui modelli:
Deduplicazione: rimuovete o riconciliate i record che descrivono la stessa entità in modo contraddittorio.
Analisi dei valori mancanti: distinguete i null accettabili da quelli che segnalano un feed interrotto.
Verifica delle etichette: controllate se i valori target corrispondono al risultato operativo che vi interessa.
Analisi del bilanciamento delle classi: verificate se categorie importanti sono assenti, rare o sbilanciate.
Arricchite il dataset senza nascondere la verità della fonte
L'arricchimento delle feature è utile, ma può anche offuscare la provenienza se i team non etichettano chiaramente i campi derivati. Mantenete distinti i campi grezzi, i campi standardizzati e le feature ingegnerizzate. Questo semplifica il debug quando il comportamento del modello diventa difficile da spiegare.
Pubblicate percorsi di accesso e hook di monitoraggio
Un dataset preparato deve essere individuabile e consumabile. Di solito ciò significa una tabella stabile, un'API o un percorso di serving documentato con una ownership chiara.
Significa anche strumentare il dataset prima del deployment, non dopo il primo incidente. Se non potete osservare i cambiamenti di tempestività, struttura o comportamento dei valori, il dataset non è pronto per l'AI in produzione.
Come le piattaforme di observability mantengono i dati AI-ready a runtime
La preparazione porta un dataset alla linea di partenza. L'observability ce lo mantiene.
Questo conta soprattutto negli ambienti regolamentati o sensibili alla privacy, dove i team non possono esportare i dati verso strumenti di AI esterni. Le analisi indipendenti del settore descrivono sempre più spesso i dati AI-ready come dati individuabili, governati, sicuri e utilizzabili attraverso sistemi frammentati, con la fiducia a runtime che diventa centrale per scalare l'AI aziendale, in particolare in finanza, sanità, telecomunicazioni e settore pubblico (IBM sui dati AI-ready affidabili e governati).

Come si presenta in pratica la fiducia a runtime
A runtime non vi chiedete più se il dataset storico sembrava valido durante la preparazione. Vi chiedete se l'input di oggi corrisponde ancora alle condizioni in cui il modello o l'agente è considerato sicuro.
Di solito questo richiede diversi controlli che lavorano insieme:
Monitoraggio della freschezza per intercettare caricamenti in ritardo, mancanti o inaspettatamente anticipati
Tracciamento dello schema per intercettare le modifiche strutturali prima che i sistemi downstream falliscano
Controlli di convalida per applicare le regole di business ai record live
Monitoraggio del comportamento per rilevare variazioni insolite nelle distribuzioni dei valori o nei pattern delle righe
Una piattaforma come il software di data observability di digna è un esempio di questo approccio. Funziona all'interno dell'ambiente del cliente, esegue i controlli direttamente nel database e combina rilevamento delle anomalie, monitoraggio della tempestività, convalida e tracciamento dello schema senza che il fornitore debba accedere ai dati di produzione. Questo modello di deployment è importante quando i dati non possono lasciare l'infrastruttura dell'organizzazione.
Le metriche operative sono concrete
Lo schema drift non è una preoccupazione vaga. Un design di riferimento definisce un contatore delle modifiche allo schema per tabella, incluse aggiunta, eliminazione, ridenominazione, cambio di tipo e di nullabilità delle colonne, e lo affianca a segnali statistici di drift come la percentuale di null e il numero di valori distinti, per separare il cambiamento strutturale da quello di distribuzione (metriche di drift di schema e attributi).
Anche la freschezza è misurabile. Un design di observability traccia la latenza di rilevamento del drift come tempo medio tra il verificarsi di una modifica allo schema e il suo rilevamento da parte del sistema. Traccia anche il tasso di perdita di dati e il tasso di errore delle pipeline come percentuali di record malformati o persi, o di job falliti (monitoraggio della latenza del drift e dei segnali di qualità delle pipeline).
Il monitoraggio assistito dall'AI riduce il lavoro manuale sulle soglie
Le soglie manuali non scalano bene su centinaia di dataset. Bigeye afferma che il suo rilevamento delle anomalie apprende il comportamento storico di un dataset e determina automaticamente le soglie per ogni attributo di qualità dei dati, usando soglie di deviazione standard basate sulla media storica per generare avvisi senza alcuno sforzo manuale (approccio di Bigeye al rilevamento delle anomalie).
Databricks descrive una direzione simile a livello enterprise. Il suo monitoraggio analizza automaticamente i pattern storici per rilevare anomalie nella freschezza e nella completezza delle tabelle, monitorando al contempo trend statistici e anomalie nel tempo in un sistema unificato (Databricks Lakehouse Monitoring).
La pulizia storica aiuta nel training. L'observability a runtime decide se gli output dell'AI in produzione restano affidabili.
È questo il cambiamento che molti team stanno compiendo ora. La preparazione all'AI non è più solo una tappa della preparazione dei dati. È una condizione operativa.
Conclusione: il vostro percorso verso dati AI-ready affidabili
I dati AI-ready non sono un mucchio più grande di record. Sono dati idonei a uno specifico caso d'uso e ancora affidabili quando i sistemi live iniziano a cambiare intorno a loro.
Ciò significa che due discipline devono incontrarsi. Primo, preparare i dataset in modo che siano accurati, contestualizzati, tracciabili e utilizzabili dalle macchine. Secondo, mantenere quello stato con controlli a runtime che intercettano input obsoleti, modifiche allo schema, record mancanti e anomalie di comportamento prima che raggiungano un modello, un agente o un flusso decisionale.
Se state valutando il vostro ambiente, mantenete pratico il primo passaggio:
Definite chiaramente il caso d'uso: retrieval, previsione, supporto decisionale o azione autonoma
Individuate i campi e le etichette critici: soprattutto quelli legati al rischio di business
Verificate duplicati, valori mancanti e integrità delle etichette: spesso compromettono la qualità del modello più rapidamente di quanto i team si aspettino
Verificate freschezza e stabilità dello schema: in particolare per sistemi live o quasi in tempo reale
Richiedete lineage e metadati leggibili dalle macchine: affinché i team possano fidarsi di ciò che il modello consuma e sottoporlo ad audit
Preferite l'observability all'interno dell'ambiente quando i dati non possono essere spostati: soprattutto in contesti regolamentati
L'errore più grande è trattare la preparazione come un progetto di pulizia una tantum. È più vicina alla reliability engineering. Stabilite i controlli, definite condizioni operative accettabili e continuate a osservare. È così che i dati grezzi diventano un'AI affidabile.
digna offre una piattaforma enterprise di data quality e data observability che aiuta i team a mantenere affidabili i dati per l'AI all'interno del proprio ambiente, con controlli nel database su anomalie, tempestività, convalida e modifiche allo schema. Se i vostri carichi di lavoro di AI dipendono dalla fiducia a runtime tanto quanto dalla preparazione iniziale, visitate digna per vedere come funziona questo modello operativo nella pratica.
La preparazione è un obiettivo in movimento, non un certificato: la gestione della qualità dei dati è ciò che mantiene un dataset idoneo al modello che già dipende da esso.
Domande frequenti
Che cosa significa davvero dati AI-ready?
L'accuratezza è solo il primo livello. I dati sono AI-ready quando portano con sé anche il contesto che trasforma i valori in segnali utilizzabili, e quando sono tracciabili e utilizzabili dalle macchine, cioè un modello può consumarli in produzione senza che una persona debba prima assemblarli. Dati accurati ma privi di contesto bloccano comunque un progetto.
Quali sono i pilastri della preparazione all'AI?
Sei: qualità e accuratezza, completezza e rappresentatività, tempestività e freschezza, etichettatura e integrità del target, governance e tracciabilità, operabilità e accesso. L'integrità delle etichette è quella che i team trascurano più spesso, e una colonna target corrotta invalida tutto ciò che viene addestrato su di essa.
Perché i progetti di AI si bloccano dopo essere sembrati in salute?
Perché lo stallo inizia a monte, non nel modello. Un progetto sembra a posto finché non tocca i dati di produzione e la fiducia deve resistere al contatto con i sistemi live: feed in ritardo, schemi che cambiano, campioni non rappresentativi. Il modello è di solito l'ultimo punto in cui il problema ha origine.
Più dati sono la risposta alla preparazione all'AI?
No. Più dati non rispondono alla domanda giusta. La preparazione è l'idoneità a uno specifico caso d'uso, quindi la mossa utile è individuare i critical data element e ponderare la checklist su di essi, anziché aumentare il volume su campi che nessun modello consuma.
Come si mantengono i dati AI-ready a runtime?
La preparazione si deteriora, quindi richiede monitoraggio anziché una certificazione una tantum. Sorvegliate continuamente la freschezza rispetto alla finestra promessa, la stabilità dello schema, le variazioni di distribuzione e l'integrità delle etichette. Il monitoraggio assistito dall'AI aiuta perché riduce la taratura manuale delle soglie che fa invecchiare le regole statiche.


