Data Operations Engineer: la guida completa 2026
|
5
min di lettura

Alle 8:12 la dashboard finanziaria segnala un calo dei ricavi durante la notte. Alle 8:19 il management chiede se il calo sia reale. Alle 8:27 un analista scopre che una tabella upstream è arrivata in ritardo, che un feature store di un modello contiene valori obsoleti e che nessuno è in grado di dire con certezza se i numeri siano sbagliati, in ritardo o entrambe le cose.
È in quel momento che spesso le organizzazioni capiscono di non avere soltanto un problema di strumenti. Hanno un problema di responsabilità. La pipeline può risultare “attiva” mentre i dati sono inutilizzabili. Il data warehouse può essere in salute mentre la dashboard mente. Il modello può continuare a produrre score mentre i suoi input sono andati completamente fuori strada.
Il Data Operations Engineer si colloca proprio in questo vuoto. Il ruolo esiste per rendere i sistemi di dati affidabili sotto la pressione della produzione: non solo per mantenere in esecuzione i job, ma per garantire che i dati in arrivo siano tempestivi, strutturalmente corretti e adatti all'uso a valle.
Indice
L'eroe invisibile del moderno data stack
Una dashboard rotta raramente è soltanto una dashboard rotta.
La maggior parte degli incidenti inizia come un sintomo vago. I numeri delle vendite non quadrano. Un modello di churn inizia a comportarsi in modo strano. Un team di prodotto vede nel report di oggi il volume di eventi di ieri. L'interfaccia di orchestrazione delle pipeline è ancora tutta verde, quindi il primo istinto è dare la colpa all'analista, all'SQL o al livello di BI. Di solito è tempo sprecato.
Il vero problema sta più in basso. I dati sono arrivati in ritardo. Uno schema è cambiato senza preavviso. Un picco di valori null è passato inosservato. Una feature table si è aggiornata, ma una chiave di join ha cambiato significato upstream. Quando i team dipendono contemporaneamente da data warehouse, pipeline di streaming, feature store e connettori SaaS, i guasti smettono di essere netti.
La parte dolorosa non è solo il disservizio. È il periodo in cui nessuno sa se può fidarsi dei dati.
È qui che il Data Operations Engineer diventa l'eroe invisibile. Questa figura agisce come un primo soccorritore della piattaforma dati. Ricostruisce i sintomi attraverso ingestion, trasformazione, tempestività, comportamento degli schemi, logica di validazione e aspettative a valle. Non si ferma a “il job è andato a buon fine”. Si chiede se il risultato sia utilizzabile.
Questa specializzazione conta perché il mercato è andato ben oltre la semplice costruzione di pipeline. Il mercato globale del data engineering è destinato a crescere da 29,1 miliardi di USD nel 2023 a 175 miliardi di USD entro il 2030, con prospettive di crescita del 23% per i ruoli legati ai dati fino al 2032, contro il 4% delle altre professioni, secondo l'analisi di LinkedIn sul mercato del lavoro nel data engineering.
Questa crescita non significa che ogni team abbia bisogno di più persone che scrivono job ETL una tantum. Significa che le aziende hanno più asset di dati critici in produzione, più carichi di lavoro di AI che dipendono da input stabili e più decisioni di business legate a dataset che devono essere corretti e puntuali.
Perché le emergenze continuano a ripetersi
Di solito i team falliscono in uno di due modi:
Assegnano l'affidabilità come attività secondaria. Un platform engineer gestisce l'orchestrazione, un data engineer le trasformazioni e un analista il report. Quando arriva un incidente, ognuno possiede un pezzo e nessuno possiede l'insieme.
Monitorano l'infrastruttura ma non il comportamento dei dati. CPU, memoria e durata dei task sembrano a posto, mentre duplicati, caricamenti obsoleti o valori non validi finiscono dritti in produzione.
Che cosa cambia con questo ruolo
Un data operations engineer sposta il modello operativo da reattivo a preventivo.
Definisce che cosa significhi “dati in salute”. Costruisce controlli su tempestività, completezza, correttezza e stabilità degli schemi. Crea percorsi di escalation che partono dalle evidenze anziché dalle supposizioni. Con il tempo, riduce il numero di mattine che iniziano con una crisi di fiducia.
Che cos'è un Data Operations Engineer
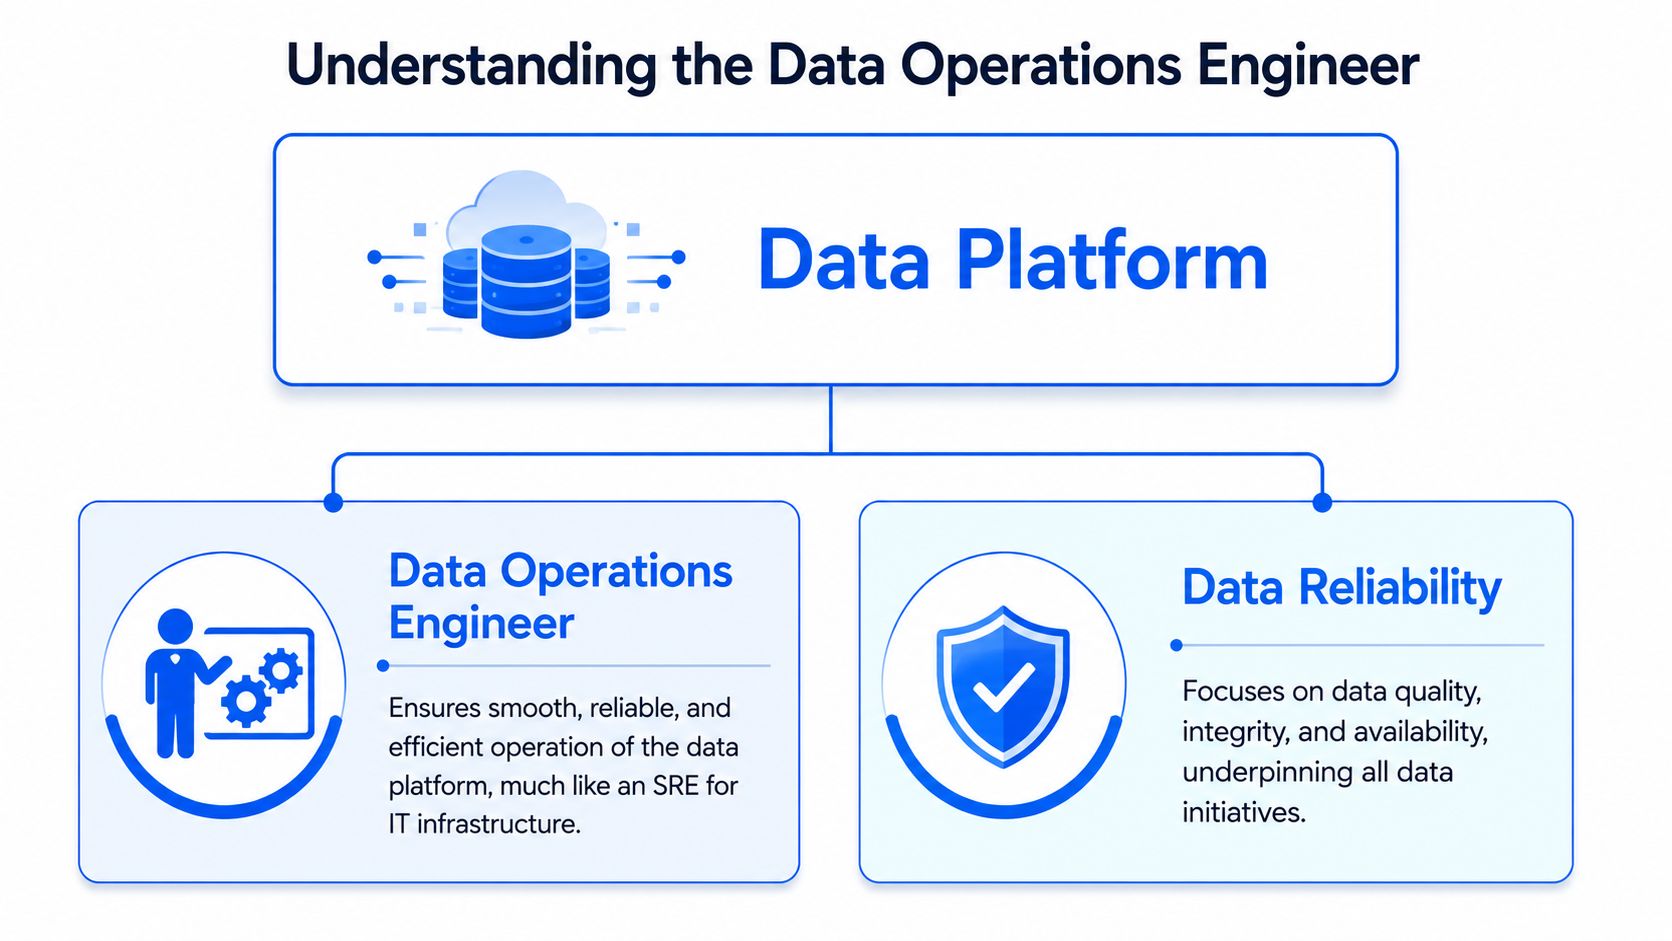
Il Data Operations Engineer è l'ingegnere responsabile dell'affidabilità operativa dei sistemi di dati. L'analogia più chiara è questa: è per la piattaforma dati ciò che un SRE è per uno stack applicativo.
I builder creano nuove pipeline, nuove trasformazioni e nuovi data product. Gli operatori si assicurano che questi asset si comportino in modo prevedibile in produzione: sotto carico, durante lo schema drift, quando le sorgenti sono instabili e sotto la pressione dei consumatori a valle di analytics e ML.
Un'utile introduzione al modello operativo più ampio è questa panoramica su DataOps.
L'analogia con l'SRE funziona davvero
Il paragone con l'SRE non è solo una questione di etichetta. Corrisponde bene al lavoro.
Un SRE applicativo si occupa di uptime, latenza, error budget, sicurezza dei rollback e risposta agli incidenti. Un data operations engineer si occupa di aspetti simili, ma per gli asset di dati:
Ambito | SRE applicativo | Data Operations Engineer |
|---|---|---|
Disponibilità | Servizio raggiungibile | Dataset o pipeline disponibile |
Latenza | Tempo di risposta alle richieste | Freschezza dei dati e tempi di consegna |
Correttezza | Risposte senza errori | Record validi, completi e affidabili |
Sicurezza delle modifiche | Deploy senza disservizi | Rilascio sicuro di modifiche a schemi e pipeline |
Risposta agli incidenti | Ripristinare il servizio | Ripristinare la fiducia nei dati |
La distinzione importante è che l'uptime della pipeline non basta. Un job pianificato alla perfezione può comunque produrre dati errati. Per questo il ruolo si colloca al confine tra observability e qualità.
Dove si colloca il ruolo nella pratica
In genere il ruolo fa da ponte tra tre gruppi:
L'engineering upstream, che costruisce i livelli di ingestion, trasformazione e storage
I consumatori a valle, come analytics engineer, sviluppatori BI e data scientist
I responsabili di governance e piattaforma, che hanno bisogno di operazioni stabili e verificabili
Questa posizione intermedia cambia il modo in cui vengono gestiti gli incidenti. Invece di discutere se il problema appartenga alla piattaforma, agli analytics o al ML, il data operations engineer stabilisce un livello di affidabilità trasversale a tutti.
Regola pratica: se il vostro team sa dire se un job è stato eseguito ma non se ci si può fidare del suo output, avete già bisogno di una responsabilità di data operations.
Data engineering tradizionale e responsabilità operativa a confronto
Un data engineer tradizionale viene spesso valutato sul throughput. Riesce a costruire il connettore, caricare i dati, rilasciare la trasformazione e supportare la roadmap di prodotto?
Un data operations engineer viene valutato sulla stabilità. Riesce a prevenire rotture silenziose, ridurre i falsi allarmi, rendere più sicuri i deploy e accorciare il tempo che va dall'alert alla causa principale verificata?
Sembra una sfumatura. Nella pratica cambia le priorità quotidiane.
Un builder potrebbe chiedersi: “Come aggiungiamo questa nuova sorgente entro venerdì?”. Un operatore si chiede: “Che cosa succede quando questa sorgente cambia tipi, salta un caricamento, duplica i record o esegue un backfill in ritardo?”
Entrambe le mentalità sono necessarie. I problemi iniziano quando ci si aspetta che un solo team faccia entrambe le cose sempre a pieno regime. Sotto la pressione delle consegne, il lavoro operativo è il primo a essere rimandato. Poi la coda degli incidenti si riempie, la fiducia cala e ogni nuova pipeline aggiunge un altro punto di possibile guasto silenzioso.
Un team maturo non lo tratta come lavoro di supporto. Lo tratta come ingegneria di produzione per i dati.
Responsabilità principali e flussi di lavoro quotidiani
Il lavoro quotidiano non è affascinante. È ripetitivo nei punti giusti, investigativo in quelli difficili e disciplinato dall'inizio alla fine.
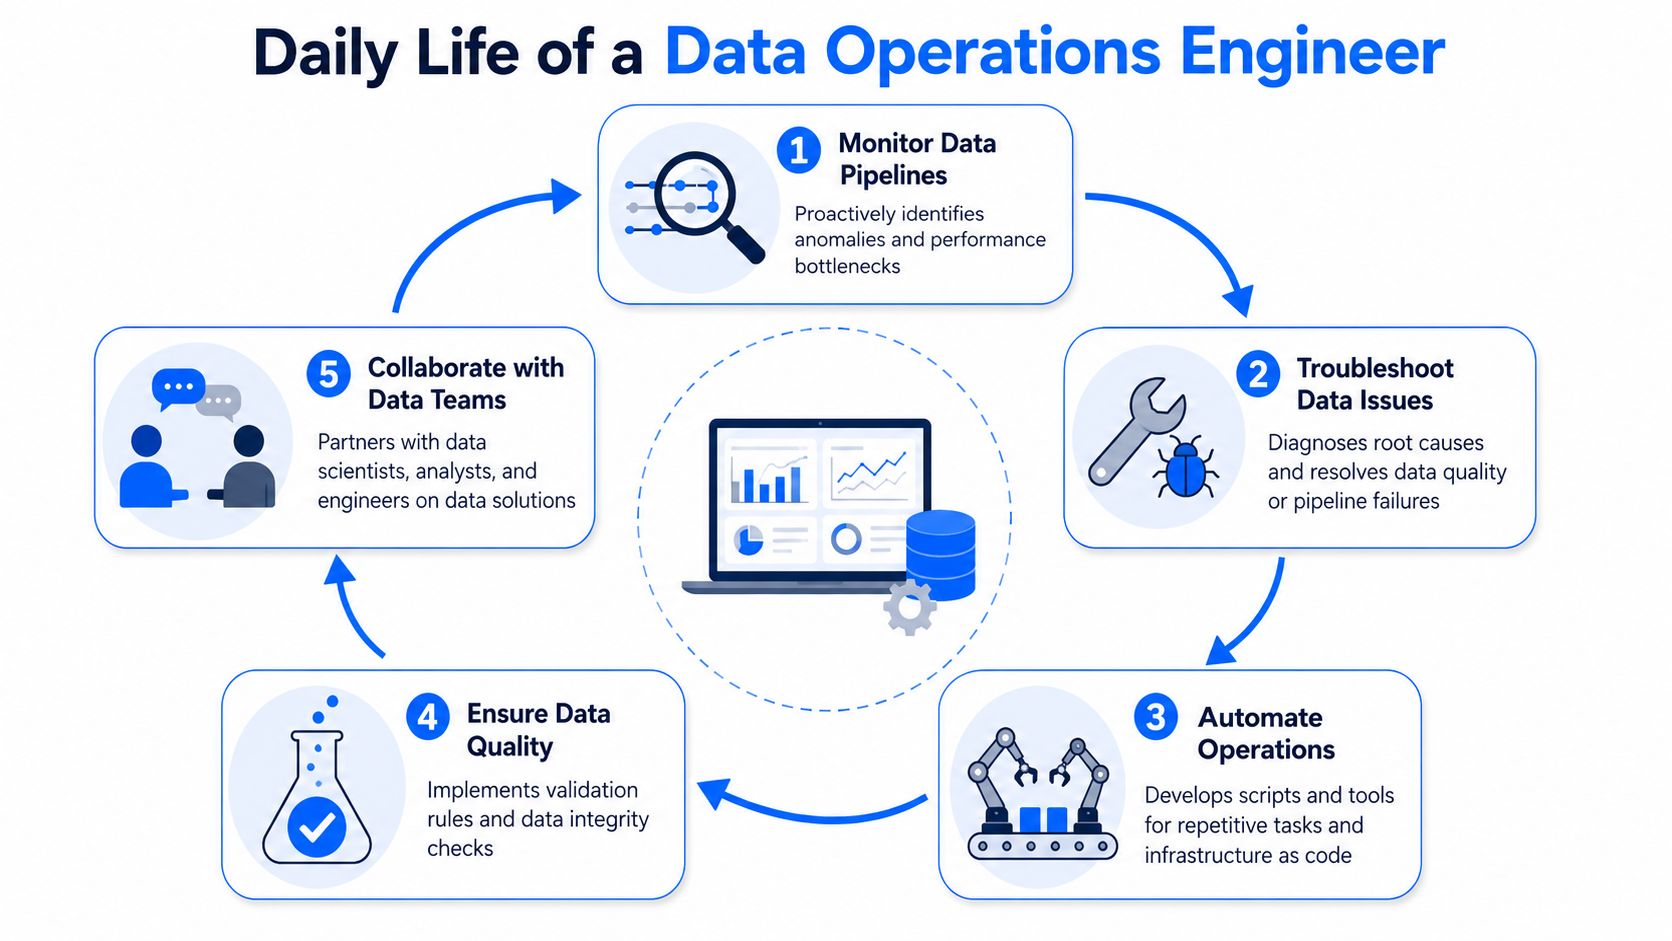
Un buon data operations engineer inizia la giornata analizzando i segnali di salute prima di leggere Slack. Eccezioni di freschezza, caricamenti in ritardo, modifiche agli schemi, variazioni anomale nel numero di righe, validazioni fallite e deploy ad alto rischio contano più delle segnalazioni aneddotiche di bug, perché mostrano che cosa è cambiato per primo.
Partire dagli health check, non dai ticket
Affidarsi eccessivamente agli utenti a valle per individuare i problemi è un errore comune. È l'approccio al contrario. Quando un dirigente o un analista segnala un problema, il raggio d'impatto è già più ampio del dovuto.
Un ritmo operativo migliore è questo:
Prima la revisione della freschezza. Verificare quali dataset critici sono in ritardo, incompleti o privi delle partizioni attese.
Poi la revisione degli schemi. Cercare colonne aggiunte, campi eliminati, attributi rinominati o tipi modificati che possono rompere in modo sottile le trasformazioni.
Infine la revisione del comportamento. Analizzare i segnali di anomalia su numero di righe, tassi di null, variazioni delle distribuzioni e cambiamenti improvvisi nei pattern.
Il confine tra observability e qualità diventa concreto. L'observability dice che una tabella è arrivata in ritardo. La qualità dice che la tabella è arrivata in tempo ma che valori chiave sono malformati. Le operations si occupano di entrambi gli aspetti, perché l'impatto sugli utenti è lo stesso: non ci si può fidare dei dati.
Gestire un incidente significa dimostrare che cosa si è rotto
Quando scatta un alert, i buoni operatori non si buttano subito a modificare il codice. Prima restringono la classe del guasto.
Un percorso di triage di base di solito è questo:
Confermare l'impatto. Quali dataset, dashboard, modelli o processi di business utilizzano l'asset interessato?
Classificare l'incidente. Si tratta di un problema di freschezza, di schema, di un'anomalia nei contenuti o di una violazione di una regola di business?
Localizzare la rottura. Sistema sorgente, connettore di ingestion, livello di trasformazione, orchestrazione, data warehouse o modello semantico a valle?
Contenerla. Bloccare la propagazione, sospendere i job dipendenti o contrassegnare i dati come non affidabili prima che output errati si diffondano.
Ripristinare sulla base delle evidenze. Eseguire backfill, patch, rerun o roll forward solo dopo che il team sa perché si è verificato l'incidente.
Questa disciplina conta perché molti “guasti di pipeline” sono in realtà guasti semantici. Il codice viene eseguito. I dati sono comunque sbagliati.
Il flusso di lavoro che cambia tutto
Il salto più grande nella maturità operativa arriva spostando i controlli a sinistra, nelle fasi di sviluppo e deploy. Nei moderni framework DataOps, integrare la validazione semantica automatizzata e la CI/CD per le pipeline può ridurre gli errori in produzione del 40–60%, intercettando prima problemi come il model drift o le modifiche agli schemi, secondo l'articolo di DASCA sull'evoluzione del ruolo del data engineer.
Questo non avviene grazie a un singolo linter o a una singola suite di test. Nasce da un flusso di lavoro che tratta le modifiche ai dati come rilasci di software in produzione.
Che cosa funziona
Controlli CI consapevoli degli schemi, che fanno fallire le build quando compaiono modifiche incompatibili
Test semantici, che validano il significato di business e non solo tipi e nullabilità
Rollout graduali per i dataset sensibili, invece di rilasci in produzione in un colpo solo
Runbook che definiscono chi interviene, come viene assegnata la severità e quando vengono avvisati i team a valle
Che cosa non funziona
DAG verdi come unico segnale
Controlli manuali a campione negli strumenti di BI
Validazione gestita solo dagli analisti
Documentazione creata dopo un incidente
I team sottovalutano anche quanto tempo si perde con passaggi di consegne operativi carenti. Quando la logica degli alert, le pianificazioni attese, la mappatura dei responsabili e le note sulle dipendenze vivono solo nella memoria collettiva, la risposta agli incidenti rallenta immediatamente. Per i team alle prese con questa parte del processo, questo articolo su come risolvere i problemi dei requisiti di documentazione è utile perché si concentra sul rendere la documentazione operativa duratura anziché decorativa.
Se non riuscite a rispondere in pochi minuti a “che cosa è cambiato, chi ne è responsabile e che cosa ne dipende”, il processo di gestione degli incidenti è già troppo fragile.
Una buona giornata si chiude senza sorprese. Le pipeline girano. Alcuni alert vengono analizzati e archiviati. Una modifica rischiosa a uno schema viene bloccata prima del rilascio. Non succede nulla di eclatante, ed è proprio questo il punto.
Il toolkit del Data Operations Engineer
Lo stack di strumenti di un data operations engineer non è un'unica categoria di prodotto. È un sistema a livelli. Ogni livello affronta una diversa modalità di guasto operativo, e la confusione nasce quando i team si aspettano che un solo strumento le gestisca tutte.
Una mappa pratica dell'ecosistema di strumenti più ampio è disponibile in questa guida agli strumenti per data engineer.
I quattro livelli di strumenti che contano
Si parte dall'infrastruttura e si sale.
Infrastructure as code
Terraform e CloudFormation contano perché ambienti riproducibili riducono le differenze nascoste tra sviluppo, staging e produzione. Se risorse del data warehouse, networking, gestione dei secret e ambienti di esecuzione divergono tra un ambiente e l'altro, il lavoro sull'affidabilità diventa archeologia.
CI e automazione
Jenkins e GitLab CI sono diffusi perché le modifiche ai dati hanno bisogno di gate di promozione. Questo livello esegue unit test, controlli di integrazione, verifiche di compatibilità degli schemi e flussi di deploy. Senza di esso, i team si affidano alla fiducia e al tempismo.
Orchestrazione
Airflow e Dagster coordinano dipendenze, pianificazioni, retry e backfill. Rispondono alla domanda se i job sono stati eseguiti nell'ordine corretto e se i task previsti sono stati completati. Sono fondamentali, ma da soli non costituiscono observability.
Observability e qualità
Questo livello è spesso definito in modo insufficiente. Dovrebbe rispondere a domande come:
I dati sono arrivati quando previsto?
La loro struttura è cambiata?
Il comportamento si è spostato al di fuori di una norma appresa?
I record hanno violato regole di business esplicite?
L'observability vi dice che cosa è cambiato
L'observability riguarda la visibilità sul comportamento dei sistemi e dei dati. Aiuta gli ingegneri a individuare movimenti insoliti prima che siano i consumatori a segnalarne l'impatto.
I metodi variano. Tecniche statistiche come lo Z-Score e l'IQR sono modi comuni per identificare gli outlier nelle distribuzioni, come descritto nella panoramica di Monte Carlo sull'anomaly detection per la data quality. Oltre ai metodi statistici, alcune piattaforme usano baseline apprese per tracciare stagionalità, volatilità e varianza normale nel tempo.
È qui che diventa evidente l'utilità del rilevamento assistito dall'AI. digna è un esempio di piattaforma che utilizza Isolation Forest e autoencoder per apprendere il comportamento normale dei dati, impostare soglie adattive direttamente nel database e segnalare anomalie senza richiedere codice Python né competenze di ML, secondo la spiegazione di digna sulle sue tecniche di anomaly detection basate sull'AI.
Questo conta perché in produzione le soglie manuali smettono rapidamente di funzionare. Le regole statiche sono fragili quando i pattern giornalieri cambiano in base al giorno della settimana, al ciclo di fatturazione, alla regione o al comportamento della sorgente.
La qualità vi dice se i dati sono accettabili
L'observability può dirvi che qualcosa sembra insolito. La qualità stabilisce se i dati sono accettabili per l'uso di business.
Di solito questo richiede una logica di validazione esplicita. Alcuni esempi:
Esigenza | Segnale di observability | Controllo di qualità |
|---|---|---|
Tempestività | La tabella è arrivata più tardi del previsto | Bloccare la generazione del report dipendente |
Stabilità degli schemi | Il tipo di una colonna è cambiato | Far fallire il deploy o mettere i dati in quarantena |
Salute delle distribuzioni | Il tasso di null è aumentato di colpo | Validare i campi obbligatori a livello di record |
Correttezza di business | I valori dei ricavi sembrano strani | Applicare le regole di business rispetto alla logica nota |
È proprio su questa distinzione che i confini del ruolo spesso si confondono. Alcuni team si aspettano che gli operations engineer si limitino a tenere in vita i job. Altri si aspettano che siano responsabili anche della validazione di business. In realtà, i data operations engineer più efficaci non scrivono personalmente ogni regola di business, ma sono responsabili del framework operativo che rende queste regole eseguibili, monitorate e azionabili.
L'observability senza validazione vi dice che qualcosa è cambiato. La validazione senza observability vi dice solo ciò che avevate pensato di controllare.
Il toolkit pratico, quindi, non è una lista della spesa. È un sistema di affidabilità. L'infrastruttura rende prevedibili gli ambienti. La CI rende più sicure le modifiche. L'orchestrazione rende ripetibile l'esecuzione. Observability e qualità rendono affidabili gli output.
Casi d'uso ad alto impatto e valore per il business
Il valore di business di un data operations engineer diventa evidente quando un guasto dei dati ha conseguenze che vanno oltre il semplice disagio. I report diventano input per le decisioni. Le feature table diventano input per i modelli. I log di validazione diventano evidenze di audit.
Proteggere gli input dei modelli in produzione
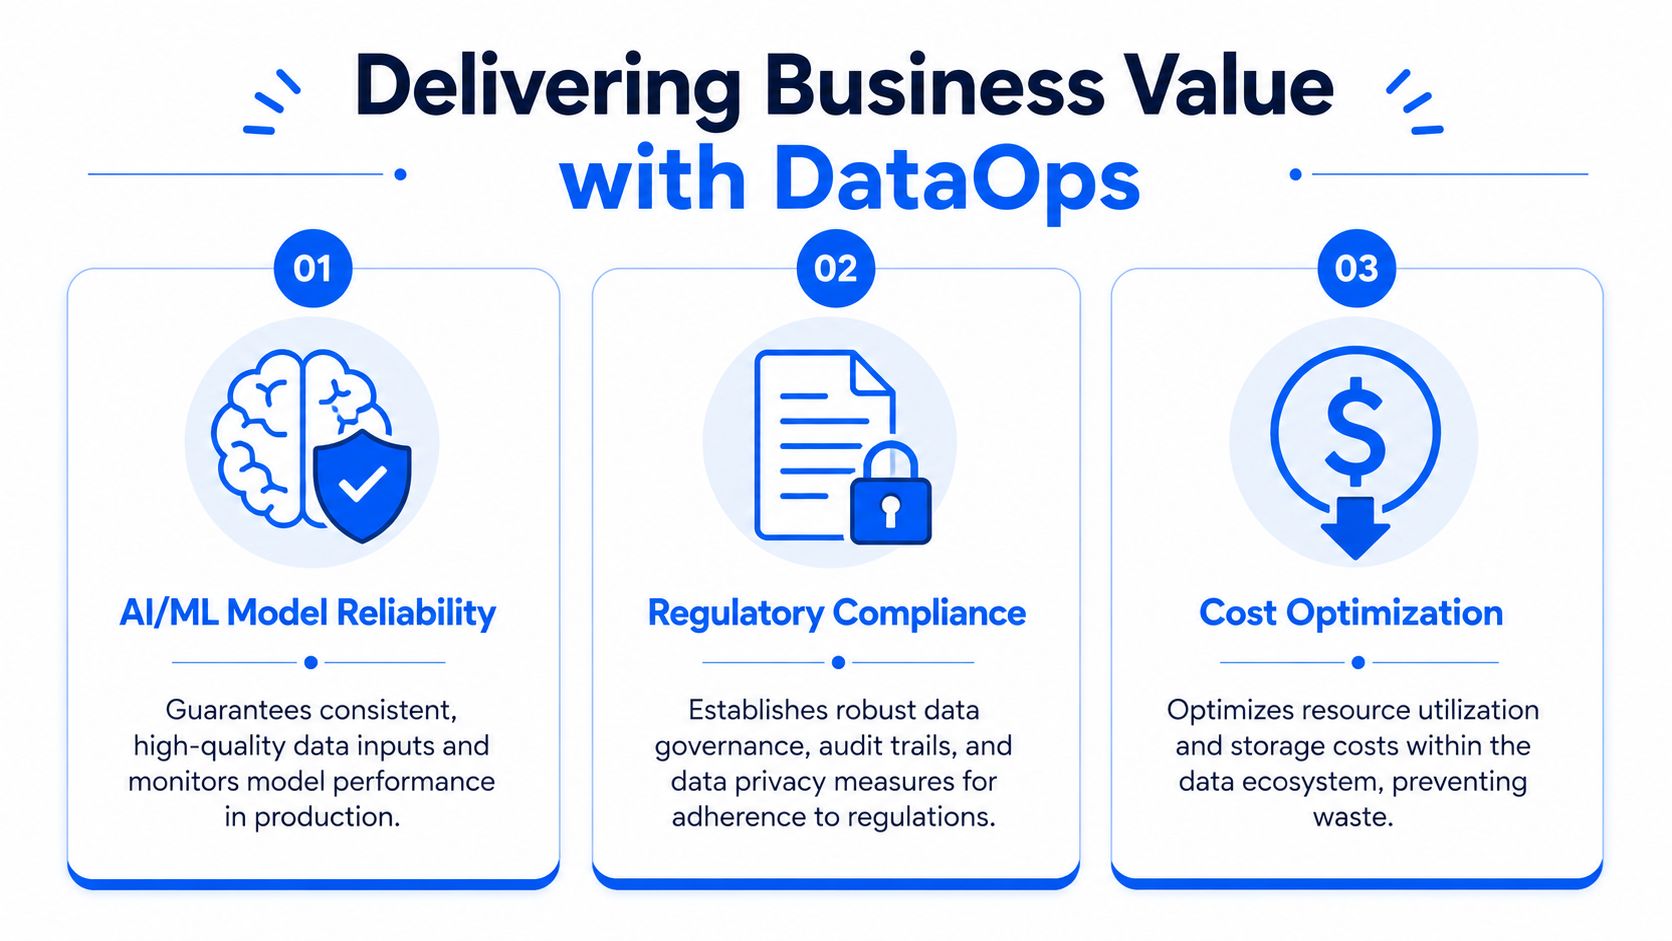
I sistemi di ML raramente si guastano con un crash clamoroso. Si degradano in modo sottile. Un campo categorico cambia valori. Un join upstream inizia a perdere copertura. Una feature arriva puntuale ma riflette un nuovo comportamento della sorgente su cui il modello non è mai stato addestrato.
Questo è lavoro operativo, non solo un'etichetta di MLOps. Il data operations engineer monitora la salute degli input dei modelli, non solo l'esecuzione della pipeline delle feature. Significa tenere d'occhio drift, modifiche agli schemi, picchi di null e interruzioni della freschezza prima che l'output del modello diventi inaffidabile.
Il vantaggio è semplice. I team smettono di trattare gli incidenti dei modelli come misteriosi problemi di algoritmo quando il vero problema sono dati sorgente instabili.
Rendere difendibile il reporting regolamentato
I team di finanza e sanità si preoccupano di una diversa modalità di guasto. Devono dimostrare che i dati erano completi, tempestivi e governati nel momento in cui sono stati utilizzati.
In questi ambienti l'elaborazione in-database è importante. Implementando il calcolo delle metriche in-database, i data operations engineer possono ridurre lo spostamento dei dati del 70–85%, un aspetto importante per i deployment in private cloud o on-premises, e consentire un'analisi della causa principale fino al 50% più rapida per gli incidenti sui dati, secondo la descrizione di Amazon del calcolo delle metriche in-database e del monitoraggio della tempestività.
Questa architettura cambia le operations negli ambienti regolamentati, perché il team può esaminare i segnali di salute senza esportare dati sensibili in un altro sistema controllato da un fornitore. Inoltre accorcia il ciclo di gestione degli incidenti. Se metriche, baseline e controlli di tempestività vengono eseguiti dove i dati risiedono già, gli ingegneri possono indagare più rapidamente, con meno spostamenti di dati e meno attriti di governance.
Ridurre gli sprechi negli ambienti privati
Gran parte degli sprechi di piattaforma deriva da spostamenti nascosti. I dati vengono copiati per il monitoraggio, copiati di nuovo per i test, esportati per controlli secondari e spostati tra strumenti che si sovrappongono.
Un data operations engineer osserva questa proliferazione e pone domande più scomode:
Quali controlli possono essere eseguiti all'interno del data warehouse?
Quali strumenti duplicati di observability e qualità possono essere consolidati?
Quali alert indicano un guasto reale anziché rumore?
Quali pipeline girano perché lo hanno sempre fatto, e non perché qualcuno ne abbia ancora bisogno?
Questo è uno dei motivi per cui il ruolo è diventato strategico negli ambienti private cloud e on-premises. Il valore non è solo l'affidabilità. È la disciplina operativa su dove risiedono i dati, chi li tocca e quanto velocemente un team può diagnosticare i problemi senza ampliare l'esposizione.
Di solito i leader di business notano questo ruolo dopo un incidente. I team maturi lo notano prima, quando si rendono conto che reporting stabile, AI affidabile e costi di piattaforma sotto controllo dipendono tutti dalla stessa cosa: operations affidabili.
Percorso di carriera, stipendio e come assumere per questo ruolo
Il timore legato ai ruoli fortemente operativi è prevedibile. Gli ingegneri temono che, una volta diventati “la persona dell'affidabilità”, resteranno intrappolati nel lavoro di supporto e perderanno la strada verso l'architettura o la leadership.
Non è un timore irrazionale. Alcune aziende sfruttano davvero il talento operativo in questo modo. Ma quando il ruolo è progettato correttamente, offre una visibilità ampia sul sistema che molti ingegneri focalizzati sulle funzionalità non ottengono mai.
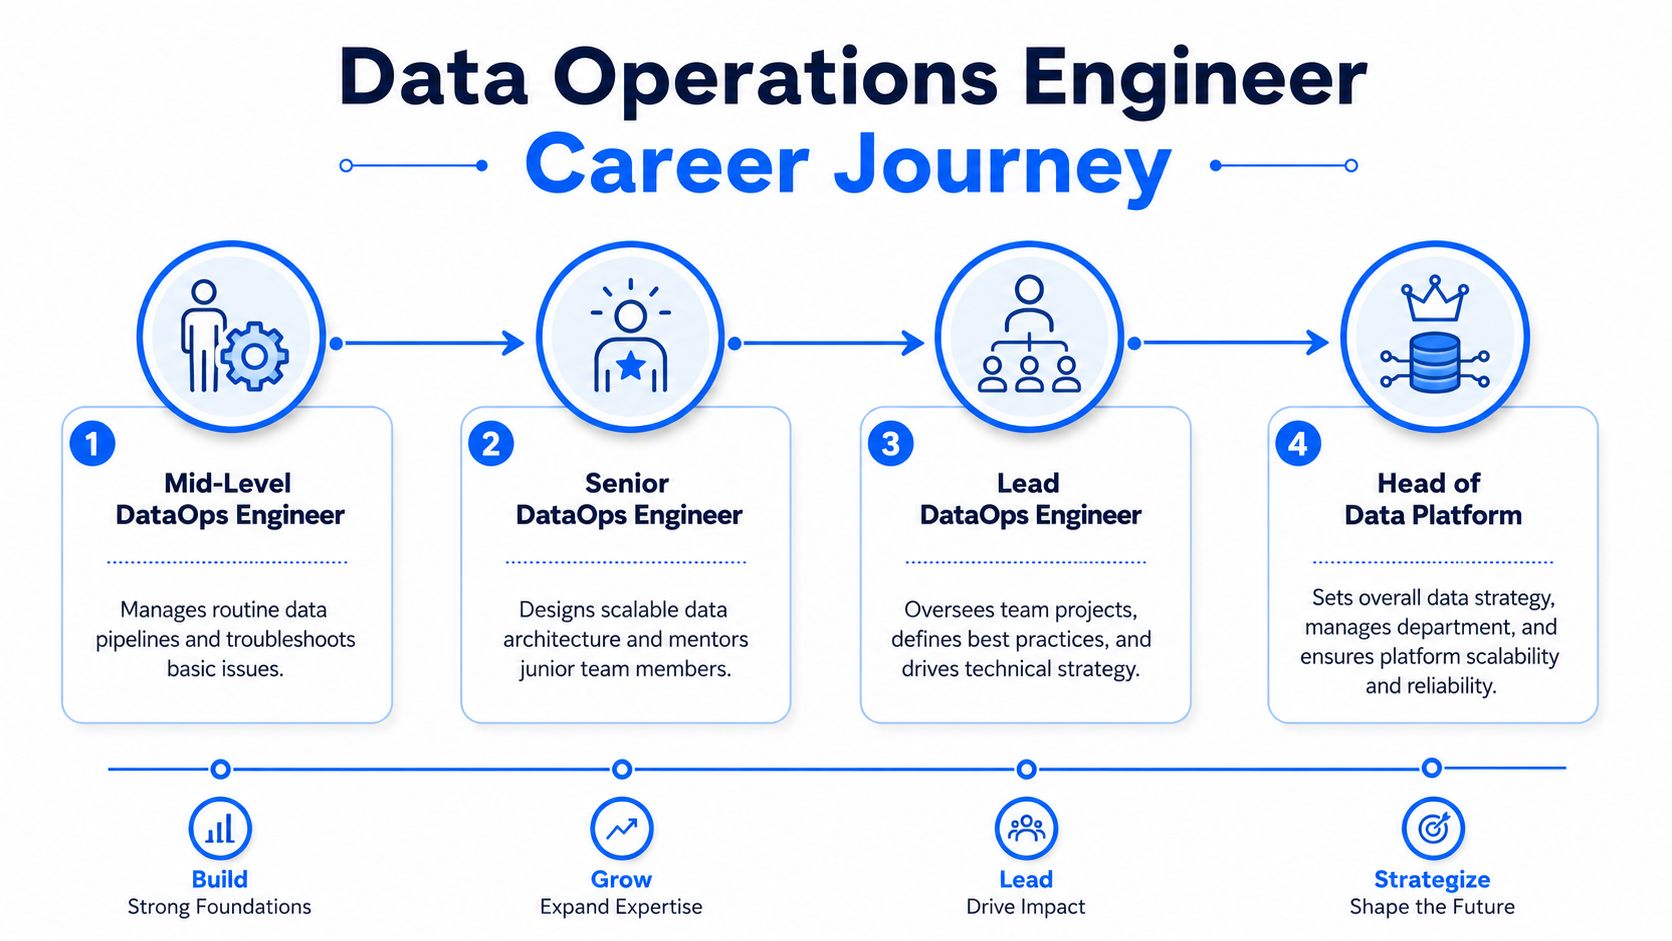
Perché questo ruolo non è un vicolo cieco
Gli operations engineer vedono l'intera piattaforma sotto stress. Imparano la mappatura delle dipendenze, il comando degli incidenti, la progettazione dei servizi, la sicurezza dei rilasci, i vincoli di audit, la negoziazione tra team e i compromessi tecnici tra velocità e controllo. È una formazione alla leadership, anche quando il titolo non dice “manager”.
L'ambiguità del mercato è reale. Su Glassdoor sono elencate 81.590 domande di colloquio per “Data Operations Engineer”, eppure c'è poca chiarezza nel lungo periodo sul fatto che il ruolo porti più facilmente alla leadership di piattaforma o resti un percorso da specialista, come emerge dalla pagina di Glassdoor dedicata ai colloqui per Data Operations Engineer. Questa mancanza di chiarezza sul percorso di carriera è uno dei motivi per cui i candidati esitano.
Il mio punto di vista è pragmatico. Se il ruolo è responsabile dei framework di affidabilità, degli standard di deploy, del processo di gestione degli incidenti e della fiducia nei dati tra i team, non è un percorso secondario. È un percorso verso responsabilità di staff, lead e head of platform. Se il ruolo si limita alla gestione degli alert fuori orario, si fermerà.
Retribuzione e realtà del mercato
Il mercato delle retribuzioni racconta una storia chiara sulla domanda. Nel 2026 i data operations engineer senior negli Stati Uniti possono guadagnare fino a 179.024 $, a riprova della domanda di ingegneri in grado di gestire complessità, observability e CI/CD per i dati, secondo la guida agli stipendi nel data engineering di Motion Recruitment.
Questo premio esiste perché le aziende hanno bisogno, adesso, di persone in grado di stabilizzare piattaforme in crescita. Assumono meno per il lavoro ETL di base punto-punto e più per ingegneri capaci di gestire ambienti ibridi, governare il rischio e supportare le dipendenze dai dati dell'era dell'AI.
Che cosa cercare in fase di assunzione e come fare l'onboarding
Gli hiring manager commettono spesso lo stesso errore. Valutano la familiarità con gli strumenti anziché il giudizio operativo.
Cercate nel curriculum le evidenze di queste abitudini:
Responsabilità degli incidenti: il candidato descrive come ha diagnosticato, contenuto e prevenuto guasti ripetuti.
Disciplina nei test: ha implementato controlli CI, livelli di validazione o controlli di rilascio per gli asset di dati.
Pensiero sistemico: comprende le dipendenze tra sistemi sorgente, modelli del data warehouse, dashboard e consumatori ML.
Comunicazione sotto pressione: sa spiegare con chiarezza l'impatto sul business e le scelte di ripristino.
Alcune domande di colloquio distinguono rapidamente i builder dagli operatori:
Una dashboard critica è sbagliata, ma tutti i task dell'orchestratore sono verdi. Che cosa controllate per prima cosa?
Una modifica a uno schema è tecnicamente retrocompatibile, ma gli analisti dicono che le loro metriche sono cambiate. Come indagate?
Quando un dataset errato dovrebbe essere messo in quarantena invece di essere lasciato passare con un avviso?
Che cosa deve contenere un runbook per gli incidenti sui dati?
Per i candidati che cercano team orientati all'affidabilità, i portali di annunci non bastano. Io guarderei anche alle aziende che stanno costruendo operations interne fortemente basate sull'AI, comprese opportunità come Join our AI employee team, perché questi ambienti spesso apprezzano gli ingegneri capaci di mantenere affidabili sistemi di dati complessi.
Un modello di onboarding utile è un semplice piano a 30-60-90 giorni.
Periodo | Focus | Risultato atteso |
|---|---|---|
Primi 30 giorni | Conoscere dataset critici, responsabili e storico degli incidenti | Sa identificare gli asset ad alto rischio e i pattern di guasto più comuni |
Primi 60 giorni | Aggiungere health check, gate di validazione e aggiornamenti dei runbook | Migliora il rilevamento e la chiarezza della risposta |
Primi 90 giorni | Standardizzare i controlli di rilascio e la gestione della severità | Stabilisce un modello operativo ripetibile |
Questo piano funziona sia per i nuovi assunti sia per i team che creano la funzione per la prima volta.
Come costruire la vostra funzione di data operations
Iniziate in piccolo, ma iniziate dalla responsabilità.
La maggior parte delle organizzazioni non ha bisogno di un grande team dedicato fin dal primo giorno. Ha bisogno di un ingegnere o di un piccolo pod con una responsabilità esplicita per l'affidabilità dei dati sugli asset critici. La chiave è che questa responsabilità sia reale. Non “aiutare quando c'è tempo”, e nemmeno “la qualità è responsabilità di tutti”, che di solito significa di nessuno.
Un runbook pratico a 30-60-90 giorni
Primi 30 giorni
Mappate i sistemi più importanti. Elencate dataset critici, dashboard, modelli, dipendenze dalle sorgenti, aspettative di aggiornamento e responsabili. Individuate dove oggi vengono scoperti gli incidenti e dove si interrompono i passaggi di consegne.
Primi 60 giorni
Definite un modello operativo di base. Stabilite le priorità per freschezza, monitoraggio degli schemi, anomaly detection e validazione a livello di record. Create livelli di severità degli incidenti e runbook snelli, in modo che chi interviene non debba improvvisare sotto pressione.
Primi 90 giorni
Avvicinate i controlli al deploy e rendete ripetibile il ripristino. Aggiungete gate CI per le modifiche ad alto rischio, standardizzate l'instradamento degli alert e create un ciclo di revisione per gli alert rumorosi e gli incidenti ricorrenti. A questo punto la funzione dovrebbe ridurre l'incertezza, non limitarsi a generare più notifiche.
Costruite la funzione attorno ai data product che possono danneggiare il business più rapidamente quando si guastano. Non partite da una copertura ampia. Partite dalle conseguenze.
Il cambio strategico è semplice. Smettete di trattare l'affidabilità come lavoro residuo per gli stessi ingegneri che già corrono per rilasciare nuove pipeline. Una funzione di data operations dedicata trasforma sistemi fragili in sistemi di produzione. È la differenza tra sperare che i vostri dati siano a posto e sapere quando non lo sono.
Se il vostro team ha bisogno di un modo per monitorare tempestività, modifiche agli schemi, anomalie e validazione a livello di record all'interno del vostro ambiente, vale la pena valutare digna come parte di uno stack di data operations concreto.
Per una visione a livello di piattaforma dei segnali di freschezza, schema e comportamento che un data operations engineer esamina ogni mattina, scoprite come la data platform observability con digna li monitora all'interno del vostro ambiente.
Domande frequenti
Che cosa fa un data operations engineer?
Un data operations engineer è responsabile dell'affidabilità operativa dei sistemi di dati e svolge per la piattaforma dati un ruolo simile a quello di un SRE per uno stack applicativo. Il ruolo va oltre il mantenere in esecuzione i job: garantisce che i dati arrivino in tempo, restino strutturalmente corretti e siano adatti a dashboard, report e modelli di ML a valle.
In che cosa un data operations engineer si differenzia da un data engineer?
La differenza sta nel modo in cui ciascun ruolo viene valutato. I data engineer tradizionali sono giudicati sul throughput: costruire connettori, caricare dati e rilasciare trasformazioni. I data operations engineer sono valutati sulla stabilità, cioè sulla capacità di prevenire rotture silenziose, ridurre i falsi allarmi, rendere più sicuri i deploy e accorciare il tempo dall'alert alla causa principale verificata.
Che cosa controlla per prima cosa ogni giorno un data operations engineer?
I segnali di salute vengono prima dei messaggi Slack o dei ticket. L'articolo raccomanda un ordine preciso: prima la revisione della freschezza per i dataset in ritardo o incompleti, poi la revisione degli schemi per colonne aggiunte, eliminate o con tipo modificato, infine la revisione del comportamento per le anomalie nel numero di righe, nei tassi di null e nelle distribuzioni.
Quanto guadagna un data operations engineer?
Nel 2026 i data operations engineer senior negli Stati Uniti possono guadagnare fino a 179.024 $, secondo la guida agli stipendi di Motion Recruitment citata nell'articolo. Questo premio riflette la domanda di ingegneri capaci di gestire ambienti ibridi complessi, observability e CI/CD per i dati, piuttosto che il lavoro ETL di base punto-punto.
Come si crea da zero una funzione di data operations?
Si parte da un ingegnere o da un piccolo pod con una responsabilità esplicita e si segue un piano a 30-60-90 giorni. Nei primi 30 giorni si mappano dataset critici, responsabili e dipendenze. Entro il giorno 60 si definiscono le priorità per freschezza, schemi, anomalie e validazione, oltre ai livelli di severità. Entro il giorno 90 si aggiungono gate CI e si standardizza l'instradamento degli alert.


