Cos'è una pipeline di dati e perché è importante
|
5
min di lettura

Una pipeline di dati è un sistema end-to-end che automatizza l'acquisizione, la trasformazione, la validazione e il caricamento dei dati, in modo che possano essere usati in modo affidabile per analytics, AI e decisioni operative. Nella produzione moderna, questo di solito significa che una pipeline deve trasferire i dati verso livelli di storage o di consumo senza perderne freschezza, struttura e affidabilità.
Probabilmente avete visto accadere il contrario. Una dashboard diventa verde, un team presume che i numeri siano sicuri e poi qualcuno scopre che il feed sottostante era obsoleto da ore perché un sistema a monte era cambiato senza preavviso.
Indice
Cosa fa davvero una pipeline di dati in produzione
Perché la definizione da manuale non basta
I quattro componenti fondamentali di ogni pipeline
Acquisizione e trasformazione
Storage e consumo
Scegliere tra architetture ETL, ELT e streaming
Dove si adatta ciascun pattern
Come fare la scelta
Modalità di guasto silenziose che rompono le pipeline
Drift dello schema e arrivi in ritardo
Regressioni della qualità e monitoraggio cieco
Il costo per il business di pipeline inaffidabili
Come si propaga il danno
Perché è un rischio di business, non un fastidio tecnico
Come capire se la vostra pipeline è pronta per la produzione
Una verifica pratica di prontezza
Domande a cui ogni revisione dovrebbe rispondere
Costruire pipeline di cui potersi fidare
Cosa fa davvero una pipeline di dati in produzione
Una dashboard dei ricavi può sembrare perfettamente sana mentre i dati che la alimentano sono già abbastanza vecchi da trarre in inganno il business. L'API di una fonte cambia il formato della risposta, un job pianificato si completa comunque e il livello di reporting continua a visualizzare i dati, così nessuno si accorge che i numeri sono vecchi di 18 ore finché qualcuno non li confronta con il sistema transazionale.
Ecco perché una pipeline di dati è più di riquadri e frecce. È la spina dorsale operativa che automatizza acquisizione, trasformazione, validazione e caricamento dei dati dai sistemi sorgente ai livelli di storage o di consumo, in modo che analisti, modelli e utenti di business possano fidarsi di ciò che vedono. Le ricostruzioni storiche mostrano che il settore è passato dagli script batch manuali degli anni '70 e '80 a sistemi ETL più strutturati intorno al 1992, e poi ad architetture ELT cloud-native, streaming e in tempo reale negli anni 2010 e 2020 (BytePlus).
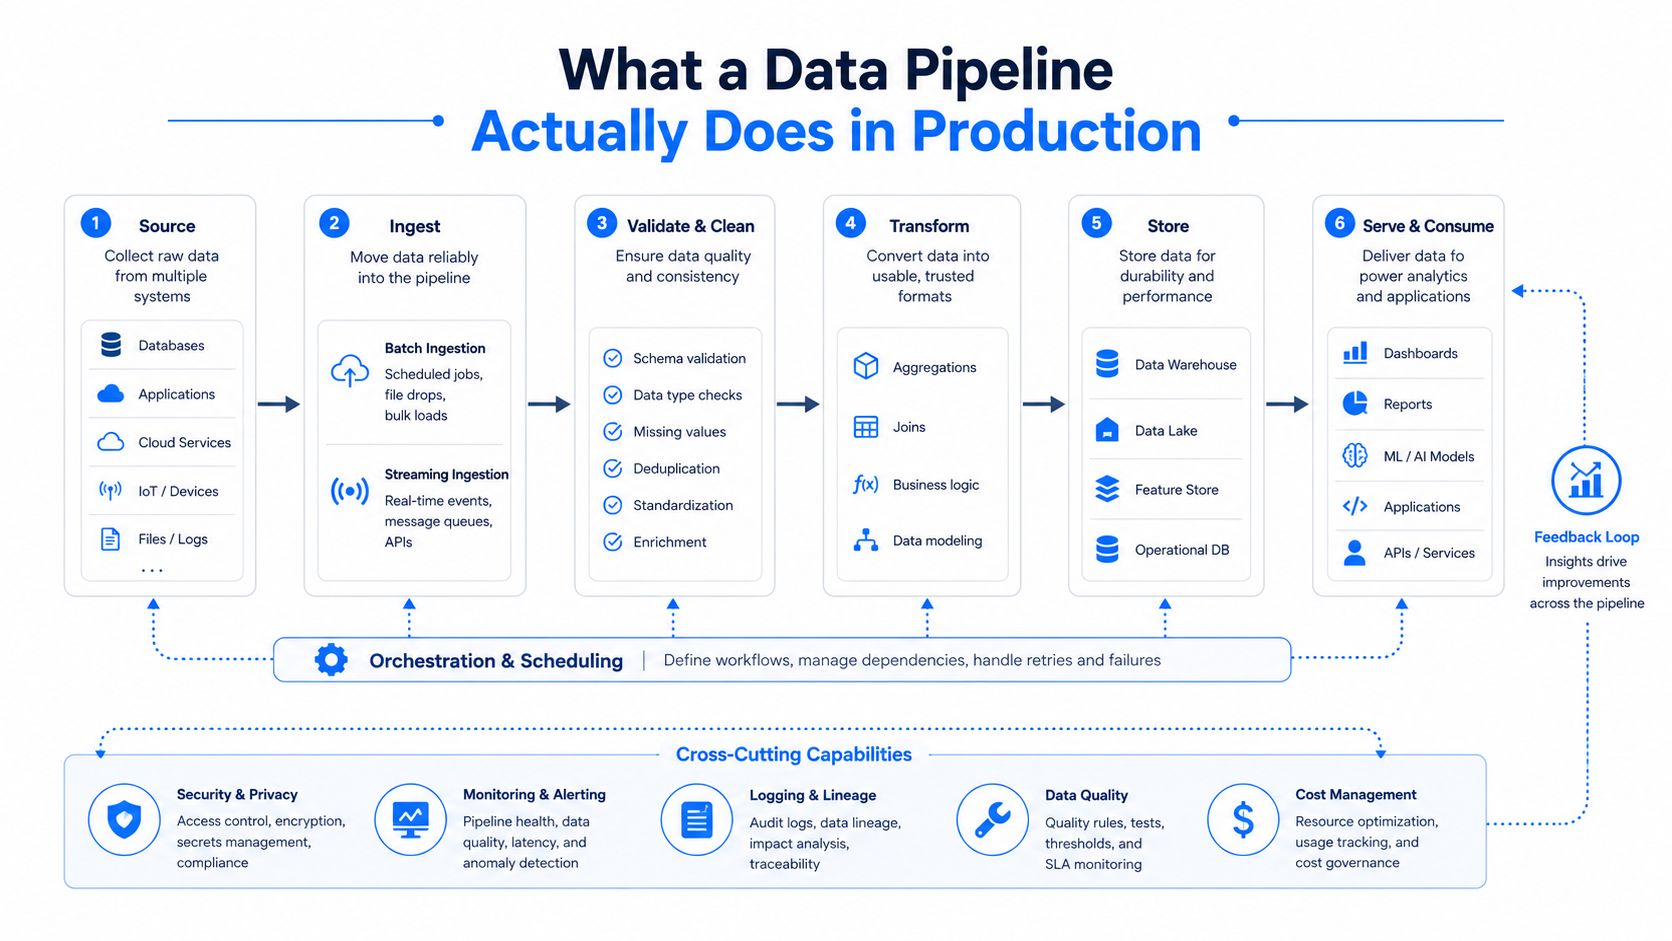
Perché la definizione da manuale non basta
La definizione semplice sembra ordinata, ma i sistemi di produzione raramente lo sono. Le API a monte cambiano senza preavviso, i database evolvono, i file arrivano in ritardo e i team a valle si aspettano comunque dati aggiornati con una cadenza prevedibile. La pipeline deve assorbire questi cambiamenti senza trasformare ogni piccola variazione in una dashboard rotta o in un thread Slack pieno di proteste.
Regola pratica: se una pipeline funziona solo quando non cambia nulla, non è pronta per la produzione: è solo fortunata.
È per questo che i team moderni considerano osservabilità, logica di retry, gestione delle dipendenze e tolleranza ai guasti come parte integrante della pipeline, non come aggiunte. Una pipeline di produzione deve proteggere il business dai guasti invisibili, non limitarsi a spostare byte da un sistema all'altro.
I quattro componenti fondamentali di ogni pipeline
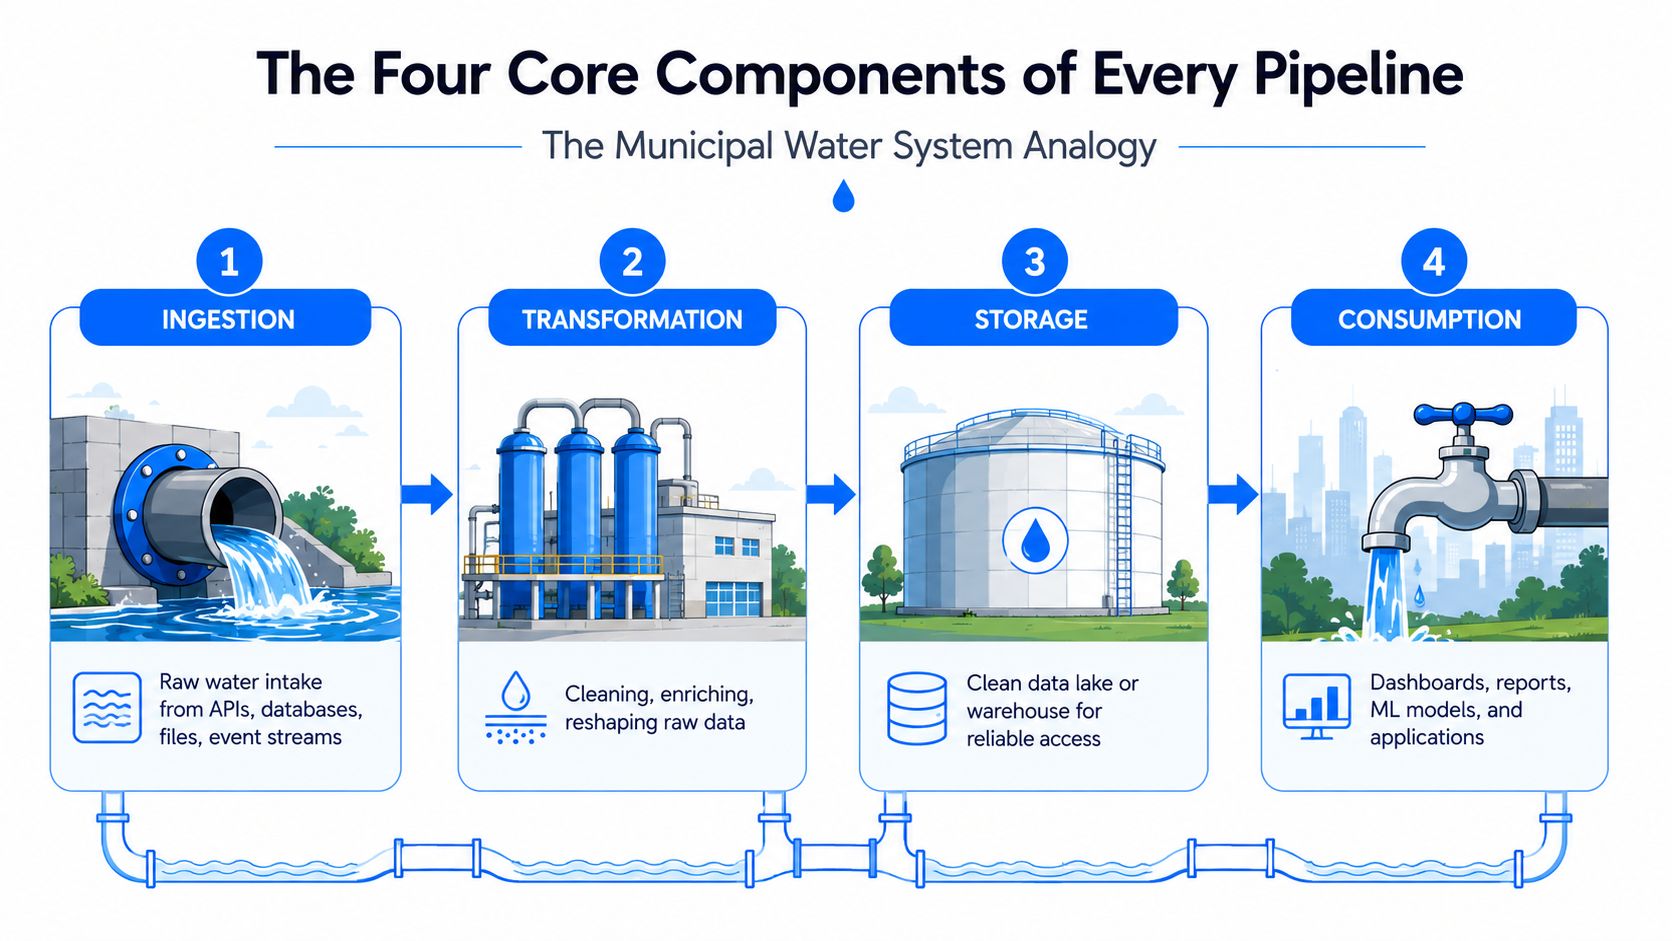
Un modo utile per comprendere la progettazione di una pipeline è paragonarla a un acquedotto comunale. L'acqua grezza entra, viene depurata, immagazzinata e poi distribuita alle abitazioni. Una pipeline di dati segue lo stesso schema di base, solo con API, database, file, flussi di eventi, data warehouse e dashboard al posto di tubi e serbatoi.
Acquisizione e trasformazione
L'acquisizione è la presa dell'acqua grezza. I team prelevano dati da API, database SQL, applicazioni SaaS, file e flussi di eventi, spesso tramite strumenti come connettori CDC, listener di webhook o depositi di file pianificati. Questa fase è la prima a rompersi quando scattano i limiti di frequenza, la paginazione viene gestita male o un sistema a monte inizia a restituire campi con una struttura diversa.
La trasformazione è l'impianto di depurazione. Gli ingegneri puliscono i record, standardizzano i formati, arricchiscono gli eventi e aggregano i fatti in output pronti per il business. Il compromesso è semplice ma implacabile: più trasformazione può migliorare la qualità, ma consuma anche risorse di calcolo e crea più punti in cui la logica può disallinearsi dalla fonte.
Storage e consumo
Lo storage è il serbatoio. Può essere un data warehouse, un data lake o un lakehouse, e la scelta dipende di solito da come i team vogliono organizzare formati, partizioni e riutilizzo a valle. Se lo storage è modellato male, i team finiscono per pagare scansioni ripetute, query lente e rielaborazioni scomode.
Il consumo è il rubinetto alla fine della linea. Strumenti di BI, modelli di ML e applicazioni operative dipendono tutti da questa fase, e ciascuno ha aspettative di freschezza diverse. Una dashboard che si aggiorna ogni notte può tollerare un ritardo, ma un'applicazione rivolta ai clienti o un workflow antifrode no.
Per una visione architetturale più dettagliata, la guida di digna all'architettura delle pipeline di dati è utile se volete mappare queste fasi su un modello operativo più ampio.
La fase che in un diagramma sembra la più semplice è di solito quella in cui iniziano i problemi in produzione, perché le decisioni su storage e consumo determinano se il resto della pipeline resta utile.
Scegliere tra architetture ETL, ELT e streaming
ETL, ELT e streaming non sono parole d'ordine in competizione. Sono risposte diverse alla stessa domanda: quanto velocemente devono muoversi i dati e quanto controllo vi serve prima che qualcuno li veda?
Dove si adatta ciascun pattern
L'ETL trasforma i dati prima di caricarli. Funziona bene negli ambienti governati in cui il team vuole controlli di qualità rigorosi prima che i dati arrivino nel sistema di destinazione, e dove le risorse di calcolo del warehouse sono limitate o costose.
L'ELT carica prima i dati grezzi e li trasforma all'interno del warehouse. Si adatta meglio agli stack cloud-native, perché storage e calcolo sono più facili da scalare in modo indipendente e gli stessi dati grezzi possono essere riutilizzati per più modelli o livelli di reporting.
Lo streaming elabora gli eventi in modo continuo man mano che arrivano. È la scelta giusta per sistemi basati su eventi, rilevamento delle frodi in tempo reale e personalizzazione, dove le informazioni obsolete sono un problema di business, non un piccolo inconveniente.
Fattore | ETL | ELT | Streaming |
|---|---|---|---|
Momento della trasformazione | Prima del caricamento | Dopo il caricamento | In modo continuo, all'arrivo degli eventi |
Contesto ideale | Ambienti governati, prevalentemente batch | Stack di analytics cloud-native | Casi d'uso operativi a bassa latenza |
Complessità operativa | Moderata | Moderata | Elevata |
Profilo di freschezza | Pianificato | Più rapido del batch classico, ma comunque pianificato | Quasi in tempo reale |
Approccio alla governance | Forte controllo prima del caricamento | Forte controllo lato warehouse | Richiede monitoraggio accurato e disciplina sugli eventi |
Come fare la scelta
Usate l'ETL quando i controlli di qualità contano più della flessibilità. Usate l'ELT quando il business vuole riutilizzo, scalabilità e iterazioni più rapide all'interno del warehouse. Usate lo streaming quando la latenza incide su ricavi, rischio o esperienza del cliente.
Se volete un confronto pratico dal punto di vista dell'implementazione, la panoramica di digna sulle pipeline di dati ETL è un buon punto di riferimento per il lato ETL della decisione.
Regola decisionale: ottimizzate per la freschezza più lenta che sia accettabile, non per la tecnologia più veloce possibile.
Sembra ovvio, finché i team non scelgono lo streaming per tutto e poi passano mesi a pagare una complessità di cui non avevano bisogno. L'architettura migliore è quella adatta a latenza, maturità della governance, vincoli di costo e capacità del team di gestirla.
Modalità di guasto silenziose che rompono le pipeline
I guasti più pericolosi di una pipeline non generano un errore rosso acceso. Lasciano terminare il job, mantengono viva la dashboard e distorcono i numeri di cui i dirigenti si fidano.
Drift dello schema e arrivi in ritardo
Il drift dello schema si verifica quando una fonte a monte aggiunge, rimuove o rinomina campi senza avvisare il team dati. Una fonte comune lo definisce come una modifica strutturale non annunciata rispetto allo schema su cui è stata costruita la pipeline, e un'altra osserva che è una delle cause di guasto più frequenti quando i database applicativi cambiano senza avvisare il team dati (DataThere). Il risultato possono essere valori null dove dovrebbero esserci valori, o aggregazioni che escludono campi di cui nessuno si era accorto che fossero spariti.
I dati che arrivano in ritardo creano un tipo diverso di problema. Una finestra batch si chiude prima che arrivino tutti i record, così la metrica giornaliera sembra completa anche se sottostima l'attività reale. Uno studio sull'elaborazione batch descrive questo fenomeno come dati che arrivano dopo la chiusura della finestra temporale prevista, ma comunque entro un periodo di tolleranza predefinito (IJSAT).
Un processore di pagamenti che cambia il formato dei timestamp o un export del CRM che perde i campi personalizzati possono rompere la logica a valle senza rompere il job stesso. Il report continua a essere visualizzato, ed è proprio per questo che le persone se ne fidano troppo presto.
Regressioni della qualità e monitoraggio cieco
Le regressioni della qualità sono più lente e più difficili da individuare. Si insinuano record duplicati, le incoerenze di formato si diffondono e la validazione di base continua a passare perché i dati sono tecnicamente presenti, solo meno affidabili di prima. Il monitoraggio tradizionale a livello di job non se ne accorge affatto, perché si chiede solo se la pipeline è stata eseguita, non se l'output ha ancora senso.
Per i team che cercano di ragionare oltre la sola freschezza, la nota di IamVera.AI su freschezza dei dati e risposte dell'AI ricorda utilmente che gli input obsoleti non influiscono solo sui report, ma anche sui ragionamenti a valle.
La risposta in produzione è monitorare insieme struttura, tempistiche e comportamento dell'output. È la differenza tra sapere che un job è stato completato e sapere che il business può fidarsi di ciò che ha prodotto.
Per un approfondimento sui pattern degli incidenti, la guida di digna sul perché le pipeline di dati falliscono in produzione collega queste modalità di guasto a punti di rilevamento concreti.
Il costo per il business di pipeline inaffidabili
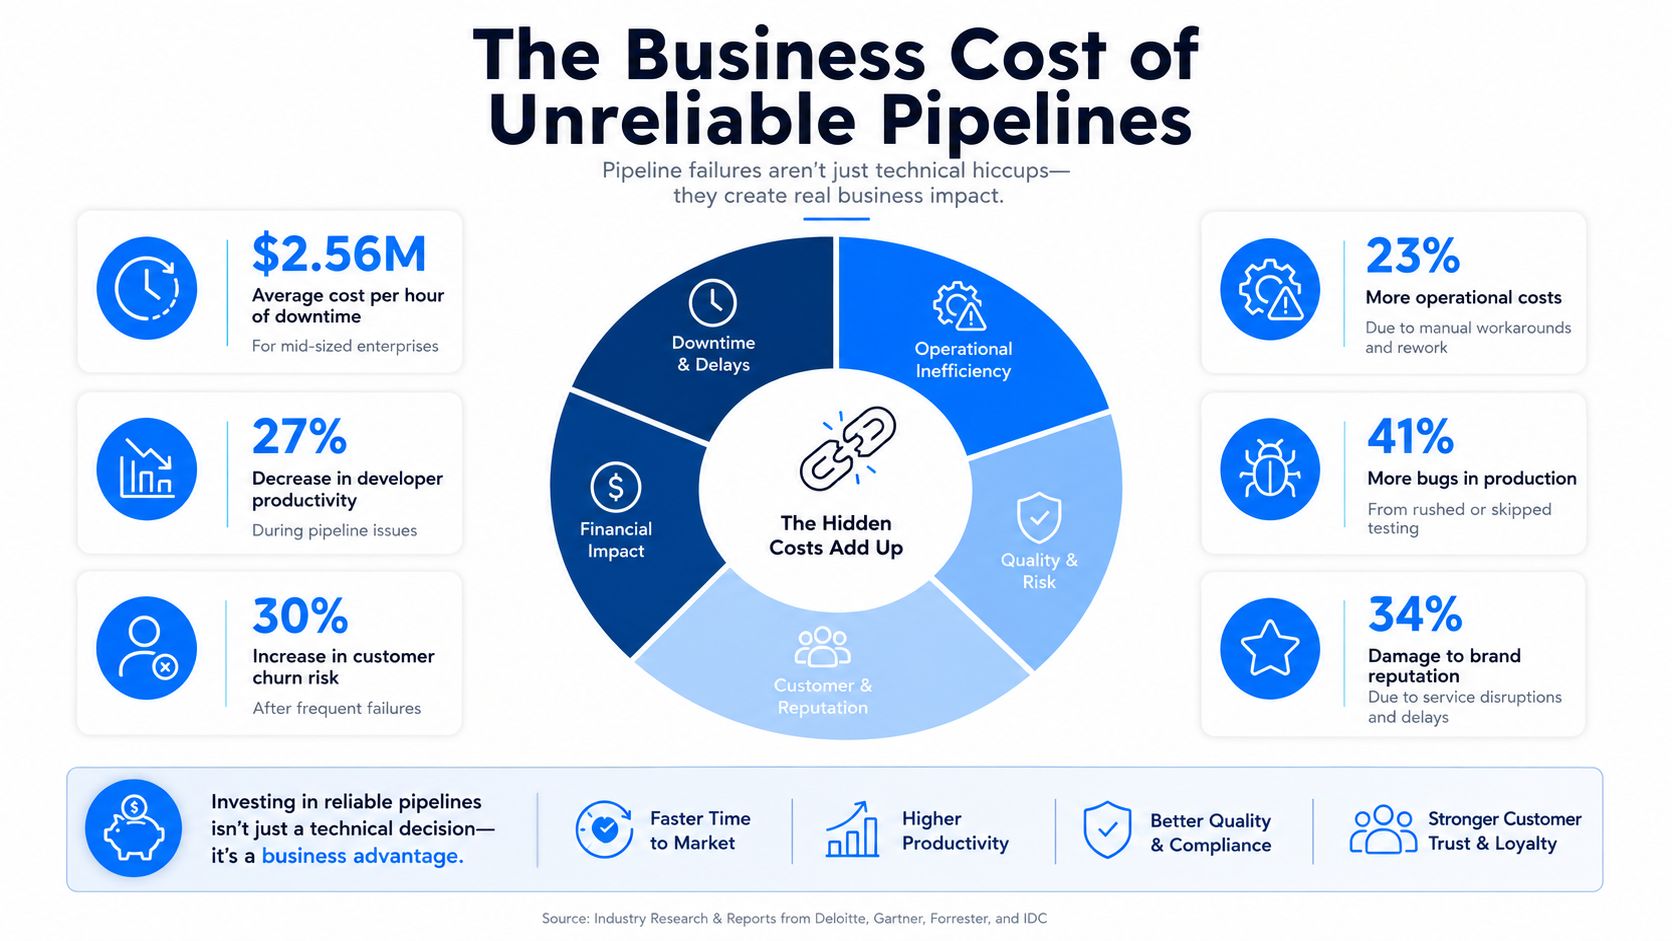
Le pipeline inaffidabili non restano confinate all'ingegneria. Si manifestano nelle decisioni sulle campagne, nelle previsioni, nei prodotti rivolti ai clienti e nel comportamento dei modelli.
Come si propaga il danno
Un livello di acquisizione rotto porta a dashboard obsolete. I team di marketing ottimizzano allora su dati di conversione superati, i team finanziari costruiscono previsioni su output incompleti e gli analisti passano il tempo a riconciliare numeri invece di rispondere alle domande. Se le applicazioni rivolte ai clienti leggono dalla stessa pipeline inaffidabile, il danno alla reputazione è immediato.
Anche i sistemi di AI e ML risentono del problema. Quando le pipeline di addestramento o delle feature si degradano, il modello non sempre fallisce in modo evidente: può subire un drift e continuare a produrre previsioni o raccomandazioni più deboli mentre tutti presumono che funzioni.
Perché è un rischio di business, non un fastidio tecnico
IBM riporta che uno studio IBV del 2025 ha rilevato che il 43% dei chief operations officer indicava i problemi di qualità dei dati come la propria priorità principale in materia di dati, e che più di un quarto delle organizzazioni stimava perdite annue superiori a 5 milioni di USD, con un 7% che perdeva 25 milioni di USD o più (IBM). Ciò corrisponde a quanto molti team già percepiscono nella pratica: i dati scadenti non sono una preoccupazione astratta di governance, sono un costo operativo.
Anche lo schema dei costi di remediation è impietoso. Uno studio citato sul ROI dei dati di qualità colloca la prevenzione a circa 1 dollaro per record, l'individuazione e la correzione dei dati scadenti dopo la loro comparsa a circa 10 dollari per record e la correzione di un errore dopo un evento a circa 100 dollari per record (LightsonData). Più a lungo sopravvive il problema, più diventa costoso.
Se volete un modo semplice per inquadrare il problema per il management, il calcolatore di digna del costo del data downtime aiuta a collegare i disservizi delle pipeline all'impatto sul business senza trasformare la discussione in congetture.
Una pipeline che sembra a posto mentre produce la risposta sbagliata costa più di una pipeline che fallisce subito, perché la falsa fiducia si moltiplica.
Come capire se la vostra pipeline è pronta per la produzione
Una pipeline è pronta per la produzione quando il team sa spiegare come si comporta in presenza di modifiche, ritardi e guasti parziali. “Ha superato lo staging” non basta, perché lo staging raramente presenta fonti dal comportamento disordinato, record in ritardo o consumatori che dipendono da output aggiornati a un orario fisso.
Una verifica pratica di prontezza
Osservabilità: ogni fase dovrebbe emettere log strutturati, il lineage dovrebbe essere tracciabile e gli alert dovrebbero scattare in base alle soglie di freschezza, non solo al completamento dei job. Se la pipeline è in ritardo ma verde, il modello di alerting è troppo superficiale.
Validazione: produttori e consumatori hanno bisogno di contratti di schema, asserzioni di qualità a livello di riga e rilevamento delle anomalie su conteggi o distribuzioni dei valori. Questo vi dà la possibilità di intercettare output errati prima che raggiungano dashboard o feature.
Freschezza e replay: definite uno SLA di freschezza reale per ogni caso d'uso a valle, poi verificate se la pipeline è in grado di rieseguire i dati storici senza duplicare i record. Se non riesce a riprendersi dopo un disservizio della fonte, non è abbastanza resiliente per la produzione.
Un utile riferimento interno per questo tipo di valutazione è la guida di digna alla misurazione dell'affidabilità, soprattutto se il vostro team deve trasformare l'affidabilità in qualcosa di misurabile anziché aneddotico.
Domande a cui ogni revisione dovrebbe rispondere
Vediamo lo stato di salute dei dati, non solo lo stato dei job? Se no, l'osservabilità è incompleta.
Sappiamo cosa è cambiato quando la fonte è cambiata? Se no, il drift dello schema vi coglierà di sorpresa.
Possiamo rielaborare in sicurezza? Se no, il ripristino creerà duplicati o lacune.
Gli utenti a valle conoscono l'aspettativa di freschezza? Se no, la fiducia si basa sull'abitudine, non sulle prove.
Buono standard: una pipeline pronta per la produzione continua a funzionare quando gli input sono in ritardo, disordinati o parzialmente errati, e vi dice esattamente quando succede.
Questo standard dovrebbe essere condiviso da ingegneria, analytics e responsabili di business. Altrimenti il team definisce il successo come “il DAG è stato eseguito”, mentre il business presume che successo significhi “i numeri sono giusti”.
Costruire pipeline di cui potersi fidare
La pipeline moderna non è solo l'idraulica tra i sistemi. È un livello di affidabilità per i data product, il che significa che la fiducia nasce dalle scelte di progettazione, non dalla sola orchestrazione.
I team che si guadagnano la fiducia fanno alcune cose con costanza. Definiscono SLA di freschezza e qualità, trattano le modifiche allo schema come eventi che possono rompere qualcosa, monitorano lo stato di salute dei dati indipendentemente dallo stato delle esecuzioni e adattano l'architettura alle esigenze dei consumatori a valle. Rendono inoltre esplicite le responsabilità, perché nessuno si fida di una pipeline critica quando nessuno sa chi interviene alle 7 del mattino.
Per i team che cercano un modello pratico, la guida di DataTeams alla costruzione di una pipeline di dati è un utile complemento alle idee presentate qui, soprattutto se state traducendo l'architettura in scelte di implementazione quotidiane.
I benefici arrivano più avanti: analisi più pulite, modelli più solidi e meno discussioni sul fatto che una metrica sia reale. Le pipeline affidabili diventano il livello di base per analytics in tempo reale, feature store di machine learning e sistemi decisionali automatizzati che dipendono da dati coerenti e di alta qualità.
digna aiuta i team a monitorare modifiche allo schema, tempestività, validazione dei dati e anomalie all'interno del proprio ambiente, ed è esattamente il tipo di controllo di cui hanno bisogno le pipeline di produzione. Se state rafforzando l'affidabilità delle pipeline o cercando di rendere visibile al business la fiducia nei dati, visitate digna e scoprite come i suoi moduli di osservabilità si inseriscono nel vostro stack.
Domande frequenti
Che cos'è una pipeline di dati?
Un sistema end-to-end che automatizza l'acquisizione, la trasformazione, la validazione e il caricamento dei dati, in modo che possano essere usati in modo affidabile per analytics, AI e decisioni operative. Il punto è l'automazione: una sequenza di passaggi manuali che per caso vengono eseguiti in ordine non è una pipeline.
Quali sono i quattro componenti fondamentali?
Acquisizione, trasformazione, storage e consumo, che corrispondono perfettamente a un acquedotto comunale: la presa dell'acqua grezza, l'impianto di depurazione, il serbatoio e il rubinetto. La fase che in un diagramma sembra la più semplice è di solito quella in cui iniziano i problemi in produzione.
Perché la definizione da manuale non basta?
Perché i sistemi di produzione raramente si comportano in modo ordinato. L'API di una fonte cambia il formato della risposta, il job pianificato si completa comunque, il livello di reporting continua a visualizzare i dati e nessuno si accorge che i numeri sono vecchi di 18 ore finché qualcuno non li confronta con il sistema transazionale.
Quando scegliere ETL, ELT o streaming?
Non sono parole d'ordine in competizione, ma diverse collocazioni della fase di trasformazione. L'ETL trasforma prima del caricamento, l'ELT carica prima i dati grezzi e li trasforma all'interno del warehouse, lo streaming elabora in modo continuo. La scelta giusta dipende dalla latenza richiesta dalla decisione e da dove deve avvenire il calcolo.
Da quanto tempo esistono le pipeline di dati?
Da più tempo del termine stesso. Le ricostruzioni storiche fanno risalire il settore agli script batch manuali degli anni '70 e '80, passando per sistemi ETL più strutturati intorno al 1992, fino ad architetture ELT cloud-native, streaming e in tempo reale negli anni 2010 e 2020.


