Data ingestion: significato e guida a pipeline affidabili
|
6
min di lettura

Probabilmente siete qui perché qualcosa a monte ha reso assurdi i vostri numeri.
Una dashboard dei ricavi che ieri andava bene ora mostra un calo improvviso. Un modello di customer analytics inizia a produrre punteggi strani. Un report finanziario si carica con lacune che nessuno sa spiegare. La prima reazione tipica è dare la colpa alla dashboard, al data warehouse o al modello. Molto spesso, però, il problema è iniziato prima, nella fase di ingestion.
Ecco perché il significato di data ingestion non si riduce a “spostare dati da A a B”. Nella pratica, l'ingestion è il primo punto di controllo in cui un team decide se i dati in arrivo sono affidabili. Se questo punto di controllo è debole, ogni sistema a valle ne eredita i danni.
Indice
L'errore silenzioso dietro ogni dashboard rotta
Raramente una dashboard si rompe prima a livello di grafico. Si rompe prima, nell'ingestion, quando la piattaforma accetta dati in ritardo, incompleti, duplicati o strutturalmente modificati come se nulla fosse.
Questo errore è costoso proprio perché sembra normale. La dashboard viene visualizzata. Le query terminano. Un modello continua a produrre punteggi. Nel frattempo i numeri sono già sbagliati e il team inizia a fare debug della logica BI, delle prestazioni del data warehouse o delle definizioni di business invece di controllare il punto di ingresso da cui sono entrati i dati errati.
Ho visto questo schema ripetersi in molti stack di analytics. Un'API a monte elimina dei campi senza preavviso. Un loader ritenta il caricamento e crea duplicati. Una partizione arriva con sei ore di ritardo, ma il report pianificato viene comunque pubblicato in orario. Quando qualcuno se ne accorge, il problema si è già propagato alla reportistica direzionale, alle previsioni e ai sistemi a valle che dipendono dalle stesse tabelle, compresi i flussi alimentati dall'estrazione di dati con AI.
Perché questi errori sono difficili da intercettare
I problemi di ingestion spesso sfuggono agli allarmi evidenti perché l'infrastruttura può restare in salute mentre la qualità dei dati si degrada. La CPU è a posto. I job sono verdi. Lo storage è disponibile. Niente di tutto ciò conferma che i record siano completi, aggiornati o strutturati come si aspettano i consumatori a valle.
Ecco perché l'ingestion va trattata come un punto di controllo, non come una semplice fase di trasporto.
Un singolo cambiamento a monte può attraversare diversi livelli prima che qualcuno ricolleghi il sintomo alla sorgente. Una colonna rinominata può non far fallire un caricamento se la pipeline è permissiva. Un calo di volume può sembrare innocuo finché una dashboard non sottostima i ricavi. Un problema di parsing dei timestamp può spostare i record nella finestra temporale sbagliata e distorcere i report sulle tendenze per giorni.
Le dashboard rotte di solito nascono da dati non controllati che entrano nel sistema, non da un grafico rotto.
La fiducia si costruisce prima che inizi l'analisi
I team affidabili verificano i dati quando arrivano. Non aspettano che siano gli utenti BI, gli analisti o i consumatori di ML a scoprire il problema in seguito.
I controlli che contano sono operativi e specifici:
Orario di arrivo: i dati possono essere caricati correttamente ed essere comunque troppo in ritardo per i report che ne dipendono.
Volume e completezza: cali, picchi, troncamenti e duplicati vanno trattati innanzitutto come incidenti di ingestion.
Integrità dello schema: campi aggiunti, colonne rimosse, cambi di tipo e modifiche alla nullabilità richiedono una gestione esplicita.
Validità di base: ID, timestamp, valute e tipi di evento dovrebbero rispettare i formati attesi prima che i dati avanzino nello stack.
È questo il significato pratico dell'affidabilità della data ingestion. Se il livello di ingestion si limita a spostare byte, ogni sistema a valle eredita il rischio. Se il livello di ingestion verifica freschezza, struttura e idoneità all'uso, il resto della piattaforma resta molto più prevedibile.
Che cos'è davvero la data ingestion
La data ingestion è il punto in cui una piattaforma decide se i dati in arrivo sono abbastanza affidabili da entrare nel sistema.
Questa definizione è più utile di "spostare dati da un luogo a un altro", perché il solo trasporto non protegge dashboard, alert o modelli. Una pipeline può copiare ogni file nei tempi previsti e deludere comunque il business se il payload è in ritardo, incompleto, malformato o presenta un sottile cambiamento rispetto al giorno prima. In produzione, l'ingestion è il punto in cui i team applicano i primi controlli rigorosi su freschezza, struttura dello schema e validità di base.
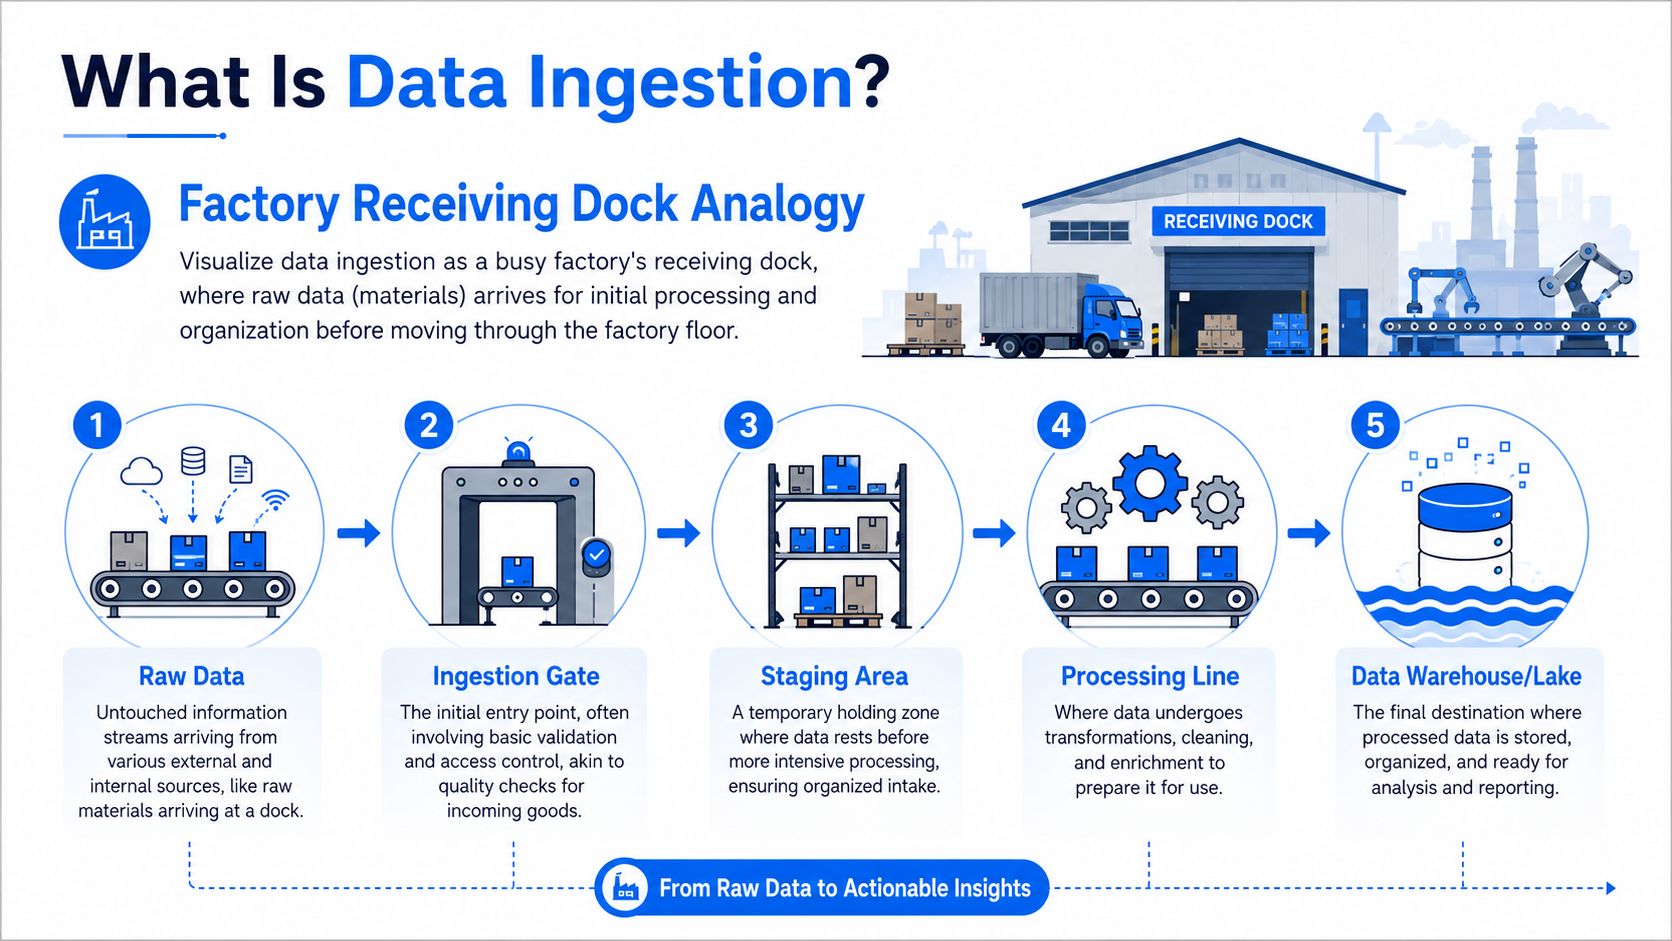
Un buon livello di ingestion riceve i dati, identifica che cosa è arrivato, lo valida rispetto alle aspettative e lo instrada verso la destinazione corretta con metadati sufficienti per risalire ai problemi in seguito. Ecco perché gli errori di ingestion sono spesso prima di tutto errori di affidabilità e solo in secondo luogo errori di trasporto.
Se lavorate con documenti, moduli o input semi-strutturati prima ancora che arrivino al data warehouse, è utile capire quale ruolo ha l'estrazione di dati con AI. L'estrazione ricava le informazioni dalla sorgente. L'ingestion copre il flusso operativo più ampio che le accetta, le controlla, le mette in staging e le carica nella destinazione in modo controllato.
Le fasi che contano nella pratica
Gli ingegneri di solito suddividono l'ingestion in alcune fasi ripetibili. I nomi variano a seconda dello stack, ma il lavoro è sempre lo stesso.
Identificazione della sorgente
Ogni scelta di progettazione parte da qui. Dati da API, replica di database, file CSV dei partner e flussi di eventi falliscono tutti in modi diversi. I team che saltano le ipotesi specifiche per ogni sorgente finiscono di solito con connettori fragili e responsabilità poco chiare.Estrazione dei dati
È la fase di raccolta. Connettori, job CDC, lettori di file e consumer di webhook estraggono i dati dal sistema sorgente. Un errore comune è considerare un successo una chiamata API riuscita o un file prelevato, anche quando il payload restituito è parziale o strutturalmente diverso.Staging
I dati grezzi hanno bisogno di un punto di approdo prima di raggiungere i modelli principali o le tabelle di serving. Lo staging rende possibile la riesecuzione, offre agli ingegneri qualcosa di concreto da esaminare durante gli incidenti e limita il raggio d'impatto quando i sistemi a monte cambiano inaspettatamente.
Regola pratica: non fate delle tabelle curate del data warehouse il primo luogo in cui emergono le sorprese provenienti dalle sorgenti.
Validazione
È nella validazione che l'ingestion dimostra il suo valore. I controlli dovrebbero coprire campi obbligatori, conteggi di righe, chiavi duplicate, parsing dei timestamp, valori enumerati, picchi di null e modifiche allo schema. I team che usano software di data ingestion per il monitoraggio e la validazione delle pipeline di solito riducono il tempo tra la rottura a monte e il rilevamento, perché osservano il punto di passaggio invece di aspettare che un analista noti un grafico sbagliato.Trasformazione
Una parte della pulizia avviene durante l'ingestion anche negli stack fortemente orientati all'ELT. Standardizzare i timestamp, normalizzare i nomi dei campi, forzare i tipi e annotare la lineage conviene spesso farlo presto, perché rende più facile il debug degli errori a valle.Caricamento
La fase finale di scrittura inserisce i dati nel sistema di destinazione in una forma utilizzabile da altri sistemi. Partizionamento, scritture idempotenti, strategia di deduplicazione e comportamento dei retry contano qui, perché una logica di caricamento sbagliata può creare duplicati silenziosi o tabelle parziali che dall'esterno sembrano in salute.
Il compromesso è semplice. Una validazione rigorosa nell'ingestion può ritardare i dati quando i controlli falliscono. Una validazione permissiva mantiene il flusso dei dati ma spinge record errati nei sistemi di BI e AI, dove la diagnosi diventa più lenta e costosa. I team solidi decidono queste soglie in modo esplicito, sorgente per sorgente.
Se di questa sezione volete ricordare un'unica idea, ricordate questa. La data ingestion è il punto di controllo in cui l'arrivo dei dati grezzi diventa disponibilità verificata.
Architetture e pattern comuni di data ingestion
Un team rilascia una dashboard pulita, poi la fiducia svanisce perché i numeri di ieri sono arrivati alle 10 invece che alle 6, o perché una sorgente ha aggiunto un campo e la pipeline lo ha accettato senza obiezioni. Sono le scelte architetturali a determinare questi esiti. I pattern di ingestion decidono non solo come si spostano i dati, ma anche quando vengono applicati i controlli su freschezza, integrità dello schema e validazione.
Due decisioni plasmano la maggior parte dei sistemi di ingestion. La prima riguarda le tempistiche: batch o tempo reale. La seconda riguarda il punto in cui i dati vengono puliti e standardizzati: ETL o ELT. Nessuna delle due è una scelta accademica. Ognuna cambia i costi operativi, il ripristino dagli errori, la velocità di debug e quanto presto un team riesce a intercettare dati errati prima che raggiungano dashboard o modelli.
Batch e tempo reale rispondono a esigenze operative diverse
L'ingestion batch sposta i dati secondo una pianificazione. L'ingestion in tempo reale elabora i record man mano che arrivano gli eventi. Entrambe possono funzionare bene. La scelta giusta dipende da quanto rapidamente i sistemi a valle hanno bisogno di dati verificati e da quanto carico operativo il team è in grado di sostenere.
Il batch è adatto ai flussi di lavoro in cui i dati possono arrivare a finestre ed essere comunque utili. Rientrano di solito in questa categoria i processi di chiusura contabile, la reportistica giornaliera, gli scambi di file con i partner e i job di riconciliazione periodica. È più semplice da comprendere, più facile da recuperare con backfill e spesso più facile da rendere idempotente.
L'ingestion in tempo reale è adatta ai sistemi in cui dati non aggiornati creano problemi di business immediati. Segnali di frode, flussi di attività degli utenti, eventi logistici e alerting operativo richiedono spesso una consegna a bassa latenza. Lo streaming però comporta più punti di possibile guasto. Le code si riempiono. I consumer restano indietro. Gli offset vengono gestiti male. La riesecuzione può duplicare i record se la logica di scrittura è approssimativa.
Ecco il confronto pratico.
Aspetto | Ingestion batch | Ingestion in tempo reale |
|---|---|---|
Latenza | Pianificata e ritardata per definizione | Disponibilità quasi immediata |
Modello operativo | Viene eseguita a finestre, con punti di ripristino più chiari | Viene eseguita in continuo e richiede un monitoraggio più stretto |
Ripristino dagli errori | Backfill e riesecuzioni sono di solito più semplici | Riesecuzione, ordinamento e gestione dei duplicati richiedono più attenzione |
Casi d'uso tipici | Analisi storiche, reportistica pianificata, flussi finanziari | Dashboard operative live, monitoraggio di eventi, sistemi a risposta rapida |
Un errore comune è forzare tutto nello streaming perché il business chiede il “tempo reale”. Nella pratica, molti team hanno bisogno di livelli di servizio diversi per dataset diversi. Una dashboard del customer support può richiedere aggiornamenti ogni pochi minuti. La reportistica sui ricavi può aver bisogno solo di un caricamento giornaliero verificato. Abbinare il pattern al caso d'uso mantiene il sistema sostenibile.
Se state valutando scelte di progettazione di sistema più ampie legate a questi compromessi, questa guida ai pattern architetturali di Appjet.ai è una lettura complementare utile, perché la progettazione dell'ingestion raramente vive in isolamento.
ETL ed ELT cambiano il punto in cui avviene la verifica
La seconda decisione architetturale riguarda l'ordine della trasformazione. ETL significa estrarre, trasformare e poi caricare. ELT significa estrarre, caricare e poi trasformare. La distinzione tecnica conta meno di quella operativa: dove valida e standardizza i dati il team prima che i consumatori a valle ne dipendano?
Con l'ETL i record vengono puliti prima di arrivare a destinazione. Questo approccio funziona bene quando il sistema di destinazione si aspetta una struttura rigida, quando lo spazio per conservare gli input grezzi è limitato o quando le regole di compliance richiedono un preprocessing prima della persistenza. Il rovescio della medaglia è che le trasformazioni fallite possono impedire del tutto l'arrivo dei dati, rendendo l'indagine più lenta se gli input grezzi non vengono conservati altrove.
Con l'ELT i dati grezzi arrivano per primi e le trasformazioni vengono eseguite all'interno del data warehouse o del lakehouse. Questo offre più flessibilità ad analisti e ingegneri, conserva il dettaglio della sorgente per la rielaborazione e di solito accelera le iterazioni. Crea però anche un rischio. Se i team considerano l'arrivo dei dati un successo, record malformati e schema drift possono restare nelle tabelle grezze finché, ore dopo, non rompono un modello a valle.
Ecco perché una progettazione matura dell'ingestion prevede controlli in ingresso sia negli stack ETL sia in quelli ELT. Campi obbligatori, validazione dei tipi, rilevamento dei duplicati, controlli di plausibilità dei timestamp e alert sulle modifiche allo schema dovrebbero avvenire nel momento in cui i dati entrano nella piattaforma, anche se le trasformazioni di logica di business avvengono più tardi.
Un insieme di regole pratiche aiuta:
Scegliete l'ETL quando i dati sorgente devono essere normalizzati prima dell'archiviazione, i sistemi di destinazione hanno vincoli strutturali stringenti o le policy richiedono un preprocessing prima del caricamento.
Scegliete l'ELT quando conservare gli input grezzi è importante, la capacità di calcolo del data warehouse è disponibile e le trasformazioni a valle cambiano spesso.
Usate pattern ibridi quando una validazione leggera e l'applicazione dello schema avvengono nell'ingestion, mentre la rimodellazione specifica del business avviene più tardi.
Per i team che confrontano strumenti per configurazioni batch, streaming e ibride, valutate un software di data ingestion per validazione, riesecuzione e monitoraggio dello schema in base a quanto bene verifica i dati nel punto di ingresso, non solo a quanto velocemente trasporta i record.
Una buona architettura di ingestion è costruita attorno ai requisiti di freschezza, alla tolleranza agli errori e alla verifica in ingresso. Il solo trasporto non basta.
I rischi operativi di una data ingestion inadeguata
Un livello di ingestion debole raramente fallisce in modo clamoroso. Si degrada in modo sottile, ed è per questo che i team lo sottovalutano.
Un'API restituisce meno righe del solito, ma il connettore segnala comunque un successo. Il team di una sorgente aggiunge una colonna e cambia un tipo. Un caricamento giornaliero arriva abbastanza in ritardo da rendere obsoleta la dashboard del mattino, ma non così tanto da far fallire il job. La piattaforma continua a funzionare mentre la fiducia si erode.
Come l'ingestion fallisce senza allarmi evidenti
Le categorie principali si ripresentano continuamente nei sistemi di produzione:
Errori di tempestività
I dati arrivano in ritardo, in parte o non arrivano affatto. Le tabelle esistono, ma il business sta leggendo uno stato non aggiornato.Schema drift
Aggiunte, rimozioni, rinomine di colonne e cambi di tipo si insinuano dai sistemi a monte e rompono le trasformazioni o distorcono le analisi.Problemi silenziosi nei record
Record mancanti, duplicati o corrotti possono distorcere report e modelli a valle. I sistemi di rilevamento basati su AI possono identificare queste deviazioni in tempo reale apprendendo baseline normali invece di dipendere da soglie scritte a mano, come spiegato in questa panoramica sulle anomalie nei dati.Metriche volatili senza una causa evidente
Il KPI cambia, ma nessuno sa se sia cambiato il business o i dati.
Un punto merita particolare attenzione. Molti ingegneri si chiedono se convenga validare durante l'ingestion o più tardi. Si stima che tra il 40 e il 60 percento dei guasti delle pipeline abbia origine da dati non validati accettati durante l'ingestion, secondo questa analisi di dbt sulla validazione dell'ingestion.
Perché l'impatto sul business emerge più tardi
I difetti di ingestion non restano circoscritti. Si propagano.
Un caricamento difettoso può alimentare le dashboard BI con totali non aggiornati. Un disallineamento di schema può propagare feature piene di null in un flusso di ML. Negli ambienti regolamentati, i record mancanti possono creare lacune di audit che vengono scoperte solo quando qualcuno cerca di riconciliare lo storico.
Di solito i team notano i problemi di ingestion nell'ultimo sistema toccato dall'errore, non nel primo che lo ha causato.
Ecco perché il “muoversi in fretta e validare dopo” non regge nelle piattaforme dati. Il “dopo” è il punto in cui il raggio d'impatto è più ampio, la superficie di debug è più estesa e il business ha già consumato l'errore.
Metriche chiave per monitorare lo stato di salute dell'ingestion
Se l'ingestion è il vostro primo confine di affidabilità, anche il monitoraggio deve partire da lì. I team che osservano solo il tasso di successo dei job perdono il segnale reale. Un job può terminare con successo e caricare comunque i dati sbagliati.
La domanda utile è semplice: che aspetto dovrebbe avere normalmente questa pipeline quando è in salute?
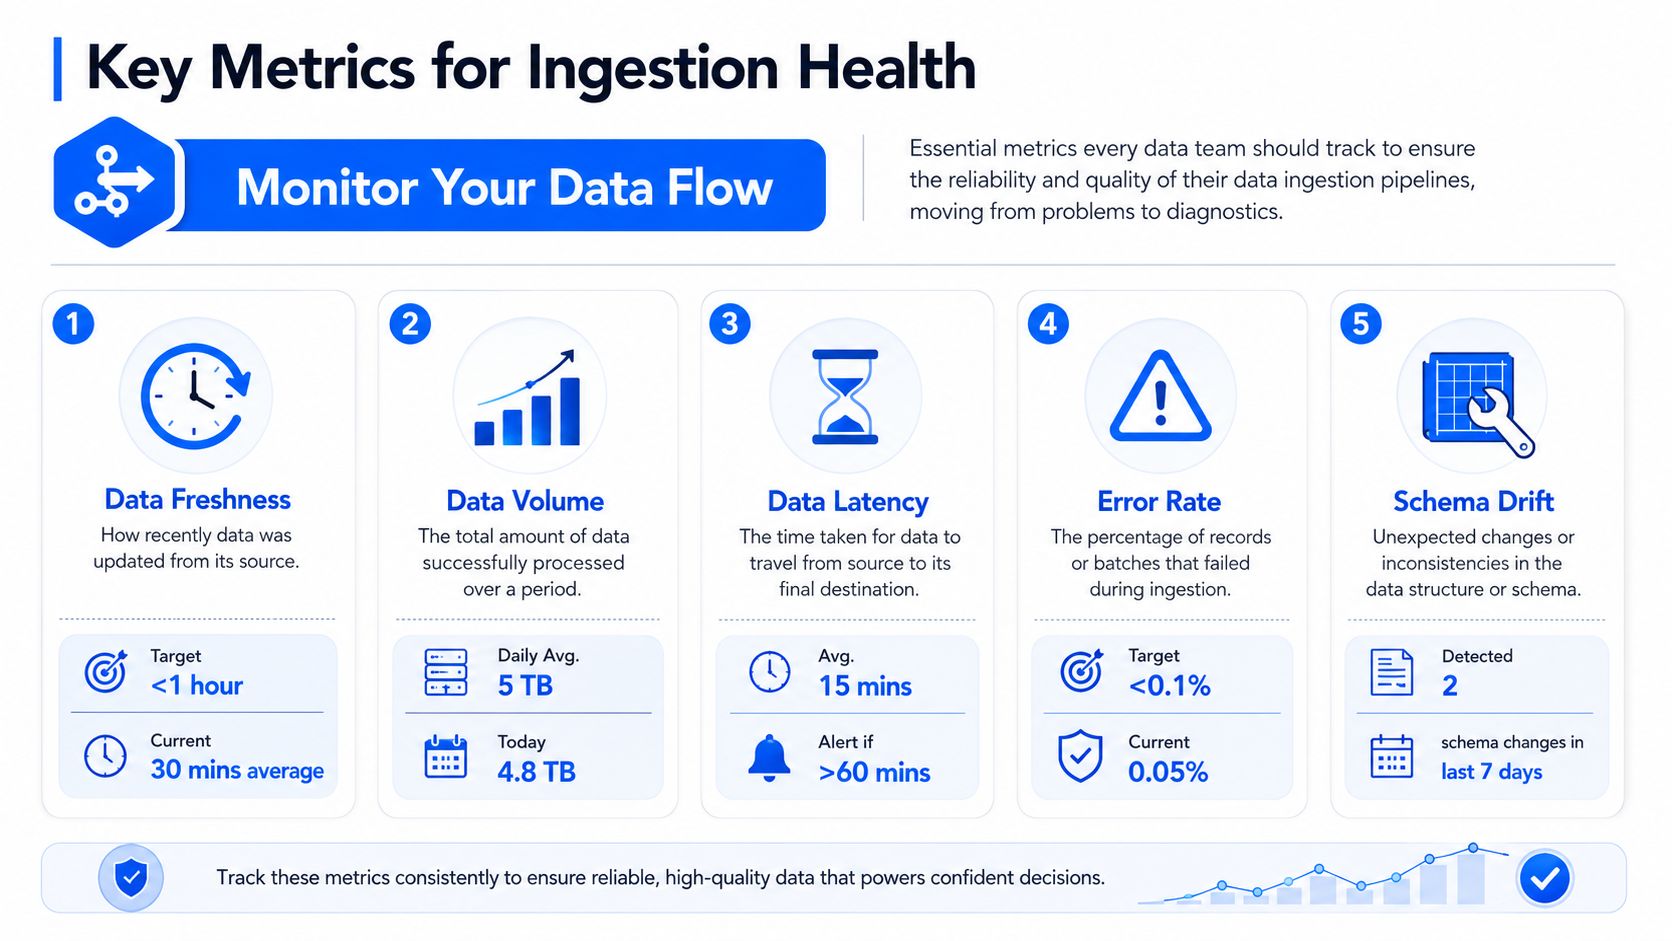
Freschezza e volume indicano se i dati arrivano correttamente
Due dei segnali più rapidi sono la freschezza e il volume.
La freschezza indica quanto sono aggiornati i dati rispetto alle aspettative sulla sorgente. Per una tabella batch, può significare verificare se il caricamento pianificato di oggi è arrivato. Per lo streaming, può significare misurare il ritardo tra la creazione dell'evento e la sua disponibilità nella destinazione.
Il volume risponde a una domanda diversa. La sorgente ha inviato all'incirca ciò che invia di solito? Un job "riuscito" che acquisisce metà dei record attesi non è in salute.
Le moderne piattaforme di Data Observability profilano automaticamente le metriche critiche di ingestion, tra cui volume dei record, valori mancanti, forma delle distribuzioni tramite istogrammi, intervalli di valori per gli estremi e controlli di unicità per i duplicati, secondo questo riferimento sulle metriche di observability.
Completezza e schema indicano se i dati sono utilizzabili
Un secondo gruppo di metriche si concentra sull'usabilità.
Completezza
Tenete d'occhio null, campi vuoti e presenza delle colonne obbligatorie. Una tabella può essere aggiornata e comunque inutilizzabile perché sono scomparsi attributi chiave.Unicità
Le chiavi duplicate compaiono spesso dopo riesecuzioni, retry o errori nella gestione del CDC. Questi problemi generano conteggi gonfiati e join incoerenti.Distribuzione dei valori
Gli spostamenti negli istogrammi e i valori fuori intervallo spesso intercettano problemi sottili delle sorgenti prima che gli stakeholder notino un'anomalia in una dashboard.Integrità dello schema
L'aggiunta di campi e i cambi di tipo meritano un monitoraggio di prima classe. Molti errori “misteriosi” a valle sono semplicemente un'evoluzione dello schema non tracciata.
Un modello operativo pratico consiste nel definire il comportamento atteso per ogni dataset e poi generare alert sulle deviazioni che contano per i consumatori. Non monitorate tutto allo stesso modo. Una tabella dei fatti finanziaria e una tabella di staging del clickstream poco critica non dovrebbero avere la stessa policy di risposta.
Monitorate i cambiamenti di comportamento, non solo l'uptime della pipeline.
È questo cambio di prospettiva che porta un team dal troubleshooting reattivo a uno stato di salute dell'ingestion sotto controllo.
Migliorare l'affidabilità con la Data Observability
I controlli manuali a campione non scalano quando una piattaforma ha più di una manciata di sorgenti. Qualcuno può interrogare i conteggi delle righe dopo un rilascio o esaminare una dashboard quando uno stakeholder si lamenta, ma questo non è monitoraggio. È una diagnosi in ritardo.
La Data Observability cambia il modello operativo osservando continuamente il comportamento dei dati. Invece di aspettare una rottura a valle, la piattaforma esamina i segnali di ingestion, come tempestività, schemi dei record, valori mancanti e cambiamenti strutturali, nel momento in cui i dati arrivano.
I controlli manuali non scalano
Le organizzazioni spesso iniziano con regole create a mano. Una soglia sul conteggio delle righe qui, un controllo sui null là, magari un alert su Slack quando un caricamento è in ritardo. Funziona per un po'. Poi gli schemi evolvono, le sorgenti si moltiplicano e le soglie statiche diventano rumorose o incomplete.
I moderni sistemi di observability migliorano questo approccio apprendendo gli schemi normali e segnalando automaticamente le deviazioni. Il calcolo delle metriche in-database consente alle piattaforme di apprendere le baseline e rilevare le anomalie calcolando le metriche direttamente all'interno del database del cliente, eliminando la manutenzione manuale delle regole o la scrittura di codice esterno, come descritto in questa panoramica sul rilevamento delle anomalie in-database.
Questa architettura conta. Evita di spostare i dati di produzione in un altro sistema solo per misurarli.
Perché il monitoraggio in-database cambia il modello operativo
Nella pratica, i team vogliono tre cose dal monitoraggio dell'ingestion:
Visibilità continua sul fatto che i dati arrivino, cambino e siano conformi alle aspettative.
Basso carico operativo, così che gli ingegneri non debbano mantenere un'infinità di regole fragili.
Esecuzione sicura all'interno dell'ambiente del cliente.
Una piattaforma come digna si adatta a questo modello combinando rilevamento delle anomalie, monitoraggio della tempestività, validazione a livello di record e tracciamento dello schema con esecuzione in-database. Se volete un quadro concettuale più ampio, questa panoramica sulla Data Observability è utile perché collega il monitoraggio all'affidabilità invece di trattarlo come una decorazione da dashboard.
Ciò che funziona sul campo è semplice. Apprendete il battito normale di ogni tabella importante. Generate alert sulle deviazioni significative. Tenete i controlli vicino ai dati. Assicuratevi che sia il responsabile dell'ingestion, non solo il responsabile della dashboard, a ricevere per primo il segnale.
È così che i team smettono di vivere gli incidenti di ingestion come sorprese per il business e iniziano a gestirli come condizioni operative rilevabili.
Best practice pratiche per un'ingestion robusta
Un'ingestion affidabile nasce più dalla disciplina che dall'ingegno. La maggior parte degli incidenti dolorosi che ho visto era evitabile, ma solo se il team avesse trattato l'ingestion come una superficie di prodotto invece che come un'utility di sottofondo.
Una checklist pratica aiuta.
Le abitudini che reggono in produzione
Validate al confine
Controllate i record quando entrano nella piattaforma. Intercettate problemi di campi obbligatori, chiavi duplicate, payload malformati e problemi di schema evidenti prima che confluiscano nelle tabelle condivise.Progettate sia per l'arrivo sia per la correttezza
Dati sbagliati arrivati puntuali restano dati sbagliati. Abbinate il monitoraggio della freschezza a controlli di qualità, così che i team non confondano la velocità con l'affidabilità.Mantenete i livelli di staging rieseguibili
Quando una sorgente si rompe, la riesecuzione è spesso la via più rapida per il ripristino. Funziona solo se l'input grezzo o quasi grezzo viene conservato in modo abbastanza pulito da poterlo rielaborare.Definite chiaramente le responsabilità
Qualcuno deve essere responsabile del contratto con la sorgente, del job di ingestion e delle aspettative sulla tabella a valle. Le responsabilità ambigue sono il motivo per cui piccoli problemi di ingestion si trasformano in lunghe call di gestione degli incidenti.Rispettate i vincoli delle sorgenti
Gran parte dell'instabilità dell'ingestion nasce al confine con i sistemi esterni. Se estraete dati da API di terze parti, progettate tenendo conto fin dal primo giorno del throttling e delle quote del fornitore. Un esempio chiaro è la policy sui rate limit di RealtyAPI.io, che mostra perché la strategia di retry e la logica di backoff fanno parte della progettazione dell'ingestion e non sono un ripensamento.Strumentate fin dal primo giorno
Introducete presto l'observability. Aggiungere a posteriori controlli di salute a una piattaforma in crescita è sempre più difficile che integrarli fin dall'inizio nel percorso di ingresso dei dati.
Le pipeline di ingestion più solide sono noiose in produzione perché gli ingegneri hanno reso rigoroso il confine.
Lo scopo non è rendere l'ingestion pesante. È renderla affidabile. Quando i team comprendono il vero significato della data ingestion, smettono di considerarla un problema di connettori e iniziano a trattarla come il punto di controllo che protegge ogni report, modello e decisione a valle.
Se il vostro team vuole essere avvisato prima di caricamenti non aggiornati, modifiche allo schema e derive silenziose dei dati, vale la pena valutare digna come parte del livello di ingestion. È progettato per monitorare data quality e observability all'interno di ambienti controllati dal cliente, ideale per i team che vogliono controlli affidabili senza spostare i dati di produzione fuori dal proprio stack.
Domande frequenti
Che cosa significa data ingestion?
La data ingestion è il punto in cui una piattaforma decide se i dati in arrivo sono abbastanza affidabili da entrare nel sistema, non un semplice spostamento di dati da A a B. Comprende identificazione della sorgente, estrazione, staging, validazione, trasformazione e caricamento, con i primi controlli su freschezza, struttura dello schema e validità di base.
Quali sono le fasi della data ingestion?
L'articolo indica sei fasi: identificazione della sorgente, estrazione dei dati, staging, validazione, trasformazione e caricamento. È nella validazione che l'ingestion dimostra il suo valore, controllando campi obbligatori, conteggi di righe, chiavi duplicate, parsing dei timestamp, valori enumerati, picchi di null e modifiche allo schema prima che i dati raggiungano le tabelle curate del data warehouse.
Meglio una data ingestion batch o in tempo reale?
Scegliete in base a quanto rapidamente i sistemi a valle hanno bisogno di dati verificati. Il batch è adatto a chiusure contabili, reportistica giornaliera e scambi di file con i partner, perché è più facile da recuperare con backfill. Il tempo reale è adatto a segnali di frode, eventi logistici e alerting operativo, ma comporta più punti di possibile guasto, come code piene, consumer in ritardo e offset gestiti male.
Qual è la differenza tra ETL ed ELT nella data ingestion?
L'ETL trasforma i record prima di caricarli nella destinazione, mentre l'ELT carica prima i dati grezzi e li trasforma all'interno del data warehouse o del lakehouse. Dal punto di vista operativo, la differenza sta nel punto in cui avviene la verifica. L'articolo raccomanda controlli in ingresso in entrambi i casi, come campi obbligatori, validazione dei tipi, rilevamento dei duplicati e alert sulle modifiche allo schema.
Quali metriche indicano che la data ingestion è in salute?
Freschezza e volume mostrano se i dati arrivano correttamente, mentre completezza, unicità, distribuzione dei valori e integrità dello schema mostrano se sono utilizzabili. Il solo tasso di successo dei job è fuorviante, perché un job può terminare con successo e caricare comunque metà dei record attesi o duplicare silenziosamente le chiavi dopo un retry.


