Che cos’è DataOps: la guida definitiva per il 2026
|
9
min di lettura

Che cos’è esattamente DataOps? In breve, significa applicare le lezioni apprese con fatica dal DevOps al mondo dei dati. È una metodologia incentrata su collaborazione, automazione e miglioramento continuo lungo l’intero ciclo di vita dei dati.
Potete considerarla la risposta moderna a pipeline di dati lente e inaffidabili e ai team frustrati che ne dipendono.
Indice
Che cos’è DataOps e perché conta proprio ora?
DataOps segna una rottura radicale con il mondo lento e frammentato in silos della gestione dei dati tradizionale. Invece di trattare la data analytics come un processo rigido, da eseguire passo dopo passo, DataOps la trasforma in una linea di produzione veloce, flessibile e automatizzata. L’obiettivo è semplice: fornire dati affidabili e di alta qualità alla stessa velocità a cui opera realmente la vostra azienda.
Questo approccio ha iniziato a prendere forma tra il 2015 e il 2018, nato dall’esigenza di gestire pipeline di dati sempre più complesse. L’impatto è difficile da ignorare. Secondo una ricerca di IBM, le organizzazioni che adottano pratiche DataOps possono ridurre i tempi di consegna dei dati in media del 40%, migliorando al contempo la qualità dei dati del 35%.

Da lento e manuale a veloce e automatizzato
In un contesto tradizionale è comune che data engineer, analisti e data scientist lavorino in silos separati. Questo crea enormi colli di bottiglia. Una semplice richiesta di un nuovo report o dataset può richiedere settimane e, quando finalmente arriva, l’informazione è spesso obsoleta o semplicemente sbagliata. DataOps nasce proprio per abbattere questi muri.
Per comprendere il cambiamento è utile un confronto diretto. La tabella seguente illustra come DataOps cambi radicalmente l’approccio alla gestione dei dati.
DataOps e gestione dei dati tradizionale a confronto
Aspetto | Gestione dei dati tradizionale | DataOps |
|---|---|---|
Workflow | Progetti lineari, a cascata, con lunghi cicli di sviluppo. | Sprint agili e iterativi incentrati su consegna e feedback rapidi. |
Automazione | Processi per lo più manuali per test, deployment e monitoraggio. | Test (CI) e deployment (CD) delle pipeline ampiamente automatizzati. |
Collaborazione | Team in silos (IT, data engineering, business) con passaggi di consegne formali. | Team cross-funzionali con responsabilità condivisa dallo sviluppo alla produzione. |
Qualità | Controllo qualità reattivo, che spesso individua gli errori in produzione. | Monitoraggio proattivo e continuo di qualità, freschezza e schema. |
Velocità | Le modifiche richiedono settimane o mesi per essere implementate. | Modifiche e nuove funzionalità possono essere rilasciate in ore o giorni. |
Focus | Centrato sull’infrastruttura e sulla fornitura di dati grezzi. | Orientato a fornire agli utenti di business “data product” pronti a generare valore. |
Questo passaggio da un processo rigido e manuale a uno fluido e automatizzato è il cuore di DataOps. Non si tratta solo di fare le stesse cose più in fretta, ma di creare una cultura dei dati fondamentalmente più affidabile e reattiva.
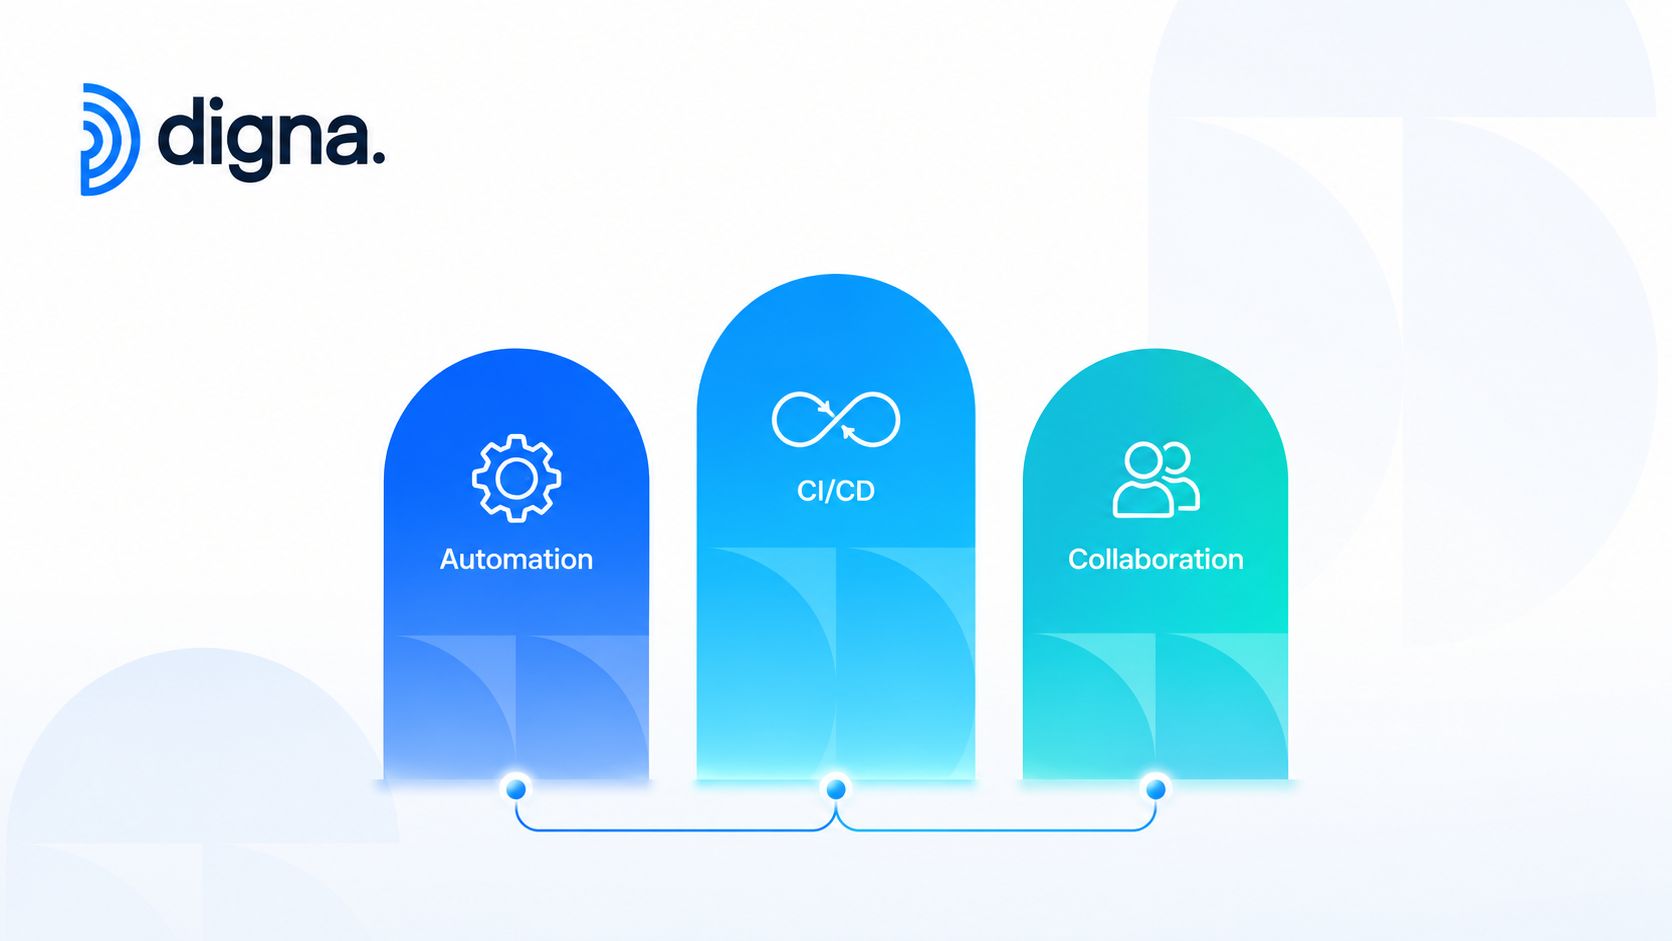
Questo framework collaborativo consente ai team di costruire, testare e rilasciare pipeline di dati rapidamente e con sicurezza. Si basa su alcune idee fondamentali:
Automazione: automatizzate tutto ciò che può essere automatizzato, dai controlli di qualità dei dati ai deployment delle pipeline. In questo modo si riducono al minimo gli errori manuali e il vostro team può concentrarsi su attività di maggior valore.
Continuous Integration/Continuous Delivery (CI/CD): applicando la CI/CD, le modifiche alle pipeline di dati vengono testate e rilasciate automaticamente. Così i team possono iterare in ore, non in settimane.
Collaborazione: DataOps favorisce un senso di responsabilità condivisa tra chi costruisce le pipeline e chi utilizza i dati. In questo modo i data product finali risolvono davvero problemi di business reali.
Adottare queste pratiche è fondamentale per costruire una enterprise data platform moderna e resiliente. Il risultato è un sistema che non solo è più veloce, ma crea anche una fiducia incrollabile nei dati che alimentano le vostre decisioni più critiche.
I principi fondamentali di un DataOps di successo
Per comprendere davvero DataOps bisogna andare oltre le parole d’ordine. Non è solo un nuovo set di strumenti: è una revisione culturale e procedurale basata su alcune idee fondamentali che cambiano completamente il modo in cui i team gestiscono i dati. Questi principi sono il “come” dietro il concetto e trasformano la promessa di una consegna agile dei dati in qualcosa di realmente utilizzabile.
In sostanza, DataOps consiste nel costruire un ecosistema automatizzato, collaborativo e guidato dal feedback. Integra tutto, dalla Data Integration e dal Data Management fino all’Analytics Development e alla Data Delivery, creando un unico workflow coeso.
Puntare sull’automazione totale
Il primo principio, e probabilmente il più importante, è semplice: automatizzare tutto il possibile. In un ambiente dati tradizionale, il lavoro manuale è il principale collo di bottiglia. Eseguire test, rilasciare pipeline e verificare a mano la qualità dei dati è lento, noioso e favorisce l’errore umano.
DataOps ribalta questa logica.
Invece di un data engineer che verifica manualmente se un dataset è aggiornato, lo fa un monitor automatico. Invece di uno sviluppatore che attende una finestra di manutenzione per rilasciare il codice, uno script automatico gestisce il deployment all’istante. Questa attenzione costante all’automazione libera il vostro team dalla gestione delle emergenze e gli permette di concentrarsi su analisi e innovazione, il lavoro che crea davvero valore.
Applicare la CI/CD alle pipeline di dati
Mutuata dal cugino DevOps, la Continuous Integration e Continuous Delivery (CI/CD) è il motore che garantisce velocità e affidabilità in DataOps.
Continuous Integration (CI): ogni volta che viene effettuato il commit di una modifica a una pipeline di dati (una nuova trasformazione SQL, uno script Python, qualsiasi cosa), questa viene testata automaticamente. Questo semplice passaggio garantisce che il nuovo codice non comprometta ciò che già funziona.
Continuous Delivery (CD): una volta superati i test, le modifiche vengono rilasciate automaticamente in produzione. È questo che permette ai team di iterare sui data product in ore o giorni, non nelle settimane o nei mesi che un tempo si accettavano come normali.
Implementando la CI/CD per i dati, le organizzazioni possono ridurre drasticamente il “cycle time” della analytics, passando da un’idea a un insight rilasciato e capace di generare valore con una velocità e una sicurezza senza precedenti. È qui che l’agilità prende davvero vita.
Promuovere una collaborazione intensa
Più di ogni altra cosa, DataOps mira ad abbattere i silos che da sempre affliggono i team dati. Promuove una cultura in cui data engineer, data scientist, analisti e utenti di business operano come un’unica unità coesa.
Non si tratta solo di andare d’accordo: si crea un ciclo di feedback stretto, essenziale per la fiducia. Quando un analista individua un problema in una dashboard, può parlare direttamente con gli engineer, che possono risalire alla fonte e correggerlo.
Questa comunicazione costante e la responsabilità condivisa creano fiducia, non solo tra i membri del team, ma anche nei dati stessi.
In cosa DataOps si differenzia da DevOps e MLOps
Se il termine “DataOps” vi suona familiare, è perché si ispira al suo celebre cugino, DevOps. Pur non essendo la stessa cosa, comprenderne le differenze, insieme a quelle con l’ambito affine dell’MLOps, è fondamentale per gestire uno stack dati moderno. Tutte e tre le discipline si basano su automazione, collaborazione e velocità, ma si concentrano su aspetti molto diversi.
DataOps prende in prestito molte ottime idee da DevOps, come la continuous integration/continuous delivery (CI/CD), i test automatizzati e la stretta collaborazione tra team. Ma ecco la differenza chiave: DevOps applica questi principi al ciclo di vita dello sviluppo software per rilasciare applicazioni affidabili. DataOps li applica alla pipeline di dati per fornire analytics affidabili.
Il prodotto finale in DevOps è codice funzionante. In DataOps, il prodotto finale sono dati affidabili.

Da DevOps a DataOps: un modello condiviso
Pensate a DevOps come al modello per costruire e rilasciare software in modo rapido e affidabile. Ha abbattuto i silos tra i team di sviluppo (Dev) e operations (Ops) per automatizzare il modo in cui le applicazioni vengono costruite, testate e rilasciate.
DataOps prende lo stesso modello e lo adatta al caos tipico del mondo dei dati. Il codice è generalmente prevedibile, i dati no. Possono arrivare in ritardo, con campi corrotti o cambiare l’intera struttura senza preavviso. DataOps aggiunge un livello di monitoraggio e validazione costanti, pensato proprio per gestire questa volatilità e garantire la qualità dei dati dalla fonte fino alla dashboard finale.
Dove si collocano MLOps e data engineering?
Per completare il quadro dobbiamo includere MLOps e data engineering. Sono due ambiti correlati, ma molto distinti.
MLOps (Machine Learning Operations) si concentra su un solo obiettivo: portare i modelli di machine learning in produzione e mantenerli lì. Riguarda l’automazione del deployment, del monitoraggio e della gestione dei modelli ML. Pur dipendendo da dati di qualità, il suo output principale è un modello predittivo, non la pipeline di dati in sé.
Data Engineering è la pratica di base che consiste nel costruire e mantenere l’infrastruttura su cui girano le pipeline di dati. DataOps non sostituisce il data engineering, lo migliora. Fornisce il framework agile e l’automazione che aiutano i data engineer a costruire sistemi più affidabili, più rapidamente.
DataOps è il tessuto connettivo che collega l’infrastruttura dei dati grezzi costruita dagli engineer al suo utilizzo finale nella analytics o nell’AI. Garantisce che le pipeline siano robuste e che i dati che alimentano i modelli ML siano davvero affidabili.
Per fare chiarezza è utile vedere queste discipline una accanto all’altra. La tabella seguente illustra ciò che rende unica ciascuna di esse.
Discipline dei dati a confronto: DataOps, DevOps, MLOps e data engineering
Disciplina | Focus principale | Obiettivo principale | Artefatto chiave |
|---|---|---|---|
DataOps | L’intero ciclo di vita dei dati | Consegna rapida di dati affidabili e di alta qualità | Dataset e analytics validati |
DevOps | Il ciclo di vita della distribuzione del software | Consegna rapida di applicazioni affidabili | Codice applicativo |
MLOps | Il ciclo di vita dei modelli di machine learning | Deployment scalabile dei modelli ML | Modelli ML pronti per la produzione |
Data Engineering | Architettura e infrastruttura dei dati | Costruire e mantenere le pipeline di dati | Dati grezzi e trasformati |
Ognuna di queste discipline svolge un ruolo critico. Il data engineering costruisce le strade, DataOps gestisce il traffico perché scorra in modo fluido e sicuro, DevOps costruisce i veicoli (le applicazioni) e MLOps costruisce le auto a guida autonoma (i modelli di AI). Lavorano tutte insieme, ma ognuna ha la propria corsia.
Certo. Ecco la sezione riscritta, adottando la voce, il tono e lo stile di formattazione richiesti.
Vantaggi concreti per il business con l’adozione di DataOps
La teoria alla base di DataOps è ottima, ma ogni leader aziendale prima o poi pone la stessa domanda: “E quindi?”. Una pratica DataOps ben gestita non è solo un aggiornamento tecnico: è la risposta a questa domanda, perché produce risultati di business reali e misurabili.
Cambia radicalmente il modo in cui un’organizzazione utilizza i dati, trasformandoli da un compito lento e reattivo in una fonte di vantaggio competitivo. Pensate a un team marketing che ottiene insight cruciali su una campagna in poche ore anziché in settimane. Può riallocare il budget pubblicitario a campagna in corso, puntando su ciò che funziona e tagliando ciò che non funziona. Questo è un vantaggio di business diretto.
DataOps colma il divario tra la promessa dell’AI aziendale e la realtà dei risultati di business. È ciò che trasforma le pipeline in profitto e il rischio operativo in insight affidabili.
Time-to-insight più rapido
Uno dei vantaggi più immediati è la drastica accelerazione dell’intero ciclo di vita dei dati. Negli approcci tradizionali, il percorso da una domanda di business a una risposta basata sui dati è estenuante. DataOps supera questi colli di bottiglia grazie all’automazione e a una collaborazione più stretta.
Scenario: un’azienda retail vuole sapere come sta andando una promozione recente.
Senza DataOps: la richiesta resta sepolta nel backlog per settimane. Quando finalmente arriva il report, la promozione è finita da tempo e l’occasione per intervenire è persa.
Con DataOps: pipeline automatizzate alimentano il sistema con i dati di vendita in modo continuo. Gli analisti possono interrogare informazioni validate e aggiornate nel giro di poche ore, fornendo al team marketing un feedback immediato per decidere la mossa successiva.
Questa velocità fa sì che gli insight arrivino quando contano davvero, consentendo decisioni proattive invece di interventi correttivi a posteriori.
Qualità dei dati e fiducia solidissime
I dati di scarsa qualità erodono silenziosamente la fiducia, portando a decisioni sbagliate ed errori costosi. Un principio cardine di DataOps è costruire fiducia integrando test e monitoraggio continui direttamente nelle pipeline di dati.
Ciò significa che problemi come tabelle corrotte o dati obsoleti vengono segnalati automaticamente, molto prima che contaminino un report finanziario critico o una dashboard rivolta ai clienti. Quando chi decide sa di poter contare sui numeri, agisce con maggiore convinzione. Per aziende come digna, che pongono la data observability al centro, questo principio è la chiave per costruire un ecosistema di dati su cui le persone possano davvero fare affidamento.
Team più efficienti e innovativi
Infine, DataOps vi restituisce la risorsa più preziosa: le vostre persone. Quando data engineer e analisti passano le giornate a gestire emergenze, riparare pipeline guaste ed eseguire script manuali, non resta alcun tempo per l’innovazione.
Automatizzando tutto quel lavoro noioso e ripetitivo, DataOps consente al vostro team di concentrarsi su attività ad alto valore. Invece di limitarsi a mantenere tutto in funzione, può esplorare nuove fonti di dati, costruire modelli analitici avanzati e trovare modi nuovi per far sì che i dati facciano crescere il business. Questo cambiamento non rende il team solo più efficiente: ne migliora il morale e libera quella capacità di innovazione per cui lo avete assunto.
I primi passi per implementare DataOps
Avvicinarsi a DataOps non significa dover smantellare e sostituire l’intera architettura dei dati. Il modo migliore per iniziare è con azioni piccole e mirate che creino slancio.
Consideratelo una serie di successi rapidi. Partendo in piccolo potete dimostrare il valore dell’approccio, affinare i vostri metodi e ottenere il consenso necessario per estenderlo a tutta l’organizzazione.
Partire da una valutazione
Prima di tutto bisogna essere onesti su dove si trovano i problemi. Analizzate con attenzione il vostro ambiente dati attuale e individuate i colli di bottiglia principali che rallentano la consegna dei dati e minano la fiducia.
Sono gli interminabili test manuali? I passaggi di consegne lenti e faticosi tra i team? Oppure dovete continuamente spegnere incendi legati alla qualità dei dati?
Individuare questi problemi specifici vi offre un obiettivo chiaro per il vostro primo intervento DataOps. Non si tratta di sistemare tutto in una volta, ma di trovare quell’area ad alto impatto in cui automazione e collaborazione faranno subito la differenza. Il ciclo di implementazione inizia spesso con l’identificazione delle fonti di dati e dei colli di bottiglia attuali, poi chiarisce le esigenze di business e riunisce team cross-funzionali di data engineer, data scientist e IT operations. Da lì potete documentare i workflow con KPI misurabili e automatizzare acquisizione e validazione.
Formare il team pilota e scegliere gli strumenti
Non serve un grande team per iniziare. Riunite un piccolo gruppo cross-funzionale di persone motivate a risolvere il problema: di solito un data engineer, un analista e uno stakeholder di business che vive in prima persona le difficoltà del processo attuale.
Questo gruppo ristretto sarà responsabile del progetto pilota dall’inizio alla fine.
Poi scegliete gli strumenti giusti. Lo stack iniziale dovrebbe concentrarsi su tre aspetti: automazione, collaborazione e monitoraggio. Nei primi passi, valutate come strumenti specializzati, ad esempio una Web Scraping API for RAG, possano automatizzare l’acquisizione dei dati per analytics avanzate e applicazioni di AI, allineando gli strumenti agli obiettivi specifici del progetto pilota.
Il diagramma seguente mostra come un framework DataOps ben implementato produca risultati di business concreti.
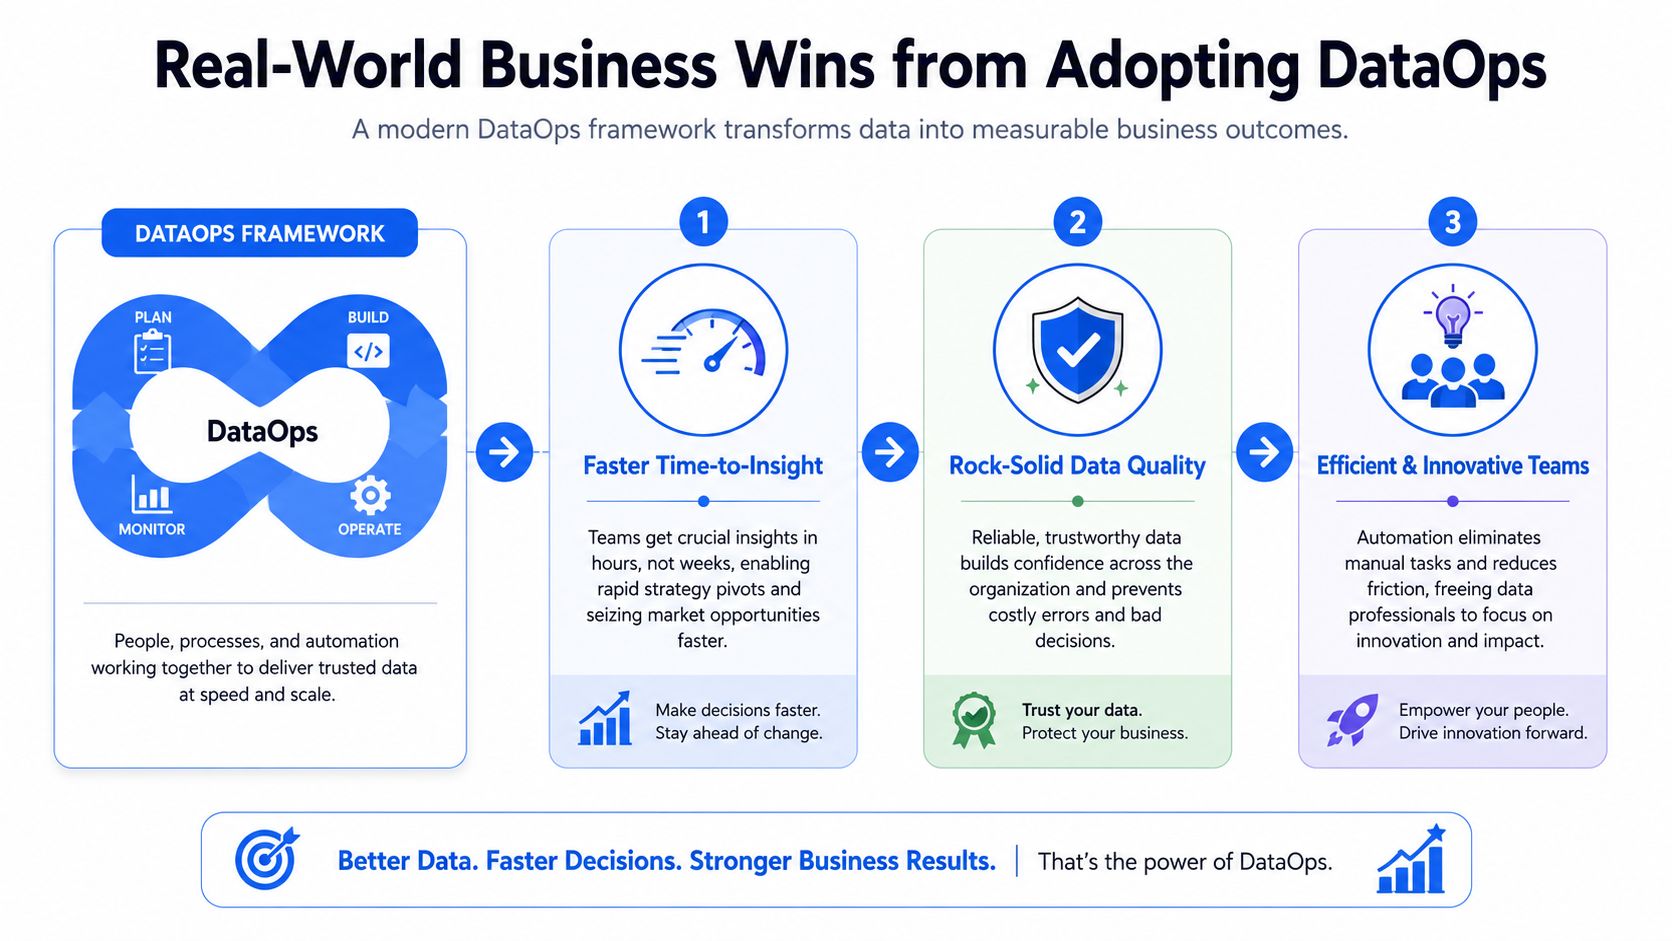
Insight più rapidi, dati affidabili e team più efficienti non sono semplici slogan: sono i risultati diretti dell’applicazione dei principi DataOps in modo mirato e consapevole.
Avviare, misurare e iterare
Con team e strumenti pronti, è il momento di partire. Scegliete una singola pipeline di dati ben definita e applicate le nuove pratiche DataOps. L’obiettivo è ottenere un successo rapido e visibile che dimostri che questo nuovo modo di lavorare vale la pena.
Il vostro progetto pilota è il vostro proof of concept. Il suo successo sarà l’argomento più convincente per estendere DataOps. Scegliete un progetto abbastanza piccolo da completarsi rapidamente, ma abbastanza significativo da farsi notare.
Una volta che il pilota è operativo, il lavoro non è finito. Dovete misurarne l’impatto. Iniziate a monitorare metriche chiave come:
Cycle time: quanto tempo serve per consegnare il data product dall’inizio alla fine?
Tasso di errore: quanti problemi di qualità dei dati intercettate prima che arrivino in produzione?
Efficienza del team: quanto lavoro manuale avete effettivamente risparmiato?
Usate questi dati per dimostrare il ROI e perfezionare il processo. Dopo un pilota di successo potete iniziare a estendere ciò che funziona, applicare le lezioni apprese ad altri progetti e ampliare gradualmente la vostra pratica DataOps. A supporto di questa espansione, potete consultare la nostra guida dettagliata sulla moderna architettura delle pipeline di dati.
Come la data observability alimenta il DataOps moderno
C’è un vecchio motto dell’ingegneria che vale in modo particolare per i dati: non si può gestire ciò che non si vede. Per DataOps, la pratica della data observability fornisce questa visibilità essenziale, trasformando i principi generali di agilità e affidabilità in una realtà concreta e quotidiana.
Senza di essa, un team DataOps procede sostanzialmente alla cieca. Non ha un modo affidabile per individuare automaticamente il degrado della qualità dei dati, intercettare modifiche impreviste dello schema o anche solo confermare che i dati siano arrivati in tempo. Le piattaforme di data observability colmano questa lacuna, fornendo monitoraggio, alerting e analisi delle cause radice che costituiscono la spina dorsale operativa di qualsiasi pratica DataOps solida.
Gli “occhi e le orecchie” della vostra pipeline di dati
Pensate a una piattaforma di data observability come digna come al sistema automatizzato di controllo qualità dell’intera vostra fabbrica di dati. Non si limita a esaminare il prodotto finale: monitora continuamente lo stato di salute delle pipeline su diverse dimensioni chiave, supportando direttamente i principi fondamentali di DataOps.
Freschezza: i vostri dati arrivano in tempo? Gli strumenti di observability tracciano i pattern di arrivo dei dati e avvisano i team in caso di ritardi, evitando che gli stakeholder prendano decisioni basate su report obsoleti.
Modifiche dello schema: un sistema sorgente ha improvvisamente aggiunto una nuova colonna o cambiato un tipo di dato? Piattaforme come digna rilevano automaticamente lo schema drift, proteggendo job e dashboard a valle da malfunzionamenti improvvisi.
Qualità dei dati: ci sono valori null inattesi, stringhe malformate o outlier statistici nei dati? Controlli di qualità automatizzati validano i dati mentre si spostano, intercettando i problemi molto prima che raggiungano un utente di business.
Volume: una fonte di dati chiave ha improvvisamente inviato 10 volte la quantità normale di dati, o non ne ha inviato affatto? Monitorare il volume dei dati e il numero di record aiuta i team a individuare guasti a monte o errori di elaborazione.
È questo che rende trasparenti i workflow di dati complessi, trasformando processi opachi in qualcosa di chiaro e gestibile.
Questo livello di dettaglio consente ai team di passare da una gestione reattiva e continua delle emergenze a una gestione proattiva e preventiva, obiettivo primario di qualsiasi organizzazione che adotti DataOps.
Collegare le funzionalità della piattaforma al successo di DataOps
La rapida adozione di queste piattaforme non sorprende, se si guardano i numeri. Il mercato globale della data observability, pilastro del DataOps moderno, è passato da 1,2 miliardi di dollari nel 2020 a una stima di 4,8 miliardi di dollari nel 2024. Questa crescita è una risposta diretta all’elevato costo dei problemi legati ai dati: il data downtime costa in media a un’organizzazione 1,7 milioni di dollari all’anno.
Offrendo un’unica vista d’insieme sullo stato di salute delle pipeline, gli strumenti di data observability automatizzano i cicli di monitoraggio e feedback richiesti da DataOps. Così risolvono problemi concreti come dashboard non funzionanti, modelli di AI inaffidabili e lacune di compliance emergenti.
In definitiva, l’obiettivo di DataOps è costruire e mantenere la fiducia nei dati della vostra organizzazione. Le piattaforme di data observability forniscono le basi tecniche per conquistare questa fiducia e mantenerla.
Domande frequenti su DataOps
Anche una volta compresa l’idea di base, quando i team si avvicinano per la prima volta a DataOps emergono sempre alcune domande pratiche. Affrontiamo le più comuni per fare chiarezza.
Qual è l’obiettivo principale di DataOps?
L’obiettivo numero uno di DataOps è ridurre drasticamente il tempo necessario per passare da un’idea a un data product affidabile. Si tratta di accorciare l’intero ciclo end-to-end.
Ma la velocità non è tutto. L’altro obiettivo, altrettanto importante, è farlo garantendo una qualità dei dati eccezionalmente elevata e affidabilità. Veloce ma sbagliato non serve a nulla.
Serve un grande team per iniziare con DataOps?
No, assolutamente no. È uno dei falsi miti più diffusi che frenano i team. Molti pensano che DataOps significhi fin da subito un enorme progetto a livello aziendale, ma le implementazioni migliori iniziano quasi sempre in piccolo.
Potete partire con un progetto pilota e un piccolo team cross-funzionale. Un ottimo punto di partenza include di solito:
Un data engineer che costruisca e gestisca la pipeline.
Un analista che comprenda davvero le esigenze del business.
Uno stakeholder di business che utilizzerà effettivamente i dati.
Questo approccio vi permette di dimostrare rapidamente il valore e di creare lo slancio necessario per un’adozione più ampia.
DataOps è fondamentalmente un cambiamento di processi e di cultura, non solo un insieme di strumenti. Gli strumenti sono abilitatori cruciali, ma la vera trasformazione nasce dall’adozione di collaborazione, automazione e miglioramento continuo. È un cambio di mentalità supportato dalla tecnologia, non definito da essa.
Comprendere questo è la chiave per fare le cose nel modo giusto. DataOps riguarda il cambiamento del modo in cui le persone lavorano insieme per fornire dati affidabili. Gli strumenti sono lì solo per servire questo scopo. Concentratevi prima sul processo e costruirete basi destinate a durare.
Pronti a potenziare la vostra pratica DataOps con un’observability di prima classe? Scoprite come digna può aiutarvi ad automatizzare i controlli di qualità, monitorare lo stato di salute delle pipeline e costruire una fiducia incrollabile nei vostri dati. Iniziate con digna.
Per vedere come il monitoraggio di freschezza, schema, volume e qualità si combini nel ciclo di feedback su cui si basa DataOps, esplorate la data platform observability con digna.
Domande frequenti
Che cos’è DataOps in parole semplici?
DataOps applica ai dati le lezioni del DevOps. È una metodologia basata su collaborazione, automazione e miglioramento continuo lungo l’intero ciclo di vita dei dati, che trasforma la analytics da un processo rigido, passo dopo passo, in una linea di produzione automatizzata. Una ricerca IBM citata nell’articolo la associa a una consegna dei dati più rapida del 40%.
In cosa DataOps è diverso da DevOps e MLOps?
La differenza sta nel prodotto finale. DevOps rilascia codice applicativo affidabile, DataOps fornisce dataset e analytics validati e MLOps mette in produzione modelli ML pronti all’uso. DataOps prende in prestito da DevOps CI/CD, test automatizzati e collaborazione, poi aggiunge monitoraggio e validazione costanti, perché i dati possono arrivare in ritardo, corrotti o ristrutturati.
Quali sono i principi fondamentali di DataOps?
Tre principi reggono la maggior parte del peso: automazione totale, CI/CD per le pipeline di dati e collaborazione intensa. In pratica, ogni modifica sottoposta a commit, come una nuova trasformazione SQL, viene testata automaticamente, le modifiche che superano i test vengono rilasciate in produzione e engineer, analisti e utenti di business condividono la responsabilità, così i problemi vengono ricondotti rapidamente alla loro origine.
Come si inizia a implementare DataOps?
Iniziate con una valutazione del vostro principale collo di bottiglia, che siano i test manuali, i passaggi di consegne lenti o le ricorrenti emergenze di qualità dei dati. Poi formate un team pilota composto da un data engineer, un analista e uno stakeholder di business, partite con una sola pipeline ben definita e monitorate cycle time, tasso di errore e lavoro manuale risparmiato.
Perché DataOps ha bisogno della data observability?
Senza observability, un team DataOps procede alla cieca. Piattaforme come digna monitorano freschezza, modifiche dello schema, qualità e volume dei dati, così dati in ritardo, schema drift, valori null inattesi o una fonte che invia improvvisamente 10 volte il suo volume normale vengono segnalati prima che gli utenti di business vedano dashboard non funzionanti o report obsoleti.


