Integrità referenziale tra database: come verificarla
|
6
min di lettura

I vostri ordini risiedono nel data warehouse. I clienti a cui fanno riferimento risiedono nel CRM, su un altro server, gestito da un altro team. Integrità referenziale tra database significa che ogni chiave in un sistema, come il numero cliente di un ordine, corrisponde a un record esistente nella tabella anagrafica di un altro sistema. Una foreign key non può garantirlo, perché una foreign key dichiarata in genere funziona solo all'interno di un unico database. Così, quando arriva un ordine con un numero cliente che il CRM non ha mai emesso, nulla va in errore. La riga viene caricata, un join la scarta e da qualche parte un report è silenziosamente sbagliato.
È la variante più difficile dell'integrità referenziale. All'interno di un database potete almeno dichiarare il vincolo; oltre il confine di un database, di un server o di un sistema non c'è nulla da dichiarare. Il concetto generale è trattato nel nostro articolo di riferimento I vostri dati trovano ancora i loro genitori? Capire l'integrità referenziale. Questo articolo tratta l'integrità referenziale tra sistemi: dove si rompe, quanto costano le soluzioni alternative più comuni, perché i formati delle chiavi generano falsi allarmi e come verificarla in digna senza copiare i dati anagrafici da nessuna parte.
Punti chiave
Una foreign key tra database in genere non è possibile: un vincolo dichiarato fa riferimento a tabelle dello stesso database, quindi i riferimenti tra sistemi sono per definizione non protetti.
Le soluzioni alternative più comuni (query federate, tabelle di riferimento copiate, lookup in fase di ETL, esportazioni per la riconciliazione) aggiungono spostamenti di dati, pipeline o lavoro manuale.
Le differenze di formato delle chiavi, come zeri iniziali, maiuscole/minuscole, riempimento con spazi e tipi di dati, creano falsi orfani. Concordate una forma canonica della chiave prima di confrontare.
Dalla Release 2026.01, digna Data Validation verifica l'integrità referenziale tra tabelle, viste, schemi e diverse connessioni di database all'interno dello stesso progetto, validando i dati dove risiedono.
La configurazione richiede pochi campi: colonne chiave, la data source in cui devono esistere, due soglie. Nessun SQL da scrivere.
Indice
Perché una foreign key non può proteggere un riferimento tra database?
Dove si rompono i riferimenti tra sistemi?
Anagrafica clienti nel CRM, transazioni nel warehouse
Anagrafica prodotti nell'ERP, ordini nel sistema ordini
Anagrafica pazienti ed episodi clinici
Core banking e warehouse di reporting
Come validano di solito i team i riferimenti tra sistemi?
Perché le differenze di formato delle chiavi creano falsi orfani?
Come si verifica l'integrità referenziale tra database in digna?
Quali riferimenti tra sistemi conviene verificare per primi?
Prossimo passo
Perché una foreign key non può proteggere un riferimento tra database?
Una foreign key non può proteggere un riferimento tra database perché è un vincolo che il motore applica alle proprie tabelle, cercando la riga referenziata nello stesso database a ogni insert, update e delete. Una foreign key dichiarata in genere non può puntare a una tabella in un altro database, server o prodotto, quindi non c'è nulla rispetto a cui verificare.
Alcuni motori consentono di eseguire query tra database, ma interrogare non significa vincolare. Un vincolo applicato tra sistemi richiederebbe che il sistema remoto fosse disponibile e coerente a ogni scrittura, mentre i sistemi separati esistono proprio perché uno continui a funzionare mentre l'altro è fermo, in migrazione o in fase di ricaricamento.
Il lato del warehouse peggiora le cose. Molte piattaforme analitiche accettano dichiarazioni di foreign key senza applicarle nemmeno all'interno di un unico database: Snowflake le descrive come facoltative e non applicate sulle tabelle standard, e BigQuery dichiara di non applicarle. Inoltre i sistemi cambiano in modo indipendente: il team CRM unisce clienti duplicati, l'ERP dismette un prodotto. Ogni modifica è valida nel proprio sistema e può comunque lasciare altrove record che puntano a chiavi non più esistenti.
Dove si rompono i riferimenti tra sistemi?
I riferimenti tra sistemi si rompono ovunque un sistema sia responsabile dei dati anagrafici e un altro registri l'attività: una tabella di transazioni che fa riferimento a un cliente, un prodotto, un paziente o un conto gestito altrove, da un altro team, con un proprio ciclo di rilascio e proprie regole per unire e dismettere le chiavi. Quattro situazioni si ripresentano di continuo.
Anagrafica clienti nel CRM, transazioni nel warehouse
Il team sales operations gestisce i clienti nel CRM; gli ordini vengono caricati nel warehouse ogni notte. Quando due record del CRM vengono uniti, un ID scompare. Gli ordini nel warehouse lo riportano ancora, e i ricavi per cliente, segmento o regione perdono silenziosamente delle righe.
Anagrafica prodotti nell'ERP, ordini nel sistema ordini
Un nuovo prodotto viene messo in vendita prima che il record anagrafico dell'ERP sia rilasciato, oppure un prodotto fuori produzione viene rimosso mentre ordini aperti vi fanno ancora riferimento. Le righe d'ordine senza un prodotto corrispondente scompaiono dai report su margini e scorte.
Anagrafica pazienti ed episodi clinici
Gli ospedali gestiscono l'identità dei pazienti in un'anagrafica pazienti, spesso un master patient index, e registrano ricoveri, richieste di esami di laboratorio e farmaci nei sistemi clinici. Quando pazienti duplicati vengono uniti, gli episodi che fanno ancora riferimento all'ID dismesso perdono il loro paziente, con effetti sulla fatturazione e sul reporting clinico.
Core banking e warehouse di reporting
Conti e clienti risiedono nel sistema di core banking. Il reporting gestionale e regolamentare gira su un warehouse separato alimentato da diversi sistemi sorgente. Un movimento che fa riferimento a un conto assente dalla dimensione conti del reporting viene escluso dai totali oppure finisce in un contenitore "sconosciuto". Approfondiamo questo caso in integrità referenziale nei dati bancari.
Come validano di solito i team i riferimenti tra sistemi?
Di solito i team validano i riferimenti tra sistemi in uno di quattro modi: interrogano la tabella remota tramite un linked server, un database link o una query federata; copiano la tabella di riferimento nel sistema di destinazione; cercano le chiavi durante l'ETL; oppure esportano le chiavi da entrambi i lati e le riconciliano periodicamente. Ognuno funziona, e ognuno ha un costo.
Il controllo sottostante è sempre lo stesso anti-join. Se entrambe le tabelle fossero raggiungibili da un unico motore, sarebbe così:
Le soluzioni alternative differiscono nel modo in cui rendono crm.customers raggiungibile dal sistema che contiene sales_orders:
Approccio | Come funziona | Quanto costa |
|---|---|---|
Linked server, database link, query federate | Un motore interroga direttamente la tabella remota ed esegue il join | Entrambi i sistemi devono essere attivi al momento della query; i join di grandi dimensioni attraverso la rete sono lenti e caricano la sorgente; le credenziali del sistema remoto sono memorizzate nel database; spesso bloccati tra zone di rete diverse |
Copiare la tabella di riferimento nel warehouse | Una pipeline replica la tabella anagrafica accanto alle transazioni | Una pipeline in più da costruire e gestire; il controllo è aggiornato solo quanto l'ultima copia; un'ulteriore copia dei dati anagrafici, spesso dati personali, solleva questioni di protezione e di residenza dei dati |
Lookup in fase di ETL | Il job di caricamento cerca ogni chiave e scarta o segnala le righe senza corrispondenza | Copre solo i dati che passano per quella pipeline; verifica una sola volta al caricamento, quindi le successive eliminazioni e unioni nell'anagrafica passano inosservate; le tabelle di scarto si accumulano senza che nessuno le legga |
Esportazioni periodiche per la riconciliazione | Gli elenchi di chiavi di entrambi i sistemi vengono esportati in file e confrontati | Manuali e poco frequenti; i risultati arrivano settimane dopo l'errore; i file con le chiavi circolano via e-mail o su unità condivise |
Nessuno di questi approcci è sbagliato, ma condividono un problema: o i dati si spostano, oppure qualcuno deve ricordarsi di eseguire qualcosa. Ciò che serve è un controllo pianificato che legga ciascun lato dove risiede e indichi al team responsabile quali record sono orfani.
Perché le differenze di formato delle chiavi creano falsi orfani?
Le differenze di formato delle chiavi creano falsi orfani perché due sistemi possono memorizzare la stessa chiave di business in forme diverse: come testo in uno e come numero nell'altro, con o senza zeri iniziali, con maiuscole/minuscole diverse o con spazi finali. Un confronto byte per byte segnala allora un padre mancante che in realtà esiste.
È il motivo più comune per cui un primo controllo tra sistemi segnala migliaia di errori:
Differenza | Sistema A | Sistema B |
|---|---|---|
Zeri iniziali |
|
|
Maiuscole/minuscole |
|
|
Riempimento e spazi |
|
|
Conversioni di tipo |
|
|
Prefissi di sistema |
|
|
Risolvetelo in tre passaggi:
Concordate una forma canonica per la chiave, ad esempio una stringa senza spazi, in maiuscolo e riempita fino a dieci cifre.
Normalizzate uno o entrambi i lati in quella forma in una vista o in un'istruzione SQL, vicino alla sorgente.
Verificate che la chiave anagrafica normalizzata sia ancora univoca. Eliminare zeri o uniformare maiuscole e minuscole può far confluire due chiavi diverse in una sola, nascondendo orfani reali.
Una query di normalizzazione si presenta così (i nomi delle funzioni variano leggermente tra i database):
Non eliminate con la normalizzazione differenze reali. Se un prefisso indica quale sistema sorgente ha emesso la chiave, una chiave composta da sistema sorgente e numero è più sicura che rimuovere il prefisso.
Come si verifica l'integrità referenziale tra database in digna?
In digna, un controllo di integrità referenziale tra database è una regola di Data Validation di tipo Referential Integrity il cui lato "must exist in" punta a una data source su un'altra connessione di database dello stesso progetto. Dalla Release 2026.01 valida i dati dove risiedono, senza replicare nessuna delle due tabelle nell'altro sistema.
Due novità della release 2026.01 lo rendono possibile. I controlli di integrità referenziale funzionano tra tabelle e viste, tra schemi e tra diverse connessioni di database all'interno di un progetto. Inoltre una data source è un livello logico basato su una tabella, una vista o un'istruzione SQL personalizzata, il che offre un punto in cui gestire i formati delle chiavi: una data source con SQL personalizzato può eliminare gli spazi, convertire o riempire la chiave prima del confronto, proprio come la query precedente. Testate questa normalizzazione su dati reali prima di farvi affidamento. Le connessioni di database sono globali, quindi una connessione CRM configurata una volta può essere riutilizzata da ogni progetto.
La regola si configura in un'unica finestra di dialogo:
Andate in Configuration, selezionate la data source che contiene le righe referenzianti, aprite la scheda Data Validation e fate clic su Add Rule. Si apre la finestra di dialogo Add Data Validation Rule.
Inserite un Name e una Description che indichi che cosa deve essere vero, ad esempio "Ogni ordine fa riferimento a un cliente presente nell'anagrafica del CRM".
Impostate Type su Referential Integrity.
In Attributes, scegliete la colonna o le colonne chiave di questa data source.
In must exist in, scegliete la Data Source di destinazione, che può trovarsi su un'altra connessione, e i relativi Attributes corrispondenti. Per una chiave composta, scegliete le colonne su entrambi i lati nello stesso ordine.
Scegliete un Threshold Mode (Absolute o Relative) e impostate l'Info threshold e il Warn threshold.
Salvate. La regola viene eseguita a ogni ispezione della data source, pianificata o su richiesta.
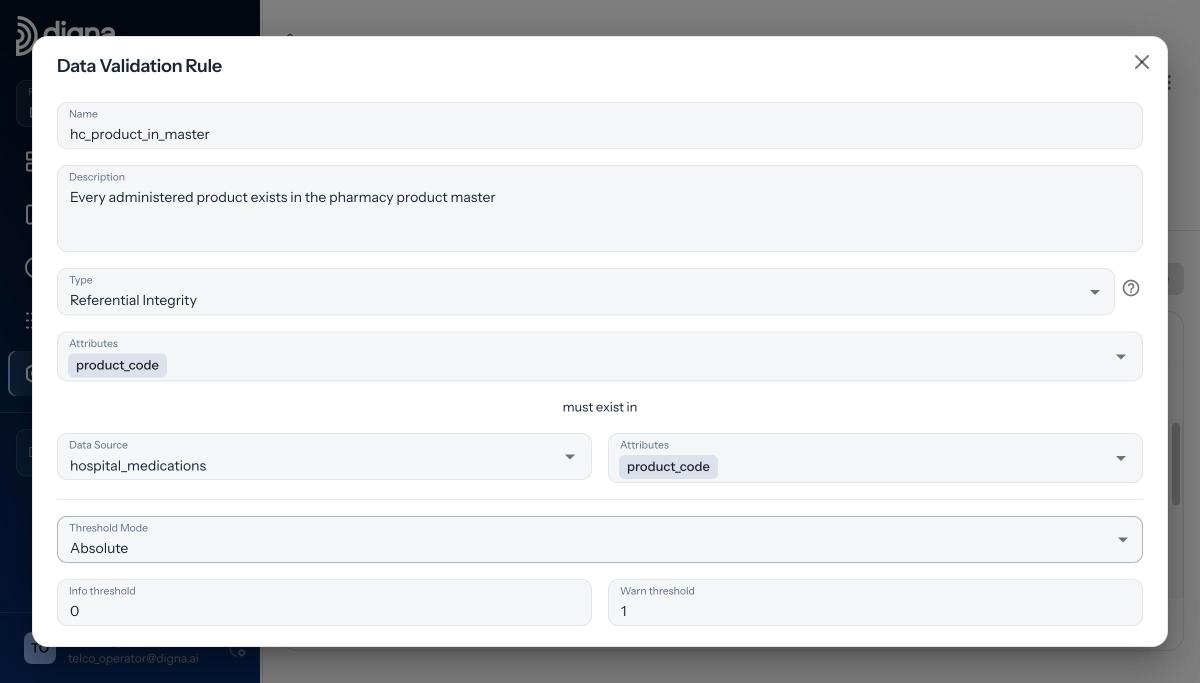
La regola di integrità referenziale in digna: product_code deve esistere nella data source hospital_medications.
Gli screenshot provengono dal nostro progetto demo, in cui entrambe le data source si trovano sulla stessa connessione. La finestra di dialogo è identica quando la data source di destinazione si trova su un'altra connessione: la scegliete in "must exist in" come qualsiasi altra data source. La demo usa dati fittizi di Danubia Kliniken, un gruppo ospedaliero austriaco inventato.
La regola hc_product_in_master stabilisce che ogni prodotto somministrato deve esistere nell'anagrafica prodotti della farmacia. Il 2026-04-22 i reparti hanno registrato 82 somministrazioni di "Coavira 2.5 mg" (codice prodotto 3858646) prima che il prodotto fosse aggiunto all'anagrafica. Ogni report che collegava le dosi ai prodotti mostrava zero dosi del nuovo prodotto, mentre gli infermieri ne avevano somministrate 82.
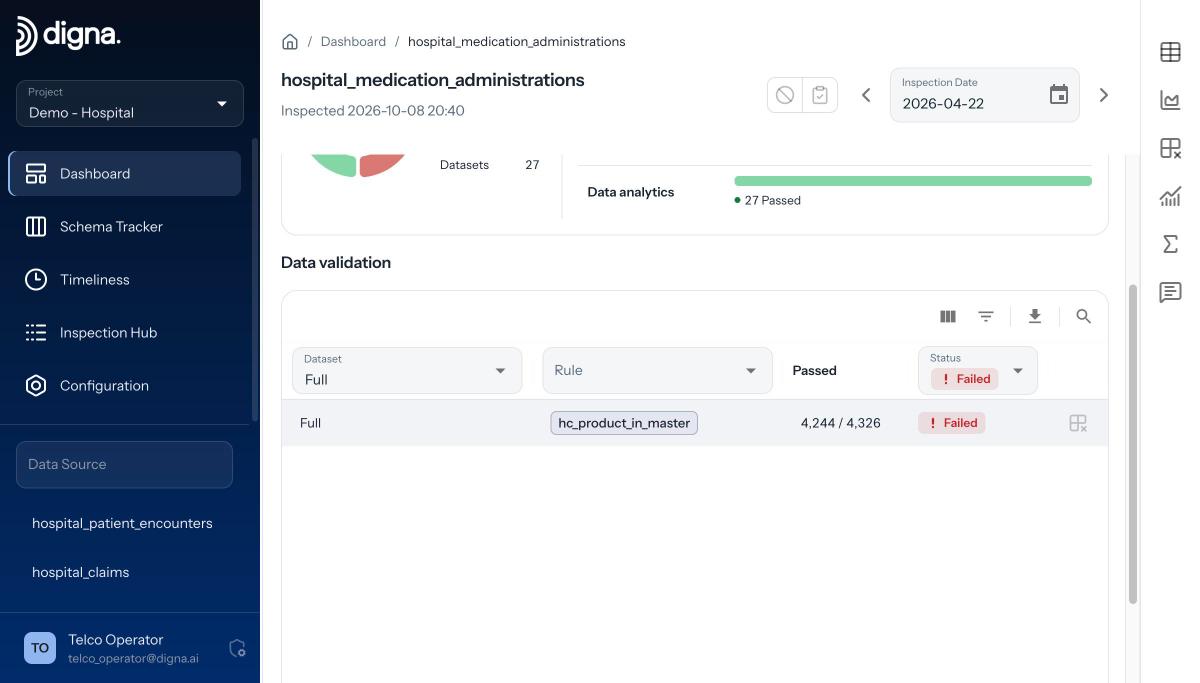
Il risultato del 2026-04-22: 4.244 righe su 4.326 superate, 82 non superate, stato Failed.
digna riporta per ogni regola il numero di record superati e non superati e restituisce i record non conformi stessi: la stessa query con la condizione di superamento negata. Nella vista Invalid Records filtrate per Passed, Uncertain o Failed, scegliete il controllo e vedete le righe, qui con ospedale, reparto, codice prodotto e nome del farmaco. Potete esportarle e avvisare il team responsabile dei dati.
Alcuni comportamenti sono importanti per i controlli tra sistemi:
Le soglie sono zero per impostazione predefinita, quindi una nuova regola non viene superata anche con un solo orfano. Se è noto che l'anagrafica è in ritardo di qualche ora rispetto alle transazioni, alzate l'Info threshold in modo che un piccolo conteggio risulti Uncertain anziché Failed, oppure usate la modalità Relative.
Le chiavi NULL vengono ignorate. Un numero cliente mancante non fa fallire il controllo referenziale. Se la chiave è obbligatoria, aggiungete una Rule separata come
customer_no IS NOT NULL.Gli elenchi di colonne devono avere la stessa lunghezza. Una differenza viene respinta anziché verificare silenziosamente una condizione più debole.
I controlli vengono eseguiti all'interno dei database sorgente. digna invia SQL e riceve conteggi, più le righe non conformi quando le richiedete. I vostri dati non lasciano mai la vostra infrastruttura.
Per la procedura completa con ogni campo, consultate come configurare un controllo di integrità referenziale. I tipi di regola, le soglie e le viste dei risultati sono descritti nella pagina digna Data Validation e nella documentazione.
Quali riferimenti tra sistemi conviene verificare per primi?
Verificate per primi i riferimenti tra sistemi che alimentano report su cui le persone agiscono, e quelli i cui dati anagrafici vengono regolarmente uniti, rinumerati o dismessi, perché è lì che un orfano si trasforma direttamente in un numero sbagliato. Iniziate con poche regole e ampliate il perimetro una volta gestiti i falsi orfani dovuti al formato delle chiavi.
Un ordine pratico per la validazione dei dati anagrafici tra sistemi:
Transazioni rispetto all'anagrafica clienti, conti o pazienti, perché lì unioni e chiusure avvengono di continuo.
Righe d'ordine e movimenti di magazzino rispetto all'anagrafica prodotti, perché i nuovi prodotti vengono spesso venduti prima che il record anagrafico sia completo.
Codici di riferimento (paese, valuta, centro di costo) rispetto al sistema responsabile dell'elenco dei codici.
Affiancate a ogni regola referenziale una regola di Uniqueness sulla chiave anagrafica: un controllo referenziale su un'anagrafica con chiavi duplicate può essere superato anche se i dati sono comunque sbagliati.
Prossimo passo
Le foreign key si fermano al confine del database, e molti dei dati che contano lo attraversano. Non vi serve un'altra pipeline per validare i riferimenti tra sistemi: una regola Referential Integrity per ogni relazione, eseguita dove risiedono i dati, mostra dopo ogni ispezione quali record hanno perso il loro padre. Se volete vederlo all'opera sul vostro ambiente, prenotate una demo con il team di digna.
Domande frequenti
È possibile creare una foreign key tra database?
In genere no. Una foreign key dichiarata fa riferimento a una tabella dello stesso database, perché il motore la verifica a ogni insert, update e delete. Tra database, server o prodotti diversi non c'è nulla da dichiarare, quindi i riferimenti tra sistemi devono essere validati da un controllo pianificato, come un anti-join o una regola di integrità referenziale.
Come si verifica l'integrità referenziale tra due database diversi?
Eseguite un anti-join che restituisca le chiavi della tabella referenziante senza corrispondenza nella tabella anagrafica. Di solito i team rendono raggiungibili entrambe le tabelle tramite query federate, tabelle di riferimento copiate, lookup in fase di ETL o esportazioni per la riconciliazione. In digna, una regola Referential Integrity può puntare a una data source su un'altra connessione, senza replicare dati.
Perché un controllo tra sistemi segnala orfani che in realtà esistono?
Di solito perché i formati delle chiavi sono diversi. Un sistema memorizza '0004711' come testo, l'altro 4711 come intero, e maiuscole/minuscole, spazi finali o prefissi di sistema causano gli stessi falsi orfani. Concordate una forma canonica, normalizzate la chiave in una vista o in un'istruzione SQL e verificate che la chiave anagrafica normalizzata sia ancora univoca.
digna copia la tabella anagrafica per confrontare le chiavi tra connessioni?
No. Dalla Release 2026.01, digna verifica l'integrità referenziale tra tabelle, viste, schemi e connessioni di database di un progetto senza replicare dati. I controlli vengono eseguiti all'interno dei vostri database: digna invia SQL e riceve conteggi, più le righe non conformi quando le richiedete. I vostri dati non lasciano mai la vostra infrastruttura.
Le foreign key NULL fanno fallire un controllo di integrità referenziale in digna?
No. Le regole Referential Integrity ignorano i NULL, quindi una riga con numero cliente vuoto non viene conteggiata come orfana. Quando la chiave è obbligatoria, aggiungete una Rule separata con una condizione come customer_no IS NOT NULL, così che chiavi mancanti e chiavi senza corrispondenza vengano segnalate come due problemi distinti.


