Conformità dei dati sanitari nel 2026: strategie chiave
|
9
min di lettura

Nel 2024 la sanità statunitense ha registrato 663 grandi violazioni di dati che hanno esposto informazioni sanitarie protette di quasi 243 milioni di persone, cioè circa tre quarti della popolazione degli Stati Uniti in un solo anno (statistiche sulla compliance sanitaria). Una scala del genere cambia subito i termini del discorso. La conformità dei dati sanitari non è un adempimento burocratico: è un problema di controllo operativo, che decide se una singola credenziale compromessa, un backup instradato male o una pipeline guasta diventano un evento da notificare.
I team che gestiscono bene questo tema smettono di trattare la compliance come una checklist legale e iniziano a trattarla come infrastruttura dati. Progettano contemporaneamente per identità, lineage, conservazione, verificabilità e validazione, perché oggi le PHI attraversano data warehouse, data lake, stack MLOps e percorsi di cloud ibrido, dove una policy limitata al solo storage non copre più il rischio rilevante.
Indice
Perché la conformità dei dati sanitari è ormai un problema di data engineering
Rischi di compliance nascosti nelle pipeline di dati moderne
Usare la Data Observability per automatizzare il monitoraggio della compliance
Checklist di implementazione per la conformità dei dati sanitari
Perché la conformità dei dati sanitari è ormai un problema di data engineering
Gli incidenti di sicurezza continuano a mostrare lo stesso schema, e quello schema è operativo, non astratto. Le statistiche sulla compliance sanitaria indicano che attacchi informatici e incidenti IT hanno causato l'81% di tutte le grandi violazioni sanitarie segnalate all'HHS OCR, coinvolgendo oltre 241,5 milioni di persone. Un'esposizione di questo tipo non nasce solo da una lacuna nelle policy. Nasce da un controllo debole su pipeline, permessi, replica e monitoraggio.
Il vecchio modello si rompe quando i dati continuano a muoversi
I programmi di compliance classici sono stati costruiti attorno a posizioni di storage, ruoli utente e cicli di revisione annuali. Quel modello fallisce non appena le stesse PHI finiscono in un data warehouse, vengono trasformate per una dashboard, alimentano un feature store di AI e poi vengono copiate in una pipeline di reporting regionale. Una checklist può confermare che la crittografia esiste, ma non vi dirà se il modello a valle sta ancora vedendo record obsoleti, sovraesposti o riutilizzati in modo improprio.
Regola pratica: se un controllo non riesce a seguire il record attraverso ingestion, trasformazione, replica ed export, non è un vero controllo.
Oggi la compliance sanitaria richiede una mentalità da problema di control plane. I team devono combinare crittografia, identità, logging, conservazione e validazione, in modo che le PHI restino governate su database, backup e integrazioni, non solo a livello applicativo (checklist pratica di sicurezza). Ho visto audit fallire perché un team aveva un sistema sorgente sicuro, ma nessuna risposta affidabile su cosa fosse successo dopo che il record era stato copiato negli analytics.
Oggi la compliance deve reggere all'AI e agli analytics
Il problema più difficile è capire se qualcuno ha usato i dati in un modo che il sistema non può dimostrare fosse consentito. La letteratura recente sugli analytics sanitari inquadra la compliance come un requisito di classificazione, de-identificazione, storage sicuro, verificabilità, consenso e governance applicabile a livello tecnico all'interno dei workflow di data engineering (rassegna sugli analytics medici e sanitari). È esattamente ciò che succede nella pratica. Training set di AI, dashboard trasversali ai sistemi e reporting federato creano tutti percorsi di riutilizzo nascosti.
Molti team parlano ancora della conformità dei dati sanitari come se si esaurisse nelle basi dell'HIPAA. Non è così. Quando la pipeline esegue generazione di feature, arricchimento e consegna in tempo reale, la domanda centrale diventa se ogni trasformazione può essere spiegata, validata e tracciata. È una disciplina di ingegneria, e le organizzazioni che lo riconoscono presto di solito passano meno tempo a ricostruire la storia in seguito.
Le pipeline moderne creano anche problemi di qualità dei dati che si trasformano rapidamente in problemi di compliance. Matching scadente, identificativi incoerenti, lineage mancante e dati di riferimento obsoleti possono spingere le PHI nel posto sbagliato o esporre dati al job sbagliato. Il modo in cui si fallisce nella pratica non è sempre una violazione clamorosa. Spesso è una rottura silenziosa di un controllo che emerge solo quando un auditor, un medico o il responsabile di un modello chiede da dove provenga un record e perché si trovasse lì. Un esempio utile di come questi errori emergano nei workflow sanitari fortemente basati sull'AI è descritto nella panoramica di digna sulle sfide della qualità dei dati sanitari e sulle soluzioni di AI.
Tradurre il quadro normativo in requisiti operativi
La compliance sanitaria abbraccia più di un framework, e l'errore che vedo più spesso è trattare quei framework come testi legali astratti invece che come requisiti di sistema. Una guida alla compliance dei dati sanitari del 2024 colloca HIPAA, GDPR e PCI DSS nello stesso ambito operativo, insieme a valutazione del rischio e risposta agli incidenti. Questo è importante perché i controlli si sovrappongono, ma non perfettamente.
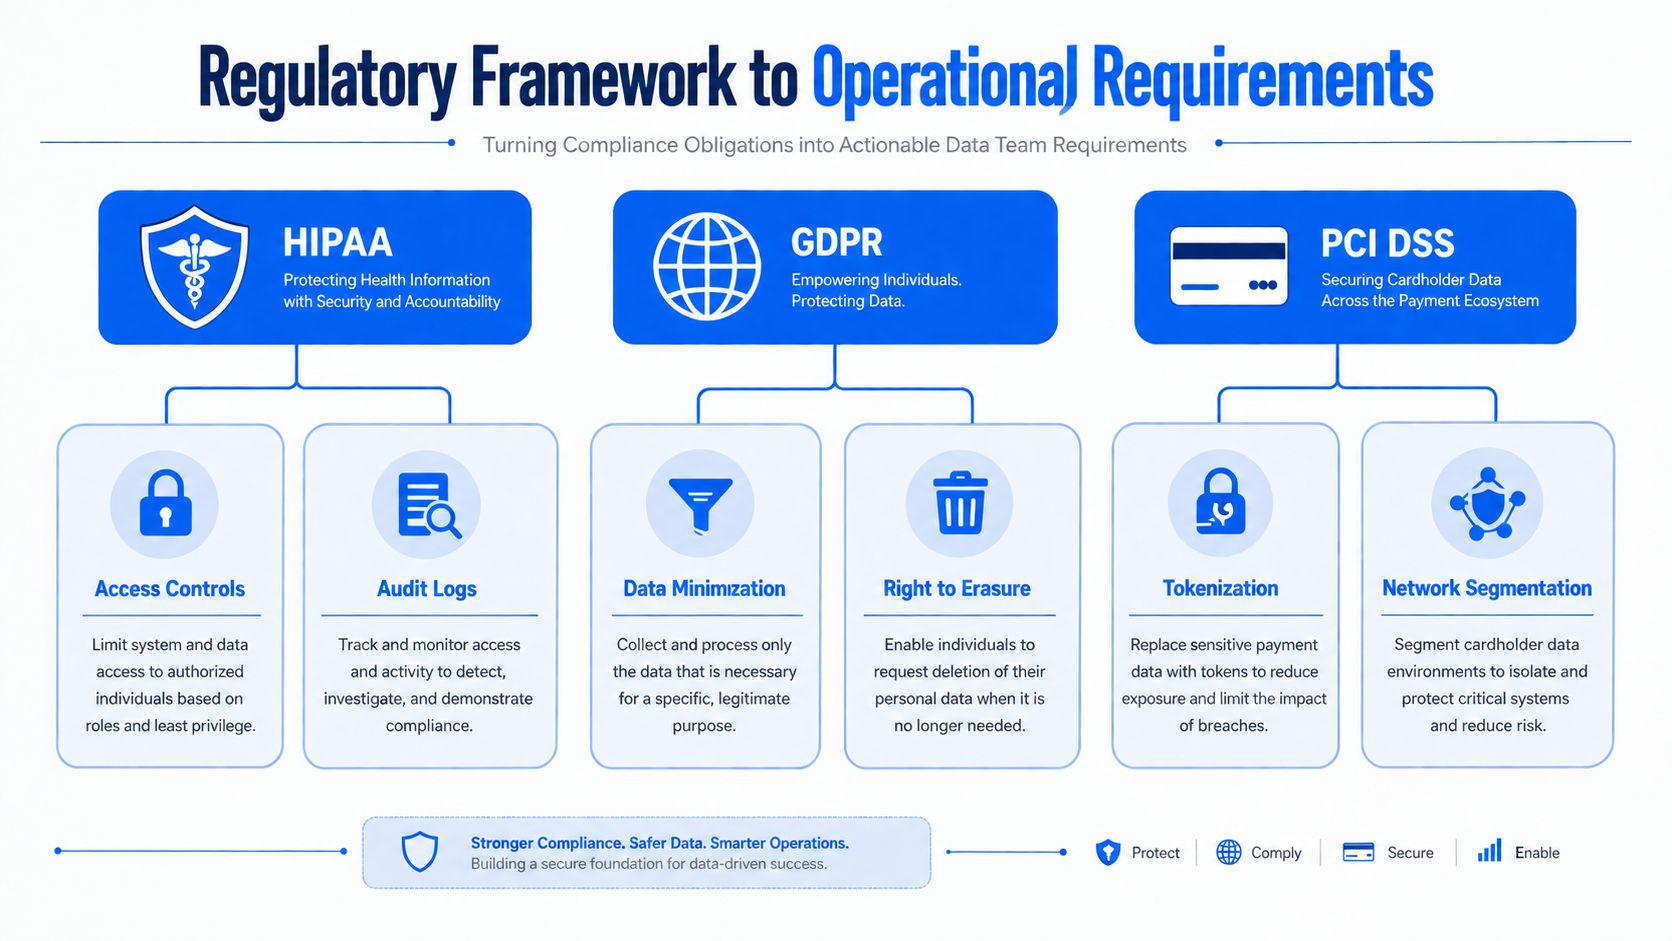
Una pipeline che sulla carta sembra conforme può comunque cedere ai margini, soprattutto quando regole cliniche, logica di validazione e analytics a valle iniziano ad agire sugli stessi record. I team che lavorano con la validazione dei dati sanitari e regole cliniche e normative su larga scala di solito scoprono la stessa cosa che ho visto negli audit: la policy deve diventare un controllo a runtime se si vuole che regga sotto traffico reale.
HIPAA trasforma le policy in controlli di workflow
In base alla HIPAA Privacy Rule dell'HHS statunitense, le covered entity hanno generalmente bisogno di un'autorizzazione scritta per usi o divulgazioni di PHI che esulano da cura, pagamento, operazioni sanitarie o un'altra autorizzazione prevista. Ciò significa che la vostra pipeline ha bisogno di più di una tabella di permessi. Servono tracciamento del consenso, accesso basato sulla finalità e un modo per separare la cura ordinaria dall'uso secondario.
La stessa norma prevede che le persone possano chiedere limitazioni a determinati usi e divulgazioni, anche se la covered entity non è obbligata ad accettarle. A livello operativo, questo crea vere diramazioni nel flusso di dati. Alcuni record devono essere instradati in modo diverso, conservati in modo diverso o esclusi da determinati estratti in base alla finalità approvata.
Nemmeno le sanzioni penali previste dalla norma sono teoriche. L'HHS afferma che le sanzioni penali possono arrivare fino a 50.000 dollari e un anno di reclusione per chi ottiene o divulga consapevolmente informazioni sanitarie identificabili in violazione della Privacy Rule (HIPAA Privacy Rule dell'HHS). Ecco perché la progettazione del controllo degli accessi non può essere approssimativa.
GDPR e PCI DSS corrispondono ad aspettative tecniche diverse
Il GDPR spinge i team verso la minimizzazione dei dati, informative chiare, registri dei trattamenti e limitazione della finalità, mentre il PCI DSS aggiunge controlli su tokenizzazione e segmentazione di rete quando i dati di pagamento si trovano in prossimità delle operazioni sanitarie. Una guida britannica sulla privacy in ambito sanitario sottolinea inoltre la necessità di nominare un Data Protection Officer dove richiesto, mantenere aggiornate le informative privacy, documentare i registri delle attività di trattamento, crittografare i dati at rest e in transito e usare controlli di accesso basati sui ruoli con revisioni periodiche degli accessi. Non sono attività burocratiche. Sono ruoli, log e revisioni che devono esistere in produzione.
La compliance funziona quando la policy diventa un controllo che una piattaforma può applicare automaticamente.
La mossa pratica è associare ogni normativa a una capacità, non a uno slogan. Gestione del consenso, limitazione degli accessi, crittografia, conservazione ed evidenze di audit devono essere visibili nello stack dati stesso. I programmi più puliti lo fanno una volta e riutilizzano lo schema in tutte le giurisdizioni. È anche il punto in cui i team che gestiscono workflow di cura multi-sistema finiscono per chiedere indicazioni operative a partner come i consigli di Clarity sul ciclo di fatturazione per la salute comportamentale, perché l'intento normativo conta solo se la pipeline è in grado di dimostrarlo end-to-end.
Rischi di compliance nascosti nelle pipeline di dati moderne
I controlli più ovvi raramente sono i primi a cedere. Le pipeline sanitarie moderne si rompono in modi più silenziosi, soprattutto quando i dati passano attraverso data lake, cloud multi-region, job di training di AI e dashboard operative. Pubblicazioni recenti sulla sicurezza in sanità sottolineano che questi ambienti spostano dati tra reti ospedaliere, data center regionali e più cloud provider quasi in tempo reale, il che rende essenziali visibilità, IAM, segmentazione, risposta agli incidenti e monitoraggio continuo (rassegna sulla sicurezza in sanità). La sola crittografia non dice chi ha usato i dati, dove sono finiti o se l'output rispetta ancora la finalità consentita.
Drift silenzioso e modifiche di schema causano danni alla compliance
Quando gli input di un modello subiscono un drift senza che nessuno se ne accorga, il problema non è solo l'accuratezza. Un workflow di compliance può iniziare ad approvare decisioni basate su record che non corrispondono più alla struttura validata o ai valori attesi. Le modifiche di schema creano lo stesso problema. Un campo viene rinominato, un code set cambia o una colonna delle unità di misura inizia a contenere valori incoerenti, e i validatori a valle non scattano mai perché nessuno li ha integrati nella pipeline.
È qui che la validazione a livello di record diventa critica. Le indicazioni degli esperti raccomandano di applicare l'autorizzazione a livello di oggetto e di record su ogni richiesta, registrare ogni accesso alle PHI e conservare quei log in archivi append-only, perché il solo accesso basato sui ruoli non ferma un'esposizione di tipo IDOR quando gli utenti possono interrogare oggetti paziente arbitrari (standard di validazione dei dati per la compliance sanitaria). La stessa logica vale per le pipeline. Un sistema può essere “autenticato” e comunque sbagliato.
Se cercate una prospettiva pratica sul lato del ciclo di fatturazione di questo problema, i consigli di Clarity sul ciclo di fatturazione per la salute comportamentale ricordano utilmente che i dati errati si propagano in rimborsi negati, pagamenti ritardati e lavoro di pulizia che in superficie sembra amministrativo, ma spesso nasce da un errore di validazione a monte.
Il riutilizzo non tracciato è il problema più difficile da individuare
Il problema di compliance più pericoloso spesso non è una violazione, ma un secondo utilizzo non documentato. I dati arrivano in un sistema per l'erogazione delle cure, vengono copiati in un data mart analitico e poi riutilizzati in un modello o in un report senza un lineage duraturo che risalga al consenso originale o alla limitazione di finalità. È particolarmente rischioso nelle pipeline di AI e analytics, dove lo stesso record può essere trasformato molte volte prima che qualcuno noti la lacuna di governance.
Ho visto team convinti che accesso basato sui ruoli e storage crittografato fossero sufficienti. Non lo erano. Una volta che esiste un dataset a valle, ogni export, merge e replay aggiuntivo crea un'ulteriore occasione per violare la limitazione della finalità o perdere la traccia di evidenze necessaria in seguito.
Punto chiave: se non siete in grado di spiegare dove un record PHI è stato copiato, trasformato e consumato, la vostra compliance non è difendibile.
Un'ultima considerazione pratica. Se il vostro team si occupa di rimborsi negati o eccezioni nel ciclo di fatturazione, guide operative come quella sugli armadi conformi SEFA di Labs USA si collocano fuori dallo stack software ma rafforzano lo stesso principio: storage controllato e accesso controllato funzionano solo quando il workflow viene applicato. La compliance sanitaria fallisce quando ci si affida alle intenzioni invece che alla strumentazione.
Controlli tecnici per la sicurezza dei dati sanitari
I controlli che reggono negli audit sono di solito noiosi, specifici e stratificati. Una baseline pratica per le piattaforme sanitarie parte da AES-256 per i dati at rest, TLS 1.3 per i dati in transito, gestione centralizzata delle chiavi in un KMS/HSM con rotazione e copie di backup offsite immutabili basate su una strategia 3-2-1. L'obiettivo è semplice: una credenziale, un bucket di storage o una replica compromessi non devono esporre PHI recuperabili o materiale crittografico.

Costruire controlli che resistono a una compromissione parziale
La crittografia è necessaria, ma non esaurisce il discorso sui controlli. Le chiavi richiedono gestione centralizzata, rotazione controllata e una collocazione separata dallo stesso piano di storage dei dati. Anche i backup devono essere immutabili, o almeno abbastanza resilienti da impedire che un ambiente primario compromesso riscriva i punti di ripristino senza essere rilevato.
Una solida strategia di backup significa trattare le copie di backup come PHI governate, non come copie operative di risulta. Se il percorso di ripristino è veloce ma la catena di backup è esposta, il rischio si è solo spostato. Nelle revisioni di progetto faccio una sola domanda: se si perde la region primaria e viene rubata una credenziale, cosa resta ancora segreto?
Gli audit trail devono essere utili, non decorativi
Le indicazioni che sopravvivono alle revisioni reali sono semplici: registrare ogni accesso alle PHI con utente, paziente, timestamp e azione, poi conservare quei log in sistemi append-only (standard di validazione dei dati per la compliance sanitaria). È il minimo necessario per ricostruire chi ha toccato cosa e quando. Se i log sono modificabili, sepolti o strutturati in modo incoerente, non saranno d'aiuto durante un audit o l'analisi di un incidente.
La validazione dei dati appartiene allo stesso insieme di controlli. Codici clinici standardizzati, campi mancanti e unità di misura anomale dovrebbero essere verificati automaticamente, perché i valori errati non si limitano a distorcere i report: possono anche spezzare la traccia di evidenze che dimostra che la pipeline si è comportata come previsto. La storia dell'audit diventa più pulita quando la validazione si trova nel percorso dei dati invece che in una revisione separata su foglio di calcolo.
Regola pratica: registrate l'azione nel momento in cui il record viene consultato, non più tardi quando qualcuno si ricorda di riepilogarla.
L'autorizzazione deve avvenire a livello di record
L'accesso basato sui ruoli resta utile, ma è troppo grossolano per i carichi di lavoro sanitari sensibili. Un medico, un analista o un utente del supporto può avere un ruolo legittimo e comunque non essere autorizzato a interrogare ogni oggetto paziente. Per questo l'autorizzazione a livello di oggetto e di record deve avvenire su ogni richiesta, soprattutto nei sistemi che espongono API o object store.
I design più solidi fanno sì che i controlli di accesso e i controlli di validazione sembrino parte dello stesso contratto. La richiesta soddisfa identità, finalità e ambito dell'oggetto, oppure non procede. Una struttura del genere è più difficile da costruire, ma molto più facile da difendere.
Usare la Data Observability per automatizzare il monitoraggio della compliance
L'osservabilità trasforma la compliance da revisione periodica a controllo continuo. È importante perché le pipeline moderne non falliscono secondo un calendario ordinato. Falliscono per caricamenti in ritardo, schema drift, join rotti, trend volatili e violazioni di regole che diventano visibili solo dopo che qualcuno ha preso una decisione sbagliata sulla base dell'output. La letteratura recente sugli analytics sanitari sostiene che la compliance oggi deve coprire classificazione, de-identificazione, storage sicuro, verificabilità, consenso e governance applicabile nei workflow di ingegneria (rassegna sugli analytics sanitari).
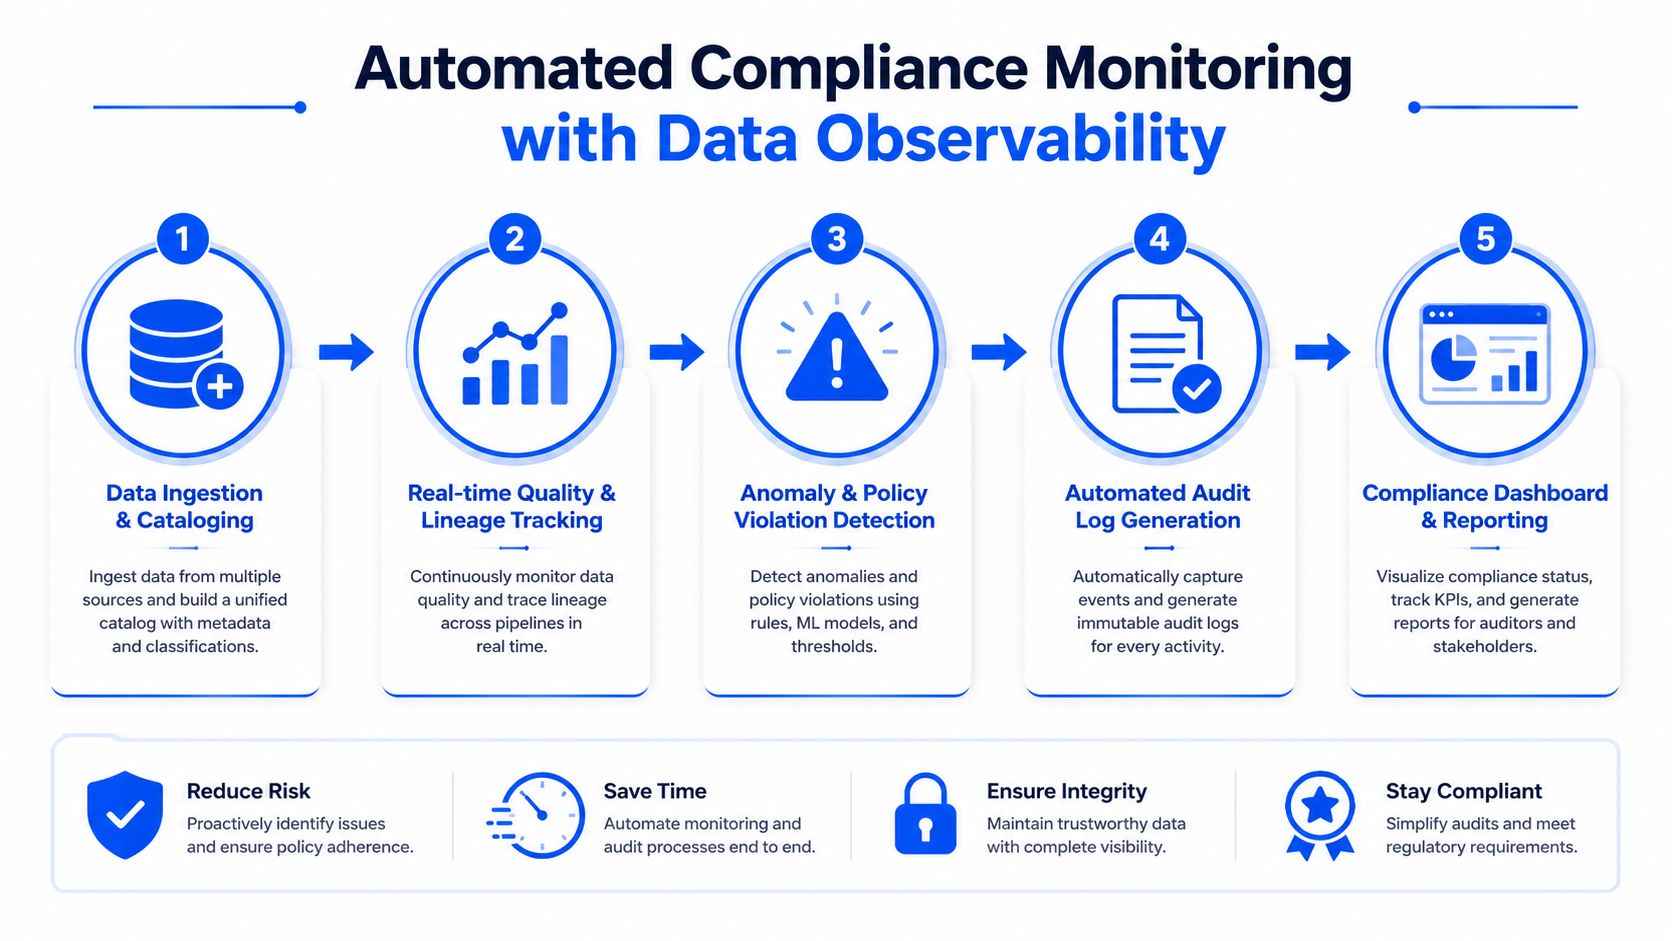
I segnali utili sono quelli che le pipeline producono già
Gli stack di osservabilità più solidi apprendono il comportamento normale e poi segnalano i cambiamenti inattesi, senza che qualcuno debba scrivere e mantenere decine di regole fragili. Questo approccio è particolarmente prezioso in sanità, perché le stesse tabelle tendono a contenere sia dati operativi sia dati regolamentati. Se una metrica cambia all'improvviso, il team deve sapere se si tratta di un cambiamento reale, di un feed guasto o di un problema di compliance nascosto.
Il tracciamento dello schema è altrettanto importante. Quando una colonna viene aggiunta, rimossa o convertita in un tipo diverso, la validazione a valle può fallire se nessuno sorveglia i cambiamenti strutturali. Conta anche il monitoraggio della tempestività, perché un caricamento di dati in ritardo o mancante può generare report obsoleti che sembrano validi ma a cui mancano PHI, transazioni rilevanti per le policy o aggiornamenti recenti.
L'osservabilità diventa evidenza quando viene acquisita correttamente
digna è un'opzione in questo ambito, perché esegue le analisi all'interno dei database del cliente e offre dashboard per trend, tempestività, rilevamento di anomalie, modifiche di schema e validazione a livello di record in ambienti private cloud o on-prem. Questo conta per la compliance, perché i dati restano all'interno del perimetro controllato dal cliente mentre la piattaforma produce comunque evidenze di monitoraggio.
Qui conta soprattutto il modello di piattaforma, non il nome del brand. Gli analytics storici fanno emergere segnali e pattern in rapido cambiamento che aiutano i team a dare priorità all'analisi delle cause radice, mentre la validazione a livello di record consente ai responsabili della governance di applicare regole di business che gli auditor possono ispezionare in seguito. Se il livello di monitoraggio è in grado di spiegare cosa è cambiato, quando è cambiato e quali record sono stati coinvolti, diventa parte del fascicolo di compliance.
Consiglio chiave: l'osservabilità è utile per la compliance solo quando crea una traccia duratura, non soltanto un flusso rumoroso di alert.
L'esecuzione in-database riduce gli spostamenti inutili
Un altro vantaggio pratico è mantenere l'analisi all'interno dell'ambiente del cliente. I team sanitari non vogliono uno strumento di monitoraggio che trasferisca record sensibili in un ulteriore archivio esterno solo per calcolare punteggi di anomalia. L'esecuzione in-database riduce gli spostamenti, mantiene i controlli più vicini alla sorgente e rende più semplice allinearsi ai confini di privacy esistenti.
Questo è il cambiamento. La compliance smette di essere una revisione manuale dei log dopo un problema e diventa un sistema continuo che sorveglia drift, strutture errate, consegne in ritardo e violazioni di policy come parte delle normali operazioni.
Checklist di implementazione per la conformità dei dati sanitari
Il modo più rapido per migliorare la propria postura è associare ogni controllo a qualcosa che una piattaforma possa dimostrare. Un buon punto di partenza è organizzare il lavoro in crittografia, accesso, verificabilità, validazione, monitoraggio e governance, poi verificare ogni voce su un sistema in esercizio anziché su un documento di policy. La tabella seguente è il tipo di mappatura che vorrei avere davanti prima di un audit.
Requisito di compliance | Controllo tecnico | Capacità di osservabilità |
|---|---|---|
Proteggere le PHI at rest e in transito | AES-256, TLS 1.3, rotazione centralizzata delle chiavi | Alert su eventi insoliti di crittografia o gestione delle chiavi |
Limitare l'uso delle PHI in base alla finalità | Tracciamento del consenso, accesso basato sulla finalità, autorizzazione a livello di record | Monitoraggio dei pattern di accesso e rilevamento delle violazioni di policy |
Dimostrare chi ha toccato cosa | Log di audit append-only con utente, paziente, timestamp e azione | Controlli di completezza dei log di audit e analisi dei trend di accesso |
Impedire la propagazione di dati errati | Validazione dei codici clinici, controlli sui campi mancanti, controlli sulle unità | Tracciamento dello schema ed esiti della validazione a livello di record |
Intercettare feed in ritardo o mancanti | Controlli di ingestion pianificati, SLA di consegna, backup immutabili | Monitoraggio della tempestività e alert sui caricamenti in ritardo |
Supportare il controllo ibrido e multi-region | Segmentazione, controlli di identità, regole di conservazione tra i sistemi | Lineage tra ambienti e monitoraggio delle distribuzioni |
Partire dai controlli che chiudono le lacune maggiori
Crittografia e gestione delle chiavi vengono per prime, perché riducono il raggio d'impatto. Controllo degli accessi e autorizzazione vengono subito dopo, perché i workflow sanitari hanno comunque bisogno che i dati si muovano, ma solo verso la persona giusta e per la finalità giusta. I log di audit, soprattutto quelli append-only, dovrebbero seguire immediatamente, perché fanno la differenza tra un'ipotesi e una traccia di evidenze.
Validazione e osservabilità appartengono allo stesso rollout, non sono un lusso da rimandare. Se aspettate che le dashboard sembrino strane, avete già perso la prova pulita che vi servirà quando qualcuno chiederà cosa sapeva il sistema e quando lo sapeva.
Gli ambienti multi-region richiedono confini di policy espliciti
Le architetture di cloud ibrido e multi-region sono il punto in cui i programmi di compliance diventano approssimativi. I dati attraversano reti ospedaliere, centri regionali e più cloud, spesso in modi che il progetto originale non aveva previsto. La risposta non è smettere di spostare dati, ma rendere esplicito e ispezionabile ogni trasferimento, ruolo e regola di conservazione.
Per i team che hanno bisogno di supporto sulla governance senza voler spostare i dati fuori dal proprio ambiente, vale la pena confrontare piattaforme e modelli di deployment come si confronterebbero i controlli di produzione. La scelta giusta non è l'interfaccia più appariscente, ma quella che rispetta il vostro ambiente e vi fornisce comunque evidenze utili.
Raccomandazioni di governance e preparazione agli audit
La preparazione agli audit si riduce alla capacità dell'organizzazione di spiegare i propri controlli sotto pressione. I team che reggono alla revisione assegnano responsabili chiari, mantengono aggiornata la documentazione e verificano gli accessi abbastanza spesso da rendere credibile il processo. La spina dorsale operativa è semplice: DPO o responsabilità equivalente dove richiesto, informative privacy, registri dei trattamenti, minimizzazione dei dati, limitazione della finalità, crittografia, RBAC e revisioni periodiche degli accessi.
Costruire la governance sulle evidenze, non sulle promesse
Ho visto audit procedere senza intoppi quando un team sapeva rispondere rapidamente a tre domande. Chi ha approvato il caso d'uso, chi può accedere alle PHI e quale prova dimostra che il sistema ha applicato la regola. Se quelle risposte stanno nella testa di tre persone diverse, l'audit si trasforma in una corsa affannosa.
Anche la governance deve rispecchiare il comportamento della pipeline. Consenso, gestione delle limitazioni e decisioni di accesso a valle devono comparire in log, approvazioni e stato del sistema, non solo in un PDF di policy. Per gli usi secondari, l'organizzazione ha bisogno di una registrazione pulita di finalità, autorizzazione e ambito di accesso. Per la cura ordinaria, serve comunque una policy chiara che separi ciò che è consentito da ciò che non lo è.
Formazione e responsabilità contano più del linguaggio delle policy
Le policy falliscono quando ingegneri, analisti e personale operativo non sanno dove siano i confini. La formazione più utile che ho visto usa esempi reali di workflow, come un export per il supporto, un estratto per la ricerca o un backfill di una dashboard, e mostra esattamente cosa è consentito, cosa richiede approvazione e cosa va registrato. Una formazione di questo tipo trasforma la compliance da vocabolario legale a modello operativo condiviso.
Un buon dossier di audit contiene di solito informative privacy aggiornate, registri dei trattamenti, esiti delle revisioni degli accessi, evidenze sulla gestione del consenso e una spiegazione chiara di come le PHI si muovono nello stack. Non servono drammi. Servono coerenza e la stessa versione dei fatti tra engineering, sicurezza e governance.
I team pronti per l'audit non improvvisano le evidenze: le generano come parte del workflow.
Se c'è un cambiamento culturale che vale la pena fare, è questo. La compliance non può restare a legale e sicurezza mentre i team dati ottimizzano tutto il resto. Platform owner, pipeline engineer e responsabili della governance hanno bisogno della stessa visione dei controlli, perché in sanità il record stesso è il prodotto, l'evidenza e la responsabilità.
Se state costruendo o modernizzando i controlli di conformità dei dati sanitari, digna può aiutarvi monitorando anomalie, modifiche di schema, tempestività e validazione a livello di record all'interno del vostro ambiente. Visitate digna per vedere come un workflow di Data Observability può supportare verificabilità, validazione e operazioni di pipeline governate senza costringere i dati sensibili a uscire dal vostro controllo.
Per la parte a livello di record di questo insieme di controlli, come i controlli su codici clinici, campi mancanti e unità di misura, vedete come digna Data Validation applica le regole di business all'interno del vostro database.
Domande frequenti
Perché la conformità dei dati sanitari è un problema di data engineering?
Perché oggi la maggior parte dell'esposizione deriva dalle pipeline, non dalla documentazione. Nel 2024 la sanità statunitense ha registrato 663 grandi violazioni che hanno coinvolto quasi 243 milioni di persone, e attacchi informatici e incidenti IT hanno causato l'81% delle grandi violazioni. Le PHI attraversano data warehouse, data lake e pipeline di AI, quindi i controlli devono seguire ogni record attraverso ingestion, trasformazione ed export.
Quali standard di crittografia dovrebbero usare le piattaforme di dati sanitari?
Una baseline pratica prevede AES-256 per i dati at rest e TLS 1.3 per i dati in transito, con chiavi gestite centralmente in un KMS o HSM e ruotate regolarmente. I backup dovrebbero seguire una strategia 3-2-1 con copie offsite immutabili, in modo che una sola credenziale rubata non possa esporre PHI recuperabili o materiale crittografico.
Cosa dovrebbe contenere un log di audit HIPAA?
Registrate ogni accesso alle PHI con utente, paziente, timestamp e azione, nel momento stesso dell'accesso anziché riepilogandolo in seguito. Questi log vanno conservati in archivi append-only, perché log modificabili, sepolti o strutturati in modo incoerente non aiutano a ricostruire chi ha toccato cosa durante un audit o l'analisi di un incidente.
Il controllo degli accessi basato sui ruoli basta a proteggere le PHI?
No. L'accesso basato sui ruoli è troppo grossolano per i carichi di lavoro sanitari sensibili, perché un medico, un analista o un utente del supporto con un ruolo legittimo potrebbe comunque non essere autorizzato a interrogare ogni oggetto paziente. L'articolo raccomanda l'autorizzazione a livello di oggetto e di record su ogni richiesta, per prevenire esposizioni di tipo IDOR tramite API e object store.
In che modo la Data Observability supporta la compliance sanitaria?
La Data Observability trasforma la compliance da revisione periodica a controllo continuo. Il tracciamento dello schema intercetta campi rinominati e code set modificati, il monitoraggio della tempestività segnala i caricamenti in ritardo che rendono obsoleti i report e la validazione a livello di record applica regole che gli auditor possono ispezionare in seguito. Eseguita all'interno del database, produce evidenze senza spostare le PHI fuori dal perimetro del cliente.


