Come misurare l'affidabilità: dati, pipeline e ML
|
7
min di lettura

Probabilmente lo state affrontando proprio ora. Una dashboard che ieri sembrava a posto oggi è improvvisamente sbagliata. Una tabella di input di un modello ha subito una modifica silenziosa dello schema. Un report finanziario non è aggiornato, ma la pipeline indica “success”. Tutti si pongono la stessa domanda: possiamo fidarci dei dati?
È questo il problema di fondo quando ci si chiede come misurare l'affidabilità. Nei data warehouse aziendali, l'affidabilità non è un esercizio di laboratorio. È una disciplina operativa. Se validate solo estratti campionati al di fuori del warehouse, vi sfuggono i guasti che si verificano all'interno delle pipeline attive, sulle tabelle di produzione e tra schemi in continua evoluzione. I team moderni hanno bisogno di un modo per misurare l'affidabilità là dove i dati già risiedono.
Indice
Perché le vostre dashboard e i vostri modelli di ML continuano a rompersi
I guasti del lunedì mattina raramente sembrano drammatici all'inizio. Una dashboard delle vendite mostra un fatturato negativo. Un modello di churn inizia a classificare tutti come clienti a basso rischio perché una tabella di origine ha smesso di aggiornarsi. Una dashboard dell'assistenza clienti perde metà delle sue categorie perché una chiave di join è cambiata a monte. Il warehouse continua a funzionare, ma la fiducia è svanita.
Ecco perché l'affidabilità va misurata in termini di business, non solo con controlli tecnici. La metrica operativa più chiara è il data downtime, calcolato come numero di incidenti × (tempo medio di rilevamento + tempo medio di risoluzione), e il benchmark utilizzato da molti team è che le aziende di primo livello puntano a meno dell'1% annuo, mentre le organizzazioni nella media vedono spesso il 5–10% dei propri asset di dati inutilizzabile, secondo la spiegazione del data downtime di Monte Carlo.
I problemi di affidabilità di solito nascono a monte
La maggior parte degli incidenti gravi non inizia con una dashboard. Inizia con una di queste condizioni:
Una pipeline è stata completata con output errati. L'orchestrazione ha segnato il job in verde, ma i valori nulli sono esplosi in un campo critico.
Uno schema è cambiato senza preavviso. Il tipo di una colonna è cambiato, un campo è scomparso o un team di origine ha rinominato un attributo.
Una fonte ha consegnato in ritardo. I report si sono aggiornati come previsto, ma con i dati parziali del giorno prima.
Un modello ha utilizzato feature obsolete. Il feature store sembrava disponibile, ma una partizione non è mai arrivata.
Anche la sicurezza può far parte della stessa catena di guasti. Se agenti di AI o livelli di automazione accedono ai dati aziendali senza controlli rigorosi, affidabilità e governance iniziano a sovrapporsi. I team che stanno riflettendo su questo confine operativo troveranno utile la guida alla sicurezza degli agenti di AI per le aziende, perché chiarisce in quali punti il rischio di accesso ai dati si trasforma in problemi di fiducia a valle.
Agli stakeholder interessa la fiducia, non il vostro grafo di orchestrazione
Un VP non chiede se un task di Airflow è stato rieseguito correttamente. Chiede se il numero sullo schermo può essere usato in sicurezza. Ecco perché il lavoro sull'affidabilità guadagna consenso quando collegate gli incidenti a downtime, SLA mancati e perdita di fiducia negli analytics.
Regola pratica: se il business non è in grado di capire se i dati sono utilizzabili, avete già un problema di affidabilità.
I team che vogliono meno sorprese in produzione dovrebbero studiare anche gli schemi ricorrenti di guasto delle pipeline, in particolare il rilevamento tardivo e le rotture nascoste nei flussi di dati di produzione. Un riferimento utile è questa analisi del perché le pipeline di dati falliscono in produzione e come rilevare i problemi in anticipo.
I quattro pilastri dell'affidabilità dei dati
Se volete un framework che il vostro team possa usare davvero, suddividete l'affidabilità in quattro pilastri. Non dieci. Non una checklist gigantesca che nessuno aggiorna. Quattro sono sufficienti per assegnare le responsabilità, definire i controlli e analizzare gli incidenti senza trasformare il processo in una messinscena di governance.
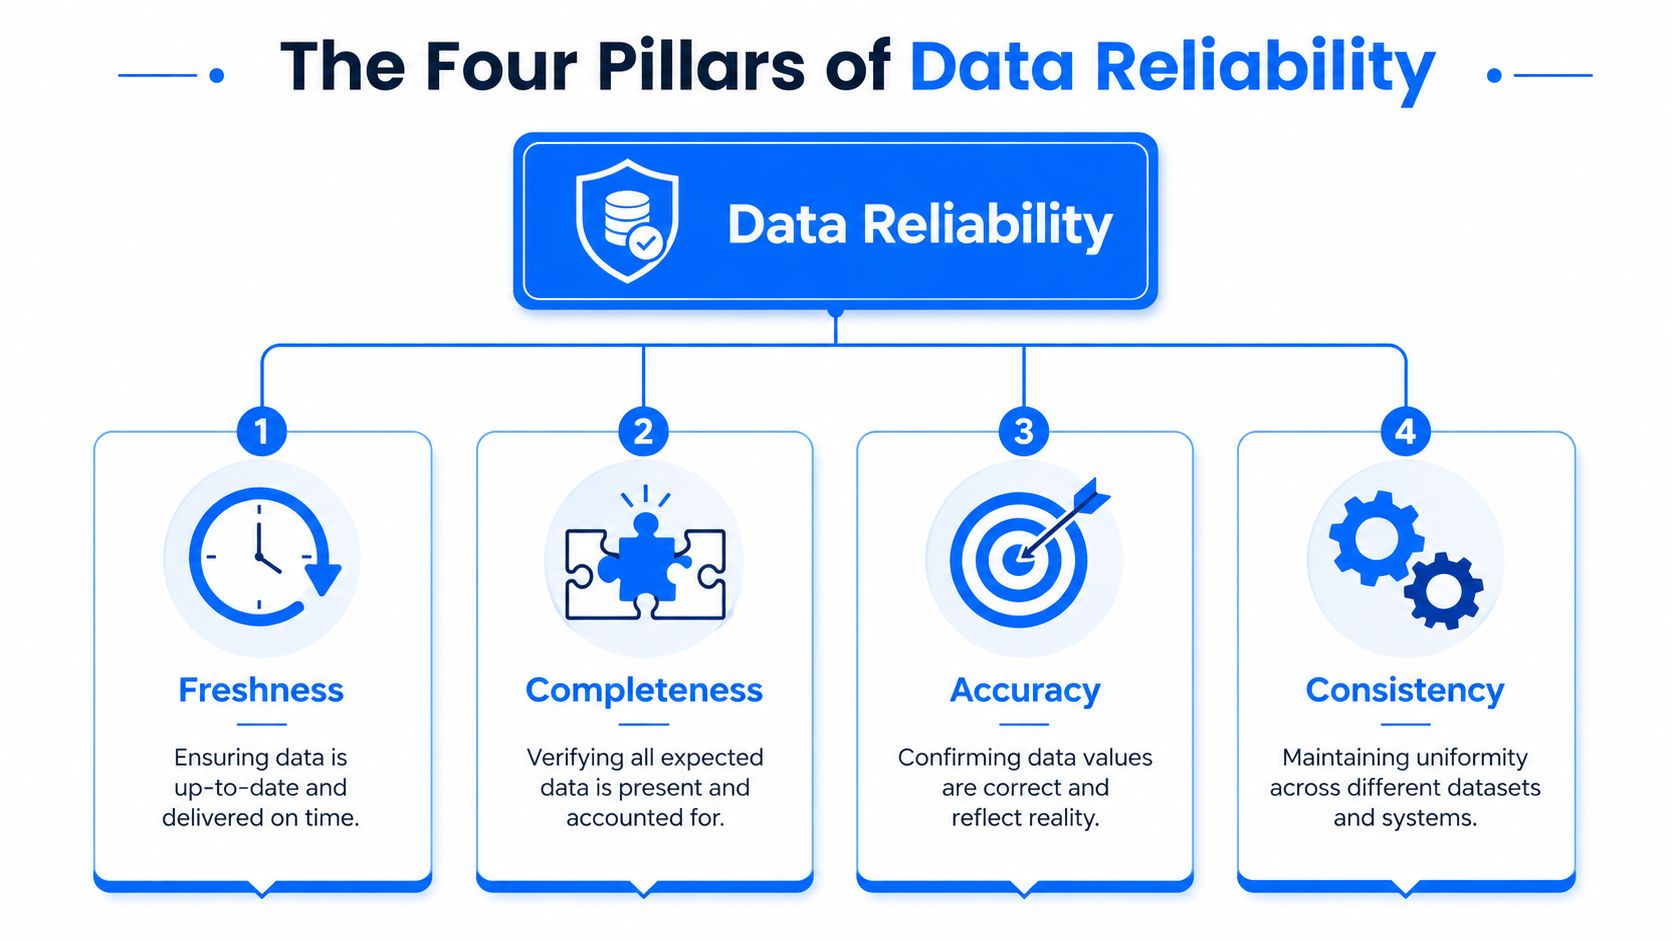
Freschezza e tempestività
La freschezza indica se i dati sono aggiornati. La tempestività indica se sono arrivati quando il business ne aveva bisogno. In un warehouse, i due concetti sono correlati ma non identici.
Un data mart finanziario giornaliero può essere fresco rispetto al proprio ultimo caricamento ed essere comunque in ritardo per la riunione del management. Una tabella antifrode in streaming può arrivare in modo continuo ma accumulare comunque un ritardo tale da compromettere le decisioni a valle. Questo pilastro appartiene contemporaneamente al livello della pipeline e al livello di consumo.
Completezza
La completezza riguarda la presenza. Ci sono tutte le righe attese? Le colonne critiche sono valorizzate? Sono arrivate tutte le partizioni? Una regione è scomparsa a causa di una modifica a un filtro a monte?
Molti team monitorano troppo poco. Contano le righe totali e si fermano lì. Questa pratica non coglie la modalità di guasto più comune nelle aziende, in cui manca un sottoinsieme mentre il totale sembra ancora plausibile.
L'affidabilità si rafforza quando verificate la forma attesa dei dati, non solo il completamento corretto dei job.
Accuratezza e correttezza
L'accuratezza è più difficile perché tocca il significato di business. Un valore può esistere, rispettare il tipo ed essere comunque sbagliato. I simboli di valuta vengono eliminati. I codici di stato si discostano dagli stati di business ammessi. Le chiavi esterne puntano a record che non esistono più.
Per i data architect, questo pilastro combina di solito la validazione tecnica con le regole di business. Alcuni controlli sono universali, come l'integrità referenziale. Altri sono specifici di una tabella e devono essere gestiti dal team che conosce il processo alla base dei dati.
Coerenza
La coerenza è ciò che mantiene utilizzabili i sistemi integrati. Formati, tipi di dati, logica delle chiavi, convenzioni di denominazione e aspettative sullo schema devono restare validi nel tempo. Questo pilastro intercetta i problemi che avvelenano in modo subdolo join, dashboard e pipeline di feature a valle.
Un modo pratico per usare i quattro pilastri è assegnare a ogni asset critico uno schema di guasto principale:
Le dashboard per il management di solito falliscono prima sulla freschezza e sull'accuratezza.
Le tabelle di feature per il ML di solito falliscono prima sulla coerenza e sulla stabilità dello schema.
I dataset per la chiusura contabile di solito falliscono prima sulla completezza e sulla correttezza.
Le dimensioni condivise di solito falliscono prima sulla coerenza, perché molti sistemi a valle dipendono da esse.
Questa classificazione velocizza le revisioni. Evita inoltre che i team applichino gli stessi controlli ovunque, uno dei motivi principali per cui il monitoraggio diventa rumoroso e costoso.
Metriche chiave di affidabilità e calcolo in-database
La domanda come misurare l'affidabilità diventa utile solo quando porta a qualcosa di calcolabile. Negli ambienti warehouse, le metriche migliori sono quelle che potete calcolare direttamente in SQL su tabelle vicine alla produzione, tabelle di metadati e log di sistema. Se dovete prima esportare i dati, avete già aggiunto latenza e rischio.
Cosa ci insegnano ancora le metriche classiche di affidabilità
La scienza classica della misurazione conserva la sua importanza. Nella progettazione di questionari, l'alfa di Cronbach è lo standard per l'affidabilità delle scale, e un valore pari o superiore a 0,8 è considerato accettabile. Per le variabili continue, il coefficiente di correlazione intraclasse (ICC) è il parametro più comune per stimare l'affidabilità confrontando misurazioni ripetute, come riassunto nella guida della biblioteca dell'Università di Southampton su affidabilità, validità e riproducibilità.
Questi metodi sono preziosi quando valutate misurazioni ripetute effettuate da persone o strumenti. Sono meno utili per le operations di un warehouse in produzione, perché di solito il vostro problema non è “Due valutatori concordano?”, ma “I dati sono arrivati, sono conformi e sono rimasti stabili all'interno di un sistema di produzione in continua evoluzione?”
Un modello mentale utile è questo: le statistiche di affidabilità tradizionali validano la coerenza delle misurazioni su campioni. Le metriche di affidabilità del warehouse validano la coerenza operativa su asset in continuo cambiamento. Se vi serve un esempio pratico di come trasformare una misurazione astratta in scorecard operative, vale la pena leggere il playbook sulle metriche di Halo AI, perché mostra come i team rendono le metriche utilizzabili anziché semplicemente riportabili.
Metriche che potete calcolare all'interno del warehouse
Di seguito trovate una tabella operativa sintetica. L'obiettivo non è copiare queste query alla lettera. L'obiettivo è costruire misure che vengano eseguite là dove risiedono i dati.
Pilastro | Esempio di metrica | Che cosa misura | Esempio di concetto SQL |
|---|---|---|---|
Freschezza | Tempo trascorso dall'ultimo caricamento riuscito | Ritardo tra disponibilità attesa ed effettiva |
|
Completezza | Deriva del numero di righe | Volume mancante o inaspettatamente gonfiato | confrontare il numero di righe della partizione corrente con l'andamento storico |
Accuratezza | Tasso di valori non validi | Violazioni delle regole di business nelle colonne critiche |
|
Coerenza | Frequenza delle modifiche allo schema | Deriva strutturale che compromette l'utilizzo a valle | confrontare l'information schema attuale con uno snapshot precedente |
Alcuni schemi pratici funzionano bene.
Sono semplici di proposito. Corrispondono a quattro domande che ogni ingegnere comprende:
È in ritardo?
Manca qualcosa?
I valori sono validi?
La struttura è cambiata?
Per i team che stanno costruendo un catalogo di metriche duraturo, questa guida alle metriche di data quality è utile perché aiuta a distinguere i controlli di facciata dalle misure che supportano davvero le operations.
Non partite da decine di controlli. Partite dall'insieme più piccolo in grado di spiegare una dashboard guasta, un join rotto o un input instabile di un modello.
Il compromesso è evidente. Il calcolo in-database preserva il contesto e riduce gli spostamenti di dati, ma richiede una progettazione disciplinata delle query, affinché i job di osservabilità non entrino in competizione con i carichi di lavoro di produzione. Ecco perché i team più esperti di solito iniziano dalle tabelle critiche, da controlli che tengono conto delle partizioni e da scansioni guidate dai metadati, anziché da una validazione a forza bruta sull'intera tabella.
Definire SLO e baseline azionabili
Le metriche grezze non cambiano i comportamenti. I team cambiano comportamento quando una metrica supera una soglia che tutti comprendono. È questo che fanno gli SLO: trasformano l'osservazione in un contratto operativo.
Un programma di affidabilità debole dice: “Monitoriamo la freschezza”. Uno solido dice: “La tabella dei fatti degli ordini clienti deve essere disponibile prima che inizi la riconciliazione a valle, e scatta un alert se la finestra di arrivo prevista non viene rispettata”. La soglia esatta dipende dall'uso di business, non dalle preferenze dell'engineering.

Le soglie devono corrispondere al danno per il business
Asset diversi meritano obiettivi diversi. Un report per il consiglio di amministrazione, una tabella antifrode quasi in tempo reale e un archivio per l'addestramento di modelli non dovrebbero condividere la stessa policy di alerting.
Usate queste regole decisionali quando definite gli SLO:
Gli asset critici per le decisioni richiedono soglie di freschezza e correttezza più rigide, perché le persone agiscono immediatamente sulla base di essi.
Le tabelle condivise a monte richiedono controlli di coerenza più solidi, perché una singola rottura strutturale può propagarsi a molti consumatori.
I dataset regolamentati richiedono regole di validazione esplicite ed eccezioni tracciabili, perché la verificabilità conta quanto la tempestività.
Gli input di feature per il ML richiedono baseline orientate alla stabilità, così che derive e modifiche dello schema vengano intercettate prima che la qualità del modello peggiori.
È in quest'ultima categoria che le soglie statiche spesso falliscono. Una regola sul numero di righe può intercettare una perdita catastrofica, ma non vi dirà se uno schema comportamentale appreso è cambiato abbastanza da rendere inaffidabile una feature.
Perché le regole statiche non reggono su larga scala
Le regole statiche sembrano allettanti perché sono facili da spiegare. Ma sono anche costose da mantenere in ambienti di grandi dimensioni. Se ogni tabella riceve soglie codificate a mano, i team passano il tempo a regolare gli alert invece di migliorare l'affidabilità.
Ecco perché l'apprendimento della baseline è importante. Il calcolo delle metriche in-database e l'apprendimento della baseline avvengono all'interno delle tabelle configurate dal cliente. Ad esempio, digna legge direttamente le tabelle di sistema DBC di Teradata tramite query SQL per convertire le metriche operative in serie temporali per l'anomaly detection basata sull'AI, come descritto nella panoramica di digna sull'analisi dei carichi di lavoro Teradata.
Questo approccio cambia il modello operativo. Invece di chiedere a un ingegnere di definire in anticipo ogni stato normale, il sistema può apprendere gli schemi ricorrenti direttamente dai segnali presenti nel warehouse. Negli ambienti ad alto volume, è la differenza tra un'osservabilità sostenibile e l'alert fatigue.
Una soglia dovrebbe riflettere il costo di un errore, non la comodità di scrivere la regola.
Resta comunque un compromesso. Le baseline apprese riducono la manutenzione manuale, ma vanno riesaminate quando il comportamento del business cambia in modo significativo. Chiusure trimestrali, lanci di prodotto, migrazioni delle fonti ed espansioni regionali possono produrre veri cambiamenti negli schemi. I team che lo fanno bene affiancano alle baseline automatiche calendari di business espliciti e la revisione da parte dei responsabili.
Strumentare lo stack dei dati per una visibilità completa
La maggior parte dei contenuti sull'osservabilità presuppone che i dati vengano spostati all'esterno, aggregati altrove e che l'affidabilità venga giudicata dall'esterno. Su piccola scala funziona. Diventa un rischio nei grandi ambienti di data warehouse, soprattutto quando privacy, latenza e carico operativo sono tutti importanti.
Il paradosso dell'affidabilità in-database
Il paradosso è semplice. Volete misurare l'affidabilità in modo continuo, ma il fatto stesso di esportare i dati per misurarla può aggiungere costi, ritardi e attriti di governance. Peggio ancora, separa il sistema di misurazione dall'ambiente in cui si verificano i guasti.
Il divario è ancora più netto per il rilevamento basato sull'AI. La sfida irrisolta è quella che alcuni ingegneri chiamano il paradosso dell'affidabilità in-database. La maggior parte delle indicazioni si concentra su campioni esterni, ma non sulla verifica che la baseline appresa da un algoritmo resti coerente quando il calcolo avviene nativamente all'interno del warehouse. Questa sfida è descritta direttamente in questa discussione sul paradosso dell'affidabilità in-database per i data engineer aziendali.

È questo l'aspetto che molti team trascurano. Non basta monitorare i dati. Serve anche la certezza che la logica di monitoraggio resti stabile quando il volume delle fonti aumenta improvvisamente, lo schema cambia o gli schemi storici si modificano.
Che cosa strumentare nella pratica
Per un programma di affidabilità incentrato sul warehouse, strumentate tre livelli contemporaneamente.
Innanzitutto, monitorate il comportamento di arrivo. Dovete sapere se i dataset attesi sono arrivati, se sono arrivati in tempo e se i ritardi sono isolati o sistemici.
In secondo luogo, monitorate la stabilità strutturale. La deriva dello schema rompe pipeline e modelli più spesso di quanto i team ammettano, soprattutto quando i team applicativi a monte rilasciano modifiche senza una revisione da parte dell'analytics.
In terzo luogo, monitorate la validità a livello di record per le entità critiche per il business. Gli aggregati possono nascondere errori profondi. Rotture referenziali, chiavi duplicate e transizioni di stato non valide di solito emergono solo quando si controllano le righe, non i riepiloghi.
Una dashboard pratica per i team di piattaforma dovrebbe includere:
Viste sulla freschezza che evidenziano tabelle in ritardo, partizioni ritardate e data mart a valle non aggiornati
Viste sullo schema che mostrano colonne aggiunte, colonne rimosse e modifiche ai tipi di dati
Viste sulla validazione che fanno emergere le violazioni delle regole per tabella, responsabile e dominio di business
Viste storiche che aiutano gli ingegneri a confrontare l'incidente attuale con gli schemi precedenti
Se state formalizzando questa capacità, un buon riferimento concettuale è che cosa significa la data observability nella pratica. Aiuta a inquadrare l'osservabilità come un modello operativo di engineering, non come l'ennesima dashboard.
Il campionamento esterno può dimostrare una tesi. La strumentazione in-database può far funzionare la piattaforma.
Il compromesso, in questo caso, è organizzativo. Una visibilità completa richiede un accordo tra platform engineering, analytics engineering, governance e team di ML. Senza una responsabilità condivisa, ogni team strumenta il proprio angolo e nessuno vede l'intera catena del guasto.
Costruire un workflow orientato all'affidabilità
Un alert di affidabilità ha valore solo se innesca la risposta giusta. Altrimenti avete costruito un sistema di notifiche, non un programma di affidabilità.
Il workflow deve essere noioso, nel senso migliore del termine. Ripetibile. Assegnato. Facile da verificare dopo un incidente grave. Quando i team lo saltano e si affidano a un debugging eroico, risolvono l'interruzione immediata ma preservano esattamente le condizioni che causeranno la successiva.
Cosa succede dopo l'alert
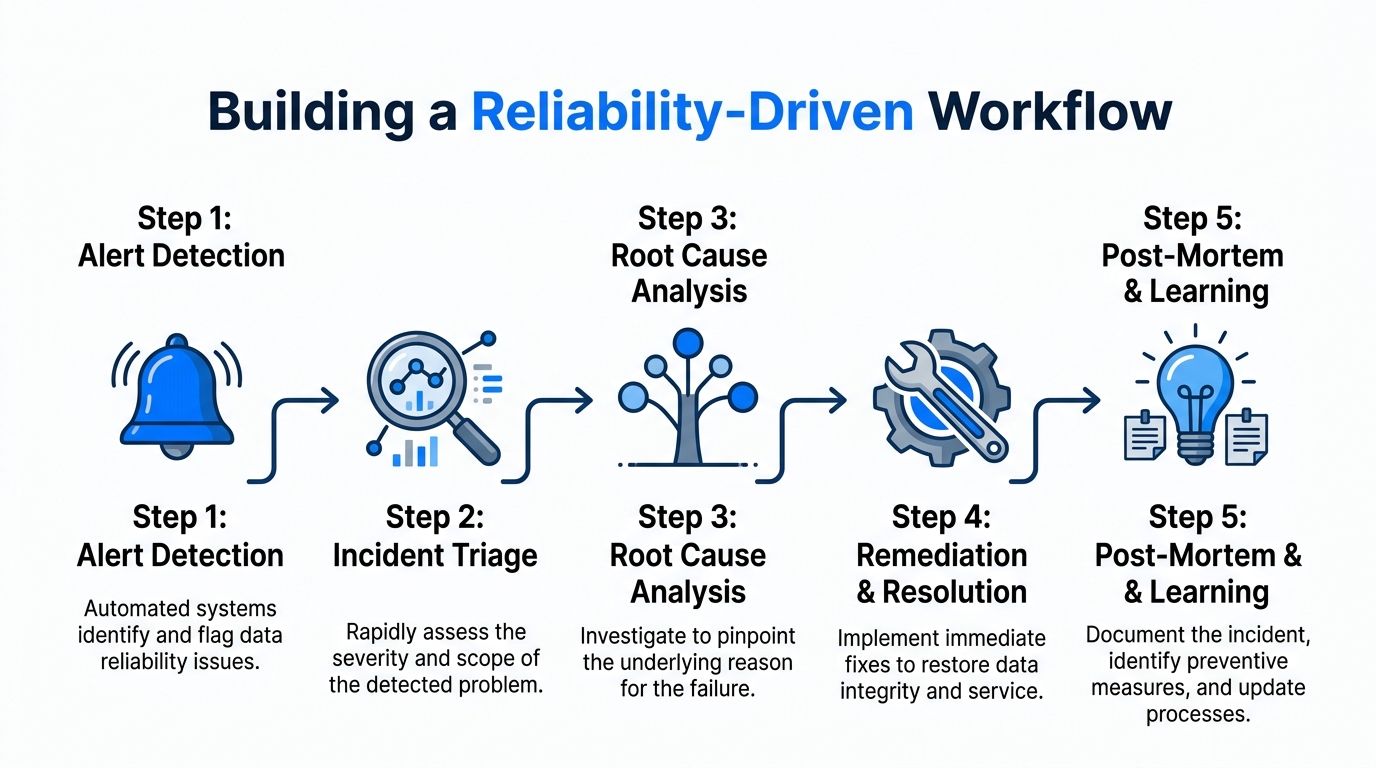
Un workflow solido segue di solito cinque passaggi, ma non tutti gli incidenti richiedono lo stesso livello di approfondimento.
Rilevare il problema
Il segnale può provenire da controlli su freschezza, schema, validazione o da verifiche di business a valle. Ciò che conta è che il rilevamento avvenga prima che gli stakeholder scoprano il problema manualmente.Effettuare un triage rapido
Stabilite se il problema è isolato, condiviso o visibile al management. Una tabella di feature guasta usata da un singolo job di addestramento è diversa da un data mart finanziario in ritardo utilizzato in tutta l'azienda.Risalire alla causa principale
Controllate i log della pipeline, i metadati del warehouse, gli schemi di consegna delle fonti e la cronologia dello schema. Chiedetevi se il problema derivi da un arrivo tardivo, da una modifica strutturale, da una regressione della logica o da dati di origine errati.Correggere in sicurezza
Eseguite un backfill se il problema riguarda dati mancanti. Correggete la logica di trasformazione se il problema è semantico. Quando possibile, garantite la compatibilità dello schema in avanti. Evitate correzioni silenziose una tantum che non lasciano traccia.Registrare quanto appreso
Aggiungete un nuovo controllo, rivedete le responsabilità o affinate una baseline. Se lo stesso incidente può ripetersi senza un nuovo controllo, il processo non è completo.
Usare gli incidenti per rafforzare la piattaforma
L'osservabilità storica è importante in questo caso, perché i trend rivelano spesso ciò che un singolo incidente nasconde. Ritardi ripetuti in un dominio di origine possono indicare una debolezza nei contratti a monte. Frequenti rotture dello schema nelle dimensioni condivise possono indicare problemi di coordinamento dei rilasci. Picchi di validazioni fallite in un processo di business possono mostrare che il problema non è affatto nell'SQL, ma nell'inserimento dei dati operativi o nell'integrazione tra sistemi.
Uno schema operativo particolarmente utile è il monitoraggio del comportamento di arrivo rispetto alle pianificazioni attese e agli schemi appresi. Il monitoraggio della tempestività della piattaforma traccia l'arrivo dei dati rispetto a schemi comportamentali appresi, calcolando i tempi di consegna attesi e rilevando i ritardi, prevenendo così direttamente report non aggiornati e dashboard rotte causati da caricamenti di dati tardivi o mancanti, come descritto in questo aggiornamento di prodotto sul monitoraggio della tempestività e sull'analisi delle serie temporali.
Per i team che progettano flussi di risposta automatizzati più ampi, i principi illustrati in architettura e progettazione degli agenti di AI sono utili perché impongono una riflessione chiara su orchestrazione, passaggi di consegne ed escalation controllata. La stessa disciplina si applica alle operations di affidabilità dei dati.
Il miglior risultato di un post-mortem non è un documento. È un nuovo controllo che previene la stessa classe di guasti.
Un workflow maturo non cerca di eliminare ogni incidente. Riduce le sorprese, accorcia la diagnosi e fa sì che ogni guasto insegni qualcosa di nuovo alla piattaforma.
Se volete misurare l'affidabilità senza spostare i dati fuori dal vostro ambiente, digna è progettata per questo modello operativo. Aiuta i team a rilevare anomalie, validare i record, monitorare la tempestività e tracciare le modifiche dello schema direttamente all'interno di ambienti di dati controllati dal cliente, così che la misurazione dell'affidabilità resti vicina ai sistemi che si guastano.
Domande frequenti
Come si misura l'affidabilità dei dati?
Con metriche che potete calcolare là dove i dati già risiedono. Il tempo trascorso dall'ultimo caricamento riuscito copre la freschezza, la deriva del numero di righe la completezza, il tasso di valori non validi l'accuratezza e la frequenza delle modifiche allo schema la coerenza. Esportare prima i dati aggiunge latenza e attriti di governance prima ancora di aver misurato qualcosa.
Quali sono i quattro pilastri dell'affidabilità dei dati?
Freschezza e tempestività, completezza, accuratezza e correttezza, e coerenza. Quattro sono sufficienti per assegnare le responsabilità e analizzare gli incidenti senza trasformare il processo in una messinscena di governance. Assegnate a ogni asset critico uno schema di guasto principale: le dashboard per il management di solito falliscono sulla freschezza, le tabelle di feature per il ML sulla coerenza e sulla stabilità dello schema.
Che cos'è il data downtime e come si calcola?
È il numero di incidenti moltiplicato per la somma del tempo medio di rilevamento e del tempo medio di risoluzione. Esprime l'affidabilità in termini di business anziché in termini di orchestrazione. Le aziende di primo livello puntano a meno dell'1% annuo, mentre le organizzazioni nella media vedono spesso dal 5% al 10% dei propri asset di dati inutilizzabile.
Perché le soglie statiche non reggono su larga scala?
Sono facili da spiegare e costose da mantenere. Codificare a mano le soglie per ogni tabella significa che i team passano il tempo a regolare gli alert invece di migliorare l'affidabilità. Una regola sul numero di righe intercetta una perdita catastrofica, ma non vi dirà che uno schema comportamentale appreso è cambiato abbastanza da rendere inaffidabile una feature.
Che cosa dovrebbe strumentare per primo un programma di affidabilità?
Tre livelli contemporaneamente: il comportamento di arrivo, la stabilità strutturale e la validità a livello di record per le entità critiche per il business. Gli aggregati nascondono errori profondi, perché rotture referenziali, chiavi duplicate e transizioni di stato non valide emergono solo quando si controllano le righe. Partite dall'insieme più piccolo in grado di spiegare una dashboard guasta.


