Guida all'automazione del reporting di compliance per gli audit 2026
|
5
min di lettura

La chiusura del trimestre si avvicina. Le richieste di audit stanno già arrivando nelle caselle di posta condivise. Qualcuno in finanza vuole le evidenze più recenti sui controlli, la security ha bisogno dei timestamp delle approvazioni, il data engineering cerca di spiegare perché un report non corrisponde a un altro e il team compliance sta ancora riconciliando le versioni dei fogli di calcolo.
Questo schema è familiare nelle aziende regolamentate perché il reporting manuale nasconde il rischio finché la scadenza non si avvicina. I team non si limitano a passare tempo a raccogliere evidenze. Passano tempo a dimostrare da dove provengono i dati, se sono cambiati, chi li ha approvati e perché ci si può fidare del numero riportato. Il lavoro è ripetitivo, ma il problema più difficile è strutturale. I processi manuali non sono stati pensati per patrimoni di dati che si estendono tra data warehouse, strumenti SaaS, pipeline e sistemi di policy.
L'automazione del reporting di compliance cambia il modello operativo. Invece di trattare gli audit come esercitazioni antincendio periodiche, trasforma il reporting in un processo controllato e ripetibile, con evidenze, validazione e tracciabilità integrate fin dall'inizio. Questo conta più nel 2026 di qualche anno fa, perché le normative sono più ambigue, i dati si muovono più velocemente e le sole regole statiche non intercettano più i problemi che generano esposizione durante le ispezioni.
Indice
Dagli audit manuali all'assurance automatizzata
Il vecchio modello è quasi ovunque lo stesso. Un'autorità di vigilanza chiede evidenze. L'internal audit chiede supporto. Poi parte una reazione a catena. Gli analisti esportano file da un sistema, gli ingegneri integrano i campi mancanti da un altro, i manager rincorrono le approvazioni via email e qualcuno ricostruisce a mano il fascicolo finale perché nessun sistema sorgente registra la storia completa.
Questa corsa contro il tempo genera due tipi di fallimento. Il primo è evidente: ritardi, rilavorazioni e report incoerenti. Il secondo è più difficile da individuare: i team normalizzano l'incertezza. Iniziano ad accettare affermazioni come “quel numero dovrebbe essere giusto” o “abbiamo usato la stessa logica dello scorso trimestre”, anche quando la trasformazione sottostante è cambiata.
Regola pratica: se un report dipende dalla conoscenza tribale per spiegare lineage o approvazioni, non è pronto per l'audit.
L'assurance automatizzata è diversa. Invece di assemblare le evidenze a posteriori, il sistema raccoglie continuamente gli input, li valida, registra le eccezioni e conserva lo storico dei workflow necessario per difendere il risultato. Gli auditor continuano a fare domande, ma l'organizzazione non deve ricostruire sotto pressione i propri controlli.
Tre fattori spingono le aziende in questa direzione:
Crescita dei volumi di dati: più sistemi sorgente significano più join, più passaggi di consegne e più punti in cui la deriva può nascondersi.
Ambiguità normativa: molti obblighi oggi richiedono capacità di giudizio, non solo una logica da checklist.
Pressione sui costi: il management vuole meno ore di lavoro manuale assorbite dai cicli di reporting ricorrenti.
I programmi più solidi collegano inoltre l'automazione del reporting alle operazioni di gestione del rischio, non solo alla produzione di documenti. I team che investono in strategie più ampie di revisione automatizzata del rischio di solito fanno scelte architetturali migliori, perché trattano il reporting come uno degli output di un ambiente di controllo continuo e non come un'attività trimestrale a sé stante.
Una piattaforma ben progettata non elimina il giudizio umano. Sposta le persone dal lavoro di copia-incolla alla gestione delle eccezioni, all'interpretazione e alla remediation. È questo il cambiamento fondamentale. L'automazione del reporting di compliance non riguarda tanto la generazione più rapida di PDF quanto la creazione di uno stato duraturo di assurance continua.
Che cos'è davvero l'automazione del reporting di compliance
Spesso ciò che viene descritto come automazione si rivela una di tre cose: uno script che esporta dati, un workflow che instrada le approvazioni o una dashboard che riassume lo stato. Sono elementi utili, ma nessuno di essi da solo costituisce automazione del reporting di compliance.
Un'analogia migliore è il passaggio dai registri contabili cartacei a un ERP integrato. Il registro registrava le transazioni, ma dipendeva dalle persone per riconciliarle, classificarle e spiegarle. L'ERP ha incorporato queste azioni in un sistema governato, con controlli, tracciabilità e una registrazione affidabile di chi ha fatto cosa. L'automazione del reporting di compliance andrebbe intesa allo stesso modo.
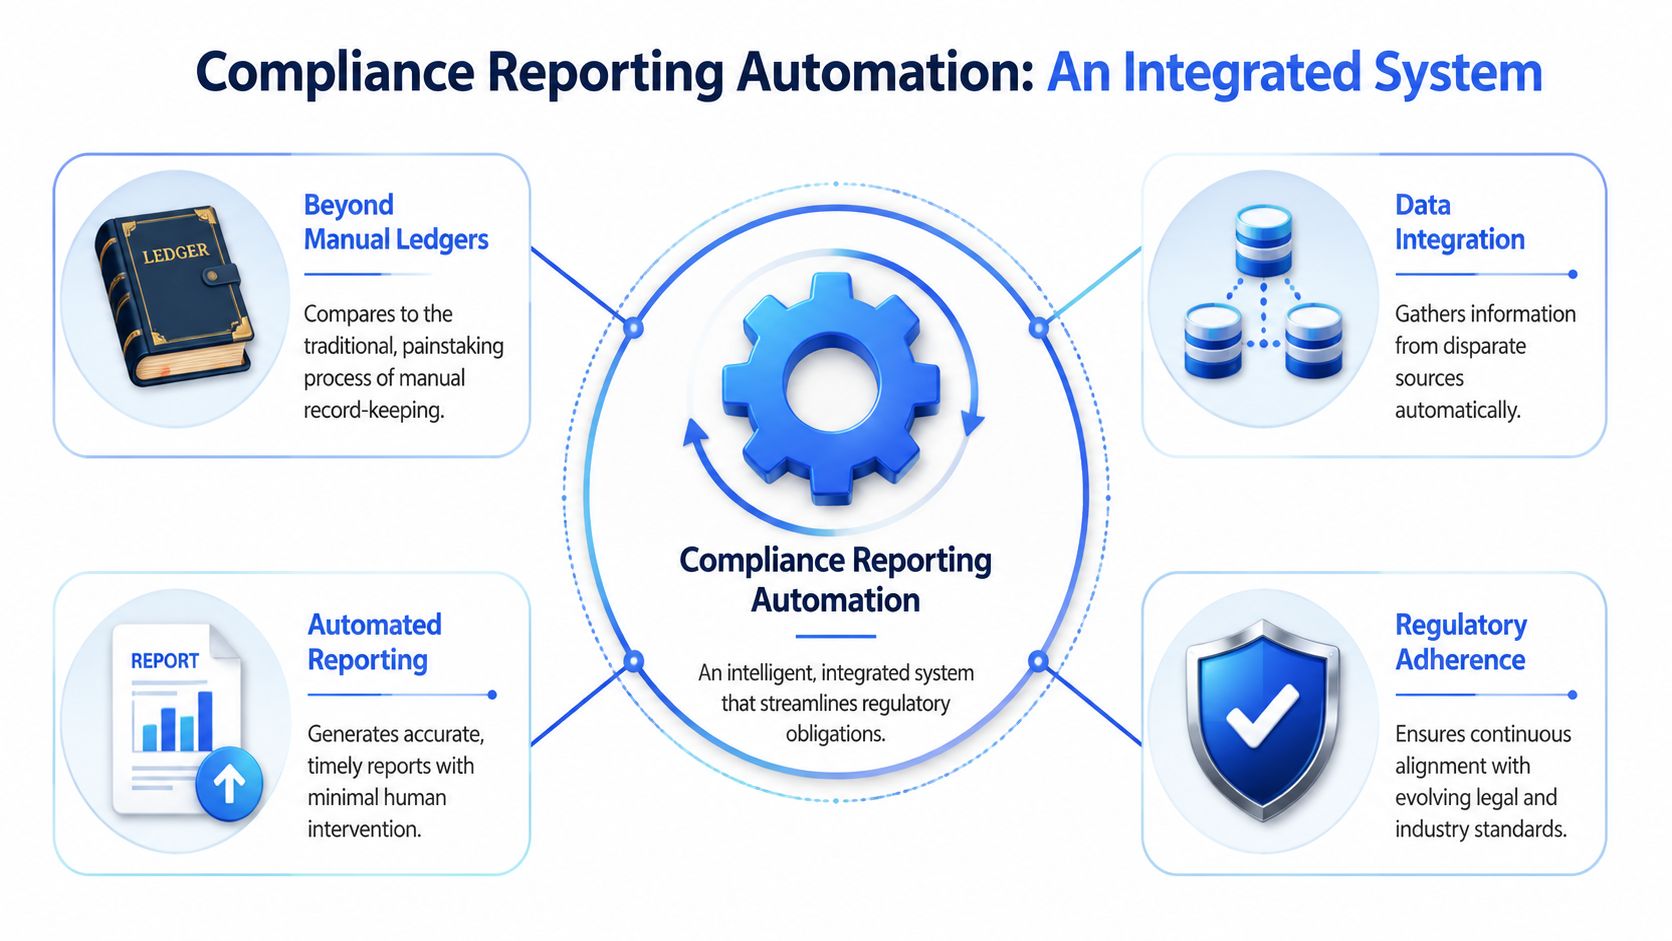
Non è solo automazione di attività
Uno script può estrarre dati da un data warehouse secondo una pianificazione. Questo non lo rende conforme. Se lo schema sorgente cambia, se un campo arriva in ritardo, se avviene un override senza attestazione o se un'autorità di vigilanza chiede come è stata classificata un'eccezione, di solito uno script non ha risposte.
La vera automazione deve fare di più che eseguire. Deve governare.
Ecco perché le organizzazioni che modernizzano questa funzione di solito finiscono per riprogettare anche le attività adiacenti. L'automazione del reporting costringe i team a standardizzare ownership dei dati, conservazione delle evidenze e percorsi di escalation. Nella pratica, questo si sovrappone spesso a iniziative più ampie per ottimizzare i workflow aziendali, perché è nei passaggi di consegne fragili che la qualità del reporting tende a cedere.
I quattro livelli che contano
Una piattaforma efficace ha quattro livelli operativi.
Aggregazione automatizzata dei dati
Si collega ai sistemi che contengono i fatti: archivi transazionali, sistemi di identità, piattaforme di ticketing, repository delle policy, tabelle del data warehouse e log. La chiave è la coerenza. I dati dovrebbero arrivare tramite un meccanismo ripetibile, non tramite esportazioni improvvisate.Validazione continua
È qui che molti strumenti più datati non sono all'altezza. I controlli tradizionali basati su regole funzionano per condizioni note come campi obbligatori, valori ammessi, logica delle date e riconciliazioni. Non funzionano bene quando le normative si basano sul contesto, su pattern insoliti o su derive emergenti. Le architetture moderne combinano una validazione configurabile con il rilevamento delle anomalie basato sull'AI, così che la piattaforma possa intercettare sia le violazioni esplicite sia i cambiamenti sospetti che le regole statiche non avevano mai previsto.Generazione di report verificabili
Un report è difendibile solo se potete spiegare come è stato prodotto. Ciò significa conservare la logica di calcolo, versionare i template e ricondurre gli output ai record sorgente e alle approvazioni.Conservazione sicura delle evidenze
Le evidenze devono restare accessibili, organizzate e collegate al workflow di controllo. Se screenshot, approvazioni e note sulle eccezioni risiedono in strumenti scollegati, l'audit trail si interromperà nel momento in cui qualcuno chiederà una prova.
Un solido framework di automazione non si limita a creare un report. Crea un report che potete difendere sei mesi dopo, sotto esame.
Questa distinzione conta perché molti prodotti “imposta e dimentica” automatizzano attività ripetitive senza affrontare il rischio interpretativo. Negli ambienti fortemente regolamentati, a vincere non è lo strumento che elimina più clic. È quello che preserva il contesto mentre scala il controllo.
Pattern chiave di architettura e implementazione
È l'architettura a decidere se l'automazione del reporting di compliance semplificherà il vostro ambiente o creerà un nuovo silo di reporting. La maggior parte delle architetture aziendali rientra in uno di due pattern.
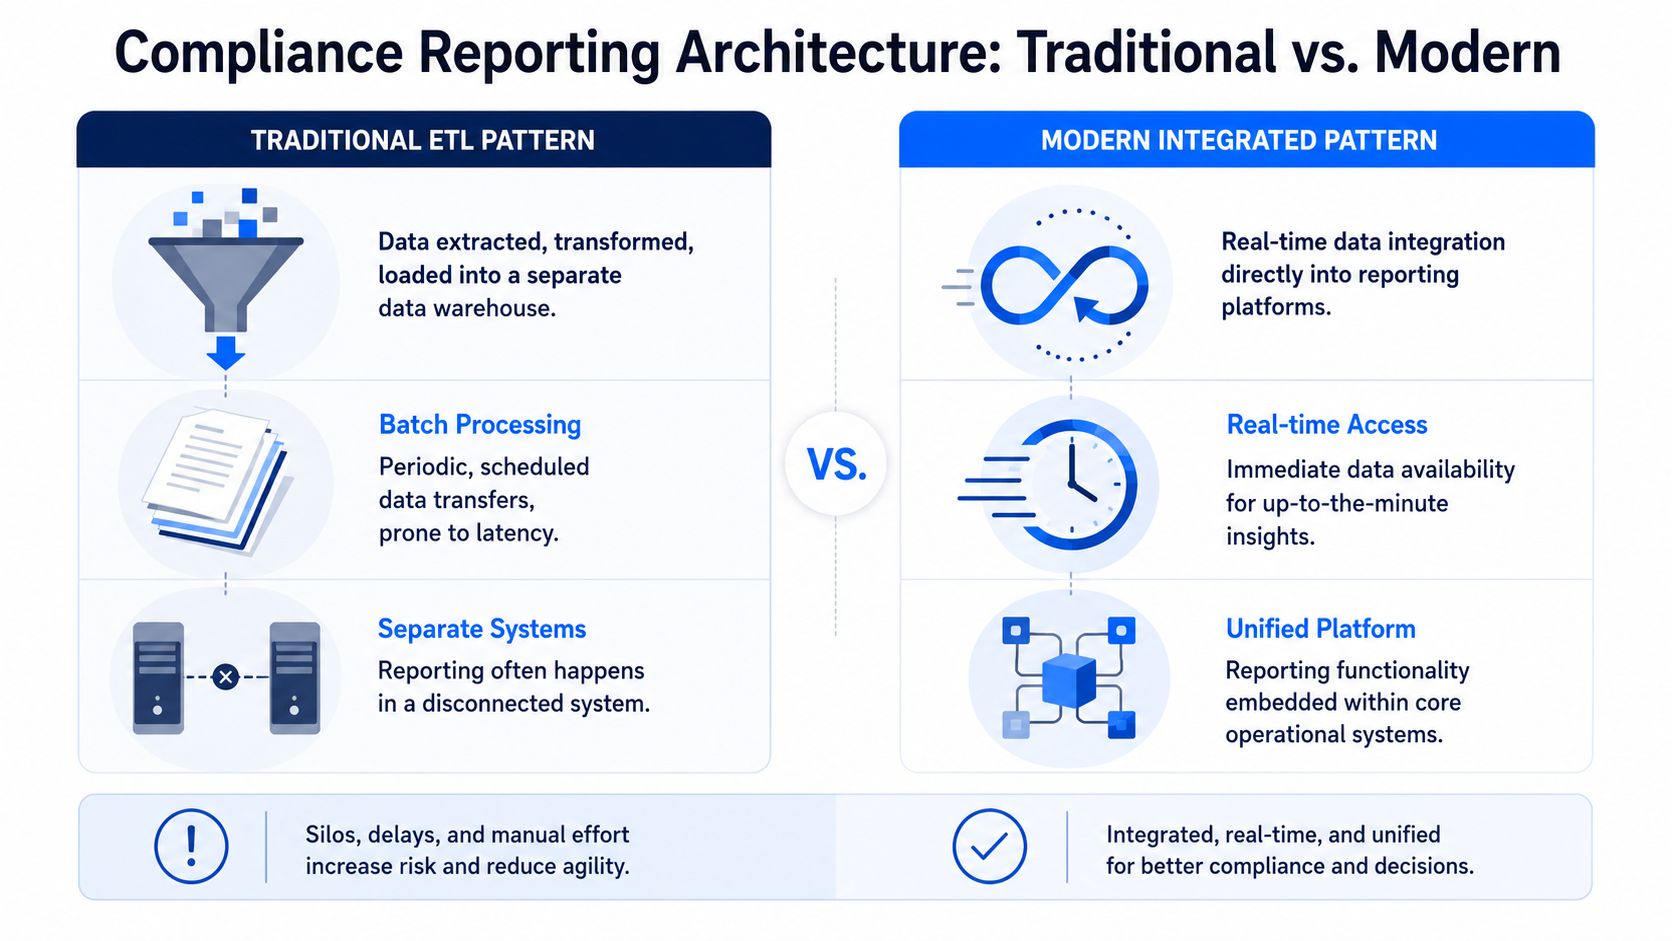
Il modello ETL-first
Nell'approccio tradizionale, i team estraggono i dati dai sistemi operativi, li trasformano e li caricano in un'applicazione di compliance o in un archivio di reporting separati. Questo modello è familiare. Può funzionare. Introduce però anche problemi prevedibili.
Ogni passaggio di spostamento dei dati crea un ulteriore punto in cui tempistiche, logica o permessi possono discostarsi dalla fonte di verità. Le finestre batch aggiungono latenza. L'archiviazione duplicata solleva questioni di residenza e conservazione. E quando un auditor chiede perché il report di compliance differisce dal record operativo, i team scoprono spesso che la risposta si trova in un job di trasformazione che nessuno esamina da mesi.
Il pattern ETL-first è di solito il più facile da acquistare e il più difficile da difendere su larga scala.
Il modello in-database
Il pattern più moderno esegue l'analisi e il calcolo delle metriche all'interno del database, del data warehouse o del data lake del cliente. I dati sensibili restano dove la governance esiste già. La piattaforma porta la logica ai dati invece di spostare i dati in un ambiente separato controllato dal fornitore.
Per le aziende regolamentate, questo conta per ragioni pratiche:
Postura di sicurezza: meno spostamenti di dati significano meno copie da proteggere.
Latenza: i controlli possono essere eseguiti più vicino agli eventi sorgente.
Sovranità: i dati restano all'interno dell'ambiente controllato dal cliente.
Chiarezza operativa: gli ingegneri possono esaminare lo stesso patrimonio di dati di cui il business già si fida.
Questo pattern supporta anche un mix migliore di tipi di controllo. La validazione configurabile gestisce i requisiti espliciti. Il rilevamento delle anomalie basato sull'AI fa emergere derive, distribuzioni insolite e scostamenti sottili che non rientrano nelle regole predefinite. È questa combinazione che manca ai prodotti più datati basati “solo su un motore di regole”. Spesso il mancato rispetto di normative ambigue non dipende da un campo vuoto. Dipende da un dataset che si è comportato in modo strano senza che nessuno indagasse.
Su cosa dovrebbero insistere i team regolamentati
Esiste un requisito critico per qualsiasi architettura basata sull'AI. Gli strumenti di automazione della compliance basati sull'AI richiedono audit log trasparenti, esportabili, ricercabili e collegati ai workflow originali, per spiegare come sono stati identificati i problemi segnalati, richiedere timestamp per le approvazioni e registrare attestazioni od override degli utenti ai fini della conformità normativa, poiché una logica opaca da "black box" crea rischi critici in sede di ispezione (Regly).
Questo singolo requisito dovrebbe escludere un numero sorprendente di fornitori.
Quando le aziende hanno bisogno di un aiuto esterno per implementare questi pattern, vale la pena esaminare il panorama delle principali società di data engineering per le grandi aziende, per capire chi sa lavorare in architetture regolamentate invece di imporre pattern di analytics generici ai carichi di lavoro di compliance.
Un semplice test decisionale aiuta. Se la piattaforma richiede un'ampia replica dei dati in uno stack separato, nasconde la propria logica di rilevamento o non riesce a ricondurre le eccezioni ai workflow sorgente, in seguito creerà problemi in sede di audit. Se calcola vicino ai dati, supporta controlli spiegabili e conserva lo storico dei workflow, è molto più probabile che superi un'ispezione reale.
Collegare la Data Observability alle esigenze di compliance
I team di compliance descrivono spesso il problema con il linguaggio delle policy. I team dati vivono lo stesso problema come deriva della qualità, pipeline interrotte, caricamenti in ritardo e cambiamenti inspiegabili. La Data Observability è il punto in cui queste due prospettive finalmente si incontrano.
Perché l'osservabilità fa parte della progettazione della compliance
Un report di compliance fallisce molto prima che venga generato il PDF. Fallisce quando i dati a monte arrivano in ritardo, quando un campo cambia tipo, quando una trasformazione scarta inavvertitamente dei record o quando una distribuzione si sposta abbastanza da distorcere una metrica di controllo. I processi manuali raramente intercettano per tempo questi problemi, perché esaminano gli output quando la finestra di reporting è già a rischio.
I sistemi automatizzati migliorano la situazione validando i dati in modo continuo e consolidando le evidenze. I sistemi automatizzati di reporting di compliance riducono i tassi di errore umano di oltre il 90% rispetto ai processi manuali basati su fogli di calcolo, grazie alla validazione dei dati in tempo reale e alla raccolta centralizzata delle evidenze in un unico "system of record" (ZenGRC).
Questo risultato ha senso dal punto di vista ingegneristico. I fogli di calcolo frammentano lo stato. Un livello di osservabilità governato lo centralizza.
Nella documentazione per il consiglio di amministrazione, i fallimenti di compliance sembrano spesso fallimenti delle policy. Nella piattaforma dati, di solito nascono come guasti delle pipeline non rilevati, tabelle obsolete o record non validi.
Mappare le funzionalità sugli obblighi
Nel valutare gli strumenti, mapperei direttamente le funzionalità tecniche sulle esigenze di audit. L'esercizio elimina molto rumore dalle demo dei fornitori.
Requisito di compliance | Funzionalità richiesta | Esempio di funzione della piattaforma |
|---|---|---|
Valori riportati accurati | Applicazione delle regole di business a livello di record | Validazione dei dati per campi obbligatori, soglie e controlli di riconciliazione |
Invii normativi tempestivi | Monitoraggio degli orari di arrivo attesi e dei ritardi | Monitoraggio della tempestività con alert basati sulla pianificazione |
Rilevamento di rischi di reporting non evidenti | Rilevamento adattivo oltre le soglie statiche | Rilevamento delle anomalie basato sull'AI per variazioni insolite di volume, distribuzione o pattern |
Gestione controllata delle modifiche | Visibilità sulle modifiche strutturali | Tracciamento dello schema per colonne aggiunte, rimosse o modificate |
Audit trail difendibile | Evidenze centralizzate e storico dei workflow | Archivio di evidenze ricercabile collegato ad approvazioni ed eccezioni |
Questa mappatura spiega perché oggi l'osservabilità rientra nella discussione sull'architettura della compliance, e non solo nel backlog del data engineering. Se volete una base più approfondita, questa spiegazione della Data Observability è utile perché inquadra il monitoraggio come una disciplina operativa anziché come un esercizio di dashboard.
La scelta progettuale importante non è tra validazione basata su regole e rilevamento delle anomalie. Servono entrambi. La validazione dimostra che i requisiti noti vengono applicati. Il rilevamento delle anomalie intercetta le incognite, soprattutto quando la deriva dei dati o i cambiamenti di comportamento creano un rischio prima che qualcuno abbia scritto una nuova regola.
L'osservabilità basata sull'AI è particolarmente utile quando le normative si affidano a un'interpretazione qualitativa. Una soglia statica può dirvi se un campo ha violato il formato. Di solito non può dirvi se una popolazione si comporta improvvisamente in un modo che rende inaffidabile un'ipotesi di controllo precedente. È qui che soglie adattive e rilevamento dei pattern aggiungono valore. I benchmark verificati di digna indicano che il rilevamento delle anomalie basato sull'AI può ridurre i falsi positivi del 30-50% rispetto ai sistemi statici basati su regole (digna). Nella pratica, meno falsi positivi significa che i team indagano sui problemi reali invece di silenziare gli alert.
Una roadmap di implementazione e metriche di successo
La maggior parte dei fallimenti nell'automazione del reporting di compliance avviene perché i team partono con un perimetro troppo ampio. Cercano di automatizzare tutti i report, tutti i framework e tutti i percorsi di approvazione contemporaneamente. La strada migliore è più mirata e disciplinata.

Partite da un report che conta
Iniziate con analisi e definizione del perimetro. Scegliete un report ad alto attrito, ad alto rischio e abbastanza frequente da essere rilevante. Vi serve un processo che oggi fa male ma che è ancora abbastanza circoscritto da poter essere sistemato in modo pulito. I buoni candidati di solito coinvolgono più sistemi sorgente, richieste di evidenze ricorrenti e difficoltà di riconciliazione note.
Passate quindi alla progettazione del pilota. Definite sistemi sorgente, responsabili dei dati, regole di validazione, workflow delle eccezioni, approvazioni necessarie e formato dell'output finale. Non saltate l'interpretazione delle policy. Se una regola dipende dal giudizio di business, rendetelo esplicito nel workflow invece di cercare di nasconderlo nel codice.
Un percorso pratico per fasi si presenta così:
Analisi e definizione del perimetro
Censite gli obblighi di reporting, individuate i passaggi manuali più onerosi e documentate dove si trovano attualmente le evidenze.Progettazione e selezione della soluzione
Scegliete dove viene eseguita la validazione, come vengono registrati gli eventi dei workflow e se l'analisi resta all'interno del vostro ambiente.Sviluppo e integrazione
Collegate il primo report a input di livello produttivo. Costruite la gestione delle eccezioni prima di realizzare dashboard rifinite.Test e validazione
Riconciliate gli output automatizzati con il reporting storico e verificate che chi approva sappia spiegare ogni override.Deployment e ottimizzazione
Andate in produzione con un solo report, stabilizzatelo, poi estendete per riutilizzo anziché per riprogettazione.
Il business case è di solito più facile da far approvare di quanto si pensi. Le organizzazioni che implementano l'automazione del reporting di compliance ottengono tipicamente una riduzione del 60-80% del lavoro manuale di compliance e vedono un ROI entro 6-12 mesi grazie a minori costi del personale e a una preparazione degli audit più rapida del 90% (analisi su LinkedIn).
Cosa misurare e cosa evitare
Usate un piccolo insieme di metriche che riflettano la realtà operativa:
Lavoro manuale eliminato: tracciate le ore prima dedicate a raccogliere, riconciliare e confezionare le evidenze.
Durata del ciclo di preparazione degli audit: misurate se la preparazione è passata da mesi a settimane, un risultato comune nella stessa analisi citata sopra.
Qualità della risoluzione delle eccezioni: verificate se i problemi vengono individuati prima e risolti con approvazioni documentate.
Difendibilità dei report: verificate se i team sanno spiegare lineage, validazione e override senza conversazioni a margine.
Per gli ambienti in cui la governance ha un peso rilevante, questa guida all'implementazione della data governance è un utile complemento, perché l'automazione del reporting si sgretola rapidamente quando ownership e gestione delle policy sono poco chiare.
Il primo pilota dovrebbe dimostrare affidabilità, non ampiezza di funzionalità. Se auditor e responsabili dei controlli non riescono a seguire la catena dai dati sorgente al report finale, non avete automatizzato la parte difficile.
Gli errori comuni sono sempre gli stessi. I team trattano l'iniziativa come un progetto IT. Sottovalutano i problemi dei dati sorgente. Automatizzano eccessivamente decisioni discrezionali che dovrebbero restare affidate a revisori responsabili. E acquistano strumenti che sembrano efficienti in una demo ma non sanno produrre un audit trail difendibile in produzione.
Casi d'uso in finanza, sanità e telecomunicazioni
I settori regolamentati adottano l'automazione del reporting di compliance per ragioni diverse, ma lo schema operativo è simile. La raccolta manuale crea ritardi. Le regole statiche non colgono il contesto. Un tessuto di controllo migliore combina validazione governata, rilevamento delle anomalie e acquisizione delle evidenze.

Lo slancio del mercato riflette questa pressione. Il mercato globale degli strumenti di automazione della compliance era valutato 2,53 miliardi di USD nel 2023 e si prevede che cresca a un CAGR del 19,7% fino al 2030, a testimonianza di una forte domanda trainata dalla complessità normativa in settori come finanza e sanità (report di mercato di Yahoo Finance).
Finanza
Nel banking e nei mercati dei capitali, il reporting spesso si inceppa su lineage e spiegabilità, non solo sull'estrazione dei dati. Un workflow AML può raccogliere correttamente l'attività transazionale e creare comunque esposizione se gli investigatori non sanno spiegare perché un caso è stato sottoposto a escalation, archiviato o oggetto di override. Lo stesso schema si ritrova nelle attività di aggregazione dei dati di rischio in stile BCBS 239. I numeri contano, ma la tracciabilità conta altrettanto.
L'architettura più solida mantiene la validazione vicino ai dati sorgente, monitora le variazioni insolite nei pattern transazionali e conserva con timestamp le attestazioni degli investigatori. I controlli basati su regole intercettano i fallimenti espliciti. Il rilevamento delle anomalie evidenzia popolazioni o comportamenti che meritano una revisione anche quando nessuna regola predefinita è scattata.
Sanità
Le organizzazioni sanitarie affrontano un tipo diverso di complessità. Il reporting legato all'HIPAA spesso richiede di dimostrare chi ha avuto accesso a informazioni sanitarie protette, se l'accesso era coerente con ruolo e processo e come sono state gestite le eccezioni. I log manuali possono rispondere in parte, ma raramente offrono una catena semplice dall'evento alla revisione fino all'azione approvata.
L'automazione aiuta correlando eventi di accesso, logica di validazione ed evidenze in un unico record controllato. Se un flusso di dati cambia, se i pattern di attività attesi derivano o se manca un attributo obbligatorio, il processo di reporting può segnalarlo prima che venga assemblato il fascicolo di audit. Questo riduce la probabilità che un team di compliance scopra la propria lacuna di reporting nel momento peggiore possibile.
Telecomunicazioni
Gli operatori di telecomunicazioni si trovano spesso all'incrocio tra obblighi di privacy, reporting sulla rete e SLA operativi. Permessi sui dati dei clienti, registri dei servizi e metriche di performance possono provenire da sistemi diversi con cicli di aggiornamento diversi. Un caricamento in ritardo o una modifica di schema in una pipeline può distorcere un invio senza alcun guasto evidente nella dashboard finale.
Una configurazione più resiliente controlla sia il contenuto sia il movimento dei dati. La validazione conferma le strutture richieste e le regole di policy. I controlli di tempestività mostrano se i flussi a monte sono arrivati quando dovevano. Il rilevamento delle anomalie individua oscillazioni insolite di volumi o pattern che i controlli statici considerano tecnicamente validi ma che sono sospette sul piano operativo.
La lezione comune a tutti e tre i settori è semplice. L'automazione funziona meglio quando non finge che ogni questione di compliance sia binaria. Il reporting moderno ha bisogno di controlli espliciti per i requisiti noti e di un rilevamento adattivo per le zone grigie che le regole statiche non sanno interpretare da sole.
Se il vostro team sta cercando di ridurre la corsa agli audit senza rinunciare alla privacy dei dati, vale la pena dare un'occhiata a digna. Combina rilevamento delle anomalie basato sull'AI, validazione a livello di record, monitoraggio della tempestività e tracciamento dello schema, il tutto eseguito all'interno di ambienti controllati dal cliente: esattamente il modello di cui molte aziende regolamentate hanno bisogno quando vogliono un'automazione del reporting di compliance più solida senza spostare dati sensibili in una black box gestita dal fornitore.
Per l'applicazione a livello di record alla base dell'obbligo di "valori riportati accurati" nella tabella sopra, guardate come digna Data Validation applica le regole di business all'interno del vostro database.
Domande frequenti
Che cos'è l'automazione del reporting di compliance?
È un processo governato, non solo uno script, un workflow di approvazione o una dashboard. L'articolo descrive quattro livelli: aggregazione automatizzata dei dati dai sistemi sorgente, validazione continua, generazione di report verificabili con logica versionata e conservazione sicura delle evidenze collegata al workflow di controllo. L'obiettivo è un report che potete difendere sei mesi dopo.
Qual è la differenza tra architetture di compliance ETL-first e in-database?
L'ETL-first copia i dati in un archivio di compliance separato, aggiungendo latenza batch, archiviazione duplicata e job di trasformazione che possono discostarsi dalla fonte di verità. Il modello in-database porta invece la logica ai dati, così che i record sensibili restino dove la governance esiste già, con meno copie da proteggere e controlli eseguiti più vicino agli eventi sorgente.
Quanto lavoro manuale può far risparmiare l'automazione del reporting di compliance?
Secondo un'analisi su LinkedIn citata nell'articolo, le organizzazioni ottengono tipicamente una riduzione del 60-80% del lavoro manuale di compliance, un ROI entro 6-12 mesi e una preparazione degli audit più rapida del 90%. L'articolo cita inoltre il dato di ZenGRC secondo cui i sistemi automatizzati riducono i tassi di errore umano di oltre il 90% rispetto ai processi basati su fogli di calcolo.
In che modo la Data Observability supporta la conformità normativa?
L'osservabilità intercetta i guasti a monte che in seguito diventano fallimenti di compliance: caricamenti in ritardo, tipi di campo modificati, record scartati e spostamenti delle distribuzioni. L'articolo associa ogni obbligo a una funzionalità, ad esempio gli invii tempestivi al monitoraggio degli orari di arrivo, i valori accurati alla validazione a livello di record e la gestione controllata delle modifiche al tracciamento dello schema per colonne aggiunte, rimosse o modificate.
Da dove dovrebbe partire un progetto di automazione del reporting di compliance?
Iniziate da un report ad alto attrito, ad alto rischio e frequente, idealmente che coinvolga più sistemi sorgente e difficoltà di riconciliazione note. Procedete poi con definizione del perimetro, progettazione della soluzione, integrazione, test rispetto ai report storici e deployment. Costruite la gestione delle eccezioni prima delle dashboard rifinite ed estendete per riutilizzo una volta stabilizzato il primo report.


