Audit della qualità dei dati: come condurre un audit affidabile
|
9
min di lettura

Di solito non vi viene chiesto un audit dei dati quando tutto è tranquillo.
Inizia quando una dashboard smette di coincidere con i numeri della finanza, quando un ente regolatore chiede come è stato prodotto un valore o quando un modello inizia a comportarsi in modo strano dopo una modifica non documentata in un sistema sorgente. A quel punto i team scoprono che stavano facendo controlli a campione, non un vero audit della qualità dei dati. Possono dire che una tabella “la settimana scorsa sembrava a posto”, ma non sanno mostrare quali criteri sono stati usati, quali evidenze sono state raccolte, chi ha revisionato il risultato o se lo stesso controllo porterebbe alla stessa conclusione il mese successivo.
Questo divario conta più di quanto molti si aspettino. Una query occasionale può individuare un difetto. Un audit deve reggere quando qualcuno chiede delle prove.
Indice
Perché l'audit della qualità dei dati conta prima ancora di controllare un singolo record
Che cosa serve davvero ai team da un audit
Che cosa produce un audit completo
Definire il perimetro dell'audit e inventariare ciò che va davvero controllato
Partire dall'idoneità all'uso
Costruire l'inventario a ritroso partendo dall'output
Fissare i confini prima che qualcuno inizi a testare
Documentare il lineage finché il sistema è ancora fresco nella memoria delle persone
Scegliere i controlli giusti e decidere come testarli
Partire dalle dimensioni e trasformarle in controlli
Campionamento, scansioni complete e monitoraggio continuo hanno ciascuno il loro posto
Testare i controlli in un pilota prima di trattarli come evidenze
Eseguire l'audit e raccogliere evidenze solide
Eseguire il più vicino possibile ai dati
Trattare lineage e tracciabilità come evidenze, non come decorazioni
Registrare anche i quasi-incidenti e le modifiche alle sorgenti
Trasformare i risultati in correzioni con responsabilità chiare e tracciamento
Il report deve fare più che riassumere i difetti
Assegnare la responsabilità per punto di controllo, non per colpa
Tracciare fino alla chiusura con una verifica, non solo con uno stato
Rendere gli audit ripetibili e pronti per il monitoraggio continuo
Mantenere il ciclo di audit snello e ricco di evidenze
Tenere d'occhio le modalità di guasto che gli audit rilevano ripetutamente
Scalare standardizzando il modello di controllo
Perché l'audit della qualità dei dati conta prima ancora di controllare un singolo record
Il momento di pressione è familiare. Uno stakeholder vuole sapere se un report è affidabile e l'istinto è di buttarsi subito su conteggi delle righe, controlli dei null e duplicati. È utile, ma non è ancora un audit. Se non definite prima i criteri, il risultato è solo attività tecnica senza una conclusione difendibile.
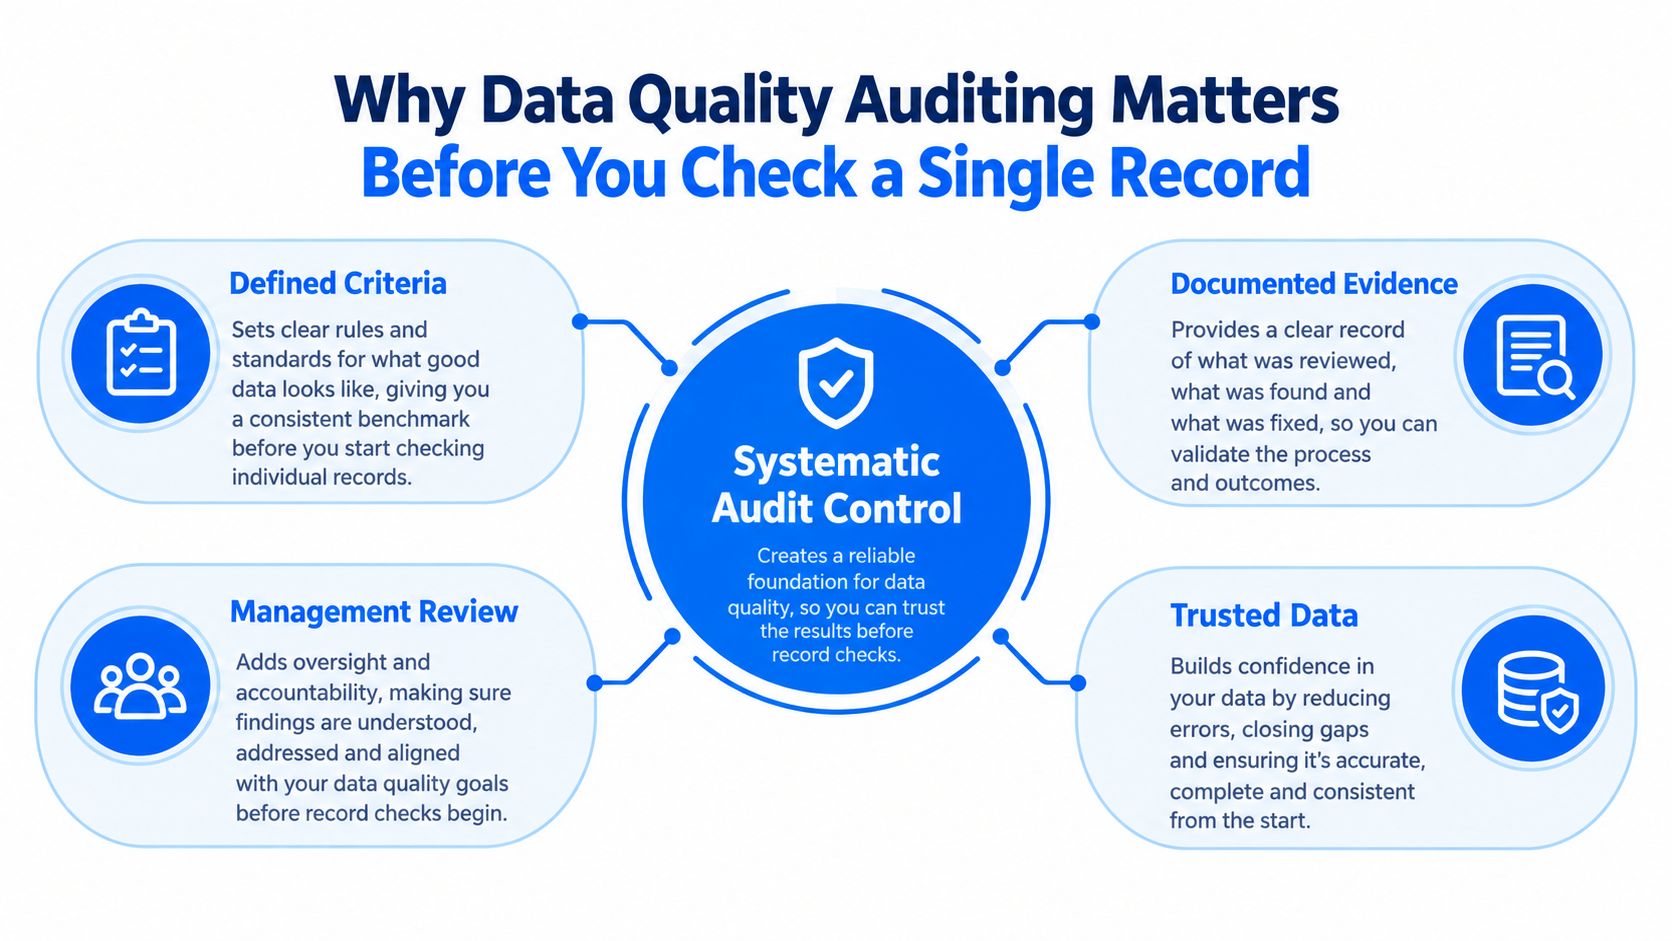
Esiste uno standard consolidato per questo. La ISO definisce un audit come un “processo sistematico, indipendente e documentato” per ottenere evidenze e valutarle rispetto a dei criteri, che è la base degli audit ripetibili sulla qualità dei dati in settori e amministrazioni pubbliche, come riassunto nel manuale ONU ed Eurostat sui metodi e gli strumenti di valutazione della qualità dei dati. Questa definizione è più pratica di quanto sembri. Vi dice cosa deve dimostrare un vero audit:
Sistematico significa che i controlli non sono improvvisati.
Indipendente significa che i risultati possono reggere a una revisione esterna al team di delivery.
Documentato significa che qualcun altro può esaminare le evidenze in seguito e giungere alla stessa conclusione.
Che cosa serve davvero ai team da un audit
In pratica, la prima vittoria è un linguaggio condiviso. I programmi di audit del settore pubblico strutturano comunemente i risultati attorno ad accuratezza, completezza, coerenza, tempestività, validità e unicità. Queste dimensioni non sono accademiche. Mettono fine alla solita discussione in cui l'engineering dice “la pipeline è andata a buon fine”, la finanza dice “il report è sbagliato” e la compliance dice “i dati sono arrivati in ritardo”.
Un team che fa audit per dimensione può distinguere modalità di guasto diverse:
Accuratezza chiede se il valore rispecchia la realtà.
Completezza chiede se mancano record o campi attesi.
Tempestività chiede se i dati sono arrivati in tempo per la decisione.
Coerenza chiede se lo stesso fatto concorda tra i sistemi.
Validità chiede se i valori rispettano regole e formati.
Unicità chiede se un'entità compare una sola volta quando dovrebbe.
Se la vostra organizzazione tratta ancora queste dimensioni come etichette di qualità astratte, è utile collegarle al motivo per cui la qualità dei dati è importante per un'organizzazione. Ogni domanda del management sulla fiducia nei dati finisce prima o poi su una di queste dimensioni.
Che cosa produce un audit completo
Un audit completo non si conclude con “abbiamo trovato righe errate”. Lo stesso manuale ONU ed Eurostat sottolinea che le conclusioni dell'audit vanno riassunte in un report, revisionate dal management e trasformate in un piano d'azione. È il ciclo di controllo che molti team saltano.
Regola pratica: se l'output del lavoro è solo un foglio di calcolo con i problemi, avete eseguito un'ispezione. Se l'output sono evidenze, conclusioni, revisione e azioni correttive, avete eseguito un audit.
Questa distinzione è il motivo per cui l'audit della qualità dei dati conta prima ancora che qualcuno controlli un singolo record. Il framework di audit determina quali evidenze contano, cosa significa un fallimento, chi dà l'approvazione e cosa succede dopo. Senza di esso, nemmeno dei buoni controlli tecnici produrranno risultati affidabili.
Definire il perimetro dell'audit e inventariare ciò che va davvero controllato
Un audit debole di solito fallisce prima ancora che inizino i test. Il perimetro è vago, i responsabili sono poco chiari e metà dei dati del report non è nemmeno nell'inventario. I team sprecano quindi tempo a validare colonne irrilevanti mentre si lasciano sfuggire proprio la trasformazione che guida la decisione che sta a cuore a tutti.
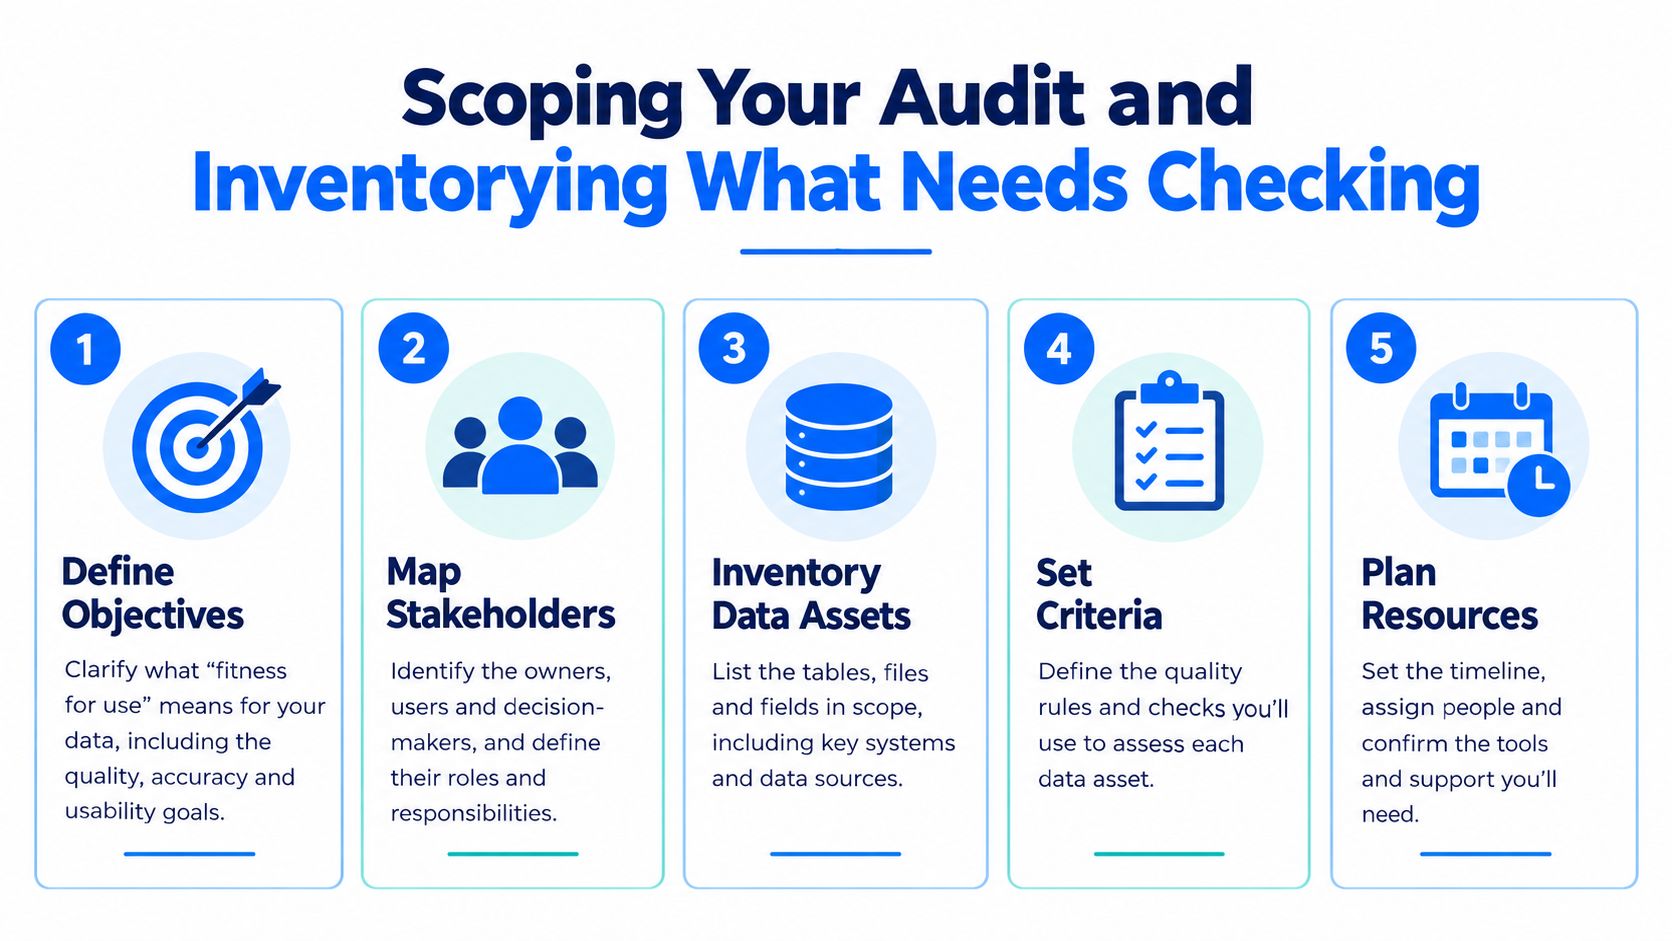
La prima disciplina è semplice. Definite il perimetro dell'audit attorno all'uso previsto, non attorno alle tabelle più facili da raggiungere.
Partire dall'idoneità all'uso
Il lavoro del NIST sulla qualità dei dati sottolinea che la qualità è contestuale e va valutata rispetto all'uso previsto, non con un punteggio universale astratto: la qualità è definita in termini di idoneità all'uso e legata ai requisiti di business nella trattazione di impostazione NIST sul contesto e la valutazione della qualità dei dati. Ciò significa che un dataset può superare un audit e non superarne un altro se cambia il contesto decisionale.
Una segnalazione regolamentare, ad esempio, richiede criteri di completezza e tracciabilità diversi rispetto a una dashboard interna sulle performance. Un dataset di addestramento per un modello può tollerare un certo ritardo, ma non classi etichettate in modo errato. Un feed per le operazioni con i clienti può richiedere una freschezza rigorosa anche quando alcuni campi di arricchimento sono facoltativi.
Prima di elencare gli asset, mettete per iscritto tre cose:
La decisione di business o l'obbligo che i dati supportano.
L'output specifico di cui ci si fida o che viene contestato.
La conseguenza di un fallimento se i dati arrivano in ritardo, sono errati, incompleti o cambiano struttura.
Costruire l'inventario a ritroso partendo dall'output
Non partite dal catalogo del warehouse sperando che la rilevanza emerga da sola. Partite dal report, dalla dashboard, dal set di feature del modello o dal documento da presentare, poi risalite a ritroso fino a tabelle sorgente, join, trasformazioni, dati di riferimento e job di consegna.
Un inventario utilizzabile comprende più dei semplici nomi delle tabelle:
Output critici come report, modelli, alert o comunicazioni esterne.
Asset a monte, tra cui tabelle sorgente, livelli di staging, logica di trasformazione e tabelle di riferimento di business.
Dipendenze operative come pianificazioni, aspettative di consegna e consumatori a valle.
Responsabili nominativi per i dati sorgente, la logica di trasformazione e l'accettazione da parte del business.
Per i team che vogliono formalizzare questo aspetto, un elenco definito di elementi di dati critici è di solito il modo più rapido per fermare l'espansione incontrollata del perimetro. Non tutti i dataset meritano la stessa profondità di audit. Quelli che alimentano la reportistica regolamentata, le decisioni sui clienti, le registrazioni contabili o l'AI in produzione di solito sì.
Fissare i confini prima che qualcuno inizi a testare
La maggior parte degli attriti negli audit nasce da errori sui confini. Un team dice che la “pipeline dei ricavi dei clienti” rientra nel perimetro, ma nessuno specifica se ciò include le estrazioni dai sistemi sorgente, la logica di arricchimento, le slowly changing dimension, gli interventi manuali o la gestione delle eccezioni.
Usate confini espliciti come questi:
Area del perimetro | Cosa definire |
|---|---|
Confine di business | Quale decisione, report, comunicazione o modello è coperto |
Confine dei dati | Quali dataset, campi e periodi di tempo sono inclusi |
Confine di processo | Quali trasformazioni, pianificazioni e passaggi di consegna sono inclusi |
Confine di responsabilità | Chi approva le regole, chi interviene sui problemi, chi dà l'approvazione finale |
Il perimetro dell'audit dovrebbe essere abbastanza ristretto da poter essere eseguito e abbastanza ampio da spiegare il numero finale.
Documentare il lineage finché il sistema è ancora fresco nella memoria delle persone
La documentazione del lineage viene rimandata perché i team pensano di poterla ricostruire più tardi. Di solito non ci riescono. La persona che sa perché esiste un join di fallback se ne va, oppure la soluzione d'emergenza di sei mesi fa diventa un comportamento normale e invisibile.
Durante l'inventario degli asset, registrate:
da dove ha origine ciascun campo critico
quale trasformazione lo crea o lo modifica
se esiste una rettifica manuale
quale pianificazione o evento lo consegna
chi dovrebbe accorgersene se smette di arrivare
Questo livello di inventario sembra pesante solo fino alla prima riunione di revisione. Poi diventa la differenza tra un'indagine rapida e una settimana di congetture.
Scegliere i controlli giusti e decidere come testarli
Una volta che il perimetro è concreto, l'errore successivo è scegliere i controlli per abitudine. I team ripiegano spesso su percentuali di null, conteggi dei duplicati e qualche regola regex perché sono facili da scrivere. Va bene per l'igiene di base. Non basta per un audit difendibile.
Vi servono controlli adeguati all'obiettivo dell'audit e un approccio di test adeguato al rischio, al volume e alla velocità di cambiamento dei dati.
Partire dalle dimensioni e trasformarle in controlli
Il framework di qualità dei dati DAMA, comunemente usato nella governance aziendale, identifica sei dimensioni fondamentali: accuratezza, completezza, coerenza, tempestività, unicità e validità; lo stesso materiale definisce operativamente la tempestività come il fatto che i dati siano abbastanza freschi da poter essere usati, con controlli d'esempio formulati come soglie misurabili, ad esempio un tempo dall'ultimo aggiornamento inferiore a un limite scelto, come meno di un'ora dall'ingestione, come descritto in questa panoramica sulle dimensioni della qualità dei dati e i controlli operativi.
Questo è importante perché trasforma aspettative vaghe in controlli testabili. “I dati devono essere aggiornati” non è verificabile in un audit. “Questa tabella deve aggiornarsi entro la soglia di freschezza concordata per l'esecuzione del report” lo è.
Ecco un modo compatto per scegliere.
Obiettivo dell'audit | Controlli consigliati | Approccio di test |
|---|---|---|
Reportistica regolamentare o direzionale | Controlli di completezza, accuratezza, tempestività e riconciliazione | Scansioni complete per campi e record chiave, più monitoraggio pianificato della tempestività |
Dati anagrafici di clienti o entità | Unicità, validità, coerenza tra sistemi | Rilevamento completo dei duplicati per gli identificativi principali, controlli mirati sulle regole per gli attributi critici |
Dashboard operative in rapido cambiamento | Tempestività, stabilità dello schema, anomalie nel volume dei record | Monitoraggio continuo con controlli su soglie e drift |
Feature dei modelli o dataset di input per l'AI | Validità, completezza, coerenza di etichette o attributi | Controlli continui sui campi critici, revisione periodica più approfondita su porzioni rappresentative |
Sistemi sorgente appena integrati | Validità del formato, pattern dei null, coerenza referenziale | Prima test pilota, poi esecuzione più ampia quando i pattern si stabilizzano |
Campionamento, scansioni complete e monitoraggio continuo hanno ciascuno il loro posto
Il campionamento funziona ancora quando i volumi di dati sono grandi e il processo è stabile, ma non regge quando gli schemi cambiano spesso o quando un difetto raro ha un impatto elevato. Le scansioni complete sono più efficaci per regole deterministiche sui dati critici, soprattutto nei warehouse moderni dove l'esecuzione in-database è praticabile. Il monitoraggio continuo è la scelta giusta quando caricamenti in ritardo, drift strutturale o modifiche operative possono compromettere la fiducia tra un ciclo di audit formale e l'altro.
Anche i framework di audit indipendenti supportano l'idea che la scelta del metodo conti. La letteratura più recente riassunta nel framework FAO descrive quattro approcci di alto livello e 15 metodi distinti, un utile promemoria del fatto che un audit maturo è un lavoro di selezione del metodo, non una checklist fissa, come illustrato nel materiale FAO sui metodi di valutazione della qualità dei dati.
Alcuni compromessi si presentano ripetutamente:
Il campionamento è più leggero quando i record sono costosi da esaminare manualmente, ma non coglierà ogni caso limite.
Le scansioni complete sono più efficaci per completezza, validità, unicità e regole di business deterministiche.
I controlli continui sono necessari quando freschezza e modifiche allo schema possono invalidare gli output a valle tra una revisione pianificata e l'altra.
Testare i controlli in un pilota prima di trattarli come evidenze
Uno dei fallimenti più comuni negli audit è una cattiva progettazione dei test. Le linee guida per l'audit clinico segnalano i record incompleti o inaccurati come un'insidia ricorrente e raccomandano test pilota prima della raccolta, la pulizia dei dati man mano che arrivano, l'individuazione di pattern di distorsione come record esclusi sistematicamente e la revisione di moduli o protocolli quando gli errori si ripetono, come riassunto nello stesso riferimento al framework di audit FAO.
È un buon consiglio anche dal punto di vista ingegneristico. Testate i vostri controlli su una porzione più piccola ma rappresentativa prima di eseguirli su larga scala. Individuerete in fretta le ipotesi sbagliate:
una regola di validità che fa fallire valori legacy ma accettati
una regola sui duplicati che confonde le tabelle storiche con quelle dello stato attivo
una regola di tempestività che ignora i calendari di business noti
un test di completezza che scambia per difetti campi volutamente poco popolati
Per esempi pratici di progettazione delle regole e di applicazione sempre attiva, questa guida su regole di validazione dei dati, controlli e qualità dei dati continua è utile perché resta vicina all'implementazione più che alla teoria.
Un controllo non è buono perché viene eseguito. È buono perché un revisore può capire perché esiste, cosa significa un fallimento e se la soglia corrisponde all'uso di business.
Eseguire l'audit e raccogliere evidenze solide
L'esecuzione è il punto in cui molti audit diventano fragili. I controlli vengono eseguiti, compaiono i risultati e poi nessuno sa rispondere alle domande di revisione di base: quale versione della regola è stata eseguita? Su quale stato del dataset? La sorgente era in ritardo? Lo schema era cambiato prima del fallimento? Si trattava di un difetto isolato o del risultato di una modifica nota a monte?
Ecco perché la progettazione delle evidenze conta quanto la progettazione dei test.
Eseguire il più vicino possibile ai dati
Nella maggior parte degli ambienti warehouse e lake, lo schema più pulito è eseguire i controlli in-database. Riduce gli spostamenti di dati, preserva i confini di sicurezza ed evita il problema collaterale di creare l'ennesima copia di dati sensibili per l'attività di audit.
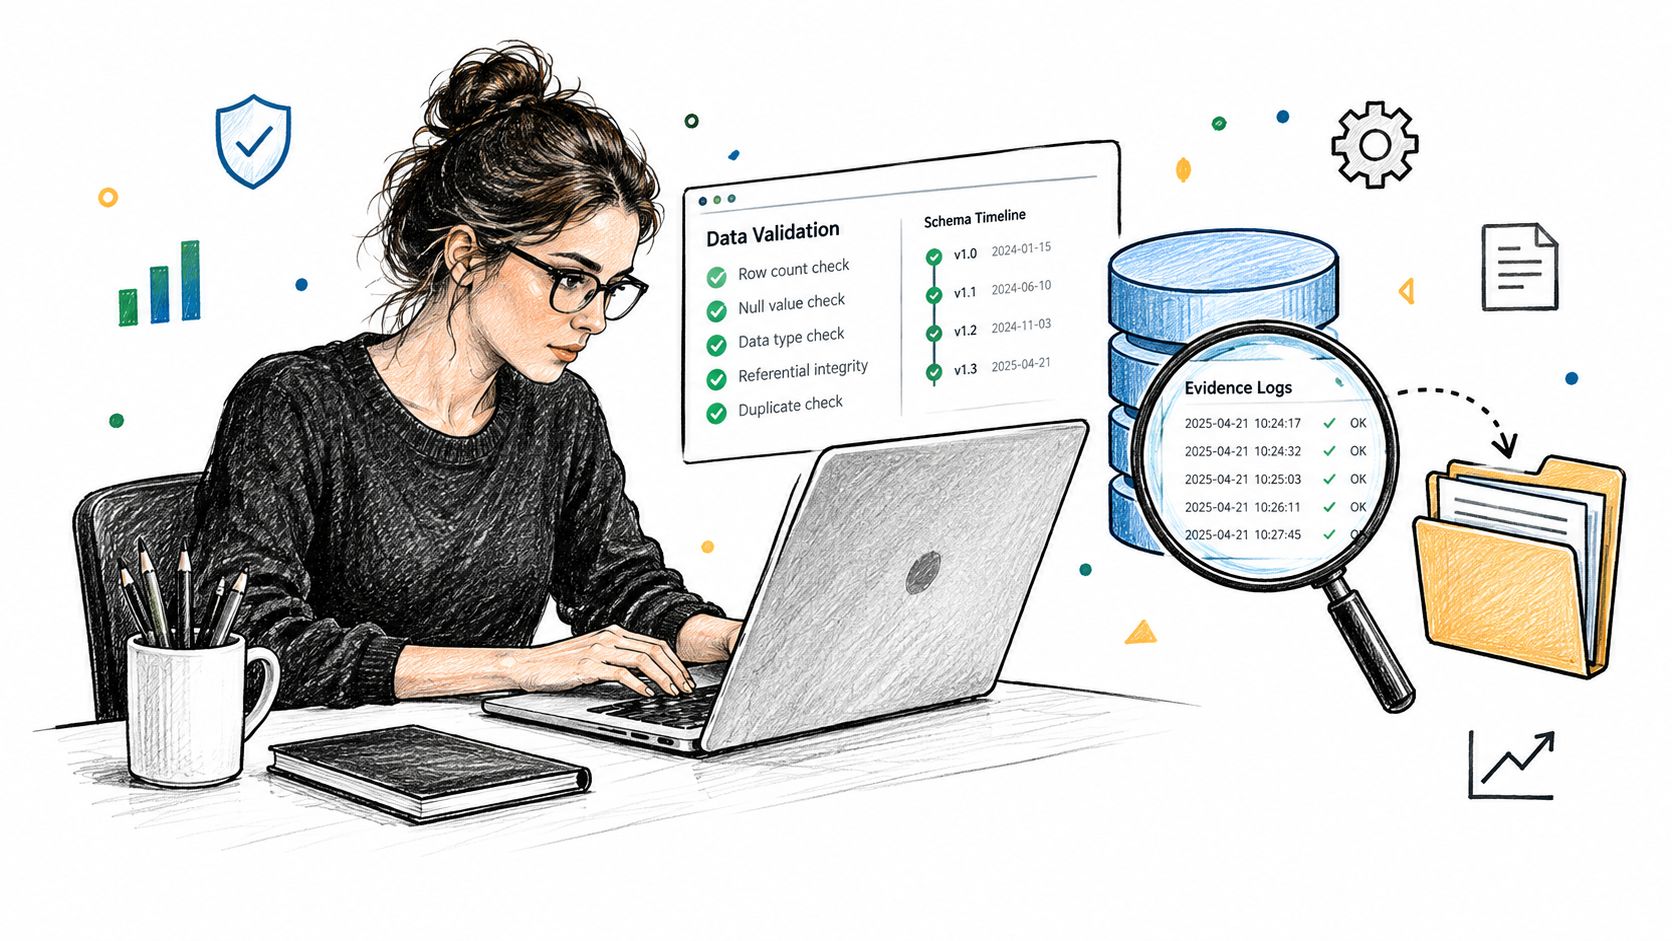
Durante l'esecuzione, registrate più di un semplice superato o fallito:
Contesto del dataset, come ambiente, schema, tabella e partizione o finestra temporale
Contesto della regola, comprese versione della logica, soglia e stato di approvazione
Contesto di esecuzione, come orario di esecuzione, stato di consegna della sorgente ed eventuali avvisi sulle dipendenze
Contesto del risultato, compresi conteggi interessati, esempi e classificazione della gravità
Se utilizzate un approccio basato su piattaforma, una menzione è d'obbligo: digna viene eseguito nell'ambiente del cliente, esegue monitoraggio e validazione in-database e mostra incidenti, trend, problemi di tempestività e modifiche allo schema in un'interfaccia condivisa. Questo modello di deployment si adatta bene agli audit perché le evidenze restano vicine ai sistemi sottoposti a revisione invece di essere ricostruite all'esterno.
Trattare lineage e tracciabilità come evidenze, non come decorazioni
La letteratura sulle pratiche aziendali di qualità dei dati considera tracciabilità e lineage come meccanismi centrali dell'audit piuttosto che metadati facoltativi. Gli elenchi di dimensioni derivati da DAMA includono la tracciabilità tra le dimensioni di qualità citate più spesso, e le fonti sulla governance descrivono il lineage come essenziale per capire come i dati vengono trasformati, da dove provengono e come fluiscono tra i sistemi, come discusso in questo documento sulla selezione delle giuste dimensioni della qualità dei dati.
Senza lineage, un controllo fallito a livello di campo vi dice che c'è del fumo. Non vi dice dove è scoppiato l'incendio.
Un registro di evidenze solido dovrebbe consentire a un revisore di rispondere rapidamente a queste domande:
Domanda di revisione | Evidenza necessaria |
|---|---|
Da dove proviene questo campo | Tabella sorgente, campo sorgente, percorso di ingestione |
Cosa è cambiato prima che comparisse il problema | Cronologia dello schema, log di deployment, comunicazione dal processo sorgente |
Come è stato trasformato il campo | Logica di trasformazione, riferimento al job o al modello |
Chi è responsabile della correzione | Responsabile della sorgente, responsabile della pipeline, approvatore di business |
Per i team che hanno bisogno di una disciplina pratica sulla qualità delle evidenze, vale la pena leggere l'articolo di Rivul AI su come verificare le affermazioni non supportate prima della presentazione. Parla di affermazioni anziché di pipeline, ma l'abitudine di fondo è identica: collegare ogni conclusione a un supporto verificabile prima che qualcuno dia l'approvazione.
Registrare anche i quasi-incidenti e le modifiche alle sorgenti
Molti incidenti dannosi iniziano come quasi-incidenti. Una sorgente consegna in ritardo ma arriva comunque prima della scadenza del report. Un campo nullable diventa improvvisamente poco popolato. Una tabella di lookup cambia semantica senza rompere lo schema. Se registrate solo i fallimenti evidenti, vi sfugge il pattern che avrebbe reso prevedibile il fallimento successivo.
Gli insiemi di evidenze più solidi includono quindi:
fallimenti evidenti
avvisi e quasi-incidenti
comunicazioni di modifica dei processi sorgente
modifiche allo schema
violazioni della freschezza
stato della correzione collegato al risultato originale
Per gli schemi di implementazione relativi a controlli basati su regole e audit trail, un data integrity checker dedicato può aiutare ad ancorare le evidenze ai dataset reali e alla cronologia delle esecuzioni, invece che a note degli analisti sparse tra ticket e chat.
Trasformare i risultati in correzioni con responsabilità chiare e tracciamento
Un audit concluso senza un modello di responsabilità è solo frustrazione ben organizzata. I team spesso fanno la parte difficile: individuano difetti reali, ne dimostrano l'impatto e suggeriscono persino le correzioni. Poi i risultati si arenano perché la responsabilità è suddivisa tra i team dei sistemi sorgente, il data engineering, gli analytics e le operations di business.
Questa lacuna nei controlli è comune. Il 44% degli intervistati ha dichiarato che la responsabilità della qualità dei dati è condivisa tra più team, il 61% si affida ancora a controlli manuali o a validazioni basate su SQL e solo il 14% applica gli SLA a livello di intera organizzazione, secondo l'analisi di Thomson Reuters sul divario di validazione nella fiducia nei dati di audit. La responsabilità condivisa non è un male, ma un'approvazione non assegnata sì.
Il report deve fare più che riassumere i difetti
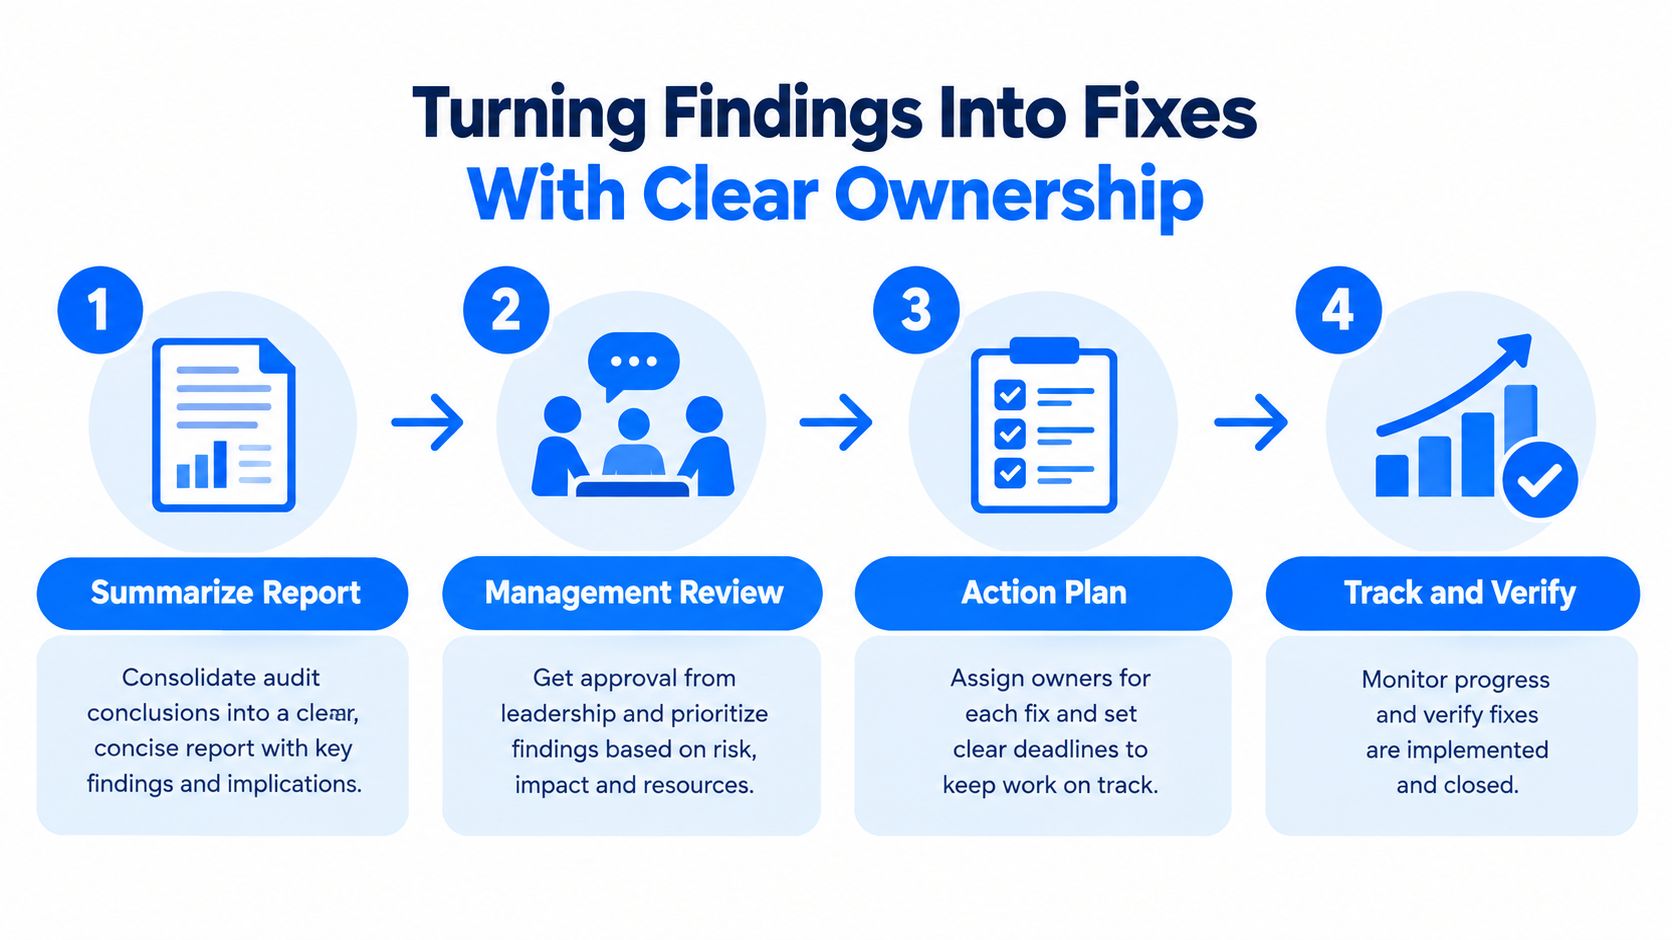
Il manuale di audit ONU ed Eurostat evidenzia un punto operativo importante: le conclusioni dell'audit vanno riassunte in un report, revisionate dal management e convertite in un piano d'azione. Questa sequenza conta perché trasforma i risultati in un cambiamento controllato invece che in una pulizia informale.
Un report dei risultati utilizzabile dovrebbe rispondere a:
cosa è fallito
perché è importante per la decisione o l'obbligo
se il problema riguarda la qualità intrinseca dei dati o il comportamento del sistema
quale mitigazione temporanea esiste
chi è responsabile della correzione definitiva
come verrà verificata la chiusura
Assegnare la responsabilità per punto di controllo, non per colpa
Il modo più rapido per perdere slancio è chiedere: “Di chi è la colpa?” Una domanda migliore: “Quale punto di controllo può impedire che si ripeta?”
Usate il tipo di fallimento per assegnare le azioni:
Problema di acquisizione alla sorgente. Il responsabile è di solito il titolare del processo o del modulo a monte.
Difetto di trasformazione. La correzione spetta al responsabile della pipeline o dell'analytics engineering.
Disallineamento delle definizioni. Deve risolverlo la governance di business o il responsabile della metrica.
Fallimento di consegna o di freschezza. Il responsabile della piattaforma o del job gestisce il controllo operativo.
Intervento manuale ripetuto. È il controllo stesso a dover essere riprogettato, non serve l'ennesima nota di eccezione.
Consiglio operativo: ogni risultato richiede un responsabile della correzione e un responsabile dell'approvazione. Possono essere persone diverse. Non dovrebbero essere un comitato.
Se gli stessi errori continuano a comparire nello stesso modulo, nella stessa estrazione o nello stesso protocollo, rivedete il modulo o il processo. Non limitatevi a ripulire di nuovo l'output. È uno dei pattern più chiari, tanto negli audit clinici quanto in quelli operativi.
Tracciare fino alla chiusura con una verifica, non solo con uno stato
Un ticket che dice “fatto” non equivale alla chiusura dell'audit. Chiusura significa che il difetto è stato corretto, che il controllo è stato aggiornato se necessario e che la verifica ora viene superata con gli stessi criteri che hanno prodotto il risultato originale.
La chiarezza dei ruoli ripaga. Un framework documentato di ruoli e responsabilità per la qualità dei dati aiuta i team a distinguere steward, ingegneri, responsabili di dominio e approvatori, così che i risultati non spariscano nelle caselle di posta condivise.
Il modello di tracciamento più affidabile è semplice:
Elemento di tracciamento | Cosa dovrebbe mostrare |
|---|---|
ID del risultato | Riferimento stabile alle evidenze |
Responsabile assegnato | Persona nominativa responsabile della correzione |
Responsabile dell'approvazione | Revisore nominativo che accetta la chiusura |
Scadenza o SLA | Tempistica prevista per la correzione |
Metodo di verifica | Quale nuovo test o evidenza conferma la chiusura |
È così che i risultati diventano correzioni invece che leggende aziendali.
Rendere gli audit ripetibili e pronti per il monitoraggio continuo
La prova di un audit della qualità dei dati non è riuscire a condurre una revisione solida sotto pressione. È verificare se gli stessi controlli funzionano ancora sei mesi dopo, quando lo schema è cambiato, un team di un sistema sorgente ha modificato il comportamento di un campo e nessuno si è ricordato di aggiornare la documentazione.
La ripetibilità nasce dal trasformare la logica di audit in un ritmo operativo.
Mantenere il ciclo di audit snello e ricco di evidenze
Uno schema pratico è mantenere focalizzato il perimetro dell'audit formale ed eseguire continuamente controlli più leggeri attorno a esso. La revisione periodica approfondita conta ancora, soprattutto per gli output regolamentati e i dataset ad alto impatto. Ma il lavoro quotidiano sull'affidabilità dovrebbe sorvegliare i tipi di cambiamento che minano la fiducia tra un ciclo di revisione e l'altro: arrivi in ritardo, record mancanti, drift strutturale e quasi-incidenti ripetuti.
Molti team esagerano. Progettano enormi esercizi trimestrali che producono presentazioni curate e pochi insegnamenti operativi. I cicli più piccoli e ricchi di evidenze reggono meglio perché i team riescono a mantenerli.
Tenere d'occhio le modalità di guasto che gli audit rilevano ripetutamente
Anche i metodi di audit tradizionali faticano con i volumi e la velocità di cambiamento moderni. Sintesi recenti osservano che il campionamento manuale e i metodi basati su fogli di calcolo faticano a verificare grandi volumi di dati di audit, e che l'adozione di osservabilità dedicata e dell'applicazione degli SLA è ancora agli inizi, come descritto in questa panoramica sulle lacune degli audit della qualità dei dati e le sfide del monitoraggio continuo. Questo coincide con ciò che emerge nella pratica: i controlli non falliscono perché l'idea era sbagliata, ma perché il metodo non tiene il passo.
Un ritmo di monitoraggio ripetibile di solito include:
Controlli di freschezza per le consegne critiche e le dipendenze a valle
Monitoraggio dello schema, così le modifiche strutturali diventano visibili prima che i consumatori falliscano
Cronologia di esecuzione delle regole per mostrare se la qualità sta migliorando o peggiorando
Revisione delle eccezioni, affinché avvisi e quasi-incidenti non vengano ignorati
Rivalidazione pianificata dopo le modifiche ai processi a monte
I buoni audit diventano più leggeri nel tempo perché i team riutilizzano criteri, schemi di evidenza e percorsi di responsabilità. I cattivi audit diventano più pesanti perché ogni ciclo riparte da zero.
Scalare standardizzando il modello di controllo
Non serve che ogni dominio usi regole identiche. Serve però che ogni dominio usi lo stesso modello di controllo: criteri espliciti, evidenze documentate, responsabilità nominative, eccezioni gestite e verifica dopo la correzione.
È questa standardizzazione che permette a un'organizzazione di sottoporre ad audit feed finanziari, cartelle cliniche, dati operativi delle telecomunicazioni o dataset di rendicontazione pubblica senza reinventare ogni volta il metodo. I controlli cambiano. Il sistema di controllo no.
Un programma di audit ripetibile è il punto in cui il lavoro sulla qualità smette di essere una pulizia reattiva e inizia a comportarsi come un'infrastruttura.
Se avete bisogno che quel sistema di controllo funzioni all'interno del vostro ambiente, digna offre validazione in-database, monitoraggio della tempestività, tracciamento dello schema, rilevamento delle anomalie ed evidenze pronte per l'audit su warehouse, lake e pipeline. È pensato per i team che hanno bisogno di audit della qualità dei dati ripetibili senza spostare i dati di produzione fuori dal proprio stack. Visitate digna per scoprire come la piattaforma supporta controlli di audit continui e difendibili.
Un audit è un'istantanea; mantenere attivi gli stessi controlli tra un audit e l'altro è il passo verso il monitoraggio continuo della qualità dei dati.
Domande frequenti
Cosa distingue un audit della qualità dei dati da un'ispezione?
L'output. Se il risultato è solo un foglio di calcolo con i problemi, si tratta di un'ispezione; un audit produce evidenze, conclusioni, revisione da parte del management e azioni correttive. La ISO inquadra l'audit come un processo sistematico, indipendente e documentato, valutato rispetto a dei criteri.
Cosa richiedono rispettivamente i requisiti sistematico, indipendente e documentato?
Sistematico significa che i controlli non sono improvvisati. Indipendente significa che i risultati possono reggere a una revisione esterna al team di delivery. Documentato significa che qualcun altro può esaminare le evidenze in seguito e giungere alla stessa conclusione.
Come va definito il perimetro dell'audit?
In base all'idoneità all'uso, non a un punteggio astratto. Il lavoro del NIST sulla qualità dei dati lega la qualità all'uso previsto e ai requisiti di business: mettete quindi per iscritto la decisione o l'obbligo che i dati supportano, l'output specifico di cui ci si fida e la conseguenza se i dati sono in ritardo, errati o incompleti.
Cosa deve contenere l'inventario dell'audit?
Costruitelo a ritroso partendo dall'output: report, modelli, alert o comunicazioni critiche; tabelle sorgente a monte, livelli di staging, logica di trasformazione e tabelle di riferimento; dipendenze operative come pianificazioni e consumatori a valle; e responsabili nominativi per sorgente, logica e accettazione da parte del business.
Quali confini prevengono gli attriti nell'audit?
Quattro. Il confine di business indica la decisione o la comunicazione coperta, il confine dei dati i dataset, i campi e i periodi, il confine di processo le trasformazioni e i passaggi di consegna, e il confine di responsabilità chi approva le regole, chi interviene e chi dà l'approvazione finale.


