Self-service analytics: la guida completa per il 2026
|
6
min di lettura
La maggior parte dei consigli sulla self-service analytics parte dal problema sbagliato. Considera l'interfaccia come la parte difficile e dà per scontato che dashboard drag-and-drop producano da sole decisioni affidabili. Nelle aziende regolamentate è l'esatto contrario. Il vero vincolo è se l'organizzazione dispone di un semantic layer governato, di metadati affidabili, di controlli di accesso e di controlli di qualità dei dati abbastanza solidi da permettere agli utenti non tecnici di muoversi rapidamente senza compromettere la logica di reporting o la compliance.
La categoria si è diffusa perché gli utenti di business volevano porre domande senza attendere i team centrali, e le piattaforme moderne oggi lo rendono più semplice con query in linguaggio naturale, esplorazione visiva e preparazione automatizzata dei dati. Ma il passaggio storico dal reporting gestito dall'IT all'analisi gestita dalle linee di business funziona solo quando l'ambiente dati è curato, non quando gli utenti vengono lasciati davanti a tabelle grezze con l'invito ad arrangiarsi.
Indice
Perché la maggior parte delle iniziative di self-service analytics fallisce
I componenti fondamentali dell'architettura di self-service analytics
Checklist per la scelta degli strumenti e strategia di deployment
Perché la maggior parte delle iniziative di self-service analytics fallisce
La modalità di fallimento più comune è semplice. I team acquistano uno strumento di BI, lo collegano ai dati condivisi e lo chiamano self-service analytics. Il primo mese sembra promettente, perché le persone possono cliccare in giro e creare dashboard. Il secondo mese fa emergere il problema di fondo: inizia la deriva delle metriche, la logica di business si biforca da un team all'altro e nessuno si fida più dei numeri.
Uno strumento non crea un significato condiviso. Un semantic layer governato sì. Senza di esso, una dashboard della finanza calcola i ricavi in un modo, un team commerciale regionale li calcola in un altro e il management riceve due versioni della stessa risposta. È qui che il self-service si rompe: non nell'interfaccia, ma nell'assenza di un livello di definizioni comune.
L'interfaccia è la parte facile
Il design drag-and-drop abbassa la barriera delle competenze, ma se la governance è debole abbassa anche la barriera all'incoerenza. Gli utenti possono creare dashboard più velocemente di quanto gli analisti riescano a revisionarle, il che sembra efficiente finché il catalogo non si riempie di dataset duplicati e di report simili che rispondono a domande di business diverse. Il risultato è una proliferazione incontrollata di dashboard, non autonomia.
Regola pratica: se un utente di business riesce a creare un report più in fretta di quanto un data steward riesca a nominarlo, approvarlo e classificarlo, l'organizzazione non ha ancora una self-service analytics. Ha un reporting fuori controllo.
L'altro fallimento nascosto riguarda l'accesso. Quando gli utenti interrogano le tabelle di produzione grezze, ogni campo diventa un potenziale problema di policy e ogni query diventa una richiesta di supporto. Per questo le implementazioni enterprise moderne separano la presentazione dall'archiviazione e collocano l'applicazione delle policy tra le due. L'obiettivo non è limitare gli utenti, ma evitare che costruiscano involontariamente analisi su dati che non dovrebbero vedere, o che usino una metrica che nessuno potrà riprodurre in seguito.
I componenti fondamentali dell'architettura di self-service analytics
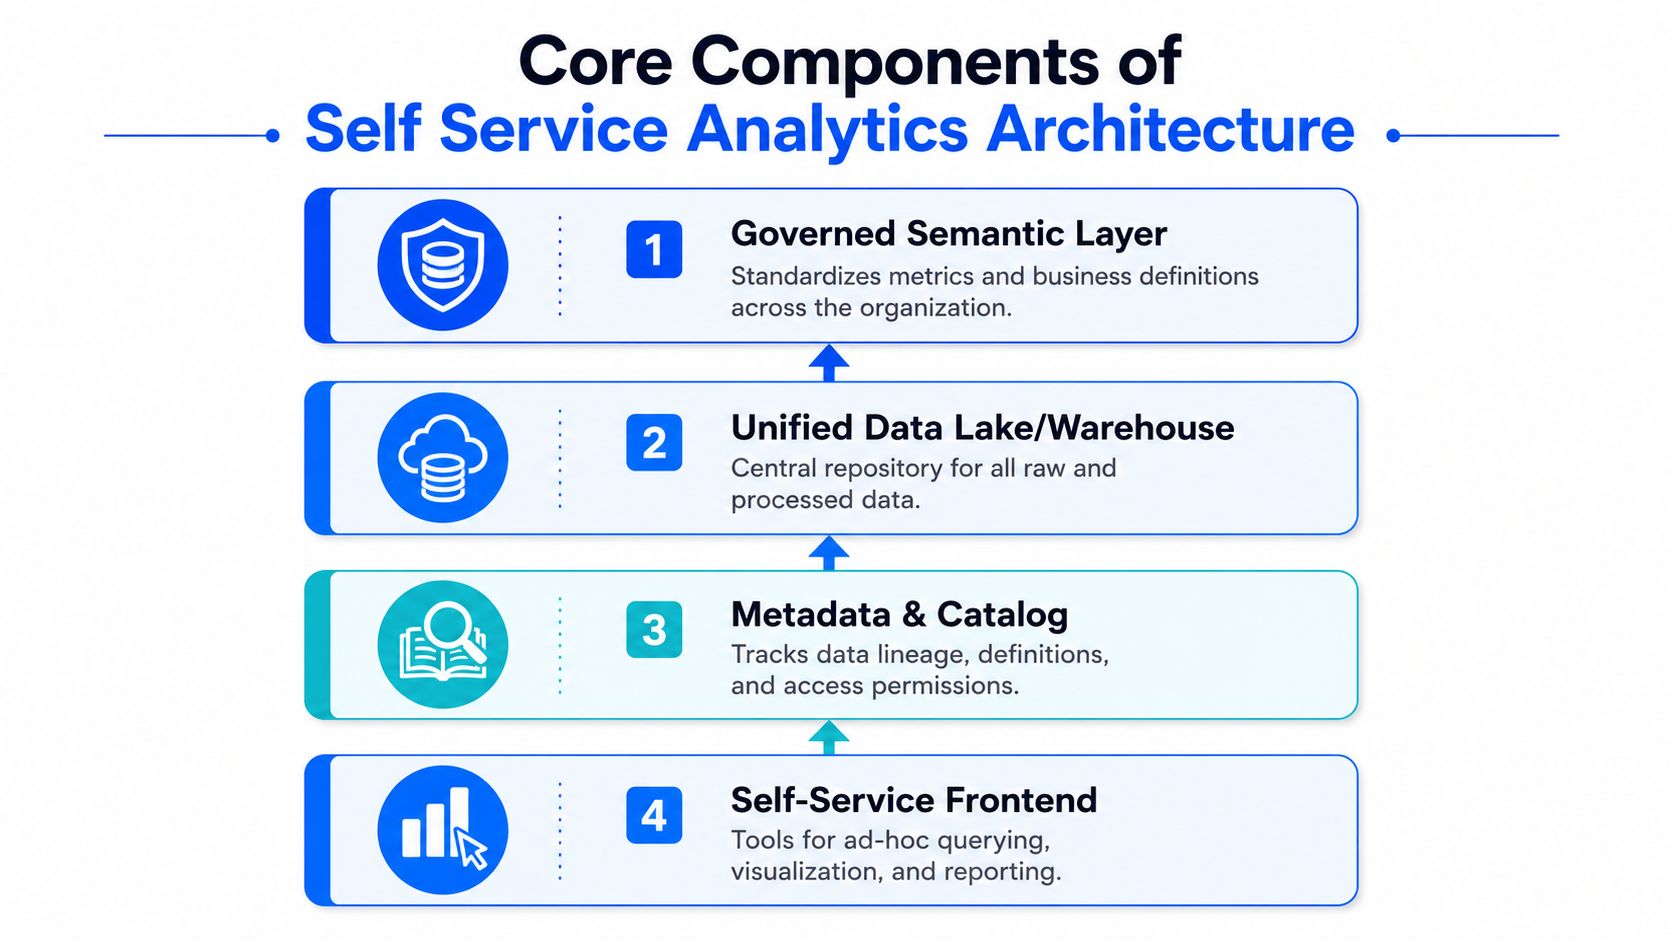
Un'architettura enterprise funzionante ha bisogno di quattro livelli, ognuno dei quali risolve un problema diverso. Lo stack non è complesso per moda, ma perché ogni livello elimina una specifica modalità di fallimento. L'obiettivo è permettere agli utenti di muoversi in autonomia mentre la piattaforma preserva significato, sicurezza e prestazioni.
Significato governato prima di un accesso esteso
Il semantic layer governato è la parte che molte organizzazioni rimandano, ed è di solito il motivo per cui l'adozione diventa caotica in seguito. Standardizza le definizioni di business, così un KPI ha lo stesso significato in tutti i reparti anche se le visualizzazioni cambiano. Questo conta più di qualsiasi rifinitura del front-end, perché gli utenti possono tollerare un'interfaccia un po' macchinosa, ma non le discussioni su che cosa significhi una metrica.
Segue il livello di catalogo e metadati, perché gli utenti non possono scoprire ciò che non riescono a trovare. Buoni metadati indicano chi è responsabile di un dataset, quanto è aggiornato, che cosa contiene e qual è la sua lineage. Nella pratica, questo trasforma la data discovery da una caccia al tesoro in un processo di selezione, ed è per questo che piattaforme e data team continuano a puntare su business glossary e cataloghi ricercabili anziché su altri fogli di calcolo ad hoc.
Il livello di controllo degli accessi è quello in cui la governance diventa reale invece che aspirazionale. Permessi basati sui ruoli, accesso specifico per dataset e workflow di richiesta per i dati riservati evitano che il self-service si trasformi in un'esposizione incontrollata. Questo è particolarmente importante in finanza, sanità, telecomunicazioni e pubblica amministrazione, dove l'auditabilità fa parte del modello operativo.
L'isolamento delle prestazioni conta più di quanto si pensi
L'ultimo livello è il compute self-provisioned, o un modo equivalente per isolare il lavoro ad hoc dai carichi di produzione condivisi. Senza quote o compute in sandbox, pochi join esplorativi possono rallentare il warehouse per tutti gli altri. Questo non danneggia solo le prestazioni, ma distrugge la fiducia nella piattaforma.
Un solido punto di riferimento per i workflow di data discovery è la data discovery negli ambienti enterprise governati, perché la stessa disciplina che aiuta gli utenti a trovare i dataset li aiuta anche a non usarli in modo improprio. I team che valutano partner di delivery possono anche confrontare il modo in cui le offerte di analisi dei dati di Bidwell affrontano il lavoro di analytics governata, soprattutto quando l'organizzazione ha bisogno sia di usabilità per il business sia di disciplina di piattaforma.
Una piattaforma che espone tabelle grezze e lo chiama empowerment risparmia tempo di configurazione a scapito della fiducia futura.
Modelli di governance che bilanciano velocità e controllo
La governance non è un unico modello. È un insieme di compromessi tra coerenza, autonomia e costi operativi. L'approccio sbagliato è di solito quello che sembra più semplice in una presentazione. Il controllo centralizzato è sicuro, la governance federata è pratica e i modelli completamente decentralizzati sono veloci solo fino alla prima disputa sulla definizione di un KPI o su una policy di accesso.
Tre modelli, tre rischi diversi
Il controllo centralizzato funziona quando la pressione della compliance è alta e il numero di utenti è ridotto. Ogni richiesta passa da un data team centrale, il che garantisce coerenza e revisioni rigorose, ma crea anche una coda. Questo modello protegge le definizioni, ma rallenta il business e può far sembrare il self-service un'operazione di branding più che un vero cambiamento operativo.
La governance federata è il modello a cui approda la maggior parte delle aziende regolamentate, perché ripartisce le responsabilità in modo utile. I team centrali standardizzano le metriche principali, le regole di accesso e le soglie di qualità. I team di dominio creano report e visualizzazioni entro questi limiti. Così l'autonomia resta abbastanza alta da consentire ai team di muoversi, preservando al tempo stesso gli standard aziendali di cui management e auditor hanno bisogno.
La governance decentralizzata e democratica lascia ai team la massima libertà. Può funzionare in ambienti piccoli e a basso rischio, con utenti molto allineati, ma è fragile su scala enterprise. Le definizioni derivano, la logica duplicata si diffonde e nessuno sa quale dashboard sia quella di riferimento. Se l'organizzazione fatica già a mantenere coerenti le metriche, questo modello peggiora il problema.
Modello | Punto di forza | Punto debole | Contesto ideale |
|---|---|---|---|
Controllo centralizzato | Massima coerenza | Approvazioni più lente | Contesti altamente regolamentati, casi d'uso circoscritti |
Governance federata | Equilibrio tra autonomia e standard | Richiede una stewardship disciplinata | Grandi aziende con più domini |
Decentralizzata e democratica | Sperimentazione locale più rapida | Rischio più alto di deriva delle metriche | Team piccoli, minore pressione della compliance |
Trasformare le policy in regole operative
Le buone checklist di governance sono concrete. Un catalogo deve mostrare responsabilità, frequenza di aggiornamento, note sulla qualità e definizioni di business dei campi chiave. Le procedure di accesso devono specificare chi può vedere che cosa, come richiedere i dati riservati e quali controlli di privacy o compliance si applicano prima dell'approvazione. Le regole di validazione devono essere visibili a chi usa i dati, non nascoste da qualche parte in un sistema di ticketing.
Ecco perché la strategia di data governance va progettata come un modello operativo, non come un documento di policy. Se le regole non sono integrate nell'analisi quotidiana, gli utenti creano soluzioni alternative. A quel punto la governance inizia a esistere solo sulla carta.
I migliori modelli federati non cercano di eliminare le variazioni locali. Mantengono stabili le metriche principali e lasciano che i team adattino il livello di presentazione alle proprie domande. È questo l'equilibrio che preserva la velocità senza lasciare che il reporting si frammenti in versioni concorrenti della verità.
Requisiti di qualità dei dati e di observability
Il self-service fallisce quando la qualità dei dati è invisibile. Una dashboard può sembrare a posto mentre il caricamento sottostante è obsoleto, uno schema cambia senza preavviso o una regola a livello di record si rompe in un modo che colpisce un solo team a valle. Gli utenti non vedono la root cause, vedono solo che il report ha smesso di corrispondere alla realtà.
Che cosa occorre monitorare
Il primo controllo è il monitoraggio dell'ingestion. Se i dati arrivano in ritardo, incompleti o nel formato sbagliato, l'analisi a valle eredita immediatamente il problema. Il secondo è il tracciamento di schema e lineage, perché aggiunte di colonne, cambi di tipo e trasformazioni a monte possono invalidare le dashboard senza preavviso. Il terzo è l'anomaly detection, che aiuta a far emergere le rotture statistiche che le semplici soglie non rilevano. Il quarto è una dashboard della qualità che rende visibili freshness, accuratezza e copertura sia agli ingegneri sia agli stakeholder di business.
Questi controlli contano soprattutto nelle aziende che non possono semplicemente trasferire dati sensibili nell'ambiente di un fornitore per esaminarli. L'esecuzione in-database mantiene l'analisi all'interno di sistemi controllati dal cliente, la soluzione giusta quando i vincoli di privacy, residenza dei dati o compliance sono stringenti. Riduce inoltre l'impegno specialistico necessario per il monitoraggio di routine, perché la piattaforma può osservare i dati là dove risiedono già.
Una sequenza di monitoraggio pratica
Controllate prima la freshness. I caricamenti in ritardo generano report obsoleti prima che qualcuno se ne accorga. Se la tempestività non è visibile, gli utenti di business presumono che la dashboard sia aggiornata anche quando non lo è.
Poi tracciate le modifiche strutturali. Il tracciamento dello schema intercetta i campi rinominati o rimossi prima che il livello di BI si rompa.
Sorvegliate outlier e derive. Le anomalie nei volumi, nelle distribuzioni o nelle regole di business emergono spesso prima che le persone le notino in una dashboard.
Esponete i risultati in una vista condivisa. Le dashboard della qualità rendono evidente quali dataset sono abbastanza stabili per il self-service e quali richiedono attenzione.
Regola empirica: la qualità dei dati per il self-service non è un'attività di back-office. È il control plane di ogni report, modello e decisione che dipende da dati condivisi.
I programmi di observability più solidi non sommergono i team di alert. Riducono il rumore imparando il comportamento di base e facendo emergere le eccezioni che contano. È la differenza tra un monitoraggio di facciata e un monitoraggio che funge da vera salvaguardia operativa.
Casi d'uso enterprise nei settori regolamentati
Un ente di previdenza sociale è un esempio utile di ciò che cambia quando la governance è progettata correttamente. Il team ha abbandonato la manutenzione di 9.000 regole di qualità dei dati scritte a mano ed è passato all'anomaly detection basata sull'AI, riducendo gli alert giornalieri da oltre 140 a segnali su cui agire. La lezione non riguarda solo il numero di alert, ma il fatto che la manutenzione delle regole ha smesso di dominare il workflow della qualità, così gli ingegneri hanno potuto dedicare tempo ai problemi che incidevano davvero sui risultati.
Questo pattern si ritrova in tutti i settori regolamentati. In sanità, il monitoraggio della tempestività intercetta i caricamenti di dati in ritardo prima che le dashboard dell'assistenza ai pazienti diventino obsolete. Nelle telecomunicazioni, il tracciamento dello schema protegge le analytics di fatturazione dalle modifiche a monte che altrimenti si propagherebbero a cascata in report rotti. In finanza e nella pubblica amministrazione l'esigenza è più ampia, perché reporting riproducibile e auditabilità contano quanto la comodità per gli utenti.
Per i team che hanno bisogno di percorsi formativi strutturati attorno a questi cambiamenti operativi, seguire un MBA in operations e supply chain può aiutare i professionisti a comprendere il controllo dei processi, anche se il lavoro di analytics in sé dipende comunque da una solida progettazione della piattaforma e da una governance disciplinata.
Che cosa hanno in comune queste implementazioni
Le organizzazioni che riescono a far attecchire il self-service non trattano tutti i dataset allo stesso modo. Separano le metriche standard ad alta affidabilità dal lavoro sperimentale. Assegnano inoltre responsabilità chiare, così gli analisti sanno chi cura il semantic layer, chi approva gli accessi e chi interviene quando emerge un problema sui dati.
L'aspetto importante non è che ogni settore abbia grafici diversi, ma che ognuno abbia una diversa tolleranza all'errore. Una dashboard di fatturazione, una dashboard sui pazienti e un report sulle prestazioni sociali richiedono tutti controlli indipendenti, anche se si trovano sulla stessa piattaforma.
Roadmap di implementazione e metriche di successo
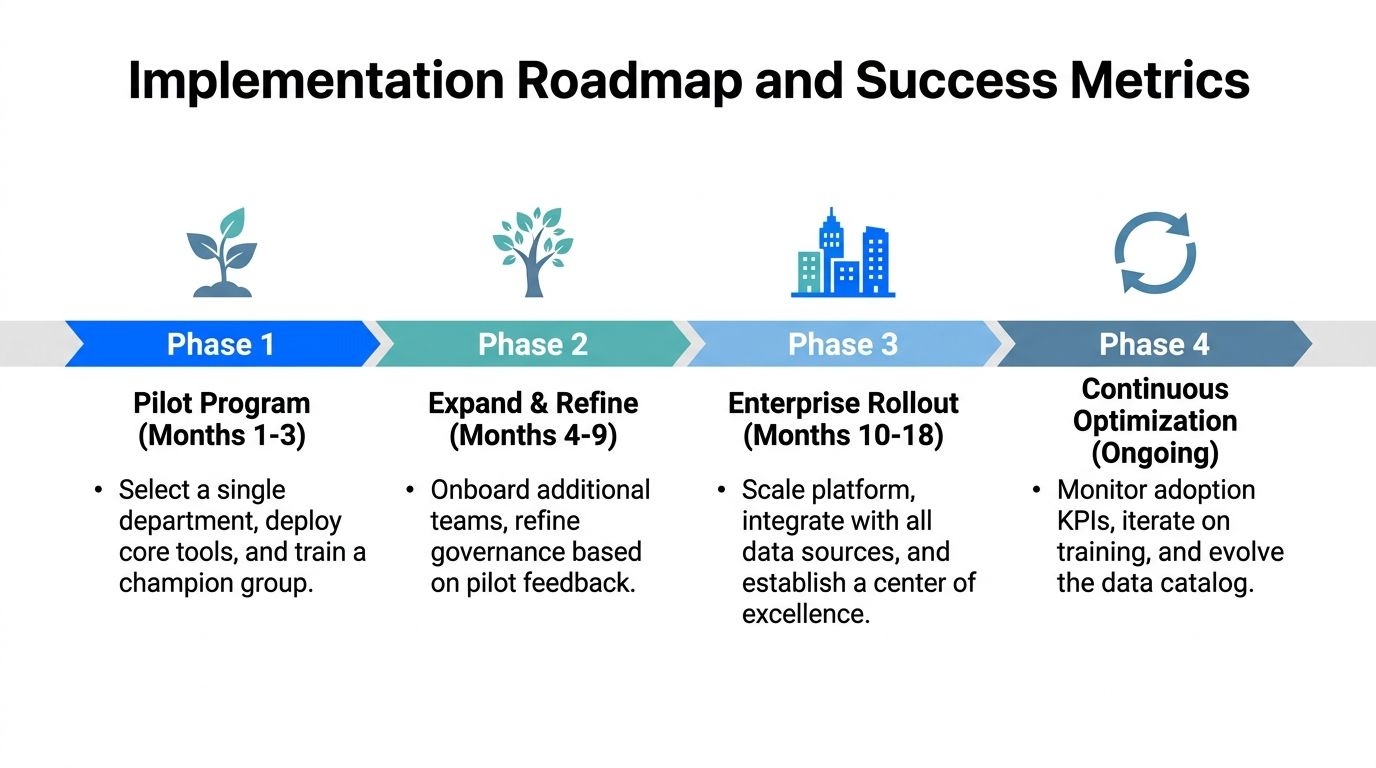
Il percorso di rollout più pulito è quello che resta piccolo abbastanza a lungo da dimostrare la validità del modello. Partite da un team pilota che abbia una reale pressione di business ma un raggio d'impatto limitato, ed estendete solo dopo che definizioni, accessi e controlli di qualità hanno retto all'uso quotidiano. Se il pilota cresce troppo in fretta, la governance si diluisce prima che il processo sia stabile.
Misurare il rollout come un programma operativo
Le metriche giuste sono operative, non cosmetiche. Il time-to-insight indica se gli utenti si muovono più rapidamente. Il carico di lavoro del data team mostra se gli analisti vengono coinvolti in meno richieste ripetitive. L'adozione delle dashboard indica se il business si fida abbastanza della piattaforma da usarla. La frequenza degli incidenti di qualità dei dati mostra se l'ambiente sta diventando più sicuro o solo più affollato.
Queste misure funzionano meglio se monitorate insieme. Se il time-to-insight migliora ma la frequenza degli incidenti aumenta, l'organizzazione potrebbe muoversi velocemente a scapito della fiducia. Se l'adozione è bassa e il carico di lavoro non cala mai, la piattaforma potrebbe essere utile ma non integrata nel lavoro quotidiano. L'obiettivo è tenere d'occhio l'equilibrio, non solo la velocità.
Errori comuni nel rollout
Estendere il pilota troppo presto: spesso i team aggiungono altri reparti prima che il semantic layer e le regole di governance siano stabili.
Formare poco gli utenti: una piattaforma self-service senza onboarding sposta semplicemente la confusione dal data team all'utente di business.
Ignorare il lavoro di manutenzione: glossari, permessi e controlli di qualità richiedono una responsabilità continuativa, non un lancio una tantum.
Considerare le dashboard il prodotto: il prodotto è il modello operativo che mantiene affidabili le dashboard.
I programmi migliori evolvono in un centro di eccellenza che cura le definizioni condivise, supporta i team di dominio e mantiene in salute il catalogo. È questo che trasforma la self-service analytics da un semplice rollout di uno strumento in una capacità duratura.
Checklist per la scelta degli strumenti e strategia di deployment
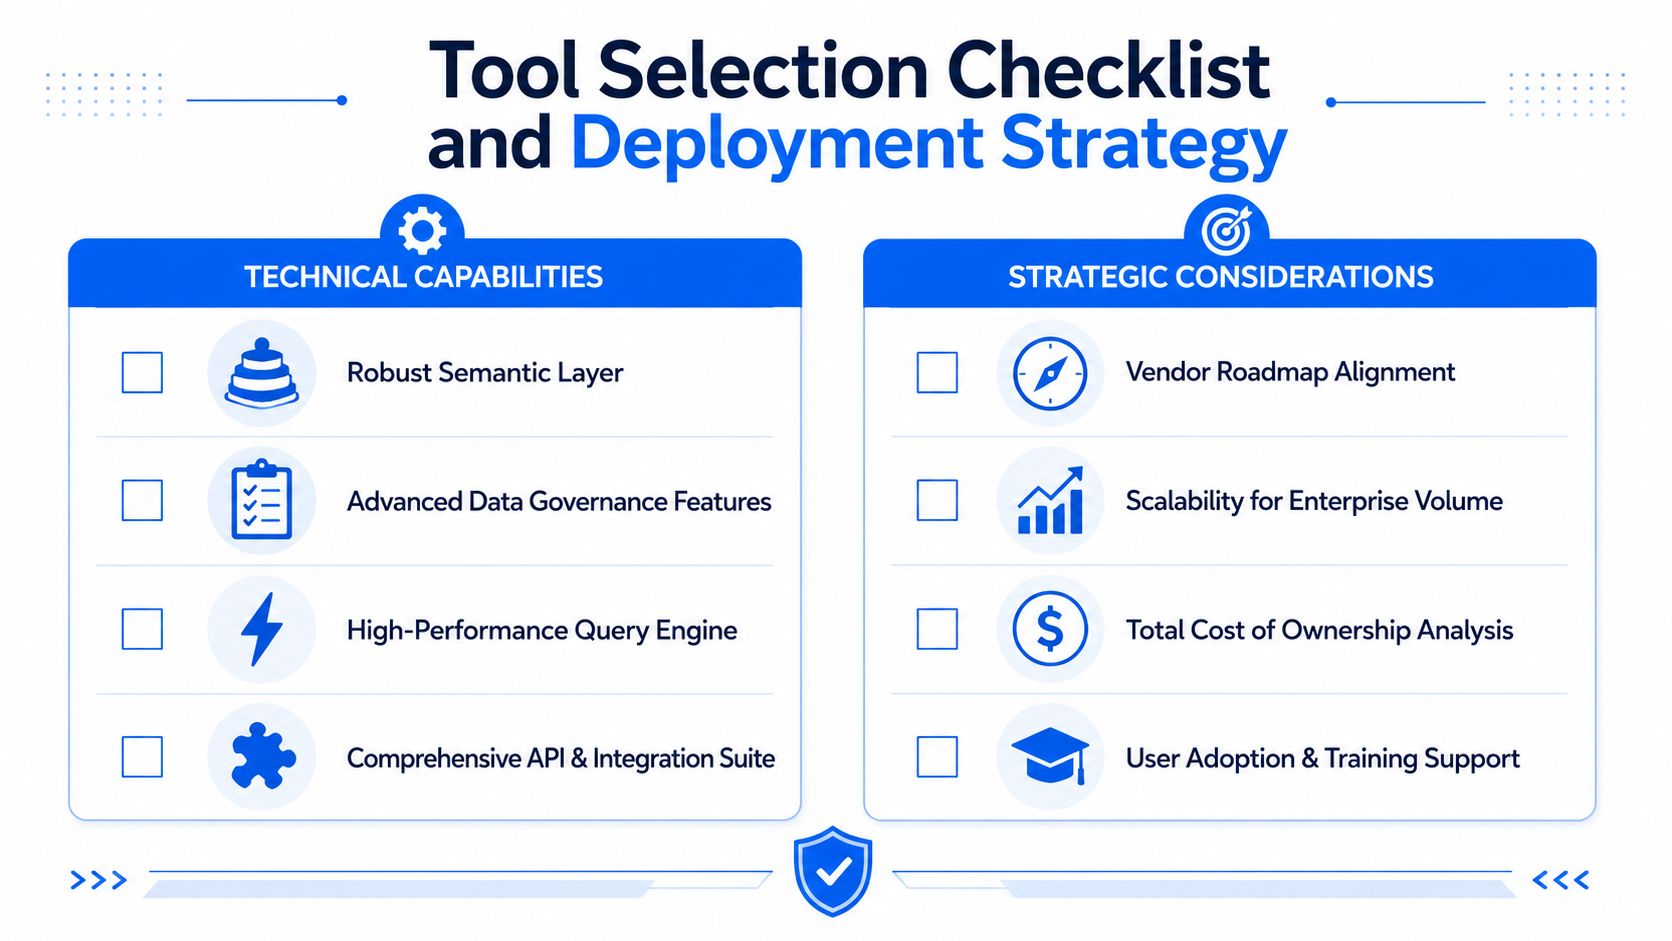
La scelta degli strumenti deve partire dall'architettura, non dagli screenshot. Un'interfaccia curata è utile, ma non compensa un supporto semantico debole, un'automazione della governance carente o una piattaforma che non si adatta al vostro modello di sicurezza. Gli acquirenti enterprise dovrebbero valutare gli strumenti come valutano l'infrastruttura, chiedendosi che cosa si rompe con un utilizzo reale.
Che cosa verificare prima dell'acquisto
Supporto solido al semantic layer. Verificate che le definizioni di business possano essere centralizzate e riutilizzate tra i team.
Funzionalità di data governance. Accertatevi che accesso basato sui ruoli, approvazioni e applicazione delle policy siano integrati.
Integrazione con l'observability. Assicuratevi che il monitoraggio di qualità, freshness e schema possa collegarsi al workflow di analytics.
Flessibilità di deployment. Private cloud, on-premises o ambienti controllati dal cliente sono importanti quando la residenza dei dati è un vincolo.
Profondità di API e integrazioni. La piattaforma deve inserirsi nei warehouse, nei cataloghi e negli strumenti di pipeline esistenti.
Scalabilità per volumi enterprise. Il successo di un pilota non significa che la piattaforma reggerà un'adozione su larga scala.
Supporto a formazione e adozione. Gli utenti di business hanno bisogno di essere messi in condizione di lavorare, non solo di avere accesso.
Costo totale di possesso. I costi nascosti emergono di solito nell'overhead di governance e nell'onere di supporto, non nella voce delle licenze.
Una buona strategia di deployment procede per fasi. Fate girare la nuova piattaforma in parallelo con lo stack di reporting attuale abbastanza a lungo da validare gli output e individuare le lacune. Coinvolgete gli utenti a ondate, partendo dal gruppo che ne trarrà il maggior beneficio e che può tollerare qualche cambiamento di processo. Mantenete disponibile il vecchio percorso finché il nuovo workflow non avrà conquistato la fiducia degli utenti.
La verifica più importante è se lo strumento aiuta l'organizzazione a imporre un significato coerente senza rallentare gli utenti fino a fermarli. Se non ci riesce, non importa quanto fosse convincente la demo.
Se state costruendo una self-service analytics per un'azienda regolamentata, digna può aiutarvi a mettere in campo il livello di qualità e observability senza esporre dati sensibili all'ambiente di terze parti. Visitate digna per scoprire come anomaly detection in-database, monitoraggio della tempestività, tracciamento dello schema e validazione supportano analytics affidabili su larga scala.
Se sono i campi rinominati o rimossi a continuare a rompere il vostro livello di BI, scoprite come digna Schema Tracker rileva le modifiche strutturali prima che gli utenti di business ci costruiscano sopra dei report.
Domande frequenti
Perché le iniziative di self-service analytics falliscono?
La maggior parte fallisce perché i team acquistano uno strumento di BI, lo collegano ai dati condivisi e lo chiamano self-service. Già al secondo mese inizia la deriva delle metriche, la logica di business si biforca da un team all'altro e nessuno si fida dei numeri. Il tassello mancante è di solito un semantic layer governato che dia a ogni KPI un'unica definizione condivisa.
Quali sono i componenti fondamentali di un'architettura di self-service analytics?
Un'architettura enterprise ha bisogno di quattro livelli: un semantic layer governato che standardizzi le definizioni di business, un livello di catalogo e metadati che mostri responsabilità, freshness e lineage, un livello di controllo degli accessi con permessi basati sui ruoli e workflow di richiesta, e un compute self-provisioned o in sandbox che isoli le query ad hoc dai carichi di produzione condivisi.
Quale modello di governance funziona meglio per la self-service analytics?
La governance federata è il modello a cui approda la maggior parte delle aziende regolamentate. I team centrali standardizzano metriche principali, regole di accesso e soglie di qualità, mentre i team di dominio creano report entro questi limiti. Il controllo centralizzato offre la massima coerenza ma le approvazioni più lente, mentre i modelli decentralizzati comportano il rischio più alto di deriva delle metriche.
Di quali controlli di qualità dei dati ha bisogno la self-service analytics?
L'articolo raccomanda una sequenza in quattro passi: controllare prima la freshness, così che i caricamenti obsoleti siano visibili; tracciare le modifiche di schema prima che campi rinominati o rimossi rompano il livello di BI; sorvegliare le anomalie nei volumi e nelle distribuzioni; esporre i risultati in una dashboard della qualità condivisa che mostri quali dataset sono abbastanza stabili per il self-service.
Come si misura il successo di un rollout di self-service analytics?
Monitorate insieme quattro metriche operative: time-to-insight, carico di lavoro del data team, adozione delle dashboard e frequenza degli incidenti di qualità dei dati. Leggerle come un insieme fa emergere i compromessi: un time-to-insight più rapido accompagnato da un aumento degli incidenti, ad esempio, significa che la velocità va a scapito della fiducia. Partite da un team pilota prima di estendere.


