Viewer de fichiers Parquet : choisir le bon outil
|
7
minute de lecture

Vous avez sans doute déjà reçu un fichier .parquet via Slack, par e-mail ou dans un bucket cloud, avec besoin d'une réponse rapide. Quelles colonnes il contient. Si le schéma correspond à l'export d'hier. Si le fichier contient de vraies lignes ou n'est qu'un artefact de plus d'un Data Pipeline cassé.
C'est à ce moment-là qu'on réalise que Parquet n'est pas un format de tableur avec une extension plus élégante. Il est efficace, compact et conçu d'abord pour les machines. Si vous choisissez la mauvaise façon de l'inspecter, soit vous perdez du temps à vous battre avec l'outillage, soit vous créez un problème de sécurité évitable en déplaçant des données sensibles dans le mauvais environnement.
Table des matières
Pourquoi les fichiers Parquet exigent des viewers spécialisés
Comparatif des principales méthodes pour visualiser un fichier Parquet
Pourquoi les fichiers Parquet exigent des viewers spécialisés
Un simple éditeur de texte ne vous aidera pas beaucoup avec un fichier Parquet. Vous n'obtiendrez pas de lignes et de colonnes lisibles, mais un blob binaire avec juste assez de fragments reconnaissables pour vous faire perdre votre temps.
C'est voulu. Apache Parquet a été créé en 2013 dans le cadre d'un effort conjoint de Twitter et Cloudera, publié pour la première fois le 1er juillet 2013, avant de devenir un projet Apache de premier niveau. Le format repose sur le stockage en colonnes, les row groups et des métadonnées basées sur Thrift, et c'est précisément pour cela qu'un visualiseur de texte classique ne peut pas l'interpréter (contexte sur le format Parquet).
Ce qui coince en pratique
Un scénario de production courant ressemble à ceci :
Un analyste reçoit un export de fichier d'un fournisseur.
Un data engineer doit vérifier si le schéma a dérivé.
Une équipe plateforme doit contrôler que les champs imbriqués ont été encodés comme l'attendent les jobs en aval.
Quelqu'un essaie d'ouvrir le fichier dans un éditeur de texte ou un explorateur de fichiers générique et n'arrive à rien.
À ce stade, un viewer de fichiers Parquet n'est plus un confort mais un outil de base. Son rôle ne se limite pas à afficher des lignes. Il doit traduire un format de stockage optimisé pour l'analytique en quelque chose que des humains peuvent inspecter rapidement et en toute sécurité.
Si vous avez besoin d'un rappel rapide sur le format lui-même, cette explication de ce qu'est Parquet est un bon complément avant de choisir un viewer.
Pourquoi les visionneuses de fichiers génériques échouent
Le mode d'échec est prévisible. Les visionneuses génériques partent du principe que le fichier est soit du texte organisé en lignes, soit un simple conteneur binaire, soit un document doté d'un moteur de rendu. Parquet n'est rien de tout cela.
Un bon viewer maîtrise notamment :
L'extraction du schéma à partir des métadonnées du fichier
La projection de colonnes, pour n'afficher que les champs qui vous intéressent
Les structures imbriquées, y compris les tableaux et les valeurs nullables
Des aperçus qui tiennent compte du stockage, plutôt qu'un faux comportement « ouvrir le fichier » qui tente de tout charger
Règle pratique : si un outil traite un fichier Parquet comme un CSV avec une autre extension, ce n'est pas le bon outil.
L'exigence cachée
On pense souvent qu'il faut un viewer parce que Parquet n'est pas lisible par un humain. C'est vrai, mais incomplet. L'exigence de fond, c'est que l'inspection de Parquet nécessite une logique qui comprend le format.
Vous n'ouvrez pas simplement un fichier. Vous interrogez une structure de stockage. Le meilleur outil dépend donc de ce que vous devez inspecter : lignes, schéma, row groups, statistiques, comportement d'encodage ou métadonnées au niveau du fichier. Le bon viewer vous donne ces réponses sans imposer un scan complet ni un déplacement de données inutile.
Comprendre la structure interne de Parquet
La différence entre un viewer Parquet rapide et un viewer laborieux commence par l'organisation du fichier. Sans la comprendre, il est difficile de juger si un outil est efficace ou s'il masque simplement des lectures coûteuses derrière une interface.
Parquet organise les données sous la forme fichier → row groups → column chunks → pages. Au sein d'un row group, les column chunks sont écrits les uns à la suite des autres, et la page est la plus petite unité encodée et compressée (organisation des data pages Parquet).

Ce qu'un viewer vous montre réellement
Quand un viewer expose les row groups et les column chunks, il n'ajoute pas une fonction avancée pour utilisateurs chevronnés. Il expose le modèle de stockage.
C'est important en production, car un aperçu de table peut être trompeur. Un aperçu générique peut afficher dix lignes et donner l'impression d'un fichier trivial, alors que le fichier réel contient de nombreux row groups, des chunks de tailles inégales, des colonnes imbriquées et des choix de métadonnées qui influencent la façon dont les moteurs en aval le lisent.
Pour les équipes qui travaillent avec des data contracts en évolution, comprendre l'organisation du fichier aide aussi à retracer l'évolution du schéma. Un sujet complémentaire utile est la conception des types de schéma et la gestion des changements, car l'inspection de fichiers devient bien plus simple quand l'équipe sait déjà quelle dérive structurelle rechercher.
Pourquoi le footer est essentiel
Parquet stocke les métadonnées critiques dans un footer situé à la fin du fichier. Les lecteurs se positionnent généralement sur les 8 derniers octets pour trouver la longueur du footer et les magic bytes PAR1 finaux, avant d'analyser le schéma, les row groups et les statistiques de colonnes (présentation du format Apache Parquet).
Ce seul détail explique en grande partie pourquoi certains viewers semblent instantanés et d'autres non. Un viewer bien conçu ne commence pas par lire le fichier depuis le début en chargeant tout en mémoire. Il saute à la fin, analyse les métadonnées et décide ensuite de ce qu'il doit lire.
Un viewer Parquet qui commence par le footer peut répondre à de nombreuses questions structurelles avant de toucher la majeure partie du dataset.
Les champs imbriqués et nullables ne sont pas des détails cosmétiques
Le fonctionnement interne de Parquet explique aussi pourquoi les colonnes imbriquées s'affichent parfois bizarrement dans des outils limités. Un column chunk peut contenir au plus une dictionary page, et si elle existe, elle doit être la première page du chunk. Les data pages contiennent ensuite les repetition levels, les definition levels et les valeurs encodées, dans cet ordre (fonctionnement interne des column chunks Parquet).
Ce n'est pas une anecdote. Cela détermine ce qu'un viewer doit décoder pour présenter correctement les tableaux, les structs et les valeurs nulles. Si un outil aplatit tout de manière maladroite, c'est souvent le signe qu'il masque la complexité au lieu de gérer correctement le format.
Ce qu'il faut attendre d'un viewer qui comprend la structure
Un viewer vaut généralement la peine d'être utilisé s'il fait clairement apparaître ces éléments :
Fonctionnalité du viewer | Pourquoi c'est important |
|---|---|
Navigateur de schéma | Permet de vérifier les noms de colonnes, les types et la structure imbriquée |
Vue des row groups | Montre comment les données sont partitionnées horizontalement |
Détails des column chunks | Révèle les limites de stockage par colonne |
Métadonnées de page ou d'encodage | Utile pour déboguer des champs imbriqués, la nullabilité ou des problèmes de compression |
Si un outil ne propose qu'un « aperçu des lignes », cela peut suffire pour une vérification rapide. Ce ne sera pas suffisant pour diagnostiquer le comportement d'un pipeline, valider des exports de fournisseurs ou comprendre pourquoi un moteur de requêtes se comporte très différemment d'un autre.
Comparatif des principales méthodes pour visualiser un fichier Parquet
Il n'existe pas un seul meilleur viewer de fichiers Parquet. Il existe cinq approches courantes, et chacune résout un problème différent. En production, l'erreur n'est pas de choisir un produit faible. C'est d'utiliser la mauvaise catégorie d'outil pour la tâche.
Outils en ligne de commande
Pour une inspection locale rapide, les outils en ligne de commande sont souvent l'option la plus directe. parquet-tools en est l'exemple classique.
Ils conviennent bien pour extraire le schéma, inspecter les métadonnées ou échantillonner des enregistrements sans ouvrir d'IDE. Ils s'intègrent aussi facilement aux workflows shell et au débogage en CI.
Le compromis porte sur l'ergonomie. Les outils en ligne de commande sont efficaces pour les ingénieurs et rebutants pour tous les autres. Ils compliquent aussi l'inspection collaborative, sauf si la sortie est capturée et partagée de façon délibérée.
Bibliothèques Python
Pour les data engineers, PyArrow et pandas sont souvent la voie la plus flexible. Vous pouvez inspecter le schéma, charger certaines colonnes, appliquer des filtres rapides et combiner l'inspection avec une logique de validation ad hoc.
C'est précisément cette flexibilité qui en fait l'option par défaut. Et c'est aussi pour cela qu'on les utilise facilement à mauvais escient.
Un notebook ou un script a tendance à glisser de « l'inspection rapide » vers « trop de données chargées en mémoire par accident ». Et dès que les équipes banalisent les scripts locaux sur des extraits de production, les frontières de sécurité commencent à s'estomper. Si votre équipe évalue déjà des pratiques plus larges d'inspection et de monitoring, il vaut la peine de comparer les catégories de logiciels de data profiling en parallèle des viewers de fichiers.
Spark et moteurs distribués
Spark n'est pas un viewer au sens classique, mais les équipes l'utilisent constamment comme tel. Si le fichier se trouve dans un environnement lakehouse et que vous avez déjà accès à un cluster, le lire via Spark peut être l'option la plus cohérente sur le plan opérationnel.
Cela fonctionne au mieux quand l'objectif est d'inspecter au sein d'une plateforme existante, pas d'ouvrir un fichier ponctuellement. Spark gère naturellement les grands datasets et le stockage distant. Le prix à payer : une mise en place lourde, un retour plus lent pour les tâches simples et beaucoup trop d'infrastructure pour des questions basiques du type « qu'y a-t-il dans ce fichier ».
Si vous avez besoin d'un cluster pour répondre à une question qu'un outil capable de lire le footer pourrait traiter en local, votre chemin d'inspection est trop lourd.
Extensions VS Code et viewers desktop
Ils sont utiles aux ingénieurs qui veulent une interface visuelle sans quitter leur workflow local. Ils sont généralement plus simples que les outils CLI et plus légers que le lancement de notebooks ou de sessions Spark.
Le problème, c'est la qualité inégale. Certaines extensions ne proposent que des aperçus superficiels. D'autres n'exposent ni les row groups, ni les statistiques, ni les détails d'encodage. Pour une inspection simple, cela peut suffire. Pour le débogage en production, c'est souvent insuffisant.
Les outils desktop ne sont par ailleurs pas plus sûrs que le poste de travail sur lequel ils tournent. C'est important lorsque le fichier contient des données réglementées ou confidentielles.
Viewers Parquet en ligne
Les viewers en ligne sont séduisants car ils suppriment toute friction de mise en place. Ouvrez le site, chargez le fichier, inspectez le contenu.
Cette commodité doit être évaluée avec soin. Certaines équipes peuvent les utiliser sans risque pour des échantillons non sensibles. Beaucoup d'équipes ne peuvent pas les utiliser du tout pour des raisons de gouvernance.
Un viewer actuel décrit un modèle plus solide. Il indique pouvoir ouvrir des fichiers Parquet locaux ou distants, les lire in place grâce à des requêtes HTTP range et récupérer uniquement les octets nécessaires à la vue en cours, ce qui permet d'ouvrir en quelques instants des fichiers de plusieurs gigaoctets tout en gardant les données sur la machine de l'utilisateur (description du produit Parquet Viewer). C'est une nette amélioration par rapport aux conceptions naïves de type upload puis traitement.
Un tableau de décision pratique
Méthode | Idéal pour | Ce qui fonctionne | Ce qui coince |
|---|---|---|---|
Outils CLI | Ingénieurs effectuant des vérifications locales rapides | Inspection rapide du schéma et des métadonnées | Ergonomie médiocre pour les profils non techniques |
PyArrow ou pandas | Analyse d'ingénierie ad hoc | Flexible, scriptable, facile à étendre | Tendance à lire trop de données ou à créer des workflows locaux désordonnés |
Spark | Inspection native à la plateforme, à grande échelle | Adapté aux grands environnements data lake | Trop lourd pour des vérifications simples |
VS Code ou viewers desktop | Inspection visuelle légère | Interface locale pratique | Profondeur fonctionnelle très variable |
Viewers en ligne | Accès rapide sans installation | Pratique pour une exploration rapide | Enjeux de confidentialité, de gouvernance et de déplacement des données |
Les meilleures équipes ne standardisent pas une seule méthode pour tous les cas. Elles définissent quand chaque méthode est autorisée, qui l'utilise et quel type de données peut être inspecté avec.
Comment inspecter des fichiers Parquet en toute sécurité
Une inspection sûre commence avant de cliquer sur « ouvrir ». La première question n'est pas de savoir quel viewer vous préférez. C'est de savoir si le fichier peut être inspecté sans copier plus de données que nécessaire et sans le déplacer dans le mauvais environnement.
Parquet vous donne ici un avantage. Un viewer peut réduire sensiblement les I/O en s'appuyant sur les métadonnées du footer. Comme Parquet stocke les métadonnées à la fin du fichier, y compris l'emplacement des row groups et des column chunks, un viewer peut d'abord analyser le footer puis ne lire que les row groups ou les colonnes dont il a besoin, au lieu de scanner tout le dataset. C'est aussi cette organisation qui permet l'inspection sélective et le predicate pushdown, puisque les row groups sont la principale unité de partitionnement horizontal et que chaque row group contient exactement un column chunk par colonne (comportement des métadonnées du format Parquet).
Commencer par la structure, pas par les lignes
La séquence la plus sûre est la suivante :
Ouvrez d'abord les métadonnées. Examinez le schéma, les row groups et les informations au niveau du fichier avant de prévisualiser des enregistrements.
Ne projetez que les colonnes nécessaires. Si vous validez un seul champ, n'en chargez pas vingt.
Appliquez des filtres sélectifs lorsque c'est possible. Laissez le viewer ignorer les groupes ou chunks non pertinents.
Prévisualisez de petites portions. Un échantillon suffit généralement pour confirmer le formatage ou la gestion des valeurs nulles.
Ne passez à une lecture complète que lorsque la tâche l'exige.
Cela paraît évident, mais beaucoup d'équipes inspectent encore des fichiers en les chargeant en bloc dans des notebooks. C'est acceptable pour de petits échantillons de développement non sensibles. C'est une mauvaise habitude dans des environnements partagés ou réglementés.
Adapter la méthode à l'environnement
Un même fichier mérite un traitement différent selon l'endroit où il se trouve.
Fichier de développement local : un outil CLI ou un viewer local convient généralement si le dataset n'est pas sensible et que l'accès est contrôlé.
Export en object storage : privilégiez un outil capable d'inspecter à distance et de lire de façon sélective plutôt que d'imposer un téléchargement complet.
Données de production ou réglementées : gardez l'inspection au sein d'une infrastructure approuvée et limitez qui peut prévisualiser les enregistrements réels.
Workflow de débogage partagé : consignez d'abord les constats sur le schéma et les métadonnées. De nombreux incidents se résolvent sans exposer de valeurs brutes.
Une grande partie de la protection des données clients consiste à réduire les déplacements inutiles. C'est le même principe que les équipes appliquent dans des pratiques plus larges de protection des données clients.
Contrôle de sécurité : si votre workflow d'inspection impose par défaut de télécharger des extraits bruts de production sur des machines personnelles, le problème n'est pas le format de fichier. C'est le processus.
Se limiter au footer quand la question est structurelle
Toutes les tâches d'inspection n'ont pas besoin d'enregistrements. Parfois, il suffit de confirmer le schéma, l'organisation des row groups, les métadonnées clé-valeur ou des statistiques de base.
C'est pourquoi l'inspection basée sur le footer constitue une ligne de partage si pratique. Apache Doris expose directement ce modèle via sa fonction table PARQUET_META, qui peut lire les métadonnées du footer Parquet sans scanner les data pages et restituer le schéma, les statistiques des row groups, les métadonnées au niveau du fichier, les métadonnées clé-valeur, les résultats de sondage des bloom filters, et même les métadonnées liées à la version ou au chiffrement (référence Apache Doris PARQUET_META).
C'est un test de cohérence utile pour évaluer n'importe quel viewer. Si une fonction de base de données peut répondre à votre question à partir des seules métadonnées, un viewer de fichiers ne devrait pas non plus avoir besoin d'une lecture complète des données.
Un workflow qui tient la route en production
Quand les équipes manipulent Parquet en toute sécurité, leur processus ressemble généralement à ceci :
Trier d'abord à partir des métadonnées
N'inspecter les valeurs que pour le minimum de colonnes nécessaires
Éviter d'exporter des copies intermédiaires
Documenter les incohérences de schéma séparément des anomalies au niveau des valeurs
Privilégier une inspection confinée à la plateforme pour les datasets sensibles
Ce n'est pas de la sur-ingénierie. C'est ce qui empêche le débogage de se transformer en exfiltration accidentelle.
Optimiser les performances du viewer
La vitesse d'un viewer ne dépend pas seulement de l'application. Elle découle souvent de la manière dont le fichier Parquet a été écrit au départ.
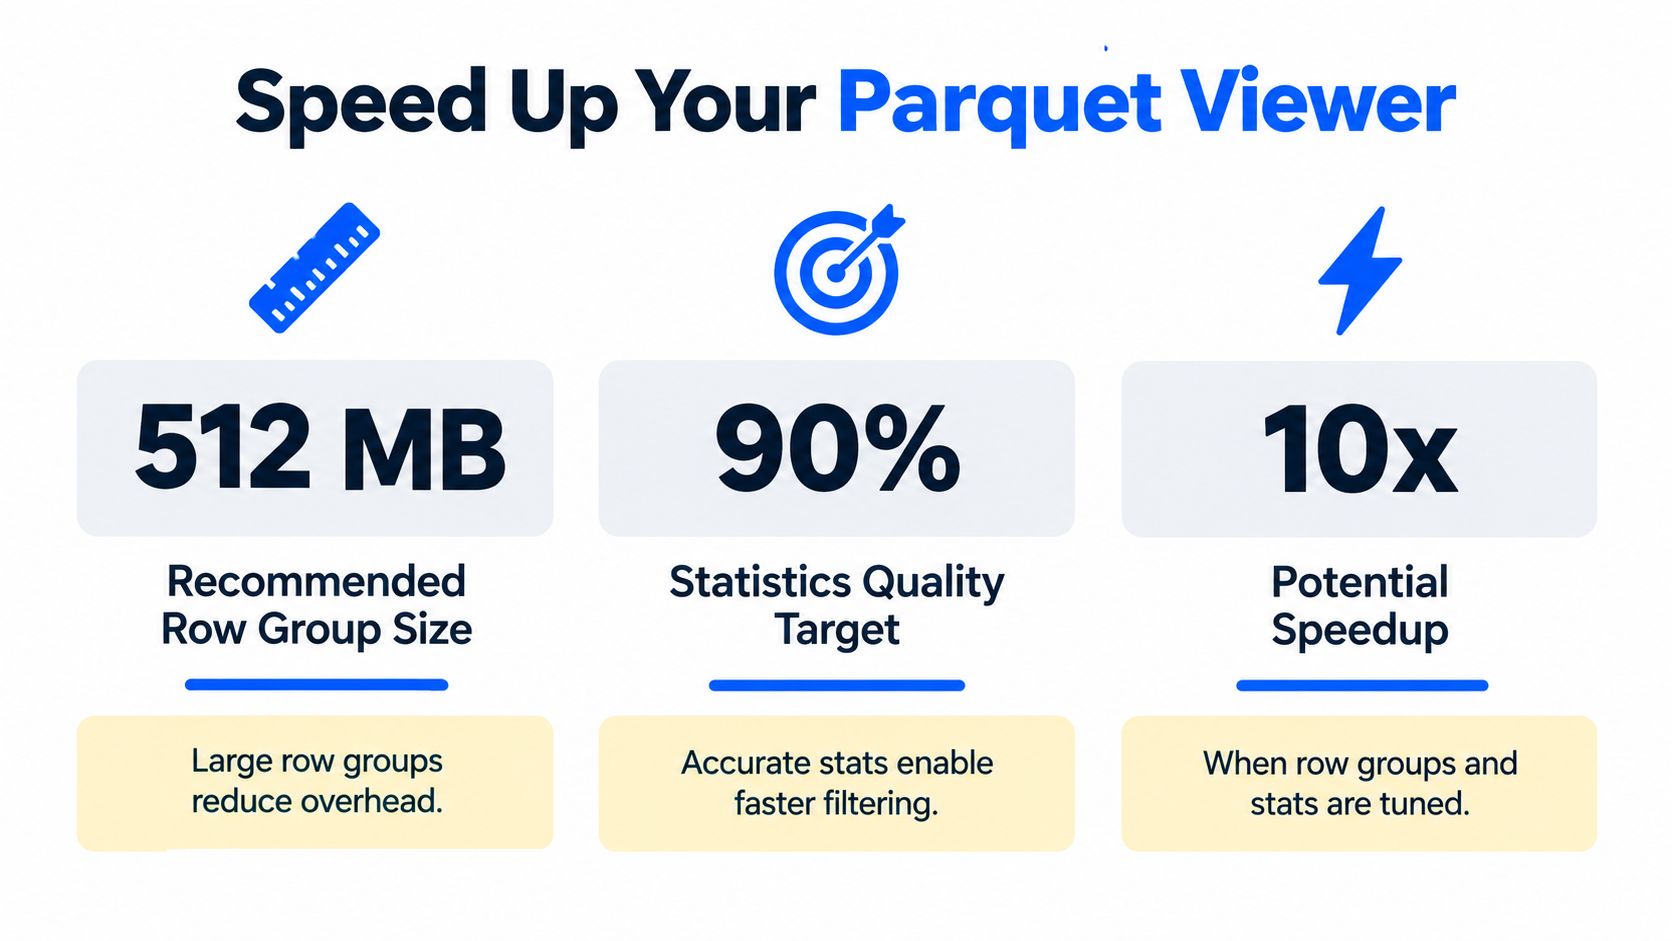
Apache Parquet recommande de grands row groups d'environ 512 Mo à 1 Go pour des lectures optimisées, car un row group entier est souvent l'unité minimale à lire. Quand les row groups sont trop petits, le surcoût des métadonnées augmente et l'efficacité des scans baisse. Des groupes plus grands améliorent l'accès séquentiel et le traitement parallèle. Par ailleurs, les statistiques des row groups, comme les valeurs min et max par colonne, permettent à un viewer ou à un moteur de requêtes d'ignorer les chunks non pertinents, ce qui compte surtout pour les tables larges et les filtres sélectifs (recommandations de configuration Parquet).
Ce qui améliore vraiment les performances
Si vous voulez qu'un viewer de fichiers Parquet soit réactif, concentrez-vous autant sur le chemin d'écriture que sur celui de lecture.
Les row groups doivent être dimensionnés de façon réfléchie. Les fichiers aux row groups fragmentés sont plus difficiles à inspecter efficacement.
Les statistiques doivent être fiables. Des statistiques faibles ou absentes réduisent l'intérêt de l'inspection sélective.
Les schémas larges demandent de la discipline. Plus vous transportez de colonnes, plus la projection devient importante.
Les données imbriquées doivent être testées avec soin. Un viewer peut ouvrir le fichier rapidement tout en passant du temps à décoder des structures complexes.
Pourquoi cela compte au-delà de l'inspection de fichiers
Une inspection rapide est l'un des symptômes d'une conception de stockage saine. Une inspection lente et laborieuse révèle souvent des problèmes plus larges de la plateforme de données : paramètres d'écriture incohérents, gouvernance de schéma faible ou manque d'observabilité sur la génération des fichiers.
C'est pourquoi je considère la visualisation de Parquet comme bien plus qu'une fonction de confort. C'est souvent le premier endroit où les ingénieurs remarquent que des fichiers sont produits d'une manière qui pénalise aussi les performances des requêtes en aval. Les habitudes qui aident un humain à inspecter efficacement les données aident aussi les moteurs à les scanner efficacement. Cela inclut des tailles de fichiers raisonnables, de bonnes statistiques et des schémas clairs.
Si vos workloads SQL peinent également, les principes de l'optimisation des requêtes recoupent souvent ce que vous découvrirez en inspectant vos fichiers Parquet.
Sécurité en entreprise et alternatives in-place
Dans les environnements réglementés, la question principale n'est généralement pas de savoir si un viewer de fichiers Parquet est pratique. C'est de savoir si son utilisation oblige à déplacer des données hors des périmètres approuvés.
C'est là que les équipes doivent être strictes. Dans la finance, la santé, les télécommunications et le secteur public, il est souvent impossible de laisser des analystes ou des ingénieurs charger des extraits sensibles dans des services externes ou disperser des copies locales sur des ordinateurs portables. Même si le viewer est compétent, le workflow peut enfreindre les exigences de gouvernance.
Un modèle in-place est plus sûr, car il garde l'inspection et le monitoring dans l'environnement du client. Concrètement, les équipes inspectent la structure, valident les enregistrements et surveillent les changements de schéma sans exporter les données sous-jacentes vers des systèmes tiers. Cela signifie aussi que le calcul doit s'exécuter au plus près des données, idéalement dans la base de données, afin d'éviter tout déplacement inutile simplement pour répondre à des questions opérationnelles.
Pour l'ingénierie au quotidien, cela change l'objectif. Au lieu de se demander « Quel viewer doit ouvrir ce fichier ? », les équipes se demandent « Pouvons-nous répondre à cette question sans déplacer le fichier du tout ? ». C'est le meilleur réflexe par défaut pour les opérations en entreprise.
Si votre équipe a besoin de cette approche in-place, digna propose une plateforme de qualité et d'observabilité des données pour l'entreprise qui s'exécute dans votre propre environnement. Elle aide les équipes à suivre les changements de schéma, valider les enregistrements, surveiller le comportement des données et garder l'analyse au plus près des données, ce qui est précisément le modèle le plus sûr lorsque l'inspection de Parquet touche des datasets de production sensibles.
Ouvrir le footer à la main permet de savoir si le schéma a changé dans un fichier ; pour détecter automatiquement les colonnes ajoutées, supprimées ou dont le type a changé dans toutes vos tables, le Schema Tracker de digna surveille les changements structurels au sein de votre propre environnement, sans que les données aient à en sortir.
Questions fréquentes
Comment ouvrir un fichier Parquet ?
Utilisez un outil qui comprend le format, pas un éditeur de texte, car Parquet est un format binaire en colonnes avec des métadonnées basées sur Thrift. Les options incluent parquet-tools en ligne de commande, PyArrow ou pandas en Python, Spark, les extensions VS Code et les viewers en ligne, chacun adapté à un type d'inspection et à un niveau de sensibilité des données.
Pourquoi ne puis-je pas ouvrir un fichier Parquet dans un éditeur de texte ?
Un éditeur de texte n'affiche qu'un blob binaire, car Parquet stocke les données sous forme de row groups, de column chunks et de pages compressées, avec le schéma dans un footer en fin de fichier. Pour le lire, il faut analyser ce footer, localisé grâce aux 8 derniers octets et aux magic bytes PAR1 finaux.
Est-il sûr d'utiliser un viewer Parquet en ligne ?
Cela dépend des données. Les viewers qui chargent puis traitent le fichier peuvent convenir pour des échantillons non sensibles, mais de nombreuses équipes de la finance, de la santé, des télécoms et du secteur public ne peuvent pas les utiliser pour des raisons de gouvernance. Les viewers qui lisent les fichiers in place via des requêtes HTTP range et gardent les données en local sont plus sûrs.
Puis-je vérifier un schéma Parquet sans lire les données ?
Oui, car le schéma, l'emplacement des row groups et les statistiques de colonnes se trouvent dans le footer du fichier. Les outils qui lisent le footer analysent d'abord ces métadonnées, et Apache Doris propose une fonction table PARQUET_META qui renvoie le schéma, les statistiques des row groups et les métadonnées clé-valeur sans scanner aucune data page.
Pourquoi mon viewer Parquet est-il lent sur les gros fichiers ?
La lenteur vient souvent de la manière dont le fichier a été écrit plutôt que du viewer lui-même. Apache Parquet recommande des row groups d'environ 512 Mo à 1 Go, car un row group entier est souvent l'unité de lecture minimale. Des row groups fragmentés, des statistiques manquantes et des schémas très larges ralentissent tous l'inspection.



