9 types de détection d'anomalies expliqués
|
10
minute de lecture

La plupart des conseils sur la détection d'anomalies commencent par les algorithmes. C'est à l'envers. La détection d'anomalies commence par la bonne définition du normal.
Aucune méthode unique ne convient à tous les jeux de données, car les anomalies prennent des formes différentes. Une anomalie ponctuelle est une valeur isolée étrange, comme un pic soudain de paiements échoués. Une anomalie contextuelle ne paraît fausse que dans son contexte, comme un volume de transactions d'apparence normale survenant à la mauvaise heure. Une anomalie collective est un motif sur plusieurs enregistrements ou pas de temps, comme un lot retardé suivi d'un afflux de rattrapage. En pratique, les équipes doivent aussi séparer les problèmes univariés des problèmes multivariés, car une seule colonne au comportement étrange n'a rien à voir avec plusieurs champs qui dérivent ensemble.
Cette distinction a des racines profondes. Une revue historique récente fait remonter la pensée des anomalies en séries temporelles à Bernoulli en 1777, puis à la distinction des types d'anomalies par Fox en 1972 et à son élargissement par Tsay en 1988, tandis que la pratique moderne s'appuie toujours sur les anomalies ponctuelles, contextuelles et collectives comme catégories centrales (revue historique de la détection d'anomalies en séries temporelles). C'est toujours le bon point de départ pour choisir entre les principaux types de détection d'anomalies.
Une règle pratique fonctionne mieux qu'une recette universelle. Utilisez la validation déterministe pour les conditions connues. Utilisez des méthodes statistiques ou de séries temporelles quand le comportement est mesurable et récurrent. Utilisez l'apprentissage automatique quand les motifs sont complexes, multivariés ou évoluent trop vite pour une logique statique. Des plateformes comme digna combinent méthodes statistiques, apprentissage automatique, validation, Timeliness et surveillance de schéma au sein de l'infrastructure du client quand ce modèle d'exploitation compte.
Table des matières
1. Apprentissage de lignes de base statistiques
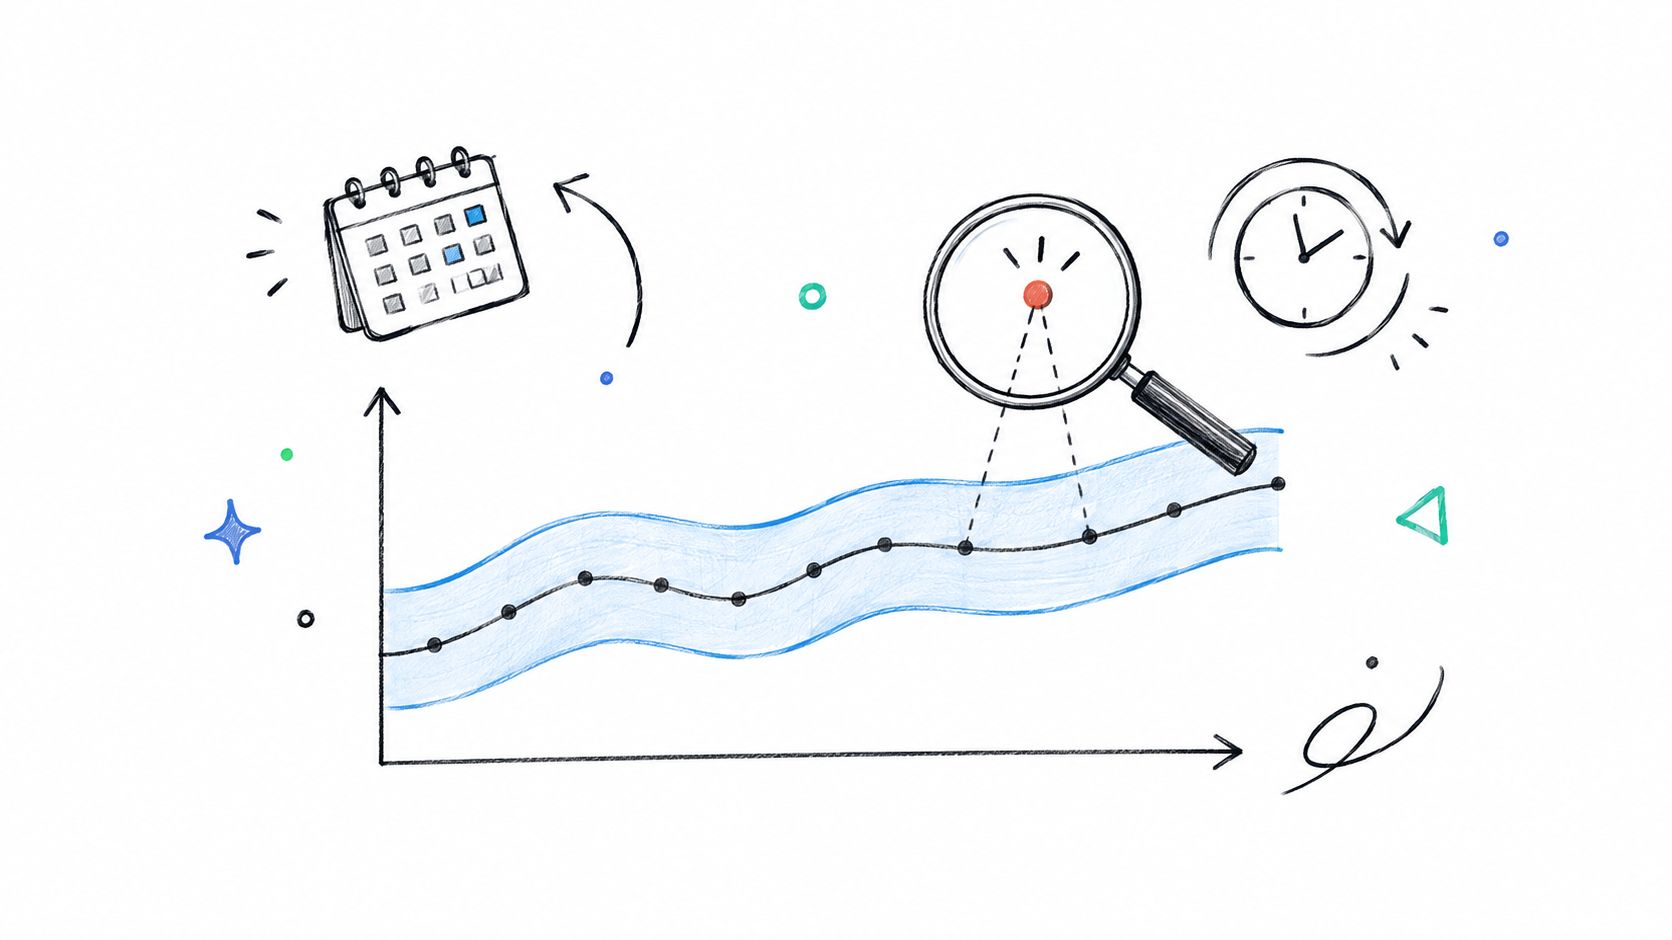
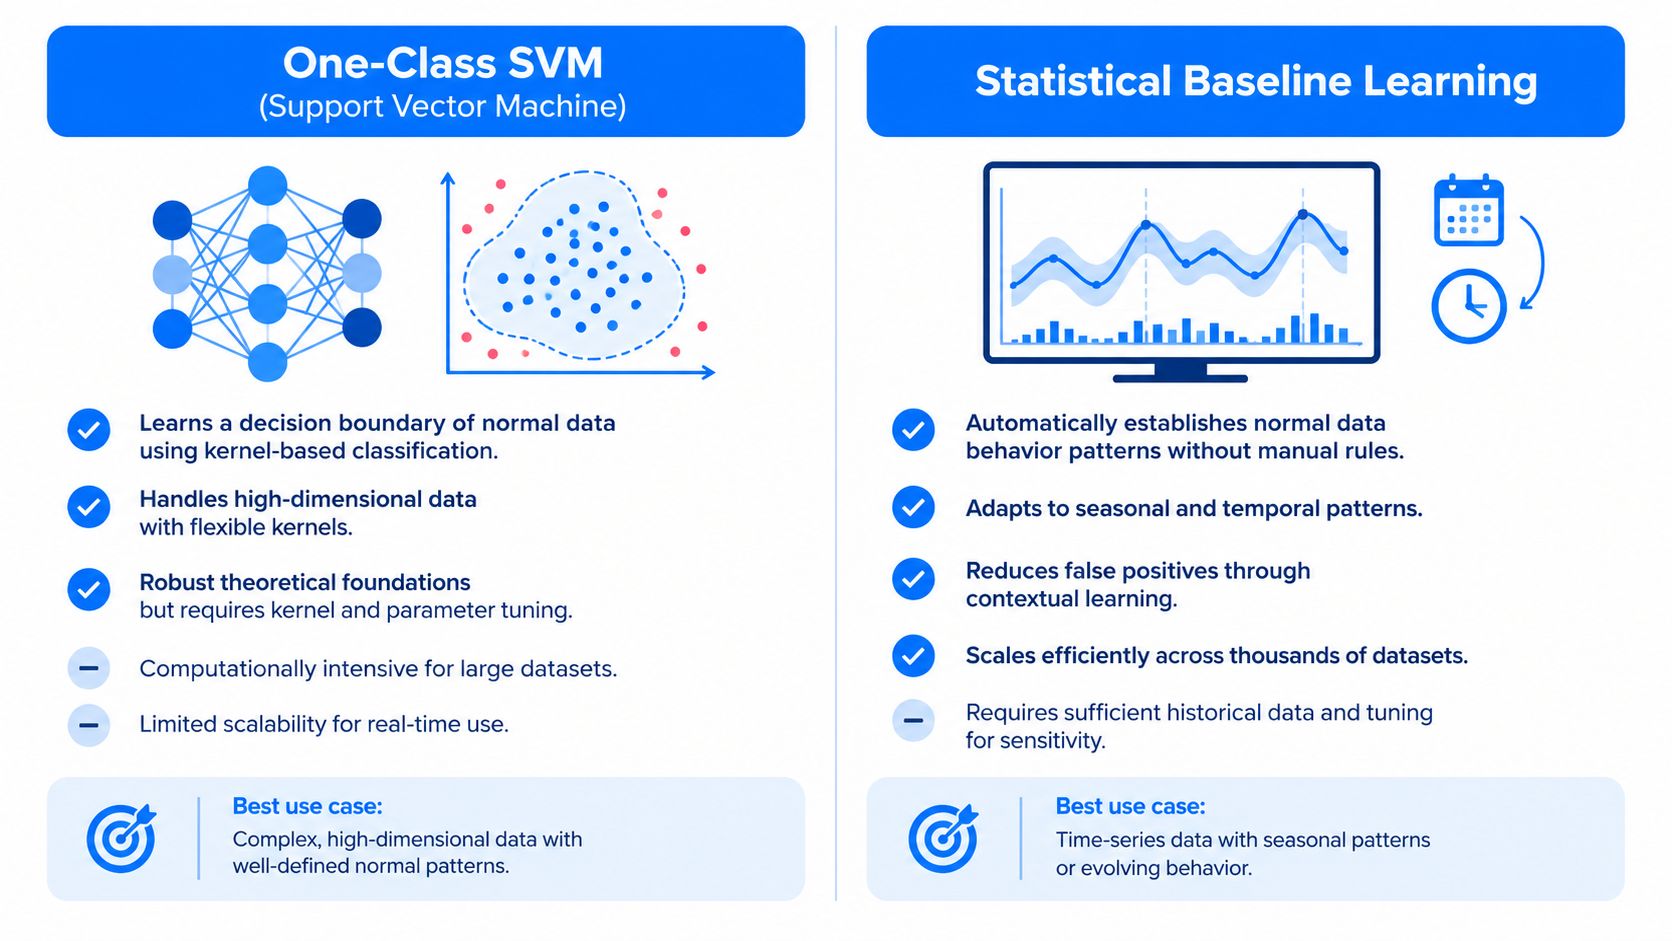
Certaines équipes appellent cela « détection d'anomalies par IA », mais l'idée utile est plus simple. Le système apprend de l'historique à quoi ressemble un comportement normal, puis signale les écarts par rapport à cette ligne de base.
Cette méthode fonctionne le mieux quand une métrique présente un comportement reconnaissable dans le temps. Les volumes de transactions peuvent monter en semaine et retomber le week-end. Les données de sinistres peuvent arriver par vagues prévisibles. Les événements de support peuvent bondir chaque matin puis se stabiliser. Un modèle de ligne de base absorbe ces motifs mieux qu'un seuil figé.
Voici l'intuition visuelle.
Quelles preuves il utilise
L'apprentissage de lignes de base s'appuie sur le comportement statistique observé dans le temps. Au lieu de demander « cette valeur a-t-elle dépassé une limite fixe », il demande « cette valeur est-elle inhabituelle pour ce jeu de données, à cette heure, sous ce motif récent ».
Cela en fait un bon candidat pour l'observabilité des données. Une équipe finance peut surveiller le volume quotidien de transactions. Une équipe d'exploitation hospitalière peut surveiller les flux d'admissions. Une plateforme de données télécom peut suivre les enregistrements d'usage arrivés en retard. Dans chaque cas, le modèle apprend les plages attendues, les tendances et la variation récurrente.
Une notion de fond utile est la distribution des données dans l'analyse d'anomalies. Les équipes qui comprennent dispersion, asymétrie et variation attendue règlent en général les lignes de base plus efficacement.
Règle pratique : associez l'apprentissage de lignes de base à des contrôles déterministes sur les jeux de données à fort risque. Le comportement appris attrape la dérive. Les règles attrapent les violations connues.
Où il aide et où il peine
Il aide quand le « normal » change dans le temps tout en suivant un motif. Il peine quand vous avez trop peu d'historique, quand le processus a changé la semaine dernière ou quand la métrique est surtout du bruit.
Exemples :
Finance : dérive inattendue du volume de transactions alors qu'aucun seuil n'a été franchi
Santé : glissements inhabituels de l'activité patient entre établissements
Télécoms : taux d'arrivée anormaux des données dans les pipelines d'ingestion
Compromis fréquents :
Fort en interprétabilité : les équipes voient d'ordinaire la bande attendue et savent expliquer pourquoi une alerte s'est déclenchée
Sensible aux mauvaises fenêtres d'entraînement : les périodes d'incident peuvent contaminer la ligne de base
Meilleur avec des contrôles d'appoint : les contrôles de validation et de Timeliness renforcent la confiance
2. Isolation Forest
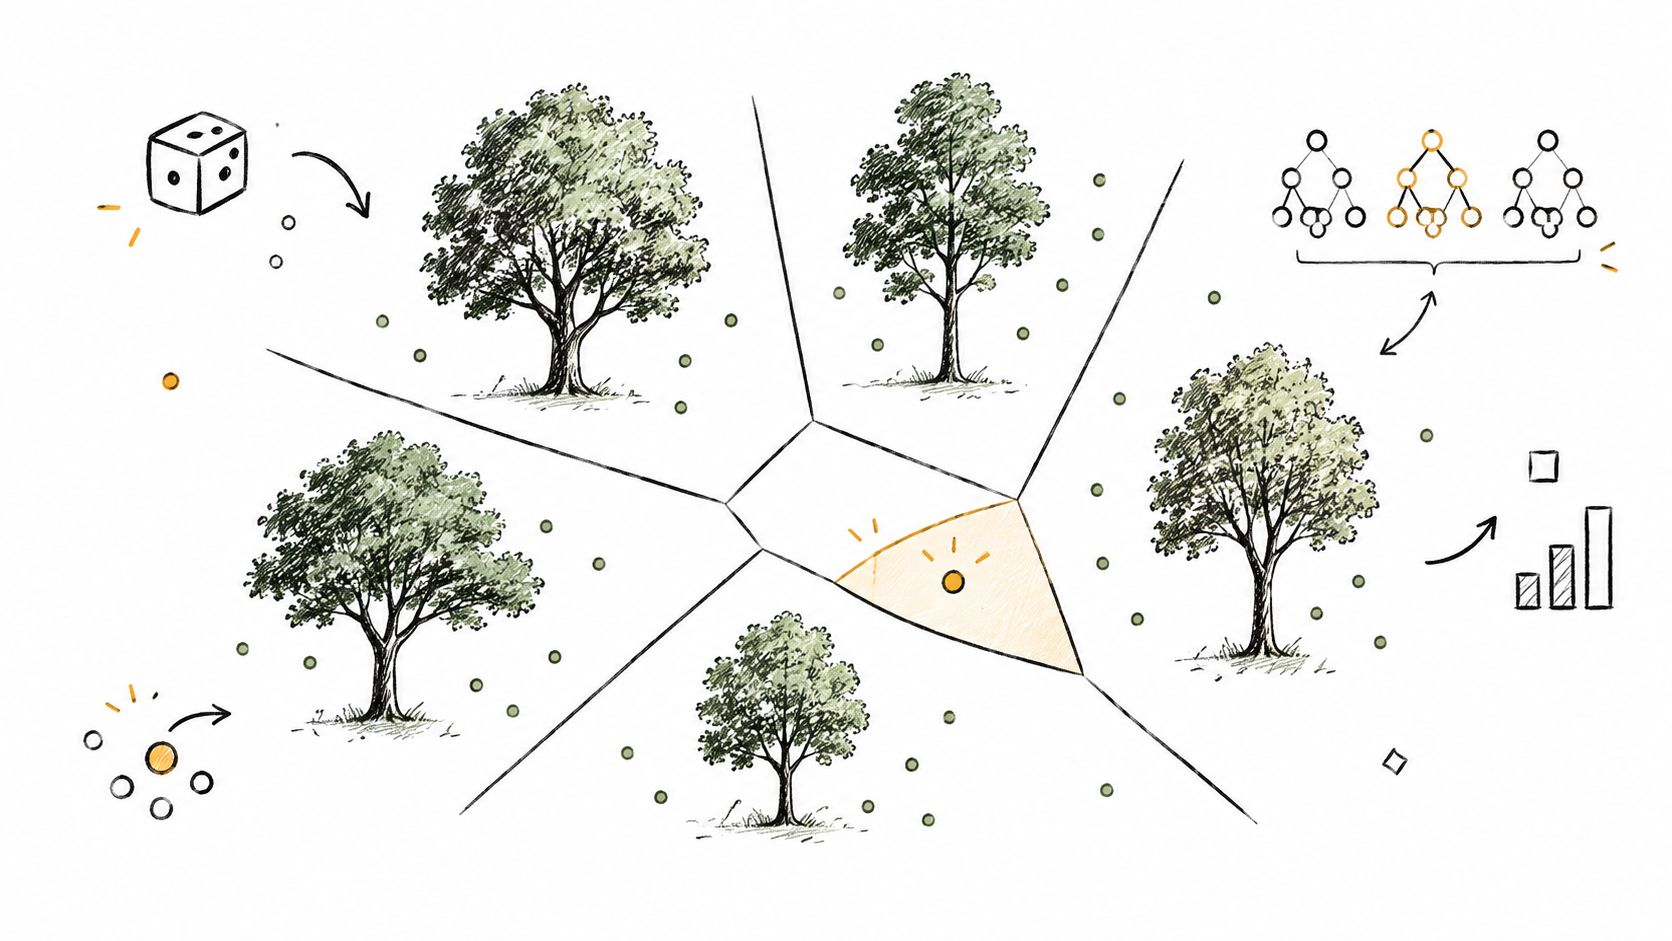
Isolation Forest est une méthode d'apprentissage automatique qui ne paraît étrange que jusqu'à ce qu'on se représente ce qu'elle fait. Elle découpe les données au hasard en partitions de plus en plus petites. Les points isolés rapidement ont plus de chances d'être des anomalies.
Cette approche la rend utile pour les données de grande dimension. Si vous évaluez de nombreuses variables à la fois, les méthodes fondées sur la distance deviennent vite malcommodes. Isolation Forest évite une partie de cette complexité en se concentrant sur la facilité à séparer un point du reste.
Comment cela fonctionne en pratique
Vous entraînez le modèle sur des données non étiquetées. Il crée de nombreux arbres aléatoires. Une observation normale demande d'ordinaire plus de découpes pour être isolée, car elle se trouve dans une région dense. Une observation inhabituelle est séparée en moins d'étapes.
C'est donc une option raisonnable quand vous n'avez pas d'étiquettes et ne voulez pas écrire à la main des règles pour chaque combinaison suspecte. Une banque peut noter des transactions à partir du montant, de la catégorie de commerçant, de l'heure, de la géographie et du canal. Un hôpital peut analyser des combinaisons de mesures d'exploitation. Une équipe télécom peut surveiller le comportement réseau sur plusieurs dimensions.
Si vous voulez prototyper la méthode concrètement, un flux de détection d'anomalies en Python est un point de départ courant.
Compromis à surveiller
Isolation Forest peut bien fonctionner sur des données multivariées, mais ce n'est pas magique. Le choix des variables compte toujours. La mise à l'échelle aussi. Si une variable domine la plage, le modèle peut isoler les mauvais enregistrements pour la mauvaise raison.
Bons usages :
Filtrage de fraude : combinaisons inhabituelles sur de nombreux attributs de transaction
Surveillance opérationnelle : comportement normal sur chaque métrique isolée mais étrange en combinaison
Exploration : grands jeux non étiquetés où il vous faut des candidats à examiner
Commencez par les paramètres par défaut, puis vérifiez les alertes réelles avec les responsables métier. Un point mathématiquement inhabituel n'est pas toujours une anomalie pertinente pour l'entreprise.
3. Score Z et méthodes d'écart type
S'il vous faut une réponse simple à « cette valeur est-elle anormalement loin de la moyenne », le score Z est souvent la première méthode à essayer.
Il mesure l'éloignement d'un point par rapport à la moyenne, en unités d'écart type. Cela paraît technique, mais la logique de décision est directe. Si la valeur est assez éloignée de ce qui est typique, signalez-la.

Meilleur cas d'usage pour les scores Z
Les scores Z sont utiles quand la métrique est plutôt stable et que sa distribution se tient raisonnablement bien. Les techniques de base courantes pour une détection statistique concrète comprennent le score Z, l'écart interquartile et les moyennes mobiles, et les équipes peuvent les combiner par vote ou pondération pour réduire les fausses alertes et améliorer la détection (notes pratiques sur les méthodes de détection d'anomalies en séries temporelles).
C'est pourquoi les scores Z restent présents dans la surveillance en entreprise. Ils s'expliquent facilement. Une équipe finance peut signaler des montants de transaction inhabituels. Une équipe de soins peut surveiller des constantes vitales atypiques. Une équipe data peut surveiller le nombre de lignes dans des chargements récurrents.
Si vous devez réfléchir plus finement à la pertinence de la moyenne et de la dispersion comme résumé, ce guide sur comment décrire la distribution des données apporte un contexte utile.
Limites et ajustements pratiques
La faiblesse, c'est le contexte. Un score Z sur des données brutes peut manquer la saisonnalité, la dérive ou des distributions asymétriques. Une métrique de ventes quotidiennes au fort effet jour de semaine peut paraître anormale chaque week-end si vous ignorez le contexte temporel.
Utilisez les scores Z avec précaution quand :
La métrique est stable : nombres de lignes, tailles de fichiers, durées ou montants à faible dérive
Vous avez besoin de transparence : l'audit ou la revue par les parties prenantes est plus simple avec des mathématiques élémentaires
Vous voulez une référence de départ : c'est un solide premier passage avant des modèles plus lourds
Ajustements pratiques rapides :
Utilisez des fenêtres glissantes : mieux adaptées aux comportements de séries temporelles changeants
Préférez des variantes au besoin : les alternatives fondées sur la médiane gèrent mieux les valeurs extrêmes
Ajoutez des règles métier : une valeur statistiquement inhabituelle peut rester acceptable en exploitation
4. Local Outlier Factor
Certaines anomalies ne sont pas extrêmes au niveau global. Elles ne sont étranges que par rapport aux données voisines. C'est là que Local Outlier Factor, ou LOF, devient utile.
LOF compare la densité locale d'un point à celle de ses voisins. Si le point se trouve dans une région plus clairsemée que les enregistrements autour de lui, la méthode le juge suspect. Cela le rend adapté aux données groupées où le « normal » possède plusieurs modes.
Pourquoi la densité compte
Pensez à l'usage client en télécoms. Gros consommateurs, utilisateurs occasionnels et comptes entreprise peuvent former des groupes distincts. Un enregistrement peut sembler normal face à l'ensemble de la population et rester étrange au sein de son propre groupe. LOF est conçu pour ce type de comparaison contextuelle.
La même logique aide en surveillance de plateforme. Un ensemble de traitements peut s'exécuter dans une bande de latence tandis qu'une autre famille de pipelines tourne dans une autre. LOF peut repérer une tâche anormale pour son groupe de pairs même si elle ne paraît pas grande en valeur absolue.
Adéquation pratique et compromis
LOF est le plus fort quand les voisinages ont du sens. Il s'affaiblit quand les dimensions se multiplient et que tout devient clairsemé. En grande dimension, les relations de plus proches voisins deviennent moins informatives.
Scénarios utiles :
Télécommunications : comportement client inhabituel au sein de cohortes d'usage similaires
Plateformes de données : traitements anormaux par rapport à des traitements comparables
Exploitation hospitalière : enregistrements qui ne collent pas aux motifs opérationnels voisins
Points à retenir :
Choisissez soigneusement la taille du voisinage : trop petite, les alertes deviennent nerveuses ; trop grande, le contexte local disparaît
Mettez d'abord les variables à l'échelle : les comparaisons de densité cassent quand une variable domine
Utilisez des boucles de revue : LOF trouve souvent des cas subtils qui demandent une interprétation métier
LOF fonctionne d'ordinaire mieux au sein d'un dispositif que comme détecteur isolé. Associez-le à un filtre statistique simple ou à une règle déterministe pour réduire le bruit de revue.
5. Réseaux de neurones auto-encodeurs
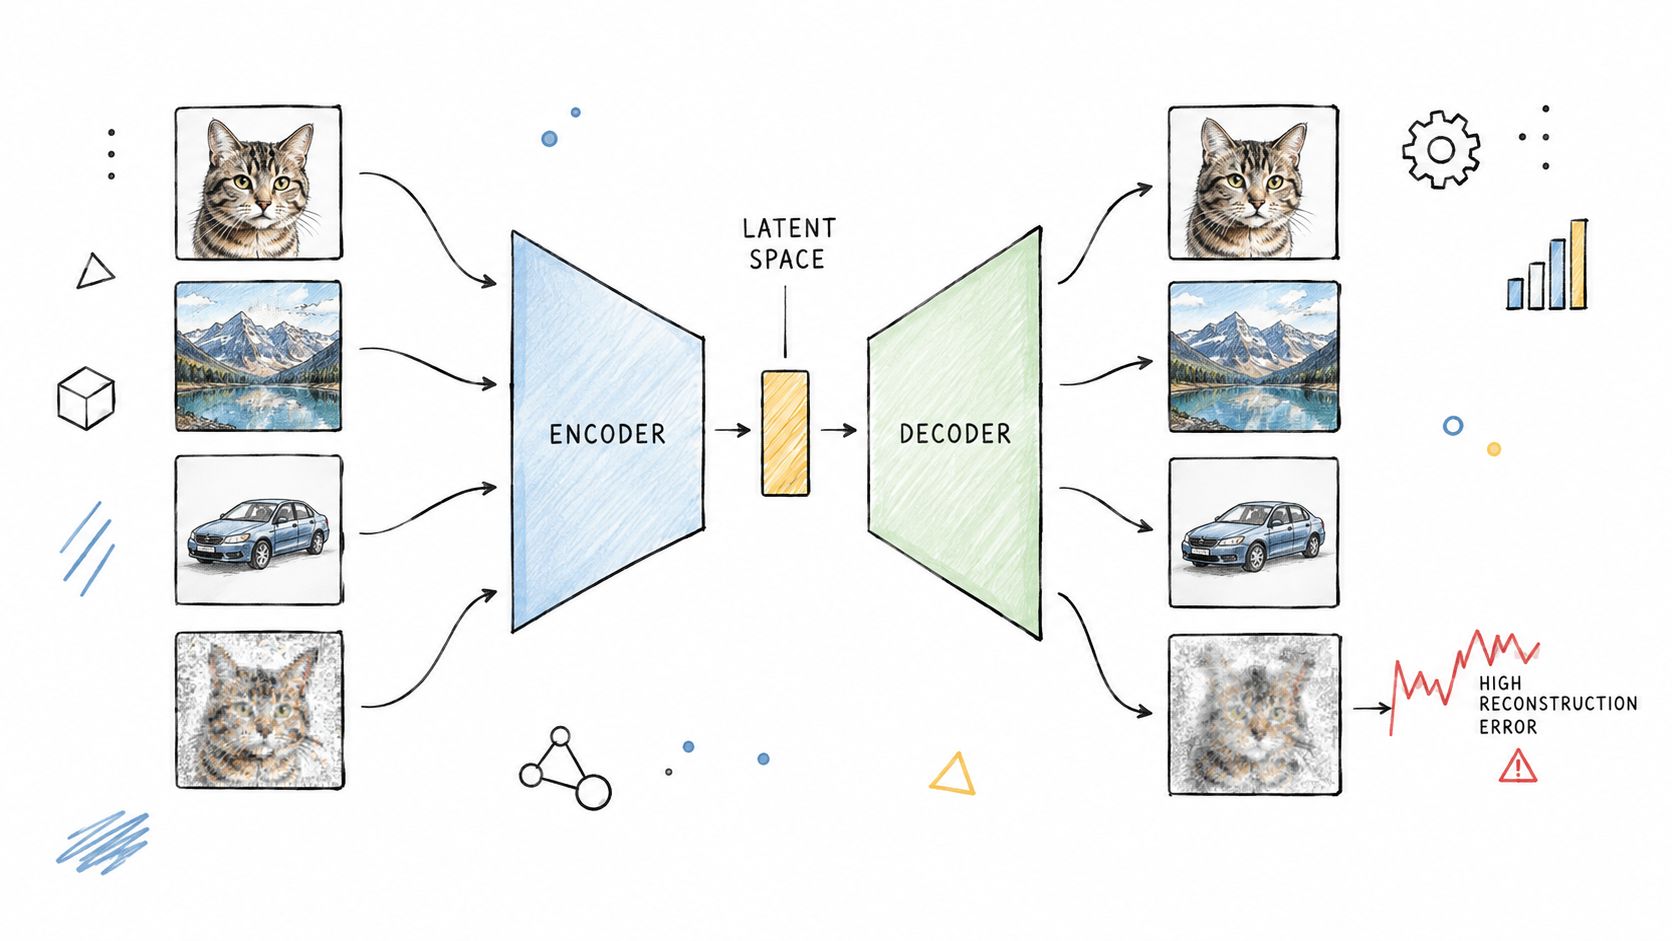
Les auto-encodeurs appartiennent à la famille de la reconstruction. Au lieu de fixer des limites explicites ou de mesurer une densité, ils apprennent à compresser puis reconstruire des données normales. Quand la reconstruction se passe mal, l'entrée peut être anormale.
Cette idée est puissante quand le motif est complexe et non linéaire. C'est aussi le moment où la détection d'anomalies devient plus difficile à expliquer à des interlocuteurs non techniques.
Où la reconstruction aide
Les auto-encodeurs sont utiles quand le comportement normal dépend de nombreuses variables en interaction et que des frontières simples ne le captent pas. Une équipe finance peut noter des comportements tarifaires complexes. Une équipe santé peut surveiller des combinaisons issues de plusieurs appareils ou capteurs. Une équipe télécom peut évaluer des signatures de trafic qui ne se séparent pas nettement par des méthodes linéaires.
Dans les grandes revues, les méthodes de détection d'anomalies sont souvent regroupées en approches statistiques, approches classiques d'apprentissage automatique et méthodes fondées sur les réseaux de neurones (revue des méthodes statistiques, d'apprentissage automatique et profond). Les auto-encodeurs se situent nettement dans ce troisième groupe.
Pour les comportements temporels, ils apparaissent souvent dans des flux plus larges de détection d'anomalies en séries temporelles, surtout quand les relations entre signaux comptent plus qu'une métrique isolée.
Les compromis sont réels
Les auto-encodeurs peuvent capter des motifs que des méthodes plus simples manquent. Ils demandent aussi des données d'entraînement plus propres, plus de réglage et une discipline d'exploitation plus forte. Si le modèle apprend un « normal » corrompu, l'erreur de reconstruction perd de son sens.
Utilisez-les quand :
Les motifs sont complexes : les interactions non linéaires comptent
Les anomalies étiquetées sont rares : la reconstruction n'exige pas beaucoup d'exemples de défaillance
Vous pouvez soutenir le modèle : entraînement, réentraînement et revue des seuils demandent des responsables
Les méthodes neuronales trouvent souvent des anomalies précieuses, mais remplacent rarement des contrôles plus simples. Les équipes ont toujours besoin de vérifications explicables pour les revues d'incident et les échanges d'audit.
6. SVM à une classe (Support Vector Machine)
La SVM à une classe cherche à apprendre la frontière autour des données normales. Tout ce qui tombe hors de cette frontière apprise est traité comme inhabituel.
Cela la rend conceptuellement différente d'Isolation Forest. Isolation Forest demande à quel point un point est facile à séparer. La SVM à une classe demande si le point tombe dans la région acceptée de comportement normal.
Quand apprendre la frontière a du sens
Cette méthode est utile quand les enregistrements normaux forment une forme cohérente, même non linéaire. Les fonctions noyau permettent au modèle de tracer des frontières plus souples, ce qui peut aider avec des motifs multivariés.
Exemples :
Services financiers : transactions qui sortent du comportement client normal
Santé : profils cliniques inhabituels sur plusieurs mesures
Analytique client : motifs d'activité de compte qui dérivent au-delà des normes connues
Le principal défi est la sensibilité. La SVM à une classe peut réagir fortement à la mise à l'échelle des variables, au choix des paramètres et à des données d'entraînement bruitées. Sur de grands jeux, elle peut aussi devenir coûteuse en calcul face à des méthodes plus légères.
Ce que les équipes doivent attendre
La SVM à une classe est souvent un bon choix pour des jeux structurés de taille moyenne où apprendre « la classe normale seulement » colle au problème métier. Elle est moins attrayante quand il vous faut une explicabilité facile ou un comportement de production peu exigeant en maintenance.
Habitudes d'exploitation utiles :
Normalisez les entrées : c'est rarement facultatif
Gardez des variables pertinentes : des variables faibles déforment la frontière
Réentraînez après un changement de processus : de nouveaux produits, canaux ou flux peuvent déplacer la région normale
S'il vous faut un modèle plus facile à discuter avec des auditeurs ou des responsables d'exploitation, la validation déterministe ou les lignes de base statistiques l'emportent en général.
7. Décomposition saisonnière et ARIMA
Le temps change tout en détection d'anomalies. Une valeur peut paraître fausse simplement parce qu'elle est apparue à la mauvaise heure, le mauvais jour, ou après la mauvaise séquence. La décomposition saisonnière et ARIMA sont faites pour ce problème.
Ces méthodes utilisent l'attente temporelle comme preuve. Elles demandent ce qui devrait arriver ensuite, compte tenu de l'historique de la série.
L'environnement de benchmark montre pourquoi le choix de méthode compte. ADBench a évalué 30 algorithmes de détection d'anomalies sur 57 jeux de données, et l'UCR Time Series Anomaly Archive fournit 250 séries temporelles curatées pour la recherche, confirmant que le choix d'algorithme dépend fortement des caractéristiques du jeu de données (présentation du benchmark ADBench et de l'archive UCR).
Ce qu'elles recherchent
La décomposition saisonnière sépare une série en tendance, saisonnalité et comportement résiduel. ARIMA modélise directement la dépendance temporelle. Les deux sont utiles quand l'anomalie n'est pas seulement « haute » ou « basse », mais « inattendue à ce moment ».
Cela compte en exploitation réelle. Un chargement par lots nocturne qui n'arrive pas à l'heure est un problème de Timeliness. Un pic d'activité client un jour férié peut être normal si saisonnalité et contexte événementiel sont correctement modélisés. Une baisse de chiffre d'affaires un week-end calme ne mérite peut-être pas d'escalade.
Cette famille de méthodes est particulièrement pertinente pour les anomalies collectives et de sous-séquence. Une revue récente note que beaucoup d'incidents de production ne sont pas des points isolés mais des anomalies collectives ou de sous-séquence, et souligne le manque pratique dans le choix de méthode pour des cas comme les chargements retardés, la dérive de schéma et le comportement de pipelines multi-signaux (revue sur la détection de glissements systémiques et les données d'observabilité). Si vous travaillez sur la surveillance de la livraison des données, ce manque vous parlera.
Une référence d'implémentation utile est ce guide pour détecter les anomalies dans les séries temporelles.
Bonne adéquation pour l'observabilité des données
Ces méthodes sont souvent la bonne réponse pour :
Chargements manquants ou tardifs : les fenêtres d'arrivée attendues comptent plus que les valeurs brutes
Métriques métier saisonnières : des motifs quotidiens, hebdomadaires ou mensuels dictent le comportement normal
Dérive dans des processus récurrents : écarts progressifs par rapport au calendrier ou au volume historiques
Un pipeline retardé est souvent une anomalie collective, pas ponctuelle. Les méthodes attentives au temps la détectent plus tôt que des seuils figés.
8. Distance de Mahalanobis
La distance de Mahalanobis est l'un des outils statistiques multivariés les plus utiles que beaucoup d'équipes ignorent. Elle mesure l'éloignement d'un point par rapport au centre des données en tenant compte de l'échelle et de la corrélation.
Ce dernier point compte. Si deux variables évoluent d'ordinaire ensemble, un enregistrement peut paraître parfaitement normal sur chaque colonne prise isolément et rester étrange en combinaison.
Pourquoi la corrélation change la réponse
Supposons que croissance du chiffre d'affaires, marge et ratio d'endettement suivent d'ordinaire une relation connue pour un segment. Un enregistrement d'entreprise aux valeurs banales sur chaque métrique peut néanmoins violer le motif multivarié habituel. La distance de Mahalanobis fait ressortir ce décalage plus efficacement que la simple distance euclidienne.
Cela la rend utile en finance, en exploitation clinique et en surveillance de la qualité des données. Un dossier de santé peut afficher des valeurs individuellement plausibles qui, combinées, forment un profil invraisemblable. Une plateforme de données peut observer des métriques de qualité acceptables séparément et suspectes ensemble.
Quand l'utiliser
La distance de Mahalanobis est un solide entre-deux entre statistique simple et apprentissage automatique complet. Elle reste interprétable tout en traitant mieux la structure multivariée que des seuils par colonne.
Elle marche le mieux quand :
Les variables sont corrélées : la covariance porte une information utile
Vous avez besoin de contrôles multivariés explicables : les analystes peuvent inspecter quelles relations ont bougé
Les données sont structurées : des métriques stables lui conviennent souvent mieux que des flux d'événements bruts
Les estimations de covariance peuvent devenir instables en contexte bruité ou de grande dimension. Une estimation de covariance par segments et la segmentation améliorent souvent la fiabilité.
9. Validation par règles et déterministe
Le conseil le plus négligé en détection d'anomalies est celui-ci. Si l'entreprise sait déjà qu'une condition est inacceptable, n'entraînez pas un modèle à la redécouvrir.
La validation par règles utilise une logique explicite. Les champs obligatoires doivent être renseignés. Les valeurs de référence doivent correspondre à des listes approuvées. Les dates doivent respecter des contraintes de séquence. Les conditions réglementaires doivent tenir exactement. Ce n'est pas de la surveillance « à l'ancienne ». C'est la forme de preuve la plus claire que vous puissiez avoir.
Le type de signal le plus fort
Les règles utilisent une connaissance métier explicite plutôt que des motifs inférés. Si un fichier de santé doit contenir des identifiants obligatoires, il n'y a aucun intérêt à demander à un modèle statistique si des identifiants manquants paraissent inhabituels. Ils sont invalides. Si un processus financier exige que les montants restent dans une plage de politique définie, un contrôle déterministe est la vérification première.
Voilà pourquoi les méthodes par règles restent essentielles en environnement réglementé et dans les flux de reporting critiques. Elles donnent aux équipes une auditabilité complète et un comportement d'exploitation stable.
Exemples :
digna Data Validation : contrôles au niveau des enregistrements face aux règles métier
Services financiers : contrôles liés à des contraintes de politique ou réglementaires
Santé : complétude des champs obligatoires et cohérence logique
Secteur public : application auditable des conditions de données exigées
Où s'arrêtent les règles
Les règles sont précises, mais elles n'attrapent que ce que quelqu'un a pensé à définir. Elles ne détecteront pas un mélange client inhabituel, une dérive subtile de métrique ni un glissement de la ligne de base des délais d'arrivée.
Des revues récentes soulignent que l'évaluation pratique de la détection d'anomalies a encore besoin de meilleures orientations sous contraintes de confidentialité, de déploiement, d'explicabilité et d'exploitation, tandis que la recherche en observabilité continue de mettre en avant le défi de réduire le bruit entre journaux, traces et métriques avec une automatisation digne de confiance (revue de la détection d'anomalies opérationnelle, explicable et consciente du déploiement). La validation déterministe aide à la confiance, car les équipes voient la condition exacte qui a échoué.
Utilisez des règles pour :
Les exigences métier connues
Les contrôles de conformité et d'audit
Les champs et enregistrements à fort risque
Des chemins d'escalade clairs
Comparaison de 9 méthodes de détection d'anomalies
Méthode | 🔄 Complexité de mise en œuvre | ⚡ Besoins en ressources | 📊 Résultats attendus | 💡 Cas d'usage idéaux | ⭐ Avantages clés |
|---|---|---|---|---|---|
Apprentissage de lignes de base statistiques | Modérée, configuration automatisée, réglage de la sensibilité | Faibles à moyens, nécessite un historique, calcul modeste | Détection d'anomalies attentive au contexte, avec moins de faux positifs | Surveillance continue des KPI et de la qualité des données, métriques saisonnières | S'adapte seule aux tendances et à la saisonnalité ; scalable ; valeur rapide |
Isolation Forest | Modérée, entraîner les arbres et régler les paramètres | Faibles à moyens, efficace sur de grands jeux de grande dimension | Détection multivariée solide en grande dimension | Détection de fraude, jeux opérationnels de grande dimension | Efficace, robuste aux variables non pertinentes, sans métrique de distance |
Score Z et écart type | Faible, calculs statistiques simples | Minimes, calcul négligeable | Signalements rapides et interprétables d'écarts sur une métrique | Nombres de lignes, seuils sur une métrique, première ligne de surveillance | Extrêmement rapide, transparent, facile à auditer et à mettre en œuvre |
Local Outlier Factor (LOF) | Modérée à élevée, choix des voisins et de la métrique de distance | Moyens à élevés, coûteux sur de grands échantillons ou en grande dimension | Détecte les écarts de densité locale et les atypiques propres à un groupe | Jeux à densités variables ou anomalies dépendantes du groupe | Capte le contexte local ; aucune hypothèse de distribution globale |
Réseaux de neurones auto-encodeurs | Élevée, conception d'architecture et réglage des hyperparamètres | Élevés, GPU et un jeu d'entraînement propre ou étiqueté utile | Détecte des anomalies non linéaires complexes via l'erreur de reconstruction | Motifs complexes de grande dimension, données multicapteurs ou temporelles | Modélise des relations non linéaires ; s'étend à des jeux de variables complexes |
SVM à une classe | Élevée, choix du noyau et réglage des paramètres | Moyens à élevés, mémoire et calcul croissent avec la taille des données | Détection par frontière ; sensible à la mise à l'échelle et aux noyaux | Jeux à région normale cohérente où les anomalies se situent à l'extérieur | Frontières de décision souples avec une base théorique solide |
Décomposition saisonnière et ARIMA | Modérée, choix des paramètres saisonniers et ARIMA | Faibles à moyens, nécessite de longues séries historiques | Composantes de tendance et de saisonnalité interprétables et anomalies prévues | Séries temporelles à forte saisonnalité, Timeliness des pipelines | Conçu pour les données temporelles ; décomposition et prévisions claires |
Distance de Mahalanobis | Faible à modérée, estimation et inversion de la covariance | Faibles à moyens, nécessite assez d'échantillons par dimension | Scores d'atypiques multivariés tenant compte des corrélations | Contrôles et surveillance de qualité multivariée corrélée | Tient compte de la covariance et de l'échelle ; efficace sur variables corrélées |
Validation par règles et déterministe | Élevée, rédaction et maintenance manuelles des règles | Moyens, effort humain ; peu de calcul | Résultats déterministes réussi ou échoué, avec auditabilité complète | Contrôles réglementaires et règles métier critiques | Totalement transparent, auditable, application exacte de la logique métier |
Choisissez la méthode qui correspond au signal
La façon la plus concrète de comprendre les types de détection d'anomalies est de cesser de les voir comme des camps rivaux. Ce sont des manières différentes de réunir des preuves.
Utilisez les scores Z quand une métrique est simple, stable et facile à résumer par moyenne et dispersion. Utilisez l'apprentissage de lignes de base quand le comportement du jeu change dans le temps tout en formant un motif attendu. Utilisez la décomposition saisonnière ou ARIMA quand le moment, la tendance et la récurrence comptent, surtout pour les chargements manquants, les retards de livraison et l'activité métier à rythme quotidien ou hebdomadaire. Utilisez LOF et la distance de Mahalanobis quand le contexte vient de points voisins ou de variables corrélées. Utilisez Isolation Forest, SVM à une classe ou auto-encodeurs quand les données sont non étiquetées, multivariées et trop complexes pour une logique statique.
Le champ méthodologique plus large reflète cette diversité. La détection d'anomalies en séries temporelles se classe couramment en apprentissage non supervisé, supervisé et semi-supervisé, et la même littérature regroupe les méthodes en familles de prévision, reconstruction, distance, encodage, voisinage et probabiliste (panorama VLDB des familles de détection d'anomalies en séries temporelles). Rappel utile : le choix d'algorithme devrait partir du signal, non du modèle préféré.
La direction du marché pointe elle aussi vers des combinaisons opérationnelles plutôt que des outils isolés. Une prévision sectorielle projette la croissance du marché de la détection d'anomalies de 4,28 milliards de dollars en 2024 à 9,25 milliards d'ici 2032, et attribue le leadership d'adoption en 2025 au logiciel avec 81,6 % de part et au déploiement cloud avec 72,8 % (prévision de marché de la détection d'anomalies). Cela ne signifie pas que chaque équipe doive se précipiter vers une pile tout-cloud. Cela montre que la détection d'anomalies scalable et orientée production est entrée dans l'exploitation courante des entreprises.
Pour l'observabilité des données, le dispositif le plus solide combine généralement plusieurs méthodes. Une règle déterministe peut rejeter des enregistrements impossibles. Un modèle de ligne de base peut détecter une dérive progressive du nombre de lignes ou des valeurs. Un détecteur de Timeliness peut repérer des chargements retardés. Un moniteur de schéma peut attraper les changements structurels avant que les consommateurs en aval ne cassent. Cette conception en couches correspond à la façon dont surviennent les incidents. Peu de défaillances de production s'annoncent par un signal unique et parfait.
digna est un exemple pertinent de cette approche combinée. Sa plateforme s'exécute dans l'environnement du client et réunit détection d'anomalies guidée par l'IA, validation au niveau des enregistrements, surveillance de la Timeliness, suivi de schéma, surveillance des métriques métier et plateforme, et exécution dans la base. Cette combinaison compte pour les équipes qui ont besoin à la fois d'une détection adaptative et d'une application contrôlée et auditable.
Utilisez cette liste avant de choisir une méthode :
Définissez clairement l'anomalie : s'agit-il d'un problème ponctuel, contextuel, collectif, univarié ou multivarié ?
Confirmez l'historique des données : avez-vous assez d'historique propre pour apprendre le comportement normal ?
Mesurez les faux positifs : qui examinera les alertes, et quel niveau de bruit est acceptable ?
Attribuez la responsabilité de réponse : quelle équipe enquête sur la dérive, les règles échouées ou les retards de livraison ?
Revoyez après un changement de processus : réentraînez, réajustez ou réécrivez les contrôles quand produits, pipelines ou calendriers changent
La bonne méthode est celle qui correspond au signal, aux données et à la réalité opérationnelle qui entoure les deux.
digna offre aux équipes de données une manière modulaire d'appliquer ces approches de détection d'anomalies en production, de l'apprentissage de lignes de base guidé par l'IA à la validation déterministe, la surveillance de la Timeliness et le suivi de schéma. Parce qu'elle s'exécute dans l'environnement du client et réalise les contrôles dans la base, elle convient aux équipes qui veulent de l'observabilité avec un contrôle fort sur les mouvements de données et les flux de revue. Si cela correspond à votre configuration, rendez-vous sur digna.
Choisir une méthode est la moitié facile ; la garder calibrée quand les données bougent, c'est le travail, et c'est là que la surveillance continue de la qualité des données gagne sa place.
Questions fréquentes
Par où la détection d'anomalies doit-elle réellement commencer ?
Par la bonne définition du normal, pas par les algorithmes. La plupart des conseils partent de la méthode, ce qui est à l'envers : le même écart peut être un incident dans un jeu de données et une saisonnalité attendue dans un autre, et aucun modèle ne tranche cette question à votre place.
Quelle différence entre lignes de base statistiques et isolation forests ?
L'apprentissage de lignes de base statistiques modélise le comportement attendu à partir de l'historique et signale ce qui s'en écarte. Les isolation forests isolent plutôt les points faciles à séparer du reste, ce qui passe bien à l'échelle en grande dimension mais donne moins d'intuition sur les raisons du signalement.
Quand utiliser les scores Z plutôt que des méthodes de densité ?
Les scores Z conviennent à des distributions à une variable à peu près normales, où l'écart à la moyenne a du sens. Local Outlier Factor gagne sa place quand la densité compte : quand un point est normal globalement mais inhabituel par rapport à ses voisins immédiats, ce que les scores Z ne peuvent pas voir.
Quelles méthodes conviennent aux séries temporelles ?
La décomposition saisonnière et ARIMA, car elles séparent tendance et saisonnalité du résidu et cherchent l'écart dans ce qui reste. Cela convient bien à l'observabilité des données, où un pic le lundi est routinier et le même pic un mercredi ne l'est pas.
Les contrôles par règles comptent-ils encore aux côtés du ML ?
Oui : la validation déterministe est le type de signal le plus fort, car elle est explicable et auditable comme un score de modèle ne l'est pas. Les règles s'arrêtent là où commencent les inconnues inconnues, précisément là où les méthodes comportementales prennent le relais.