Sources de données disparates : Un guide pratique d'intégration
|
7
minute de lecture
Vous avez probablement déjà vécu cela. Une réunion hebdomadaire du lundi commence avec une personne affirmant que le CRM indique que le trimestre dernier a été solide, la finance affirme que l'histoire de la marge semble différente, et l'entrepôt de données produit montre un troisième chiffre totalement différent. Personne ne ment, mais la salle reste silencieuse car chaque rapport décrit une version légèrement différente de l'entreprise.
C'est ce qui rend les disparate sources of data si frustrantes. La rupture commence rarement par une panne spectaculaire, elle commence par de minuscules décisions : un horodatage interprété d'une façon dans un pipeline, une règle de remboursement mise à jour dans un autre, ou une définition du « client actif » qui a dévié juste assez pour déformer le tableau de bord. Si vous avez hérité d'une pile de rapports qui s'est développée au fil des initiatives passées, des fusions, des changements de fournisseurs et des correctifs « temporaires » qui ne sont jamais partis, vous savez déjà à quel point cela semble normal.
Table des matières
Quand vos rapports ne concordent plus
Ce que signifient réellement les sources de données disparates
La pile de décalages
Quatre défis pratiques auxquels vous serez confrontés en premier
Les quatre modes de défaillance qui apparaissent tôt
Stratégies d'intégration entre lesquelles il vaut la peine de choisir
Harmonisation et validation qui tiennent la route
Normaliser le sens avant le chiffre
Où doit se situer la validation
La surveillance comme système d'alerte précoce
Les signaux de surveillance et ce qu'ils détectent
Une check-list de travail pour votre prochain projet d'intégration
Décisions de pré-construction
Construire et valider
Quand vos rapports ne concordent plus
Un responsable financier arrive avec un tableur, un analyste produit ouvre le tableau de bord de l'entrepôt, et l'équipe CRM montre sa propre vue du chiffre d'affaires. Les trois chiffres semblent raisonnables à première vue, ce qui aggrave le désaccord au lieu de l'atténuer. L'équipe ne reçoit pas un signal de défaillance clair, elle obtient trois histoires plausibles qui ne peuvent pas toutes être vraies en même temps.
C'est généralement le moment où l'on blâme l'entrepôt de données, la couche BI ou le dernier travail ETL touché. La cause est souvent en amont. Un pipeline a pu convertir des horodatages en heure locale, un autre a pu appliquer une nouvelle politique de remboursement, et un troisième peut encore compter un « client actif » selon une définition que personne n'a documentée après le dernier lancement.
C'est pourquoi la réconciliation des données consiste moins à « faire correspondre les rapports » qu'à retracer quel système détient quelle version de la réalité. Un point de départ utile est un modèle mental simple : chaque source a ses propres règles, et ces règles peuvent diverger sans qu'aucune équipe n'ait l'intention de causer des problèmes. Pour une définition en langage clair de ce problème de réconciliation, voir l'aperçu de la réconciliation des données de digna.
Règle pratique : si trois rapports ne concordent pas, ne commencez pas par réécrire le tableau de bord. Commencez par demander quel champ, quelle règle ou quel horodatage a changé en premier.
La confusion est si courante car les piles de données modernes sont construites à partir de l'historique accumulé, et non à partir d'un schéma d'architecture propre. Cela signifie que le même événement commercial peut être représenté dans un CRM, un système financier, un entrepôt et un outil de support, chacun avec son propre rythme et son propre vocabulaire. Dès que cela se produit, « le chiffre » cesse d'être un chiffre unique pour devenir une négociation entre les systèmes.
Ce que signifient réellement les sources de données disparates
Le terme « disparate » ressemble à un problème de format, mais ce n'est que la première couche. Une source peut arriver sous forme de JSON, une autre en CSV, une autre en parquet, et un export fournisseur peut être verrouillé dans sa propre structure. Même à ce niveau, la forme des données modifie déjà la façon dont vous les ingérez, les analysez et les validez.
La couche suivante est la cadence. Un fichier de traitement par lots nocturne, un flux d'événements en continu et un tableur mis à jour manuellement se comportent tous différemment dans un pipeline. Si vous les traitez de la même manière, la source la plus récente peut toujours être la moins fiable car elle arrive au mauvais moment, avec de mauvaises attentes.
Vient ensuite la couche que la plupart des guides ignorent : la sémantique. Deux systèmes peuvent tous deux avoir une colonne appelée customer_id, mais l'un peut être la clé primaire du système d'enregistrement tandis que l'autre est un identifiant marketing qui a été anonymisé pour le reporting de campagne. Les étiquettes correspondent, mais pas le sens, et c'est là que les jointures naïves induisent en erreur.

La pile de décalages
Une bonne façon de concevoir des disparate sources of data est de les voir comme une pile. Les différences de format se situent en bas, les limites du système au-dessus, et les différences sémantiques se situent au sommet, là où vit le sens commercial. Chaque couche s'ajoute à celle du dessous, c'est pourquoi une jointure peut sembler techniquement réussie tout en étant analytiquement fausse.
Lorsque les équipes recherchent un meilleur processus de découverte à travers les entrepôts, les API et les outils existants, elles ont généralement besoin d'un moyen de faire émerger ces couches tôt. Un point de départ pratique est le guide de découverte de données de digna, car l'inventaire des sources et les vérifications de sens doivent avoir lieu avant que les transformations ne figent de mauvaises hypothèses.
Un ensemble de données peut être parfaitement formaté tout en étant inadapté à la question que vous posez.
C'est le malentendu fondamental. Les gens supposent souvent que l'intégration de données consiste principalement à déplacer des octets d'un endroit à un autre. En pratique, il s'agit d'aligner le format, la cadence, la conception du système et le sens commercial afin que la vue finale ne se charge pas seulement avec succès, mais qu'elle dise la vérité.
Quatre défis pratiques auxquels vous serez confrontés en premier
Les premiers problèmes d'intégration apparaissent rapidement, et ils semblent généralement ordinaires. Une charge utile de webhook Stripe arrive sous forme de JSON imbriqué tandis qu'un ERP existant émet toujours des fichiers nocturnes à largeur fixe. Le décalage de forme est évident, mais le coût réside dans l'inférence constante de schéma et le temps humain passé à décider quel champ fait autorité.
Les quatre modes de défaillance qui apparaissent tôt
Défi | À quoi cela ressemble | Symptôme typique |
|---|---|---|
Hétérogénéité des formats | JSON imbriqué d'un côté, exports à largeur fixe de l'autre | Les tâches de chargement échouent ou infèrent un mauvais schéma |
Décalage de cadence | Tickets en temps réel mélangés à des fichiers d'enquête hebdomadaires | Les tableaux de bord vieillissent silencieusement et confondent les utilisateurs |
Variance de qualité | Enrichissement tiers à côté d'un flux de clics propriétaire incomplet | Valeurs nulles, doublons et agrégats instables |
Conflit sémantique | « Pays » signifie un code ISO dans un système et du texte libre dans un autre | Les jointures réussissent, mais l'indicateur clé de performance (KPI) est faux |
Le décalage de cadence est celui qui trompe le plus les équipes. Les tickets de support peuvent arriver presque en temps réel tandis que les enquêtes de satisfaction client arrivent dans un CSV hebdomadaire, ce qui signifie que toute vue « des dernières 24 heures » peut être incomplète sans sembler en panne. Si l'analyste ne connaît pas le profil de décalage de chaque source, il confondra les différences de fraîcheur avec des changements commerciaux.
La variance de qualité est le tueur silencieux. L'enrichissement tiers peut côtoyer des données de flux de clics propriétaires contenant des sessions manquantes, des identifiants dupliqués ou des enregistrements incohérents, et le résultat fusionné peut tout de même sembler assez propre pour passer un examen superficiel. Ce type d'instabilité est précisément la raison pour laquelle la qualité des sources doit être traitée comme faisant partie intégrante de la conception, et non comme un travail de nettoyage après coup.
Le conflit sémantique est le plus difficile car il se cache derrière des noms de champs familiers. Une source qui utilise country pour les codes ISO, une autre qui stocke du texte libre et une troisième qui conserve une abréviation obsolète sont toutes « correctes » au sein de leurs propres systèmes. Dès que vous les comparez, le sens commercial se fracture.
Pour les équipes qui cherchent à comprendre comment la dérive structurelle se transforme en pipelines défectueux, le guide sur la dérive des schémas de digna aide à formuler le problème comme un problème opérationnel, et non comme une simple nuisance de modélisation.
Si le nom du champ semble familier, ralentissez. C'est là que se cachent les bugs sémantiques.
C'est pourquoi les projets d'intégration s'essoufflent si souvent. Les premiers problèmes ne sont pas exotiques, ils sont ordinaires et répétés, et ils obligent les équipes à choisir entre vitesse et confiance avant même que la forme de la pile ne soit stabilisée.
Stratégies d'intégration entre lesquelles il vaut la peine de choisir
ETL, ELT, CDC et la modélisation canonique résolvent des problèmes différents, et ils sont faciles à utiliser à mauvais escient lorsque les gens les traitent comme une idéologie. L'ETL fonctionne lorsque les utilisateurs ont besoin de données structurées et organisées, et que les systèmes sources sont suffisamment stables pour que vous puissiez transformer avant de charger sans devoir retravailler constamment. C'est une bonne solution pour les consommateurs de systèmes existants, les flux de Compliance et les couches de reporting qui ne doivent voir que des structures validées.
L'ELT est plus logique lorsque l'entrepôt est rapide et que les analystes souhaitent d'abord une fidélité brute, puis une transformation dans un second temps. Cela permet aux équipes de préserver les détails de la source et de revoir la logique plus tard sans avoir à ré-extraire les données. C'est particulièrement utile lorsque les questions commerciales changent plus vite que les systèmes sources.
Le CDC appartient à la voie opérationnelle. Lorsque les systèmes en aval doivent refléter rapidement les modifications des sources, la capture de données modifiées maintient le décalage suffisamment petit pour que les flux de travail des produits, du support ou de la finance restent alignés avec ce qui vient de se passer. Le compromis est que le CDC peut déplacer l'incertitude plus rapidement, de sorte qu'il nécessite toujours une validation à l'arrivée.
La modélisation canonique résout un tout autre problème : l'accord. Si les ventes, le produit et la finance ont tous besoin de la même définition du client ou du produit avant de commencer tout travail en aval, un modèle canonique leur offre un contrat partagé unique. C'est plus lent au départ, mais cela évite que chaque équipe n'invente sa propre vérité en aval.
Les piles les plus intelligentes combinent généralement ces modèles. Une équipe peut intégrer le CDC dans une zone intermédiaire (staging), utiliser l'ELT à l'intérieur de l'entrepôt, alimenter un modèle canonique dans la BI, et toujours utiliser l'ETL pour structurer les exports d'un système hérité. Ce n'est pas de l'incohérence, c'est une architecture adaptée à l'usage.
Si vous comparez les options d'intégration pour des cas d'utilisation analytiques et respectueux de la vie privée, une solution BI axée sur la confidentialité peut être un contexte utile, car le modèle d'intégration et la couche de consommation doivent généralement être conçus ensemble.
Pour les projets centrés sur l'entrepôt de données, la page d'intégration de l'entrepôt de données de digna est un point de référence utile pour comprendre comment les couches de chargement et de distribution se connectent en pratique.
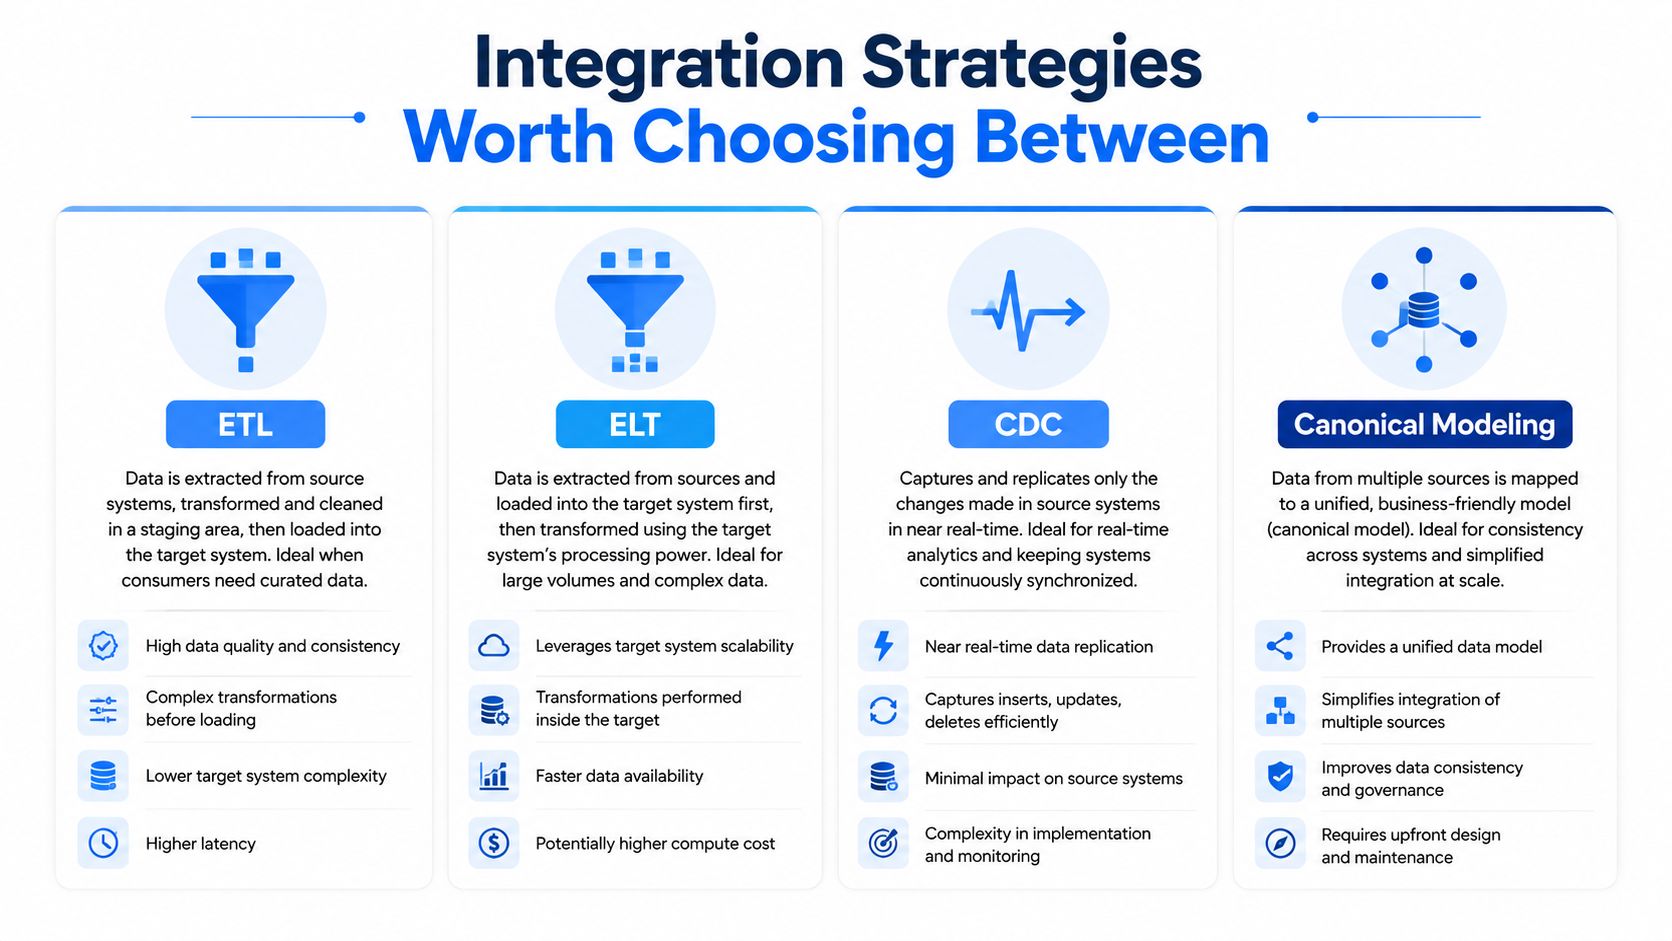
La bonne stratégie d'intégration est celle qui correspond au consommateur, à l'exigence de latence et au niveau de confiance que vous pouvez imposer à la frontière.
De nombreuses équipes perdent des semaines à débattre pour savoir quel modèle est « moderne ». Ce débat passe à côté de l'essentiel. La question clé est de savoir quel modèle maintient le contrat sémantique suffisamment clair pour que les équipes en aval puissent utiliser les données sans avoir à faire d'ingénierie inverse.
Harmonisation et validation qui tiennent la route
L'harmonisation commence par la déduplication, mais pas de la manière simpliste qui suppose que des clés exactes existent déjà. Les systèmes indépendants partagent rarement des identifiants parfaits, de sorte que le blocage de clés et la correspondance probabiliste deviennent souvent nécessaires, ne serait-ce que pour déterminer quels enregistrements font probablement référence à la même entité. Cette étape doit avoir lieu avant que la logique de fusion ne fige les comptes de doublons dans une fausse certitude.
Normaliser le sens avant le chiffre
Une fois les enregistrements alignés, normalisez la couche des unités. Les devises, les fuseaux horaires, les systèmes de mesure et les calendriers fiscaux créent tous des décalages invisibles lorsque les équipes supposent qu'une valeur signifie la même chose partout. Un chiffre d'affaires en heure locale et un chiffre d'affaires en UTC peuvent tous deux être corrects tout en n'étant pas comparables.
La réconciliation sémantique vient ensuite. Les tables de correspondance et les définitions faisant autorité sont importantes ici, car les noms de champs cachent souvent des différences de règles métier qu'aucun contrôle de type ne détectera. Un nom de colonne propre ne sert à rien si une source traite le « client » comme un compte, une autre comme un utilisateur et une troisième comme une entité de facturation.
Le même principe s'applique au travail sur l'« enregistrement d'or » (golden record), où les équipes tentent de décider quelle version d'un client, d'un produit ou d'un emplacement doit être conservée. Si vous souhaitez un autre cadre pratique pour ce problème, l'approche golden record de BatchData est une référence externe utile sur la façon dont une couche d'enregistrements partagée modifie la cohérence en aval.
La validation doit s'ajouter à l'harmonisation, et non la suivre. Les vérifications de schéma appartiennent à la frontière, les vérifications d'intégrité référentielle appartiennent aux systèmes intermédiaires, les règles métier telles que les quantités non négatives appartiennent au pipeline, et la réconciliation au niveau des lignes doit comparer les totaux de contrôle de chaque source. Pour une manière structurée de penser à ces vérifications, le guide des règles de validation de digna est pertinent car la validation doit voyager avec les données, et non attendre qu'un tableau de bord ne signale un problème.
Où doit se situer la validation
La validation à la fin arrive trop tard. Au moment où le tableau de bord semble erroné, le contexte qui expliquerait la défaillance a déjà disparu.
Le modèle le plus solide consiste à valider à chaque transfert, car chaque transfert conserve le contexte source, le propriétaire et l'attente d'origine. Cela accélère la correction et raccourcit les discussions. Cela empêche également les équipes de traiter les données fusionnées comme fiables simplement parce qu'elles ont survécu à un travail de chargement.
La surveillance comme système d'alerte précoce
La surveillance n'est utile que si elle détecte la cause avant que le rapport ne devienne un mystère. La façon la plus propre d'y parvenir est de suivre de concert la Timeliness, les anomalies et les changements de schéma, et non pas sous forme de files d'attente distinctes. Si une source arrive en retard, le tableau de bord vieillit déjà, même si les chiffres semblent encore parfaits.
La surveillance de la Timeliness est la première ligne de défense, car les problèmes de fraîcheur commencent souvent en amont et se propagent en aval sans rupture visible. Si un SLA glisse, l'équipe doit le savoir avant que les utilisateurs professionnels ne commencent à prendre des décisions basées sur des données obsolètes. Cela est particulièrement crucial là où une source arrivant en retard peut modifier un KPI sans changer la forme du graphique.
La détection des anomalies couvre une classe de défaillance différente. Les variations de volume, de distribution et les pics de taux de valeurs nulles peuvent révéler un filtre défectueux, une jointure manquante ou un mauvais déploiement en amont bien avant que quelqu'un ne remarque une baisse de chiffre d'affaires. C'est tout l'intérêt de surveiller le comportement de la source, et non seulement le résultat dans le tableau de bord.
Le suivi de schéma ferme la boucle. Les ajouts de colonnes, les changements de types et les dérives de nullabilité sont les changements structurels silencieux qui perturbent les consommateurs en aval après qu'un pipeline semble « fonctionner ». Pour les systèmes de données qui doivent réagir à l'évolution des exigences de classification et de protection, le NIST note que la surveillance doit détecter les changements dans l'actif lui-même et déclencher des contrôles révisés si nécessaire, c'est pourquoi le suivi des schémas appartient à la boucle opérationnelle, et non seulement à la documentation.
Une vue de surveillance pratique est un tableau de bord unique regroupé par source, avec des indicateurs de lignage (lineage pointers) associés à chaque alerte. Cela permet à un ingénieur d'astreinte de retracer un fichier en retard, une anomalie de volume ou un changement de schéma jusqu'au système d'origine sans avoir à basculer d'un outil à l'autre. Les meilleures équipes cessent de se demander : « Quel rapport est faux ? » pour commencer à se demander : « Quelle source a changé en premier ? »
Les signaux de surveillance et ce qu'ils décetent
Catégorie de signal | Ce qu'il suit | Défaillance détectée tôt |
|---|---|---|
Timeliness | Délai d'arrivée, chargements manquants, arrivées anticipées | Tableaux de bord obsolètes et décalage silencieux |
Détection des anomalies | Volume, distribution, variations de taux de valeurs nulles | Filtres défectueux, jointures manquantes, ruptures en amont |
Suivi de schéma | Colonnes ajoutées, changements de types, dérive de nullabilité | Défaillances du pipeline dues à un changement structurel |
La différence entre la surveillance réactive et proactive est une question de timing. Les équipes réactives entendent parler du problème après que les utilisateurs s'en plaignent. Les équipes proactives détectent la cause lorsqu'elle est encore mineure, ce qui préserve à la fois la confiance et le temps de résolution des incidents.
Une check-list de travail pour votre prochain projet d'intégration
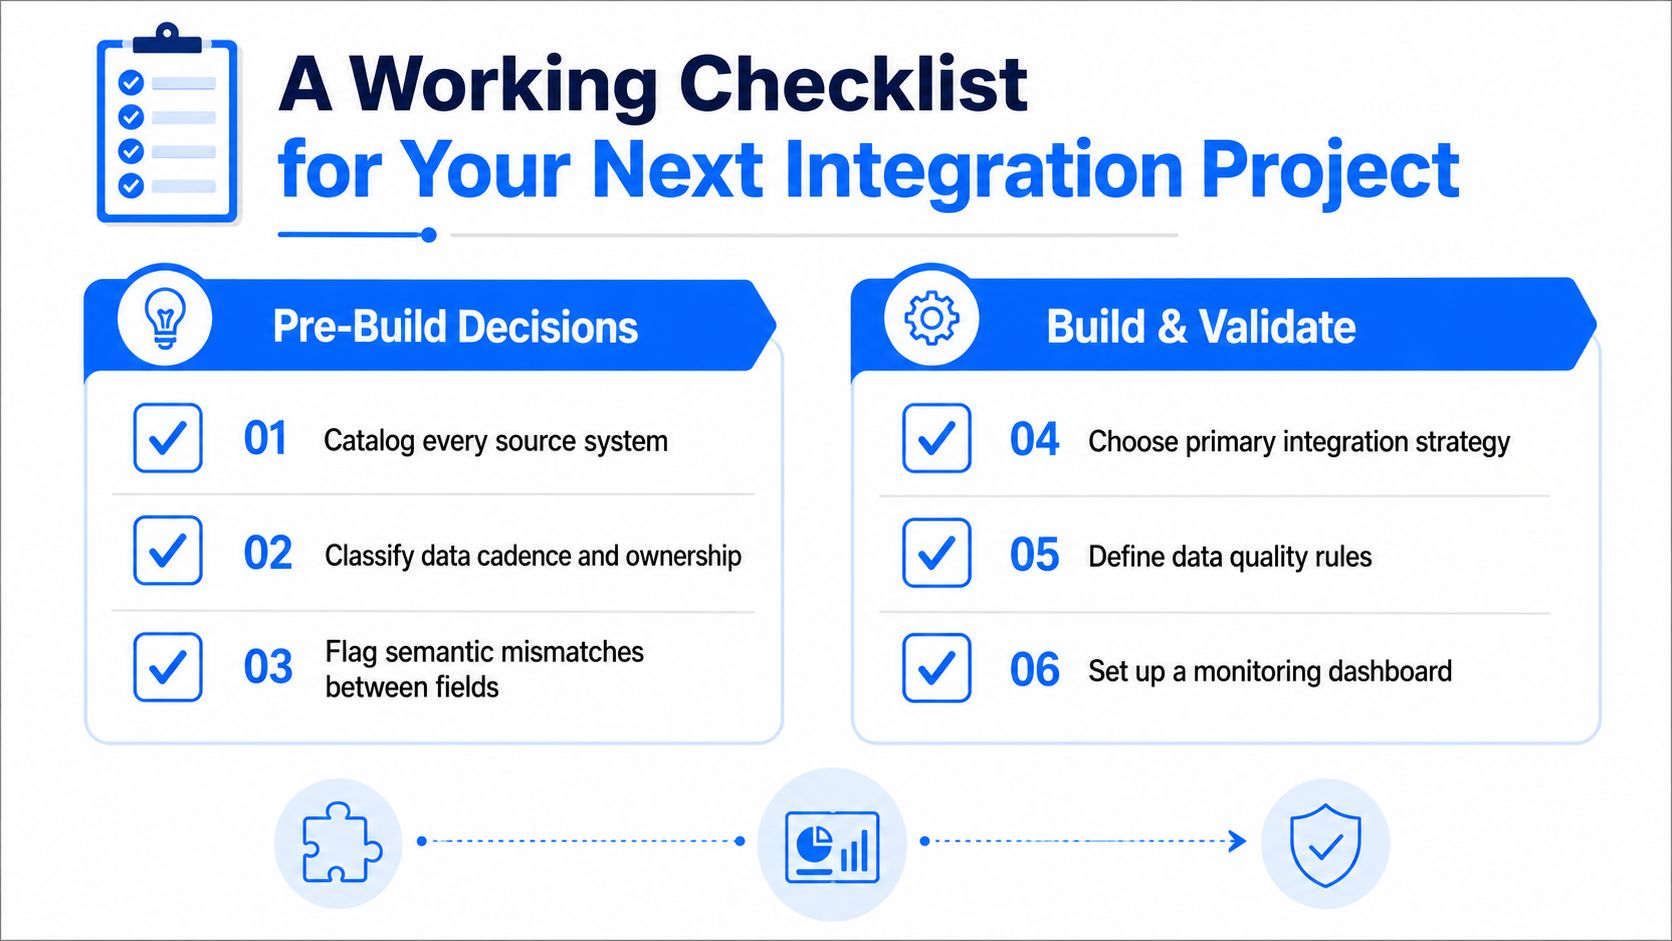
Commencez avant d'écrire votre première transformation. Cataloguez chaque source, classez sa cadence et identifiez le propriétaire qui peut répondre rapidement aux questions sur le schéma et le sens des données. Signalez tôt les conflits sémantiques, en particulier pour les champs tels que client, chiffre d'affaires, pays et produit.
Décisions de pré-construction
Cataloguer chaque système source, afin de ne pas découvrir un tableur caché après le lancement.
Classer la cadence et la propriété, afin que les fichiers en retard et les transferts flous ne deviennent pas des incidents surprises.
Signaler les décalages sémantiques, afin que les équipes ne réutilisent pas le même nom de champ pour des significations métier différentes.
Construire et valider
Choisir le modèle d'intégration principal, ETL, ELT ou CDC, en fonction du consommateur et du besoin de latence.
Documenter d'abord le modèle canonique, afin que les transformations ne codent pas de définitions concurrentes.
Définir des seuils de validation et des alertes de fraîcheur, afin que les mauvais chargements échouent rapidement au lieu de fuir dans la BI.
Ajouter des moniteurs de dérive de schéma et des vérifications du nombre de lignes, afin que les sources abandonnées et les modifications structurelles apparaissent avant que les utilisateurs ne s'en aperçoivent.
Si vous avez besoin d'une séquence concrète, effectuez un audit des sources d'une journée, esquissez le schéma canonique sur un tableau blanc et connectez un contrôle d'Observability dans le pipeline à fort trafic. Cela suffit à stopper la première série de défaillances silencieuses sans attendre qu'un comité ne valide l'architecture.
Si votre équipe est confrontée à des rapports discordants, à une dérive sémantique ou à des pipelines qui n'échouent qu'une fois le tableau de bord déjà erroné, digna vous offre un moyen de surveiller la Timeliness, la validation, les changements de schéma et les anomalies au sein de votre propre environnement. Visitez digna pour voir comment cela s'intègre dans une véritable pile d'intégration, et utilisez-le comme point de départ pour concevoir des données auxquelles vos équipes peuvent faire confiance.
Questions fréquentes
Que signifie vraiment « sources disparates » ?
Plus qu'un problème de format. Le format n'est que la première couche ; dessous se trouvent des définitions différentes, des cadences de mise à jour différentes et des idées différentes sur le système qui détient quelle version de la réalité, et c'est cela qui fait diverger les rapports.
Par où commencer quand trois rapports divergent ?
Pas en réécrivant le tableau de bord. Commencez par demander quel champ, quelle règle ou quel horodatage a changé en premier, car le rapprochement consiste moins à faire coïncider des rapports qu'à retracer quel système détient quelle version de la réalité.
Pourquoi les stacks modernes produisent-ils ce problème ?
Parce qu'ils se construisent à partir d'une histoire accumulée et non d'un schéma d'architecture propre. Chaque système est arrivé pour résoudre un problème précis à un moment précis, et les recouvrements entre eux ont rarement été conçus délibérément.
Qui est accusé en premier ?
L'entrepôt, la couche BI ou le dernier job ETL que quelqu'un a touché. Ce réflexe est compréhensible et le plus souvent faux, car la divergence a généralement commencé plus en amont, dans une définition, et non dans la couche où elle est devenue visible.
Qu'exige l'harmonisation au-delà du mapping ?
Un accord sur la propriété. Mapper les champs entre systèmes règle la partie mécanique, tandis que décider quel système fait autorité pour chaque concept est la partie qui empêche la même dispute de revenir chaque trimestre.


