Comment utiliser la simulation et la méthode de Monte-Carlo
|
7
minute de lecture

Une prévision des coûts de pipeline peut sembler précise jusqu'à ce que le système en amont ralentisse, que les tentatives se multiplient ou qu'une source commence à envoyer des enregistrements incomplets. La direction peut demander un chiffre unique pour le trimestre suivant, alors que l'équipe de données sait seulement que la latence, le comportement des tentatives et les taux de valeurs nulles se situent dans des plages larges et incertaines. Les moyennes facilitent la présentation des prévisions, mais elles peuvent masquer les résultats qui génèrent le risque opérationnel le plus important.
La simulation vous permet de rejouer ces conditions incertaines avant qu'elles n'affectent la production. Au lieu de demander uniquement : « Quel sera le coût du pipeline dans des conditions typiques ? », vous pouvez demander : « Comment le coût varie-t-il à travers de nombreuses combinaisons plausibles de latence, de tentatives et de données manquantes ? » Le résultat est une distribution qui expose le risque, teste les seuils d'alerte et transforme les hypothèses en éléments que votre équipe peut inspecter.
La méthode de Monte-Carlo est le moteur le plus largement utilisé pour cette traduction. Elle échantillonne de manière répétée des entrées incertaines, exécute un modèle et agrège les résultats. La méthode est née à Los Alamos au milieu des années 1940 et est rapidement passée de la physique de guerre à une technique de calcul généralisée, comme le documente le récit de Los Alamos sur la naissance de la méthode. Ce guide relie ses fondations à l'observabilité des données (Data Observability), avec des modèles pratiques en Python et R pour les plages de métriques, les tests de résistance de pipeline, la sensibilité aux données manquantes et la validation de la détection d'anomalies (Data Anomalies).
Table des matières
Pourquoi les équipes de données ont besoin de simulation
Des estimations ponctuelles aux distributions de risques
Un état d'esprit orienté production
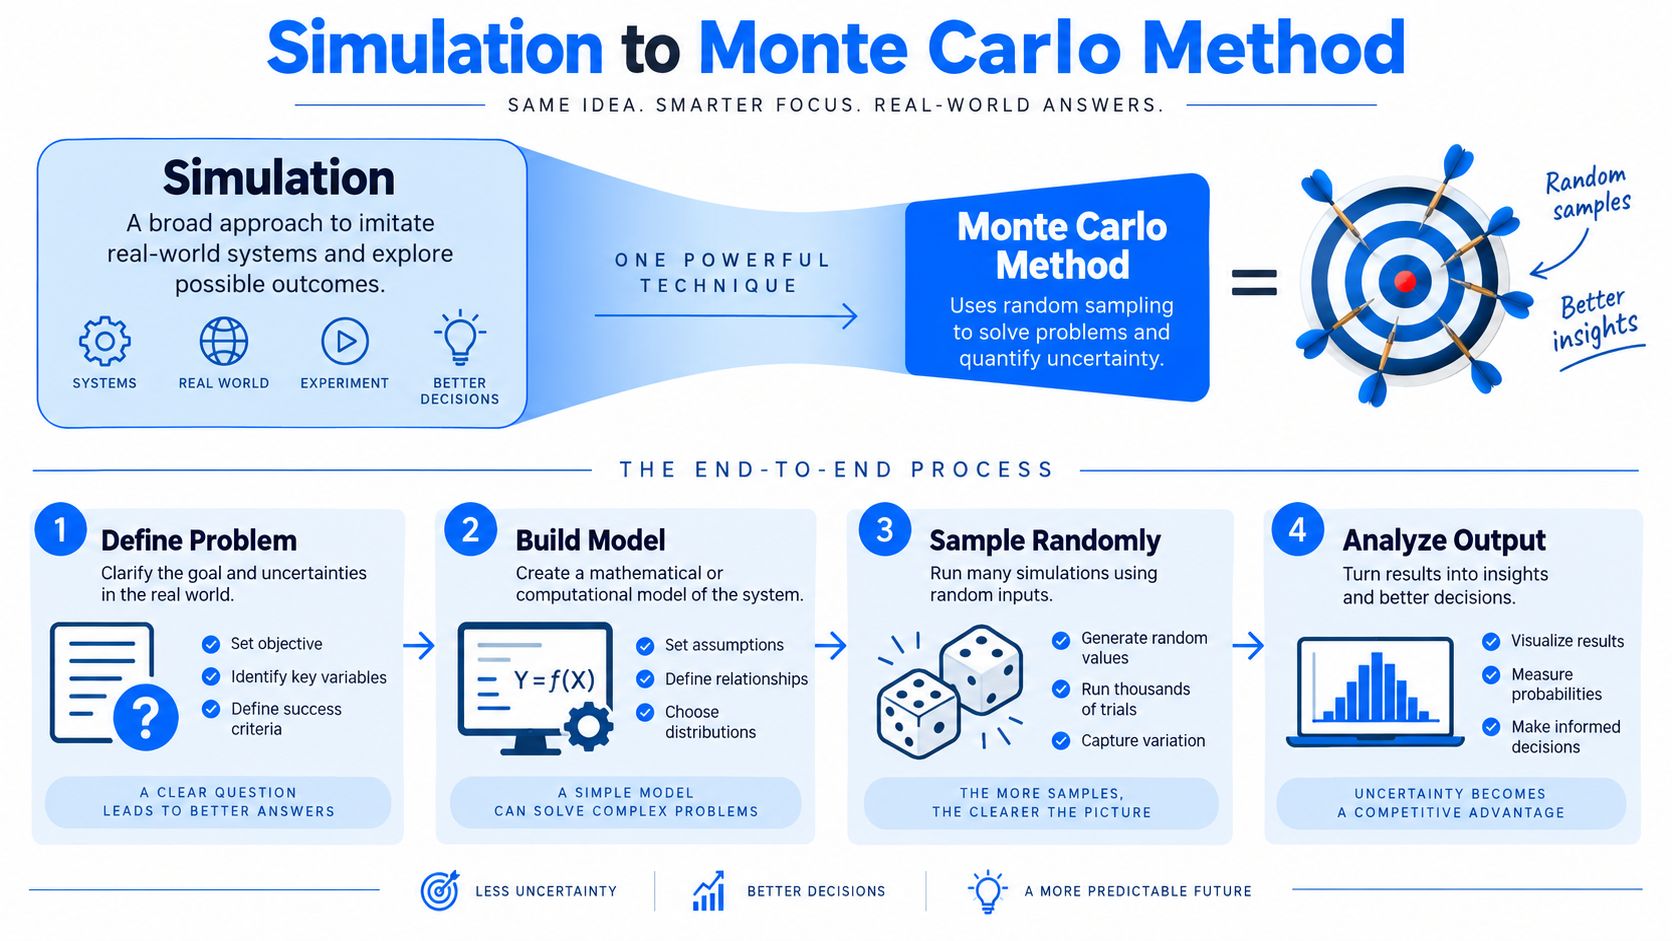
Comprendre la simulation et la méthode de Monte-Carlo
L'analogie de la cible de fléchettes
Associer la boucle à l'observabilité (Observability)
Fondements statistiques clés
Planification des essais à partir d'un intervalle cible
Réduire la variance avec précaution
Mise en œuvre de la méthode de Monte-Carlo
Un modèle d'implémentation compact
Python avec NumPy
R avec les fonctions de base
Des choix d'ingénierie qui comptent
Applications pratiques pour les équipes de données
Des plages de métriques au lieu d'une fausse précision
Stress et sensibilité
Tester les détecteurs d'anomalies (Data Anomalies)
Pièges courants et bonnes pratiques
Reproductibilité et qualité des entrées
Dépendance et convergence
Éviter l'excès de confiance dans la validation
Construire des études de simulation fiables
Pourquoi les équipes de données ont besoin de simulation
Une équipe de plateforme de données prépare une prévision pour le coût du pipeline du trimestre prochain. Le modèle financier a besoin de la charge de travail attendue, mais les entrées ne sont pas fixes. Une API en amont peut arriver tôt ou tard, le comportement des tentatives change sous la charge, et les tables sources peuvent contenir plus de valeurs nulles que ce que l'équipe prévoit. Une seule moyenne pour chaque variable produit un feuille de calcul propre, mais elle ne dit pas grand-chose sur les combinaisons qui poussent la plateforme au-delà de son budget ou de son objectif de service.
Une simulation modifie la question. L'équipe peut générer de nombreuses replays synthétiques, échantillonnant les retards d'arrivée plausibles, les taux de tentatives et les pourcentages de valeurs nulles pour chaque essai. Chaque replay produit un résultat, tel que le temps de traitement, la consommation de calcul, les enregistrements échoués ou le coût estimé. L'ensemble des résultats montre si la décision est stable ou si un léger changement dans les hypothèses crée une traîne significative de mauvais résultats.

Des estimations ponctuelles aux distributions de risques
Un calcul déterministe utilise des entrées fixes et renvoie un résultat unique. Cette approche est utile lorsque les entrées sont connues et stables, mais les décisions d'observabilité (Observability) correspondent rarement à cette description. Un seuil de fraîcheur (Timeliness) peut dépendre d'un comportement d'arrivée variable. Une alerte de volume peut dépendre de la saisonnalité, des chargements retardés et du filtrage en amont. Un contrôle de qualité peut réagir différemment selon que les valeurs manquantes sont aléatoires ou concentrées dans un segment à forte valeur.
La simulation permet aux ingénieurs de faire varier ces entrées ensemble. Vous pouvez ensuite inspecter une médiane, un résultat haut de gamme, une probabilité de défaillance ou la plage dans laquelle se situent la plupart des essais. Le but n'est pas de faire disparaître l'incertitude. C'est de rendre l'incertitude visible avant qu'un tableau de bord, une alerte ou un plan de capacité ne code une hypothèse injustifiée.
Règle pratique : Si une décision dépend d'entrées que vous ne pouvez décrire que sous forme de plages ou de distributions, une estimation unique cache probablement des informations dont vos parties prenantes ont besoin.
Un état d'esprit orienté production
Une étude de simulation utile commence par une décision, pas par un générateur de nombres aléatoires. Définissez le résultat qui compte, identifiez les entrées incertaines, documentez la relation entre ces entrées et conservez les résultats des essais pour examen. Le même cadre peut prendre en charge une prévision de coûts, un test de résistance de pipeline ou une vérification de la pertinence d'un seuil d'anomalie lorsque le trafic change.
Les sections qui suivent transforment cet état d'esprit en un modèle de travail. Vous verrez en quoi l'idée générale de simulation diffère de la méthode de Monte-Carlo, comment la convergence affecte la confiance, comment implémenter la boucle en Python et R, et comment connecter le résultat aux flux de travail d'observabilité (Observability).
Comprendre la simulation et la méthode de Monte-Carlo
La simulation est la pratique globale consistant à imiter un processus réel à l'aide d'un modèle. Un ingénieur de données peut simuler un pipeline en générant des arrivées, en appliquant des transformations, en injectant des pannes et en mesurant le temps d'exécution. Le modèle peut représenter des événements au fil du temps, des dépendances entre services ou l'effet de règles opérationnelles.
La méthode de Monte-Carlo est une famille de techniques qui utilise un échantillonnage aléatoire répété pour estimer un résultat numérique ou une distribution de sortie. Une simulation peut être déterministe, pilotée par des événements ou basée sur des règles. Monte-Carlo ajoute de l'aléatoire aux entrées, au processus, ou aux deux, puis utilise des essais répétés pour approximer ce qu'un calcul direct peut ne pas être en mesure de résoudre commodément.
L'analogie de la cible de fléchettes
Considérez un carré contenant une cible de fléchettes circulaire. Lancez des points aléatoires à travers le carré et enregistrez si chaque point atterrit à l'intérieur du cercle. La fraction de points à l'intérieur du cercle estime l'aire du cercle par rapport au carré, ce qui peut ensuite permettre d'estimer pi lorsque la géométrie est définie de manière appropriée.
Cet exemple est utile car il expose la boucle centrale :
Définir le domaine. Établir le carré et le cercle.
Échantillonner les entrées. Générer des coordonnées aléatoires.
Évaluer le modèle. Vérifier si chaque point tombe à l'intérieur du cercle.
Agrégater les sorties. Convertir le nombre d'impacts en une estimation.
Les fléchettes ne découvrent pas une formule cachée. Elles approximent une réponse par des observations répétées. Plus d'essais rendent généralement l'estimation moins sensible à la séquence aléatoire particulière, bien que la qualité du résultat dépende toujours du modèle et de la conception de l'échantillonnage.
Associer la boucle à l'observabilité (Observability)
Dans une plateforme de données, le carré devient l'espace des conditions de fonctionnement plausibles. Les coordonnées aléatoires deviennent des taux d'arrivée échantillonnés, des temps de traitement, des événements de défaillance ou des schémas de données manquantes. Le test du cercle devient le pipeline, la règle de validation ou le détecteur d'anomalies (Data Anomalies) que vous souhaitez évaluer. Le résultat agrégé peut être un quantile de latence, un taux d'alertes manquées ou la plage d'une métrique métier.
Un essai est une exécution du modèle avec un ensemble d'entrées échantillonnées. Une réplication est une exécution répétée destinée à produire une autre observation comparable, souvent sous les mêmes hypothèses de modèle et d'échantillonnage. Un estimateur est le calcul appliqué aux sorties des essais, tel qu'une moyenne, un quantile ou une fraction dépassant un seuil.
La distribution d'échantillonnage décrit comment cet estimateur varie d'un échantillon répété à l'autre. La convergence signifie que l'estimateur devient suffisamment stable pour la décision que vous prenez. Cela ne signifie pas que le modèle est correct. Une simulation convergée avec de mauvaises hypothèses d'entrée peut produire une réponse précise à une mauvaise question.
Pour un cadre d'observabilité (Observability) pratique, consultez le guide de digna sur les méthodes de Monte-Carlo pour une meilleure observabilité des données (Data Observability). L'habitude d'ingénierie importante consiste à séparer les entrées stochastiques de la logique métier déterministe. Cette séparation permet de remplacer une hypothèse d'entrée, de réexécuter le même modèle et de voir quelles conclusions changent.
Fondements statistiques clés
Les résultats de Monte-Carlo sont des estimations, pas des garanties. Si chaque essai produit un résultat (Y_i), un estimateur simple pour le résultat attendu est la moyenne de l'échantillon :
[
\hat{\mu} = \frac{1}{N}\sum_{i=1}^{N}Y_i
]
Sous des hypothèses appropriées d'indépendance et de variance finie, l'erreur standard de cette estimation est d'environ :
[
SE(\hat{\mu}) = \frac{s}{\sqrt{N}}
]
Ici, (s) est l'écart-type de l'échantillon observé et (N) est le nombre d'essais. La relation est importante sur le plan opérationnel. L'erreur diminue à un taux proportionnel à un divisé par la racine carrée de N, donc quadrupler la taille de l'échantillon réduit de moitié l'erreur standard. Plus d'essais aident, mais ils ne produisent généralement pas de gains linéaires.
Planification des essais à partir d'un intervalle cible
Commencez par un essai pilote et mesurez la variance de sortie. Si vous souhaitez un intervalle de confiance bilatéral de demi-largeur approximative (h) et que vous utilisez une valeur critique normale (z), une formule de planification pratique est :
[
N \approx \left(\frac{z s}{h}\right)^2
]
Cette formule est une approximation et ne remplace pas la vérification de la convergence. Elle est particulièrement utile lorsque l'estimateur est une moyenne et que le résultat se comporte de manière raisonnable. Les quantiles, les probabilités d'événements rares, les résultats à traîne lourde et les échantillons dépendants nécessitent des diagnostics plus prudents car leur incertitude peut être bien plus grande que ce qu'indique un calcul basé sur la moyenne.
Suivez l'estimation de manière cumulative plutôt que de n'inspecter que la valeur finale. Tracez la moyenne mobile ou le quantile cible en fonction du nombre d'essais, et comparez des lots indépendants. Si le résultat varie considérablement lorsqu'un autre lot arrive, la simulation n'est pas prête pour une conclusion opérationnelle ferme.
Une autre préoccupation concerne la taille effective de l'échantillon. Si les essais sont corrélés, la valeur nominale de (N) surestime la quantité d'informations indépendantes. Cela se produit couramment lorsque les ingénieurs réutilisent une trace de série temporelle, transportent un état d'un essai à l'autre ou échantillonnent indépendamment des entrées liées alors que la production montre qu'elles évoluent ensemble.
Réduire la variance avec précaution
Les méthodes de réduction de la variance peuvent améliorer la précision sans simplement exécuter plus d'essais. Elles peuvent également rendre le modèle plus difficile à expliquer, utilisez-les donc lorsque la simulation de base est correcte et que l'incertitude restante mérite d'être optimisée.
Technique | Idée centrale | Meilleur cas d'utilisation | Complexité | Réduction attendue de l'erreur |
|---|---|---|---|---|
Variables antithétiques | Associer un tirage aléatoire à un tirage complémentaire | Modèles lisses où les sorties appariées ont tendance à se compenser | Faible | Dépend de la corrélation négative entre les sorties appariées |
Variables de contrôle | Corriger l'estimation à l'aide d'une quantité connexe au comportement connu | Modèles avec un calcul de référence solide | Moyenne | Dépend de la relation avec le contrôle |
Échantillonnage préférentiel | Échantillonner plus souvent les régions influentes et repondérer les résultats | Événements rares et probabilités de queue | Élevée | Peut être substantielle lorsque la distribution de proposition est bien choisie |
Échantillonnage stratifié | Diviser l'espace d'entrée en groupes et échantillonner chacun délibérément | Populations hétérogènes ou plages d'entrées inégales | Moyenne | Dépend de la variance intra-strate |
Pour un contexte plus large sur le choix des techniques statistiques, utilisez la référence de digna sur les méthodes statistiques pour l'analyse de données. Lors d'une revue de conception, expliquez non seulement pourquoi la variance a diminué, mais aussi quelle hypothèse valide la technique et comment vous avez vérifié la logique de pondération ou d'appariement.
Mise en œuvre de la méthode de Monte-Carlo
Une implémentation répétable sépare le modèle des entrées aléatoires. Cette conception vous permet de tester d'autres distributions sans réécrire la logique du pipeline.
Un modèle d'implémentation compact
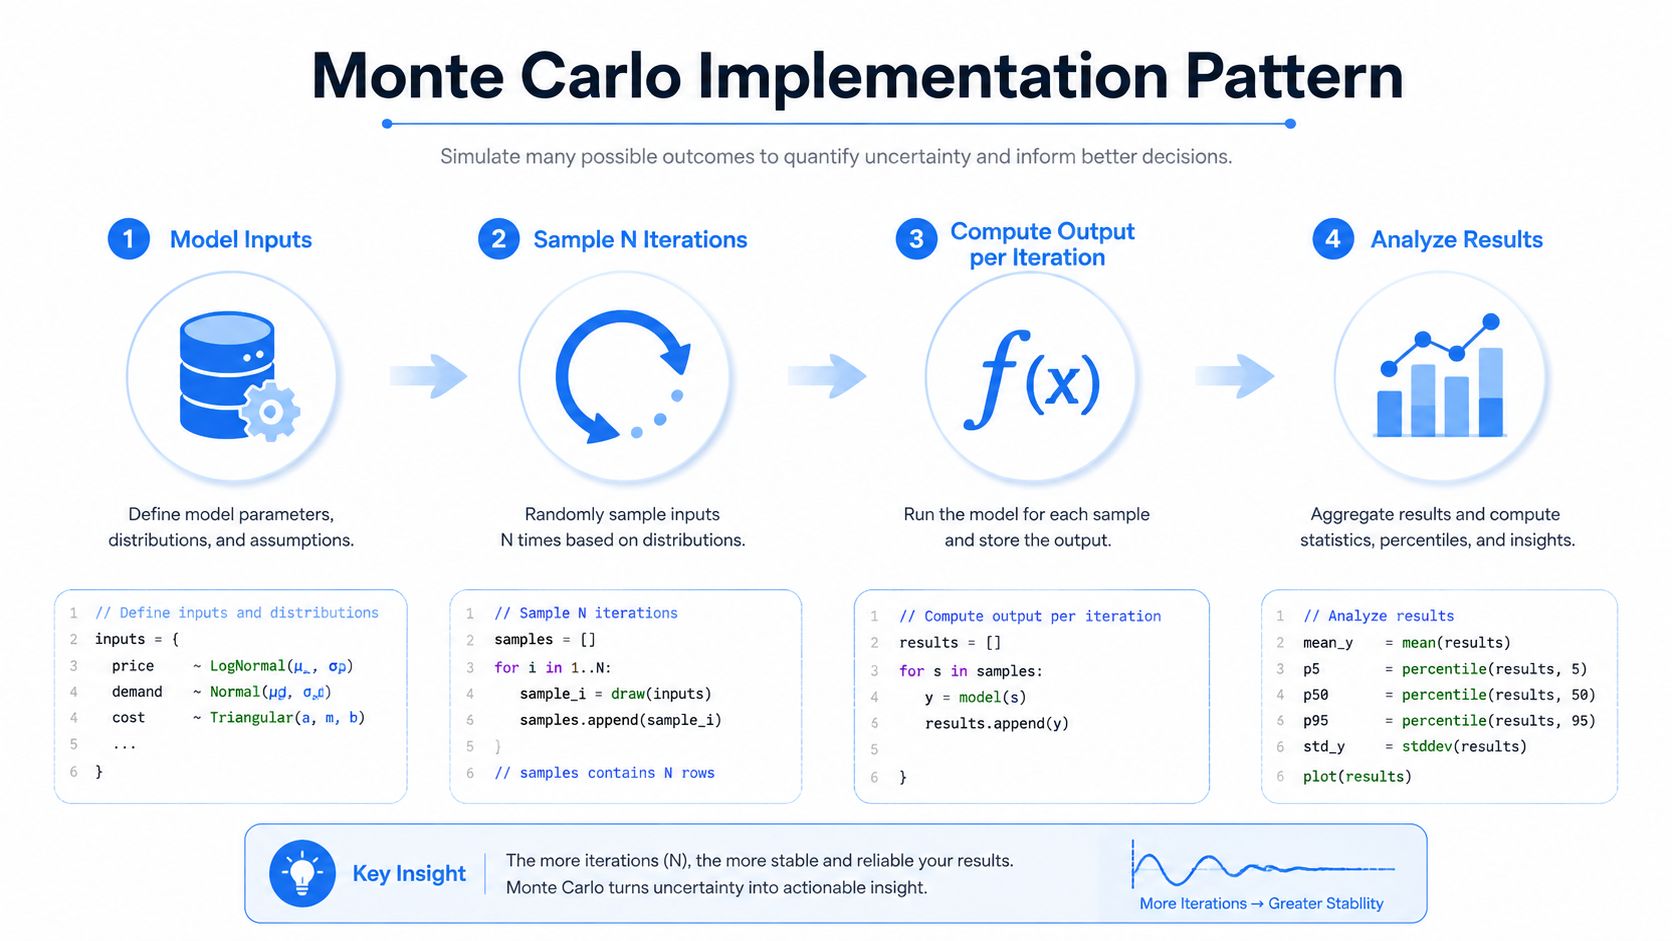
Utilisez ce pseudo-code comme structure de base :
Définir les entrées du modèle et leurs distributions.
Définir une stratégie de graine (seed) et choisir (N) itérations.
Échantillonner les entrées incertaines.
Calculer une sortie pour chaque itération.
Agrégater les sorties des essais.
Rapporter l'estimation et un intervalle d'incertitude.
Enregistrer les sorties brutes et les informations de diagnostic.
Le modèle doit être déterministe une fois ses entrées échantillonnées fournies. Si le calcul de sortie inclut une part d'aléatoire masquée, exposez-la comme un autre flux d'entrée afin de pouvoir la reproduire et l'auditer.
Python avec NumPy
L'exemple suivant estime un quantile de latence de pipeline lorsque le temps de service présente une asymétrie positive (skewed). Une distribution log-normale est une démonstration raisonnable pour des temps de service positifs et asymétriques, mais les paramètres de production doivent provenir de données observées ou d'une hypothèse documentée.
Ce code traite chaque exécution comme un lot synthétique contenant de nombreux temps de service, puis calcule la latence totale par exécution. Le quantile final décrit la distribution de sortie simulée, tandis que l'intervalle montre la plage entre les quantiles de sortie sélectionnés. Ne qualifiez pas cet intervalle d'intervalle de confiance formel sans avoir vérifié l'estimateur et la conception de l'échantillonnage. Pour une étude formelle, estimez l'incertitude autour du quantile lui-même, souvent par lotissement ou rééchantillonnage.
R avec les fonctions de base
La même structure fonctionne en R. rlnorm() génère des valeurs positives et asymétriques, et quantile() résume le vecteur de sortie résultant.
Une graine fixe rend une exécution de développement reproductible, mais une stratégie de graine de production nécessite d'être documentée. Vous pouvez utiliser une graine fixe enregistrée pour l'auditabilité, des graines distinctes pour les processus parallèles ou une graine contrôlée générée par le système d'orchestration. Stockez la graine avec la configuration et la version du modèle.
Des choix d'ingénierie qui comptent
Les opérations vectorisées de NumPy surpassent généralement les boucles au niveau Python pour les charges de travail numériques importantes. Si la matrice est trop grande pour la mémoire, tirez et traitez par lots, en ne conservant que les statistiques ou les sorties brutes requises par votre processus de gouvernance (governance). Conservez l'échantillonneur de distribution, le modèle déterministe, l'estimateur et le code de rapport dans des fonctions distinctes afin que les réviseurs puissent tester chaque couche indépendamment.
Pour les flux de travail d'anomalies basés sur Python, la documentation de digna sur la détection des anomalies de données (Data Anomalies) avec Python fournit un point d'intégration pertinent. Le cadre de simulation peut coexister avec la surveillance plutôt que de la remplacer, générant des scénarios de crise qui vous aident à évaluer le comportement d'un détecteur avant de régler un seuil de production.
Applications pratiques pour les équipes de données
Monte-Carlo devient utile lorsqu'il répond à une décision que votre tableau de bord actuel ne peut pas résoudre. Un tableau de bord peut afficher la fraîcheur (Timeliness), le volume ou la métrique de qualité actuelle. Une simulation peut montrer comment cette métrique se comporte lorsque plusieurs conditions incertaines se produisent simultanément.
Les quatre applications ci-dessous utilisent le même cadre de base, mais chacune nécessite des hypothèses d'entrée différentes et produit un livrable différent pour les parties prenantes.
Cas d'utilisation | Modèle d'entrée | Itérations typiques | Livrable de sortie |
|---|---|---|---|
Plages d'utilisateurs actifs quotidiens | Schémas d'activité historiques, retards de rapport et données manquantes plausibles | Choisies par vérifications de convergence | Graphique de plage avec estimation centrale et limites d'incertitude |
Test de résistance ETL | Variation du taux d'arrivée, temps de traitement et comportement en cas de panne ou de tentative | Choisies pour stabiliser les métriques de traîne | Rapport de capacité et de risque de défaillance |
Sensibilité aux données manquantes | Schémas de lignes manquantes par segment de jeu de données et contribution aux métriques | Choisies pour comparer les scénarios de données manquantes | Tableau de sensibilité des KPI et distribution d'impact |
Validation du seuil d'anomalie | Changements de trafic synthétiques, variation de base et anomalies injectées (Data Anomalies) | Choisies pour comparer les résultats de détection | Revue de précision et de rappel à travers les scénarios |
Des plages de métriques au lieu d'une fausse précision
Supposons qu'un rapport de direction nécessite une plage d'utilisateurs actifs quotidiens. L'équipe peut échantillonner l'activité à partir d'une distribution empirique, puis faire varier les charges retardées et les enregistrements manquants. Le résultat n'est pas un remplacement de la métrique observée. C'est un moyen de montrer à quel point la valeur rapportée pourrait varier sous des conditions de données plausibles.
Le livrable doit énoncer clairement les hypothèses. Les parties prenantes doivent savoir si la plage reflète la variabilité comportementale naturelle, la dégradation du pipeline, les données manquantes, ou les trois à la fois. Si la simulation utilise des tirages indépendants pour des entrées qui évoluent normalement ensemble, la plage peut être trompeusement étroite ou inutilement large.
Stress et sensibilité
Pour les tests de résistance ETL, introduisez de la gigue (jitter) dans les taux d'arrivée et les temps de traitement, puis modélisez les tentatives et les chemins de défaillance. Inspectez non seulement le temps de traitement moyen, mais aussi la queue de distribution, la croissance des files d'attente et le point où les SLA en aval échouent. Un test de résistance est précieux car il révèle des interactions qu'une relecture de journée normale n'exposerait pas.
L'analyse des données manquantes mérite un traitement particulier. La suppression aléatoire de lignes peut sous-estimer les dommages lorsque l'absence de données est concentrée dans un produit, une région, un niveau de client ou une plage horaire. Exécutez des mécanismes d'absence de données distincts et comparez les distributions de KPI de chiffre d'affaires ou de désabonnement qui en résultent. Le livrable publié doit identifier les segments qui guident le changement, et non simplement présenter un ajustement global unique.
Tester les détecteurs d'anomalies (Data Anomalies)
Un détecteur d'anomalies a besoin de plus qu'un seuil qui semble raisonnable sur des données historiques. Générez un trafic synthétique comprenant des variations normales, des arrivées retardées, des changements de volume et des anomalies (Data Anomalies) injectées connues. Mesurez si le détecteur alerte lorsqu'il le doit, reste silencieux lors des variations attendues et reste utile lorsque la référence change.
Monte-Carlo complète l'observabilité (Observability) plutôt que de la remplacer. La surveillance de la production enregistre ce qui s'est passé. La simulation explore ce qui pourrait se passer selon des hypothèses énoncées. Pour un exemple pratique de ce lien, voir repérer les anomalies de données (Data Anomalies) avec les simulations de Monte-Carlo.
Pièges courants et bonnes pratiques
Une simulation peut échouer silencieusement parce que le code s'exécute correctement alors que les hypothèses s'écartent de la production. L'aléatoire ajoute de la flexibilité, mais il multiplie également les manières dont un résultat apparemment rigoureux peut dissimuler une erreur de modélisation.
Reproductibilité et qualité des entrées
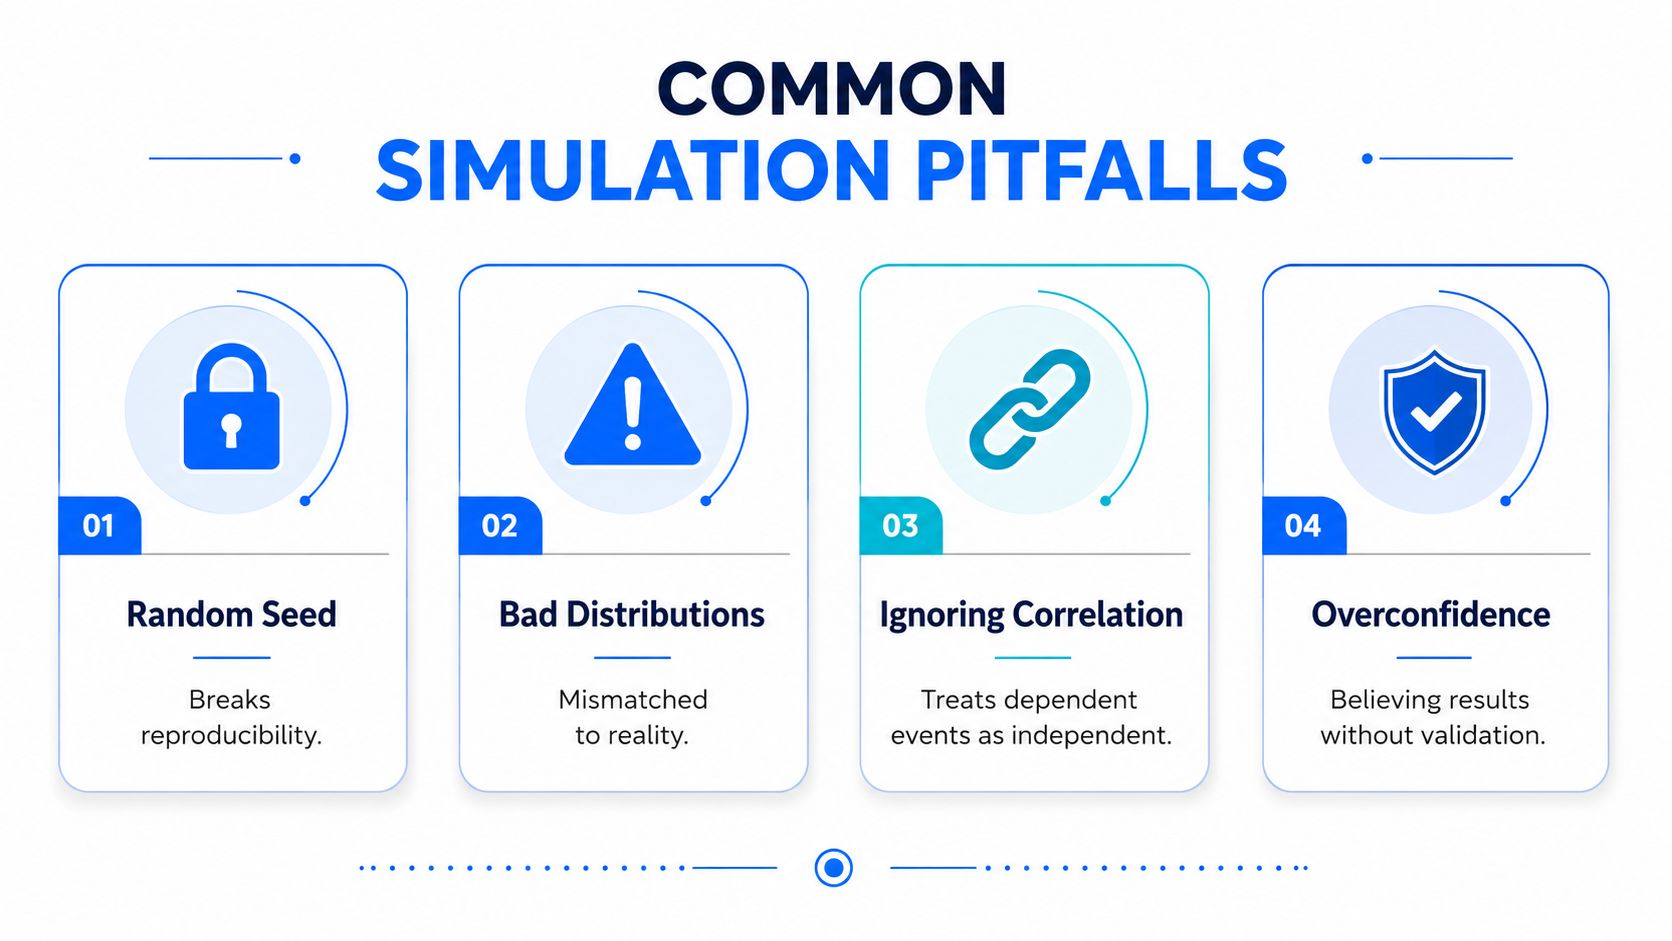
Une graine non divulguée rend un résultat difficile à reproduire. Un réviseur peut réexécuter le même code et obtenir un résultat différent, confondant ainsi une variation d'échantillonnage normale avec un changement de logique. Enregistrez ensemble la graine, le générateur, la version du modèle, la configuration et l'instantané des données d'entrée.
Une distribution doit avoir une justification empirique ou métier. Tracez des histogrammes sources, inspectez l'asymétrie (skew) et les valeurs aberrantes, et comparez les tirages simulés avec les données observées. Une distribution normale peut être pratique, mais la commodité ne la rend pas appropriée pour les arrivées tardives, les temps de service ou les intervalles de défaillance qui présentent une longue traîne à droite.
Règle de validation : Ne décrivez jamais une distribution comme réaliste tant que les tirages simulés n'ont pas été comparés au comportement qu'ils sont censés représenter.
Dépendance et convergence
Les tirages indépendants ne sont pas automatiquement corrects. Le volume d'arrivée et le délai de traitement peuvent augmenter ensemble. Les lignes manquantes peuvent se regrouper lors d'une défaillance spécifique en amont. Si le modèle échantillonne ces variables de manière indépendante, il peut gommer l'événement complexe même que l'équipe souhaite étudier.
Utilisez des diagrammes de dispersion, des analyses de séries temporelles ou un modèle conjoint documenté pour inspecter la dépendance. Pour les simulations en chaîne ou itératives, les graphiques d'autocorrélation peuvent révéler que les échantillons adjacents ne sont pas indépendants. Le diagnostic de Gelman-Rubin peut aider à comparer plusieurs chaînes lorsqu'une méthode basée sur les chaînes est appropriée, mais il ne s'agit pas d'un test de convergence universel pour tous les cadres de Monte-Carlo indépendants.
Un nombre insuffisant d'itérations produit des estimations de traîne instables. Tracez des estimations cumulatives, comparez des lots et planifiez le nombre d'essais autour d'une largeur d'intervalle cible. Présentez des intervalles d'incertitude aux côtés des estimations ponctuelles, en particulier lorsque les parties prenantes pourraient autrement considérer la valeur centrale comme une promesse absolue.
Éviter l'excès de confiance dans la validation
Un détecteur validé uniquement sur les données utilisées pour le régler peut sembler plus performant qu'il ne l'est en réalité. Séparez les données par période ou par condition de fonctionnement, validez sur une période de contrôle exclue et testez des scénarios synthétiques qui n'ont pas servi à sélectionner le seuil. Le but n'est pas de fabriquer un résultat favorable, mais de découvrir où le modèle cesse de soutenir la décision opérationnelle.
Construire des études de simulation fiables
Traitez une étude de simulation comme un produit de données déployable. Avant de vous fier à son résultat, vérifiez que :
La graine est enregistrée : Conservez le générateur aléatoire, la graine, la version du modèle et la configuration.
Les distributions sont justifiées : Stockez les données sources, la méthode d'ajustement ou la justification métier pour chaque entrée incertaine.
La convergence est vérifiée : Comparez les estimations cumulées et les lots par rapport à la précision requise pour la décision.
Une référence existe : Comparez la simulation avec une estimation analytique, une relecture historique ou une référence déterministe si possible.
Les essais bruts sont stockés : Conservez suffisamment de résultats pour reproduire les résumés, analyser les traînes et examiner les scénarios inattendus.
Les entrées sont surveillées : Relancez l'étude lorsque les distributions de données en amont, les modèles de charge de travail ou le comportement du pipeline changent.

Choisissez Monte-Carlo lorsque la distribution d'entrée est connue mais que la distribution de sortie ne l'est pas, lorsque les mathématiques analytiques sont impraticables ou lorsque vous avez besoin d'intervalles de confiance empiriques plutôt que d'une simple estimation ponctuelle. Pour les équipes de production, cette décision s'inscrit aux côtés de pratiques plus larges d'observabilité des données (Data Observability), où le comportement observé peut alimenter les hypothèses et révéler le moment où une simulation ne reflète plus la réalité.
digna offre des capacités d'observabilité des données (Data Observability) modulaires pour les anomalies (Data Anomalies), la fraîcheur (Timeliness), la validation, les modifications de schéma et les métriques métier ou de plateforme au sein de votre propre environnement. Visitez digna pour connecter le comportement observé du pipeline à l'analyse des risques basée sur la simulation et prendre des décisions de fiabilité plus défendables.
Questions fréquentes
Quelle différence entre simulation et méthode de Monte-Carlo ?
La simulation est la pratique large consistant à imiter un processus réel par un modèle. La méthode de Monte-Carlo est une famille de techniques au sein de cette pratique, qui utilise l'échantillonnage aléatoire répété pour estimer un résultat numérique ou une distribution de sortie.
Où la méthode de Monte-Carlo est-elle née ?
À Los Alamos au milieu des années 1940, d'où elle est rapidement passée de la physique de guerre à une technique de calcul générale. Cette origine marque encore son usage : elle a été conçue pour des systèmes rétifs au calcul direct, pas pour des problèmes déjà pourvus de formules nettes.
À quoi ressemble la boucle de simulation ?
Quatre étapes répétées : définir le domaine, échantillonner les entrées, évaluer le modèle et agréger les résultats. L'exemple de la cible met la boucle en évidence parce que la géométrie est évidente alors que le calcul direct ne l'est pas.
Quand une estimation unique masque-t-elle une information nécessaire ?
Dès qu'une décision dépend d'entrées que l'on ne peut décrire que comme des plages ou des distributions. Un calcul déterministe part d'entrées fixes et rend un résultat, tandis que la simulation laisse les ingénieurs faire varier ces entrées ensemble et observer la dispersion des issues.
Comment une étude de simulation doit-elle commencer ?
Par une décision, pas par un générateur de nombres aléatoires. Une posture orientée production part de l'usage prévu du résultat, puis remonte vers les entrées qui méritent une distribution et vers le degré de convergence que la décision exige réellement.


