Qu'est-ce que Parquet : explication du format colonnaire
|
8
minute de lecture

Vous avez probablement déjà rencontré Parquet sans vous en rendre compte. Une requête de tableau de bord s'exécute sur des fichiers stockés dans un stockage objet, le code SQL semble inoffensif, et pourtant, une agrégation en apparence simple passe le plus clair de son temps à lire des données dont la requête n'a jamais besoin. Le même ensemble de données peut fonctionner de manière fluide dans DuckDB ou Spark, puis se comporter différemment dans un autre moteur parce qu'un type logique, une statistique ou une fonctionnalité plus récente n'est pas interprété de la même manière.
Alors, qu'est-ce que Parquet ? Apache Parquet est un format de fichier de données open source orienté colonnes, conçu pour un stockage et une récupération efficaces, en particulier pour les charges de travail analytiques. Ce n'est pas une base de données et il ne remplace pas un format de table tel qu'Iceberg ou Delta Lake. C'est la couche physique de fichiers qui sous-tend de nombreux lacs de données, entrepôts, exports analytiques et pipelines d'apprentissage automatique (machine learning).
Table des matières
Pourquoi Parquet existe et où il s'intègre
Où s'intègre Parquet dans une pile de données moderne
Comment Parquet a vu le jour
Au cœur d'un fichier Parquet
Les groupes de lignes sont les étages
Les blocs de colonnes sont les étagères
Les pages sont la plus petite unité de lecture pratique
Le codage et la compression travaillant ensemble
Aperçu des codages et codecs Parquet courants
Le Predicate Pushdown et pourquoi les requêtes deviennent plus rapides
Ce que vérifie le lecteur
Parquet face aux formats CSV, JSON et ORC
Parquet vs CSV vs JSON vs ORC
Interopérabilité, sécurité et compromis concrets
Le support des moteurs est une question de compatibilité
Les coûts derrière la commodité
Conseils pratiques pour les charges de travail analytiques
Une liste de contrôle pratique pour la disposition
Considérations sur la gouvernance et l'IA
Pourquoi Parquet existe et où il s'intègre
Un analyste exécute :
Sur un grand fichier CSV, le moteur de requête analyse généralement les lignes sur l'ensemble du fichier et inspecte des champs que le calcul n'utilise jamais. Les lectures de stockage et le temps CPU sont consacrés à des colonnes non concernées. Parquet regroupe les valeurs par colonne, permettant ainsi au lecteur de se concentrer uniquement sur region et revenue.
L'idée clé est l'organisation physique. Un fichier orienté lignes conserve ensemble les champs de chaque enregistrement, tandis qu'un fichier en colonnes regroupe les valeurs d'une même colonne. Les colonnes contiennent généralement des types de données similaires et des valeurs répétées, ce qui donne aux méthodes de codage et de compression un schéma plus prévisible. Apache décrit Parquet comme un format de fichier de données open source orienté colonnes pour un stockage et une récupération efficaces dans sa documentation officielle.
Cette conception convient à plusieurs charges de travail courantes :
Lacs de données cloud : Les fichiers dans Amazon S3 et les stockages d'objets similaires peuvent être interrogés sans charger chaque champ dans une base de données.
Tables de faits analytiques : Spark, Trino et Presto peuvent analyser des colonnes sélectionnées à partir de grands ensembles de données d'événements ou de transactions.
Exports opérationnels : Les équipes peuvent extraire les données applicatives et publier une copie analytique sans conserver un format d'échange lourd en texte.
Variables d'apprentissage automatique (ML features) : Les pipelines d'entraînement et les magasins de variables peuvent échanger des fichiers typés et compressés au lieu d'analyser de manière répétée des fichiers CSV ou JSON.
Parquet a également une place spécifique dans l'architecture d'un lac de données. Un lac de données contient des fichiers et des métadonnées. Les formats de table ajoutent des transactions, des instantanés (snapshots), le suivi des partitions et la gestion des schémas. Cette comparaison des lacs de données et des datamarts situe Parquet au sein de cette architecture plus large.
Où s'intègre Parquet dans une pile de données moderne
Couche | Rôle typique | Intégration de Parquet |
|---|---|---|
Systèmes sources | Applications, API et bases de données opérationnelles | Généralement une cible d'exportation, pas le système source |
Ingestion | Déplace et dépose les données brutes ou transformées | Format de dépôt efficace pour les lots analytiques |
Stockage | Stockage objet et fichiers de lac de données | Format de fichier physique de base |
Gestion des tables | Transactions, instantanés et coordination des schémas | Couche physique de fichiers sous des formats tels qu'Iceberg ou Delta Lake |
Moteur de requête | Traitement SQL et dataframes | Lu directement par de nombreux moteurs analytiques |
BI et ML | Tableaux de bord, modèles et pipelines de variables | Format compact d'échange et d'analyse |
Parquet se situe sous les formats de table tels qu'Iceberg et Delta Lake, fournissant la couche de fichiers physiques plutôt que de gérer les transactions ou les instantanés. Cette séparation explique pourquoi un fichier Parquet peut fonctionner avec plusieurs moteurs, tandis que le comportement au niveau de la table dépend toujours des métadonnées environnantes et du système de requête.
Le modèle mental pratique est simple : Parquet rend les analyses de fichiers analytiques sélectives et économiques. Ses avantages dépendent de la façon dont les fichiers sont disposés, de la manière dont les valeurs évoluent à travers le codage et la compression, de la façon dont les filtres parviennent au lecteur, et de la prise en charge cohérente des fonctionnalités pertinentes par le moteur choisi.
Comment Parquet a vu le jour
Parquet est né d'un problème pratique lié à Hadoop : les requêtes analytiques n'avaient souvent besoin que de quelques champs issus d'enregistrements très larges. Twitter et Cloudera l'ont développé en tant que projet open source, influencé par les travaux de Google sur Dremel concernant le traitement en colonnes des données imbriquées. La première version est parue le 13 mars 2013, suivie de Parquet 1.0 en juillet 2013, comme le rapporte l'historique d'Apache Parquet.

L'objectif de conception était la lecture sélective. Si une requête demandait customer_id et revenue à partir d'un large enregistrement d'événement, le lecteur pouvait éviter d'analyser les champs non concernés. L'influence de Dremel a également orienté Parquet vers les données analytiques imbriquées, et pas seulement vers les tables plates de type feuille de calcul.
ORC s'est développé dans l'écosystème Hive autour d'objectifs similaires, offrant aux utilisateurs d'Hadoop une autre alternative sérieuse en colonnes. Le rôle de Parquet a grandi à mesure que de plus en plus d'outils adoptaient des lecteurs et des scripteurs compatibles. Le format a également continué à évoluer. Un exemple est BYTE_STREAM_SPLIT, approuvé dans la ligne de version 2.8.0 en 2019, qui a ajouté une fonctionnalité standardisée plutôt que de laisser le format inchangé.
Le projet est devenu un projet de premier niveau de l'Apache Software Foundation le 27 avril 2015. Cette governance soutient un écosystème comportant de nombreuses implémentations indépendantes au lieu d'un seul lecteur contrôlé par un fournisseur unique. Spark, Trino, Presto, Hive, ClickHouse, DuckDB, Polars, BigQuery, Snowflake, Athena et Redshift font partie des moteurs et services répertoriés dans la documentation de l'écosystème du format. La compatibilité dépend toujours des fonctionnalités implémentées par chaque moteur et de sa gestion des schémas, des codages et des métadonnées.
Cela a de l'importance au moment de l'ingestion. Un pipeline d'ingestion de données peut écrire des lots analytiques au format Parquet, tandis qu'un format de table ajoute des transactions et des instantanés, et qu'un moteur de requête décide comment analyser les fichiers.
Leçon historique : Parquet a réussi en s'adaptant à un modèle d'accès analytique courant, puis en se propageant sur des moteurs capables de lire efficacement les colonnes sélectionnées.
Son histoire explique la répartition des responsabilités : Parquet gère les couches physiques de fichiers, de codage et de compression, tandis que les systèmes environnants assurent la gestion des tables et le comportement des requêtes.
Au cœur d'un fichier Parquet
Une requête n'a besoin que de quelques champs d'une grande table, pourtant un fichier orienté lignes peut l'obliger à lire chaque champ. Parquet évite ce gaspillage grâce à une disposition physique imbriquée. Une analogie utile est celle d'un bâtiment de bibliothèque : le fichier Parquet est le bâtiment, un groupe de lignes est un étage, un bloc de colonnes est une étagère, et une page est une pile de livres sur cette étagère. Chaque niveau a un rôle spécifique.
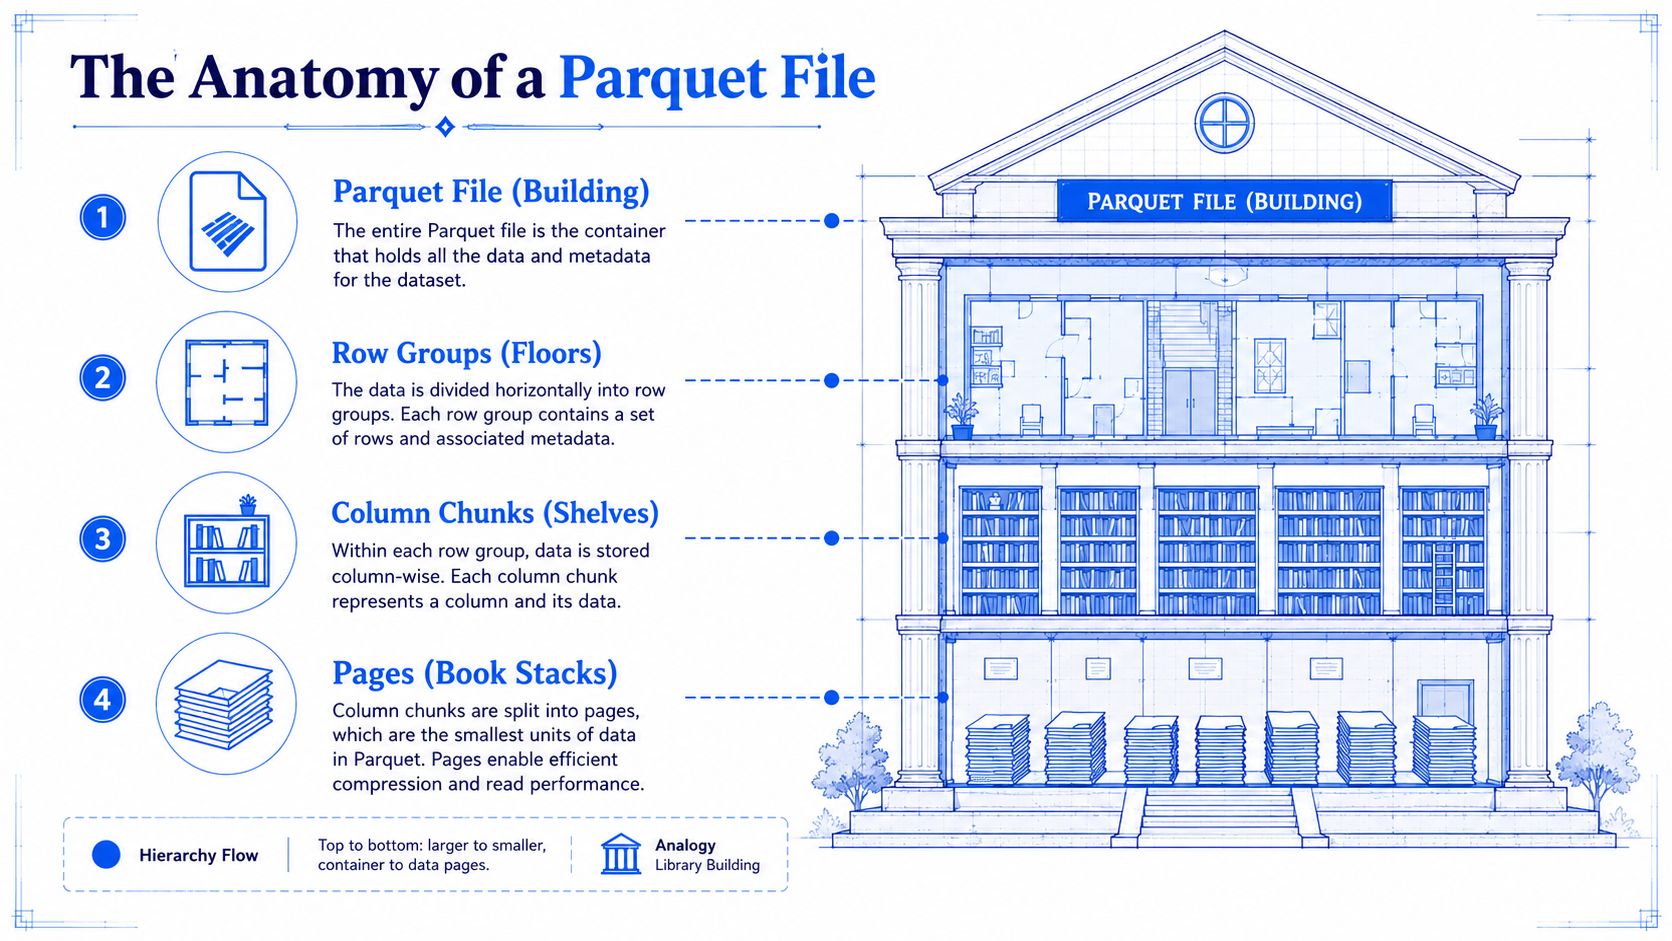
Un fichier Parquet commence par un en-tête magique de 4 octets, PAR1. Ses données sont organisées en groupes de lignes. Chaque groupe de lignes contient exactement un bloc de colonnes par colonne, et chaque bloc de colonnes contient une ou plusieurs pages. Cette hiérarchie offre aux lecteurs la structure nécessaire pour sélectionner des colonnes et ignorer les données non pertinentes, comme décrit dans la documentation sur les concepts de Parquet d'Apache.
Les groupes de lignes sont les étages
Un groupe de lignes contient une tranche horizontale de lignes de table. Pour des colonnes telles que event_date, region et revenue, un groupe de lignes contient une partie de ces trois éléments. Leurs plages de lignes restent alignées, de sorte qu'un moteur peut évaluer les mêmes enregistrements tout en lisant uniquement les colonnes requises par une requête.
Les scripteurs ciblent généralement des groupes de lignes de taille comprise entre 128 Mo et 1 Go. Le réglage approprié dépend du moteur, du système de stockage, de la charge de travail et du nombre de colonnes. Des groupes plus grands peuvent réduire la surcharge de métadonnées, tandis que des groupes plus petits permettent d'ignorer des données de manière plus précise. Considérez le dimensionnement des groupes de lignes comme une décision liée à la charge de travail plutôt que comme une constante universelle.
Les blocs de colonnes sont les étagères
Au sein d'un groupe de lignes, chaque colonne possède son propre bloc de colonnes (column chunk). Le bloc region stocke les valeurs de région codées, tandis que le bloc revenue stocke les valeurs de revenus codées. Une requête qui a besoin de ces champs peut ainsi éviter de lire un bloc customer_notes non concerné.
Le pied de page (footer) enregistre l'emplacement et les métadonnées de chaque bloc. Il décrit également le schéma et les chemins des métadonnées de colonnes, ce qui permet à un lecteur d'interpréter les champs imbriqués et de localiser les octets pertinents sans avoir à analyser le fichier depuis le début.
Les pages sont la plus petite unité de lecture pratique
Les blocs de colonnes sont divisés en pages contenant des valeurs codées et des métadonnées de page. La taille par défaut d'une page est généralement de 1 Mo, bien que les scripteurs et les moteurs puissent choisir d'autres paramètres. Les pages offrent une limite plus fine pour les statistiques, la compression et les lectures sélectives.
Le fichier se termine par un pied de page contenant les informations nécessaires pour décoder les données, suivi d'un marqueur final PAR1. Un lecteur peut se positionner à la fin, lire le pied de page, identifier le schéma et l'emplacement des groupes de lignes, puis émettre des lectures ciblées pour les blocs et pages sélectionnés. Cette structure rend Parquet binaire, auto-descriptif et fractionnable pour le traitement distribué.
Modèle mental du lecteur : Commencer par le pied de page, identifier les groupes de lignes et les colonnes utiles, puis lire les blocs et pages ciblés.
Parquet transporte les informations structurelles nécessaires à sa propre lecture, de sorte qu'un catalogue distinct n'est pas obligatoire. Un catalogue peut néanmoins faciliter la découverte. Une gestion solide des métadonnées est utile à l'échelle de la table, en particulier lorsque de nombreux fichiers et versions de schémas doivent être suivis. La portabilité des fichiers dépend également du fait que les lecteurs prennent en charge les fonctionnalités utilisées par le scripteur, et pas seulement du fait que les deux outils se revendiquent compatibles avec Parquet.
Le codage et la compression travaillant ensemble
Les gens utilisent souvent « codage » et « compression » comme s'ils signifiaient la même chose. Dans Parquet, il s'agit d'étapes distinctes d'un pipeline :
Le codage réorganise les valeurs pour faire apparaître des schémas récurrents.
La compression réduit le flux d'octets qui en résulte.
Prenons l'exemple d'une colonne country contenant des chaînes de caractères répétées. Le codage par dictionnaire (dictionary encoding) peut attribuer à chaque valeur distincte un petit identifiant entier, puis stocker ces identifiants au lieu de répéter les chaînes complètes tout au long de la page. Le codage par plages (run-length encoding) permet de représenter de manière compacte une séquence de valeurs identiques. Le codage delta stocke les différences entre valeurs consécutives, ce qui peut être efficace lorsque les nombres sont ordonnés ou varient progressivement. Le tassement de bits (bit-packing) stocke de petits entiers en utilisant uniquement les bits dont ils ont besoin.
Ces techniques ne conviennent pas toutes à n'importe quelle colonne. Le codage par dictionnaire est naturellement adapté aux valeurs catégorielles répétées, tandis que le codage delta nécessite un schéma de séquence utile. Le scripteur choisit un codage pour la colonne et la page, et les métadonnées enregistrent ce choix.
C'est seulement après cette réorganisation qu'un codec au niveau de la page compresse les octets. La documentation d'Apache décrit des codecs tels que Snappy, GZIP, LZ4 et ZSTD, tandis que PyArrow prend également en charge Brotli et la sortie non compressée dans sa documentation sur la configuration de Parquet. La documentation du format explique que le contenu des pages est compressé tel quel, sans encadrement ou remplissage supplémentaire, ce qui permet de conserver un comportement de décompression simple.
Aperçu des codages et codecs Parquet courants
Technique | Idéal pour | Compromis |
|---|---|---|
Codage par dictionnaire | Chaînes répétées et valeurs catégorielles | Moins utile lorsque les valeurs sont majoritairement distinctes |
Codage par plages (RLE) | Longues suites de valeurs identiques | Performances médiocres lorsque les valeurs changent constamment |
Codage delta | Valeurs numériques ordonnées ou variant progressivement | Dépend de l'ordre et de la forme des données |
Tassement de bits (bit-packing) | Petits entiers et index compacts | Nécessite des plages de valeurs appropriées |
Snappy | Lectures et écritures rapides | Privilégie généralement la vitesse à la réduction maximale de la taille |
ZSTD | Forte réduction de l'espace de stockage | Peut nécessiter plus de ressources CPU que les codecs plus rapides |
GZIP | Compatibilité avec les outils plus anciens | Souvent plus lent pour les charges de travail interactives |
LZ4 | Compression et décompression à faible latence | Le taux de compression dépend des données |
Les paramètres de codage et de codec résident dans différentes parties des métadonnées du fichier. Le choix du codage est associé aux informations de la page et de la colonne, tandis que le codec de compression est enregistré dans les métadonnées de la page concernée. Des scripteurs tels qu'Apache Spark, DuckDB et PyArrow peuvent appliquer des valeurs par défaut différentes, de sorte que deux fichiers Parquet valides peuvent présenter des profils de performance distincts.
Une erreur courante de réglage consiste à sélectionner un niveau de compression agressif sans mesurer la charge de travail. Une fois qu'une colonne a déjà été rendue très régulière par codage, un paramètre plus lent comme ZSTD niveau 19 peut ajouter un coût CPU sans apporter de réduction de taille significative. Le bon choix dépend de la nature du goulot d'étranglement : stockage, transfert réseau, CPU ou latence.
Le Predicate Pushdown et pourquoi les requêtes deviennent plus rapides
Une requête de tableau de bord filtre les ventes de janvier, regroupe les résultats par région et additionne les revenus. Un lecteur Parquet peut y répondre sans décoder la majeure partie du fichier. Ce mécanisme est appelé predicate pushdown (ou filtre poussé), ou plus précisément, filtrage et élagage au niveau de la couche de stockage.
Le moteur vérifie d'abord les valeurs minimales et maximales de event_date enregistrées pour chaque groupe de lignes. Si un groupe de lignes se situe entièrement en dehors du mois de janvier, le lecteur peut l'ignorer sans ouvrir ses pages de données. Pour un groupe de lignes qui chevauche la plage de dates, les statistiques au niveau de la page peuvent éliminer les pages dont les plages ne peuvent toujours pas correspondre.
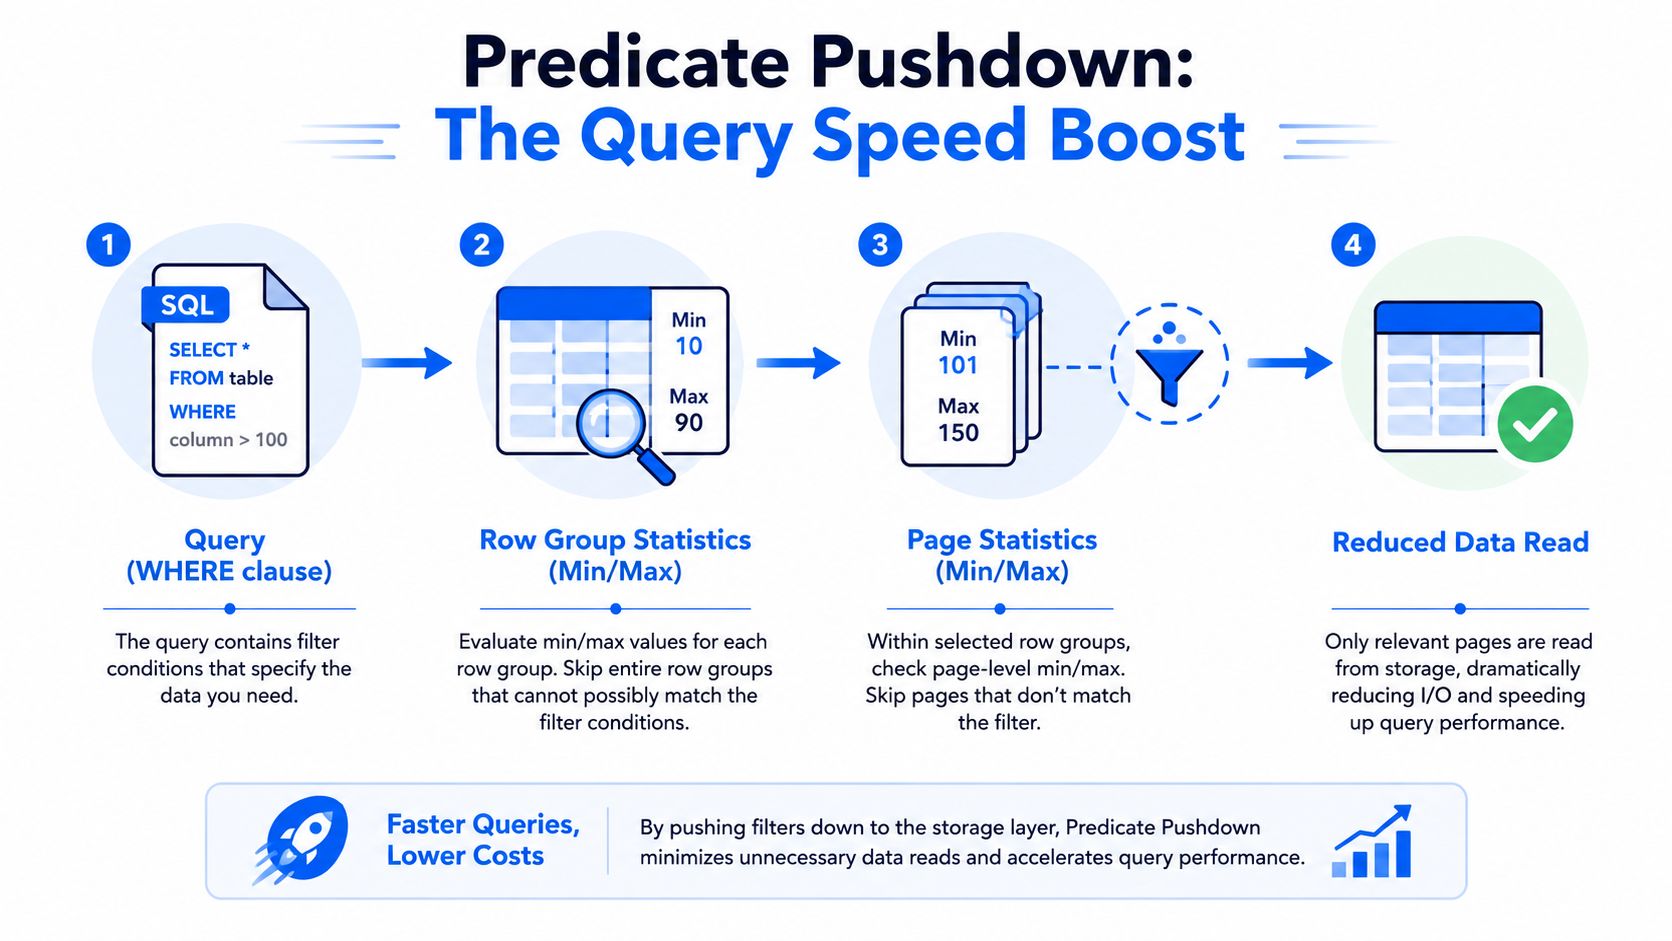
Le lecteur ne demande alors que les pages event_date, region et revenue nécessaires à la requête. Les autres colonnes partagent les mêmes lignes, mais elles n'ont pas besoin d'être décodées. La structure au niveau du fichier et au niveau des colonnes de Parquet fournit la disposition des métadonnées qui rend cet accès sélectif possible.
Ce que vérifie le lecteur
Une séquence d'élagage typique comprend :
Statistiques des groupes de lignes : Comparer le filtre avec la plage enregistrée pour chaque bloc de colonnes.
Statistiques des pages : Inspecter les valeurs minimales et maximales de manière plus précise au sein des groupes de lignes candidats.
Informations du dictionnaire : Résoudre certains filtres catégoriels à partir des valeurs des pages de dictionnaire.
Filtres de Bloom : Vérifier les informations d'appartenance probabiliste lorsque le fichier les contient et que le lecteur les prend en charge.
Sélection de colonnes : Décoder uniquement les colonnes projetées requises pour le résultat.
La disposition des fichiers détermine la quantité de travail que l'élagage permet d'éviter. Si les valeurs sont dispersées sur chaque page, les plages min/max se chevauchent et le moteur a peu de données à ignorer. Le tri par une colonne fréquemment filtrée peut regrouper les valeurs similaires, bien que l'organisation utile dépende du scripteur et de la conception de la table.
Le pushdown est également un comportement du moteur, et non la garantie que chaque prédicat est traité de manière identique. Les lecteurs peuvent limiter l'élagage pour les types imbriqués ou interpréter les types logiques différemment. La prise en charge des dictionnaires et des filtres de Bloom peut également varier. Pour des conseils plus larges sur l'optimisation des requêtes SQL, reliez le comportement de stockage au plan d'exécution de la requête.
La règle opérationnelle est simple : Parquet ne rend pas toutes les requêtes rapides. Il rend les requêtes sélectives moins coûteuses lorsque la disposition des fichiers et les métadonnées permettent l'élagage.
Parquet vs CSV, JSON, and ORC
Le bon format dépend du travail à effectuer. Les formats CSV et JSON fonctionnent bien comme formats d'échange parce que les humains peuvent les inspecter, les applications peuvent les produire facilement et les API les acceptent couramment. Les analyses analytiques répétées révèlent leurs limites : les valeurs sont stockées sous forme de texte et les lecteurs analysent généralement les enregistrements un par un.
Parquet fait un compromis différent. Il stocke des données typées dans une disposition binaire, compressée et orientée colonnes, de sorte qu'un moteur peut lire uniquement les colonnes nécessaires à une requête. Cela en fait un excellent choix par défaut pour le stockage analytique, tout en le rendant peu pratique à ouvrir dans un éditeur de texte ou à envoyer directement à un consommateur qui attend du JSON.
Le pipeline de codage a ici toute son importance. Parquet peut coder ensemble des valeurs similaires, appliquer des techniques de dictionnaire ou de longueur de plage là où c'est approprié, puis compresser les pages résultantes. Les formats CSV et JSON laissent généralement plus d'analyses et d'inférences de type au lecteur. ORC suit un modèle en colonnes similaire et constitue la comparaison la plus proche, en particulier dans les environnements orientés Hive.
Parquet bénéficie d'une prise en charge directe par de nombreux outils, notamment Spark, Trino, Presto, Hive, ClickHouse, DuckDB, Polars, BigQuery, Snowflake, Athena et Redshift, comme décrit dans la documentation du format d'Apache. Ce noyau partagé améliore la portabilité, bien qu'il ne garantisse pas un comportement identique pour chaque type logique, structure imbriquée ou fonctionnalité de métadonnées.
Parquet vs CSV vs JSON vs ORC
Format | Stockage | Vitesse de requête | Évolution du schéma | Idéal pour |
|---|---|---|---|---|
Parquet | Binaire compact et orienté colonnes | Excellent pour les analyses analytiques sélectives | Prend en charge les schémas typés et les modifications structurelles compatibles | Lacs de données modernes et analytique |
CSV | Texte et orienté lignes | Coûteux pour les analyses larges ou répétées | Informel et défini de manière externe | Exports simples et zones de dépôt (landing zones) |
JSON | Texte, imbriqué et flexible | L'analyse syntaxique peut être coûteuse à grande échelle | Flexible mais faiblement contraint | API, événements et échange |
ORC | Binaire compact et orienté colonnes | Excellent, en particulier pour les charges de travail orientées Hive | Prise en charge des schémas typés | Environnements Hadoop centrés sur Hive |
L'évolution du schéma nécessite toujours une coordination. Parquet enregistre les informations de schéma dans chaque fichier, tandis qu'un système de table ou un catalogue réconcilie généralement les versions sur l'ensemble d'une collection de fichiers. L'ajout d'un champ nullable est généralement plus facile que de modifier la signification ou la représentation physique d'un champ existant. Les types logiques peuvent également produire des résultats différents lorsque les lecteurs les prennent en charge de manière inégale.
Utilisez le format CSV ou JSON lorsque des humains, des API ou des outils d'ingestion simples ont besoin du résultat. Choisissez ORC lorsque la compatibilité avec Hive et une pile centrée sur ORC déterminent le format. Choisissez Parquet pour les lacs analytiques modernes et l'échange de données multi-moteurs, puis testez les lecteurs, les scripteurs et les types logiques spécifiques à votre environnement.
Interopérabilité, sécurité et compromis concrets
L'adoption généralisée de Parquet peut donner l'impression trompeuse que chaque moteur lit chaque fichier de la même manière. Spark, DuckDB, Trino, BigQuery, Athena et Polars s'accordent généralement sur la disposition de base, mais ils peuvent diverger sur les types imbriqués, les types logiques tels que UUID et JSON, la précision décimale, les index de page et la signification des statistiques dans le pied de page.
Cela crée un cas d'échec pratique : un scripteur produit un fichier valide, tandis qu'un autre lecteur ne prend pas en charge la fonctionnalité spécifique utilisée. Le fichier peut s'ouvrir avec succès dans un outil et échouer, rétrograder un type ou ignorer une optimisation dans un autre. La page d'état de l'implémentation d'Apache rend cette disparité explicite. Elle montre différents ensembles de fonctionnalités selon les implémentations, avec notamment Parquet Java atteignant la version 1.16.0 en septembre 2025, tandis qu'Arrow Rust, Hyparquet, DuckDB et Polars suivent différentes versions de fonctionnalités.
Le support des moteurs est une question de compatibilité
Moteur | Types imbriqués | Utilisation des statistiques | CVE-2025-30065 corrigée |
|---|---|---|---|
Spark | Large prise en charge, dépend des fonctionnalités | Utilise les statistiques et les chemins d'élagage pris en charge | Vérifier la dépendance Parquet déployée |
DuckDB | Forte prise en charge analytique, dépend des fonctionnalités | Utilise les métadonnées de fichiers prises en charge | Vérifier la version déployée et les dépendances |
Trino | Prise en charge étendue des connecteurs | Le comportement dépend du connecteur et de la version du lecteur | Vérifier la dépendance déployée |
BigQuery | Lit directement Parquet | Comportement géré par le service | Confirmer les directives actuelles du service |
Athena | Lit directement Parquet | Prend en charge les fonctionnalités d'élagage compatibles dans les configurations de table applicables | Confirmer les directives actuelles du service |
Polars | Lit Parquet via son implémentation | La prise en charge des fonctionnalités varie selon la version | Vérifier la dépendance déployée |
La sécurité mérite autant d'attention que l'interopérabilité. En avril 2025, la vulnérabilité critique de désérialisation CVE-2025-30065 a affecté la bibliothèque parquet-java. Les consignes de sécurité ont alerté les équipes afin qu'elles passent à Parquet 1.15.1 et évitent les fichiers non fiables, comme le mentionnent les directives d'implémentation et de sécurité d'Apache.
Cela modifie la réponse à la question « Puis-je lire en toute sécurité n'importe quel fichier Parquet dans n'importe quel outil ? ». Non. Traitez les fichiers provenant de téléchargements non fiables ou de tiers externes comme des entrées hostiles. Appliquez des correctifs à la bibliothèque concernée, isolez les lecteurs lorsque cela est approprié, évitez d'accepter aveuglément les schémas distants et examinez le comportement des métadonnées facultatives et des index de page avant d'activer des fonctionnalités agressives. Un lecteur sandboxé peut réduire la zone d'impact, mais il ne remplace pas la gestion des dépendances.
Les coûts derrière la commodité
Parquet présente également des compromis non liés à la sécurité :
Mises à jour fréquentes : Les fichiers analytiques immuables peuvent créer une amplification de l'écriture lorsque les enregistrements changent souvent.
Petits fichiers : De nombreux petits objets augmentent la surcharge de référencement, d'ouverture et de métadonnées dans le stockage d'objets.
Schémas larges : Les métadonnées de pied de page peuvent croître considérablement lorsque les fichiers contiennent de nombreuses colonnes et groupes de lignes.
Débogage : Les fichiers binaires corrompus sont plus difficiles à inspecter que les CSV mal formés.
Écarts entre moteurs : Une fonctionnalité prise en charge par une implémentation peut être ignorée ou rejetée par une autre.
Les équipes doivent également tenir compte des exigences de résidence des données lors de la sélection des emplacements de stockage, des lecteurs et des chemins de traitement. Parquet améliore les modèles de stockage physique et d'accès, mais il ne résout pas à lui seul les questions de gouvernance, d'isolation ou de contrôle réglementaire.
Conseils pratiques pour les charges de travail analytiques
Une configuration Parquet fiable commence par la disposition des fichiers plutôt que par l'ajustement du codec. Pour de nombreuses charges de travail d'analyse cloud, visez des groupes de lignes d'environ 128 Mo à 256 Mo et des pages proches de 1 Mo, comme indiqué dans ce guide d'optimisation de Parquet. Ce sont des points de départ, pas des garanties. Faites des tests avec le moteur, le stockage d'objets et les formes de requêtes utilisés par votre équipe.
Une liste de contrôle pratique pour la disposition
Choisissez les groupes de lignes délibérément : Équilibrez les lectures ciblées avec la surcharge des métadonnées et le comportement des requêtes de stockage d'objets.
Conservez des pages de taille modérée : Une taille de page proche de 1 Mo est une base de référence raisonnable pour la compression et le filtrage au niveau de la page.
Triez les colonnes de filtrage utiles :
event_timeetuser_idpeuvent en bénéficier lorsque les requêtes filtrent de manière sélective et que les valeurs se regroupent dans les pages.Évitez le tri systématique : Le tri ajoute du travail d'écriture, privilégiez donc les colonnes qui apparaissent dans les prédicats importants.
Partitionnez grossièrement : Les partitions par date ou par catégorie sont souvent plus faciles à gérer que les clés à forte cardinalité qui créent un nombre excessif de répertoires.
Compactez les petits fichiers : Une table comportant de nombreux petits objets Parquet peut présenter des performances médiocres, même si chaque fichier est individuellement bien formé.
La compression doit s'adapter à la charge de travail. Snappy est un choix raisonnable axé sur la vitesse. ZSTD est utile lorsque la réduction du stockage est importante et que la capacité CPU est disponible. GZIP peut rester approprié pour la compatibilité avec les anciens systèmes, mais c'est rarement le premier choix pour les analyses interactives lorsque des codecs plus rapides sont pris en charge.
Parquet n'est pas une bonne solution pour tous les ensembles de données. Une toute petite table de référence de moins de quelques mégaoctets peut être plus facile à distribuer en CSV ou à stocker dans une petite base de données. Le format justifie son utilisation lorsque les analyses analytiques répétées, la sélection de colonnes, la compression et le traitement distribué l'emportent sur le coût des outils binaires et de la gestion des fichiers.
Considérations sur la gouvernance et l'IA
Appliquez les schémas au moment de l'écriture, enregistrez les versions du scripteur et du lecteur, et testez des fichiers représentatifs sur l'ensemble des moteurs utilisés par vos consommateurs. Utilisez Iceberg ou Delta Lake lorsque vous avez besoin de transactions au niveau de la table, d'instantanés et d'une évolution gérée du schéma. Parquet reste une couche d'échange physique utile entre les pipelines d'entraînement et les magasins de variables, mais il ne doit pas être confondu avec un système de gouvernance complet.
Pour les équipes gérant de nombreux ensembles de données Parquet, l'Observability doit couvrir bien plus que la simple existence des fichiers. Surveillez les modifications de schéma, les délais de livraison, la validation des enregistrements et les métriques métier afin qu'un fichier techniquement lisible ne devienne pas analytiquement non fiable. digna offre des fonctionnalités de qualité des données en base de données, de Timeliness, d'anomalies, de validation, de suivi des schémas et d'observabilité de plateforme qui peuvent être appliquées pendant que les données restent dans l'environnement du client.
Règle de travail : Optimisez la disposition des fichiers pour les filtres exécutés par vos utilisateurs, puis validez le résultat dans chaque moteur important.
Si votre lac contient des fichiers Parquet mais que vous ne pouvez pas facilement suivre la dérive des schémas, les arrivées tardives ou les changements de comportement des données, visitez digna pour découvrir comment l'observabilité en base de données peut surveiller ces risques au sein de votre propre environnement. Commencez par le module qui correspond à votre problème de fiabilité immédiat, puis étendez-le à mesure que vos charges de travail d'analyse et d'IA augmentent.
Questions fréquentes
Qu'est-ce que Parquet ?
Un format de fichier en colonnes pour les données analytiques. L'idée clé est l'organisation physique : les valeurs d'une même colonne sont stockées ensemble, si bien qu'un moteur de requête lit uniquement les colonnes touchées par le calcul au lieu d'analyser des lignes entières dans tout le fichier.
Pourquoi Parquet est-il plus rapide que CSV en analytique ?
Grâce à ce qu'il peut éviter de lire. Une moyenne groupée sur un gros CSV oblige le moteur à analyser des lignes et inspecter des champs jamais utilisés par le calcul, tandis que la disposition en colonnes ne lit que les colonnes concernées, et le stockage typé et compressé réduit encore les octets déplacés.
Où Parquet se situe-t-il dans un stack moderne ?
Comme couche physique de fichiers. C'est un format d'atterrissage efficace à l'ingestion, le format de fichier central du stockage objet et la couche sous les formats de table comme Iceberg ou Delta Lake, tout en restant directement lisible par de nombreux moteurs analytiques.
Quelles charges de travail lui conviennent le mieux ?
Quatre reviennent : les lacs de données cloud où l'on interroge des fichiers en stockage objet sans charger chaque champ, les tables de faits analytiques balayées par Spark, Trino ou Presto, les exports opérationnels publiant une copie analytique, et les variables de machine learning échangées en fichiers typés compressés plutôt qu'en CSV ou JSON réanalysés sans cesse.
Parquet est-il un format de système source ?
Non, c'est généralement une cible d'export plutôt que le lieu de naissance des données. Applications, API et bases opérationnelles restent les systèmes sources, et Parquet devient la copie analytique que ces systèmes publient pour les moteurs de requête, la BI et le ML en aval.



