Qu'est-ce que la gestion de la qualité des données et pourquoi est-elle importante
|
8
minute de lecture

Vous connaissez déjà cette sensation. Le tableau de bord semble calme, la direction l'utilise dans ses réunions et personne ne s'est plaint. Puis, un changement de schéma en amont se glisse dans un pipeline de paiements, le chiffre d'affaires dérive, et l'erreur reste là assez longtemps pour influencer les décisions avant que quiconque ne s'en aperçoive. C'est à ce moment-là que la gestion de la qualité des données cesse d'être un exercice théorique pour devenir un système de contrôle.
La gestion de la qualité des données est la pratique continue consistant à s'assurer que les données sont adaptées aux personnes et aux systèmes qui les consomment. En production, cela signifie mesurer, surveiller et corriger les données au fur et à mesure qu'elles se déplacent dans les pipelines, les modèles, les rapports et les flux de travail opérationnels. L'ancien modèle consistant à nettoyer les données de temps en temps n'a jamais tenu la route dans les vraies entreprises, surtout à partir du moment où les données ont commencé à alimenter l'analytique, l'automatisation et les rapports réglementés.
Table des matières
Quand les données de confiance deviennent un risque
Pourquoi l'ancien modèle s'effondre
Les six dimensions de la qualité des données
Ce que chaque dimension permet de détecter
Comment fonctionne réellement la gestion de la qualité des données
Planifier, faire, vérifier, agir en production
Des règles statiques à l'Observability continue
Ce qui change dans la pratique
Choisir la bonne architecture et les bons outils
Choix d'architecture et compromis
Prioriser ce qui compte le plus
Comment cibler le programme
Bâtir votre programme de qualité des données
Une feuille de route pratique pour le déploiement
Quand les données de confiance deviennent un risque
Un directeur financier fait confiance au tableau de bord des revenus. La finance l'utilise depuis des mois, les chiffres concordent la plupart du temps, et le rapport atterrit dans la revue opérationnelle hebdomadaire sans controverse. Puis, un léger changement de schéma en amont survient dans le pipeline de paiements, le travail de transformation s'exécute toujours, aucune alerte ne se déclenche et le tableau de bord reste erroné pendant trois semaines jusqu'à ce qu'une plainte client n'oblige quelqu'un à y regarder de plus près.
Ce genre d'échec est précisément la raison pour laquelle la gestion de la qualité des données existe en tant que discipline, et non comme une simple tâche ménagère. L'évolution historique est importante ici. Le MIT a lancé le programme Total Data Quality Management en 1988, ce qui a contribué à établir une approche basée sur le cycle de vie pour mesurer, améliorer et surveiller en permanence la qualité des données. Des recherches fondamentales résumées par la Harvard Business Review ont également rapporté que seulement 3 % des données des entreprises respectaient les normes de qualité de base, sur la base de 195 mesures portant sur la complétude, l'exactitude, la cohérence et la Timeliness, et que 47 % des enregistrements nouvellement créés contenaient au moins une erreur critique (Integrate.io).
Ces chiffres expliquent le passage du nettoyage à la governance. Le problème n'est pas que les équipes ignorent l'existence de mauvaises données, c'est que les mauvaises données se cachent souvent jusqu'à ce qu'elles se soient déjà propagées en aval. La gestion de la qualité des données moderne doit fonctionner à la vitesse du pipeline, car un enregistrement obsolète, une jointure rompue ou un événement de dérive de schéma peut faire mentir un tableau de bord de confiance sans jamais déclencher un audit par lots traditionnel.
Pourquoi l'ancien modèle s'effondre
L'audit périodique ne fonctionne que lorsque l'entreprise peut tolérer des délais. C'est rarement le cas aujourd'hui. Un flux corrompu peut empoisonner les modèles, les couches de reporting et les contrôles bien avant qu'une revue mensuelle ne le détecte.
Règle pratique : si un ensemble de données peut influencer l'argent, le risque ou les soins aux patients, les contrôles de qualité doivent être intégrés au pipeline, et non dans une revue de feuille de calcul après coup.
La frontière pratique entre les « données propres » et la qualité des données gérée est simple. Le nettoyage est réactif, une fois le problème visible. La gestion est continue, mesurée et liée à des exigences explicites des consommateurs. C'est la différence entre résoudre un problème et prévenir une défaillance silencieuse.
Les Six Dimensions de la Qualité des Données
De nombreuses équipes parlent de la qualité des données comme s'il s'agissait d'un tout unique. Ce n'est pas le cas. Un ensemble de données peut être acceptable pour un cas d'usage et inutile pour un autre, c'est pourquoi la discipline repose sur plusieurs dimensions, et non sur un score unique. Les conseils techniques alignés sur les documents de l'ISO et du NPL traitent l'exactitude, la complétude, la cohérence, la Timeliness, la traçabilité, la disponibilité et la Compliance comme des dimensions distinctes qui doivent être mesurées indépendamment, car un même ensemble de données peut convenir à un flux de travail et être inacceptable pour un autre (NPL guidance).
Pour le travail d'ingénierie quotidien, les six dimensions que la plupart des équipes opérationnalisent sont celles ci-dessous.
Ce que chaque dimension permet de détecter
L'Exactitude consiste à vérifier si les données reflètent la réalité. Si une jointure duplique des lignes, un calcul de la valeur à vie du client peut sembler plausible tout en étant faux. Mesurez-la à l'aide de contrôles d'intégrité référentielle, de rapprochements et de contrôles qui comparent les valeurs attendues aux valeurs observées.
La Complétude concerne les informations manquantes. Des valeurs nulles dans un champ de segmentation peuvent exclure des personnes d'une campagne ou rendre un modèle aveugle à une partie de la population. Les contrôles du taux de valeurs nulles et la validation des champs obligatoires sont les outils de base ici.
La Timeliness indique si les données arrivent au moment où elles sont nécessaires par rapport à l'événement qu'elles décrivent. Un modèle de fraude fonctionnant sur des caractéristiques obsolètes peut prendre une mauvaise décision en toute confiance. Les SLA de fraîcheur, la détection des arrivées tardives et les seuils basés sur l'âge sont les contrôles pratiques.
La Cohérence signifie qu'une même entité ne se contredit pas d'un système à l'autre. Si le CRM et la facturation ne s'accordent pas sur l'adresse d'un client, les flux de travail en aval entreront en conflit. Le rapprochement multi-sources et les règles de standardisation permettent de détecter cela.
La Validité vérifie si les valeurs correspondent au domaine, au format ou à l'ensemble de règles attendus. Après une migration de source, un champ de statut peut commencer à contenir des valeurs en dehors de l'énumération approuvée. Les vérifications de domaine et la validation de format gèrent cela.
L'Unicité concerne les enregistrements en double. Dans le secteur de la santé, les dossiers de patients en double fragmentent les antécédents médicaux et compliquent la coordination des soins. La logique de déduplication, les contrôles de clés uniques et la correspondance d'identités sont les défenses habituelles.
Aperçu des dimensions de la qualité des données | Comment elle est mesurée | Cas d'usage les plus sensibles |
|---|---|---|
Exactitude | Rapprochement, intégrité référentielle, totaux de contrôle | Finance, facturation, rapports de direction |
Complétude | Taux de valeurs nulles, contrôles des champs obligatoires | Segmentation, rapports réglementaires, flux de travail cliniques |
Timeliness | SLA de fraîcheur, seuils d'âge à l'arrivée | Fraude, opérations, analyses en temps réel |
Cohérence | Comparaison multi-sources, règles de standardisation | Données de référence, opérations clients, reporting |
Validité | Contrôles d'énumération, contrôles de plage, contrôles de format | Systèmes opérationnels, Compliance, automatisation |
Unicité | Détection des doublons, correspondance d'identités | Santé, CRM, résolution d'identité |
Si vous souhaitez une analyse plus approfondie du modèle de dimensions, le cadre pratique sur digna's dimensions of data quality mérite d'être comparé à la conception de vos propres contrôles.
L'erreur que je vois le plus souvent est celle d'équipes qui construisent un score global unique et appellent cela de la governance. Cela masque le mode de défaillance qui importe réellement.
La bonne question n'est pas « Les données sont-elles bonnes ? ». La bonne question est « Bonnes pour quoi, et mesurées comment ? »
Comment fonctionne réellement la gestion de la qualité des données
La gestion de la qualité des données fonctionne comme un cycle de vie, non comme une barrière. L'ISO 8000-61:2016 la structure sous la forme d'une boucle Planifier-Faire-Vérifier-Agir : planifier la stratégie, mettre en œuvre les processus, surveiller et mesurer les performances par rapport aux exigences, puis prendre des mesures correctives pour continuer à s'améliorer (ISO 8000-61:2016). Cette structure est importante car elle transforme la qualité en un rythme opérationnel plutôt qu'en un projet ponctuel.
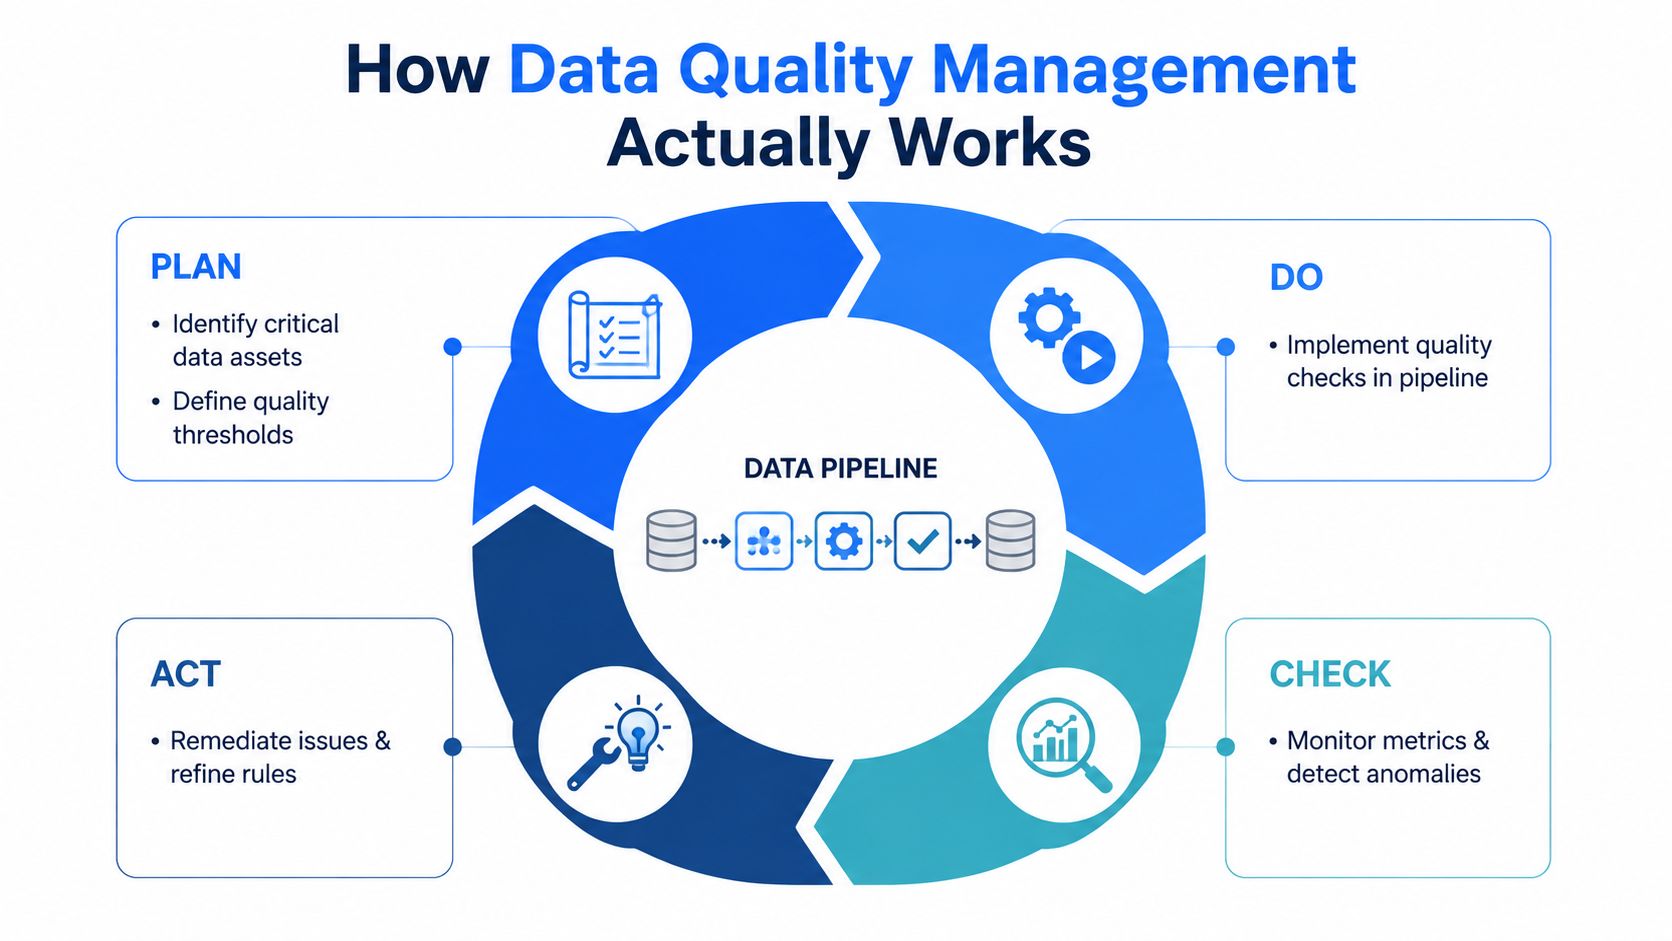
Planifier, faire, vérifier, agir en production
L'étape Planifier commence par l'identification des actifs critiques, la définition des seuils avec les parties prenantes de l'entreprise et l'attribution de la responsabilité. L'ISO 8000-150:2022 met l'accent sur les rôles et les responsabilités, la partie que de nombreuses équipes négligent jusqu'à ce qu'un incident prouve qu'elles ne peuvent pas se le permettre (ISO 8000-150:2022). Quelqu'un doit être responsable de la règle, de l'exception et de la correction.
L'étape Faire est le lieu où réside la validation. Dans les pipelines bien gérés, cela signifie des contrats de schéma, des contrôles de plage, des contrôles de domaine, des contrôles de valeurs nulles et des tests de transformation intégrés directement dans les jobs, et non greffés après coup. Une mise en œuvre pratique peut également suivre data engineering best practices où l'orchestration, le versioning et la testabilité sont intégrés au flux de travail dès le départ.
L'étape Vérifier correspond à la surveillance continue. Les directives de l'ISO et les travaux de mise en œuvre préconisent tous deux de mesurer à intervalles réguliers ou en continu, ce qui est essentiel car de nombreux défauts se manifestent sous forme de dérive, de retard ou de changement structurel avant de devenir des défaillances évidentes (ISO 8000-61:2016, MDPI implementation study). Les alertes doivent classer la gravité, et non pas simplement crier au loup.
L'étape Agir concerne la remédiation. Les enregistrements erronés peuvent être mis en quarantaine, corrigés lorsque c'est possible ou orientés vers un examen manuel, mais l'essentiel est que chaque exception nécessite un parcours documenté et une boucle de rétroaction vers l'ensemble de règles. C'est ainsi que les gestionnaires de données, les ingénieurs et les analystes restent alignés au lieu de se disputer après coup.
Règle opérationnelle : ne construisez pas un programme de qualité qui ne fait que bloquer les pipelines. Construisez-en un qui indique à l'équipe ce qui a échoué, quelle est la gravité et ce qu'il faut faire ensuite.
Le choix de la plateforme compte, mais le modèle opérationnel importe davantage. Un bon système de contrôle détecte le problème tôt, limite la zone d'impact et laisse une piste d'audit.
Des règles statiques à l'Observability continue
Les contrôles de qualité par lots traditionnels détectent les erreurs tardivement. Au moment où une assertion SQL quotidienne échoue, les consommateurs en aval peuvent déjà avoir pris des décisions, entraîné des modèles ou publié des tableaux de bord basés sur de mauvaises données. La couverture récente du domaine souligne une transition vers la validation continue, les contrôles augmentés par l'IA et une governance respectueuse de la vie privée, car le nettoyage statique ne convient pas aux pipelines, aux modèles et aux indicateurs commerciaux en direct (DZone coverage).
Ce changement est visible dans les outils utilisés par les équipes. Au lieu de rédiger manuellement chaque seuil, les couches d'Observability modernes apprennent les bases de référence, surveillent les anomalies et suivent automatiquement les changements de schéma. Elles surveillent également la fraîcheur pour que les flux obsolètes apparaissent comme des problèmes opérationnels plutôt que comme des surprises commerciales.
Ce qui change dans la pratique
Une pile d'Observability pratique couvre généralement trois aspects. Premièrement, la détection d'anomalies recherche les écarts statistiques par rapport au comportement de référence. Deuxièmement, le suivi de schéma détecte les colonnes ajoutées, les colonnes supprimées et les changements de type avant que les consommateurs ne subissent des ruptures. Troisièmement, la surveillance de la Timeliness signale les arrivées tardives ou manquantes afin que le problème soit traité comme un incident, et non comme un mystère.
Le but n'est pas seulement la vitesse. C'est le contexte. Une colonne peut être techniquement présente mais sémantiquement erronée, et une table peut passer un contrôle de validité générique tout en étant trop obsolète pour qu'on puisse lui faire confiance. La couche d'Observability vous donne le signal que l'ancien modèle d'audit n'a jamais pu fournir, en particulier une fois que les données commencent à alimenter des agents IA et des décisions automatisées.
Si vous cartographiez cela vers une suite de produits, la description de l'architecture sur digna's data observability approach est un point de référence utile pour comprendre comment les contrôles continus s'intègrent dans une surveillance plus large.
L'Observability continue ne remplace pas les règles, elle rend les règles viables au rythme de la production.
Une détection plus précoce est une victoire. Au lieu de découvrir un mauvais chargement après les plaintes des métiers, l'équipe voit le problème presque au moment où il apparaît et peut réagir tant que la zone d'impact est encore restreinte.

Choisir la bonne architecture et les bons outils
Une suite de gestion de la qualité des données médiocre échoue généralement de l'une de ces deux manières. Soit les contrôles se situent trop loin des données et introduisent de la latence, soit ils vivent si près des systèmes de production qu'ils créent une surcharge opérationnelle. L'exécution en base de données maintient la validation à proximité du warehouse ou du lakehouse, ce qui réduit les transferts et convient aux environnements sensibles à la sécurité, mais peut augmenter l'utilisation des ressources de calcul. Les plateformes d'Observability cloud-natives centralisent la surveillance et la détection gérée, mais elles peuvent soulever des inquiétudes concernant la localisation et la confidentialité des données si de mauvaises données quittent le périmètre.
Choix d'architecture et compromis
Compromis de l'architecture de qualité des données | Idéal pour | Principaux compromis | Considérations de confidentialité |
|---|---|---|---|
Exécution en base de données | Warehouses, lakehouses, pipelines réglementés | Faible transfert, intégration plus étroite, augmentation possible des coûts de calcul | Parfaitement adapté lorsque les données doivent rester dans des systèmes contrôlés par le client |
Observability cloud-native | Équipes souhaitant une surveillance gérée et des tableaux de bord partagés | Configuration rapide, vue centralisée, préoccupations possibles concernant la localisation des données | Nécessite un examen attentif concernant les données personnelles (PII), la juridiction et l'accès des fournisseurs |
Frameworks personnalisés | Exigences de contrôle hautement spécialisées | Flexibilité maximale, maintenance technique plus élevée | Peuvent être conçus pour un isolement strict, mais la charge de la maintenance reste en interne |
Architectures hybrides | Environnements à maturité mixte | Équilibre entre rapidité et contrôle, travail d'intégration plus important | Utile lorsque les contrôles sensibles restent locaux tandis que les métadonnées sont centralisées |
La bonne architecture dépend de la réglementation, de l'échelle et de la maturité opérationnelle. Les équipes des secteurs de la finance, de la santé, des télécoms et du secteur public ont généralement besoin d'un contrôle plus étroit sur l'endroit où s'exécute la validation, sur les personnes autorisées à voir les résultats et sur la manière dont les exceptions sont documentées. Pour les équipes qui souhaitent ce contrôle au sein de leur propre environnement, an overview of data system architecture trade-offs aide à définir où la validation, la détection d'anomalies, la surveillance de la Timeliness et le suivi de schéma doivent s'exécuter.
Le choix d'une plateforme doit être évalué comme une couche de contrôle, et pas seulement comme l'achat d'un outil. Si l'équipe doit encore exporter des données pour les inspecter, une partie de la valeur est perdue. Si la plateforme ne s'intègre pas aux flux d'orchestration, de métadonnées et d'incidents, elle se transforme en un énième tableau de bord auquel les gens finissent par ne plus faire confiance. Le test pratique est simple : les contrôles s'intègrent-ils au pipeline sans imposer de transferts supplémentaires, de copies superflues ou de révisions manuelles additionnelles ?
Prioritiser ce qui compte le plus
Vouloir surveiller toutes les tables de la même manière est le meilleur moyen de tuer un programme de qualité. La fatigue des alertes s'installe, les ingénieurs coupent les notifications et l'équipe cesse de croire au système au moment où cela compte le plus. La meilleure approche consiste à prioriser par criticité métier, car la table qui alimente le reporting de la direction, les entrées de modèles ou les déclarations réglementaires mérite un niveau d'exigence différent d'un jeu de données de staging à faible enjeu.
Les enquêtes mettent en évidence un problème connexe : les équipes savent souvent que la qualité est importante, mais elles ne savent pas toujours comment bien tester les données. Cela rend la priorisation encore plus cruciale, car elle impose de décider quels contrôles importent, où doivent se situer les seuils et quel niveau de faux positifs est acceptable (enquête de référence Synq).
Comment cibler le programme
Commencez par cartographier le lignage afin de connaître la zone d'impact de chaque actif. Une seule source défaillante peut affecter un tableau de bord, une prévision et un flux de Compliance, mais l'urgence de la remédiation ne sera pas identique pour les trois. L'objectif est de classer le jeu de données selon son impact en aval avant de décider ce qu'il faut surveiller.
La vision de planification interne sur les critical data elements constitue un cadre utile pour ce type de tri.
Données de revenus et de risques : Placez des contrôles en temps réel ou quasi-réel sur les champs qui affectent les mouvements d'argent, l'exposition ou les preuves réglementaires.
Entrées de modèles : Surveillez en priorité la fraîcheur, la dérive de schéma et les valeurs manquantes, car des entrées obsolètes ou mal formées brisent rapidement la confiance dans le modèle.
Jeux de données opérationnels : Utilisez des seuils qui reflètent la tolérance de l'entreprise, et non une pureté théorique.
Tables analytiques à faible impact : Acceptez une surveillance plus légère si le coût d'une défaillance en aval est faible.
Si tout est critique, rien ne l'est.
C'est l'argument du ROI pratique. Un programme ciblé consacre l'attention des ingénieurs là où le coût d'une défaillance est le plus élevé, et laisse les tables de faible valeur sous une surveillance plus légère sans prétendre que c'est une faiblesse. La governance se renforce car elle cesse de vouloir être universelle.
Bâtir votre programme de qualité des données
Un programme qui survit à la confrontation avec la production nécessite des étapes. La première étape est l'inventaire des actifs et les SLA de base. La deuxième est la validation automatisée aux limites d'ingestion et de transformation. La troisième est la détection d'anomalies, la surveillance de la fraîcheur et le rapprochement multi-sources. La quatrième est la réponse aux incidents, l'escalade et l'amélioration continue.
Le guide de mise en œuvre sur digna's data quality team s'adapte à cette approche par étapes car le modèle de l'équipe compte tout autant que les règles elles-mêmes. Sans attribution claire des responsabilités, les exceptions s'éternisent et les mêmes erreurs réapparaissent sous de nouveaux noms.
Une feuille de route pratique pour le déploiement
Commencez par les actifs qui présentent le risque commercial le plus élevé. Définissez ce que signifie « bon » avec les métiers, pas seulement avec l'ingénierie, et consignez les seuils par écrit. Si les parties prenantes ne parviennent pas à s'accorder sur le SLA, le programme n'a pas un problème de qualité, il a un problème d'exigences.
Ensuite, ajoutez des contrôles là où les données entrent ou changent de forme. Les vérifications de schéma, les seuils de valeurs nulles et les tests d'intégrité référentielle constituent la première couche car ils détectent les ruptures de pipeline les plus courantes sans rendre le système fragile. Après cela, introduisez la détection d'anomalies et les contrôles de Timeliness afin que le programme puisse détecter les dérives, et pas seulement les violations évidentes de règles.
La gestion des incidents doit être sans surprise, et c'est un compliment. Les alertes ont besoin d'être acheminées, les responsables ont besoin de procédures opérationnelles (runbooks) et les violations ont besoin de voies d'escalade. L'objectif n'est pas de créer plus de tickets, mais de raccourcir le délai entre la détection et la correction.
Le succès doit être visible dans les opérations, pas dans des slogans. Suivez le délai moyen de détection, le délai moyen de résolution, la part des actifs critiques sous surveillance active et la réduction des incidents en aval. Ces signaux vous indiquent si le programme améliore le contrôle ou s'il génère simplement du bruit.
Les sponsors exécutifs écoutent lorsque vous associez la qualité à moins de cycles de retravail, à un entraînement plus rapide des modèles et à moins de constatations de non-conformité. Ils arrêtent d'écouter lorsque la conversation reste abstraite.
Un bon programme rend la qualité mesurable, attribuable et reproductible. C'est la différence entre une simple fonctionnalité de plateforme et une discipline d'entreprise.
Si vous mettez sur pied ou remplacez un programme de qualité des données, digna peut vous aider à surveiller les jeux de données critiques au sein de votre propre environnement grâce à la validation, la détection d'anomalies, les contrôles de Timeliness et le suivi de schéma dans une seule couche opérationnelle. Visitez digna pour voir comment les contrôles continus peuvent s'intégrer à vos pipelines, à votre modèle de governance et aux systèmes d'entreprise qui dépendent de données de confiance.


