L'outil de qualité des données sur site expliqué aux équipes d'entreprise
|
8
minute de lecture

Un tableau de bord peut être vert alors que les données sous-jacentes sont déjà erronées. Un chargement planifié arrive en retard, un système source ajoute une colonne, ou la distribution de la clientèle change sans déclencher de défaillance du pipeline. Les rapports continuent de s'actualiser, les tâches s'affichent toujours comme réussies, et l'entreprise ne découvre le problème que lorsqu'un analyste s'interroge sur un résultat inattendu.
Ce modèle de défaillance est courant dans les grands patrimoines de données car celles-ci traversent désormais des entrepôts, des data lakes, des bases de données existantes, des réseaux privés et des services cloud. Un contrôle de qualité qui ne surveille qu'une seule plateforme peut manquer le point d'entrée d'un changement dans le patrimoine. Un guide d'entreprise expliquant pourquoi les problèmes de données continuent de créer des conflits clarifie le problème global, mais la question du déploiement reste pratique : où la surveillance doit-elle s'exécuter, et comment doit-elle fonctionner à travers les limites de confiance ?
Un outil de qualité des données sur site (on-prem) est donc bien plus qu'un simple choix d'hébergement. Il peut définir un modèle opérationnel dans lequel les contrôles s'exécutent au plus près des données sensibles, les équipes conservent le contrôle de l'infrastructure, et les ingénieurs bénéficient toujours d'une vue unifiée sur des systèmes distribués. Une évaluation correcte commence par la détection des défaillances, puis passe par la sécurité, l'intégration hybride, la responsabilité opérationnelle et le coût total de possession.
À la fin, vous serez en mesure de décider si l'exécution sur site convient à votre patrimoine, quelles fonctionnalités méritent d'être testées lors d'un projet pilote, comment comparer ce modèle avec le SaaS, et comment bâtir un dossier de ROI incluant à la fois le travail de retouche évité et les responsabilités dont votre équipe héritera.
Table des matières
Introduction : Pourquoi la qualité des données échoue silencieusement au sein de l'entreprise
Ce qu'est réellement un outil de qualité des données on-prem
Comparatif des outils de qualité des données On-Prem vs SaaS
Fonctionnalités essentielles que tout outil on-prem devrait inclure
Sécurité du déploiement et modèle opérationnel pour les patrimoines hybrides
Comment évaluer et choisir le bon outil de qualité des données on-prem
h2 id="51">Introduction : Pourquoi la qualité des données échoue silencieusement au sein de l'entreprise
Un ingénieur de plateforme de données remarque que le pipeline de nuit s'est terminé avec succès. La tâche de l'entrepôt ne présente aucun état d'erreur, l'actualisation du tableau de bord est terminée et le service BI est disponible. Plus tard, un responsable de la gouvernance constate que le dernier rapport utilise un chargement incomplet, tandis qu'un ingénieur analytique découvre qu'une colonne source a changé de type et a altéré le comportement en aval.
Aucun de ces événements ne produit nécessairement une panne technique critique. Un fichier en retard peut contenir des enregistrements valides. Une table peut rester interrogeable après la modification de sa distribution. Une modification de schéma peut passer par l'étape d'intégration tout en brisant des hypothèses dans une transformation ou un modèle. La réussite opérationnelle et la qualité des données sont deux signaux distincts.
Cette distinction importe le plus dans les patrimoines où les systèmes sensibles restent sur site tandis que les charges de travail analytiques et d'IA s'exécutent dans des environnements cloud privés ou publics. Les secteurs réglementés tels que le secteur public, les services financiers et la santé ont souvent besoin de la résidence des données, de contrôles de sécurité stricts ou d'une compatibilité avec les systèmes existants. Une estimation du marché évalue les déploiements sur site à 37,5 % du marché mondial de la qualité des données en 2025, soit environ 1,8 milliard de dollars, avec une croissance projetée inférieure à celle du cloud, à un TCAC de 13,8 % jusqu'en 2034 (estimation du marché de la qualité des données par MarketIntelo). La base installée ne disparaît pas au motif que les plateformes cloud se développent.
Règle pratique : Traitez la qualité des données comme un problème de surveillance à l'échelle du patrimoine, et non comme un test rattaché à un seul pipeline.
Une approche sur site devient utile lorsque la couche de surveillance doit respecter l'emplacement des données. Au lieu de copier des enregistrements sensibles dans un service externe, la plateforme peut calculer des métriques au sein de l'infrastructure contrôlée par le client et publier des métadonnées, des incidents et des tendances gouvernés aux personnes qui en ont besoin.
Ce guide construit la décision de manière progressive. Il commence par le modèle d'exécution, compare les compromis entre sur site et SaaS, identifie les fonctionnalités qui capturent les différents modes de défaillance, puis examine la sécurité hybride, l'impact sectoriel et le coût. La décision finale ne consiste pas à savoir « quel produit possède la plus longue liste de fonctionnalités ? », mais plutôt à déterminer si le modèle opérationnel peut détecter les changements importants, préserver les limites de confiance, soutenir une résolution responsable et rester économiquement viable pour votre équipe plateforme.
Ce qu'est réellement un outil de qualité des données on-prem
Pensez à un centre de distribution qui gère des produits sensibles. L'inspecteur qualité peut examiner chaque expédition à l'intérieur de l'entrepôt, enregistrer les mesures et signaler si les marchandises répondent aux exigences. L'inspecteur n'a pas besoin d'expédier chaque article à une installation tierce uniquement pour calculer un score de qualité.
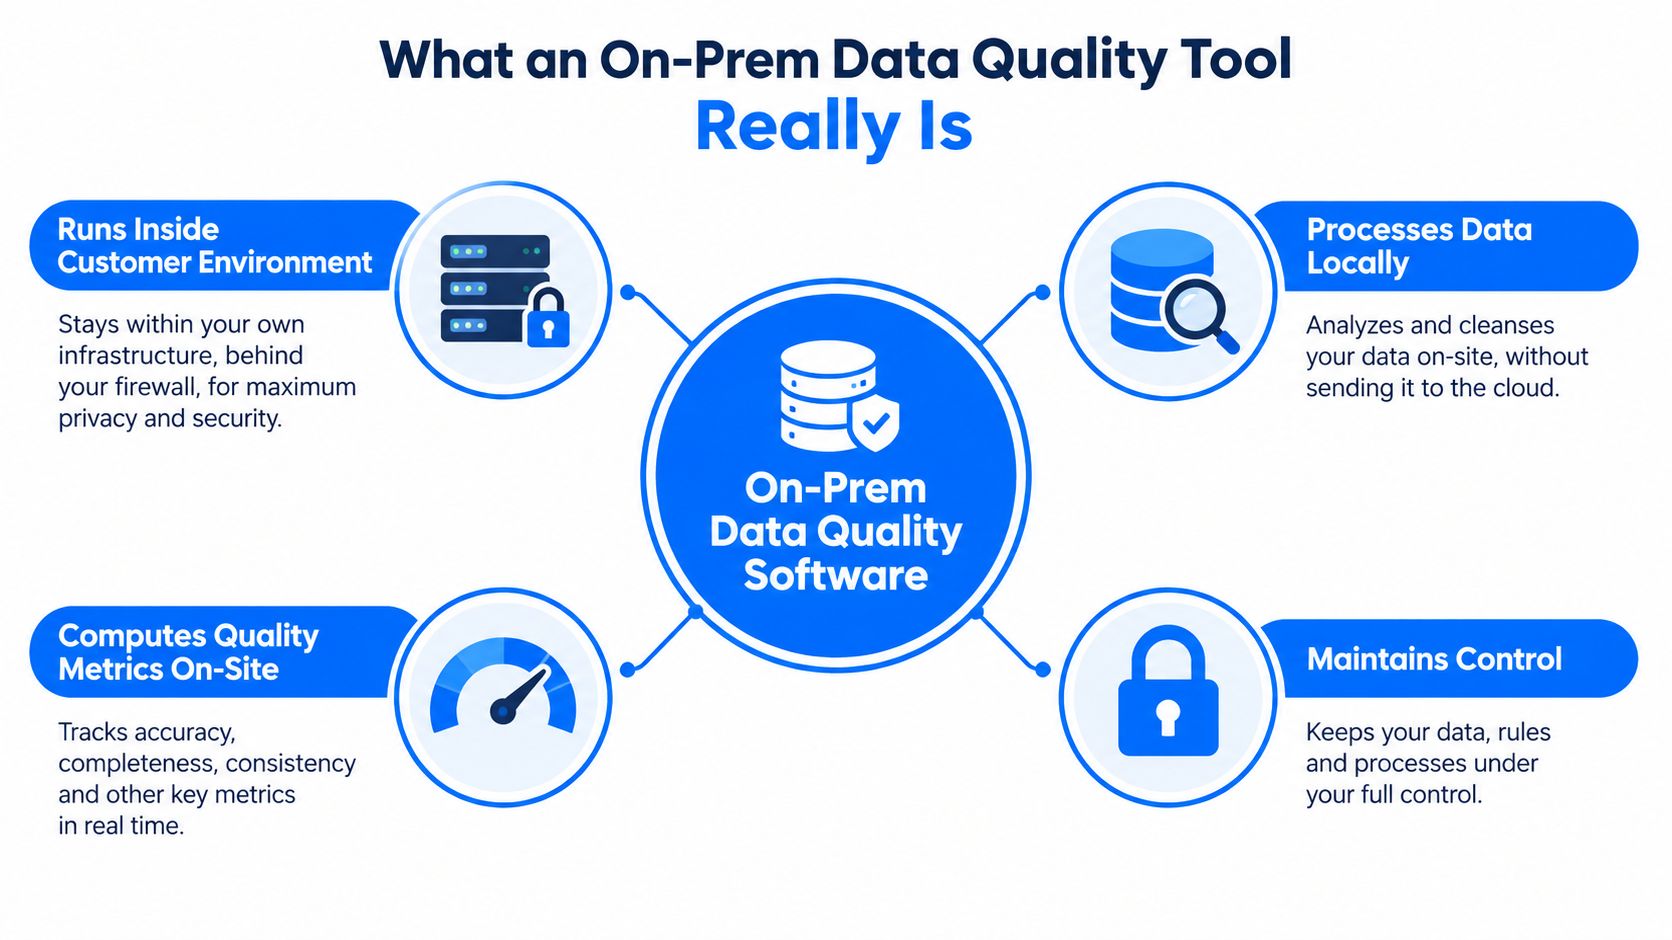
Un outil de qualité des données on-prem suit le même principe. Le logiciel s'exécute au sein du propre centre de données du client, de son cloud privé, de son VPC ou de son infrastructure contrôlée. Il se connecte aux bases de données et aux plateformes où résident déjà les enregistrements, y calcule les métriques de qualité et envoie les résultats autorisés vers une interface partagée destinée aux ingénieurs, aux analystes et aux parties prenantes.
Commencer par l'endroit où le calcul a lieu
La distinction importante ne réside pas dans l'endroit où l'interface utilisateur est hébergée. Demandez plutôt où la plateforme lit les enregistrements et effectue l'analyse. L'exécution en base de données signifie que l'outil calcule les contrôles au sein de l'environnement de base de données du client, réduisant ainsi les mouvements de données et conservant les enregistrements sensibles en place. Cela peut également prendre en charge un calcul de métriques à plus faible latence, car l'analyse se fait là où les données résident déjà, comme décrit dans les recommandations de digna sur la qualité des données en base de données.
Cette conception modifie le débat sur la sécurité. Une équipe de sécurité peut examiner les autorisations de la base de données, les chemins réseau, les contrôles d'identité et les journaux d'audit au sein des processus d'entreprise établis. La plateforme de qualité des données devient une charge de travail gouvernée supplémentaire plutôt qu'une nouvelle voie d'exportation des données de production.
Séparer le déploiement de la collaboration
L'approche sur site ne signifie pas que des équipes isolées doivent travailler sans vision commune. Une plateforme utile fournit toujours des tableaux de bord pour l'état des incidents, l'historique des métriques, les résultats des règles, les changements de schéma et la propriété. La couche d'exécution peut rester proche de chaque source de données tandis que la couche de présentation offre aux différents utilisateurs une vision opérationnelle cohérente.
Par exemple, un ingénieur peut enquêter sur une requête de validation ayant échoué, un analyste peut examiner un changement de distribution, et un responsable de la gouvernance peut avoir besoin de preuves qu'une règle métier a été surveillée. Ils examinent des conséquences différentes d'un même état sous-jacent des données.
Comprendre la limite de gouvernance
Les outils SaaS centralisent généralement la surveillance dans un environnement géré par le fournisseur. Une plateforme sur site place au contraire davantage de contrôle entre les mains du client, y compris le déploiement, l'accès, les mises à niveau, la disponibilité et l'intégration. Ce contrôle peut répondre aux exigences de résidence, mais il engendre également du travail opérationnel.
La bonne question n'est donc pas de savoir si le sur site est automatiquement plus sécurisé. Il s'agit de savoir si votre organisation peut exploiter la couche de surveillance selon ses propres normes de sécurité et de plateforme tout en préservant une vue unifiée sur les environnements cloud et hérités.
Comparatif des outils de qualité des données On-Prem vs SaaS
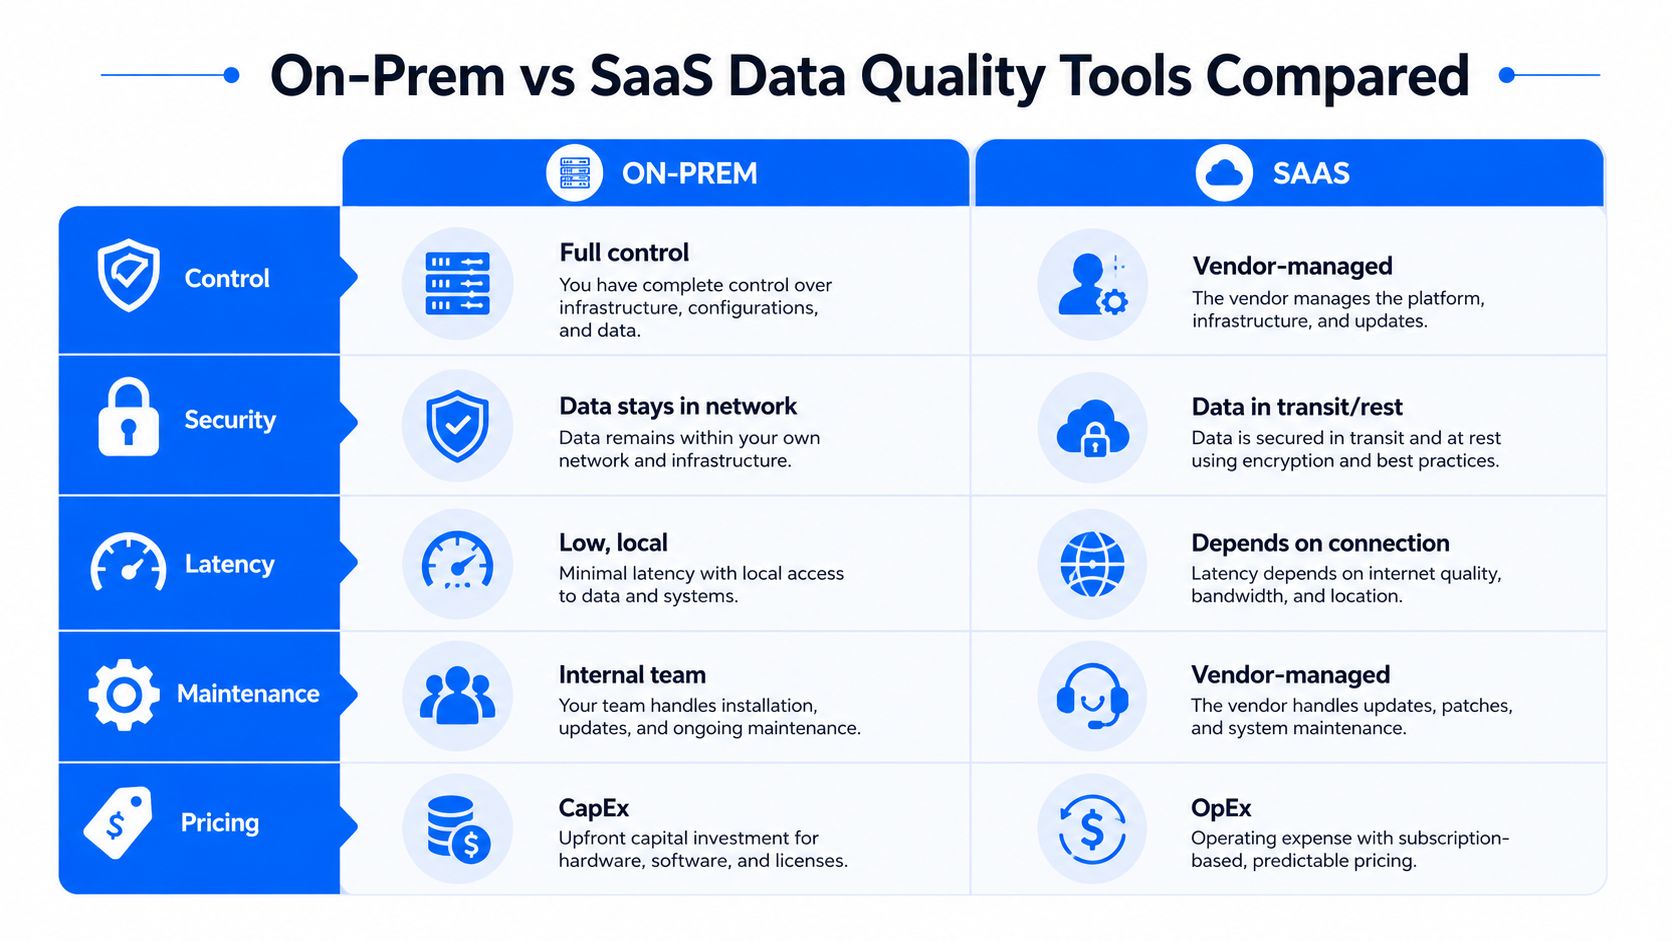
La comparaison doit commencer par les contraintes, et non par la préférence de marque. Un outil sur site offre généralement à l'acheteur un meilleur contrôle sur l'exécution, le positionnement réseau et le calendrier des mises à niveau. Le SaaS réduit généralement les responsabilités d'installation et d'infrastructure, mais il peut exiger que les données, les métadonnées ou les résultats de surveillance traversent une frontière que les équipes réglementées ne peuvent accepter.
Critères d'évaluation | Outil On-Prem | Outil SaaS |
|---|---|---|
Contrôle | Le client contrôle le déploiement et l'infrastructure | Le fournisseur gère le service |
Sécurité | Les données peuvent rester au sein du réseau du client | Les données et le trafic de surveillance utilisent des chemins de service externes |
Latence | L'exécution locale peut réduire les mouvements et la dépendance aux connexions | Les performances dépendent en partie de la connectivité et de l'architecture du service |
Maintenance | Les équipes internes gèrent les opérations et les mises à niveau | Le fournisseur gère une grande partie du fonctionnement de la plateforme |
Tarification | Peut impliquer des coûts d'infrastructure et d'exploitation internes | Les coûts d'abonnement sont généralement traités comme des dépenses d'exploitation |
Le compromis réside dans la responsabilité opérationnelle. Le sur site donne aux équipes d'infrastructure et de sécurité un contrôle direct, mais elles doivent planifier la capacité, les correctifs, la sauvegarde, la haute disponibilité, l'Observability de l'outil lui-même et la reprise après sinistre. Le SaaS peut simplifier ces tâches, bien que l'acheteur doive toujours régir les accès, les intégrations, les Data Contracts et la responsabilité des incidents.
Associer la décision au patrimoine de données
Le sur site est souvent la solution la plus adaptée lorsque les enregistrements doivent rester au sein d'une infrastructure contrôlée par le client, lorsque les systèmes existants sont difficiles à exposer en externe, ou lorsque les auditeurs exigent des preuves détaillées d'accès et de traitement. Il convient également aux patrimoines hybrides où la copie de données vers une plateforme SaaS créerait une complexité supplémentaire en matière de résidence, de confidentialité ou de réseau.
Le SaaS peut être plus simple pour les équipes disposant d'une architecture principalement cloud-native, d'une capacité d'exploitation de plateforme limitée et d'aucune restriction quant à l'envoi des données de surveillance requises à un service géré par un tiers. La simplicité peut s'avérer cruciale. Un outil qu'une équipe peut déployer, configurer et maintenir de manière cohérente a plus de valeur qu'une plateforme théoriquement parfaite qui n'atteint jamais la production.
La décision ressemble à d'autres choix d'infrastructure. Les équipes comparant la messagerie cloud par rapport à un serveur sur site font face à une question similaire concernant le contrôle, la responsabilité et la commodité du service. Le même principe s'applique ici : choisissez la frontière qui correspond au modèle de risque et à la capacité opérationnelle de votre organisation.
Un aperçu pratique des logiciels de qualité des données peut aider les équipes à structurer la couche fonctionnelle, mais le déploiement nécessite toujours une évaluation charge de travail par charge de travail. Identifiez les ensembles de données qui sont sensibles, l'endroit où le calcul doit avoir lieu, les métadonnées qui peuvent quitter chaque environnement et qui assurera le support de la plateforme à deux heures du matin.
Fonctionnalités essentielles que tout outil on-prem devrait inclure
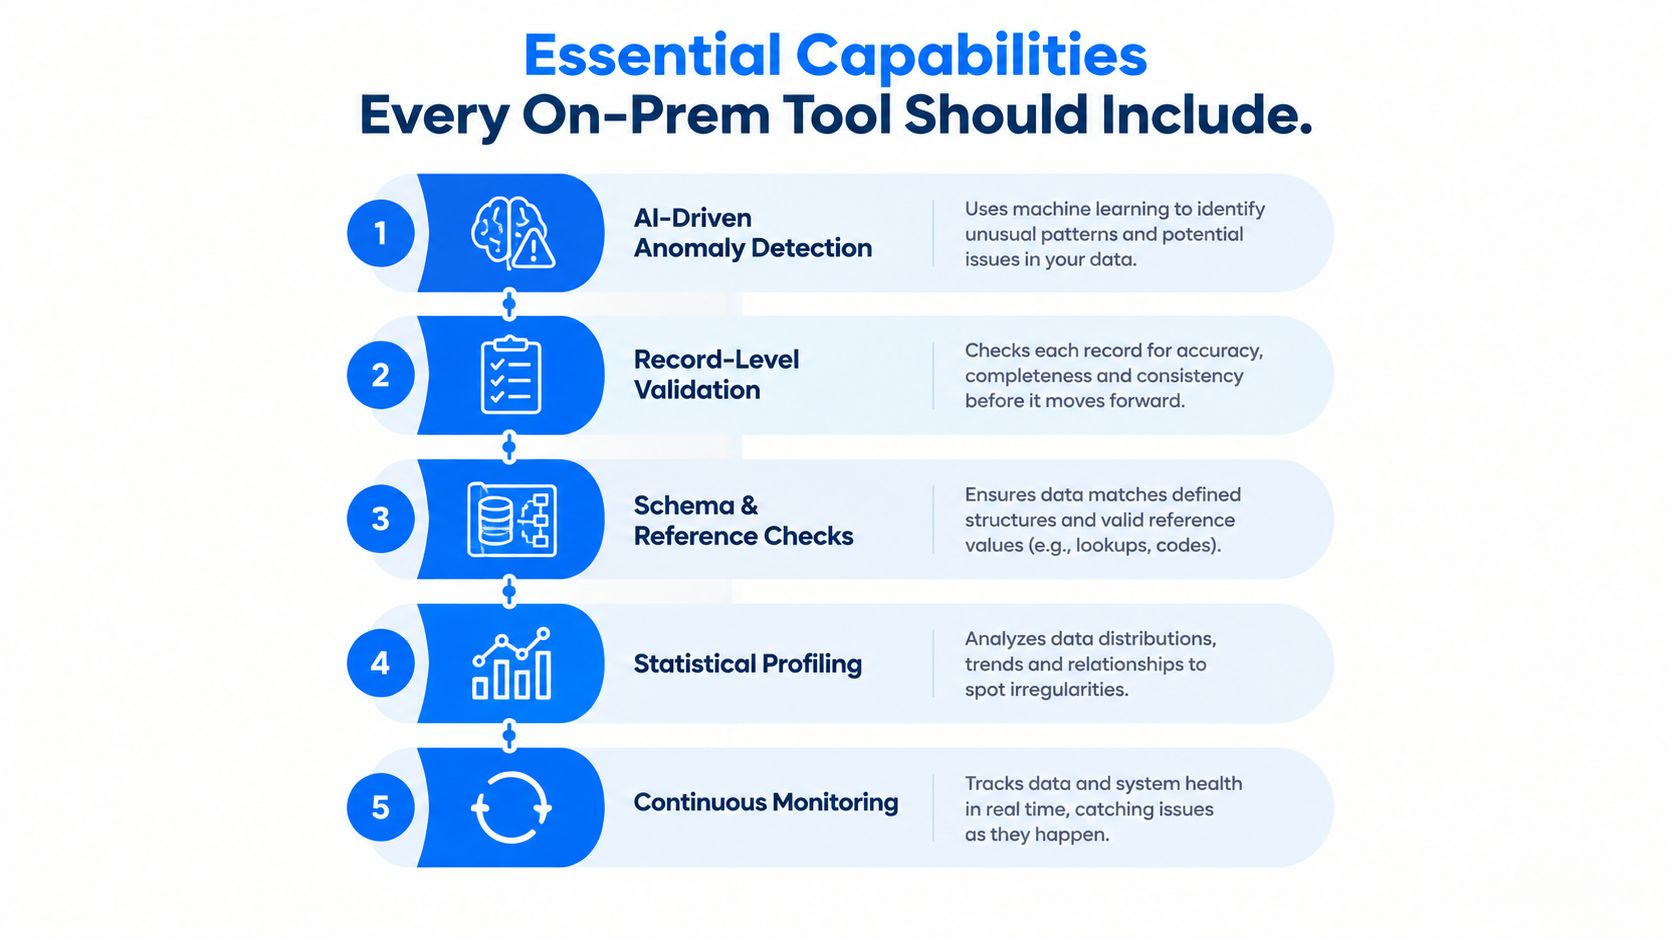
Une plateforme de qualité gagne sa place en détectant différents types de défaillances, et non en produisant un unique score global. La fraîcheur, le volume, la distribution, le schéma et la validation des règles révèlent chacun un symptôme différent. Un modèle d'Observability pratique combine ces signaux car un chargement retardé ne modifiera pas nécessairement un schéma, et un événement de corruption silencieuse peut ne pas réduire le nombre de lignes.
Fraîcheur et volume
La surveillance de la Timeliness consiste à savoir si les données sont arrivées au moment attendu par les utilisateurs. Elle doit prendre en compte les schémas de livraison normaux, les calendriers, les données arrivant en retard, les chargements manquants, les nouvelles tentatives et les chargements partiels. Le calcul de la livraison attendue est particulièrement utile car un seuil fixe peut mal classer une source ayant un comportement d'arrivée variable mais prévisible.
La surveillance du volume détecte une autre catégorie de problème. Un pipeline peut se terminer tout en chargeant beaucoup moins ou beaucoup plus d'enregistrements que d'habitude. Un changement soudain de volume peut indiquer un changement de filtre en amont, une jointure rompue, une panne de source ou un événement commercial inattendu nécessitant une investigation.
Distribution et détection des anomalies
La surveillance de la distribution examine l'intérieur de l'ensemble de données. Elle peut identifier des changements dans les modèles de valeurs, les comportements de valeurs nulles, l'équilibre des catégories ou d'autres caractéristiques statistiques que le décompte des lignes ne révélera pas. L'apprentissage de référence piloté par l'IA peut réduire la dépendance vis-à-vis de seuils configurés manuellement. La plateforme apprend le comportement normal d'un ensemble de données et signale les écarts pour examen.
L'analyse historique apporte du contexte. Une seule observation inhabituelle peut être inoffensive, tandis qu'un changement progressif des métriques historiques peut indiquer une dégradation des données ou un changement de processus. Les équipes ont besoin de vues sur les tendances et la volatilité pour distinguer un événement ponctuel d'un problème de fiabilité en développement.
Schéma et contrôles structurels
Le suivi du schéma surveille le Data Contract entre producteurs et consommateurs. Les colonnes ajoutées ou supprimées, les types de données modifiés et les structures altérées peuvent briser les transformations, les tableaux de bord ou les modèles, même lorsque l'intégration signale un succès.
Une mise en œuvre robuste enregistre le changement, identifie les actifs affectés là où le lignage est disponible, et donne à l'équipe propriétaire suffisamment de contexte pour décider si le changement est intentionnel. La surveillance du schéma ne doit pas simplement dire « quelque chose a changé ». Elle doit aider les ingénieurs à déterminer ce qui a changé et ce qui pourrait en dépendre.
Validation des enregistrements et logique métier
Les signaux statistiques ne remplacent pas les règles déterministes. La validation au niveau de l'enregistrement vérifie si les valeurs respectent les conditions métier, les relations de référence et les exigences d'audit. Des exemples consistent à vérifier qu'un statut est compatible avec une date de cycle de vie, qu'une transaction correspond à une classification approuvée, ou qu'un champ obligatoire est renseigné pour un type d'enregistrement particulier.
Les cinq signaux sont complémentaires. La fraîcheur vous indique quand les données sont arrivées, le volume vous indique quelle quantité est arrivée, la distribution vous indique comment son comportement a changé, le schéma vous indique si sa structure a évolué, et la validation vous indique si les enregistrements répondent à l'intention métier.
L'exécution en base de données est essentielle pour ces cinq fonctionnalités. Calculer les métriques là où les données résident déjà réduit les mouvements inutiles et permet à l'outil de fonctionner à proximité d'ensembles de données volumineux ou sensibles. La plateforme requiert toujours des requêtes efficaces, une planification judicieuse, des autorisations et des contrôles de ressources, car l'exécution locale n'élimine pas le besoin d'une gestion responsable des charges de travail.
Sécurité du déploiement et modèle opérationnel pour les patrimoines hybrides
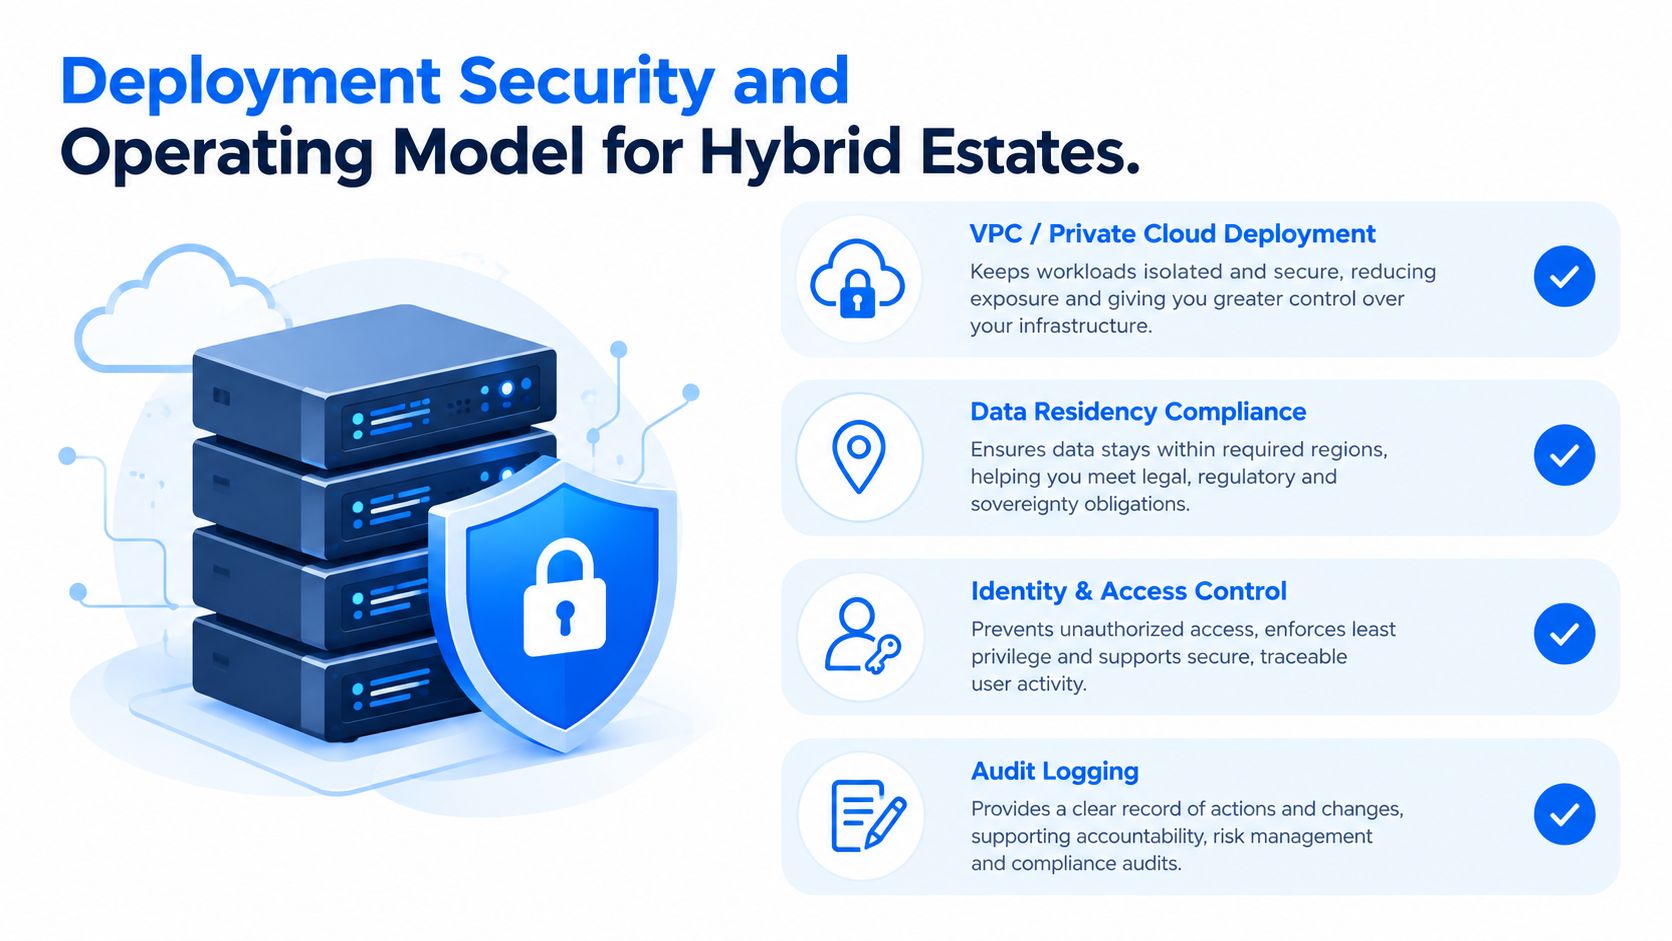
Les patrimoines hybrides mettent en évidence la faiblesse consistant à traiter le sur site comme un simple choix d'installation unique. Un client peut conserver des données transactionnelles dans un centre de données, exploiter un entrepôt dans un cloud privé et utiliser des services cloud pour l'analytique ou le développement de modèles. La couche de surveillance doit observer ces systèmes sans transformer chaque limite de confiance en un problème d'exportation de données.
Valider la limite de déploiement
Commencez par un examen conjoint impliquant les équipes chargées de la plateforme de données, de la sécurité, de l'infrastructure, de la confidentialité et de la gouvernance. Les questions ci-dessous permettent de déceler les lacunes avant qu'un achat ne devienne une exception d'architecture :
Emplacement de l'exécution : Où l'outil s'exécute-t-il, et où les requêtes sont-elles exécutées ?
Mouvement des données : Les enregistrements bruts quittent-ils l'environnement, ou la plateforme ne renvoie-t-elle que des métriques et des métadonnées ?
Identité : L'outil peut-il utiliser l'identité d'entreprise et les contrôles d'accès basés sur les rôles ?
Résidence : Chaque domaine de données peut-il rester dans sa juridiction et sa limite d'infrastructure requises ? Examinez les exigences de résidence des données applicables avant d'approuver la connectivité.
Lignage : Les équipes peuvent-elles tracer un problème à travers les actifs cloud et sur site sans centraliser les enregistrements sensibles ?
Accès hérité : La plateforme peut-elle se connecter à des bases de données plus anciennes et à des systèmes opérationnels sans imposer de migration ?
Preuves d'audit : Les exécutions de règles, les événements d'accès, les modifications de configuration et les décisions relatives aux incidents sont-ils enregistrés ?
Opérations : Qui est responsable des correctifs, des mises à niveau, des sauvegardes, de la capacité, des certificats et des tests de reprise ?
Opérer à travers les limites de confiance
Un tableau de bord unifié ne nécessite pas un data lake unique pour l'ensemble de la surveillance. Un modèle distribué peut exécuter des contrôles localement dans chaque environnement, conserver les données brutes à la source et partager les résultats de qualité gouvernés via des canaux approuvés. Cette approche offre une visibilité aux équipes de gouvernance centrales tout en permettant aux propriétaires locaux de plateformes de contrôler l'accès et l'exécution.
Le modèle opérationnel doit également définir la propriété. La sécurité peut approuver la connectivité, mais les propriétaires de données doivent décider si une anomalie est attendue. Les équipes de plateforme maintiennent le service, tandis que les équipes de domaine corrigent les défauts de source ou de transformation. Sans ces rôles, une installation sur site peut devenir un autre îlot de surveillance isolé.
Cas d'usage sectoriels : ROI et impact opérationnel
L'argument économique en faveur de la qualité des données sur site dépend de ce que la défaillance coûte à votre organisation et des responsabilités qu'elle peut absorber. Le prix de la licence n'est qu'une ligne budgétaire. Le calcul plus large inclut le travail de retouche des analystes, les investigations des ingénieurs, les rapports retardés, la consommation inutile de plateforme, la préparation des audits et le coût opérationnel de l'exploitation du service de surveillance.
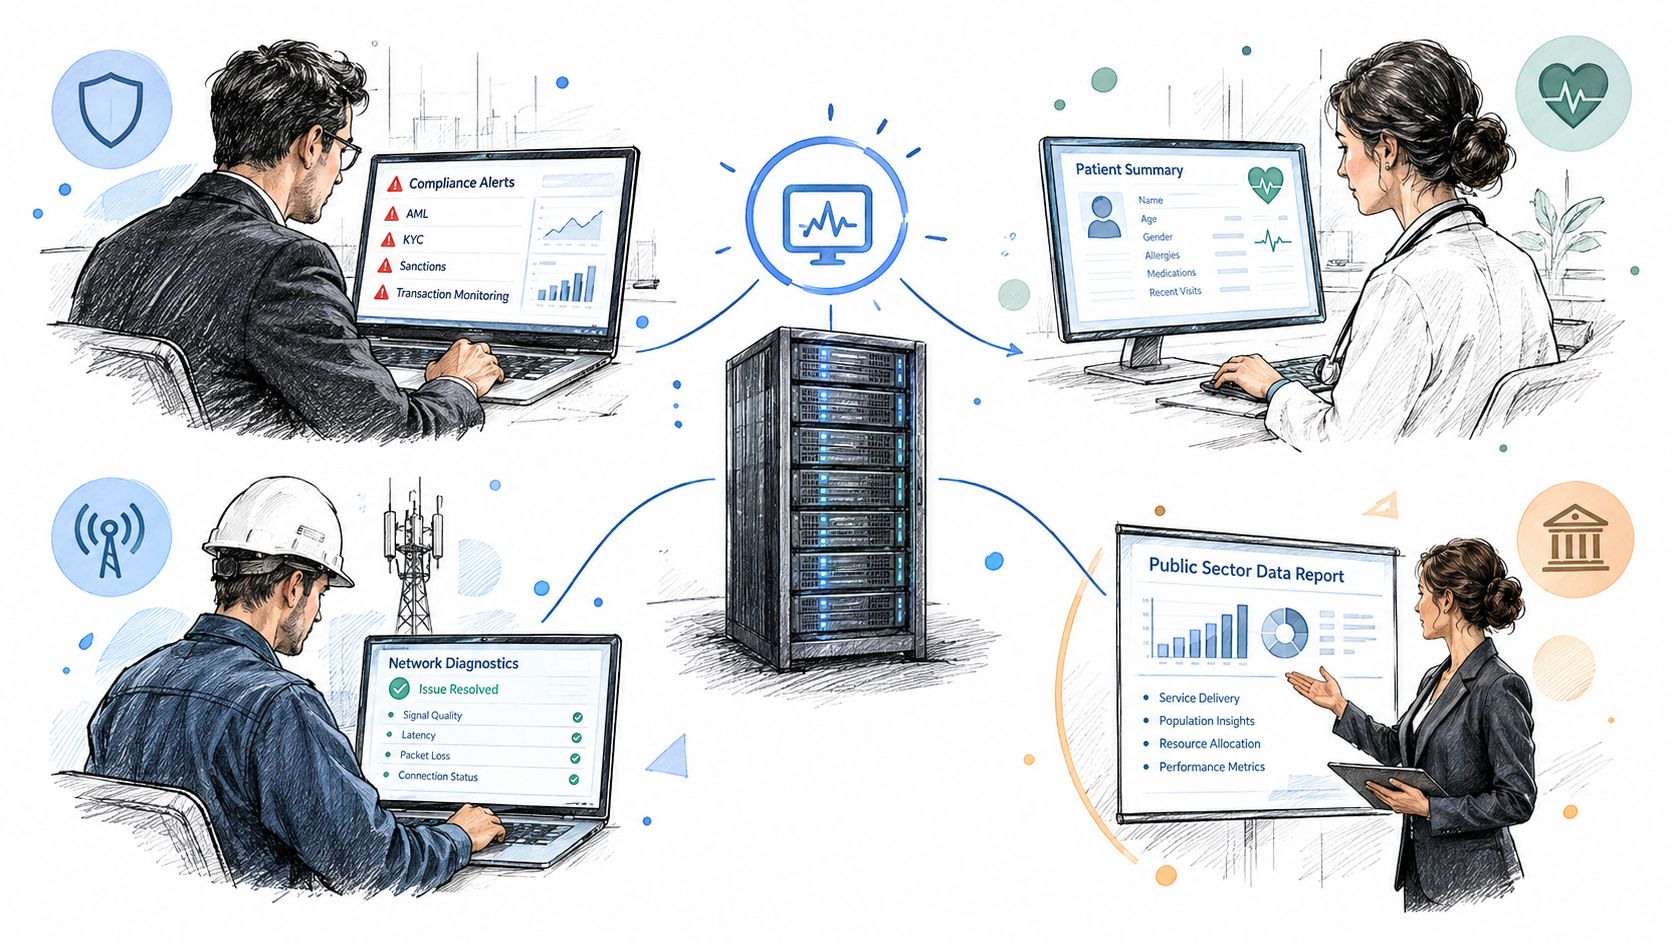
Dans la finance, une équipe peut appliquer une validation au niveau de l'enregistrement aux transactions critiques, surveiller les délais de livraison pour les données de risque et suivre les changements de schéma avant que le reporting réglementaire ne soit rompu. Les équipes de santé peuvent donner la priorité à la résidence, à l'accès contrôlé et aux preuves que les règles métier ont été appliquées à des données cliniques ou opérationnelles sensibles. Les équipes de télécommunications ont souvent besoin d'une surveillance des anomalies et du volume sur des sources opérationnelles à haut débit, tandis que les équipes du secteur public peuvent accorder de la valeur à la traçabilité et à des contrôles cohérents sur des systèmes plus anciens.
Mesurer l'impact opérationnel, pas les indicateurs de vanité
Un modèle de ROI utile s'intéresse à ce qui change une fois que la détection devient continue :
Découverte plus précoce des incidents : Les équipes identifient les chargements tardifs avant que des tableaux de bord obsolètes n'atteignent les décideurs.
Temps d'investigation réduit : La distribution, le schéma et le contexte historique limitent la recherche de la cause première.
Moins de travail de retouche : Les analystes passent moins de temps à rapprocher des rapports ayant utilisé des entrées incompatibles ou incomplètes.
Meilleure préparation aux audits : Les résultats des règles et l'historique opérationnel fournissent des preuves pour examen.
Consommation contrôlée : Les équipes de plateforme peuvent repérer les charges de travail et les comportements de données inhabituels avant qu'ils ne créent des pressions évitables sur les coûts ou la capacité.
Confiance accrue : Les utilisateurs métiers peuvent voir l'état de la surveillance au lieu de s'en remettre à des assurances informelles.
Le compromis est clair. Le sur site peut réduire les mouvements de données et soutenir la Compliance, mais l'acheteur prend à sa charge l'infrastructure, le déploiement et la maintenance. Des recherches sur l'observabilité indiquent que 56,8 % des répondants ont identifié le coût des outils comme un problème, tandis que 29,3 % ont cité des factures annuelles imprévisibles et 27,3 % ont pointé du doigt les CapEx et OpEx pour la gestion des données (rapport State of Observability 2025 de ManageEngine). Ces conclusions renforcent la nécessité de comparer l'exposition aux abonnements avec la main-d'œuvre interne et les obligations d'infrastructure plutôt que de s'en tenir uniquement au devis d'une licence.
Le délai de rentabilisation nécessite un test réel
Une étude de cas d'Acceldata indique que sa plateforme a vérifié plus d'un milliard de lignes pour 50 règles de qualité des données critiques en moins de 2 heures (études de cas Acceldata). Il s'agit d'une référence communiquée par le fournisseur, et non d'une promesse pour chaque patrimoine.
L'expérience de mise en œuvre publiée pour digna est également conditionnelle : « Cela dépend fortement du client, si tout est préparé, cela ne prend pas plus de 2 heures. C'était le cas lors de notre première installation de digna auprès des IT-Services de la Sécurité Sociale d'Autriche. » La leçon pratique est de tester explicitement le travail de préparation. Les approbations de connexion, les tables représentatives, les règles, la propriété et l'acheminement des alertes déterminent la rapidité avec laquelle un déploiement produit des preuves utiles.
Comment évaluer et choisir le bon outil de qualité des données on-prem
Utilisez un projet pilote pour tester le modèle opérationnel, et pas seulement l'interface. Sélectionnez des ensembles de données représentatifs issus à la fois d'un environnement hérité et d'une plateforme cloud, puis vérifiez si l'outil peut les surveiller sans déplacer les enregistrements sensibles vers un service externe.
Votre évaluation doit répondre à ces questions :
Exécution : Les métriques sont-elles calculées dans l'environnement ou la base de données du client ?
Couverture : Une seule plateforme peut-elle combiner détection d'anomalies, validation, ponctualité, schéma et analyse historique ?
Références : La détection des anomalies apprend-elle le comportement des ensembles de données sans obliger les ingénieurs à maintenir chaque seuil ?
Contexte : Une alerte peut-elle afficher les actifs affectés, le comportement historique et la propriété ?
Intégration : Se connecte-t-il aux bases de données, entrepôts, planificateurs, systèmes d'identité et canaux de notification déjà utilisés ?
Opérations : Votre équipe peut-elle appliquer des correctifs, sauvegarder, faire évoluer et restaurer l'outil selon les normes existantes ?
Tarification : Le modèle est-il compréhensible et évite-t-il des frais imprévisibles pour chaque analyse, alerte ou appel d'API ?
Adoption : Les ingénieurs, les analystes et les utilisateurs de la gouvernance peuvent-ils travailler à partir de la même vue sur l'état et les incidents ?
Commencez par un module à forte valeur ajoutée et un ensemble de données clairement identifié sous une propriété définie. Mesurez si le pilote détecte les modes de défaillance connus de fraîcheur, de distribution, de schéma et de validation, puis calculez l'effort interne requis pour l'exploiter. Un dossier commercial pour la qualité des données bien structuré doit inclure le travail de retouche évité, la réponse aux incidents, la préparation des audits, l'infrastructure, la main-d'œuvre de la plateforme et l'intérêt de conserver les données dans des limites approuvées.
L'échange avec le fournisseur doit également inclure des preuves de déploiement, et non seulement une démonstration des fonctionnalités. Demandez un examen de l'architecture, un parcours de sécurité, une intégration représentative et un test du délai d'obtention de la première alerte. Si vous faites référence à la plateforme d'exemple, respectez scrupuleusement la typographie de la marque : digna s'écrit avec un « d » minuscule.
digna fournit une plateforme d'entreprise pour l'observabilité et la qualité des données qui s'exécute au sein de l'environnement du client, avec une exécution en base de données pour la détection d'anomalies, la validation, la ponctualité et la surveillance des schémas. Visitez digna pour explorer un modèle d'exploitation sur site pour les patrimoines de données hybrides et évaluer s'il correspond à vos exigences de sécurité, de gouvernance et de fiabilité.
Questions fréquentes
Qu'est-ce qui rend un outil qualité « on-premise » ?
Le lieu du calcul, pas celui de l'interface. Ce qui compte est de savoir si les requêtes s'exécutent dans votre réseau et si les enregistrements bruts quittent l'environnement ou si seules des métriques et des métadonnées reviennent. Ce seul choix de conception refaçonne toute la discussion sécurité.
L'on-premise est-il automatiquement plus sûr que le SaaS ?
Non, et la question est mal posée. Le SaaS centralise la surveillance dans un environnement géré par l'éditeur, tandis que l'on-premise garde l'exécution dans l'infrastructure du client et y transfère la responsabilité opérationnelle. La bonne comparaison part des contraintes : résidence, accès aux systèmes anciens, preuves d'audit.
Quelles capacités un pilote on-premise doit-il prouver ?
Cinq signaux complémentaires. La fraîcheur dit quand la donnée est arrivée, le volume combien, la distribution comment son comportement a changé, le schéma si sa structure a bougé, et la validation si les enregistrements respectent l'intention métier. Une plateforme qui ne produit qu'un score global n'a pas mérité sa place.
Que doit couvrir la revue de déploiement ?
Huit questions arbitrées ensemble par les équipes plateforme, sécurité, infrastructure, confidentialité et gouvernance : lieu d'exécution, mouvement des données, identité et accès par rôles, résidence par domaine, lineage entre frontières, accès aux bases anciennes, preuves d'audit, et qui porte correctifs, montées de version, sauvegardes et tests de reprise.
Quelle est la taille du segment on-premise ?
Une estimation de marché situe les déploiements on-premise à 37,5 % du marché mondial de la qualité des données en 2025, soit environ 1,8 milliard USD, avec un TCAC de 13,8 % jusqu'en 2034, sous le segment cloud. Le segment persiste parce que les systèmes sensibles restent sur site pendant que l'analytique migre.


