Monitoring du data warehouse : le guide complet pour 2026
|
7
minute de lecture

Le lundi matin est rude lorsque le tableau de bord de la direction s'ouvre sur des chiffres obsolètes, une table de chiffre d'affaires en retard et un fil Slack demandant pourquoi le total du KPI ne correspond pas à celui de la finance. C'est la réalité opérationnelle derrière le monitoring du data warehouse : le travail qui évite aux équipes de découvrir les problèmes seulement après que les utilisateurs métier ont déjà pris des décisions sur des données erronées.
L'écart entre attentes et réalité reste important. Une synthèse de recherche conjointe publiée en 2023 indique que seulement 7% des équipes data résolvent les incidents avant que les utilisateurs n'en ressentent l'impact, que 39% consacrent entre 20% et 40% de leur temps à réparer des pipelines, que 51% ont besoin de quelques heures pour résoudre un seul incident et que 36% ont besoin de quelques jours ou plus étude source sur les opérations d'observabilité des données. Ces chiffres expliquent pourquoi le monitoring n'est plus une couche optionnelle au-dessus du data warehouse : il fait partie de ce qui permet à l'entreprise de fonctionner.
Ce changement est également visible sur le marché. Une enquête sectorielle de 2026 révèle que seulement 22% des organisations jugent l'observabilité des données critique, que 32% la jugent très importante et qu'à peine plus d'un tiers déclarent l'avoir réellement adoptée enquête sectorielle sur la maturité de l'observabilité. Cet écart en dit long, car la plupart des grandes entreprises ont encore besoin d'une meilleure visibilité sur la fraîcheur, la qualité et les schémas de défaillance avant de pouvoir faire confiance à l'analytique et à l'IA.
Table des matières
Pourquoi le monitoring du data warehouse est crucial aujourd'hui
Les composantes essentielles du monitoring du data warehouse
Pourquoi le monitoring du data warehouse est crucial aujourd'hui
Un data warehouse peut sembler en bonne santé vu de l'extérieur et pourtant échouer de manière à affecter l'activité. La finance voit un tableau de bord propre, les ventes voient une courbe de tendance normale, puis quelqu'un remarque que le rafraîchissement de la veille n'a jamais abouti ou qu'un changement de schéma a cassé un modèle en aval. Lorsque ces problèmes apparaissent, les équipes passent déjà leur matinée à réconcilier des systèmes au lieu d'exploiter les données.
Le coût d'attendre que les utilisateurs s'en aperçoivent
Les pires incidents de data warehouse ne font généralement pas de bruit. Une table peut se rafraîchir en retard, une colonne peut changer de type, ou un pipeline peut réussir partiellement tout en laissant les utilisateurs métier face à des résultats obsolètes. Le monitoring est essentiel car il détecte ces situations avant qu'elles ne se transforment en problèmes de confiance dans toute l'organisation.
Les anciens modèles opérationnels reposaient sur des vérifications manuelles et un savoir tribal. Cette approche s'effondre dès que des dizaines de domaines, de parties prenantes et de pipelines dépendent du même data warehouse.
Règle pratique : si une personne doit ouvrir un tableau de bord pour savoir si le data warehouse est en bonne santé, le data warehouse est déjà trop difficile à gérer.
Pourquoi l'observabilité est devenue une discipline opérationnelle
La synthèse de recherche de 2023 met clairement en évidence le compromis. Les équipes réagissent encore après l'impact au lieu de le prévenir. Lorsque les ingénieurs consacrent une grande partie de leur temps à réparer des pipelines et ont encore besoin d'heures ou de jours pour résoudre les incidents, le problème n'est plus un bug ponctuel. C'est le mode de fonctionnement lui-même.
C'est pourquoi les programmes de monitoring matures misent sur la détection précoce, une responsabilité claire et un routage rapide. Ils ne se contentent pas de demander si un job s'est exécuté. Ils vérifient si les bonnes données sont arrivées à temps, si la structure a changé, si la qualité s'est dégradée et si les KPI métier ont toujours du sens.
Pour les équipes qui veulent resserrer cette boucle, un bon point de départ pratique est le guide des bonnes pratiques du data warehouse de digna. Il aide à faire la différence entre « nous avons des alertes » et « nous savons quoi faire quand le data warehouse dérive ».
Un programme de monitoring utile doit aussi tenir compte de compromis opérationnels réels. Trop d'alertes, et les équipes les ignorent. Trop peu de contrôles, et le premier signe de problème vient d'un analyste frustré ou d'une mauvaise décision déjà en cours. Le bon équilibre combine la validation traditionnelle et la détection d'anomalies, y compris des approches in-database qui maintiennent les contrôles au plus près des données et réduisent le délai entre la défaillance et sa détection.
Le bénéfice, c'est la confiance. Une fois le data warehouse surveillé de manière intentionnelle, les data engineers passent moins de temps à éteindre des incendies, les analystes passent moins de temps à valider des extractions à la main, et les dirigeants cessent de demander quelle version du chiffre est la bonne. C'est ce qui rend le data warehouse exploitable à l'échelle de l'entreprise.
Les composantes essentielles du monitoring du data warehouse
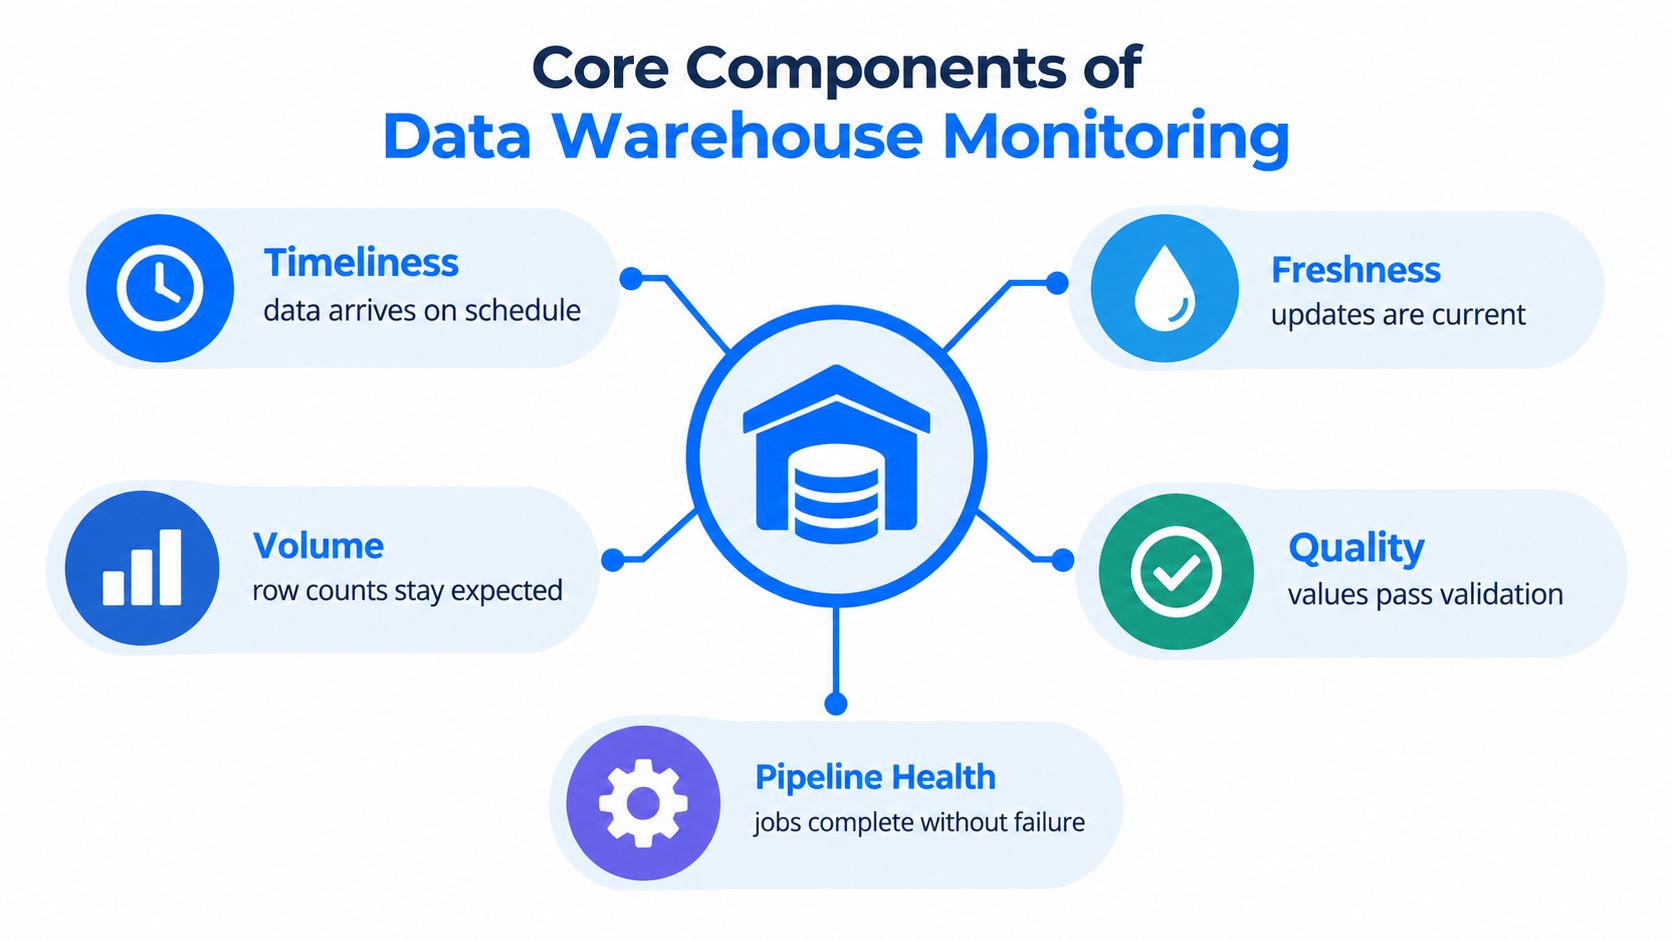
Le monitoring ne fonctionne que s'il couvre les bonnes couches de risque. Un data warehouse peut se charger à temps et contenir malgré tout des enregistrements erronés. Il peut aussi paraître à jour alors qu'une modification de champ casse silencieusement des modèles en aval. Un monitoring solide relie ces modes de défaillance au lieu de les traiter comme des outils distincts.
Ponctualité et fraîcheur sont liées, mais pas identiques
Le monitoring de la ponctualité vérifie si les mises à jour arrivent au moment prévu. Le test pratique est simple : comparer l'horaire réel de mise à jour avec un planning ou un SLA, puis alerter lorsque l'écart devient trop important. Un exemple courant est une table horaire qui déclenche une alerte lorsque son intervalle de mise à jour dépasse environ 2 heures recommandations sur le monitoring de la ponctualité.
La fraîcheur correspond à l'âge de l'enregistrement le plus récent. La ponctualité demande si le chargement a eu lieu à temps. La fraîcheur demande à quel point les données sont actuelles en ce moment. Les équipes confondent souvent les deux, ce qui crée une fausse assurance. Un job peut s'exécuter selon le planning et charger malgré tout des enregistrements anciens. Un job en retard peut tout de même produire des données actuelles une fois terminé.
Le monitoring du schéma et de la qualité détecte les défaillances silencieuses
Le schema drift est l'un des moyens les plus simples de casser les consommateurs en aval sans incident visible. Des changements structurels comme l'ajout ou la suppression de colonnes, les changements de type, les champs renommés et les modifications de contraintes peuvent casser des tableaux de bord, des datamarts et des modèles sans avertissement s'ils ne sont pas détectés et communiqués. Pour les équipes qui ont besoin d'un point de référence pratique, le guide des bonnes pratiques du data warehouse de digna est un bon point de départ pour réfléchir à la gestion des changements autour de la structure du data warehouse. L'objectif n'est pas seulement de détecter le changement, mais de s'assurer que les responsables en aval savent ce qui a changé avant de livrer des hypothèses erronées.
Le monitoring de la qualité se situe au niveau de l'enregistrement. Il doit valider les données par rapport aux règles métier et inclure des contrôles de complétude, d'exactitude, de cohérence et de ponctualité recommandations sur les incidents de qualité des données. Des recommandations indépendantes préconisent également des seuils mesurables comme des valeurs nulles inférieures à 0,1% et zéro identifiant client en double par mois, afin que la qualité ne reste pas subjective.
Quand le monitoring est vague, les équipes débattent de la gravité. Quand il est mesurable, elles peuvent agir.
La performance et la santé des pipelines maintiennent le système exploitable
Le monitoring de la performance est la partie que de nombreuses équipes repoussent jusqu'à ce que les utilisateurs se plaignent. Il surveille la consommation de ressources, la latence des requêtes et le débit afin que le data warehouse ne devienne pas si lent qu'il en serait fonctionnellement inutilisable. C'est important, car un data warehouse qui fonctionne techniquement mais répond trop lentement fait tout de même défaut à l'entreprise.
La santé des pipelines relie tous les autres signaux. Si des jobs échouent, relancent indéfiniment ou commencent à prendre plus de temps sans que personne ne le remarque, toutes les autres couches deviennent plus bruyantes. Les équipes qui surveillent la santé des pipelines en parallèle de la qualité et de la fraîcheur des données sont alertées plus tôt et se renvoient moins la responsabilité entre équipes plateforme et analytique.
Pour les équipes qui ont besoin d'un modèle opérationnel concret plutôt que d'une théorie, l'approche d'intégration au data warehouse de digna montre comment le monitoring peut se placer au plus près du data warehouse au lieu d'être greffé comme un système séparé.
Règles traditionnelles ou observabilité pilotée par l'IA
Les règles statiques restent importantes, mais elles ne suffisent pas à elles seules. Les seuils codés en dur sont efficaces pour détecter les modes de défaillance connus, en particulier lorsque la règle métier est claire et la tolérance fixe. Ils peinent lorsque les données changent de forme, que les tendances dérivent ou que des anomalies apparaissent de façon imprévue.
Ce que les règles statiques font bien et où elles échouent
Le monitoring basé sur des règles est simple. Si un job s'exécute en retard, si les valeurs nulles dépassent un seuil, si une colonne critique disparaît, l'alerte se déclenche. Il est donc facile à expliquer, facile à auditer et utile pour les contrôles liés à la conformité.
L'inconvénient, c'est la maintenance. Chaque nouveau dataset, cas particulier ou règle métier ajoute un seuil supplémentaire à ajuster. Dans les grands environnements, le volume d'alertes devient un problème en soi, car les gens cessent de faire confiance aux notifications dès que trop d'entre elles sont routinières ou peu utiles.
Comment l'observabilité pilotée par l'IA change la charge de travail
L'observabilité pilotée par l'IA emprunte une autre voie. Au lieu de demander aux ingénieurs de définir chaque seuil à l'avance, elle apprend le comportement de référence de chaque dataset et signale les écarts par rapport à ce comportement attendu. Elle est donc utile pour les dérives, les anomalies subtiles et les situations qui n'entrent pas dans une règle bien définie.
Le compromis tient à la maturité. Les méthodes pilotées par l'IA ont besoin de suffisamment d'historique pour apprendre et doivent encore être ajustées lorsque les usages évoluent. Elles donnent le meilleur d'elles-mêmes lorsqu'elles sont associées à des règles ciblées pour la logique métier connue, la couche IA prenant en charge la détection d'anomalies à grande échelle et la priorisation.
Voici une manière utile d'y réfléchir.
Domaine | Règles statiques | Observabilité pilotée par l'IA |
|---|---|---|
Détection | Modes de défaillance connus | Dérives et anomalies inattendues |
Bruit | Peuvent être précises, mais deviennent bruyantes à grande échelle | Peut réduire la prolifération des seuils manuels, mais nécessite encore des ajustements |
Maintenance | Entretien continu des règles | Gestion des références et ajustement des modèles |
Pour un contexte opérationnel plus large, les tendances du monitoring de la performance IT offrent un parallèle utile sur la manière dont les équipes de monitoring réduisent le bruit tout en restant concentrées sur les signaux pertinents.
Les meilleures configurations en production combinent généralement les deux. Utilisez des règles déterministes pour les contrôles qui ne doivent jamais être ambigus, puis ajoutez une détection pilotée par l'IA là où le data warehouse se comporte davantage comme un système vivant que comme une checklist figée. Pour les équipes qui évaluent les différentes méthodes, la comparaison de digna entre contrôles qualité pilotés par l'IA et méthodes traditionnelles est une référence pratique.
Les métriques clés que chaque équipe devrait surveiller
Un programme de monitoring devient concret lorsqu'il suit des métriques sur lesquelles on peut agir. Il ne s'agit pas de tout mesurer. Il s'agit de mesurer ce qui indique si le data warehouse alimente correctement l'activité.
Commencer par la ponctualité, la qualité et la performance
Les métriques de ponctualité comparent l'horaire réel de mise à jour avec le planning ou le SLA attendu. Si un batch doit s'exécuter chaque jour, il faut un seuil clair définissant à partir de quand un retard justifie une alerte. Le seuil exact dépend de l'activité, mais l'essentiel est que l'équipe s'accorde dessus à l'avance, et non après un incident.
Les métriques de qualité transforment les règles métier en contrôles. Utilisez-les pour valider la complétude, l'exactitude, la cohérence et la ponctualité au niveau de chaque ligne recommandations sur le monitoring de la qualité. Lorsque les seuils sont mesurables, les équipes peuvent décider si une dégradation est acceptable, temporaire ou s'il s'agit d'un véritable incident à trier.
Les métriques de performance doivent inclure le temps de réponse des requêtes, le débit des pipelines et l'utilisation des ressources. Des requêtes lentes et des pipelines surchargés sont souvent le premier signe que le data warehouse est sous pression, en particulier pendant les périodes de reporting intensif ou après le lancement d'un nouveau modèle.
Ne pas s'arrêter à la santé technique
Les métriques métier sont importantes car elles révèlent des problèmes que les contrôles techniques ne voient pas. Le chiffre d'affaires, le nombre de transactions, l'activité client et d'autres KPI opérationnels peuvent révéler un problème de data warehouse plus vite qu'une page de statut des jobs. Si une métrique métier clé change brusquement alors que rien n'a changé côté activité, le data warehouse mérite un examen attentif.
C'est aussi pourquoi la fraîcheur et la ponctualité doivent être traitées séparément. Une table peut être mise à jour selon le planning tout en contenant des valeurs sources obsolètes, ou contenir des valeurs fraîches après un retard que les utilisateurs ne peuvent pas tolérer. Ces deux situations sont des signaux utiles, mais elles pointent vers des causes racines différentes.
Un bon monitoring ne se demande pas seulement si les données existent. Il se demande si l'entreprise peut leur faire confiance.
Pour les équipes qui souhaitent définir ces signaux de manière plus structurée, le guide de digna sur les métriques de ponctualité des données est une référence pratique. Il aide à relier les attentes fondées sur les plannings à la réalité opérationnelle de la livraison des données dans le data warehouse.
Un ensemble de métriques clair rend aussi l'analyse des incidents plus honnête. Si l'équipe peut voir ensemble le timing, la qualité et l'impact métier, il devient beaucoup plus facile de distinguer un problème de chargement d'un problème de modélisation ou d'une véritable évolution de l'activité.
Modèles de mise en œuvre du monitoring en entreprise
Le monitoring en entreprise échoue lorsqu'il crée plus de systèmes à gérer qu'il n'évite de problèmes. Le modèle de déploiement le plus solide maintient les contrôles au plus près des données, garde les informations sensibles dans l'environnement du client et rend les alertes compréhensibles pour les équipes qui doivent agir.
L'exécution in-database est le choix opérationnel le plus sûr par défaut
Exécuter les contrôles directement dans les bases de données du client réduit les déplacements de données et répond mieux aux exigences de sécurité et de gouvernance que l'export de tout vers des systèmes externes. C'est essentiel dans les environnements réglementés, mais aussi dans les entreprises ordinaires qui ne veulent pas déplacer des données sensibles du data warehouse à des fins de monitoring.
Ici, la conception compte plus que la marque. Un modèle in-database permet à la couche de monitoring d'inspecter les données là où elles se trouvent, tout en produisant des alertes, des tendances et des mises à jour de statut visibles par les bonnes personnes. En pratique, cela se traduit généralement par moins de frictions avec les équipes sécurité et moins de surprises lors des revues.
Les alertes centralisées ont besoin de contexte, pas seulement de rapidité
Une gestion unifiée des alertes ne fonctionne que si les notifications sont rattachées au bon responsable et au bon circuit de réponse. Un flux d'incidents bruyant n'aide en rien si le même message arrive dans cinq canaux et que personne ne sait qui doit corriger le problème. Le système de monitoring doit router les alertes par dataset, par domaine ou par type de défaillance afin que la bonne personne voie le bon signal.
Un modèle pragmatique pour l'entreprise ressemble à ceci.
Contrôles in-database : effectuer les calculs à côté du data warehouse pour réduire les déplacements de données et simplifier la gouvernance.
Accès basé sur les rôles : limiter qui peut voir les détails sensibles des incidents.
Intégration opérationnelle : se brancher sur les outils d'orchestration et de communication que l'équipe utilise déjà.
Visibilité partagée : exposer le même signal aux ingénieurs, aux analystes et aux utilisateurs métier sans les contraindre à des versions différentes de la vérité.
Pour les équipes qui évaluent des outils compatibles avec ce modèle, la présentation du monitoring et du reporting de digna est pertinente, car elle montre comment les alertes et le reporting peuvent s'appuyer sur des contrôles natifs du data warehouse sans créer un problème de copie séparée des données.
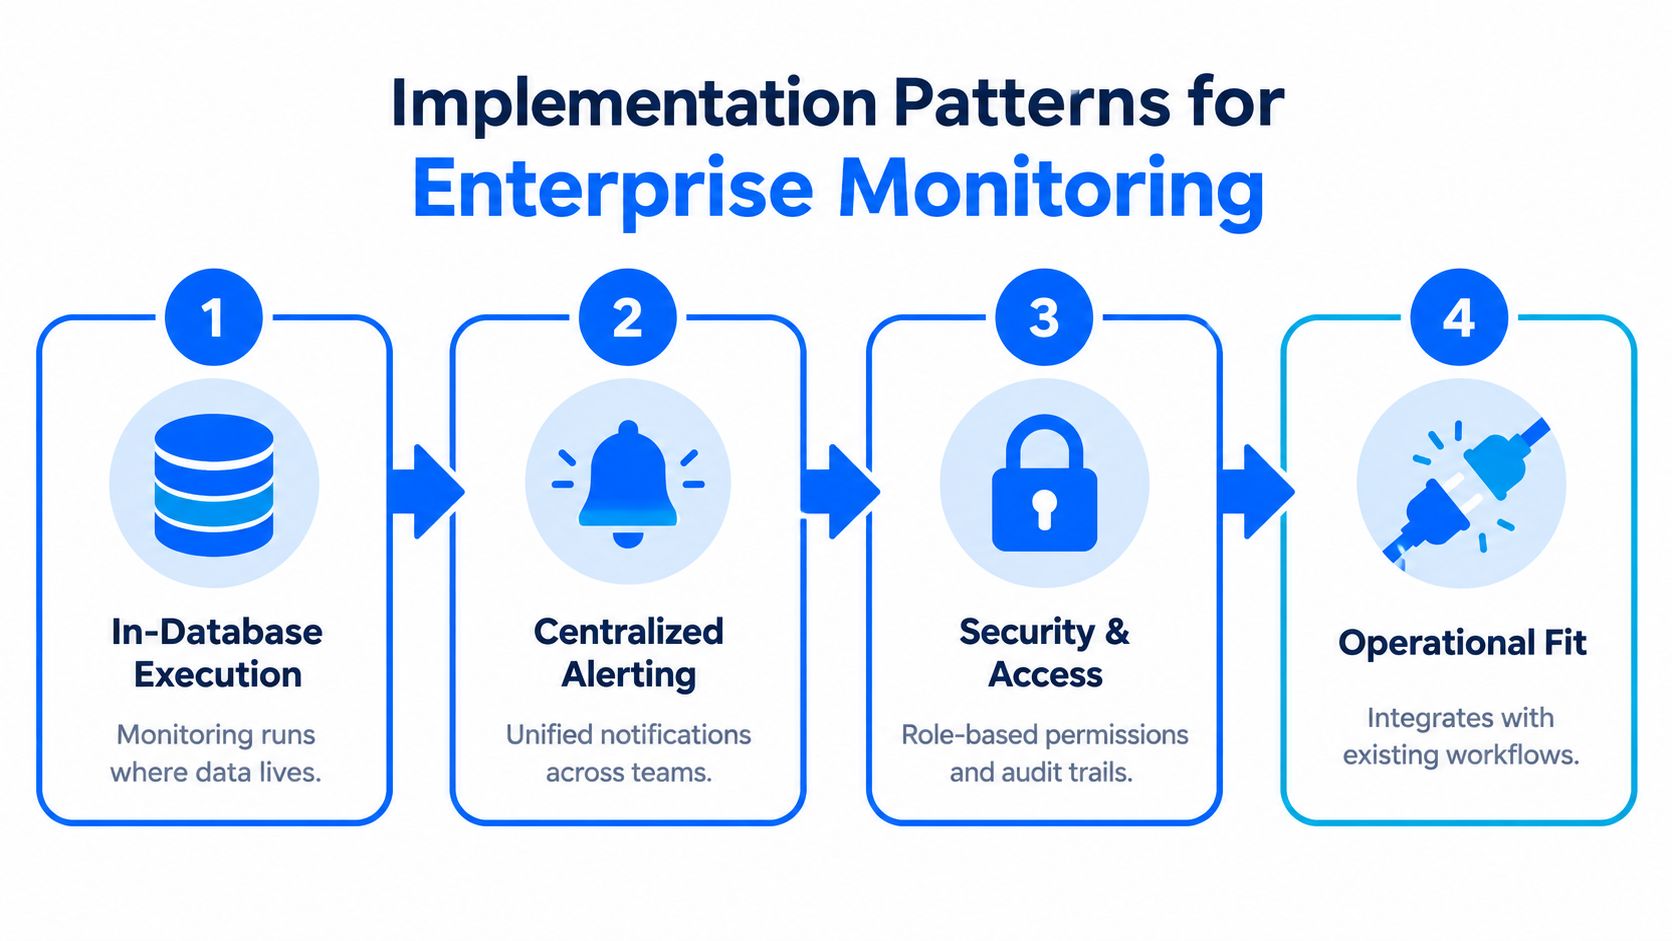
L'objectif est l'intégration opérationnelle. Si la couche de monitoring interrompt chaque workflow, elle ne survivra pas à la production. Si elle s'adapte à la façon dont l'équipe du data warehouse travaille déjà, elle devient une partie du plan de contrôle au lieu d'un énième tableau de bord que personne ne consulte.
Construire une culture du monitoring pour un succès durable
Les outils de monitoring ne créent pas la fiabilité à eux seuls. Ce sont les équipes qui la créent. Les organisations qui réussissent traitent l'observabilité comme une composante des opérations data, et non comme une tâche de configuration ponctuelle confiée à l'ingénierie après un incident.
La responsabilité et la réponse doivent être explicites
Chaque domaine de données a besoin d'un responsable clairement identifié, et chaque type d'alerte d'un circuit de réponse connu. En cas de changement de schéma, l'analytics engineer doit savoir s'il faut mettre à jour un modèle, prévenir le responsable d'un tableau de bord ou escalader vers une équipe plateforme. Si une règle de qualité échoue, quelqu'un doit déterminer si le problème vient des données en amont, d'une transformation défectueuse ou d'une règle métier à réviser.
Les boucles de feedback comptent tout autant. Chaque incident doit laisser derrière lui quelque chose d'utile : un meilleur seuil, une règle plus claire ou une référence plus précise. Sans cette boucle, les équipes rejouent simplement la même lutte contre les incendies avec des symptômes légèrement différents.
Revoir le bruit, former les utilisateurs et faire vivre le programme
C'est grâce à des revues régulières que les bons programmes de monitoring restent sains. Les équipes doivent réexaminer quelles alertes se sont déclenchées, lesquelles ont été utiles et lesquelles doivent être supprimées ou affinées. Si personne ne revoit jamais l'ensemble des signaux, la fatigue des alertes finira par éroder la confiance.
La formation est l'autre moitié du travail. Les ingénieurs, les analystes et les utilisateurs métier doivent tous comprendre ce que signifient les alertes et quelle action entreprendre. Une plateforme de monitoring ne fonctionne que si les gens peuvent l'interpréter sans organiser une réunion à chaque changement.
Un data warehouse est fiable lorsque l'équipe peut expliquer rapidement ses défaillances et empêcher qu'elles ne se reproduisent.
C'est aussi pourquoi l'observabilité est devenue un prérequis pour une analytique et une IA dignes de confiance. Un modèle n'est fiable que si les données qui l'alimentent le sont, et un tableau de bord n'est utile que si le pipeline qui le sous-tend l'est aussi. Les organisations qui construisent une culture du monitoring ne se contentent pas de réduire les pannes : elles décident plus vite, car moins de décisions nécessitent au préalable une vérification manuelle des données.
Pour les équipes prêtes à renforcer la qualité des données, la fraîcheur, le suivi des schémas et le monitoring métier dans un seul modèle opérationnel, digna propose une plateforme d'observabilité in-database qui s'intègre directement dans l'environnement du client. Découvrez-la si vous cherchez un moyen concret de surveiller le comportement de votre data warehouse sans exporter de données sensibles hors de votre stack.
Pour voir comment les contrôles de ponctualité décrits ici fonctionnent sans plannings définis manuellement pour chaque table, le module Timeliness de digna apprend le schéma d'arrivée habituel de chaque table et alerte lorsqu'un chargement est en retard ou manquant.
Questions fréquentes
Qu'est-ce que le monitoring du data warehouse ?
Il s'agit du contrôle continu d'un data warehouse pour détecter les chargements en retard, les données obsolètes, les changements de schéma, la dégradation de la qualité et les lenteurs, afin d'identifier les problèmes avant que les utilisateurs métier n'agissent sur des chiffres erronés. Les programmes matures surveillent aussi les KPI métier, car une variation soudaine d'une métrique révèle souvent en premier un problème de pipeline.
Quelle est la différence entre la ponctualité et la fraîcheur des données ?
La ponctualité vérifie si un chargement est arrivé au moment prévu par rapport à son planning ou à son SLA. La fraîcheur mesure l'âge de l'enregistrement le plus récent à l'instant présent. Un job peut s'exécuter à l'heure et charger malgré tout des enregistrements anciens, et un job en retard peut tout de même livrer des données actuelles : chacune nécessite donc son propre contrôle.
Quelles métriques un programme de monitoring du data warehouse doit-il suivre ?
Commencez par la ponctualité par rapport au planning attendu, la qualité au niveau des enregistrements (complétude, exactitude et cohérence) et la performance, comme le temps de réponse des requêtes, le débit des pipelines et l'utilisation des ressources. Ajoutez des métriques métier comme le chiffre d'affaires ou le nombre de transactions, car elles révèlent des problèmes que les contrôles techniques ne voient pas.
Les contrôles d'anomalies pilotés par l'IA sont-ils meilleurs que les règles statiques ?
Aucune des deux approches ne suffit seule. Les règles statiques conviennent aux modes de défaillance connus et aux contrôles de conformité, car elles sont faciles à expliquer et à auditer, mais elles deviennent coûteuses à maintenir à grande échelle. Les contrôles pilotés par l'IA apprennent la référence de chaque dataset et détectent les dérives inattendues : les configurations en production combinent donc généralement les deux.
Pourquoi exécuter le monitoring du data warehouse dans la base de données ?
L'exécution in-database maintient les contrôles à côté des données, si bien que les enregistrements sensibles n'ont jamais besoin d'être exportés vers un système de monitoring externe. Cela réduit les déplacements de données, répond aux exigences de sécurité et de gouvernance des secteurs réglementés et entraîne généralement moins de frictions lors des revues de sécurité, tout en produisant des alertes et des tendances.



