Fichier Parquet : architecture, performance et usage
|
10
minute de lecture

Vous êtes probablement dans l'une de deux situations. Soit vous choisissez un format de stockage pour un nouveau jeu de données et chaque option semble vaguement « optimisée », soit Parquet est déjà en production et votre problème n'est pas de le lire, mais de comprendre pourquoi un jeu est rapide, un autre poussif et un troisième refuse soudain de s'ouvrir.
C'est là que la plupart des contenus sur Parquet s'arrêtent trop tôt. Ils décrivent le chemin idéal. Ils disent que Parquet est en colonnes, compressé et bon pour l'analytique, ce qui est vrai mais insuffisant quand vous réglez des row groups, déboguez des envois corrompus ou décidez si de nouveaux types logiques casseront l'interopérabilité entre moteurs.
Parquet compte parce qu'il occupe le centre des plateformes de données modernes. C'est le format que beaucoup d'équipes utilisent comme couche physique sous les lacs de données, les lakehouses, les feature stores, les zones d'archivage et les échanges entre outils. Comprendre la mécanique du fichier, c'est mieux décider en matière de disposition, de comportement des requêtes, de gouvernance et de gestion des pannes.
Sommaire
Comment le predicate pushdown et les page indexes accélèrent les requêtes
Compression, encodage, partitionnement et évolution du schéma
Ce qu'est un fichier Parquet et pourquoi il compte
Un fichier Parquet est un format de fichier en colonnes ouvert conçu pour les charges analytiques. Il a démarré comme un effort open source conjoint entre Twitter et Cloudera, est sorti pour la première fois sous le nom de Parquet 1.0 en juillet 2013, et est devenu projet de premier niveau de l'Apache Software Foundation le 27 avril 2015. Sa conception s'appuyait sur le découpage et réassemblage d'enregistrements à la Dremel, ce qui en a fait un choix naturel pour l'analytique à grande échelle dans les lacs de données cloud, comme l'indique la présentation d'Apache Parquet.
Cette origine compte car les charges analytiques ne se comportent pas comme les systèmes transactionnels. Les analystes récupèrent rarement un enregistrement complet à la fois. Ils parcourent beaucoup de lignes, touchent peu de colonnes, filtrent fort, agrègent davantage et répètent ce motif toute la journée. Un format orienté lignes comme CSV oblige le moteur à lire beaucoup de données inutiles pour répondre à une question simple.
Pourquoi le stockage en colonnes change le profil de coût
Supposons que votre table contienne customer_id, event_date, country, device_type, revenue, campaign, browser et une douzaine d'autres champs. Si votre requête n'a besoin que d'event_date et de revenue, un format par lignes traîne quand même chaque champ dans les E/S et l'analyse syntaxique. Parquet non.
C'est le gain concret. Le stockage en colonnes permet aux moteurs de ne lire que les colonnes nécessaires, ce qui réduit les E/S et la mémoire gaspillées pour un travail analytique sélectif. C'est l'une des raisons pour lesquelles Parquet est devenu la couche d'échange par défaut entre des outils qui ne partagent pas un même runtime.
Pourquoi les équipes s'y fient dans des environnements multi-outils
Un fichier Parquet porte son propre schéma et ses métadonnées dans sa structure, si bien qu'il voyage bien entre Spark, Hive, Pandas, DuckDB, Trino et les moteurs proches de l'entrepôt. Vous n'avez pas toujours besoin d'un catalogue externe rien que pour interpréter son contenu.
Règle pratique : si votre équipe s'attend à ce que le même jeu de données circule entre moteurs de traitement, un format autodescriptif évite beaucoup de code de liaison fragile.
Parquet est devenu de fait la langue commune du stockage dans la pile lakehouse. Si vous réfléchissez plus largement à la conception de plateforme, c'est une des raisons pour lesquelles le socle de la plateforme de données compte autant. Le format de fichier n'est pas un détail annexe. Il façonne la façon dont chaque moteur en aval lit, écarte, valide et fait confiance à vos données.
Au cœur de l'architecture du fichier Parquet
La façon la plus nette de comprendre un fichier Parquet est d'arrêter de le voir comme un bloc et de commencer à le penser comme une petite bibliothèque.
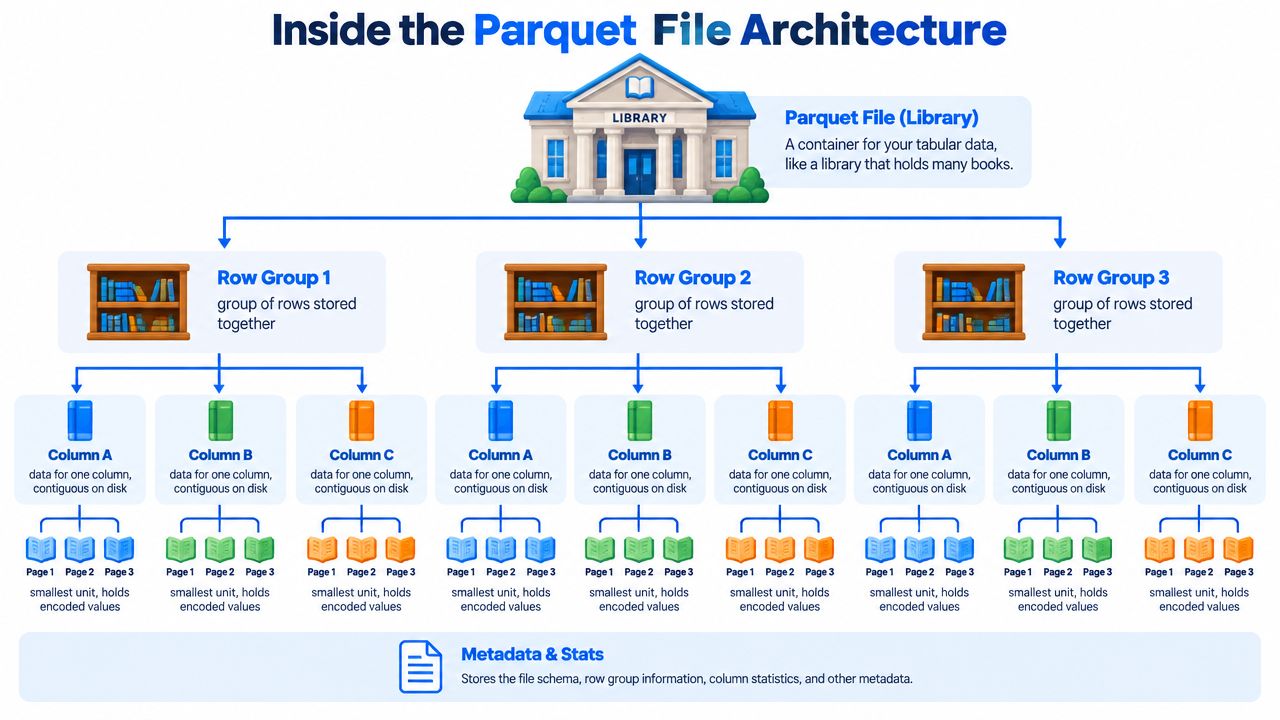
Le fichier est le bâtiment. À l'intérieur, les row groups sont les sections de la bibliothèque. Dans chaque row group, chaque column chunk est une étagère pour une colonne. Et chaque column chunk contient des pages, les unités plus petites lues séquentiellement depuis le disque.
La documentation des concepts Apache le pose directement : un fichier contient un ou plusieurs row groups, chaque row group contient exactement un column chunk par colonne, et chaque column chunk contient une ou plusieurs pages. Elle note aussi que les column chunks sont contigus dans le fichier, l'une des raisons pour lesquelles les lectures en colonnes sont efficaces en pratique, comme documenté dans la référence des concepts Parquet.
La hiérarchie que les lecteurs utilisent vraiment
Cette hiérarchie n'a rien d'académique. Les moteurs de requête s'en servent en permanence.
Le niveau fichier donne au lecteur un objet unique à ouvrir et inspecter.
Le niveau row group sert d'unité pratique d'analyse parallèle.
Le niveau column chunk permet au moteur de ne tirer que les colonnes demandées par la requête.
Le niveau page est l'endroit où les valeurs encodées sont stockées puis décodées dans l'ordre.
Si vous avez travaillé sur l'architecture des systèmes de données, cela devrait vous parler. Les systèmes efficaces sont souvent hiérarchiques parce que la hiérarchie donne des points d'arrêt aux lecteurs. Parquet offre ces points d'arrêt à plusieurs niveaux.
Ce qui se trouve aux extrémités du fichier
Un fichier Parquet sain commence et se termine par les octets magiques PAR1. C'est l'une des premières vérifications d'intégrité que font beaucoup d'outils. Si la marque de fin manque, le fichier est peut-être tronqué, incomplet, ou n'est pas du Parquet du tout.
Le pied de page, près de la fin du fichier, est l'endroit où réside l'essentiel de l'intelligence. Il stocke le schéma, les métadonnées de row group et des métadonnées clé-valeur. C'est pourquoi Parquet est autodescriptif. Les lecteurs n'ont pas à deviner la forme du jeu de données.
Un fichier Parquet est facile à lire quand les pages de données vont bien. Il est facile à diagnostiquer quand le pied de page va bien. C'est pénible quand le transport a cassé le fichier avant que l'une ou l'autre couche puisse aider.
Comment Parquet gère les données imbriquées
Parquet a été conçu autour du découpage et réassemblage à la Dremel, qui lui permet de représenter des structures imbriquées comme les structs, listes et maps sans répéter les noms de champs à chaque ligne. L'astuce est que l'écrivain décompose les enregistrements imbriqués en morceaux en colonnes et conserve assez d'informations positionnelles pour les reconstruire ensuite.
Cette information positionnelle s'exprime couramment via les definition levels et les repetition levels. En clair, ces niveaux aident le lecteur à distinguer « ce champ est nul », « cette liste est vide » et « cet enfant imbriqué appartient au même parent que la valeur précédente ». Si vous avez déjà relu des données imbriquées avec des valeurs nulles surprenantes ou des formes incohérentes, c'est généralement cette mécanique qui est en cause.
Sous le capot, les pages peuvent utiliser différents encodages selon les données et le comportement de l'écrivain. Vous croiserez l'encodage plain, par dictionnaire, run-length, le bit-packing, les encodages de type delta et le byte stream split dans de vrais systèmes. L'essentiel n'est pas de mémoriser chaque encodage. C'est de comprendre que Parquet stocke les valeurs dans des unités de page compactes et encodées plutôt qu'en texte brut ligne par ligne.
Comment le predicate pushdown et les page indexes accélèrent les requêtes
Une requête Parquet devient rapide quand le lecteur peut prouver que de grandes parties du fichier sont hors sujet avant d'ouvrir les pages de données. C'est là le gain. La compression aide sur les octets sur disque et sur le réseau. Le predicate pushdown aide sur quelque chose de plus précieux en production : moins de lectures, moins de décompressions et moins de travail dans le moteur d'exécution.
Le point de départ, ce sont les métadonnées du pied de page décrites dans la documentation du format de fichier Parquet. Outre le schéma et la disposition, Parquet peut stocker des statistiques par colonne pour chaque row group, dont les valeurs minimales, maximales et le nombre de valeurs nulles. Les moteurs utilisent ces statistiques pour tester votre filtre sur chaque row group avant d'analyser les données de colonne.
Un cas courant rend cela concret. Supposons que votre requête filtre sur :
WHERE event_date BETWEEN '2026-01-01' AND '2026-01-31'
Si les bornes event_date d'un row group se situent entièrement en mars, le moteur peut l'écarter à partir des seules métadonnées. Si un autre row group couvre des dates de janvier, ce groupe demande une inspection plus poussée. Le résultat est simple :
Les row groups dont le min et le max ne peuvent satisfaire le prédicat sont écartés.
Les row groups dont la plage recoupe le prédicat restent candidats.
Les groupes candidats exigent encore des lectures de pages ou des vérifications de valeurs pour confirmer les correspondances.
Cela paraît simple, mais deux détails de production comptent.
D'abord, les statistiques de row group ne valent que ce que vaut la disposition des données. Si les valeurs sont regroupées par event_date, les plages min et max sont étroites et l'élagage est net. Si le fichier a été écrit à partir de données fortement mélangées, chaque row group peut couvrir une large plage de dates, et les métadonnées perdent beaucoup en sélectivité. Le predicate pushdown fonctionne toujours. Il a simplement moins de matière.
Ensuite, les row groups sont une unité grossière. Ils fonctionnent comme des cartons dans un entrepôt. Si l'étiquette dit que tout le contenu date de mars, vous sautez le carton entier. Si elle dit que le carton couvre janvier à mars, vous devez l'ouvrir même si seuls quelques enregistrements de janvier pourraient correspondre.
C'est là que les page indexes entrent en jeu. Parquet prend en charge des métadonnées optionnelles au niveau page via ColumnIndex et OffsetIndex, définis dans la spécification du page index Parquet. ColumnIndex stocke les bornes de page et les informations de valeurs nulles d'une colonne. OffsetIndex associe les pages à des décalages physiques et à des plages de lignes. Ensemble, ils donnent au lecteur une carte plus fine à l'intérieur du row group.
L'effet pratique passe facilement inaperçu si vous ne lisez que des tutoriels du chemin idéal. Sans page indexes, un moteur peut savoir qu'un row group mérite un examen et lire malgré tout beaucoup de pages à l'intérieur. Avec eux, le moteur peut écarter les pages non concordantes et se rapprocher de celles qui pourraient satisfaire le filtre. Pour des requêtes sélectives sur de gros row groups, cela supprime beaucoup d'E/S inutiles.
La distinction mérite d'être gardée au clair :
Les statistiques de row group décident s'il faut lire un row group tout court.
Les page indexes décident quelles pages de ce row group méritent d'être touchées.
C'est aussi pourquoi le réglage de Parquet peut sembler incohérent d'un outil à l'autre. La prise en charge côté écriture des page indexes varie. Côté lecture aussi. Un moteur les exploite agressivement. Un autre les ignore et se rabat sur le seul élagage par row group. En 2026, cet écart apparaît encore dans les piles mixtes, surtout là où Spark, Trino, des moteurs d'entrepôt et des lecteurs Python touchent les mêmes fichiers.
Les filtres de Bloom appartiennent à la même famille de mécanismes d'évitement, mais répondent à un problème plus étroit. Ils peuvent aider aux tests d'appartenance sur des colonnes à forte cardinalité comme user_id, à condition que l'écrivain les ait produits et que le lecteur sache s'en servir. Quand une équipe dit « le pushdown Parquet ne marche plus », la cause profonde n'est souvent pas le format. C'est l'une de ces mécaniques : mauvais regroupement, statistiques faibles, page indexes non pris en charge, ou un lecteur qui retombe sur une analyse complète.
Cet état d'esprit diagnostique compte davantage aujourd'hui, car de nouveaux types logiques, dont Variant, les données géospatiales et le type FILE, élargissent ce que les équipes mettent dans Parquet. À mesure que les fichiers portent des données plus complexes, la question n'est plus seulement « puis-je lire ce fichier ? ». C'est « quelles parties de ce fichier mon moteur peut-il écarter sans risque, et sur quelles métadonnées s'appuie-t-il pour le décider ? ».
Parquet face à CSV, Avro et ORC
Choisir Parquet devient plus simple quand on cesse de demander quel format est « le meilleur » et qu'on demande quel schéma d'accès il faut soutenir.
CSV est universel et facile à inspecter. Il est aussi faible sur le schéma, le typage et les lectures sélectives. Avro est orienté lignes et convient mieux quand écrire et lire des enregistrements complets compte plus que parcourir quelques colonnes. ORC est en colonnes comme Parquet et reste solide dans les environnements très orientés Hive. Parquet se place au milieu comme le format analytique le plus répandu entre moteurs.
Les arbitrages en un coup d'œil
Format | Disposition | Schéma | Compression | Coût d'analyse | Coût d'écriture | Idéal pour |
|---|---|---|---|---|---|---|
Parquet | En colonnes, organisé en row groups et column chunks | Intégré au fichier | Forte, favorisée par la disposition en colonnes et l'encodage | Faible pour les requêtes analytiques sélectives | Plus élevé que le texte brut et souvent plus lourd que les formats lignes simples | Analytique, lacs de données, échange entre moteurs |
CSV | Texte brut orienté lignes | Aucun intégré au format | Compression externe possible, mais le fichier lui-même est du texte | Élevé car les lecteurs doivent analyser des lignes entières et déduire les types | Très faible | Export simple et échange lisible par un humain |
Avro | Binaire orienté lignes | Forte prise en charge du schéma | Encodage binaire compact | Meilleur pour l'accès par ligne que pour l'élagage de colonnes | Bon pour les flux à forte écriture | Streaming, données d'événements, lectures au niveau ligne |
ORC | En colonnes | Schéma et métadonnées intégrés | Forte | Faible pour les analyses analytiques | Arbitrages de conception proches de Parquet | Analytique centrée sur Hive et écosystèmes de tables |
Comment aborder la décision
Utilisez CSV quand la portabilité et l'inspection humaine comptent plus que l'efficacité analytique. Il reste la lingua franca de l'échange de base, mais les équipes paient ensuite cette commodité en analyse syntaxique, typage faible et lectures gaspillées.
Utilisez Avro quand vous tenez à la fidélité des lignes, à l'évolution du schéma dans des pipelines d'événements et aux profils à forte écriture. Les systèmes connectés à Kafka y aboutissent souvent, à bon droit.
Utilisez ORC quand votre pile est liée à un traitement de style Hive et à des comportements de table propres à ORC. Il résout beaucoup des mêmes problèmes que Parquet, mais le centre de gravité diffère.
Utilisez Parquet quand la plupart des charges sont des analyses filtrées, des projections et de l'agrégation sur de grands jeux de données. C'est le format qui survit le mieux aux changements d'outils, parce que tant de lecteurs le comprennent.
Travailler avec Parquet dans Spark, Hive et Pandas
Le plus intéressant avec Parquet n'est pas read_parquet() en soi. C'est que différents écrivains laissent des empreintes différentes, et que ces empreintes pèsent sur les lectures ultérieures.
Spark, Hive et Pandas peuvent tous travailler sur le même jeu Parquet, mais ils ne l'écrivent pas toujours pareil. Cela se voit dans la disposition des row groups, le comportement de tri, la qualité des statistiques, la structure des répertoires de partition et l'efficacité avec laquelle un autre moteur pourra élaguer ensuite.
Spark et les jeux partitionnés
Dans Spark, le schéma habituel est direct : lire un DataFrame, le transformer et réécrire du Parquet vers le stockage objet. Les équipes combinent souvent cela avec partitionBy(...), qui crée des arborescences de style Hive comme event_date=2026-01-01/. Ces répertoires deviennent des colonnes de partition virtuelles à la lecture.
C'est utile, mais cela crée aussi un piège. Les équipes partitionnent parfois trop finement et se retrouvent avec trop de petits fichiers. Une fois là, les métadonnées de pied de page se fragmentent entre de nombreux objets et la planification des requêtes devient plus bruyante.
Si vous surveillez déjà la fiabilité de Databricks ou de Spark, la surveillance de la qualité des données sur Databricks devient pertinente, car les erreurs de disposition se manifestent d'abord par un comportement d'exécution incohérent, et non par de nettes erreurs de format.
Hive et son chemin Parquet mature
Hive prend en charge Parquet depuis des années et, dans beaucoup d'environnements, le lit nativement via les abstractions de table habituelles. Le point opérationnel important est qu'une table Hive peut sembler « logique », alors que la performance vient toujours de la disposition physique Parquet en dessous. Si les fichiers sont mal partitionnés ou portent des statistiques faibles, Hive ne peut pas rattraper cela avec des métadonnées seules.
Surprises avec Pandas et PyArrow
Pandas atteint généralement Parquet via PyArrow ou fastparquet. Avec PyArrow, sélectionner les colonnes à la lecture préserve le bénéfice principal de l'accès en colonnes. C'est une bonne habitude quand les analystes n'ont besoin que d'une tranche du jeu.
Le problème subtil est à l'écriture. Un fichier Parquet produit dans un notebook fonctionne souvent bien en analyse locale, mais se comporte mal ensuite quand un autre moteur tente de pousser des filtres ou de paralléliser les analyses. Cela ne veut pas dire que Pandas a tort. Cela veut dire que les valeurs par défaut d'un notebook ne sont pas un design de stockage de production.
Si un jeu de données naît dans un notebook et finit dans un pipeline partagé, réécrivez-le avec des réglages de production avant de le déclarer terminé.
Un dernier point que beaucoup d'équipes manquent : un jeu écrit par Spark et lu par DuckDB peut se comporter autrement qu'un jeu écrit par PyArrow et lu par Spark. Même format, décisions d'écrivain différentes.
Compression, encodage, partitionnement et évolution du schéma
Un jeu Parquet peut paraître sain de l'extérieur et mal se comporter en production. Les fichiers s'ouvrent. Les requêtes renvoient des lignes. Puis une table analyse bien plus de données que prévu, une autre produit des centaines de fichiers minuscules, et une troisième casse après une mise à jour de l'écrivain. Ces quatre leviers l'expliquent en général : compression, encodage, partitionnement et évolution du schéma.
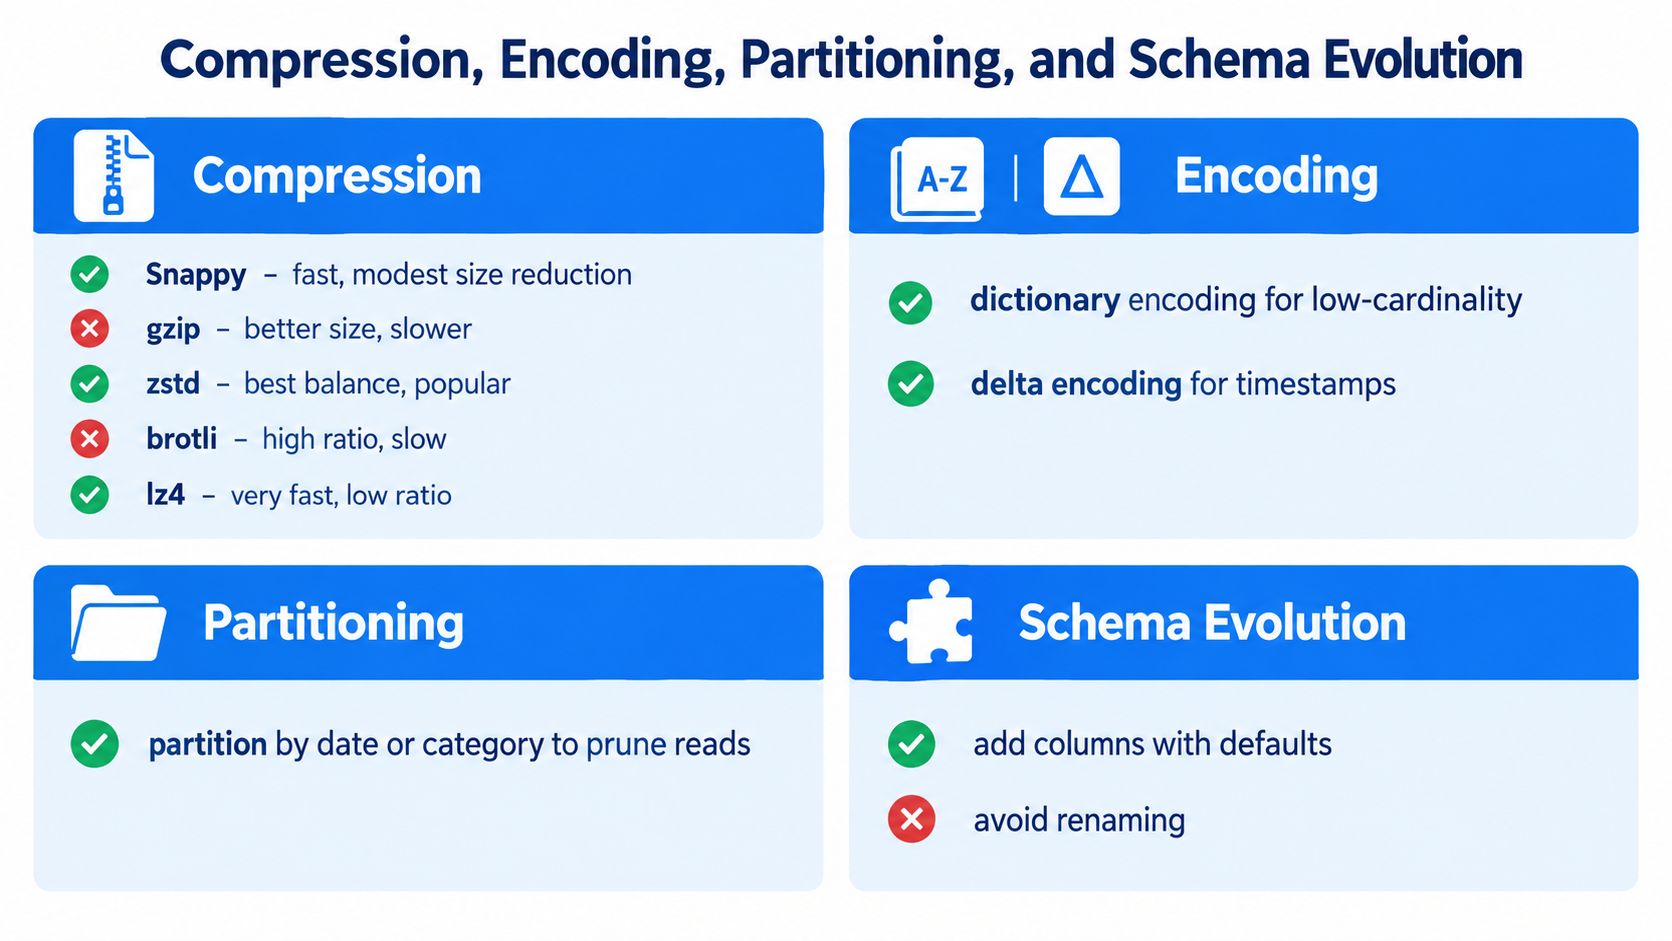
Compression et encodage résolvent des problèmes différents
La compression décide comment les octets sont comprimés pour le stockage. L'encodage décide comment les valeurs sont disposées avant que la compression ne les voie.
Cette distinction compte, car un encodage faible laisse au compresseur du travail inutile. Un bon encodage peut rendre une compression ordinaire bien meilleure.
Pour la compression, l'arbitrage porte en général sur CPU contre taille :
Snappy est un choix par défaut courant quand la rapidité de lecture et d'écriture compte plus que la taille minimale.
gzip compresse souvent davantage, mais coûte plus de CPU.
zstd convient bien à de nombreuses charges mixtes car il équilibre souvent ratio et vitesse.
brotli peut avoir du sens quand la réduction du stockage prime sur le débit d'écriture.
lz4 privilégie la vitesse.
L'encodage est plus sensible à la forme de la colonne. L'encodage par dictionnaire fonctionne bien quand une colonne répète le même petit ensemble de valeurs, comme des codes pays ou des champs de statut. Les encodages delta conviennent aux entiers ordonnés, aux horodatages et aux valeurs qui évoluent progressivement. Le byte stream split peut aider certaines colonnes en virgule flottante. Si la compression consiste à faire la valise, l'encodage est la façon de plier les vêtements avant.
La taille des row groups fixe l'enveloppe de performance
Les row groups comptent parmi les réglages les moins spectaculaires de Parquet et parmi les plus coûteux à rater. Ils déterminent la quantité de données regroupées pour l'analyse, l'évitement et le travail parallèle.
Les recommandations de configuration Parquet préconisent de grands row groups, car des groupes plus grands améliorent souvent l'efficacité d'analyse et la compression. Dans les systèmes réels, les équipes visent fréquemment plus petit pour équilibrer les limites mémoire, le dimensionnement des tâches et le comportement d'élagage. Un row group plus grand donne à chaque tâche plus de travail utile. Un plus petit donne au moteur plus d'occasions d'écarter des données inutiles.
La question n'est donc pas de savoir si de grands row groups valent toujours mieux. La bonne question est : vos charges profitent-elles davantage d'un débit d'analyse supérieur ou d'un évitement plus fin ?
Si les analystes filtrent beaucoup sur une plage de dates étroite, des row groups surdimensionnés peuvent forcer les lecteurs à tirer plus de données que nécessaire. Si la charge consiste surtout en analyses larges, les groupes plus grands paient souvent.
Le partitionnement doit refléter la façon dont les données sont vraiment lues
Le partitionnement fonctionne au mieux quand il suit un filtre grossier et stable comme la date d'événement, la région ou un autre champ présent dans de nombreuses requêtes. Il fonctionne mal quand les équipes partitionnent sur des colonnes à forte cardinalité parce qu'elles paraissent sélectives sur le papier.
Une bonne règle est simple. Partitionnez pour la découverte des fichiers, pas pour chaque prédicat imaginable.
Le sur-partitionnement crée une arborescence coûteuse à lister, coûteuse à planifier et sujette à la prolifération de fichiers minuscules. Le sous-partitionnement pousse trop de travail de filtrage dans les fichiers eux-mêmes. La bonne disposition est généralement ennuyeuse. C'est bon signe.
Trier à l'intérieur des partitions est souvent aussi important que le partitionnement lui-même. Si les lignes aux valeurs proches sont regroupées, les statistiques Parquet et les page indexes ont plus de chances d'aider le lecteur à écarter proprement des données.
L'évolution du schéma est là où apparaît la dette de compatibilité
Ajouter une colonne nullable est généralement facile. Renommer un champ d'un moteur à l'autre, changer des types logiques ou réécrire des structures imbriquées, c'est là que les ennuis commencent.
Parquet est assez permissif pour que des changements semblent fonctionner pendant des semaines avant d'échouer chez un lecteur en aval. Un moteur peut interpréter un type logique d'une façon, un autre l'élargir, et un troisième matérialiser des valeurs nulles. C'est pourquoi l'évolution du schéma doit être traitée comme un processus de compatibilité, pas comme une case à cocher du format.
La complexité augmente parce que l'écosystème Parquet continue de bouger. Le blog du projet Apache Parquet suit les travaux en cours sur des fonctionnalités comme Variant pour les données semi-structurées, les types géospatiaux et le type logique FILE, ainsi que des discussions plus larges de format et de versionnage qui comptent pour la compatibilité entre moteurs. Ces fonctionnalités sont utiles, mais elles posent aux équipes de production une question pratique : quels lecteurs de votre pile savent les analyser correctement aujourd'hui ?
C'est là qu'un suivi de schéma discipliné aide. Un outil comme le suivi de la dérive de schéma pour les pipelines Parquet peut détecter des changements structurels avant qu'ils n'apparaissent comme des désaccords silencieux entre lecteurs.
L'état d'esprit sûr est conservateur. Utilisez les fonctionnalités récentes de Parquet quand elles résolvent un vrai problème, mais encadrez-les par des vérifications de compatibilité des lecteurs, testez des fichiers écrits par les moteurs réels de votre pile, et traitez les mises à jour d'écrivain comme des changements de comportement, pas comme des correctifs de routine.
Diagnostiquer les échecs de fichiers Parquet en production
Quand un fichier Parquet refuse de se lire, les ingénieurs accusent souvent le format en premier. C'est généralement le mauvais réflexe. Les retours récents de la communauté montrent que les échecs réels les plus difficiles portent souvent sur l'intégrité du fichier et le transport, pas sur la conception de Parquet, et que le même symptôme peut venir de problèmes de stockage, d'écrivain ou de lecteur plutôt que de la structure du fichier, comme l'expose la FAQ de diagnostic des échecs Parquet.
Une meilleure approche consiste à trier les échecs par archétypes.
Quatre classes de défaillance qui font gagner du temps
Échecs de récupération
Le lecteur n'a jamais reçu les bons octets. Pensez aux listings d'objets périmés, aux mauvaises entrées de manifeste, aux téléchargements partiels ou à une page d'erreur HTML enregistrée avec l'extension.parquet.Échecs de pied de page
L'objet existe, mais le pied de page manque, est corrompu ou illisible. Les envois tronqués et les écritures multipart incomplètes apparaissent souvent ici.Échecs de liaison de schéma
Le fichier s'ouvre, mais le lecteur associe les types autrement que l'écrivain ne l'entendait. Vous obtenez des valeurs nulles silencieuses, des champs imbriqués cassés ou des incohérences de type logique.Échecs de décodage et de matérialisation
Les métadonnées semblent correctes jusqu'à ce que le moteur décode les pages ou matérialise des valeurs en mémoire. La compatibilité de compression, la corruption de pages et les limites propres au lecteur se rangent souvent ici.
Un ordre de triage pratique
Suivez une séquence simple avant de modifier du code :
Vérifiez d'abord la récupération. Confirmez que l'objet est complet et qu'il s'agit bien d'un fichier Parquet, pas d'un contenu mal étiqueté.
Contrôlez les marques d'extrémité et le pied de page. Si la fin est cassée, rien au-dessus n'a d'importance.
Inspectez le schéma et les types logiques. Comparez la sortie de l'écrivain aux attentes du lecteur.
Seulement ensuite, déboguez le décodage. Ne sautez pas aux théories sur les codecs avant de savoir que le fichier est entier.
Les pipelines Parquet cassés commencent souvent hors de Parquet. Le stockage, le transport, le nommage et les politiques de cycle de vie des objets causent une part surprenante des ennuis.
La surveillance des fichiers et l'observabilité des pipelines aident plus que la seule connaissance du format. Si les équipes utilisent déjà la supervision du data lake, elles repèrent souvent des partitions manquantes, des arrivées tardives ou des changements brusques de schéma avant qu'un lecteur ne lève une erreur bas niveau.
Le changement de perspective essentiel est simple. Ne demandez pas « pourquoi Parquet est-il cassé ? ». Demandez « à quelle étape les octets, les métadonnées, la liaison de schéma ou le chemin de décodage ont-ils cessé d'être fiables ? ».
Checklist d'exploitation pour les fichiers Parquet
Un Parquet sain n'arrive pas parce que le format est bon. Il arrive parce que les équipes appliquent les mêmes règles chaque fois qu'elles écrivent, valident et publient des fichiers.

La checklist à coller dans un runbook
Figez les versions d'écrivain. Gardez des versions de bibliothèque stables entre les jobs qui écrivent le même jeu. Des écrivains mélangés produisent souvent des comportements mélangés.
Vérifiez les statistiques du pied de page. Assurez-vous que les métadonnées de row group existent et sont assez plausibles pour que les lecteurs élaguent efficacement.
Choisissez les cibles de row group à dessein. Beaucoup d'équipes tournent autour de 128 Mo en pratique, tandis que les recommandations du projet évoquent 512 Mo à 1 Go pour de grands row groups selon la charge et le moteur, d'après les recommandations Parquet citées plus haut.
Auditez la disposition des partitions. La structure de répertoires devrait refléter la façon dont les gens interrogent les données.
Testez l'évolution du schéma avant la fusion. Ajouter des colonnes est une chose. La dérive des types logiques en est une autre.
Revoyez les choix de compression et d'encodage. N'héritez pas des valeurs par défaut d'un notebook en supposant qu'elles conviennent à la production.
Validez l'intégrité du transport. Un écrivain correct ne vous protège pas des envois cassés ni des surprises du stockage objet.
Observabilité et gouvernance rendent cela durable
Cette checklist gagne en utilité quand elle est liée à des contrôles automatisés. Great Expectations peut valider des règles de schéma et de contenu. Apache Griffin peut soutenir des flux de qualité des données. Datafold peut aider à comparer des changements entre environnements. digna est une autre option de cette catégorie. Elle s'exécute dans l'environnement du client et surveille le comportement des données, la Timeliness, les validations et les changements de schéma sur les pipelines, ce qui correspond aux régressions Parquet silencieuses que de simples contrôles de fichier laissent passer.
La gouvernance a aussi sa place ici. Les métadonnées de colonne peuvent porter des étiquettes PII. Les formats de table et les couches de catalogue peuvent imposer rétention et politiques d'accès. Les permissions du stockage objet comptent toujours, car le fichier Parquet le plus propre du monde ne sert à rien si le mauvais job peut l'écraser.
Habitude opérationnelle : traitez chaque jeu Parquet à la fois comme un problème de format de fichier et comme un problème de contrat. La performance vient du format. La fiabilité vient du contrat.
Un fichier Parquet est simple à utiliser quand quelqu'un d'autre a fait les bons choix pour vous. En production, ce quelqu'un, c'est votre équipe.
Si Parquet porte des charges analytiques ou d'IA critiques dans votre environnement, digna peut vous aider à surveiller les parties qui échouent d'ordinaire : dérive de schéma, données manquantes ou tardives, problèmes de qualité au niveau des enregistrements et comportements inhabituels entre pipelines. C'est particulièrement utile quand un problème Parquet n'est pas du tout un problème de format, mais un problème de livraison, de métadonnées ou de contrat en amont. Jetez un œil à digna si vous voulez cette visibilité dans votre propre environnement.
La version de cette checklist au niveau du jeu de données, appliquée en continu plutôt que fichier par fichier, se retrouve dans la façon dont la gestion de la qualité des données fonctionne en pratique.
Questions fréquentes
Quand Parquet a-t-il été créé ?
Parquet a démarré comme un effort open source conjoint entre Twitter et Cloudera, avec Parquet 1.0 publié en juillet 2013, et est devenu projet de premier niveau de l'Apache Software Foundation le 27 avril 2015. Sa conception s'appuyait sur le découpage d'enregistrements à la Dremel, qui lui permet de représenter des structures imbriquées sans répéter les noms de champs à chaque ligne.
Comment Parquet stocke-t-il les données imbriquées comme les structs, listes et maps ?
Par découpage et réassemblage à la Dremel. L'écrivain décompose les enregistrements imbriqués en morceaux en colonnes et conserve assez d'informations positionnelles pour les reconstruire à la lecture, si bien que les noms de champs ne sont pas répétés par ligne. C'est pourquoi les schémas très imbriqués restent compacts au lieu de gonfler comme du JSON imbriqué.
Pourquoi un fichier Parquet ne se lit-il pas ?
Les problèmes d'intégrité et de transport causent plus d'échecs réels que le format lui-même. Un fichier sain commence et se termine par les octets magiques PAR1, si bien qu'une marque de fin manquante signale une troncature, un téléchargement partiel ou une page d'erreur HTML enregistrée en .parquet. Vérifiez la récupération avant de modifier du code.
Quelle taille de row group faut-il utiliser ?
Les row groups déterminent la quantité de données regroupées pour l'analyse, l'évitement et le travail parallèle, et comptent parmi les réglages les plus coûteux à rater. De plus grands groupes améliorent l'efficacité d'analyse mais élargissent le rayon d'impact quand les statistiques sont faibles ; de plus petits donnent aux lecteurs plus d'occasions d'écarter. Réglez-les sur des schémas d'analyse réels.
Comment garder des jeux Parquet fiables en production ?
Appliquez les mêmes règles à chaque écriture. Figez les versions d'écrivain pour que les jobs écrivant un même jeu ne produisent pas des comportements mélangés, partitionnez sur des filtres grossiers et stables, et validez avec les moteurs lecteurs plutôt qu'avec le seul écrivain. Des outils comme Great Expectations, Apache Griffin, Datafold et digna automatisent ces contrôles.



