La gestion des données dans les banques : guide 2026
|
7
minute de lecture

Les grands cadres de supervision définissent la gestion des données bancaires à travers quatre dimensions de contrôle mesurables : l’exactitude, l’intégrité, l’exhaustivité et l’actualité. Concrètement, il ne s’agit pas seulement de stocker les données, mais de prouver qu’elles restent fiables jusque dans les processus de risque, de finance et de reporting.
Les banques qui en font un simple exercice de documentation passent à côté de l’essentiel. Le vrai travail réside dans les contrôles opérationnels, les contrôles de fraîcheur, les rapprochements, le lineage et l’auditabilité sur l’ensemble du parcours des données, car des données obsolètes ou incomplètes se propagent rapidement une fois entrées dans les systèmes en aval.
Table des matières
Les dimensions de contrôle mesurées par les régulateurs
Quatre dimensions de contrôle offrent aux régulateurs un moyen concret d’évaluer la qualité des données bancaires : l’exactitude, l’intégrité, l’exhaustivité et l’actualité. Les banques doivent relier ces dimensions à la gouvernance, à une architecture de données intégrée et à des contrôles qualité mesurables, plutôt que de les laisser au stade de principes (BDO). Les conséquences opérationnelles sont immédiates. Un flux en retard peut fausser l’agrégation des risques, un champ manquant peut affaiblir un contrôle financier et un enregistrement incohérent peut propager des erreurs dans les couches de reporting qui reposent sur des données partagées.
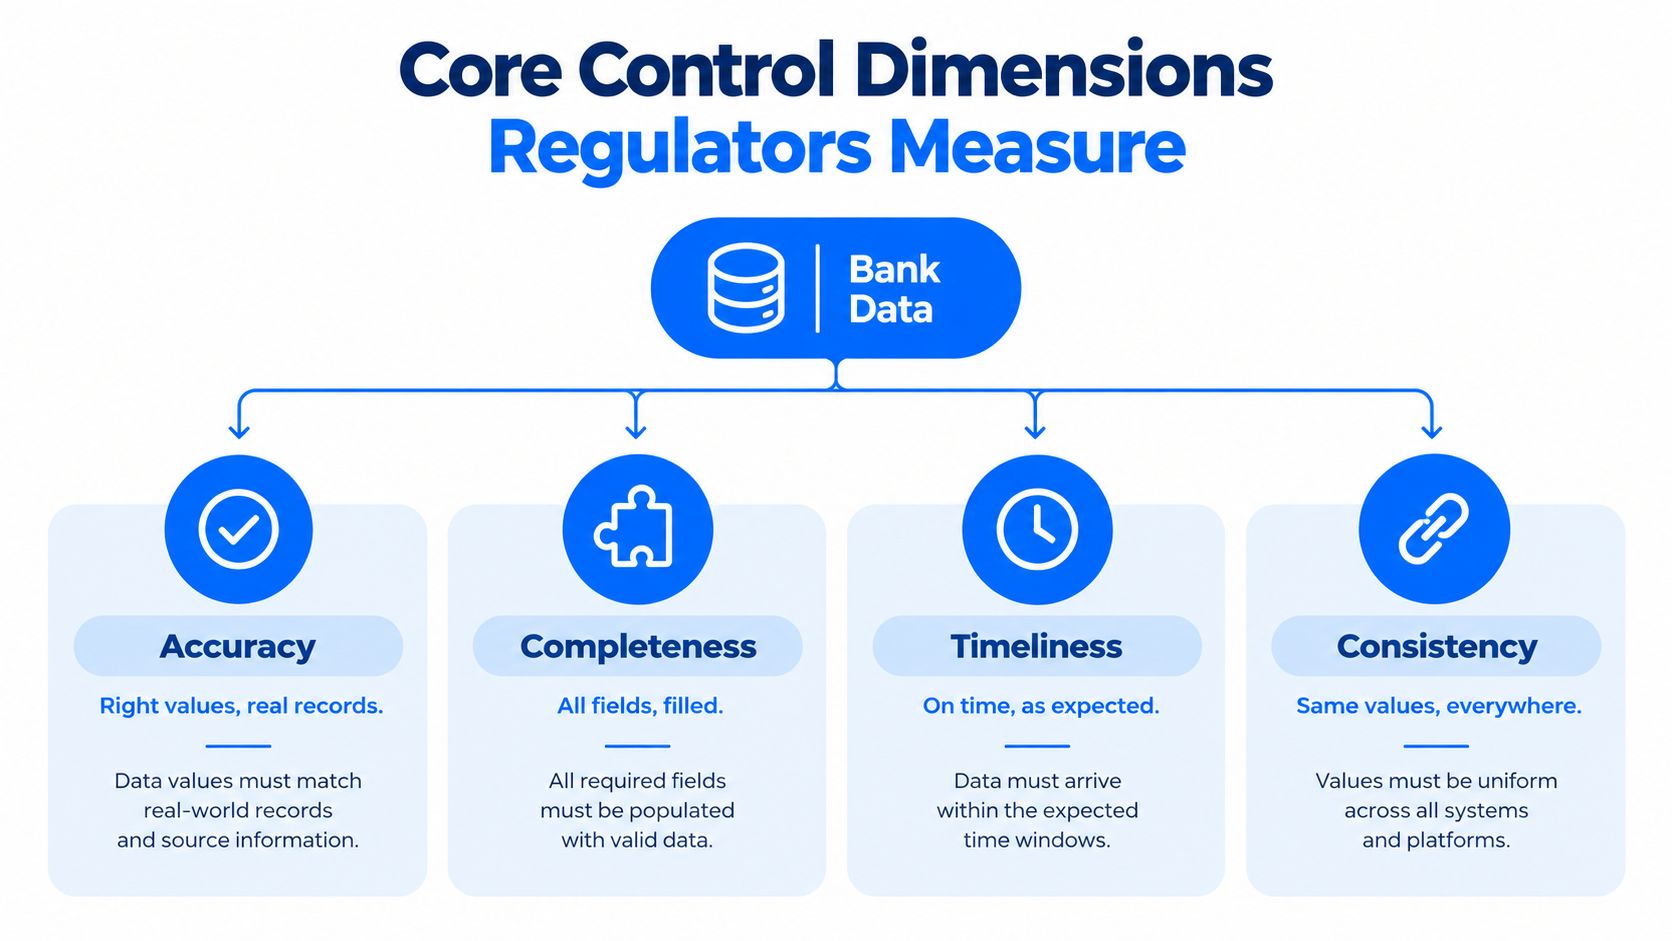
Ce que chaque dimension de contrôle signifie en pratique
L’exactitude signifie que les valeurs correspondent à l’enregistrement source de référence qu’elles sont censées représenter. Pour une banque, les soldes, les attributs clients, les classifications et les données de référence doivent concorder avec le système de référence validé, et pas seulement avec une copie dans un entrepôt de données qui est peut-être déjà périmée.
L’intégrité préserve les relations et le sens des enregistrements lorsqu’ils circulent entre les systèmes. Elle englobe des clés valides, des pistes d’audit complètes, des transformations maîtrisées et des définitions cohérentes. Sans ces contrôles, un chiffre publié peut conserver son format tout en perdant le sens qu’il avait au moment de la saisie.
L’exhaustivité couvre les champs, les enregistrements et les attributs requis pour un contrôle métier ou réglementaire. Un flux de transactions peut sembler sain tout en omettant un élément obligatoire. Les rapports en aval peuvent alors paraître complets tout en masquant une lacune significative.
L’actualité permet d’identifier les données qui arrivent trop tard pour l’usage prévu. Une banque peut disposer des enregistrements nécessaires, mais des données obsolètes ne peuvent servir ni à l’analyse de liquidité courante, ni aux stress tests, ni à l’agrégation des risques, ni au reporting réglementaire.
Règle pratique : traitez les contrôles de fraîcheur et les rapprochements comme des contrôles opérationnels, et non comme des tâches de nettoyage périodiques.
Le guide de la BCE sur l’agrégation efficace des données sur les risques et la notification des risques reprend ces mêmes dimensions et exige des KPI détaillés pour chacune d’elles (guide de la BCE). Un KPI utile doit montrer davantage que le succès ou l’échec d’une règle. Il doit identifier la source concernée, le pipeline, le responsable, le rapport en aval et le moment de la détection.
Cette distinction révèle l’écart entre la conception des contrôles et leur exécution. Une banque peut documenter un seuil de fraîcheur et ne découvrir pourtant un flux défaillant qu’une fois le rapport en retard. Les outils d’observabilité modernes peuvent surveiller les livraisons, les changements de schéma, les variations de volume et les échecs de règles sur l’ensemble du pipeline. La validation in-database permet de tester les soldes, les relations référentielles et les règles métier au plus près des données, avant que les défauts ne se propagent.
Commencez par séparer les contrôles qualité descriptifs des contrôles de maîtrise. Les règles descriptives repèrent les anomalies évidentes. Les règles de contrôle démontrent que le pipeline fonctionne dans les limites attendues avant que les données n’atteignent les processus de risque, de finance ou de reporting.
Utilisez un vocabulaire commun aux auditeurs, aux ingénieurs et aux responsables métier, puis reliez chaque règle à une conséquence métier. Les dimensions de la qualité des données constituent une référence utile pour ce vocabulaire. La gestion des données dans les banques devient une discipline opérationnelle lorsque les équipes peuvent mesurer chaque dimension, remonter les défaillances jusqu’à leur source et apporter la preuve de leur correction.
Modèles pratiques de gouvernance et de responsabilité
Une bonne gouvernance échoue lorsque personne n’est responsable d’un problème de données de bout en bout. Les banques ont besoin d’une responsabilité explicite, de procédures d’escalade claires et d’un lineage documenté pour que les défauts de qualité soient priorisés et corrigés au lieu d’être simplement consignés puis oubliés (Dunnixer). C’est toute la différence entre une charte de gouvernance et un modèle de contrôle qui fonctionne. L’une crée de la responsabilité sur le papier, l’autre change la façon dont les incidents circulent dans l’organisation.
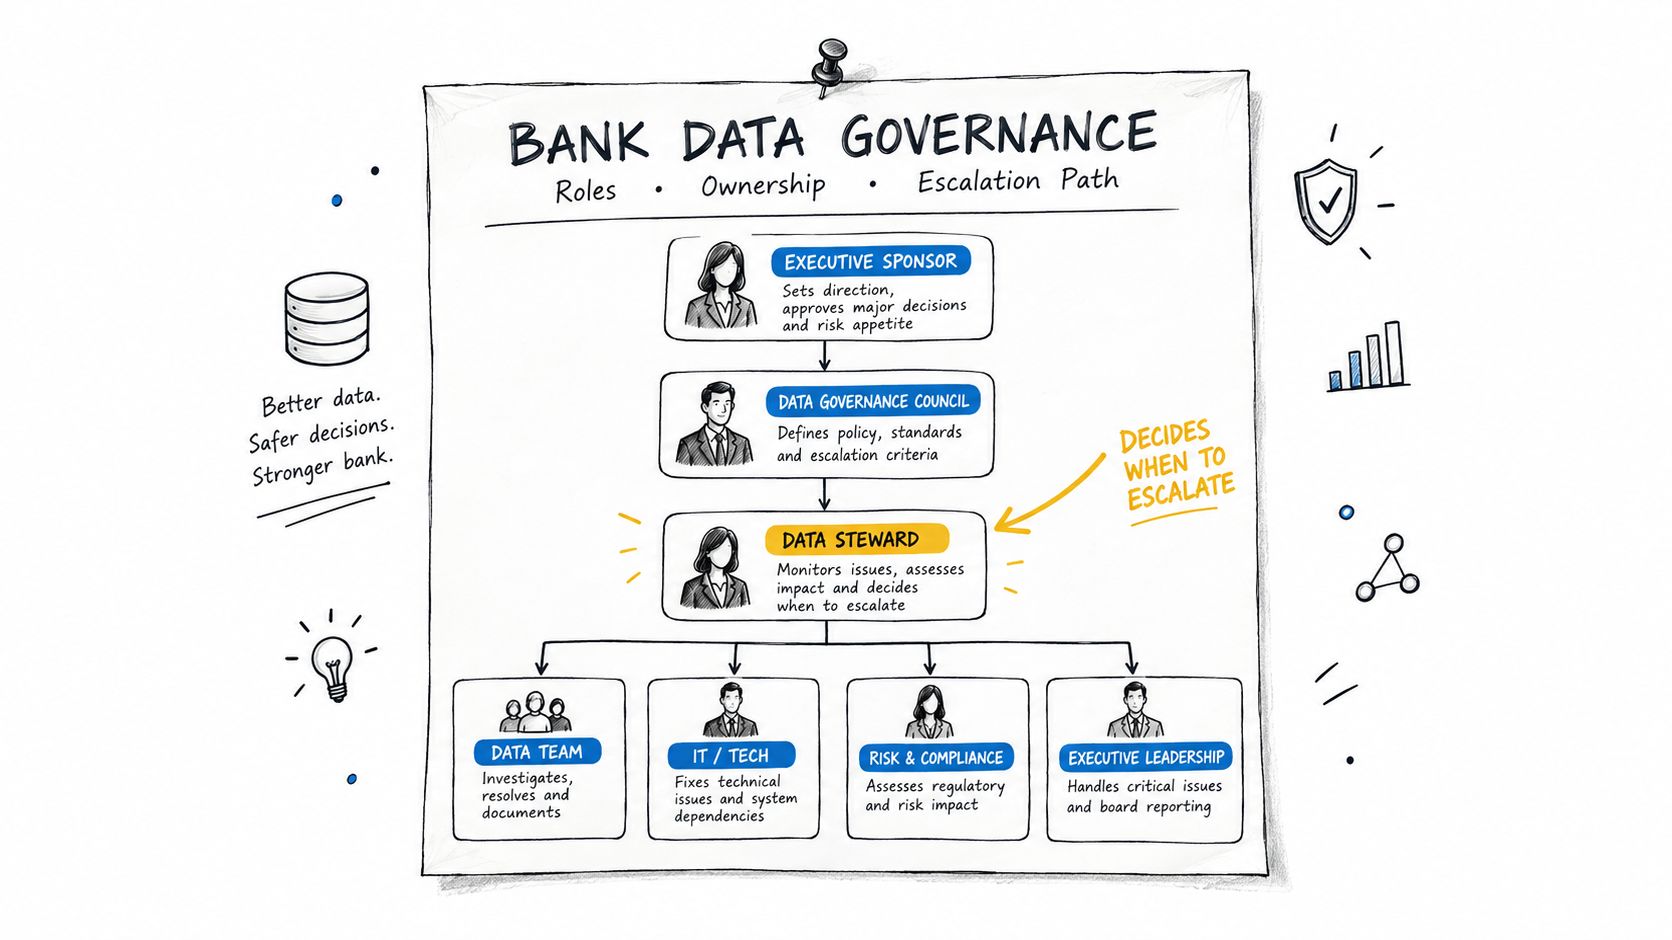
À quoi ressemble une responsabilité qui fonctionne
Une banque n’a pas besoin de plus de comités. Elle a besoin de responsables nommés pour les domaines de données critiques, d’un circuit d’escalade documenté et d’une définition partagée de ce que signifie « corrigé ». Si un flux de données de référence tombe en panne, le data steward doit savoir qui le prend en charge, qui approuve la correction et quels consommateurs en aval doivent être informés.
Les programmes les plus solides standardisent aussi les définitions critiques. Lorsqu’un client, un produit, une exposition ou un solde n’a pas le même sens d’un service à l’autre de la banque, chaque rapprochement devient plus difficile et chaque audit plus long. Des définitions standard réduisent les débats sémantiques et recentrent l’attention sur les véritables défauts.
La responsabilité n’est pas une ligne hiérarchique. C’est l’obligation de veiller à ce que les données continuent de fonctionner une fois la réunion terminée.
Une référence de qualité à jour compte pour la même raison. Si personne ne sait à quoi ressemble la « normale », une dérive silencieuse peut rester en production pendant des semaines avant que quiconque ne la remarque. C’est particulièrement dangereux dans les banques aux environnements hétérogènes, où plateformes centrales, data marts et couches de reporting interprètent chacun le même enregistrement de façon légèrement différente.
Notre article sur la gouvernance des données financières s’inscrit bien dans ce modèle, car la gouvernance ne fonctionne que si elle relie politique, stewardship et surveillance opérationnelle. En pratique, les meilleures banques organisent la responsabilité des contrôles autour du parcours des données, et non autour de frontières floues entre départements. Le responsable du système source, le steward de la définition métier et le consommateur du rapport ont ainsi chacun des obligations définies.
L’écueil à éviter
Le schéma d’échec le plus courant est simple. Un problème de qualité est consigné, mais personne n’a l’autorité nécessaire pour corriger la source, si bien que l’équipe applique un contournement en aval. Ce contournement permet au rapport d’avancer, mais il masque le problème d’origine et en crée un second dans le lineage.
C’est pourquoi la gouvernance doit inclure l’escalade. Si un défaut touche un jeu de données réglementaire, le problème ne doit pas attendre un cycle de revue mensuel. Il doit suivre un circuit défini qui déclenche l’action, la collecte de preuves et un suivi avec un responsable désigné.
Les banques qui y parviennent ne comptent pas sur des exploits individuels. Elles s’appuient sur la clarté des rôles, des définitions standard et la discipline de traiter les problèmes de qualité comme des incidents opérationnels, et non comme du bruit administratif.
Exigences BCBS 239 et architecture de conformité
BCBS 239 reste la référence, car il relie l’agrégation des données sur les risques aux attentes des superviseurs. Le cadre définit 14 principes pour une agrégation efficace des données sur les risques et une notification des risques efficace, afin d’aider les banques à produire des informations sur les risques exactes, à jour et complètes, y compris en période de tensions (BRI). Ses exigences dépassent largement l’équipe de reporting. Elles façonnent la gouvernance, l’architecture, la conception des contrôles et la capacité de la banque à agréger les informations sur les risques de manière cohérente entre entités juridiques et lignes métier.
Dimension | Exigence | Impact opérationnel |
|---|---|---|
Agrégation | Produire les données sur les risques au moyen de processus largement automatisés afin de réduire les erreurs | Moins de manipulations manuelles, moins d’erreurs de conversion, une production plus rapide |
Couverture | Rendre les données disponibles pour l’ensemble des lignes métier, entités juridiques, types d’actifs, régions et regroupements concernés | Une meilleure visibilité sur les expositions, les concentrations et les risques émergents |
Lineage | Tracer les données de leur saisie jusqu’au reporting final, y compris au niveau de chaque attribut | Une meilleure auditabilité et une isolation plus rapide des défauts |
L’automatisation compte, car chaque transfert manuel crée un nouveau point de défaillance. Les collaborateurs peuvent ressaisir des valeurs, retarder une soumission ou appliquer une logique de tableur qui n’entre jamais dans la conception formelle des contrôles. Les workflows automatisés réduisent ces points de défaillance, mais ils ne remplacent pas la responsabilité des contrôles. Ils rendent les contrôles définis reproductibles et mesurables à grande échelle.
La couverture constitue un test architectural distinct. L’agrégation des risques doit représenter l’établissement dans son ensemble, y compris les entités juridiques, régions, groupes d’actifs et vues de reporting concernés. En exclure un seul peut laisser la banque avec un rapport soigné et une vision des risques incomplète. La conception doit donc prévoir un périmètre explicite, des règles d’inclusion et des contrôles qui repèrent les populations manquantes avant le reporting.
Le lineage constitue la couche de preuve. Les recommandations prudentielles associées à BCBS 239 insistent sur la traçabilité de la saisie des données jusqu’au reporting final, y compris la capacité à suivre chaque attribut (EY). Un diagramme de lineage ne prouve pas à lui seul que le contrôle fonctionne. Les équipes ont besoin de preuves d’exécution montrant la valeur source, chaque transformation, le résultat de la validation et la sortie du rapport.
Le guide de la BCE ajoute un niveau de détail opérationnel en exigeant des banques qu’elles définissent des KPI pour surveiller les dimensions de la qualité des données. L’architecture de conformité passe ainsi d’une documentation statique à une observation continue. Les outils d’observabilité modernes peuvent mettre en évidence les problèmes de fraîcheur, de volume, de schéma et les échecs de règles dans des pipelines fragmentés, tandis que la validation in-database peut tester les enregistrements au plus près de l’endroit où ils sont créés ou modifiés.
Pour les détails de mise en œuvre, consultez notre guide pour respecter les principes BCBS 239 grâce à une qualité des données pilotée par l’IA.
Test opérationnel : lorsqu’un chiffre de risque change, l’équipe doit pouvoir identifier sa source, ses transformations, ses contrôles de validation et les preuves associées sans reconstitution manuelle.
Les banques présentent souvent une couverture partielle des contrôles comme une couverture BCBS 239. La distinction est importante. Des lacunes dans le lineage, l’automatisation ou le périmètre de l’établissement peuvent rester invisibles jusqu’à ce qu’une période de tensions augmente les volumes de reporting ou révèle des données incohérentes. Une architecture résiliente doit faire apparaître ces lacunes grâce à la surveillance, sans attendre qu’une revue prudentielle ou un incident de reporting les mette au jour.
Pourquoi les contrôles échouent sans responsabilité à la source
Ce qui est frustrant dans la gestion des données bancaires, c’est que des contrôles peuvent paraître solides sur le papier et échouer malgré tout en production. Une étude européenne de 2025 sur le reporting réglementaire a montré que 90 % des banques disposaient d’au moins trois contrôles de qualité des données et 66 % d’une architecture de données centralisée, mais que seules 18 % déclaraient une mise en œuvre complète de BCBS 239 et à peine 24 % une documentation de lineage étendue (Deloitte). La même étude a constaté que les données source manquantes ou erronées restaient la première cause d’erreurs de reporting, citées respectivement par 56 % et 50 % des banques.
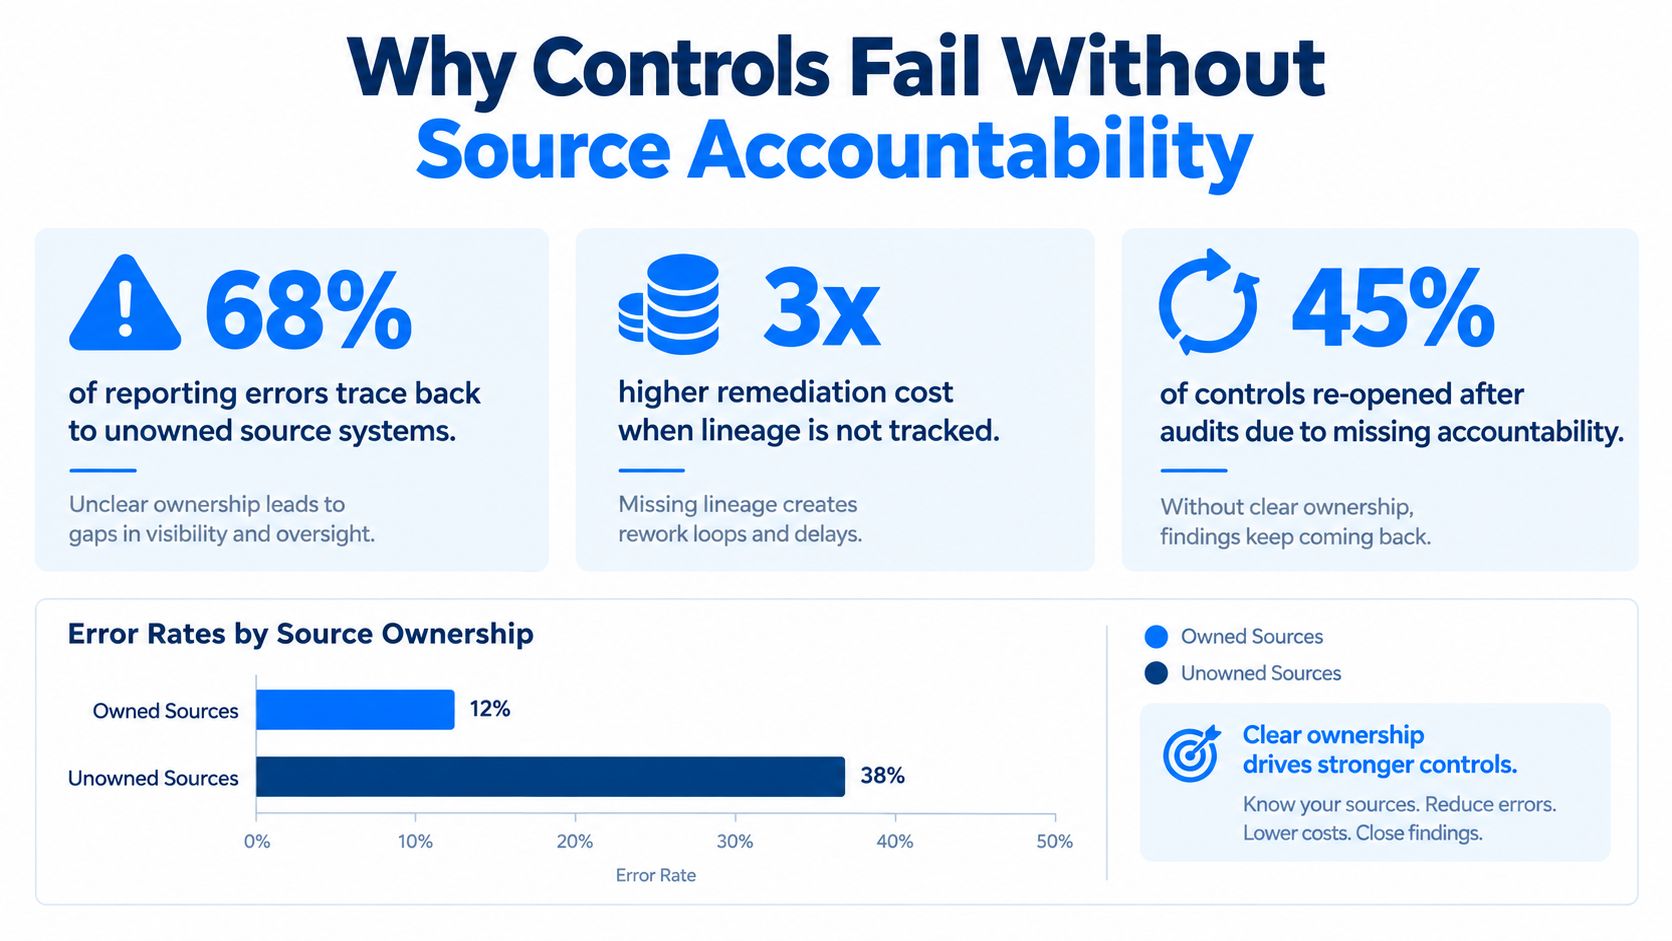
Pourquoi les contrôles en place manquent encore la cause racine
C’est la leçon à contre-courant que la plupart des banques doivent entendre. Le facteur limitant n’est souvent pas le manque de contrôles, mais la faiblesse de la responsabilité sur les données source, la fragmentation des flux et une visibilité insuffisante du lineage. Les équipes peuvent installer des règles de validation, mais si personne n’est responsable du système source et que personne ne peut remonter une valeur erronée jusqu’à son origine, le même défaut ressurgit sans cesse dans différents rapports.
C’est pourquoi la gestion des incidents est si importante. Consigner un problème n’est pas la même chose que le résoudre. Si le défaut se situe en amont, l’équipe en aval ne peut que traiter les symptômes, pas la cause.
Notre guide sur les responsabilités du data owner correspond à cette réalité opérationnelle. La responsabilité doit remonter jusqu’à la source, car c’est là que commence l’obligation de rendre des comptes et là que se trouve généralement la possibilité de corriger.
L’effet des flux fragmentés sur la remédiation
Les flux fragmentés rendent la remédiation coûteuse d’une manière facile à sous-estimer. Une banque peut corriger le rapport visible, mais sans lineage, chaque consommateur en aval doit revalider le même problème de son côté. L’effort de vérification se multiplie et la clôture est retardée.
Ils affaiblissent aussi la réponse aux audits. Lorsque les auditeurs demandent comment un chiffre a été produit, les équipes ont besoin d’un chemin allant de la saisie de l’enregistrement jusqu’à la sortie du rapport, et non d’un assemblage disparate de captures d’écran et de notes de tickets. Si le lineage est mince, la banque peut prouver qu’un contrôle a été exécuté, mais pas que les bonnes données y sont passées.
Si l’équipe ne sait décrire que le symptôme, c’est encore le problème à la source qui dirige la banque.
Un meilleur diagnostic consiste à se demander si l’organisation peut remonter les exceptions jusqu’à leurs points d’origine. Si la réponse est non, les contrôles agissent comme des filtres et non comme des mécanismes de responsabilité. Cette distinction est importante, car des filtres peuvent réduire les erreurs visibles tout en laissant le processus de production inchangé.
Les banques qui sortent de ce schéma font généralement deux choses différemment. Elles attribuent la responsabilité à la source et conçoivent des contrôles qui conservent la preuve du chemin suivi par les données. C’est cette combinaison qui comble l’écart entre la conception des contrôles et leur exécution.
Le fossé du modèle opérationnel prêt pour l’IA
Les banques savent que les données sont essentielles pour l’IA, mais beaucoup peinent encore à passer de l’ambition à l’exécution. Une récente enquête de KPMG auprès des banques a montré que 93 % des répondants citaient la confidentialité des données et les risques, 89 % la qualité des données et 81 % la complexité de l’existant et de l’intégration comme principaux défis de modernisation, alors que 68 % déclaraient avoir une vision cible et 65 % une feuille de route et un modèle de financement (enquête bancaire KPMG). Cet écart en dit long. La stratégie existe. L’ossature opérationnelle, elle, manque souvent.
Là où les programmes d’IA s’enlisent
Le premier point de rupture est généralement la confiance. Si la qualité des données est inégale, les équipes ne s’y fieront pas pour l’entraînement des modèles, leur surveillance ou la recherche documentaire pour la GenAI. Cela ralentit l’expérimentation avant même que le premier pilote ne produise quoi que ce soit d’utile.
Le deuxième point de rupture est l’intégration. Les systèmes hérités compliquent le transfert de données validées entre les workflows de risque, de finance et d’IA sans créer de nouvelles copies ni de nouveaux rapprochements. Il en résulte une pile technologique moderne en surface et fragile en dessous.
Le troisième point de rupture est la pression de la gouvernance. Les banques n’ont pas seulement besoin de données qui fonctionnent techniquement, elles ont besoin de données capables de passer une revue de conformité. Si les données d’entrée d’un modèle ne peuvent être ni tracées, ni expliquées, ni validées, la banque risque d’avoir un cas d’usage prometteur qui ne franchit jamais la revue opérationnelle.
Notre ressource sur les données prêtes pour l’IA est pertinente ici, car être prêt pour l’IA tient surtout à la solidité des contrôles, pas à l’effet de mode. Si le data pipeline sous-jacent ne peut pas démontrer la fraîcheur, la structure et la traçabilité des données, la couche d’IA hérite de cette faiblesse.
À quoi ressemble un modèle opérationnel réaliste
Un modèle réaliste ne commence pas par le modèle. Il commence par le parcours des données. Les banques ont besoin d’une validation là où les données arrivent, de contrôles d’actualité là où les flux sont livrés et d’un lineage qui reste intact lorsque les enregistrements sont transformés ou joints.
C’est là que l’observabilité devient utile. Les équipes doivent voir quand un flux change, quand un schéma évolue ou quand une source cesse de livrer à temps, avant que le problème ne s’inscrive dans les analyses en aval. L’intérêt ne se limite pas à la rapidité. Il s’agit d’empêcher que des données défaillantes ne deviennent un modèle défaillant.
Être prêt pour l’IA est d’abord un problème d’exploitation des données.
La leçon pratique est que les feuilles de route cibles ne suffisent pas. Les banques ont besoin de contrôles opérationnels qui résistent au passage des slides de modernisation aux pipelines en production. Sinon, le programme d’IA devient une initiative de plus, engagée sur le papier et fragile en production.
Construire un cadre intégré de gestion des données
Un cadre efficace réunit gouvernance, architecture, lineage et validation dans un seul modèle opérationnel. Il ne s’agit pas d’ajouter des étapes de revue. Il s’agit de rendre la qualité visible suffisamment tôt pour que la banque puisse empêcher des données erronées d’atteindre le reporting réglementaire, les modèles de risque ou les workflows d’IA.
La conception la plus solide commence par une surveillance continue au niveau du parcours des données. Les banques doivent surveiller la fraîcheur des livraisons, les changements de schéma et les échecs de règles là où les données entrent dans l’environnement, et pas seulement après que quelqu’un a remarqué un rapport erroné. C’est là que la validation in-database prend tout son sens : des contrôles exécutés au plus près des données limitent leurs déplacements, préservent les preuves de contrôle et évitent de transformer chaque exception en exercice de copie et de comparaison.
Le cadre qui tient vraiment la route
Un cadre bancaire pratique comporte généralement cinq couches.
Définition des contrôles : chaque jeu de données critique dispose de règles explicites d’exactitude, d’intégrité, d’exhaustivité et d’actualité.
Responsabilité : un responsable et un steward nommément désignés répondent du comportement de la source et de la remédiation.
Lineage : la banque peut tracer les données de la saisie au reporting final, en passant par chaque transformation.
Surveillance : la fraîcheur, la validation et les changements de schéma sont contrôlés en continu, et non périodiquement.
Réponse : les exceptions déclenchent une escalade accompagnée de preuves, et pas seulement un numéro de ticket.
Ces couches doivent reposer sur l’architecture réelle de la banque, et non à côté d’elle. Si les contrôles résident dans des outils séparés qui exigent une synchronisation manuelle, les équipes finissent par rapprocher les contrôles eux-mêmes plutôt que les données.
Le meilleur modèle de contrôle est celui auquel les opérateurs peuvent se fier sans tout revérifier à la main.
C’est aussi pourquoi les outils d’observabilité comptent davantage aujourd’hui. Les attentes des superviseurs évoluent vers la preuve plutôt que l’intention. Si la banque peut montrer ce qui est arrivé, ce qui a changé, ce qui a échoué et ce qui a été corrigé, le modèle de contrôle devient auditable au lieu de rester une aspiration.
digna est une option dans ce domaine, car elle combine validation des données, monitoring Timeliness, suivi des schémas et exécution in-database au sein de l’environnement du client. Dans un contexte bancaire, ce type de conception répond au besoin de laisser les données en place tout en les contrôlant en continu dans les entrepôts, les lacs de données et les pipelines.
Le test final est simple. Si la banque peut détecter tôt les données d’entrée défaillantes, les remonter jusqu’à leur source et prouver ce qui s’est passé sans reconstitution manuelle, alors le modèle opérationnel remplit vraiment son rôle. Sinon, l’organisation dispose encore d’un discours de gouvernance, mais pas encore d’une capacité de gestion des données bancaires résiliente.
Si vous modernisez les contrôles de données de votre banque et cherchez un moyen concret de surveiller la fraîcheur, de valider les enregistrements et de préserver le lineage au sein de votre propre environnement, rendez-vous sur digna et découvrez comment ses modules d’observabilité et de validation s’intègrent aux opérations sur données réglementées. La plateforme est conçue pour les équipes qui ont besoin de preuves, pas seulement de tableaux de bord.
Plus de dix ans après la publication de BCBS 239, de nombreuses banques le traitent encore comme un projet de documentation plutôt que comme une évolution de leur gestion des données sur les risques. Notre article sur la manière de transformer la conformité BCBS 239 en valeur métier revient sur les principes d’exactitude, d’actualité et de reporting, et sur la façon dont les banques peuvent faire de cette obligation réglementaire un avantage concurrentiel.
Questions fréquentes
Quelles sont les quatre dimensions de la qualité des données utilisées par les régulateurs pour les banques ?
Les régulateurs évaluent les données bancaires selon l’exactitude, l’intégrité, l’exhaustivité et l’actualité. Le guide de la BCE sur l’agrégation des données sur les risques demande aux banques de définir des KPI détaillés pour chacune d’elles, et un KPI utile doit indiquer la source concernée, le pipeline, le responsable, le rapport en aval et le moment de la détection, pas seulement si une règle a été respectée.
Combien de principes compte BCBS 239 ?
BCBS 239 énonce 14 principes pour une agrégation efficace des données sur les risques et une notification des risques efficace. Trois exigences façonnent le plus l’architecture bancaire : une agrégation largement automatisée pour réduire les erreurs manuelles, une couverture de l’ensemble des entités juridiques, régions et types d’actifs, et un lineage qui trace chaque attribut de la saisie des données jusqu’au rapport final.
Pourquoi les banques échouent-elles encore à respecter BCBS 239 malgré leurs contrôles de qualité des données ?
Les contrôles échouent surtout parce que les données source n’ont pas de responsable identifié. Une étude Deloitte de 2025 a montré que 90 % des banques européennes appliquent au moins trois contrôles de qualité des données, mais que seules 18 % déclarent une mise en œuvre complète de BCBS 239 et 24 % un lineage étendu, tandis que les données source manquantes ou erronées restent la première cause d’erreurs de reporting.
Qu’est-ce qui freine l’adoption de l’IA sur les données bancaires ?
La confiance dans les données et l’intégration, bien plus que la stratégie. Dans une enquête KPMG auprès des banques, 89 % citaient la qualité des données et 81 % la complexité de l’existant et de l’intégration parmi les principaux défis, alors que 68 % avaient déjà une vision cible. Sans contrôles de fraîcheur, validation et lineage sur le parcours des données, les modèles d’IA héritent des faiblesses de leurs données d’entrée.
Que doit inclure un cadre de gestion des données bancaires ?
Un cadre opérationnel comporte cinq couches : définition des contrôles, responsabilité, lineage, surveillance et réponse. Chaque jeu de données critique dispose de règles explicites, d’un responsable et d’un steward nommés, d’une traçabilité jusqu’au rapport final, de contrôles continus de la fraîcheur, de la validation et des changements de schéma, et d’une escalade accompagnée de preuves plutôt que d’un simple numéro de ticket.


