10 exemples de politiques de gouvernance des données
|
12
minute de lecture

Un document de politique peut exister pendant que ses données restent, dans les faits, non gouvernées. Les enquêtes du secteur rapportent que seules 23 % des organisations utilisent des cadres formels de gouvernance ou de qualité des données, que 55 % ne tiennent pas en continu un inventaire des données sensibles, que 70 % n'ont pas de stratégie unifiée reliant la visibilité des données et celle des identités et que seules 39 % savent classifier l'ensemble de leurs données. Ces constats montrent pourquoi une liste de titres de politiques ne suffit pas. Une politique utile traduit un principe en un contrôle observable, désigne une personne pour l'exploiter, consigne des preuves et définit ce qui se passe quand le contrôle échoue. Résultats d'enquête sur l'adoption de la gouvernance des données
Les dix exemples de politiques de gouvernance des données ci-dessous sont rédigés comme des modèles opérationnels, non comme des définitions figées. Chacun relie un objectif de contrôle à son responsable, son déclencheur, ses preuves, sa voie d'escalade et un résultat mesurable. Ces exemples s'appliquent aux services financiers, à la santé, aux télécommunications et à l'administration publique, mais la même logique vaut pour les jeux de données critiques, le reporting réglementé, les pipelines analytiques et les systèmes d'IA.
Une politique doit aussi refléter le contexte juridique de l'organisation. Le règlement européen sur la gouvernance des données a été adopté par le Parlement européen le 6 avril 2022, est entré en vigueur le 23 juin 2022 et est devenu applicable le 24 septembre 2023 après une période transitoire de 15 mois, créant un cadre juridique pour la réutilisation des données, les intermédiaires et l'altruisme en matière de données sur les marchés de l'UE. Calendrier et implications du règlement européen sur la gouvernance des données Cette progression illustre la pression concrète qui pousse les entreprises à passer de la conception de politiques à des contrôles opposables, en particulier lorsque les données franchissent des juridictions.
Table des matières
1. Politique de standards de qualité des données et de validation
2. Politique de détection d'anomalies et d'apprentissage de référence
3. Politique de Timeliness et de surveillance des livraisons
4. Politique de détection des changements de schéma et de gouvernance structurelle
5. Politique de propriété des données et de responsabilité de stewardship
6. Politique de surveillance des métriques métier et de fiabilité des KPI
8. Politique d'accès aux données et de gouvernance de la sécurité
9. Politique de réponse aux incidents de données et d'escalade
10. Politique d'amélioration continue et de métriques de gouvernance
Transformer le texte de la politique en contrôles opérationnels
1. Politique de standards de qualité des données et de validation
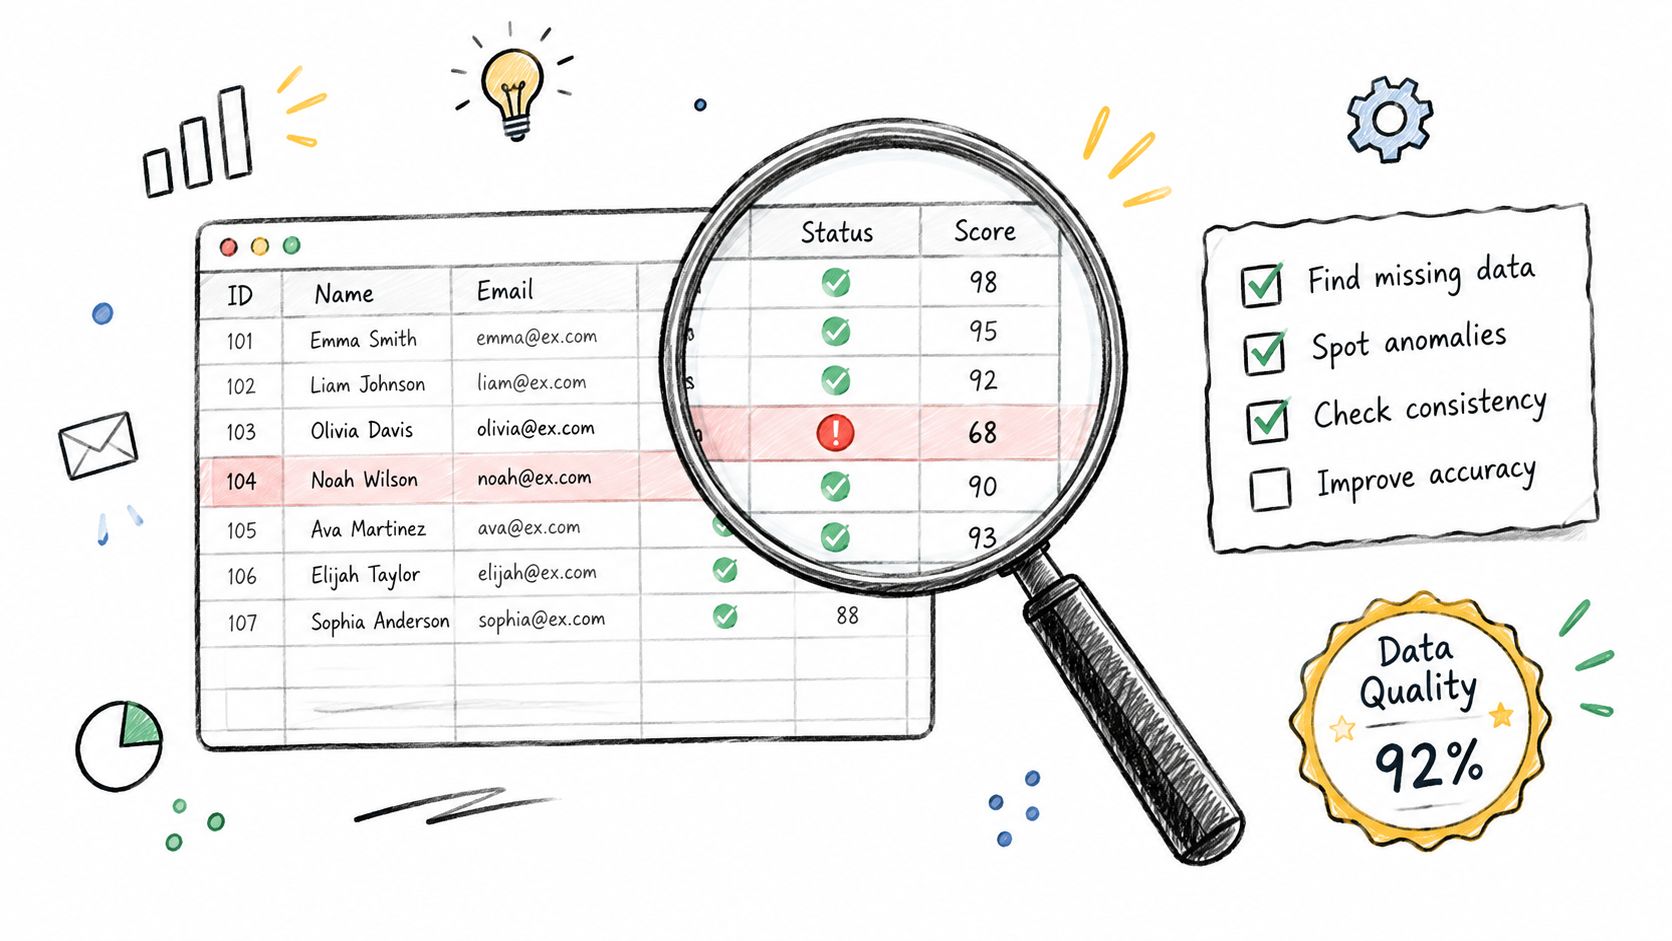
Une politique de qualité des données définit la condition minimale qu'un enregistrement doit remplir avant que les systèmes en aval le traitent comme exploitable. Son objectif de contrôle est l'adéquation à l'usage, non une perfection abstraite. Un enregistrement de transaction peut exiger un montant valide, une partie identifiable et les champs réglementaires requis. Un enregistrement clinique peut exiger des mesures et des identifiants cohérents entre eux. Un compte télécom peut nécessiter des attributs de facturation et de client cohérents avant l'exécution du reporting de chiffre d'affaires.
Le propriétaire des données approuve la signification métier de chaque règle. Un data steward tient le registre des règles, tandis que les ingénieurs de données implémentent les contrôles dans le pipeline ou la base concernée. Le déclencheur est un chargement planifié, un événement d'ingestion ou un passage de relais dans le processus métier. Les preuves doivent comprendre la définition de la règle, sa justification métier, l'horodatage d'exécution, les enregistrements concernés, les résultats de réussite et d'échec, l'état de remédiation et l'historique d'approbation.
Règle pratique : Une règle de validation n'est gouvernable que lorsque quelqu'un peut expliquer pourquoi elle existe, ce qu'elle vérifie et qui agit quand elle échoue.
La validation déterministe diffère de la surveillance comportementale. Une règle telle que « le montant de la transaction doit être présent et numérique » produit un résultat reproductible. Un moniteur d'anomalies évalue au contraire si le comportement s'est écarté d'un motif attendu. Les deux ont leur place dans un programme qualité, mais ils répondent à des questions différentes.
Comment la mettre en œuvre
Commencez par les jeux de données qui portent le plus grand risque métier, réglementaire ou opérationnel. Demandez aux ingénieurs de données, aux analystes et aux référents métier de définir les règles ensemble, puis documentez la justification pour que les futurs mainteneurs comprennent le contrôle visé.
Responsable : Un propriétaire métier des données approuve seuils et exceptions.
Déclencheur : Chaque chargement pertinent ou événement de traitement au niveau de l'enregistrement.
Preuves : Versions de règles, journaux d'exécution, enregistrements en échec, notes de remédiation et validation.
Escalade : Le steward enquête d'abord, puis oriente les cas non résolus vers le propriétaire et les consommateurs concernés.
Résultat : Les jeux critiques disposent d'une couverture de validation visible et d'une réponse documentée aux échecs.
Les équipes peuvent utiliser les standards de qualité des données de digna et son module de validation au niveau de l'enregistrement pour imposer des contrôles métier déterministes sans dépendre d'une revue manuelle. Les règles doivent être revues chaque trimestre ou semestre, en particulier après des changements de produits, d'obligations de reporting ou de systèmes sources. Pour un contexte complémentaire, consultez le guide des standards de qualité des données d'AutoProv.
2. Politique de détection d'anomalies et d'apprentissage de référence
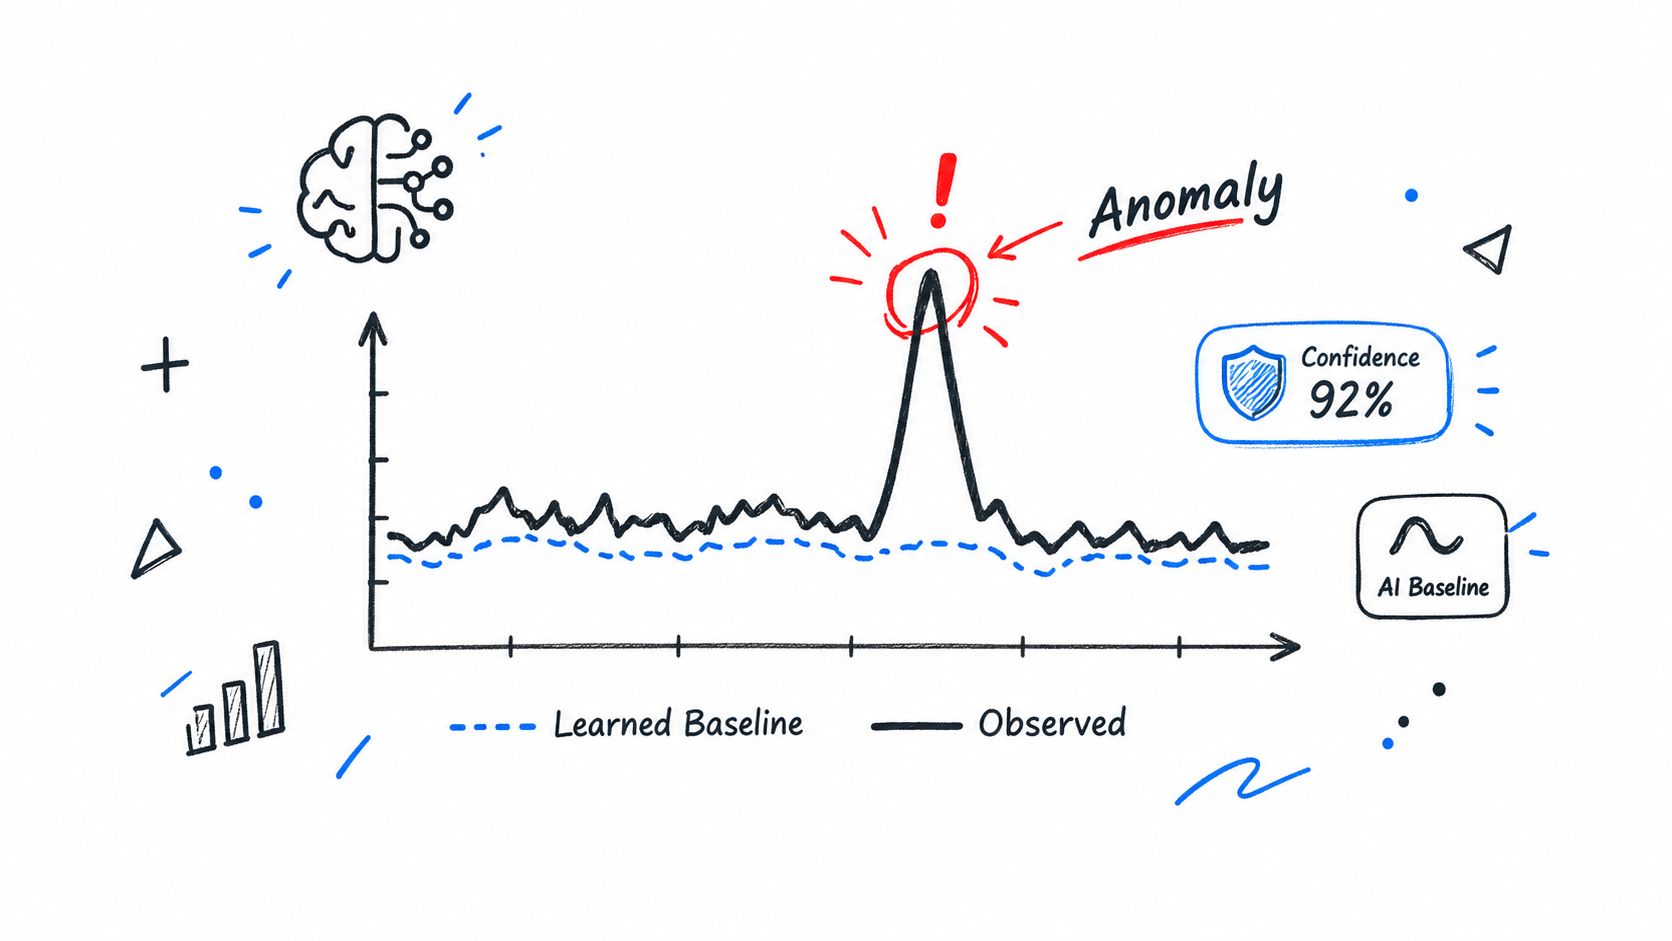
Un jeu de données peut satisfaire toutes les règles statiques de validation et devenir malgré tout peu fiable lorsque son comportement se déplace. Une politique de détection d'anomalies comble cet écart en définissant quels motifs surveiller, comment le comportement normal est appris, qui enquête sur les écarts et quelles preuves soutiennent la décision finale.
Le responsable de la surveillance choisit le jeu de données, le contexte métier et les dimensions surveillées. Un data scientist ou un ingénieur plateforme configure l'apprentissage de la référence. Le data steward consigne les anomalies confirmées, leurs causes et leur traitement. Les déclencheurs peuvent inclure des changements de volume, de distribution, de fréquence ou d'un autre comportement défini.
Le contrôle doit séparer un signal statistique d'un incident confirmé. Les équipes des services financiers peuvent enquêter sur des volumes de négociation inhabituels ou des motifs liés à la fraude. Les équipes de santé peuvent examiner des variations inattendues d'admissions ou de distributions de mesures cliniques. Les organismes publics peuvent revoir des distributions de prestations ou une activité de dépôt anormales. Ces cas exigent du contexte avant qu'une alerte ne devienne un incident opérationnel.
La surveillance comportementale identifie l'écart. La revue humaine détermine si cet écart est un défaut, un événement métier légitime ou un risque émergent.
Contrôles pour la surveillance comportementale
Laissez le modèle apprendre le comportement historique avant que les alertes deviennent opérationnelles. La conception de mise en œuvre prévoit une période d'apprentissage de 2 à 4 semaines, afin que les cycles ordinaires et les motifs récurrents façonnent la référence. Cette durée relève de la conception de cette politique, non d'un benchmark sectoriel général.
Responsable : Le responsable de la surveillance attribue le triage et le SLA de réponse.
Déclencheur : Un écart défini de volume, de distribution, de fréquence ou d'une autre dimension surveillée.
Preuves : Conservez la période de référence, la fenêtre de comparaison, le détail de l'alerte, la sévérité, les notes d'enquête, la cause racine, le traitement et la remédiation.
Boucle d'apprentissage : Consignez anomalies confirmées et faux positifs afin d'ajuster le modèle et les seuils.
Escalade : Orientez les anomalies à fort impact ou non résolues vers le propriétaire des données et le processus de réponse aux incidents.
Résultat : Les analystes distinguent la variation attendue des défauts de données, ce qui renforce la confiance dans le reporting et les entrées d'IA.
Les équipes peuvent utiliser la détection d'anomalies de digna pour les workflows Python afin de soutenir l'apprentissage de référence et la surveillance continue. Sa capacité analytique aide aussi à examiner les motifs historiques d'anomalies au lieu de traiter chaque alerte comme un événement isolé.
La mise en œuvre doit suivre cet ordre : sélectionner les jeux à haut risque, définir le comportement surveillé, établir la période d'apprentissage, tester la sévérité des alertes, attribuer la responsabilité du triage, puis revoir les cas confirmés. La politique doit être révisée quand les processus métier ou le comportement des données changent.
3. Politique de Timeliness et de surveillance des livraisons
Un jeu de données ponctuel est une dépendance opérationnelle, pas seulement un attribut de qualité. Un flux peut contenir des valeurs exactes et manquer néanmoins la fenêtre de décision de la clôture de journée, de l'édition des factures, des opérations cliniques du jour ou du reporting réglementaire. La politique doit convertir « assez frais » en une attente de livraison convenue, un déclencheur observable et une réponse définie.
Partez du besoin du consommateur. Finance, opérations, reporting et référents cliniques peuvent utiliser la même table à des moments différents de la journée : le producteur de données possède donc l'exécution de la livraison tandis que le consommateur définit la fenêtre requise. L'équipe plateforme enquête sur les défaillances d'orchestration, d'infrastructure et de dépendances.
Consignez le consommateur, le cas d'usage, la fenêtre de livraison acceptée et la conséquence d'un retard. Un déclencheur valide peut être une arrivée manquée, un chargement anticipé qui viole des hypothèses en aval, ou une livraison hors de la fenêtre de service convenue. Le dossier de preuves doit conserver les heures d'arrivée attendue et réelle, l'historique des livraisons, l'état du pipeline, les informations de dépendance, les enregistrements d'incident et la décision sur un éventuel manquement au SLA.
Rendre les attentes de livraison observables
Des calendriers appris par IA peuvent identifier le comportement normal de livraison sans obliger les ingénieurs à entretenir de fragiles fenêtres horaires manuelles. Le guide de digna sur les définitions et métriques de Timeliness explique comment surveiller les arrivées manquantes, tardives et anticipées et calculer l'heure de livraison attendue.
Mettez le contrôle en œuvre dans cet ordre :
Définir l'échéance du consommateur et la conséquence d'un retard.
Établir le comportement de livraison attendu à partir de l'historique observé.
Poser une alerte lorsque l'arrivée prévue passe sans les données attendues, ou lorsque le comportement de livraison change.
Désigner le producteur comme premier point d'escalade.
Orienter les menaces sur l'échéance vers le responsable de la plateforme et le consommateur métier.
Conserver l'heure attendue, l'heure réelle, la durée du retard, l'état des dépendances et la réponse du responsable.
Le résultat est une clarté diagnostique. Les équipes peuvent distinguer une source tardive d'un pipeline en échec ou d'un problème d'infrastructure en aval, au lieu de traiter chaque livraison manquée comme le même incident.
Examinez les tendances de Timeliness chaque mois. Un retard récurrent peut signaler un problème de processus, tandis qu'un flux fiable peut ne plus répondre aux besoins d'un consommateur nouvellement arrivé. Ces constats doivent mettre à jour la fenêtre de livraison, la responsabilité ou la règle d'escalade.
4. Politique de détection des changements de schéma et de gouvernance structurelle
Un changement de schéma peut invalider des sorties de confiance avant qu'un contrôle au niveau des valeurs ne détecte quoi que ce soit. Supprimer une colonne, changer un type de données ou modifier une contrainte peut casser un rapport, un modèle ou une transformation dès l'ingestion. Cette politique gouverne donc la visibilité et l'impact du changement structurel, avec comparaison déterministe à une référence de schéma approuvée.
Le contrôle commence par un schéma enregistré et un propriétaire de schéma nommé. La détection automatique compare chaque version déployée à cette référence et consigne ajouts, suppressions, changements de type et changements de contraintes. Le déclencheur est tout écart structurel non approuvé. Un relecteur de changement évalue les consommateurs concernés, tandis que les ingénieurs plateforme gèrent déploiement, notification et rollback.
Les preuves doivent rendre la décision auditable :
Schéma avant et après, et horodatage de détection.
Demande de changement, justification et niveau de risque.
Évaluation d'impact et lineage concerné.
Approbation, résultat du déploiement et décision de rollback.
Un établissement financier pourrait détecter la suppression d'un champ utilisé dans des calculs réglementaires. Un organisme de santé pourrait intercepter un changement de type sur une mesure clinique avant qu'il n'atteigne l'aide à la décision. Un organisme public peut devoir aligner ses systèmes d'audit lorsque la structure d'un jeu de données publiques change. Dans chaque cas, le résultat mesurable est une détection plus précoce et moins de défaillances silencieuses dans le reporting, l'analytique ou les pipelines d'IA.
Transformer la détection en revue proportionnée
Les consommateurs connus en aval doivent être prévenus avant l'impact en production. Cette exigence dépend du lineage courant : la politique doit donc vérifier que la carte d'impact est complète avant l'approbation. Un comité de revue peut approuver, refuser ou différer un changement, tandis que des niveaux de risque évitent qu'une évolution à faible impact ne crée un goulot d'étranglement manuel.
Responsable : Propriétaire du jeu de données ou du domaine.
Déclencheur : Écart structurel par rapport au schéma enregistré.
Preuves : Diff de schéma, justification, approbations, carte d'impact et enregistrement du déploiement.
Escalade : Transmettre les changements non approuvés ou à fort impact au comité de revue et au processus d'incident.
Résultat : Les consommateurs reçoivent un avis exploitable avant que la dérive structurelle ne devienne une défaillance silencieuse.
L'explication de digna sur la dérive de schéma et le changement structurel décrit la surveillance structurelle continue nécessaire à ce contrôle. Son Schema Tracker établit une référence pour les ajouts, suppressions et changements de type, et aide les équipes à bloquer ou à revoir les changements avant qu'ils n'atteignent les consommateurs.

5. Politique de propriété des données et de responsabilité de stewardship
La propriété est un contrôle opérationnel, pas une étiquette dans un catalogue. La politique attribue la responsabilité de la qualité, de la ponctualité, des attentes d'accès, des définitions et de la résolution des incidents sur les jeux critiques. Elle doit aussi montrer qui peut décider, qui exécute le travail et quelles preuves attestent que la responsabilité est active.
Le propriétaire des données accepte le risque métier et approuve définitions, attentes de qualité et exceptions. Le data steward convertit ces décisions en métadonnées, règles, surveillance et traitement des incidents. Les producteurs restent responsables de la création et de la livraison des données. Les ingénieurs plateforme maintiennent les contrôles techniques, tandis que les consommateurs signalent les défauts qui touchent l'analytique, le reporting ou l'usage d'IA.
Un nouveau jeu critique, un changement de propriété significatif ou un problème de gouvernance non résolu déclenchent une revue. Le propriétaire confirme périmètre et risque, le steward consigne les règles d'exploitation, et les équipes concernées reçoivent une voie d'escalade. Les différends inter-domaines vont au décideur désigné plutôt que de rester dans une file non attribuée.
Rendre la responsabilité auditable
Un registre de propriété doit relier chaque jeu critique à son propriétaire, son steward, son producteur, ses consommateurs, sa sensibilité, ses droits de décision et sa voie d'escalade. Conservez-le là où enquêteurs d'incidents, ingénierie, analytique et métiers consultent le même enregistrement.
Preuves de contrôle : Définitions approuvées, attentes de qualité, règles d'accès, décisions d'exception et changements de propriété.
Preuves d'exploitation : Actions du steward, incidents attribués, notes de remédiation, comptes rendus de revue et entrées courantes du registre.
Preuves d'escalade : Engagements de réponse manqués, conflits non résolus, acceptation du risque et décisions de la direction.
Mesure de résultat : Chaque jeu important a une personne responsable capable d'expliquer sa signification, son usage acceptable et la réponse en cas d'échec des contrôles.
Cette définition du data steward distingue la responsabilité métier de la coordination opérationnelle. Des réunions de stewardship, hebdomadaires ou bimensuelles selon les cas, peuvent passer en revue incidents, actions en retard et motifs de qualité récurrents. La réunion n'est utile que si les participants travaillent sur des preuves partagées et consignent décisions, responsables et échéances. Ce compte rendu relie l'activité de gouvernance à un reporting, une analytique et des sorties d'IA plus fiables.
6. Politique de surveillance des métriques métier et de fiabilité des KPI
La fiabilité d'un KPI est un contrôle opérationnel, pas une fonctionnalité de tableau de bord. Elle protège la planification, le reporting et la communication aux actionnaires en détectant quand une métrique métier bouge de façon inattendue et en testant si la cause est l'activité de l'entreprise ou une défaillance de données.
Le propriétaire de la métrique, généralement un responsable métier, approuve la définition, l'interprétation et l'usage acceptable de chaque KPI. L'analytics engineering entretient le calcul et les dépendances. Un data steward coordonne l'enquête lorsque les données sources ou les règles métier changent. Le déclencheur peut être un mouvement inhabituel du chiffre d'affaires, de l'activité client, des volumes, du risque de portefeuille, de l'attrition, des résultats de traitement ou de la performance opérationnelle.
Chaque fiche de KPI doit inclure sa définition approuvée, ses données sources, sa logique de calcul, son responsable, le contexte de revue et les facteurs saisonniers ou opérationnels connus. Les équipes des services financiers peuvent surveiller chiffre d'affaires net, coût d'acquisition et risque de portefeuille. Les équipes de santé peuvent suivre admissions, résultats et efficacité opérationnelle. Les équipes télécom peuvent observer attrition, revenu moyen par utilisateur et disponibilité du réseau.
Une alerte KPI exige des preuves avant l'escalade. Un changement important peut venir d'un chargement tardif, d'une modification de schéma, d'un filtre changé, d'une mise à jour de définition ou d'un véritable événement métier. Reliez la surveillance aux contrôles de qualité, de Timeliness, d'anomalies et de schéma décrits ailleurs dans le programme de gouvernance.
Commencez par les 3 à 5 métriques métier les plus critiques, comme le prévoit l'approche de mise en œuvre. N'élargissez la couverture que lorsque les responsables savent enquêter et répondre de façon cohérente. La séquence d'exploitation est la suivante :
Contrôle de définition : Confirmer que la définition approuvée et le calcul restent inchangés.
Contrôle de données : Examiner fraîcheur, volume, complétude et preuves structurelles.
Contrôle métier : Consigner un événement ou une condition d'exploitation qui explique le mouvement.
Contrôle d'escalade : Déterminer si le KPI touche un rapport formel, une décision métier ou une communication externe.
Le responsable consigne l'alerte, les preuves examinées, la conclusion, l'action et l'échéance. Les cas non résolus passent au steward, au décideur métier ou à l'autorité de reporting selon l'impact. Le résultat mesurable est un KPI que les analystes, les dirigeants et les systèmes d'IA peuvent reproduire, expliquer et croire.
La solution Business Monitoring de digna peut examiner les variations inhabituelles du chiffre d'affaires, des volumes, de l'activité client et des métriques opérationnelles. Des revues mensuelles avec la direction métier vérifient si les alertes représentent encore un risque significatif et si les seuils demandent un ajustement.
7. Politique de lineage et d'analyse d'impact
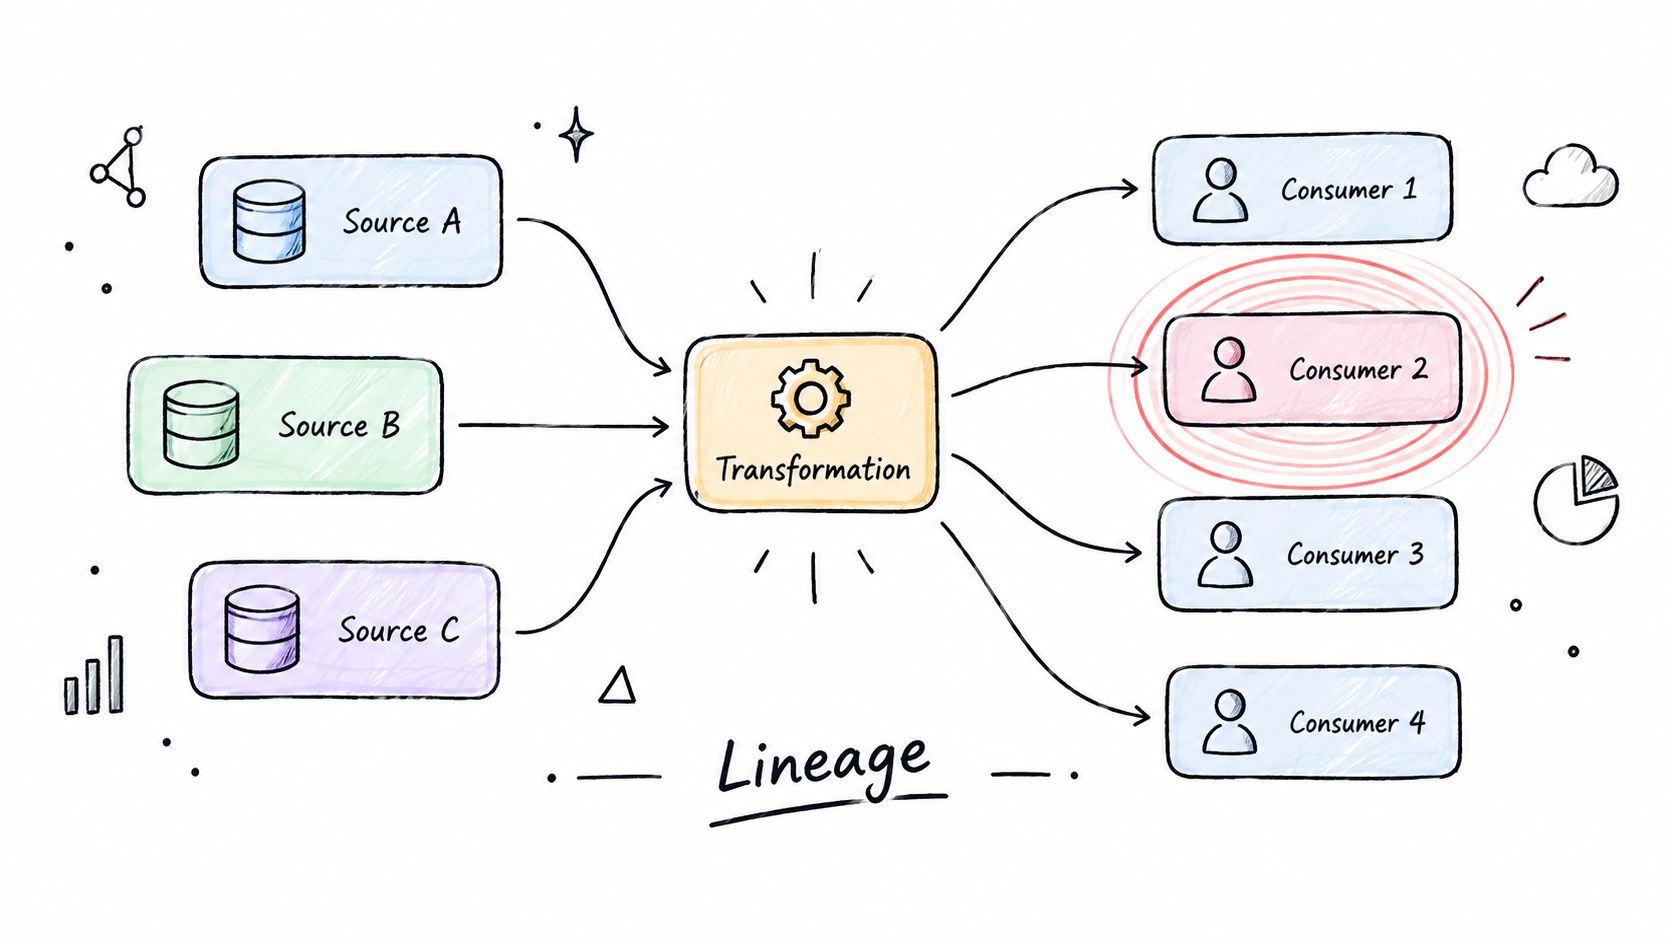
Le lineage transforme une dépendance de données en contrôle opérationnel. Il relie un chiffre publié ou une entrée de modèle à sa source, ses transformations, ses destinations et ses consommateurs. L'objectif de la politique est d'établir le périmètre concerné avant qu'un défaut, un changement structurel ou un constat d'audit ne déclenche une remédiation.
Le propriétaire des données classe les actifs critiques et approuve leur usage métier. Les ingénieurs de données capturent les dépendances de pipeline et de transformation, tandis que les stewards vérifient que les relations techniques reflètent la signification métier. Un nouveau flux critique, un changement de pipeline significatif, un incident de qualité, le déploiement d'un modèle ou une demande d'audit démarrent le contrôle.
Les preuves doivent inclure actifs source et destination, logique de transformation, relations de dépendance, une carte de lineage versionnée, la date de revue et les consommateurs concernés. La séquence d'exploitation est la suivante :
Enregistrer le flux et son responsable.
Capturer les dépendances techniques et les versions de transformation.
Confirmer les définitions métier et les consommateurs critiques.
Évaluer l'impact lorsqu'une source, une règle ou une destination change.
Escalader les relations manquantes ou ambiguës vers le propriétaire des données et l'architecte plateforme.
Une banque peut utiliser cet enregistrement pour repérer les modèles de risque touchés par un flux rompu. Un organisme de santé peut cartographier les flux de données cliniques pour l'audit et la conformité, tandis qu'un organisme public peut montrer comment les données sources atteignent les systèmes de reporting. Pour les systèmes d'IA, le lineage fournit la preuve des entrées consommées par un modèle et de la manière dont ces entrées ont changé.
Le lineage est un contrôle structurel, pas un schéma figé.
Les schémas manuels se dégradent à mesure que les systèmes évoluent. La capture automatique depuis les outils de pipeline offre une base d'exploitation plus solide, mais un steward doit toujours vérifier si les dépendances sont complètes et si les consommateurs à fort impact sont représentés. Le résultat mesurable est une analyse d'impact plus rapide et fondée sur des preuves, avec une remédiation priorisée par rapports, modèles et décisions concernés plutôt que par recherches manuelles.
digna comprend un catalogue de données qui peut soutenir la documentation du lineage et une compréhension partagée. Une piste d'audit visuelle peut aussi montrer ce qui s'est passé et quand, une exigence de preuve pertinente pour le logiciel de piste d'audit pour la conformité des flottes au Royaume-Uni.
8. Politique d'accès aux données et de gouvernance de la sécurité
La gouvernance des accès est un contrôle opérationnel, pas une liste de permissions. Elle précise qui peut consulter ou modifier chaque domaine de données, quelle finalité métier justifie cet accès, comment les droits sont accordés ou retirés et quelles preuves soutiennent la décision. L'objectif de contrôle est l'usage autorisé des données sensibles et critiques. Des règles trop restrictives peuvent retarder des analyses légitimes, tandis qu'une revue faible accroît l'exposition et rend la responsabilité difficile à établir.
Le propriétaire des données définit les règles d'accès du domaine et approuve les exceptions. Les équipes de gestion des identités et des accès provisionnent les droits, les équipes sécurité entretiennent authentification et journalisation, et les stewards vérifient si l'accès correspond encore aux responsabilités actuelles. Une demande, un changement de rôle, une mutation, un départ, une élévation de privilèges ou une recertification planifiée déclenchent le processus.
Un enregistrement défendable relie la demande à son approbateur, au mappage de rôles, à l'état des droits, aux horodatages d'octroi et de révocation, aux événements d'accès, à la justification de l'exception et au résultat de la revue. Les conflits non résolus vont à la sécurité et au propriétaire responsable, l'accès étant suspendu ou restreint là où la politique l'exige.
La limitation des finalités façonne aussi le contrôle. Les orientations RGPD de l'UE prévoient que les données à caractère personnel soient collectées pour des finalités déterminées, explicites et légitimes, et ne soient pas réutilisées de manière incompatible. Orientations de la Commission européenne sur les principes du RGPD Un utilisateur peut donc obtenir l'accès pour une tâche opérationnelle définie sans être autorisé à réaffecter ces mêmes données à des analyses, du reporting ou du développement d'IA sans lien.
Intégrer la piste de revue à la mise en œuvre
Utilisez un accès fondé sur les rôles, lié aux responsabilités du poste plutôt qu'à l'appartenance informelle à une équipe. Reliez la politique aux systèmes d'identité quand c'est possible, puis menez des revues d'accès trimestrielles pour que les propriétaires retirent les droits dépourvus de finalité documentée.
Responsable : Propriétaire métier des données.
Déclencheur : Demande, changement de rôle, départ, changement de privilèges ou revue trimestrielle.
Preuves : Workflow d'approbation, état des droits, événement d'accès, révocation et exception.
Escalade : Équipe sécurité et propriétaire responsable pour les conflits non résolus.
Résultat : L'accès reste autorisé, explicable, révisable et réversible.
L'exécution en base de digna et ses options de déploiement en cloud privé ou sur site peuvent soutenir les contrôles pendant que les données restent dans l'environnement du client. La technologie consigne et applique les décisions, mais l'organisation doit déterminer qui a besoin d'un accès, pourquoi il est nécessaire et quand il doit prendre fin.
9. Politique de réponse aux incidents de données et d'escalade
Les incidents de données demandent un contrôle opérationnel, pas seulement un ticket. La politique doit couvrir les défaillances de qualité, les livraisons tardives ou manquantes, les changements de schéma, les KPI peu fiables et les préoccupations d'accès. Son objectif est de détecter le problème, de limiter son effet sur l'analytique, le reporting ou les workflows d'IA, de documenter les décisions et d'éviter la récurrence.
Le responsable de l'incident pilote la réponse. Le propriétaire du jeu de données évalue l'impact métier et approuve une remédiation acceptable. Les ingénieurs plateforme examinent les causes techniques, les stewards tiennent l'enregistrement et les consommateurs concernés reçoivent des mises à jour. Les déclencheurs comprennent une validation en échec, des alertes d'anomalie, une livraison manquée, un changement structurel non autorisé ou une métrique métier inexpliquée.
La sévérité détermine la voie de réponse. Un incident touchant le reporting réglementaire, les opérations de trading ou la sécurité des patients justifie une escalade plus rapide et une communication plus claire qu'un problème interne à faible impact.
Rendre la résolution auditable
L'enregistrement doit conserver l'alerte, la notification, l'enquête, la cause racine, l'action corrective, l'approbation de rétablissement et la revue post-incident. Ces preuves distinguent une défaillance de source corrigée d'un contournement temporaire.
Détection : Capturer le signal, l'horodatage, le jeu concerné et le périmètre initial.
Notification : Contacter le propriétaire, le steward, les consommateurs et les personnes d'astreinte.
Enquête : Établir impact, cause, dépendances et confinement.
Résolution : Corriger, revenir en arrière, mettre en quarantaine ou communiquer la limitation des données.
Prévention : Attribuer le travail de suivi et vérifier que le contrôle a changé.
L'escalade doit être déclenchée par l'impact métier, non par le seul volume d'alertes.
Le responsable ne clôt l'incident que lorsque les preuves soutiennent un usage rétabli ou une limitation explicite. Une base de connaissances consultable doit conserver causes racines, décisions et exceptions. Des revues post-incident mensuelles peuvent révéler des faiblesses récurrentes de processus ou de plateforme que les tickets individuels dissimulent.
L'alerting et le tableau de bord centré utilisateur de digna peuvent donner aux ingénieurs, analystes et parties prenantes une vue partagée des incidents et des tendances. La séquence de mise en œuvre consiste à définir les critères de sévérité, connecter les signaux de détection, attribuer les rôles de réponse, exiger des preuves à la clôture, puis revoir les causes récurrentes. Le résultat mesurable est un historique de réponse qui soutient un reporting fiable et un usage d'IA plus sûr en aval.

10. Politique d'amélioration continue et de métriques de gouvernance
La gouvernance a besoin de ses propres métriques d'exploitation. Une politique d'amélioration continue définit comment l'organisation mesure la couverture des contrôles, examine la performance, priorise les lacunes et modifie la politique quand les conditions métier ou réglementaires évoluent. Elle empêche la gouvernance de devenir un exercice de revue documentaire détaché du comportement réel des données.
Le conseil de gouvernance fixe le cadre de mesure. Les propriétaires de domaine interprètent les résultats, les stewards coordonnent la remédiation et les équipes plateforme fournissent les preuves d'exécution. Le déclencheur est une revue de gouvernance planifiée, un incident significatif, un nouveau workflow réglementé ou un changement notable du patrimoine de données.
Parmi les mesures utiles :
Couverture de classification : La part des actifs de données dotés d'une classification.
Couverture de propriété : La part des jeux critiques dotés de propriétaires nommés.
Couverture de lineage : La part des éléments de données critiques au lineage documenté.
Réactivité sur les accès : La part des demandes d'accès approuvées dans le SLA convenu.
Achèvement des recertifications : La part des revues d'accès trimestrielles achevées à temps.
Ces mesures proviennent d'un guide de mise en œuvre qui recommande de suivre la couverture opérationnelle plutôt que de se fier aux seuls documents de politique. Le même guide indique que le délai moyen d'approbation des accès est tombé à 1,3 jour contre 5,2 jours avant la politique, avec des contrôles qualité planifiés atteignant 97 % d'exécution et une conformité de rétention atteignant 88 %. Métriques de mise en œuvre pour les contrôles de politique de gouvernance
Utiliser les benchmarks sans externaliser le jugement
Les travaux de l'UNSC et du Global Data Governance Mapping ont créé un cadre de 26 indicateurs répartis sur six attributs de gouvernance pour comparer la mise en œuvre entre organisations et juridictions. Cadre du Global Data Governance Mapping Un benchmark peut révéler des contrôles manquants en matière de propriété, de métadonnées, d'accès, de lineage ou de gestion des incidents, mais il ne peut pas décider quel risque compte le plus pour une entreprise donnée.
Sélectionnez 5 à 7 métriques clés reliées à la valeur métier, examinez-les chaque trimestre et publiez le travail d'amélioration en toute transparence. Le module Data Analytics de digna peut soutenir l'analyse historique des métriques d'observabilité, tandis que des ressources sur les outils pour un déploiement d'IA sûr et auditable apportent une perspective pertinente sur les exigences de preuve dans les environnements fortement orientés IA.
Comparaison de 10 politiques de gouvernance des données
Politique | 🔄 Complexité de mise en œuvre | ⚡ Ressources nécessaires | 📊 Résultats attendus | Cas d'usage idéaux | ⭐ Avantages clés |
|---|---|---|---|---|---|
Politique de standards de qualité des données et de validation | Élevée, définition de règles et gouvernance étendues | Moyenne–Élevée, ingénieurs de données, experts métier, outils de validation | Adéquation des données constante, pistes d'audit, moins d'erreurs en aval | Secteurs réglementés, pipelines de ML, reporting d'entreprise | Empêche les mauvaises données, impose la cohérence, soutient la conformité |
Politique de détection d'anomalies et d'apprentissage de référence | Moyenne, mise en place des modèles et pipelines de surveillance | Moyenne, données historiques, ressources ML et observabilité | Détection précoce des dérives, alertes adaptatives, surveillance extensible | Détection de fraude, séries temporelles à fort volume, métriques opérationnelles | Détecte des problèmes inédits, réduit le réglage manuel, s'étend facilement |
Politique de Timeliness et de surveillance des livraisons | Moyenne, définition de SLA et apprentissage des calendriers | Moyenne, instrumentation des pipelines, observabilité | Meilleure ponctualité, respect des SLA, moins de retards en aval | Facturation, échéances réglementaires, pipelines sensibles au temps | Alertes de retard proactives, preuves de SLA, visibilité sur la fiabilité des pipelines |
Politique de détection des changements de schéma et de gouvernance structurelle | Moyenne–Élevée, suivi structurel continu et analyse d'impact | Moyenne, cartographie du lineage, cartographie des consommateurs en aval | Détection rapide des changements cassants, moins de défaillances en aval | Schémas évolutifs, plateformes multi-équipes, validation de contrats | Empêche les défaillances silencieuses, permet des rollbacks coordonnés, pistes d'audit |
Politique de propriété des données et de responsabilité de stewardship | Moyenne, définitions de rôles et processus d'organisation | Moyenne, stewards désignés, cadence de gouvernance, tableaux de bord | Responsabilité claire, enquêtes plus rapides, propriété durable | Grandes organisations, environnements réglementés, équipes data distribuées | Accélère la résolution, clarifie les responsabilités, préserve le savoir |
Politique de surveillance des métriques métier et de fiabilité des KPI | Moyenne, définitions de métriques et intégration BI | Moyenne, référents métier, analystes, outils de BI | KPI fiables, alertes précoces d'impact métier, confiance dans les décisions | Reporting de direction, métriques produit et finance, KPI destinés aux investisseurs | Évite les mauvaises décisions, relie les métriques aux causes racines, soutient la stratégie |
Politique de lineage et d'analyse d'impact | Élevée, capture et maintenance du lineage de bout en bout | Élevée, outils de catalogue, automatisation, effort d'intégration | Évaluation rapide du rayon d'impact, enquêtes plus courtes, preuves de gouvernance | Pipelines complexes, audits, dépendances multi-systèmes | Permet une analyse d'impact rapide, réduit le temps de triage, soutient la conformité |
Politique d'accès aux données et de gouvernance de la sécurité | Moyenne, intégration RBAC et IAM | Moyenne, IAM, journalisation, processus de revue des accès | Accès maîtrisé, journaux prêts pour l'audit, risque interne réduit | Données sensibles ou réglementées (PII, PHI, financières) | Protège les données sensibles, garantit l'auditabilité, impose le moindre privilège |
Politique de réponse aux incidents de données et d'escalade | Moyenne, playbooks d'incident, SLA et astreintes | Moyenne–Élevée, équipes d'astreinte, outils d'incident, processus de post-mortem | MTTD/MTTR réduits, remédiation documentée, apprentissage continu | Services de données critiques, pipelines de reporting réglementaire | Réponse structurée, résolution plus rapide, apprentissage organisationnel |
Politique d'amélioration continue et de métriques de gouvernance | Moyenne, choix des métriques et processus de maturité | Moyenne, analytique, revues avec les parties prenantes, métriques historiques | Progrès de gouvernance mesuré, feuille de route d'amélioration priorisée | Organisations qui font mûrir leur gouvernance, besoin de justifier le ROI | Fournit des preuves d'impact, entretient l'optimisation continue, aligne les parties prenantes |
Transformer le texte de la politique en contrôles opérationnels
Les programmes de gouvernance les plus solides ne commencent pas par écrire toutes les politiques possibles. Ils commencent par un petit ensemble de jeux de données à haut risque et rendent la responsabilité visible. Cette approche traite aussi un problème central de mise en œuvre : la gouvernance formelle reste incomplète dans beaucoup d'organisations, si bien qu'une documentation large peut donner l'apparence de la maturité sans fournir de couverture de contrôle.
Commencez par sélectionner les jeux qui soutiennent le reporting réglementé, les décisions financières significatives, les opérations cliniques, la facturation client ou les workflows d'IA et d'analytique. Attribuez un propriétaire métier et un steward opérationnel avant de définir des contrôles détaillés. Le propriétaire doit décider ce que signifie « apte à l'usage », quels consommateurs comptent et quel niveau de risque l'organisation accepte. Le steward doit entretenir règles, preuves, enregistrements d'incidents et activité d'escalade.
Définissez ensuite les preuves de qualité et de livraison. Une politique qualité doit produire des résultats de validation, le détail des enregistrements en échec et un historique de remédiation. Une politique de Timeliness doit montrer le comportement de livraison attendu et réel, pas seulement si un pipeline s'est terminé. Ces contrôles fonctionnent ensemble parce qu'un pipeline réussi peut malgré tout livrer des données incomplètes ou tardives, tandis qu'un chargement ponctuel peut contenir des enregistrements invalides.
Ajoutez ensuite les contrôles d'accès et structurels. La gouvernance des accès doit relier finalité, rôle, approbation, provisionnement, révocation et preuves de revue. Le principe RGPD de minimisation exige que les données à caractère personnel soient adéquates, pertinentes et limitées à ce qui est nécessaire au regard des finalités. Orientations de l'ICO britannique sur la minimisation des données Ce principe donne aux décisions d'accès et de collecte une limite concrète. Les politiques de rétention ont aussi besoin d'une base défendable. NIST SP 800-63B indique que les fournisseurs de services cloud doivent respecter les obligations applicables de conservation des enregistrements et, lorsque la conservation n'est pas obligatoire, utiliser un processus de gestion des risques tenant compte des risques de confidentialité et de sécurité et informer l'abonné de la politique de rétention. Orientations NIST SP 800-63B sur la conservation des enregistrements
La gouvernance devient crédible quand chaque exigence importante produit des preuves qu'une personne nommée peut interpréter et sur lesquelles elle peut agir.
Reliez les incidents à des voies d'escalade plutôt que d'envoyer les alertes dans une file sans propriétaire. Définissez la sévérité, les responsabilités d'astreinte, les destinataires de la communication, les options de confinement, les attentes en matière de cause racine et la revue post-incident. Le propriétaire doit pouvoir approuver une réponse métier, tandis qu'ingénieurs et stewards fournissent les preuves techniques et opérationnelles nécessaires.
Enfin, examinez les tendances régulièrement. Mesurez la couverture de classification et de propriété, le lineage des éléments critiques, la performance du SLA d'accès, l'achèvement des recertifications, l'exécution des contrôles qualité, la ponctualité, les motifs d'anomalies et la récurrence des incidents. L'approche de benchmark issue du Global Data Governance Mapping montre pourquoi des indicateurs structurés sont plus utiles à la comparaison que des récits de maturité. Les équipes de gouvernance peuvent adapter cette logique sans traiter un cadre externe comme un substitut à leurs propres décisions de risque.
ISO/IEC 38505-1 présente la gouvernance des données comme une responsabilité de l'organe de gouvernance : évaluer, diriger et surveiller le traitement et l'usage des données. Elle reconnaît aussi la responsabilité en cas d'atteinte à la vie privée, au regard de la législation sur la conservation des enregistrements et du non-respect de normes obligatoires. Responsabilités de gouvernance des données selon ISO/IEC 38505-1 Cette perspective change le rôle de la technologie de gouvernance. Les outils peuvent exécuter des contrôles, conserver des preuves et rendre les incidents visibles, mais la direction reste responsable des décisions, de l'interprétation, des exceptions et de la reddition de comptes.
digna peut soutenir ce modèle d'exploitation par la validation en base, la détection d'anomalies pilotée par l'IA, la surveillance de Timeliness, le suivi de schéma, une visibilité partagée des incidents, un catalogue de données et l'analyse historique. Ses options de déploiement en cloud privé et sur site permettent à la plateforme de s'exécuter dans l'environnement du client, l'organisation conservant la responsabilité de la conception des politiques et de la propriété des contrôles.
Adoptez les politiques dans l'ordre, mesurez si elles fonctionnent réellement et révisez-les quand l'activité change. Un modèle est un point de départ. Un programme de gouvernance qui fonctionne est la combinaison de droits de décision, de contrôles exécutables, de preuves, de réponse humaine et de revue récurrente.
digna réunit validation au niveau de l'enregistrement, détection d'anomalies, surveillance de Timeliness, suivi de schéma, surveillance métier et analytique historique dans une plateforme qui s'exécute dans l'environnement du client. Rendez-vous sur digna pour voir comment ses modules aident à transformer les politiques de gouvernance des données en contrôles observables pour l'analytique et l'IA.
La politique 4 décrit le contrôle ; la détection qui le sous-tend est une capacité produit. Schema Tracker compare chaque schéma déployé à une référence approuvée et consigne ajouts, suppressions, renommages et changements de type au fil de leur survenue.
Questions fréquentes
Qu'est-ce qui rend une politique de gouvernance opérationnelle plutôt que décorative ?
Chaque politique nomme un objectif de contrôle, un responsable, un déclencheur, un dossier de preuves, une voie d'escalade et un résultat mesurable. Les données d'enquête citées dans l'article montrent que seules 23 % des organisations utilisent des cadres formels de gouvernance : la documentation seule crée donc régulièrement l'apparence de la maturité sans couverture de contrôle.
Quelles politiques une équipe doit-elle écrire en premier ?
Commencez par un petit ensemble de jeux de données à haut risque : reporting réglementé, décisions financières significatives, opérations cliniques, facturation client et workflows d'IA ou d'analytique. Attribuez un propriétaire métier et un steward opérationnel avant de définir des contrôles détaillés, car une documentation large écrite d'abord devance les contrôles censés la faire appliquer.
En quoi une politique de Timeliness diffère-t-elle d'une politique qualité ?
Une politique qualité décide si un enregistrement est apte à l'usage. Une politique de livraison convertit « assez frais » en une fenêtre convenue, un déclencheur observable et une réponse définie, le producteur possédant l'exécution et le consommateur définissant la fenêtre. Un pipeline peut réussir et manquer quand même la clôture de journée.
Quelles preuves une politique de changement de schéma doit-elle conserver ?
Le schéma avant et après avec son horodatage de détection, la demande de changement et sa justification, un niveau de risque, une évaluation d'impact couvrant le lineage concerné, ainsi que l'approbation, le résultat du déploiement et la décision de rollback. La détection compare chaque version déployée à une référence enregistrée détenue par un propriétaire de schéma nommé.
Qui possède une politique de gouvernance au quotidien ?
Trois rôles se la partagent. Le propriétaire des données approuve la signification métier de chaque règle et accepte le risque résiduel, le steward entretient le registre des règles, les preuves et l'activité d'escalade, et les ingénieurs implémentent les contrôles dans le pipeline ou la base. Consigner ce partage en premier est ce qui garde la politique auditable.



