Comment exécuter une requête efficacement en 2026
|
6
minute de lecture

Vous pouvez mettre en production une requête qui renvoie des lignes, passe les tests et pose malgré tout des problèmes. La casse apparaît généralement plus tard, quand un dashboard ralentit, qu'un chiffre de rapprochement est faux ou qu'un traitement en aval consomme des données à la mauvaise granularité sans que personne ne s'en aperçoive. À force d'exécuter des requêtes, on apprend que « elle s'est terminée » est le niveau d'exigence le plus bas, pas celui qui garantit la fiabilité d'un data warehouse.
Table des matières
Pourquoi exécuter une requête va bien au-delà de lancer du SQL
Optimiser les requêtes analytiques grâce aux statistiques et à la conception des prédicats
Au-delà de la syntaxe L'écart de validation sémantique dans la surveillance des requêtes
Gérer les données tardives, modifiées ou partielles dans l'exploitation des requêtes
Enseignements pratiques pour une exécution fiable des requêtes
Pourquoi exécuter une requête va bien au-delà de lancer du SQL
Une requête était autrefois considérée comme une ligne de texte envoyée à une base de données. Cette vision est trop étroite pour les systèmes modernes, car la base de données choisit les chemins d'accès, l'ordre des jointures et l'utilisation des ressources tout en élaborant le résultat. Le modèle relationnel d'Edgar F. Codd, en 1970, a fait évoluer l'idée vers des requêtes déclaratives, où l'utilisateur décrit le résultat souhaité et le système décide comment l'obtenir, et System R d'IBM a transformé cette idée en système concret doté d'un optimiseur de requêtes fondé sur les coûts qui comparait des plans alternatifs avant l'exécution (histoire d'IBM sur Patricia Selinger).
Ce changement compte toujours chaque fois qu'une équipe exécute une requête dans un data warehouse, une base opérationnelle ou un workflow d'observabilité. Le résultat dépend du volume de données, des résultats intermédiaires, du volume analysé et des ressources disponibles à cet instant, pas seulement du fait que le SQL soit syntaxiquement correct. Pour les équipes qui travaillent sur l'observabilité et la qualité des données, la requête est l'opération que l'on mesure, pas seulement le texte que l'on relit. C'est pourquoi les plateformes construites autour du comportement d'exécution, comme la data observability de digna, s'intéressent à ce que fait la requête dans la base de données plutôt qu'à la seule syntaxe.
Règle pratique : considérez le plan d'exécution comme une partie de la requête, car c'est là que le coût, la pression sur les ressources et la dérive du plan apparaissent en premier.
Pourquoi les contrôles de syntaxe ne suffisent pas
Un contrôle de syntaxe vous indique que l'instruction est valide. Il ne vous dit pas si elle a lu trop de données, effectué les jointures dans le mauvais ordre ou produit un résultat assez plausible pour passer la relecture. C'est l'écart auquel les équipes de production se heurtent sans cesse, surtout lorsque le succès d'une requête se juge uniquement au fait qu'elle se termine.
L'autre angle mort est le comportement historique. Le même SQL peut s'exécuter différemment lorsque les données grossissent, que les statistiques changent ou qu'un chemin de jointure devient moins sélectif. L'histoire de la normalisation explique aussi pourquoi les équipes ne peuvent pas se fier indéfiniment au comportement d'un seul éditeur : SQL a évolué pendant des décennies au fil des révisions ANSI et ISO tout en restant le langage commun des systèmes relationnels (historique de la norme SQL par l'ANSI).
Le workflow standard pour exécuter une requête
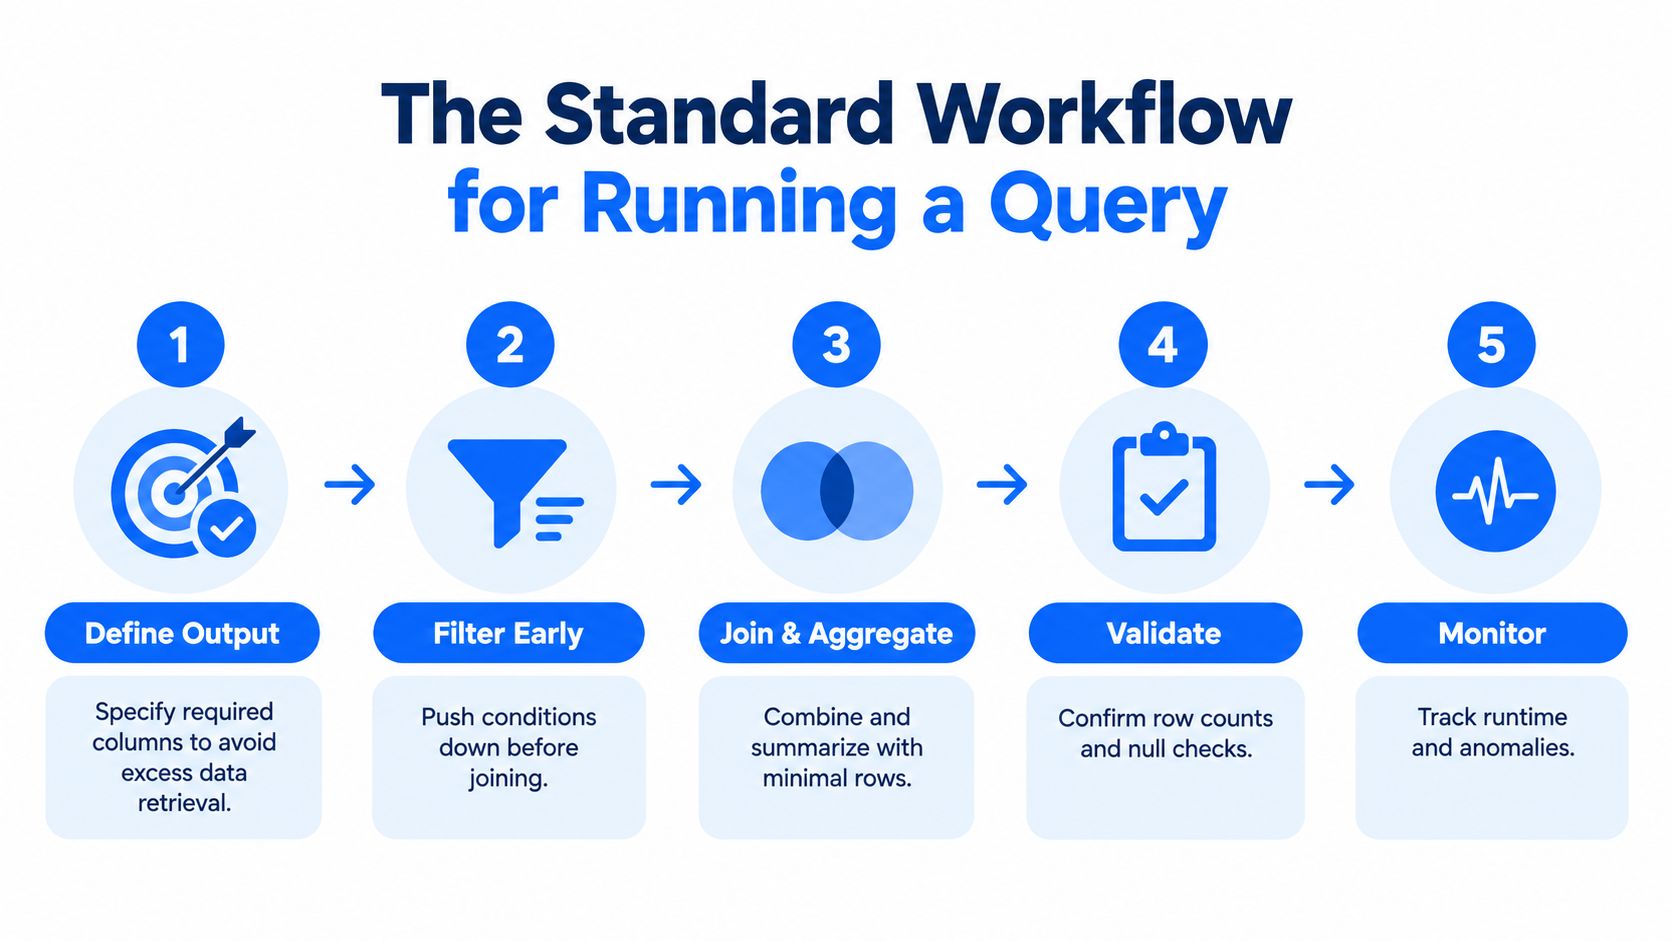
Le workflow de production le plus fiable commence avant que la base de données ne fasse le gros du travail. Définissez d'abord le résultat attendu, puis ne demandez que les colonnes minimales nécessaires pour le produire. La requête reste ainsi ciblée et évite de traîner des données inutiles à travers les jointures et agrégations suivantes.
Étape 1 Définir le résultat
La définition du résultat doit préciser la granularité souhaitée, la population de lignes attendue et les colonnes requises. Si la question métier porte sur l'activité quotidienne des clients, n'interrogez pas à la granularité compte-mois en espérant que les chiffres se rapprochent plus tard. Une requête qui demande moins est plus facile à comprendre, moins coûteuse à exécuter et bien moins susceptible de vous surprendre.
Étape 2 Filtrer avant de joindre
Appliquez les conditions le plus tôt possible pour que la base de données travaille sur moins de lignes. Ce principe rejoint la recommandation de Microsoft de n'interroger que les colonnes nécessaires et de réduire les données avant les opérations JOIN, et il est d'autant plus important que les tables sources sont volumineuses ou déséquilibrées (bonnes pratiques de performance de Google BigQuery).
Étape 3 Examiner le plan d'exécution
L'examen du plan doit couvrir l'ordre des jointures, le volume analysé, les estimations de cardinalité et toute étape de tri ou d'agrégation susceptible de devenir un goulot d'étranglement. Ne vous fiez pas à un « ça a l'air correct » dans l'éditeur SQL. Vérifiez ce que l'optimiseur prévoit, puis comparez-le à la charge de travail que vous attendez.
Étape 4 Mesurer sur des données représentatives
Exécutez la requête révisée sur des partitions réalistes, pas sur des échantillons jouets. Une requête rapide sur une tranche étroite peut s'effondrer sur le mois en cours, sur le plus gros client ou avec un cache froid. Comparez le résultat au budget de latence et de ressources que vous avez fixé au départ.
Gardez la requête ennuyeuse en production. Ennuyeuse signifie bornée, mesurable et stable sur les partitions que votre équipe interroge réellement.
Étape 5 Valider le comportement à l'exécution
Utilisez les métadonnées du plan et du job pour identifier où le temps est consommé, puis relancez après chaque changement significatif. En pratique, une requête n'est « terminée » que lorsqu'elle renvoie le bon résultat, reste dans le budget et se comporte de manière cohérente sur des données représentatives.
Pour les équipes qui souhaitent un modèle opérationnel plus approfondi, l'orchestration de pipelines pour les charges de requêtes aide à relier la requête au reste du flux de données au lieu de la traiter comme une commande isolée.
Optimiser les requêtes analytiques grâce aux statistiques et à la conception des prédicats
Les charges analytiques passent souvent inaperçues jusqu'à ce qu'elles échouent bruyamment. Le SQL est valide, mais l'optimiseur reçoit un mauvais signal parce que les clés de jointure ne correspondent pas proprement, que les statistiques du catalogue sont obsolètes ou qu'un prédicat impose une analyse plus large que nécessaire. Le guide de tuning d'IBM cite les incompatibilités de types de données, les expressions dans les prédicats de jointure, les jointures sans égalité, les jointures externes inutiles, les restrictions redondantes et les statistiques de catalogue inexactes comme des risques récurrents, et cette liste correspond à ce que les équipes observent dans les systèmes réels (guide IBM DB2 sur le tuning des requêtes).
Ce qui dégrade les performances analytiques
Les expressions sur des colonnes indexées ou de partitionnement sont un piège courant. Dès que vous enveloppez la colonne dans une fonction, le prédicat peut devenir non sargable, ce qui signifie que la base de données ne peut pas utiliser le chemin d'accès prévu et finit par analyser plus de données que nécessaire. La validation des types de données compte tout autant, car une clé de jointure incompatible peut pousser l'optimiseur vers un plan moins efficace.
C'est aussi là que les ressources d'apprentissage pratiques sont utiles. Si vous développez vos propres compétences en bases de données et souhaitez affiner la partie tuning, build database projects without a degree est une lecture externe utile, car elle aborde la progression des compétences à partir du travail réel plutôt que de la théorie.
Une boucle de validation rigoureuse
Exécutez la requête une première fois pour vérifier son exactitude, puis comparez les lignes estimées aux lignes réelles à chaque étape. Testez ensuite le comportement avec cache froid et cache chaud, mesurez le temps écoulé et la consommation de ressources, et ne modifiez qu'une seule chose à la fois. Cette séquence est plus lente que de retoucher le SQL à l'aveugle, mais c'est le seul moyen de savoir si un changement a amélioré le plan ou simplement déplacé le coût ailleurs.
Une routine solide devrait inclure :
Valider d'abord les clés de jointure. Assurez-vous que les types de données correspondent avant de toucher aux index ou aux hints.
Vérifier les erreurs d'estimation. Si les estimations de lignes du plan sont fausses, ajustez les statistiques ou la forme du prédicat avant d'incriminer le matériel.
Mesurer la consommation de ressources. CPU, mémoire, octets analysés et volume de spill ou de shuffle indiquent si la requête est saine.
Répéter après chaque changement. Plusieurs modifications simultanées masquent la cause de l'amélioration ou de la régression.
Pour les équipes qui standardisent le tuning des requêtes, le guide d'optimisation des requêtes SQL est utile, car il relie la conception des prédicats au chemin d'exécution réel au lieu de traiter l'optimisation comme un exercice de mise en forme.
Au-delà de la syntaxe L'écart de validation sémantique dans la surveillance des requêtes
Une requête peut s'exécuter avec succès et rester fausse sur des points importants. Elle peut dupliquer des lignes via une jointure, perdre des enregistrements arrivés en retard, décaler par erreur une borne de date ou agréger à la mauvaise granularité tout en renvoyant un jeu de résultats parfaitement propre. C'est pourquoi la syntaxe et le statut d'exécution sont, à eux seuls, des signaux faibles.
Des recherches indépendantes sur les bases de données montrent que les erreurs d'estimation de cardinalité sont répandues et constituent souvent la cause principale des mauvais plans de requête (recherche VLDB sur le comportement des requêtes et l'estimation de cardinalité). C'est important, car les hypothèses de l'optimiseur façonnent le plan, et le plan détermine les performances et parfois la qualité du résultat que vous pensez obtenir.
Succès d'exécution et succès sémantique
Le succès d'exécution signifie que le moteur a terminé l'instruction. Le succès sémantique signifie que la requête a renvoyé la bonne population, à la bonne granularité et avec la bonne signification métier. Ce sont deux tests différents, et les équipes de production ont besoin des deux.
Une surveillance des requêtes qui s'arrête à l'exécution passe à côté des défaillances les plus dangereuses. La requête peut être rapide, peu coûteuse et pourtant fausse. Dans la finance, la santé, les télécommunications et le secteur public, ce type d'erreur peut contaminer des rapports, des décisions opérationnelles ou des données d'entrée de modèles sans déclencher d'incident visible.
Une pratique de production plus solide consiste à associer des attentes à chaque requête critique :
Granularité attendue. Sachez si le résultat doit être au niveau client-jour, compte-mois ou autre.
Totaux de rapprochement. Comparez les totaux du résultat à un total de contrôle fiable lorsqu'il existe.
Cas limites représentatifs. Vérifiez explicitement les arrivées tardives, les clés en double et les dates limites.
Référence comportementale. Comparez la forme actuelle du résultat aux exécutions précédentes et surveillez la dérive.
L'approche in-database de digna s'inscrit dans ce modèle, car les contrôles s'exécutent là où se trouvent les données. Les équipes peuvent ainsi valider le comportement sans sortir d'enregistrements sensibles du data warehouse ou de la base opérationnelle. C'est un avantage concret lorsque l'objectif est l'observabilité, et non une copie supplémentaire des données.
Gérer les données tardives, modifiées ou partielles dans l'exploitation des requêtes
Une requête peut se terminer proprement et rester inexploitable en production. Un fichier peut arriver après l'heure limite, une source peut recharger des lignes a posteriori ou un producteur peut changer de structure sans prévenir. Le SQL s'exécute toujours, mais le résultat peut ne plus correspondre au périmètre métier visé. Les équipes qui ne s'appuient que sur des contrôles réussi ou échoué s'en aperçoivent généralement lorsqu'un dashboard bouge ou qu'un traitement en aval consomme le résultat erroné.
Les orientations de la Commission européenne sur la qualité des données considèrent la qualité comme dépendante de l'usage et citent l'exactitude, l'exhaustivité, la cohérence, l'unicité, l'intégrité, la ponctualité, la provenance et les méthodes de collecte des données comme attributs de qualité. Ce cadre convient mieux au travail opérationnel sur les requêtes qu'un simple indicateur binaire de succès.
La surveillance a besoin d'un modèle de gravité
Les contrôles de fraîcheur, de couverture des périodes, de changements de schéma et d'exhaustivité ne devraient pas tous déclencher la même réponse. Un chargement tardif mais valide peut mériter un avertissement. Un fichier source manquant devrait bloquer l'utilisation en aval. Si chaque problème est bloquant, les équipes cessent de faire confiance aux alertes. Si chaque problème est informatif, personne ne réagit assez vite.
Un contrôle solide repose sur des seuils adaptés au contexte, et non sur une règle unique réussi ou échoué pour chaque jeu de données.
Le plus difficile est de distinguer les données tardives mais valides des données manquantes. Les historiques d'arrivée aident. Les références saisonnières aussi. Tout comme un responsable clairement désigné pour chaque contrôle. Conservez des preuves pour l'analyse, car les questions après un incident sont généralement simples : qu'est-ce qui a changé, quand, et le résultat était-il encore utilisable en toute sécurité ?
Quand le contexte l'emporte sur la rigidité
Si une source arrive normalement tôt mais avec du retard une fois par semaine, la règle devrait refléter ce schéma. Si un jeu de données est corrigé plus tard dans la journée, la surveillance doit tolérer une incohérence temporaire sans masquer de vraies défaillances. C'est la frontière entre un contrôle durable et une automatisation fragile.
Pour les équipes qui ont besoin d'une définition concrète de la fraîcheur, les métriques et la surveillance de la ponctualité des données offrent une manière pratique de définir l'ensemble de règles et le modèle de gravité des alertes.
Les entrées tardives et changeantes nécessitent aussi des contrôles sémantiques. La granularité, la population et la signification métier peuvent dériver même lorsque la fraîcheur semble acceptable. C'est là qu'une approche in-database aide, car elle permet aux équipes de valider ces conditions là où se trouvent les données au lieu de copier des enregistrements uniquement pour les inspecter.
Enseignements pratiques pour une exécution fiable des requêtes
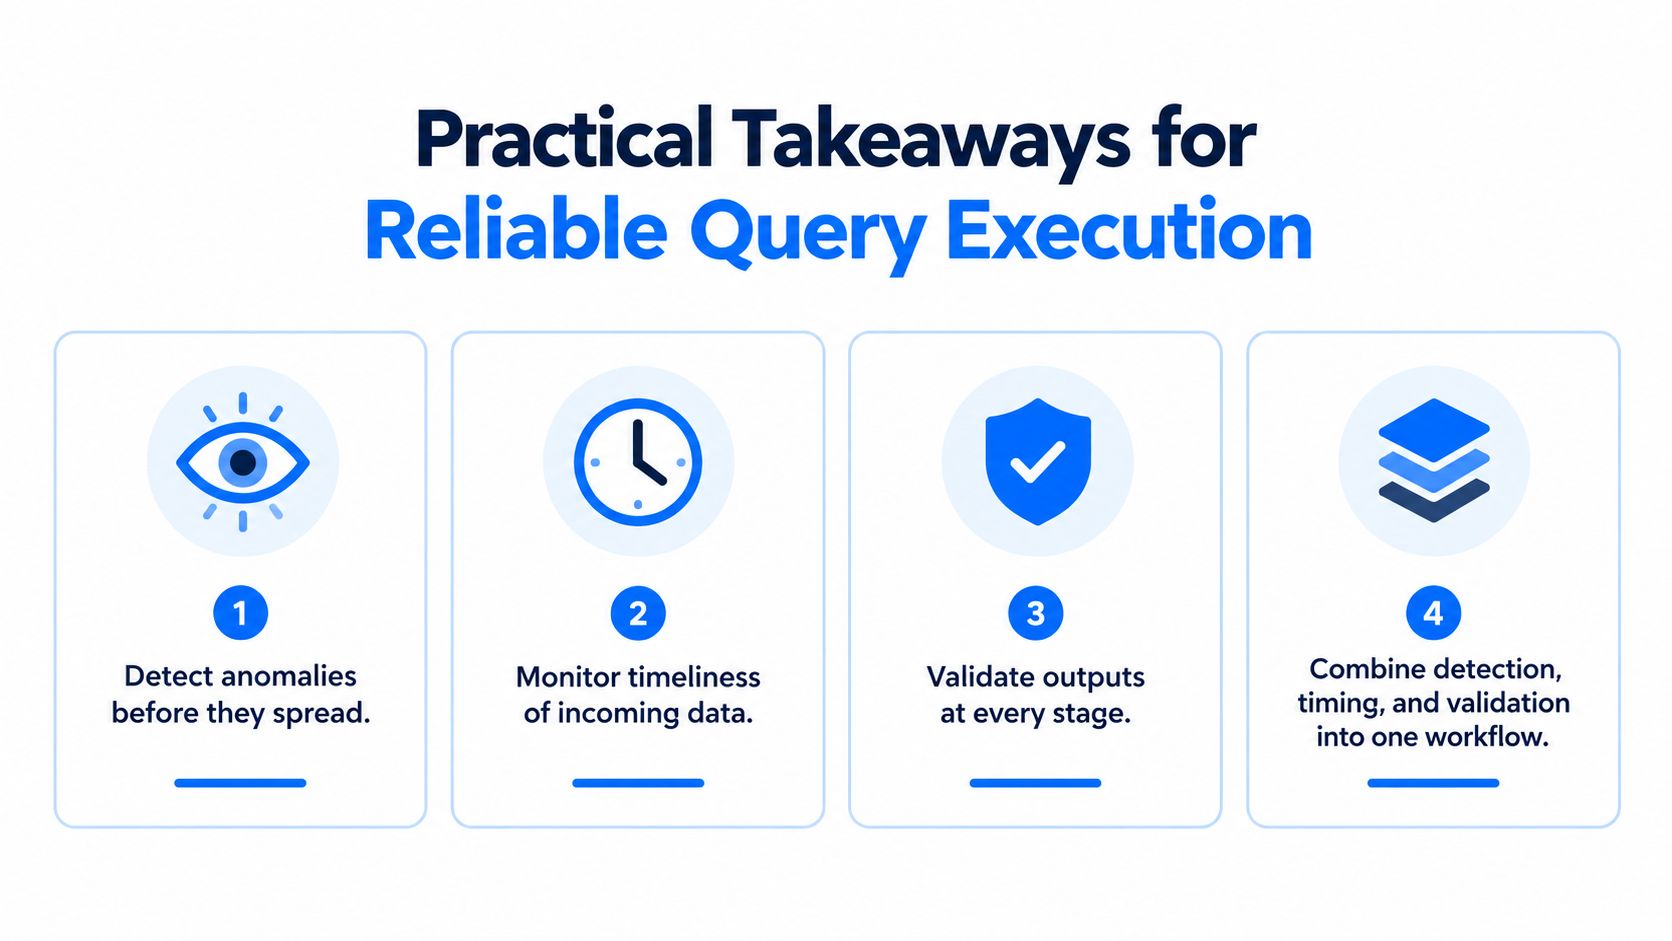
Une requête qui renvoie un résultat sans erreur peut tout de même être fausse. En production, une exécution fiable repose sur la combinaison du contrôle des performances, du contrôle de la ponctualité et de la validation sémantique, car un résultat rapide avec la mauvaise granularité ou la mauvaise population reste un échec.
Ce qu'il faut standardiser
Commencez par la granularité attendue et la fenêtre de latence acceptable pour chaque requête importante. Enregistrez une référence pour le temps d'exécution, les lignes analysées et la forme du résultat, afin que les régressions soient visibles lorsque le comportement change. Si vous vérifiez seulement que l'instruction s'est terminée, vous passez à côté de la dérive qui compte.
Gardez une politique assez simple pour que les opérateurs puissent l'appliquer sous pression. Définissez quelles défaillances bloquent l'utilisation, lesquelles déclenchent une revue et lesquelles sont tolérables pendant une courte période. Cette approche aligne détection, validation et gouvernance sans transformer chaque alerte en crise.
Ce qui fonctionne en production
Utilisez la détection d'anomalies pour la dérive, les contrôles de ponctualité pour les arrivées et la validation pour les règles métier. Exécutez ces contrôles dans la base de données lorsque c'est possible, car copier les données ailleurs uniquement pour les inspecter ajoute du coût et du risque. Si le data warehouse peut tester le comportement là où les données se trouvent déjà, le diagnostic est plus rapide et le flux d'alertes inspire davantage confiance.
Pour les performances des requêtes, gardez l'examen du plan et la comparaison avec la référence dans la même boucle. Si le plan change, examinez-le. Si les estimations de lignes dérivent, comparez-les aux valeurs réelles. Si le temps d'exécution reste dans le budget mais que la forme du résultat est anormale, traitez-le comme un problème de données et non comme une exécution réussie.
Pour les équipes qui comparent les approches, le tuning des performances des bases de données pour des requêtes fiables est un complément pratique, car il relie le comportement des requêtes à la stabilité de la charge de travail plutôt qu'à des corrections isolées.
Si vous devez surveiller le comportement des requêtes, détecter la dérive tôt et valider les résultats sans déplacer de données sensibles, rendez-vous sur digna. digna exécute les contrôles dans votre data warehouse, de sorte que vous validez la granularité, la ponctualité et la dérive sans déplacer un seul enregistrement.
Pour comprendre plus en détail pourquoi les contrôles exécutés là où se trouvent les données sont à la fois plus sûrs et plus rapides que l'export d'enregistrements vers un outil externe, consultez notre article sur l'exécution in-database de la qualité des données.
Questions fréquentes
Que signifie exécuter une requête efficacement ?
Exécuter une requête efficacement signifie qu'elle renvoie le bon résultat, respecte son budget de latence et de ressources et se comporte de manière cohérente sur des données représentatives. Se terminer sans erreur n'est que le niveau le plus bas. Une requête peut être rapide et peu coûteuse tout en étant fausse si elle agrège à la mauvaise granularité.
Pourquoi filtrer avant une jointure en SQL ?
Filtrer avant la jointure permet à la base de données de travailler sur moins de lignes, ce qui réduit le volume analysé et la taille des résultats intermédiaires. Appliquez les conditions tôt et ne sélectionnez que les colonnes nécessaires. L'effet est le plus marqué sur des tables sources volumineuses ou déséquilibrées, comme le recommande aussi BigQuery.
Que faut-il vérifier dans un plan d'exécution ?
Examinez l'ordre des jointures, le volume analysé, les estimations de cardinalité et toute étape de tri ou d'agrégation susceptible de devenir un goulot d'étranglement. Comparez ensuite les lignes estimées aux lignes réelles à chaque étape, car la recherche identifie les erreurs d'estimation de cardinalité comme une cause majeure de mauvais plans.
Pourquoi une requête exécutée avec succès peut-elle renvoyer de mauvais résultats ?
Le succès d'exécution signifie seulement que le moteur a terminé l'instruction. Le résultat peut tout de même dupliquer des lignes via une jointure, omettre des enregistrements tardifs, décaler une borne de date ou agréger à la mauvaise granularité. Des attentes comme la granularité, les totaux de rapprochement et une référence comportementale détectent ces erreurs sémantiques.
Comment les données tardives ou partielles doivent-elles influencer la surveillance des requêtes ?
Les données tardives ou partielles exigent un modèle de gravité plutôt qu'une règle unique réussi ou échoué. Un chargement tardif mais valide peut ne mériter qu'un avertissement, alors qu'un fichier source manquant doit bloquer l'utilisation en aval. Les historiques d'arrivée et les références saisonnières aident à distinguer données tardives et données manquantes.


