Framework de Data Observability : Un guide pratique 2026
|
6
minute de lecture
Le conseil le plus populaire concernant un framework de data observability est également le plus incomplet : déployez les cinq piliers, connectez les alertes et déclarez la plateforme observable. La fraîcheur, le volume, la distribution, le schéma et la lignée sont des signaux nécessaires, mais ils n'indiquent pas à la personne qui doit agir la rapidité requise, ni si une anomalie a une importance pour l'entreprise.
Un tableau de bord peut afficher un pipeline défaillant alors que les dirigeants reçoivent encore des chiffres incorrects. Un véritable framework connecte la détection à la responsabilité, à la data governance, à la réponse aux incidents et au contrôle des coûts. Cette distinction est cruciale alors que la data observability s'impose dans la planification stratégique des grandes entreprises. Une étude de marché de 2026 estime que la catégorie passera de 3,51 milliards USD en 2026 à 6,03 milliards USD d'ici 2031, tandis qu'une autre prévoit une croissance de 2,90 milliards USD en 2025 à 8,79 milliards USD d'ici 2035. Ces deux estimations situent le marché à un taux de croissance annuel composé (CAGR) d'environ 11 %, preuve que l'observability est devenue une catégorie de logiciels pérenne plutôt qu'une pratique expérimentale d'ingénierie des données (analyse de marché de SNS Insider).
Table des matières
Pourquoi la plupart des programmes de Data Observability s'arrêtent aux cinq signaux
Détecter n'est pas la même chose que répondre
La couche de governance est le système manquant
Ce qu'est réellement un Framework de Data Observability
Quatre couches rendent le framework exploitable
Les cinq signaux fondamentaux et ce que chacun détecte
Rôles et Governance au sein du Framework
Placer la responsabilité dans l'actif de données
Points d'intégration à travers les pipelines, les entrepôts et la BI
Transporter le contexte dans l'entrepôt et la couche BI
Un modèle de maturité en quatre étapes pour vous auto-évaluer
Quatre étapes de maturité opérationnelle
Une feuille de route de démarrage sur 90 jours pour 2026
Jours 1 à 30 : établir les responsabilités
Jours 31 à 60 : ajouter une détection légère
Jours 61 à 90 : boucler la boucle
Questions fréquentes que les acheteurs et architectes se posent encore
Combien doit coûter le choix entre développer ou acheter ?
Quelles fonctionnalités logicielles sont importantes ?
Combien de temps faut-il pour obtenir une couverture significative ?
Pourquoi la plupart des programmes de Data Observability s'arrêtent aux cinq signaux
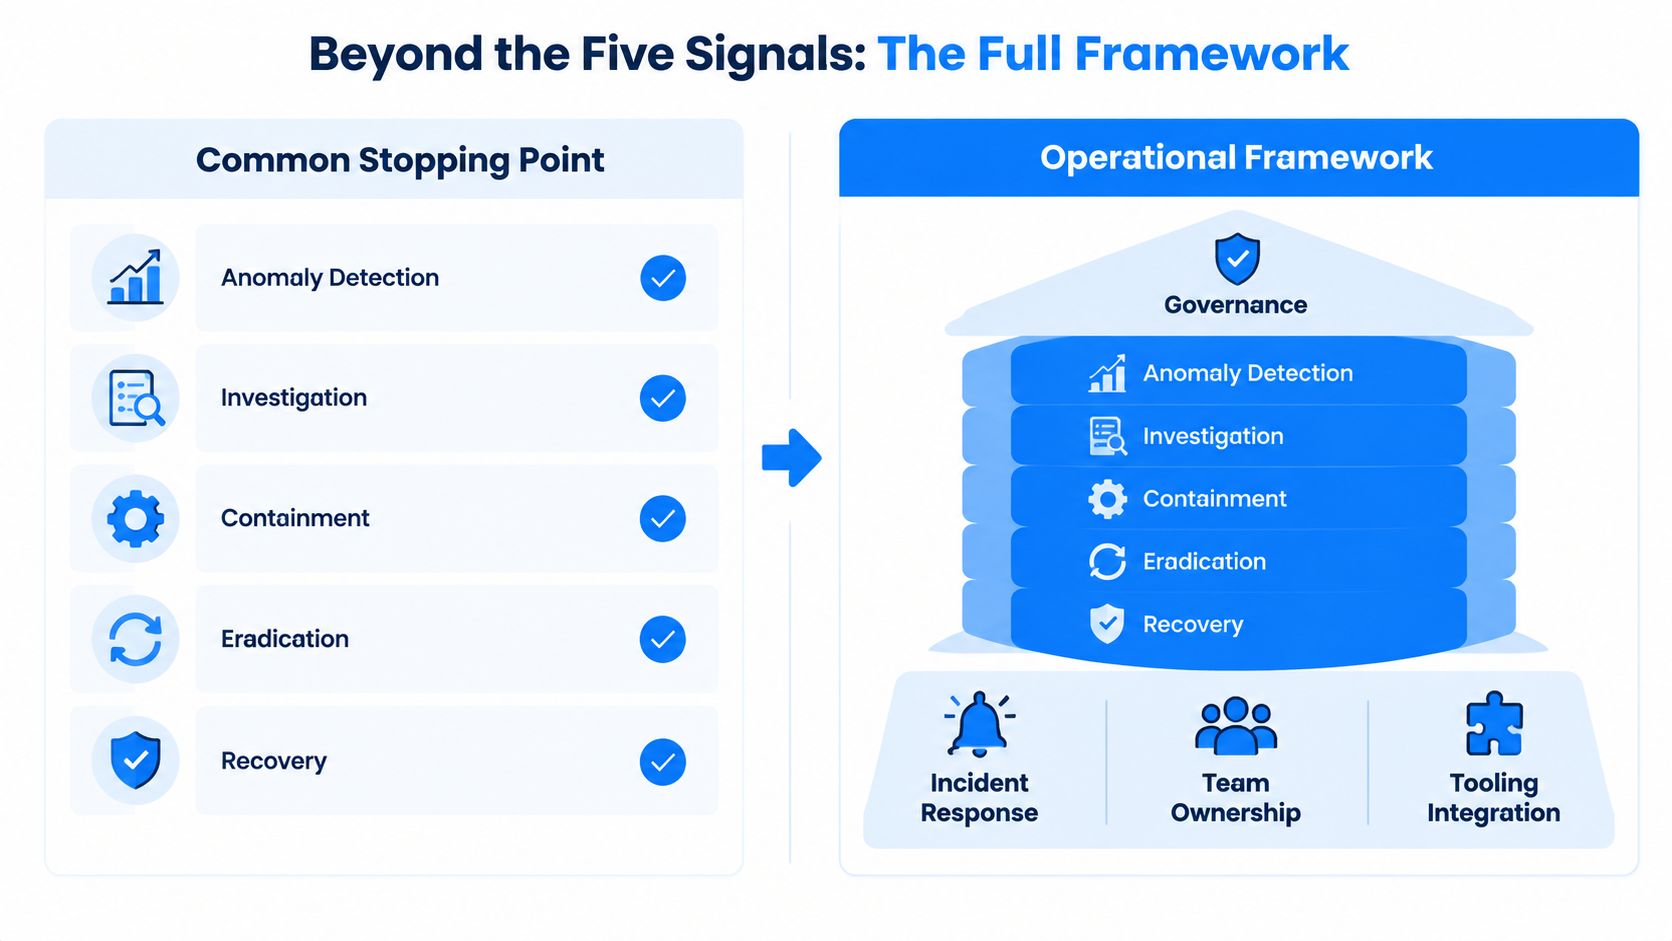
Les cinq signaux sont souvent confondus avec un framework finalisé. Ils ne constituent que la couche de télémétrie. Sans discipline opérationnelle, la télémétrie ne produit qu'un échec bien instrumenté.
La fraîcheur, le volume, la distribution, le schéma et la lignée peuvent tous apparaître en vert ou en rouge sur un tableau de bord alors que l'organisation manque toujours d'un propriétaire désigné, d'un parcours d'escalade, d'une règle de suppression ou d'un guide de remédiation. Un schéma d'échec classique s'ensuit : une alerte arrive sur Slack, personne n'a d'attente définie pour le tri, le propriétaire du produit de données suppose que l'ingénierie s'en occupe, et l'incident reste ouvert jusqu'à ce qu'une partie prenante repère un chiffre incorrect.
Détecter n'est pas la même chose que répondre
Un signal répond à une seule question étroite. La table est-elle arrivée à l'heure ? Le volume de lignes a-t-il changé ? Le schéma a-t-il dérivé ? Il ne répond pas aux questions opérationnelles qui établissent l'impact commercial :
Qui possède l'actif de données ?
Qui trie l'alerte ?
Quels utilisateurs sont affectés ?
Quel est le temps de réponse applicable ?
Le pipeline doit-il être mis en quarantaine, relancé ou poursuivi ?
Quelle cause racine récurrente nécessite une correction architecturale ?
Ce fossé permet à un environnement riche en signaux de continuer à envoyer des chiffres erronés aux dirigeants. L'organisation dispose d'une visibilité, mais d'aucun accord sur l'action que cette visibilité doit déclencher.
Une configuration de surveillance plus modeste peut s'avérer plus performante lorsque la propriété est explicite. Un ensemble de données critique doté d'un gestionnaire documenté, d'une attente de niveau de service, d'un canal d'escalade et d'un guide de remédiation testé est plus utile que des centaines de moniteurs sans propriétaire. Le framework gagne sa légitimité en raccourcissant le chemin entre l'anomalie et l'action responsable.
Règle pratique : Une alerte sans propriétaire, sans niveau de gravité et sans parcours de réponse est une notification, pas un contrôle opérationnel.
La couche de governance est le système manquant
La governance détermine quelles déviations interrompent le travail et lesquelles ont leur place dans un rapport de tendance. Elle définit la criticité, la variance acceptable, les fenêtres de maintenance, les règles de suppression, la conservation des preuves et les niveaux d'escalade. Elle enregistre également si un incident récurrent reflète un problème de source temporaire ou un défaut de conception dans le pipeline.
L'évolution de cette catégorie reflète ce changement de responsabilité. Gartner a publié son premier Guide du marché pour les outils de Data Observability le 23 février 2026, reconnaissant la data observability comme une catégorie distincte de logiciels d'entreprise couvrant la détection d'anomalies, les alertes, la lignée et les flux de travail de réponse aux incidents (discussion de Monte Carlo sur le guide de Gartner). Le changement important est pratique : les entreprises peuvent traiter l'observability comme une capacité d'architecture et de governance, plutôt que comme une collection de scripts de surveillance.
What a Data Observability Framework Actually Is
Une définition pratique commence par l'objectif opérationnel. Gartner décrit les outils de data observability comme aidant les organisations à comprendre l'état et la santé des données, des pipelines, de l'infrastructure et des coûts opérationnels financiers dans des environnements distribués grâce à une surveillance continue, un suivi, des alertes, des analyses et des dépannages (définition des outils de data observability par Gartner).
Traduit en termes d'ingénierie, un data observability framework est un système en couches qui transforme la télémétrie des données en actions humaines gouvernées. Il combine des signaux de détection, des métadonnées contextuelles, une propriété attribuée, des processus de réponse et des politiques qui déterminent quelles anomalies sont importantes et ce qui se passe ensuite. Le framework se situe entre la télémétrie brute et les décisions opérationnelles, tout comme un système d'exploitation coordonne les signaux matériels, les applications, les autorisations et les actions des utilisateurs.

Four layers make the framework usable
Chaque implémentation neutre vis-à-vis des fournisseurs nécessite quatre couches :
Couche de signal : Fraîcheur, volume, distribution, schéma, lignée et toute métrique de qualité ou de plateforme spécifique au domaine.
Couche de contexte : Criticité de l'ensemble de données, contrats de données (Data Contracts), propriété, dépendances en aval, modifications récentes, sensibilité et utilisation commerciale.
Couche de réponse : Routage des alertes, création d'incidents, tri, mise en quarantaine, remédiation, examen post-incident et capture de preuves.
Couche de governance : Politiques pour les SLA, la gravité, la suppression, l'accès, la conservation, l'escalade et la gestion des risques récurrents.
Les cinq signaux appartiennent à la première couche. Ils ne deviennent opérationnels que lorsque les trois autres couches apportent du sens et des conséquences. Pour une introduction concise sur la réduction des risques grâce à la data observability, ce qu'il faut retenir, c'est que la détection est précieuse parce qu'elle permet une intervention plus rapide et mieux informée, et non parce qu'elle ajoute un énième tableau de bord.
L'architecture doit également correspondre à l'environnement. Dans les secteurs réglementés, les équipes ont besoin de contrôles qui fonctionnent sur des systèmes cloud, hybrides et sur site, qui préservent les preuves d'audit et évitent les déplacements inutiles de données sensibles. Un framework peut être assemblé à partir d'orchestrateurs existants, de fonctionnalités d'entrepôt, de catalogues et de systèmes d'incidents, ou fourni par une plateforme dédiée. La conception importe plus que le nom du fournisseur.
Les équipes qui évaluent une plateforme peuvent utiliser les capacités de data observability de digna comme exemple d'approche modulaire combinant la détection d'anomalies, la Timeliness, la validation et le suivi des schémas avec une exécution en base de données.
The Five Core Signals and What Each One Catches
Les cinq signaux restent le fondement technique approprié, à condition que chacun soit lié à un mode de défaillance et à une politique de réponse. Un framework mature ne collecte pas de métriques simplement parce qu'elles sont disponibles. Il choisit des mesures capables de détecter des changements significatifs au plus près des données.
La Freshness mesure le moment de l'arrivée par rapport à un calendrier prévu ou à un SLA. Un horodatage de niveau maximum peut révéler des tâches bloquées, des partitions abandonnées ou une limitation d'API qui fige l'ingestion. Utilisez des centiles plutôt que des moyennes lorsque le retard varie, car une moyenne peut masquer des événements tardifs marginaux qui affectent les utilisateurs. Les conseils pratiques en matière de Timeliness doivent distinguer les livraisons tardives, manquantes et de façon inattendue en avance, comme expliqué dans les métriques et la surveillance de la data timeliness.
Le Volume compare le nombre de lignes, la taille en octets ou la taille des partitions avec les plages attendues. Il détecte les chargements tronqués, les écritures en double causées par des tentatives infructueuses et les boucles de rétro-alimentation silencieuses. Une plage doit tenir compte de la croissance normale et de la saisonnalité, sinon le moniteur transforme un changement commercial de routine en bruit.
La Distribution examine le comportement statistique des champs numériques et les fréquences de catégories dans les dimensions. Les statistiques sur fenêtre glissante et les Z-scores peuvent faire surface une dérive que le volume total ne détecte pas, notamment les erreurs de cartographie en amont ou les modifications d'étalonnage des capteurs. Les vérifications de distribution nécessitent des références spécifiques aux ensembles de données, car les métriques de production peuvent être saisonnières, volatiles, multivariées et affectées par des changements de régime. Le benchmark BOOM de Datadog illustre ce défi de modélisation avec 350 millions d'observations sur 2 807 séries chronologiques de production réelles, évaluées sur plusieurs horizons de prévision (discussion sur le benchmark BOOM de Datadog).
Le Schema valide la structure par rapport à un contrat attendu. Les colonnes ajoutées ou supprimées, les types de données modifiés et la possibilité de valeurs nulles altérée peuvent casser les transformations sans pour autant arrêter l'ingestion. La dérive de schéma est particulièrement dangereuse lorsqu'une équipe source modifie un champ de nullable à non-nullable ou supprime une colonne que le code SQL en aval attend toujours.
La Lignée (lineage) représente le graphe de dépendance de la source à la consommation. Elle révèle les ensembles de données orphelins, les jointures rompues après des refontes et les dépréciations en amont non signalées. La lignée au niveau des colonnes est particulièrement utile lorsqu'un champ modifié alimente un petit nombre de métriques critiques au sein d'une table beaucoup plus grande.
Signal | Mode de défaillance détecté | Mécanisme de détection |
|---|---|---|
Freshness | Arrivées tardives, manquantes, bloquées ou anormalement précoces | Retard d'horodatage par rapport à un SLA, un calendrier ou une référence apprise |
Volume | Chargements tronqués, écritures en double et boucles de rétro-alimentation | Comparaison du nombre de lignes, de la taille en octets et de la taille des partitions |
Distribution | Dérive statistique, erreurs de cartographie et changements de catégories | Statistiques sur fenêtre glissante, analyse de fréquence et Z-scores |
Schema | Champs ajoutés, supprimés, modifiés ou en rupture de contrat | Comparaison structurelle par rapport aux attentes enregistrées |
Lineage | Dépendances rompues, actifs orphelins et rayon d'impact masqué | Continuité du graphe de dépendance et analyse d'impact |
Ces signaux sont relativement simples à déployer. Ils sont plus difficiles à maintenir lorsque chaque table se voit appliquer des attentes identiques. Hiérarchisez les actifs critiques, définissez différentes politiques de gravité et laissez les anomalies de faible valeur s'agréger dans des rapports plutôt que d'interrompre un ingénieur d'astreinte. C'est la governance, et non la détection, qui représente la partie coûteuse pour rendre l'observability utile.
Roles and Governance Inside the Framework
Un framework sans propriété définie est un tableau de bord auquel personne ne répond. Le modèle opérationnel le plus sain sépare la détection, le tri et la remédiation, puis rend le transfert de responsabilité explicite.
Les ingénieurs de plateforme de données ou les ingénieurs en fiabilité des sites (SRE) exploitent généralement l'infrastructure de surveillance et détectent les anomalies techniques. Les propriétaires de produits de données trient ces anomalies car ils comprennent la signification commerciale de l'actif, ses utilisateurs et son comportement acceptable. La remédiation nécessite souvent à la fois des ingénieurs de données, qui corrigent les pipelines d'ingestion ou de transformation, et des ingénieurs analytiques, qui corrigent la logique des métriques ou les modèles sémantiques.
Put accountability in the asset
Les matrices RACI aident lors du lancement, mais elles s'étiolent souvent après des réorganisations. La propriété doit résider dans le Data Contract ou les métadonnées de catalogue associées à l'actif. Au minimum, chaque ensemble de données critique doit déclarer :
Le gestionnaire responsable (steward) : la personne ou l'équipe responsable du produit de données.
L'attente de service : le comportement en matière de fraîcheur, d'exhaustivité et de disponibilité sur lequel les utilisateurs peuvent compter.
Le parcours d'astreinte : le canal ou le service d'incident qui reçoit les alertes exploitables.
La criticité : le niveau d'importance commerciale qui détermine la gravité et l'escalade.
Le guide de remédiation (runbook) : les premières étapes de diagnostic et de remédiation.
Un incident de niveau P1 affectant un tableau de bord de direction doit contourner la file d'attente standard et atteindre un agent d'astreinte défini en moins de 15 minutes. Cette attente de réponse est une politique opérationnelle, pas une propriété de l'outil de détection. La politique doit également spécifier qui peut mettre les données en quarantaine, qui approuve une rétro-alimentation et qui communique avec les utilisateurs.
Module | Responsable de la détection | Responsable du tri | Responsable de la remédiation |
|---|---|---|---|
Fraîcheur d'ingestion | Plateforme de données ou SRE | Propriétaire du produit de données | Ingénieur de données et propriétaire de la source |
Contrat de schéma | Équipe d'ingestion ou de plateforme | Propriétaire du produit de données | Ingénieur de la source et ingénieur de données |
Distribution des métriques | Opérateur d'observability | Ingénieur analytique | Ingénieur analytique et ingénieur de données |
Impact sur la lignée | Équipe catalogue ou plateforme | Gestionnaire et propriétaires concernés | Équipes d'ingénierie propriétaires |
Flux d'incident | SRE ou opérations de données | Gestionnaire d'incident | Résolveur technique affecté |
Les pannes courantes sont prévisibles. Les couches d'ingestion n'ont souvent pas de propriétaire durable, les réorganisations laissent des actifs orphelins, et le passage de relais entre l'ingénierie des données et l'ingénierie analytique laisse persister la dérive sémantique car chaque groupe suppose que l'autre possède la métrique. Un modèle clair de rôles de data governance est utile, mais le contrat et le parcours d'escalade doivent être appliqués dans les opérations quotidiennes.
Integration Points Across Pipelines, Warehouses, and BI
L'observability ne fonctionne que là où la télémétrie est connectée. Un framework qui surveille l'entrepôt mais ignore l'ingestion, l'orchestration, les modèles sémantiques ou les flux d'ETL inversé présente des zones d'ombre qui ressemblent faussement à de la fiabilité.
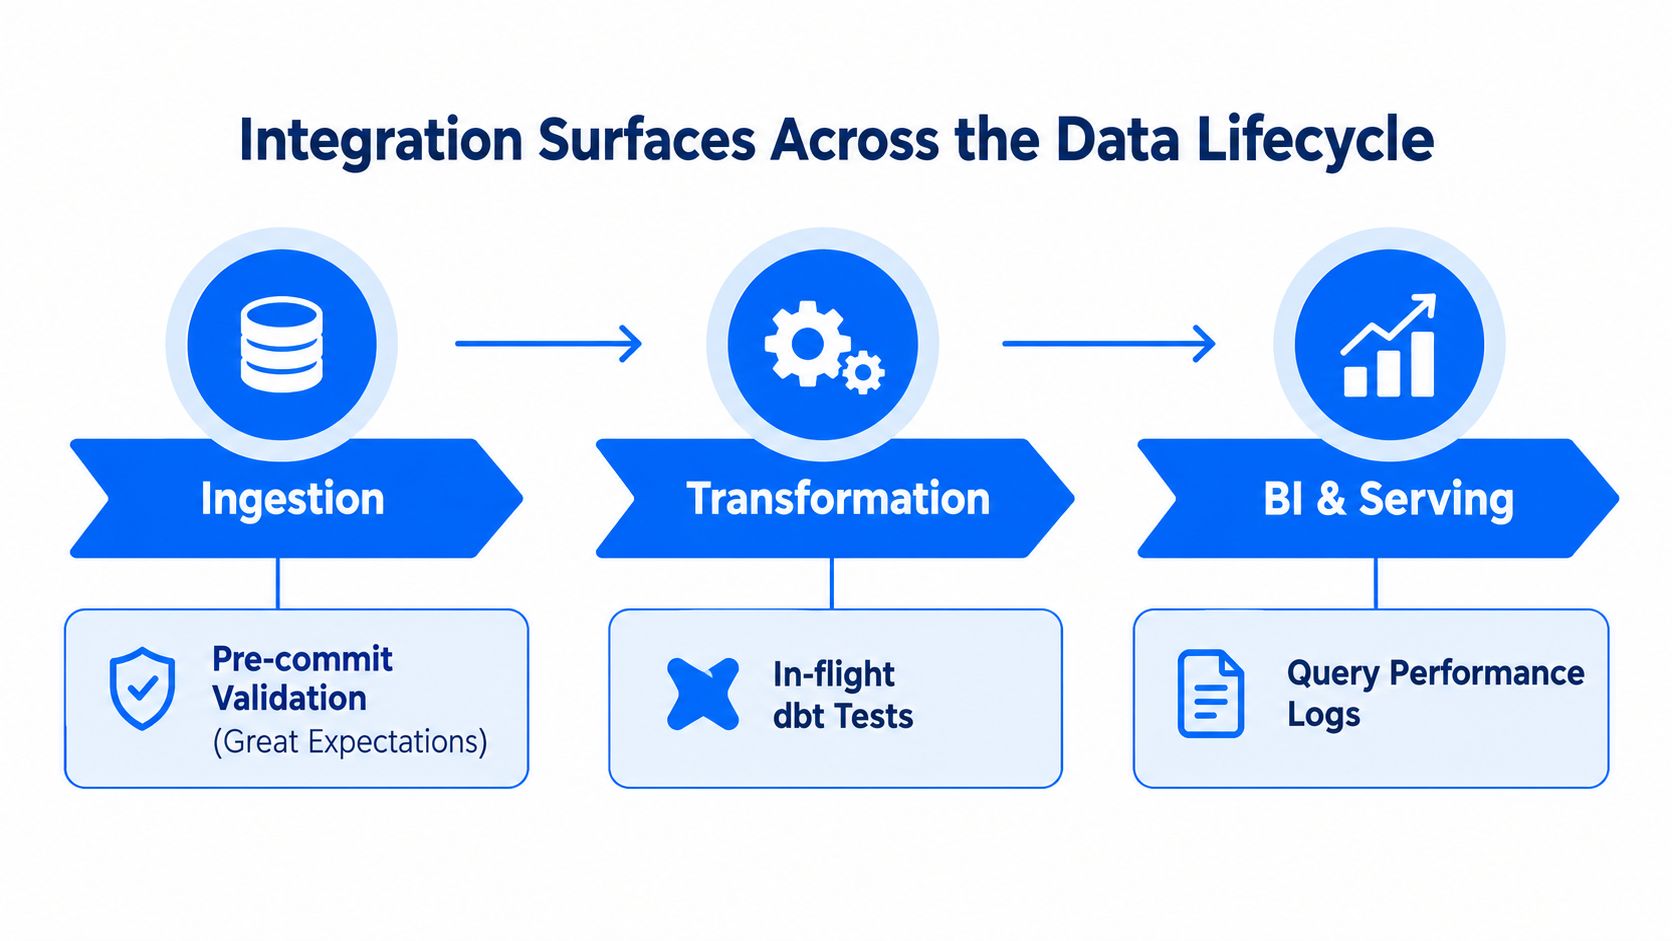
Au moment de l'ingestion, associez une validation de schéma avant validation (pre-commit) aux adaptateurs de source et aux vérifications de déploiement. Great Expectations peut valider des attentes explicites, tandis que la comparaison de schémas (schema diffing) peut comparer les structures entrantes avec les contrats enregistrés. Émettez le résultat sous forme d'événement de validation contenant l'actif, la version, les champs modifiés et le contexte de déploiement. L'alerte de consommation doit acheminer les modifications de rupture vers la source et les propriétaires en aval avant que la nouvelle structure n'atteigne la production.
Pendant la transformation, utilisez des tests d'outils d'ingénierie tels que dbt, des capteurs Airflow, des vérifications d'actifs Dagster ou des délais d'attente Prefect au moment précis où le pipeline sait si une tâche est terminée et si sa sortie est exploitable. Émettez l'état d'exécution, la durée, l'horodatage de sortie, le nombre de lignes et le contexte d'échec dans un magasin de télémétrie partagé. Un échec d'orchestration doit créer un seul incident avec le contexte de dépendance, et non des alertes distinctes pour chaque tâche en aval.
Carry context into the warehouse and BI layer
L'historique des requêtes de l'entrepôt peut révéler des changements de distribution, une consommation inhabituelle, des analyses coûteuses et des charges de travail qui contournent le parcours de transformation attendu. Ces métriques doivent être placées à côté des signaux de santé des données afin que les équipes de plateforme puissent relier une anomalie de données à une requête, un déploiement ou un changement de charge de travail récent.
La couche BI a besoin de réconciliation, et pas seulement de l'état du pipeline. Comparez les sorties des modèles sémantiques avec les tables de vérité, validez les définitions des métriques et vérifiez si l'état de rafraîchissement d'un tableau de bord correspond à ses attentes publiées. La logique métier dérive souvent alors même que les transformations brutes restent techniquement saines.
Les intégrations de lignée avec DataHub, Atlan ou Unity Catalog permettent de calculer rapidement le rayon d'impact. Intégrez autant que possible dans le graphe les scripts SQL non gérés, les flux d'ETL inversé vers les systèmes opérationnels et les définitions de la couche sémantique. Une approche d'intégration d'entrepôt de données doit préserver le flux de métriques depuis les vérifications des sources jusqu'aux événements de transformation et à la réconciliation de la BI.
L'objectif est d'obtenir une chronologie d'incident unifiée. Un changement de schéma, une tâche échouée, une anomalie de volume, un tableau de bord affecté, un propriétaire et un événement de remédiation doivent apparaître sous la forme d'un enregistrement unique et connecté, plutôt que sous forme de fragments dispersés entre la surveillance, le catalogue, l'orchestration et les outils de discussion.
A Four-Stage Maturity Model You Can Self-Assess Against
Les modèles de maturité deviennent des exercices de vanité lorsqu'ils mesurent l'installation d'outils plutôt que le comportement opérationnel. À chaque étape, la question utile n'est pas de savoir si une fonctionnalité existe, mais si l'équipe peut prouver que les collaborateurs y répondent de manière cohérente.
Four stages of operational maturity
Étape 1 : Réactive. Les parties prenantes découvrent les problèmes en se plaignant des tableaux de bord ou des rapports. Demandez-vous si l'équipe mesure le temps de résolution des incidents. Si personne ne peut identifier quand un incident a commencé, qui en était le propriétaire ou quand il a été clôturé, le programme est réactif, quel que soit le nombre de contrôles en place.
Étape 2 : Proactive. La surveillance automatisée de la fraîcheur et des schémas couvre les pipelines critiques, mais la couverture reste partielle et la propriété informelle. Demandez quelle proportion des actifs de niveau un dispose d'un SLA déclaré et d'un gestionnaire désigné. Si la réponse nécessite une recherche manuelle, l'organisation dispose de la détection mais pas d'une responsabilité fiable.
Étape 3 : Opérationnelle. Les signaux, la lignée et la réponse aux incidents sont standardisés. Les alertes font référence à des Data Contracts, à des règles de gravité et à des propriétaires, tandis que l'équipe suit le coût de l'observability et les pannes récurrentes. Demandez-vous si les défaillances d'actifs non critiques continuent de créer des tempêtes d'alertes. Si c'est le cas, le programme n'a pas mis en place une governance basée sur la criticité.
Étape 4 : Intégrée. L'observability fait partie du cycle de vie du développement logiciel (SDLC) des données. Les tests de contrats, la politique en tant que code, les vérifications de schémas et les barrières de déploiement empêchent les régressions avant la production. Demandez si les équipes déploient régulièrement des modifications sans régression d'observability. Les équipes matures rendent ce comportement difficile car les contrats et les vérifications s'exécutent lors de la livraison.
Étape | Question de diagnostic | Indicateur opérationnel |
|---|---|---|
Réactive | Le temps de résolution des incidents est-il mesuré ? | Les parties prenantes signalent les pannes après impact |
Proactive | Quels actifs de niveau un ont des SLA déclarés ? | Des vérifications automatisées existent sur les pipelines critiques |
Opérationnelle | Les pannes de faible criticité déclenchent-elles encore des tempêtes d'alertes ? | Signaux, lignée, propriété et réponse standardisés |
Intégrée | Les équipes peuvent-elles livrer sans régression d'observability ? | Les contrats et les barrières de politique s'exécutent dans le SDLC |
Les équipes se retrouvent souvent bloquées entre l'adoption et la discipline. Elles achètent un outil avant de classifier les actifs, créent des seuils globaux et célèbrent le nombre de moniteurs alors que la propriété reste ambiguë. Un modèle de maturité de qualité des données structuré n'est utile que lorsque chaque étape exige des preuves issues des incidents, des contrats et des comportements de réponse.
A 90 Day Starting Roadmap for 2026
Une équipe manquant de ressources n'a pas besoin d'instrumenter chaque ensemble de données dès le premier jour. Elle a besoin d'une boucle de contrôle étroite qui prouve la propriété, produit des signaux utiles et crée un enregistrement d'incident répétable.
Jours 1 à 30 : établir les responsabilités
Commencez par les 20 ensembles de données ayant un impact sur le chiffre d'affaires dont dépendent la direction, la finance, les clients ou les opérations clés. Attribuez un propriétaire responsable à chacun, enregistrez sa criticité et son comportement de livraison attendu, et définissez un canal Slack unique comme point d'entrée des incidents. Ce canal n'est pas le système d'incident final, mais il donne à l'équipe un chemin commun pendant que le flux opérationnel gagne en maturité.
Pour chaque actif, capturez les modes de défaillance actuels, les utilisateurs en aval, le contact d'escalade et le guide de remédiation minimal. N'ajoutez pas encore de surveillance globale. Assurez-vous d'abord que chaque future alerte a une destination définie.
Jours 31 to 60, add lightweight detection
Intégrez des vérifications de fraîcheur et de volume dans l'orchestrateur existant. Ajoutez une comparaison de schémas (schema diffing) à l'ingestion, et envoyez les échecs avec l'actif, le propriétaire, le comportement attendu, le comportement observé et le contexte de dépendance probable. Organisez une revue hebdomadaire de la santé des données qui examine les alertes non résolues, les causes répétées et les moniteurs sur lesquels personne n'a agi.
Évitez les seuils génériques. Une règle fixe appliquée à chaque table produit du bruit car les tables ont des calendriers, des modèles de croissance et des conséquences commerciales différents. Commencez par des attentes explicites pour les ensembles de données critiques et utilisez des références historiques lorsque le comportement est variable.
Jours 61 to 90, close the loop
Ajoutez la lignée pour les colonnes critiques et définissez des SLO au niveau de l'ensemble de données. Documentez la différence entre la mise en quarantaine automatique et l'escalade humaine. Un lot malformé peut être mis en quarantaine en toute sécurité, tandis qu'un flux réglementaire retardé peut nécessiter une notification immédiate au propriétaire et une communication commerciale.
Les deux pièges du déploiement sont les tempêtes d'alertes et les ensembles de données orphelins. Supprimez ou regroupez les anomalies de faible gravité, et refusez d'intégrer un actif sans un gestionnaire désigné. Le résultat doit être un framework restreint mais complet : une détection connectée à la propriété, à la réponse, aux preuves et à l'examen.
Common Questions Buyers and Architects Still Ask
What should build versus buy cost?
La décision repose sur la capacité d'ingénierie, la profondeur d'intégration, la couverture et les attentes de service. Une suite open source utilisant des outils comme Great Expectations, OpenLineage et Marquez peut réduire les coûts de licence, mais l'équipe reste responsable du déploiement, des mises à niveau, des connecteurs, de la qualité des métadonnées, du routage des alertes et des flux d'incidents.
Les plateformes commerciales échangent une partie de cette charge de travail interne contre des frais de licence et une dépendance vis-à-vis du fournisseur. Comparez la charge opérationnelle totale plutôt que le seul prix de l'abonnement. Incluez le temps d'ingénierie, l'infrastructure, le déplacement des données, l'examen de sécurité, le support et le coût opérationnel des alertes bruyantes ou incomplètes.
Les résultats des enquêtes disponibles en 2026 montrent pourquoi ce compromis mérite d'être étudié de près. 38 % des personnes interrogées ont cité la complexité et les frais généraux comme leur principale préoccupation en matière d'observability, tandis que 30 % ont identifié la fatigue liée aux alertes comme le principal obstacle à une réponse plus rapide aux incidents, selon l'enquête de Grafana Labs (enquête sur l'observability de Grafana Labs). Considérez ces chiffres comme des indicateurs de planification, et non comme un argument automatique pour développer ou acheter.
Le framework doit également prendre en compte des contrôles qu'une démonstration de produit pourrait masquer. Demandez qui maintient les règles, qui possède les vérifications échouées, comment les preuves sont conservées et si le modèle opérationnel fonctionne toujours lorsque la plateforme n'est pas disponible.
Which vendor capabilities matter?
Évaluez le chemin de détection et de réponse avant de juger de la conception du tableau de bord :
Détection basée sur les journaux vs basée sur les requêtes : les journaux fournissent le contexte de l'événement de pipeline, tandis que les requêtes inspectent le comportement réel de l'entrepôt. De nombreux environnements nécessitent les deux.
Lignée au niveau des colonnes : les graphes au niveau des tables peuvent ne pas suffire pour l'analyse d'impact des métriques réglementées.
Support natif de l'entrepôt : confirmez que les vérifications s'exécutent efficacement dans les systèmes qui hébergent les données.
Application de la propriété : vérifiez si la plateforme achemine et escalade les incidents ou se contente d'afficher les anomalies.
Modèle économique : vérifiez si la tarification dépend des analyses, des alertes, des appels d'API, des tables, des modules ou du volume d'utilisation.
Contrôle du déploiement : les options de cloud privé et sur site sont importantes lorsque les données de production ne peuvent pas quitter l'environnement du client.
Un tableau de bord n'est pas un modèle opérationnel. Un framework nécessite que la détection, la propriété, l'escalade, les preuves et l'examen soient connectés via ces capacités.
How long does meaningful coverage take?
Une couverture significative d'un patrimoine de données de taille moyenne prend de six à neuf mois, et non six semaines. Les premiers travaux peuvent rapidement protéger certains actifs sélectionnés, mais une couverture durable nécessite une classification, des contrats, de la lignée, un assainissement de la propriété, des pratiques de réponse et une intégration sur les couches d'ingestion, de transformation, d'entrepôt et de BI.
Dimension | Suite Open Source | Plateforme commerciale |
|---|---|---|
Licence initiale | Souvent faible ou absente | Abonnement ou frais de plateforme |
Responsabilité d'ingénierie | Élevée, incluant l'exploitation et la maintenance | Partagée avec le fournisseur, selon le service |
Personnalisation | Large contrôle via le code et les API | Régie par les capacités et extensions du produit |
Charge d'intégration | L'équipe construit et maintient les connecteurs | Le fournisseur peut proposer des intégrations natives |
Flux de governance | Généralement assemblé à partir de composants distincts | Peut être inclus, mais doit être vérifié |
Contrôle du déploiement | Contrôle total au sein de l'infrastructure du client | Dépend du modèle d'hébergement et de déploiement |
Un framework sur mesure convient aux environnements ayant des exigences d'audit inhabituelles, un investissement important dans Dagster ou Airflow, ou des limites de maillage de données (data mesh) qui rendent la lignée des éditeurs trop superficielle pour être fiable. Une plateforme commerciale convient aux équipes qui ont besoin d'une intégration plus rapide, d'un support cohérent et d'une couche opérationnelle maintenue. Prenez la décision en fonction des contrôles requis, de la propriété et des flux de réponse, et non de l'attrait visuel des tableaux de bord.
digna fournit une plateforme modulaire de qualité des données et d'observability qui s'exécute dans le cloud, le VPC ou le centre de données d'un client, avec une exécution en base de données pour la détection d'anomalies, la surveillance de la Timeliness, la validation au niveau des enregistrements, le suivi des schémas et les métriques de plateforme. Les équipes qui conçoivent une observability gouvernée pour des pipelines réglementés ou des charges de travail d'IA peuvent évaluer digna par rapport à leur architecture existante.
Questions fréquentes
Qu'est-ce qu'un cadre d'observabilité des données ?
Un système en couches qui transforme la télémétrie des données en action humaine gouvernée. Quatre couches le rendent utilisable : une couche de signaux, une couche de contexte portant criticité et responsabilité, une couche de réponse pour le triage et la remédiation, et une couche de gouvernance fixant SLA, sévérité, suppression et escalade.
Pourquoi la plupart des programmes s'arrêtent-ils aux cinq signaux ?
Parce que détecter n'est pas répondre. Fraîcheur, volume, distribution, schéma et lineage peuvent s'afficher au vert ou au rouge alors que personne n'a désigné de responsable, de voie d'escalade, de règle de suppression ni de runbook. Une alerte sans responsable, sévérité et chemin de réponse est une notification, pas un contrôle.
L'observabilité des données est-elle une catégorie logicielle reconnue ?
Oui. Gartner a publié son premier Market Guide for Data Observability Tools le 23 février 2026, couvrant détection d'anomalies, alerting, lineage et flux de réponse à incident. Une étude de marché de 2026 estime une croissance de 3,51 milliards USD en 2026 à 6,03 milliards d'ici 2031.
Que capte chacun des cinq signaux ?
La fraîcheur mesure l'heure d'arrivée face à un calendrier ou un SLA, le volume compare comptages de lignes et tailles de partition aux plages attendues, la distribution examine le comportement statistique et les fréquences de catégories, le schéma valide la structure face à un contrat, et le lineage représente le graphe de dépendances de la source à la consommation.
Davantage de surveillance donne-t-il plus de fiabilité ?
Pas en soi. Un dispositif plus restreint peut mieux fonctionner quand la responsabilité est explicite, car la contrainte tient généralement à la gouvernance plutôt qu'à la couverture. Reliez chaque signal à un mode de défaillance et à une politique de réponse avant d'en ajouter un autre.



