L'architecture de la Data Observability expliquée simplement
|
8
minute de lecture

Un tableau de bord peut être vert alors que la décision qui en découle est déjà erronée. Le pipeline s'est terminé, l'entrepôt est disponible et chaque tâche planifiée signale un succès ; pourtant, un système source a fourni des données en retard, une équipe en amont a modifié le type d'une colonne, ou un chargement partiel a supprimé des enregistrements. L'équipe financière voit le chiffre d'affaires d'hier, une équipe opérationnelle passe à côté d'un problème naissant, et une fonctionnalité d'IA consomme des entrées qui ne correspondent plus aux hypothèses utilisées lors de l'entraînement.
Les équipes commencent souvent par ajouter des alertes supplémentaires. Cette approche est utile jusqu'à ce qu'une alerte se déclenche sans attribution claire, sans contexte ou sans vision précise de l'impact en aval. Le problème le plus profond est d'ordre architectural : où s'exécute le calcul de l'observabilité, où vivent les métadonnées et comment le système connecte-t-il un signal technique aux personnes et aux processus métiers concernés ?
L'architecture de Data Observability répond à ces questions. Elle étend la surveillance traditionnelle des infrastructures en offrant une visibilité continue sur les pipelines de données, les entrepôts, les lacs de données, les tableaux de bord et les entrées de machine learning. Cette catégorie commerciale s'est développée rapidement. Selon une estimation du secteur pour 2026, le marché de la data observability est évalué à 3,51 milliards USD et devrait atteindre 6,03 milliards USD d'ici 2031, avec un TCAC de 11,42 % sur la période 2026-2031 (estimation du marché par Mordor Intelligence). Un autre rapport de 2026 évalue le marché à 3,4 milliards USD en 2026, contre 2,94 milliards USD en 2025 (rapport de marché Spherical Insights).
La leçon pratique est simple. Une architecture fiable ne doit pas seulement vous dire qu'une table a changé. Elle doit montrer ce qui a changé, si le changement est attendu, quels actifs en aval en dépendent et si le signal affecte les rapports, les opérations, la governance ou l'IA. Les équipes qui souhaitent adopter une approche structurée de la fiabilité peuvent également utiliser ce guide pour mesurer la fiabilité des données.
Table des matières
Introduction : Pourquoi l'architecture de Data Observability est essentielle aujourd'hui
Ce que signifie réellement l'architecture de Data Observability
Les cinq piliers pour détecter les défaillances invisibles des données
Des signaux techniques à l'impact métier avec des exemples concrets
Votre feuille de route pour implémenter une architecture de Data Observability
Introduction : Pourquoi l'architecture de Data Observability est essentielle aujourd'hui
Un incident typique commence de manière subtile. Une tâche d'ingestion reçoit moins d'enregistrements que d'habitude, mais se termine avec succès. Une transformation continue de s'exécuter car le schéma est techniquement valide. Le tableau de bord se met à jour à l'heure prévue, de sorte que son indicateur d'état reste vert. Personne ne remarque rien jusqu'à ce qu'un responsable demande pourquoi un indicateur métier a évolué de manière inattendue.
La surveillance traditionnelle permet de répondre à des questions opérationnelles telles que la disponibilité d'un serveur, la fin d'une tâche ou l'existence d'une erreur dans un processus. Les systèmes de données ont besoin de plus de contexte. Les données changent de forme, de volume, de distribution, de timing et de signification tout au long de leur parcours d'ingestion, de transformation, de stockage et de consommation. Un pipeline peut être opérationnellement sain tout en produisant des données incomplètes, obsolètes ou structurellement incompatibles avec l'utilisation en aval.
La zone d'ombre est généralement d'ordre architectural
L'architecture moderne de data observability est née du fait que les métriques d'infrastructure de base et la surveillance des performances des applications ne permettaient pas d'expliquer ces défaillances. À mesure que les pipelines sont devenus plus distribués, les équipes ont ajouté des contrôles pour la qualité des données, le lignage, les anomalies et le comportement en temps réel. Cette discipline fonctionne désormais comme une couche architecturale pour la fiabilité et la governance, et non plus simplement comme un tableau de bord de réponse aux incidents.
Cette distinction est importante pour plusieurs groupes :
Les ingénieurs de données ont besoin de trouver la source d'une défaillance sans avoir à chercher dans des outils déconnectés.
Les ingénieurs analytiques et les développeurs BI ont besoin d'avoir l'assurance que les transformations et les tableaux de bord reflètent des entrées actuelles et structurellement valides.
Les responsables de la governance ont besoin de preuves que les contrôles s'appliquent en continu sur les entrepôts, les lacs et les pipelines de données.
Les équipes d'IA ont besoin d'une traçabilité depuis les enregistrements sources jusqu'aux fonctionnalités, aux données d'entraînement et aux entrées des modèles.
L'architecture détermine si ces groupes partagent un contexte unique ou s'ils doivent l'assembler manuellement lors d'un incident. Une couche centrale de métadonnées peut relier la propriété, le lignage, le comportement historique et l'utilisation. L'exécution distribuée permet de maintenir les contrôles à proximité des systèmes qui détiennent les données. Les alertes peuvent ensuite acheminer un événement significatif au lieu d'envoyer une métrique isolée vers un canal opérationnel générique.
Ce qu'une bonne architecture permet de réaliser
Un système bien conçu détecte les modes de défaillance connus et inattendus. Les contrôles déterministes peuvent appliquer des règles explicites, tandis que les méthodes statistiques peuvent identifier des comportements inhabituels sans exiger que quelqu'un prévoie chaque problème possible. Le résultat n'est pas, par définition, des données parfaites. C'est un système de rétroaction qui donne aux équipes des preuves plus précoces, un meilleur diagnostic et une base plus claire pour prioriser les mesures correctives.
L'architecture a également un impact sur la governance, la portabilité et le contrôle des coûts. Déplacer des données vers un service externe peut simplifier certaines analyses, mais cela peut introduire des préoccupations supplémentaires concernant l'accès, le mouvement et l'infrastructure. Exécuter des contrôles au sein d'un entrepôt ou d'un environnement de lac existant permet de préserver la localisation des données, bien que cela nécessite une planification minutieuse concernant les autorisations, les charges de travail et les moteurs pris en charge. Ces compromis méritent autant d'attention que la liste des métriques surveillées.
Ce que signifie réellement l'architecture de Data Observability
Une analogie utile est celle du tableau de bord d'une voiture. La surveillance traditionnelle peut vous dire si le moteur tourne et si le véhicule est alimenté en électricité. L'observability vous offre une vue plus riche : vitesse, niveau de carburant, température, indicateurs d'avertissement et suffisamment de contexte pour comprendre pourquoi la voiture ne se comporte pas comme prévu.

Appliquez cette analogie à une plateforme de données. Le plan de données est l'endroit où les données sont générées, déplacées, transformées et stockées. Le plan de contrôle définit les calendriers, les politiques, les seuils, les flux de travail et les réponses. La couche de métadonnées explique ce qu'est chaque actif, à qui il appartient, comment il se connecte à d'autres actifs et comment il s'est comporté au fil du temps.
Construire la définition en trois étapes
Tout d'abord, identifiez le système observable. Il comprend les applications sources, les tâches d'ingestion, les outils de transformation, les entrepôts, les lacs, les tableaux de bord et les entrées de modèles. L'observability doit suivre les données tout au long de ce parcours, et non s'arrêter à la première tâche réussie.
Deuxièmement, identifiez les signaux. Les métriques décrivent un comportement mesurable tel que le moment d'arrivée, le volume ou la distribution. Les journaux enregistrent les événements et les erreurs. Les signaux prédictifs mettent en évidence les écarts par rapport aux modèles attendus. Le lignage et les métadonnées ajoutent le contexte qui transforme un avertissement en un parcours d'investigation.
Troisièmement, identifiez la boucle de décision. La plateforme collecte ou calcule des signaux, les évalue par rapport à des règles ou à des références apprises, enrichit les événements avec du contexte et achemine les actions vers les propriétaires ou les flux de travail d'incidents. C'est cette boucle qui distingue l'observability d'un rapport de qualité statique.
Pourquoi les seuls outils de qualité ne suffisent pas
Un outil de qualité des données peut valider que les valeurs sont conformes à des règles connues. C'est précieux, mais cela n'explique pas automatiquement si une table retardée affecte un rapport réglementaire, quelle équipe est propriétaire de la source en amont, ou si ce même comportement est normal pour un calendrier de livraison particulier. L'observability combine la validation avec la Timeliness, la détection d'anomalies, le lignage et le contexte opérationnel.
L'architecture doit également rester indépendante des pipelines qu'elle observe. Les conseils pratiques recommandent de séparer la plateforme d'observabilité du système de données observé, permettant ainsi à la plateforme de surveiller les environnements nouveaux et existants sans imposer de réécritures architecturales (conseils d'architecture académique). Cette indépendance permet aux équipes d'ajouter une couverture de manière progressive plutôt que de devoir repenser au préalable chaque entrepôt, lac ou flux d'orchestration.
En langage clair, l'architecture de data observability est l'agencement de l'exécution, de la collecte, des métadonnées, de l'analyse et de l'action qui permet à une équipe de comprendre l'état actuel et attendu des données tout au long de leur cycle de vie.
Couches et composants clés d'une architecture moderne
Une architecture moderne fonctionne de manière optimale sous la forme d'un ensemble de couches spécialisées. Chaque couche assume une responsabilité différente, mais toutes les couches partagent suffisamment de métadonnées et de contexte d'événements pour faciliter le diagnostic.

Systèmes sources et plan de données
Les données métiers proviennent de ce plan et les transformations s'y exécutent. Il peut inclure des bases de données opérationnelles, des applications SaaS, des systèmes de streaming, des stockages cloud, des entrepôts et des lacs de données. Le plan de données doit rester responsable du travail de déplacement et de traitement des données.
Un choix de conception important consiste à déterminer si les calculs d'observabilité s'exécutent ici. L'exécution en base de données peut calculer des métriques et effectuer des contrôles au sein de sources de données compatibles, tandis qu'une conception externe extrait les informations pour les analyser ailleurs. Maintenir l'exécution à proximité des données peut réduire les mouvements inutiles et préserver les limites de sécurité existantes, mais les équipes doivent tout de même gérer les autorisations et l'isolation des charges de travail.
Collecte et ingestion
La couche de collecte rassemble la télémétrie et les métadonnées à partir du plan de données. Elle peut capturer des statistiques de table, des événements de pipeline, des modifications de schéma, des comportements de requête, des délais de livraison, des résultats de validation et des mises à jour de lignage. Le but n'est pas de copier chaque enregistrement dans le système d'observabilité, mais de collecter les signaux et les références nécessaires pour comprendre le comportement.
Une couche de collecte solide prend en charge à la fois les modèles planifiés et les modèles pilotés par les événements. Les contrôles planifiés sont utiles pour les fenêtres de livraison connues. Les événements sont utiles lorsqu'un schéma change, qu'un pipeline se termine ou qu'une source émet une transition d'état pertinente.
Orchestration centralisée et métadonnées
La couche de contrôle planifie les contrôles, applique les politiques, stocke la configuration et coordonne les alertes. La couche de métadonnées enrichit chaque signal avec la propriété, les définitions, le lignage, l'utilisation, l'environnement et le contexte historique. Ensemble, elles répondent aux questions auxquelles les métriques brutes ne peuvent pas répondre.
Cette couche doit également prendre en charge les environnements hérités et hétérogènes. Une plateforme qui ne comprend qu'un seul entrepôt laisse des zones d'ombre autour des systèmes sur site, des clouds multiples ou des outils d'orchestration plus anciens. L'objectif architectural est un modèle de contexte partagé, et non une uniformité forcée dans chaque système sous-jacent.
Observability et action
La couche supérieure présente l'état de santé, les tendances, les anomalies, les incidents et l'impact. Elle doit aider un intervenant à passer d'un signal à une décision :
Détection : Quel comportement a changé ?
Diagnostic : Quel événement ou transformation en amont peut l'expliquer ?
Impact : Quels ensembles de données, tableaux de bord, modèles ou processus en dépendent ?
Action : Qui est propriétaire de la correction et comment l'événement doit-il être suivi ?
Cette structure s'aligne sur des conseils plus larges sur l'architecture des systèmes de données, où les limites entre le traitement, l'orchestration, les métadonnées et la consommation doivent rester explicites.
Règle d'architecture : Maintenez l'exécution à proximité des données lorsque la governance et le coût exigent une localisation, mais centralisez suffisamment le contexte pour que les intervenants puissent en comprendre l'impact sur l'ensemble de la plateforme.
Les cinq piliers pour détecter les défaillances invisibles des données
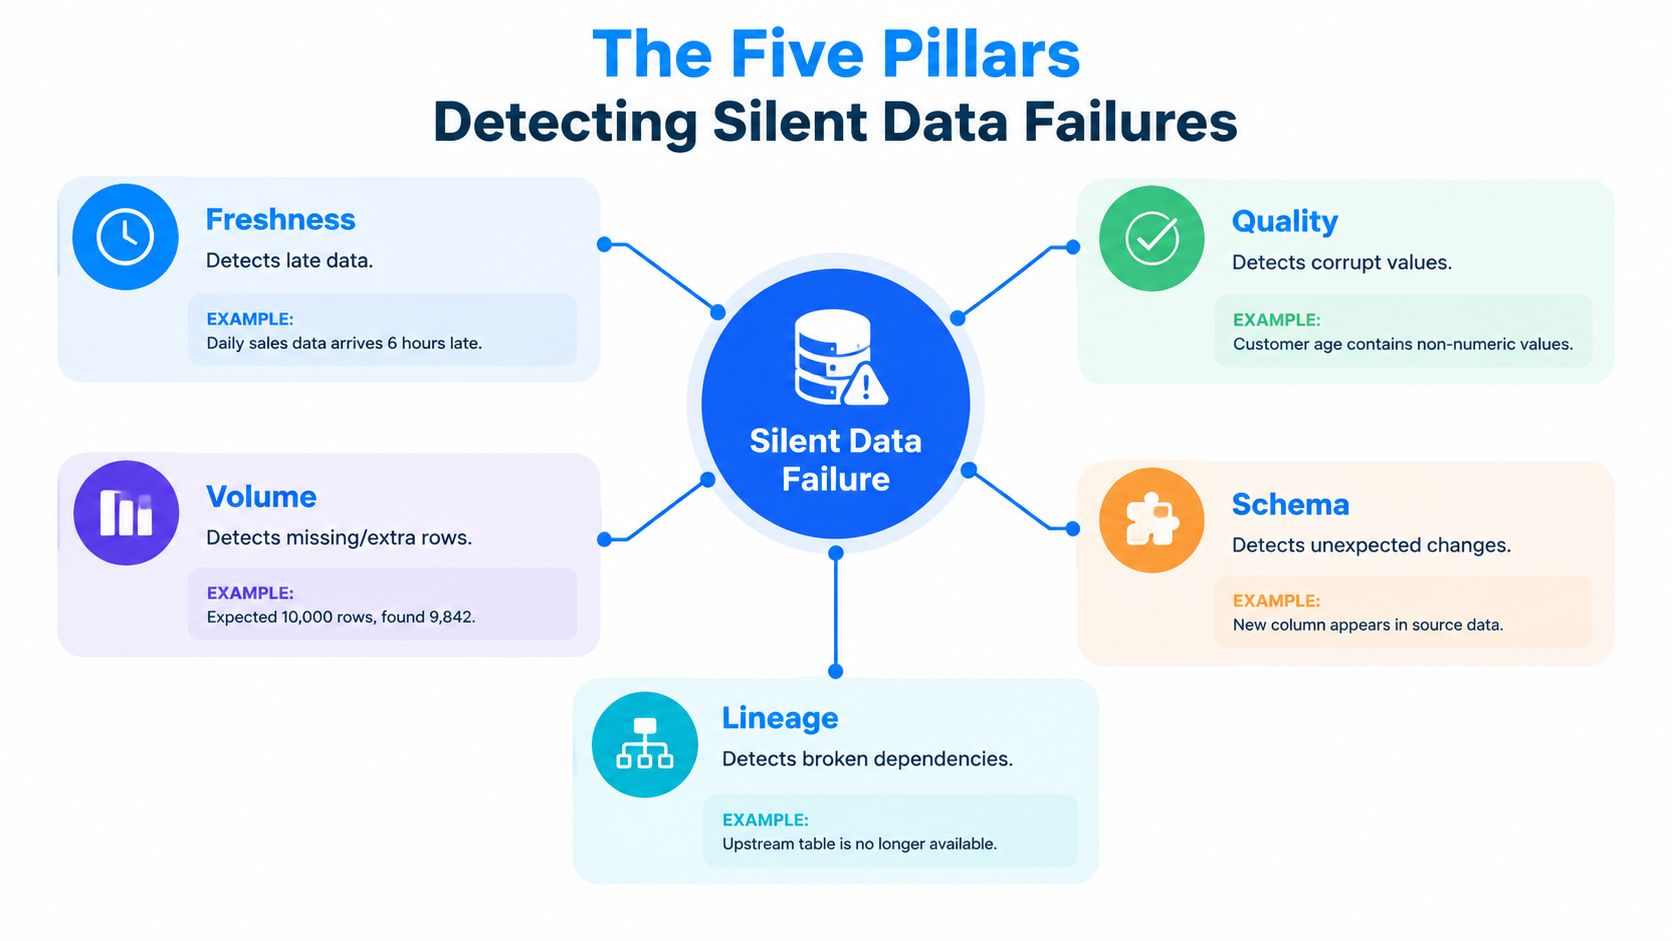
Le modèle à cinq piliers offre aux équipes un point de départ pratique : la Fraîcheur, la Qualité, le Volume, le Schéma et le Lignage. Chaque pilier traite d'un mode de défaillance différent. Les implémentations matures associent la validation déterministe à la détection statistique d'anomalies, car les règles explicites capturent les violations connues tandis que l'analyse comportementale peut révéler des changements inattendus.
Fraîcheur
La fraîcheur permet de savoir si les données sont suffisamment récentes pour l'utilisation prévue. Elle ne se limite pas à vérifier si une tâche s'est exécutée. Une tâche réussie peut tout de même livrer des données en retard, manquer une partition ou publier un extrait incomplet.
La fraîcheur est synonyme de Timeliness. Surveillez l'arrivée et le traitement par rapport au comportement historique ou à une attente de service explicite, puis traitez les retards comme de potentielles défaillances de source ou d'ingestion.
Un contrôle utile consiste à comparer l'heure d'arrivée réelle avec le calendrier prévu. Le système doit également distinguer une livraison tardive d'une livraison anticipée lorsque cette différence est importante. Un fichier anticipé peut indiquer qu'un processus source a changé, même si les données semblent disponibles.
Qualité
Les contrôles de qualité valident les enregistrements et les valeurs par rapport aux attentes métiers ou techniques. Les exemples incluent les champs obligatoires, les plages valides, les relations référentielles, les catégories autorisées et la cohérence entre des ensembles de données connexes. Ces règles sont particulièrement importantes pour les rapports réglementés et les flux opérationnels critiques.
La qualité n'est pas un score unique. Les équipes doivent définir quelles dimensions importent pour chaque cas d'usage, puis associer les contrôles échoués à l'actif et au propriétaire concernés. Une règle pour une table de transactions financières peut différer de celle d'un ensemble de données exploratoires. Plus de détails sur l'organisation de ces dimensions figurent dans le guide de digna sur les dimensions de la qualité des données.
Volume
Les contrôles de volume recherchent des données manquantes, dupliquées ou anormalement volumineuses. Une variation du nombre de lignes peut indiquer un chargement incomplet, une panne de source, un problème de jointure ou un événement métier légitime. Ce contrôle devient plus utile lorsqu'il prend en compte les modèles historiques et les dépendances en aval plutôt que d'appliquer un seuil universel unique.
Schéma
La surveillance du schéma suit les modifications structurelles telles que l'ajout ou la suppression de colonnes, les champs renommés et les types de données modifiés. Elle fournit souvent une alerte précoce car les modifications structurelles peuvent casser des transformations, des tableaux de bord, des contrats ou des fonctionnalités de modèle avant que quiconque ne remarque une erreur de rapport visible.
Les équipes doivent classer les changements attendus et inattendus. Une migration contrôlée peut ajouter une colonne intentionnellement, tandis qu'une API en amont peut modifier un type sans préavis. Le même événement nécessite un acheminement différent selon la propriété, l'environnement et l'utilisation en aval.
Lignage (Lineage)
Le lignage montre comment les données se déplacent de la source à la transformation puis à la consommation. Il transforme une alerte isolée en une carte d'impact. Si une table source change, le lignage peut révéler quelles tables dérivées, rapports, métriques ou entrées d'IA dépendent du champ concerné.
L'observability de bout en bout relie les événements sources à l'impact en aval à travers l'ingestion, la transformation, le stockage et la consommation (recherche sur l'observabilité des pipelines). Sans lignage, les équipes peuvent détecter un problème rapidement mais passer trop de temps à décider par où commencer.
Où l'Observability doit s'exécuter et comment la déployer
Un pipeline peut détecter un contrôle de qualité échoué et créer tout de même des problèmes de governance, de coût ou de portabilité. La décision architecturale la plus importante concerne l'endroit où doivent résider le calcul, les métadonnées et les alertes, plus encore que le choix des contrôles à activer. Les conceptions en base de données calculent les contrôles compatibles au sein de l'entrepôt ou de la plateforme de données. Les conceptions externes extraient les données ou les métriques vers un service distinct pour le traitement.
L'exécution en base de données permet de lancer des tâches au sein de systèmes tels que Databricks, SAP HANA ou Snowflake, maintenant ainsi le traitement dans l'entrepôt SQL au lieu de déplacer les données à l'extérieur pour analyse (conseils sur l'observabilité pushdown). Cette approche s'apparente à l'inspection des marchandises à l'usine : les données restent près de leur source, tandis que la plateforme absorbe la charge de travail. L'exécution externe crée un modèle d'exploitation centralisé, mais elle peut nécessiter des autorisations plus larges, des connecteurs et des mouvements de données. Les équipes qui construisent leur pratique d'ingénierie de plateforme de données doivent traiter cette décision d'emplacement comme faisant partie de la conception de la plateforme.
Critère | Exécution en base de données | Exécution externe |
|---|---|---|
governance | Les contrôles s'exécutent dans les limites et les politiques d'accès aux données existantes. | Un service distinct peut nécessiter des autorisations pour extraire ou inspecter les données. |
Mouvement des données | Les métriques et la validation peuvent être calculées là où résident les données. | Les données ou les résultats de profilage sont déplacés vers une couche de traitement externe. |
Contrôle des coûts | Utilise la puissance de calcul de l'entrepôt ou de la plateforme, ce qui rend la governance de la charge de travail importante. | Ajoute des coûts d'infrastructure ou de service distincts, tout en réduisant certains travaux au sein de la plateforme. |
Portabilité | Fonctionne bien lorsque les moteurs pris en charge et les modèles SQL sont cohérents. | Peut centraliser la logique sur des systèmes hétérogènes, mais peut créer une dépendance vis-à-vis du service. |
Sécurité | Favorise la localisation des données et minimise l'exposition des enregistrements de production. | Nécessite des contrôles rigoureux pour l'extraction, le stockage, le chiffrement et la conservation. |
Performance | Bénéficie de l'accès aux données locales et de l'optimisation du moteur. | Peut introduire des surcharges de transfert, de planification ou de sérialisation. |
Opérations | Les équipes gèrent l'impact de la charge de travail au sein de chaque plateforme. | Les équipes gèrent les connecteurs, la fiabilité de l'extraction et la capacité externe. |
Adapter le déploiement à l'environnement
Les options de cloud privé, de VPC et sur site sont importantes lorsque la résidence des données, le réseau ou les règles d'accès restreignent le déploiement. Une organisation réglementée peut installer le système d'observabilité au sein de son propre compte cloud, VPC ou centre de données, maintenant ainsi les données de production dans une limite approuvée.
La portabilité mérite la même attention. Les approches ouvertes et interopérables, notamment l'adoption d'OpenTelemetry, l'observabilité-as-code et la consolidation des outils, apparaissent comme des priorités dans les récentes analyses des tendances de l'observabilité (tendances de l'observabilité d'IBM). Pour les équipes de données, la portabilité signifie conserver les métadonnées, les politiques, le lignage et l'historique opérationnel lorsque les plateformes changent. L'exportation de tableaux de bord seuls ne préserve pas ce contexte opérationnel.
Avant de choisir, posez-vous trois questions :
La plateforme peut-elle observer chaque environnement critique sans imposer de relocalisation des données ?
Qui paie pour le calcul utilisé par le profilage et la détection d'anomalies ?
Les équipes de governance peuvent-elles auditer les contrôles, les autorisations, les sorties et le modèle de conservation ?
Une alerte techniquement exacte ne suffit pas si l'architecture augmente le risque d'accès ou produit une facture imprévisible. Choisissez la conception qui équilibre la qualité de détection avec la localisation des données, la portabilité et le contrôle opérationnel.
Des signaux techniques à l'impact métier avec des exemples concrets
Une alerte de fraîcheur devient plus utile lorsqu'elle se connecte à un processus métier. Une alerte de schéma devient urgente lorsqu'elle identifie un champ utilisé par un rapport réglementaire ou une fonctionnalité d'IA. Un signal de charge de travail de plateforme devient exploitable lorsqu'il explique quelle équipe, quel modèle de requête ou quel produit de données consomme des ressources.
Cette connexion provient de la combinaison du lignage, des métadonnées d'utilisation, de la propriété, des définitions métiers et des signaux d'observabilité dans un graphique de dépendances contextuel. Le graphique ne remplace pas les contrôles techniques. Il donne à chaque contrôle sa place dans le modèle opérationnel.

Services financiers
Un ensemble de données de transactions peut réussir un contrôle de base de fin de pipeline tout en échouant à une règle métier ou en arrivant après une fenêtre de rapport. La gestion de la qualité des données combine la validation, la détection d'anomalies, le suivi de la Timeliness et la surveillance des schémas pour identifier le problème. Le lignage montre ensuite si les enregistrements concernés alimentent les calculs de risque, les rapports réglementaires ou le rapprochement en aval.
La priorité de réponse doit refléter cet impact. Un écart dans une table analytique inutilisée n'est pas équivalent à un changement structurel dans un ensemble de données utilisé par un processus financier critique.
Santé
Les équipes de santé ont souvent besoin de données cliniques, opérationnelles et réglementaires fiables sur des systèmes ayant des propriétaires et des modèles de livraison différents. Un extrait tardif peut retarder une vue opérationnelle, tandis qu'un type de champ modifié peut casser une intégration en aval. La fraîcheur, la validation, le suivi des schémas et le lignage fournissent des preuves différentes pour une même investigation.
La structure de l'architecture doit maintenir les données sensibles dans des environnements approuvés tout en exposant suffisamment de métadonnées pour que les équipes autorisées en comprennent l'état et la responsabilité.
Télécommunications et secteur public
Une plateforme de télécommunications peut surveiller les données clients et opérationnelles pour détecter des comportements inhabituels de volume, de disponibilité ou de distribution. Une organisation du secteur public peut donner la priorité à la traçabilité, à la cohérence et à des preuves prêtes pour l'audit à travers des processus de données de longue durée. Dans les deux cas, le choix de conception important consiste à connecter les événements techniques aux obligations de service et aux propriétaires responsables.
La surveillance métier peut également évaluer les KPI directement sur les données sous-jacentes. L'observabilité de la plateforme de données ajoute une vue connexe sur les charges de travail, la consommation, la disponibilité et le comportement de la plateforme. L'observability fait de plus en plus partie de la gestion des coûts et de la stratégie de normes ouvertes, et non d'une simple couche de tableau de bord.
Préparation à l'IA
Les équipes d'IA ont besoin de plus d'une table propre au moment de l'entraînement. Elles ont besoin d'un lignage depuis les données sources jusqu'aux transformations, fonctionnalités, entrées d'entraînement et sorties de modèles. Si un schéma source change ou si un retard de fraîcheur affecte un pipeline de fonctionnalités, le graphique de dépendances doit révéler quelles entrées de modèle peuvent être obsolètes ou structurellement incompatibles.
La question utile n'est plus seulement : « Le contrôle a-t-il réussi ? » Elle est : « Quel résultat métier, quel processus opérationnel ou quelle entrée d'IA dépend de ce signal, et qui peut agir dessus ? »
Votre feuille de route pour implémenter une architecture de Data Observability
Commencez par un périmètre restreint et un propriétaire clair. Un déploiement généralisé sans priorités produit du bruit avant que l'équipe ne comprenne comment réagir.
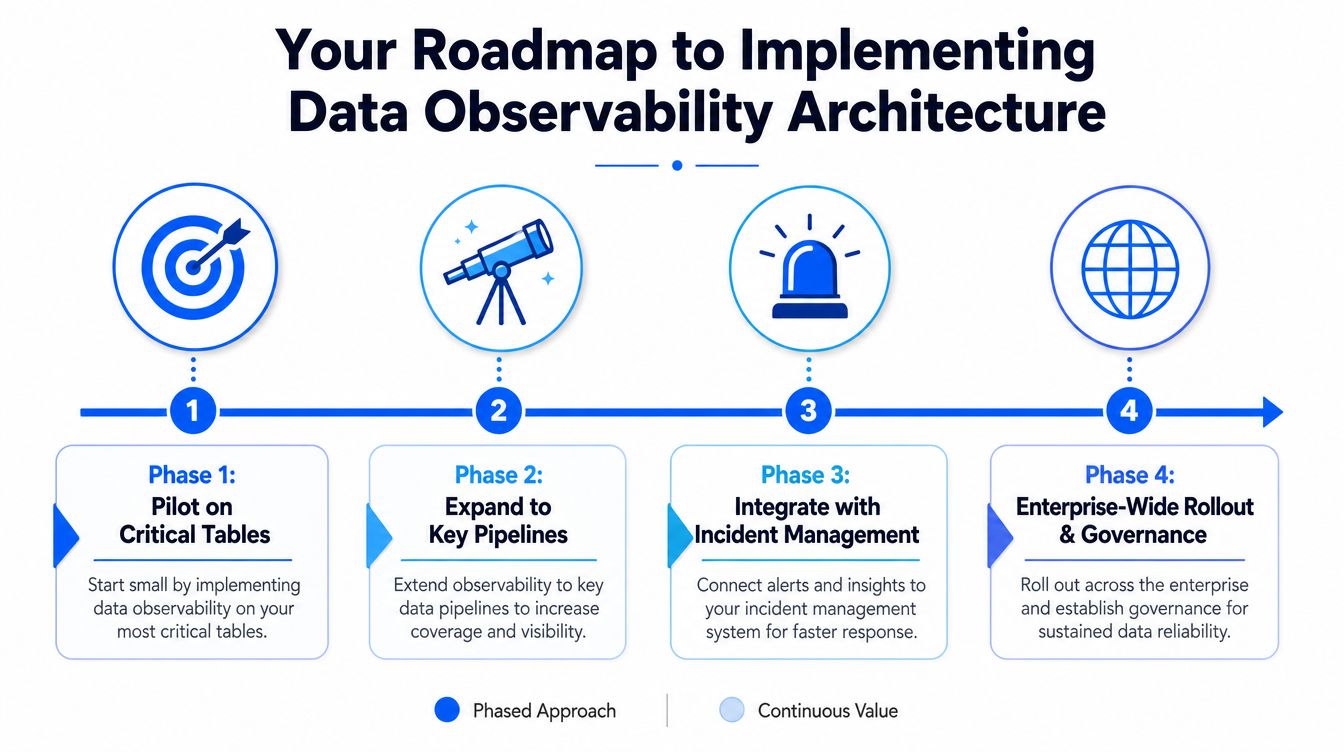
Phase un : piloter les tables critiques
Choisissez des ensembles de données qui soutiennent des rapports, des opérations, de la governance ou des flux de travail d'IA importants. Établissez les comportements de livraison attendus, les modèles de volume de base, les attentes en matière de schéma et un petit ensemble de validations métiers. Attribuez un propriétaire pour chaque alerte avant d'activer les notifications.
Phase deux : étendre aux pipelines clés
Ajoutez une couverture en amont et en aval afin que l'équipe puisse retracer les défaillances plutôt que de voir des symptômes isolés sur les tables. Incluez le lignage, l'utilisation et les métadonnées de propriété, puis comparez l'exécution en base de données et l'exécution externe pour les environnements concernés.
Phase trois : connecter la gestion des incidents
Acheminez les alertes vers les équipes responsables de la résolution. Enregistrez les actifs concernés, la cause suspectée, l'impact métier, l'état et la résolution. Passez en revue les incidents récurrents pour identifier les corrections architecturales au lieu de répéter des récupérations manuelles.
Phase quatre : établir la governance d'entreprise
Standardisez les politiques de fraîcheur, de modification de schéma, de validation, d'accès, de conservation et d'escalade. Étendez l'approche aux entrepôts, aux lacs, aux pipelines et aux environnements sur site tout en examinant la portabilité et la consommation de calcul. Une implémentation modulaire peut commencer par une seule fonctionnalité et évoluer via un modèle de coût de base auquel s'ajoute un montant par table active et par module, plutôt que d'exiger tous les cas d'usage dès le départ.
Un tableau de bord centré sur l'utilisateur doit servir les ingénieurs, les analystes et les parties prenantes de la governance avec des vues différentes du même contexte sous-jacent. Les équipes à la recherche de conseils pratiques peuvent utiliser ce cadre de mise en œuvre de la qualité des données pour définir la propriété, les contrôles et les priorités de déploiement.
L'architecture la plus solide traite la qualité de détection, la governance, la portabilité et le contrôle des coûts comme un seul problème de conception. Commencez par un produit de données critique, mesurez l'aptitude de l'équipe à détecter et à expliquer les défaillances, puis étendez le modèle uniquement lorsque le modèle opérationnel est prêt.
digna fournit une plateforme d'observabilité et de qualité des données d'entreprise avec exécution en base de données, détection d'anomalies, surveillance de la Timeliness, validation, suivi des schémas et surveillance métier et de plateforme. Visitez digna pour voir comment une architecture qui maintient les données en place peut soutenir des analyses fiables, la governance et l'IA dans l'ensemble de votre environnement de données.
Questions fréquentes
Qu'est-ce que l'architecture d'observabilité des données ?
L'agencement de l'exécution, de la collecte, des métadonnées, de l'analyse et de l'action qui permet à une équipe de comprendre l'état actuel et attendu des données sur tout leur cycle de vie. L'analogie utile est le tableau de bord d'une voiture : non pas plus de cadrans, mais l'agencement qui conduit à agir juste.
Pourquoi la surveillance classique ne suffit-elle pas ?
Parce qu'elle répond à des questions opérationnelles : un serveur est-il disponible, un job s'est-il terminé, un processus a-t-il renvoyé une erreur. Aucune n'explique une table arrivée à l'heure, exécutée avec succès et porteuse de valeurs fausses, or c'est cette défaillance qui atteint la décision.
Où faut-il exécuter les calculs d'observabilité ?
C'est le choix de conception décisif dans le plan de données. Exécuter les contrôles là où naissent déjà les données métier garde le contexte près de la défaillance, évite les déplacements inutiles et compte surtout quand confidentialité et charge opérationnelle limitent ce qui peut quitter l'environnement.
Qui profite d'une bonne architecture d'observabilité ?
Quatre groupes aux besoins distincts : les data engineers qui localisent une panne sans fouiller des outils déconnectés, les analytics engineers qui ont besoin d'entrées structurellement valides, les responsables gouvernance qui exigent la preuve de contrôles continus, et les équipes IA qui ont besoin de traçabilité des sources jusqu'aux entrées de modèle.
Quelle est la taille du marché de l'observabilité des données ?
Une estimation sectorielle de 2026 le valorise à 3,51 milliards USD et projette 6,03 milliards d'ici 2031, avec un TCAC de 11,42 % sur 2026-2031. Cette croissance traduit le recoupement croissant entre gouvernance, fiabilité et responsabilité opérationnelle, plutôt qu'un effet de mode.



