Tabla del sistema de métricas: esquema, consultas y mejores prácticas
|
9
minuto de lectura

El propietario de un panel de control abre el informe de la mañana y descubre que los números no han cambiado desde hace dos días. La propia canalización se muestra en verde, el almacén de datos está disponible y ninguna tarea ha fallado. Más tarde, alguien descubre que una columna ascendente cambió de tipo, una transformación omitió parte de su entrada o la última partición nunca llegó. El incidente no fue causado por la falta de un panel de control. Fue causado por la falta de evidencia operativa.
Una tabla de sistema de métricas proporciona esa evidencia en una forma consultable. En lugar de dispersar las comprobaciones en cuadernos, scripts de shell, metadatos del almacén y herramientas de monitoreo externas, los equipos pueden registrar señales a nivel de tabla y columna en un libro de contabilidad operativo. Ese libro de contabilidad puede admitir comprobaciones de frescura, análisis de volumen, detección de cambios de esquema, investigación histórica, flujos de trabajo de propiedad y pistas de auditoría sin convertir cada investigación en un proyecto de ingeniería personalizado.
Tabla de contenidos
Por qué los equipos de datos necesitan una tabla de sistema de métricas
La brecha práctica entre la recopilación y la acción
Qué es una tabla de sistema de métricas
Por qué es importante la separación
Metadatos del proveedor frente a un libro de contabilidad interno controlado
Esquema central y patrones de diseño de columnas
Un diseño de referencia
Claves y rutas de acceso
Consultas SQL prácticas para tareas comunes de Observability
Infracciones de Timeliness
Anomalías de volumen
Desviación del esquema
Estrategias de retención y agregación
Retención solo de datos sin procesar
Resúmenes agrupados por tiempo
Retención por niveles
Conexión de métricas con señales de Timeliness y desviación de esquema
Correlación de señales
Una matriz de decisión para una respuesta con poco ruido
Cuando más métricas reducen la efectividad de la Observability
Priorizar por consecuencias
Retirar comprobaciones que no cambian las decisiones
Instrumentación de tablas de métricas en plataformas empresariales
Un patrón de despliegue que se mantiene firme
Proteger el rendimiento
Governance y auditabilidad en industrias reguladas
Separar a los redactores de los lectores
Referencia rápida para el diseño de tablas de sistema de métricas
Patrones de consulta de producción
Los umbrales necesitan contexto
Por qué los equipos de datos necesitan una tabla de sistema de métricas
Un equipo de datos suele notar los problemas de fiabilidad a través de sus consumidores. Un analista informa que un panel de control de ingresos está desactualizado. Un usuario de finanzas detecta un cambio inesperado en un informe. Un ingeniero de aprendizaje automático descubre que una tabla de características contiene un tipo desconocido o una concentración inusual de valores faltantes. Para entonces, el sistema ya ha fallado en su propósito operativo, incluso si cada tarea de orquestación se completó con éxito.
La capa que falta suele ser un pequeño conjunto de primitivas duraderas de Observability. Una tabla de sistema de métricas puede capturar recuentos de filas, tasas de valores faltantes, comportamiento de valores distintos, marcas de tiempo, latencia e identificaciones del esquema a nivel de tabla o columna. Esos valores convierten un cambio invisible en un registro que SQL puede inspeccionar, comparar, retener y enrutar a un propietario.
La distinción es importante porque el estado de la canalización responde solo a una pregunta: ¿se ejecutó la tarea? No responde si los datos llegaron a tiempo, si el volumen de salida es plausible, si una columna crítica cambió o si un proceso comercial posterior puede confiar en el resultado. Una base de Data Observability añade esas señales al panorama operativo.
La brecha práctica entre la recopilación y la acción
Los scripts ad-hoc suelen funcionar para una primera comprobación. Se vuelven difíciles de gobernar cuando cada equipo implementa sus propias convenciones de nomenclatura, umbrales, programaciones y destinos de alerta. Las herramientas externas pueden añadir cobertura, pero pueden dejar las definiciones de métricas, el contexto histórico y los metadatos de propiedad divididos entre múltiples sistemas.
Una tabla centralizada ofrece a los ingenieros una interfaz estable:
Detección: almacena el valor observado y la hora en que se calculó.
Comparación: evalúa el valor frente a una referencia de nivel base, una expectativa de nivel de servicio o un período anterior.
Escalada: asocia la gravedad, el propietario, el manual de instrucciones y el estado.
Evidencia: conserva lo que se comprobó, cuándo se ejecutó y qué resultado produjo.
Regla práctica: Una métrica no es operativa hasta que alguien pueda consultarla, identificar a su propietario, decidir qué acción debe desencadenar y revisar su historial.
Las tablas de métricas de Oracle ilustran el cambio arquitectónico de la inspección manual en un momento dado al seguimiento estandarizado actual e histórico. Oracle 10g introdujo tablas de métricas que calculaban deltas y tasas, simplificando preguntas como la tasa de E/S de la base de datos actual. Las vistas históricas relacionadas admiten el análisis de tendencias, incluyendo DBA_HIST_SYSMETRIC_SUMMARY para el análisis de varios días y DBA_HIST_METRIC_NAME para identificar métricas en un repositorio AWR compartido. El historial de tablas de métricas de Oracle y el seguimiento operativo demuestran por qué el patrón sigue siendo útil: los equipos necesitan tanto el estado actual como la evidencia necesaria para comprender cómo se desarrolló ese estado.
Sin una tabla de sistema de métricas, los equipos reaccionan a las quejas. Con una, pueden detectar la degradación antes de que una parte interesada abra un ticket, correlacionar varias señales y crear evidencia lista para la gobernanza a partir del mismo registro operativo.
Qué es una tabla de sistema de métricas
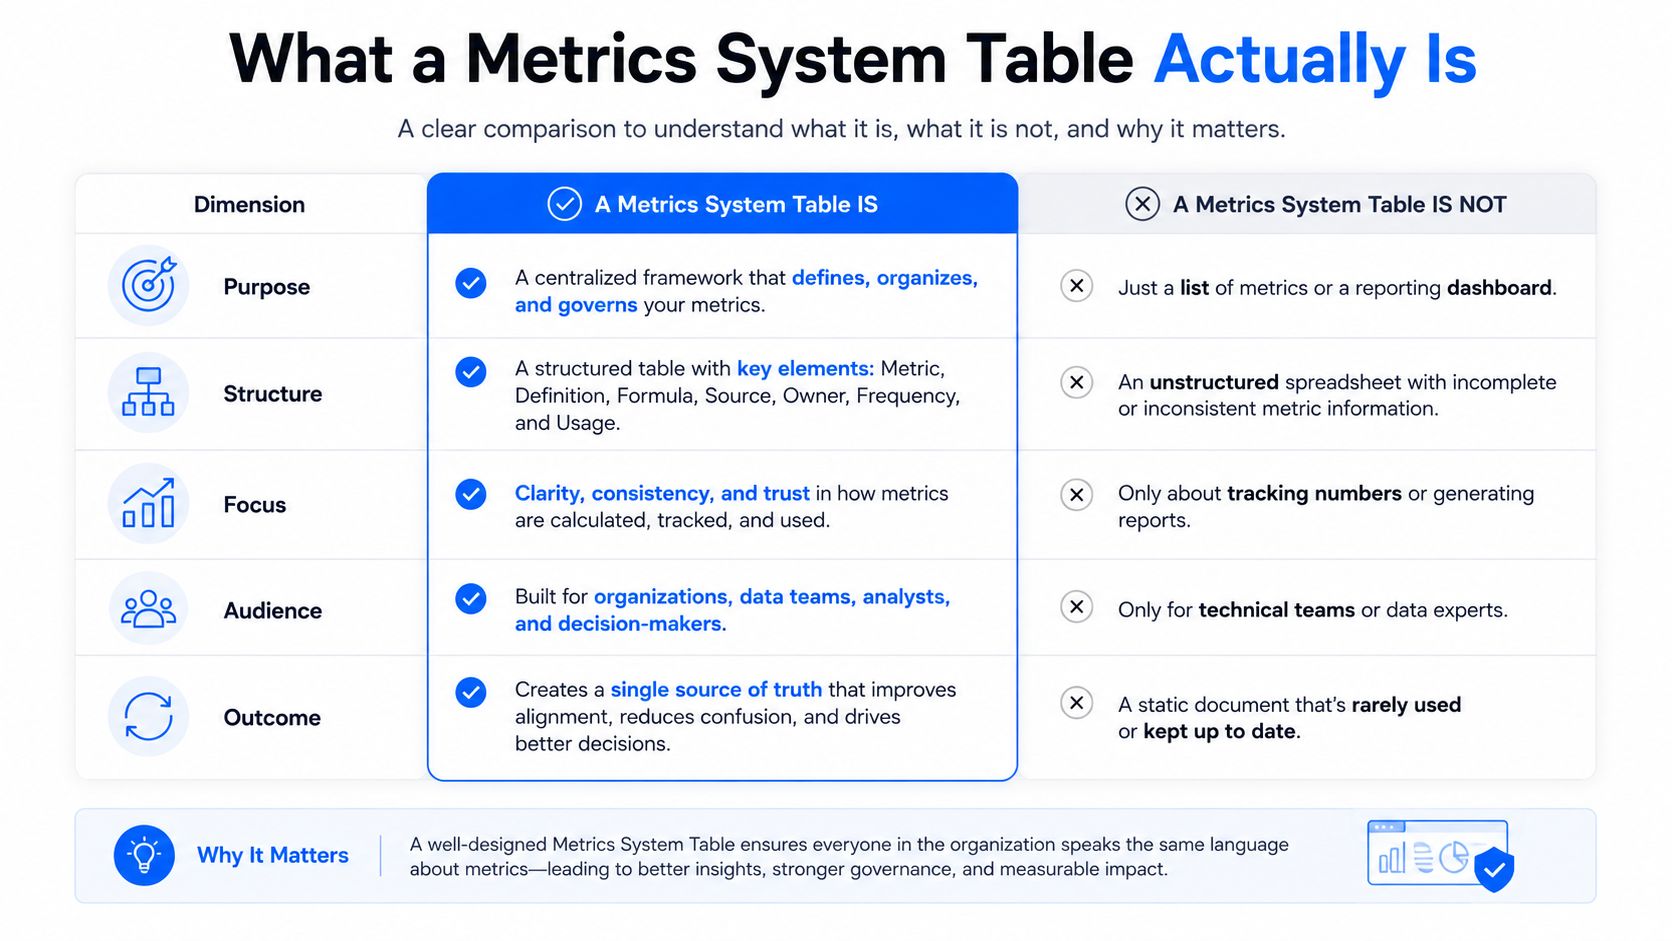
Una tabla de sistema de métricas es un libro de contabilidad operativo de baja latencia de observaciones calculadas sobre activos de datos. Registra mediciones derivadas de tablas de usuarios, canalizaciones o metadatos de la plataforma sin reemplazar los datos subyacentes ni crear una segunda copia en el almacén.
Una tabla orientada al usuario contiene entidades comerciales como pedidos, usuarios, eventos o reclamaciones. Una tabla de métricas registra observaciones sobre esas entidades, incluyendo un recuento de filas en un momento dado, la marca de tiempo del último evento, la proporción de valores faltantes, la estimación de cardinalidad, la identificación del esquema o el resultado de la validación. El valor medido pertenece al registro de la métrica. Las filas de origen permanecen en la aplicación o en la tabla analítica.
Por qué es importante la separación
Las dos cargas de trabajo tienen formas diferentes. Las tablas de usuarios pueden admitir transacciones, uniones, agregaciones o ingesta. Una tabla de sistema de métricas se diseña generalmente para consultas de ventanas de tiempo, búsquedas filtradas, escrituras orientadas a anexar y comparaciones históricas. Tratarla como una tabla de hechos transaccionales añade detalles, almacenamiento y sobrecarga de consultas sin mejorar las decisiones operativas.
Un registro práctico puede incluir:
Dimensiones: base de datos, esquema, tabla, columna, tipo de métrica, entorno y dominio comercial.
Medidas: valor observado, recuento de filas afectadas, uso de recursos o puntuación de anomalías.
Metadatos de ejecución: tiempo de cálculo, consulta de origen o identificador de tarea, versión de la comprobación y estado del resultado.
Contexto de gobernanza: propietario, gravedad, referencia de linaje y estado de remediación.
La tabla también debe admitir la priorización. Un flujo de alto volumen de mediciones no es un flujo de trabajo de alerta por sí solo. Los equipos necesitan umbrales, propiedad y campos de estado que les permitan filtrar la variación habitual de las condiciones que requieren acción. Mantener esas decisiones cerca de la observación registrada admite operaciones de poco ruido y listas para la gobernanza, y permite que las comprobaciones se ejecuten contra los datos en la base de datos en lugar de exportar cada detalle a otro lugar.
Este diseño se adapta a la función de las tablas de sistema relacionales como una capa de metadatos. Exponen señales de perfilado y monitoreo en lugar de filas de aplicación ordinarias. Un agregado compacto con marca de tiempo puede servir como un libro de contabilidad operativo mientras controla el almacenamiento y la sobrecarga de consultas, tal como se describe en la guía de diseño de tablas del sistema.
Metadatos del proveedor frente a un libro de contabilidad interno controlado
Snowflake, BigQuery y Databricks proporcionan metadatos generados por el sistema, historial de consultas, historial de tablas y vistas de esquemas de información. Estas fuentes ayudan con la inspección específica de la plataforma, pero es posible que no proporcionen la política de retención, el modelo de nomenclatura, las comprobaciones comerciales, los campos de propiedad o el esquema multiplataforma que requiere una empresa.
Una tabla personalizada permite que un equipo defina:
qué métricas son autoritativas,
con qué frecuencia se calcula cada métrica,
cuánto tiempo permanecen disponibles los registros sin procesar y resumidos,
qué umbrales crean incidentes,
y qué metadatos pueden inspeccionar los auditores y los administradores de datos.
Ese control es importante cuando un resultado de Timeliness, un evento de esquema o una validación comercial deben seguir siendo comprensibles después de que la canalización original cambie. Una capa semántica puede estandarizar el significado comercial por encima de estas señales sin ocultar el registro operativo. Los equipos que evalúan ese límite pueden comparar el enfoque del libro de contabilidad con una capa semántica dbt.
Esquema central y patrones de diseño de columnas
Un esquema útil separa lo que se midió, qué valor se observó y cómo se produjo la observación. Combinar estas funciones en una sola columna sobrecargada dificulta el filtrado, la retención y el envío de alertas.
Comience con un modelo de eventos estrecho. Las dimensiones estáticas identifican el activo y la métrica. Los campos dinámicos almacenan el resultado en un momento de observación particular. Los metadatos de ejecución explican el cálculo y brindan a los operadores suficiente contexto para reproducir o clasificar el resultado.
Un diseño de referencia
Nombre de columna | Tipo de datos | Propósito | Valor de ejemplo |
|---|---|---|---|
|
| Tabla medida completamente calificada |
|
|
| Columna medida, anulable para métricas de tabla |
|
|
| Identidad de la métrica |
|
|
| Hora en que se calculó la métrica |
|
|
| Resultado numérico |
|
|
| Límite inferior aceptable |
|
|
| Límite superior aceptable |
|
|
| Resultado de la evaluación |
|
|
| Definición de comprobación y contexto de diagnóstico |
|
Los tipos exactos varían según la plataforma, pero el principio de diseño se mantiene. Utilice DECIMAL para las proporciones cuando la precisión sea importante, TIMESTAMP WITH TIME ZONE para los tiempos de observación y un campo de extensión estructurado como JSONB para los detalles en evolución, como los motivos de error, las definiciones de filtros o los identificadores de tareas de origen. No coloque las dimensiones del filtro principal dentro de JSON si los operadores las consultan regularmente. Promueva esos campos a columnas indexadas.
Una implementación al estilo PostgreSQL podría verse así:
Claves y rutas de acceso
La clave compuesta evita observaciones duplicadas para el mismo activo, métrica y tiempo de cálculo. En sistemas donde las repeticiones pueden producir múltiples resultados legítimos, añada un identificador de ejecución y haga que la regla de unicidad refleje ese modelo de ejecución en lugar de sobrescribir la evidencia.
Cree rutas de acceso en torno a preguntas reales de los operadores:
Una consulta sobre infracciones recientes de Timeliness puede filtrar por tipo de métrica y rango de tiempo en lugar de escanear comprobaciones no relacionadas. La guía de esquemas de información de MySQL plantea el mismo punto operativo desde otro ángulo: los metadatos dinámicos como los recuentos de filas, la longitud de los datos, la longitud del índice, el tiempo de actualización y la cardinalidad pueden agregar sobrecarga, por lo que los equipos deben consultar solo los objetos necesarios y evitar escaneos amplios. La guía de optimización del esquema de información admite el acceso filtrado por esquema, tabla, tipo de métrica y ventana de tiempo.
El esquema también debe documentarse junto con las comprobaciones que lo rellenan. Un catálogo de esquemas de almacén puede ayudar a los equipos a razonar sobre las dependencias, pero el libro de contabilidad de métricas debe permanecer optimizado para el acceso operativo, no para la integridad descriptiva. Consulte los esquemas en un almacén de datos para conocer el límite entre los metadatos estructurales y la evidencia de monitoreo.
Consultas SQL prácticas para tareas comunes de Observability
SQL se vuelve útil cuando cada consulta responde a una pregunta operativa y devuelve suficiente contexto para una decisión. Los siguientes patrones asumen la tabla de referencia de la sección anterior y utilizan la sintaxis de estilo PostgreSQL. Snowflake, BigQuery y Redshift requieren pequeños cambios en la sintaxis de marca de tiempo, percentil y función de fecha.
Infracciones de Timeliness
Almacene la última marca de tiempo de origen observada como metric_value para una métrica de Timeliness, o almacénela en metadatos estructurados si la plataforma necesita un valor de edad numérico independiente. La siguiente consulta compara la observación más reciente con un SLA almacenado en una tabla de configuración.
Particione la tabla por computed_at donde la plataforma lo admita. El predicado de tiempo delimitado permite la poda de particiones y evita un escaneo de todo el historial.
Anomalías de volumen
Una línea base móvil debe reflejar la variación normal en lugar de una única ejecución previa. Este ejemplo utiliza un promedio móvil y una desviación estándar sobre las métricas históricas de recuento de filas.
Utilice una partición o clave de agrupación en el nombre de la tabla y la hora de observación. El rango exacto debe reflejar el riesgo comercial y la estacionalidad, no una constante universal.
Desviación del esquema
La desviación del esquema es más fácil de detectar cuando se almacena una instantánea de referencia como una familia de métricas distinta. La siguiente consulta compara el detalle de la identificación del esquema actual con la última instantánea aprobada.
Los equipos que desean medir la desviación del esquema de manera operativa pueden realizar un seguimiento de la frecuencia de desviación y la latencia de detección de desviación, definidas como el número de cambios de esquema en un período y el tiempo transcurrido entre un cambio y su detección. La guía de monitoreo de desviación de esquema describe esas medidas sin requerir que cada cambio estructural se convierta en un incidente.
Tarea de Observability | Patrón SQL principal | Funciones clave | Umbral típico |
|---|---|---|---|
Timeliness | Última observación frente a la edad configurada |
| SLA específico de la tabla |
Anomalía de volumen | Línea base móvil y banda de desviación |
| Dependiente de la línea base |
Desviación del esquema | Instantánea actual comparada con la línea base |
| Agregado, eliminado o tipo cambiado |
Monitoreo de tasa de nulos | Proporción actual frente a la línea base |
| Tolerancia específica de la columna |
Seguimiento de latencia | Brecha entre ejecuciones y comparación de tiempo de ejecución |
| Expectativa específica de la canalización |
Mantenga estas consultas bajo control de versiones y revíselas como código de producción. Las prácticas de optimización de consultas SQL son especialmente relevantes cuando la tabla de métricas contiene meses de observaciones.
Estrategias de retención y agregación
Las observaciones sin procesar son valiosas durante la respuesta a incidentes y costosas cuando se retienen sin un plan. Una tabla de métricas que registra cada ejecución, activo y comprobación puede crecer rápidamente, por lo que la retención debe coincidir con las preguntas que los operadores necesitan responder.
Tres patrones cubren la mayoría de los despliegues.
Retención solo de datos sin procesar
Este modelo conserva registros detallados y los depura con una política de tiempo de vida. Preserva el mejor detalle forense, incluido el contexto de ejecución exacto y la secuencia de cambios que precedieron a un incidente. La desventaja es que las consultas de tendencias históricas escanean más filas y la tabla necesita un mantenimiento de particiones disciplinado.
La retención solo de datos sin procesar funciona cuando la investigación de incidentes es el caso de uso dominante o cuando la plataforma ya proporciona una poda de particiones económica. Funciona mal cuando los equipos de gobernanza necesitan tendencias históricas largas y los operadores consultan de forma habitual toda la tabla.
Resúmenes agrupados por tiempo
Los resúmenes por horas o días almacenan agregados como mínimo, máximo, promedio, recuento, valor más reciente y recuento de anomalías. Hacen que el análisis de tendencias sea más rápido y reducen la cantidad de datos históricos que deben permanecer en el almacén de datos activo. El compromiso es la irreversibilidad. Un resumen diario puede mostrar que una tabla se comportó de manera anormal, pero es posible que no revele qué ejecución, columna o comprobación produjo la primera desviación.
Utilice vistas materializadas o modelos dbt incrementales para estos resúmenes. Realice la partición por la fecha del grupo y conserve las dimensiones requeridas para los filtros más comunes, como tabla, tipo de métrica, dominio y entorno.
Retención por niveles
Un modelo híbrido conserva los registros sin procesar para una ventana operativa corta y los resúmenes acumulados para una ventana analítica más larga. Equilibra el detalle de los incidentes con la visibilidad de las tendencias, mientras que el almacenamiento en frío puede contener evidencia de Compliance cuando no se requiere una latencia de consulta interactiva.
Decisión de retención: Conserve el detalle sin procesar cuando este cambie el resultado de una investigación. Acumule los registros cuando la pregunta restante sea direccional, comparativa o centrada en la gobernanza.
Alinee la retención con los patrones de acceso. Si los operadores filtran por tabla y tiempo reciente, particione por fecha de observación e indexe o agrupe por nombre de tabla. Si los auditores filtran por control, propietario o período de informe, preserve esos campos en el resumen en lugar de obligarlos a reconstruir el contexto a partir de eventos sin procesar.
Las características históricas del almacén de datos pueden complementar este diseño, pero no eliminan la necesidad de elegir qué registros de métricas siguen siendo consultables. Los patrones de datos históricos de Snowflake brindan un contexto útil para separar el historial operativo del análisis a largo plazo.
Conexión de métricas con señales de Timeliness y desviación de esquema
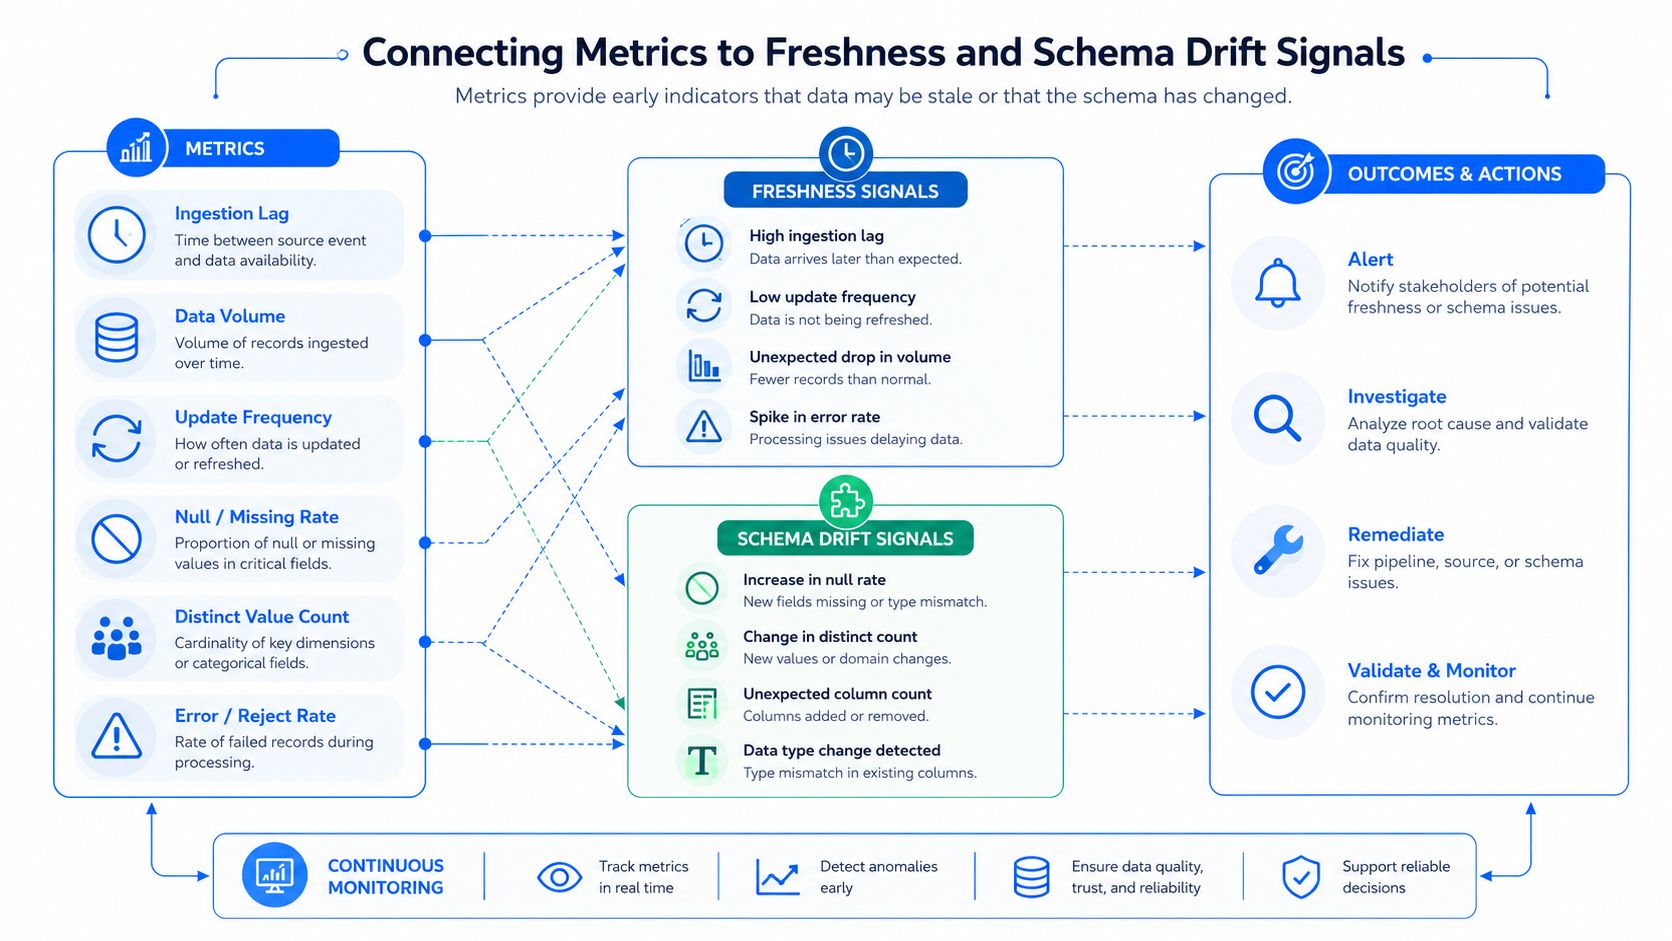
Una sola métrica rara vez explica si una tabla es segura para el consumo. Una llegada tardía puede ser inofensiva si el cronograma de origen cambió. Un cambio en el recuento de filas puede ser esperado durante un evento estacional. Un cambio de esquema puede ser compatible con versiones anteriores. La señal útil aparece cuando varias observaciones apuntan al mismo modo de falla.
Los registros de Timeliness, volumen y esquema se pueden unir mediante el identificador de tabla y una ventana de tiempo común. A partir de ahí, los equipos pueden construir un índice de confiabilidad compuesto, pero la puntuación debe clasificar la prioridad de la investigación en lugar de pretender representar una verdad objetiva.
Correlación de señales
Una consulta de correlación simple puede identificar tablas con múltiples condiciones simultáneas:
La regla de escalada debe reflejar la consecuencia. Una falla de Timeliness combinada con una falla de volumen puede justificar un reintento automatizado o una investigación del origen. Un cambio de esquema combinado con un modelo posterior sensible al tipo debería pausar la promoción y solicitar la revisión de un administrador de datos. Una fluctuación aislada en la tasa de nulos puede requerir observación en lugar de una alerta inmediata.
Una decisión matrix para una respuesta con poco ruido
Combinación de señales | Interpretación probable | Respuesta |
|---|---|---|
Solo Timeliness | Entrega tardía o faltante | Comprobar el cronograma ascendente, luego reintentar cuando sea seguro |
Solo volumen | Variación de carga o extracción parcial | Comparar los totales de origen y la carga de trabajo reciente |
Solo esquema | Cambio estructural | Revisar la compatibilidad y las dependencias descendentes |
Timeliness más volumen | Carga incompleta o demorada | Escalar al propietario de la canalización |
Esquema más volumen | Cambio de contrato o transformación | Retener la publicación descendente y revisar |
Las tres juntas | Falla generalizada de activos | Abrir un incidente de alta prioridad con contexto de linaje |
El monitoreo de desviación de esquema pregunta si una columna se agregó, eliminó o cambió de tipo sin previo aviso. Timeliness pregunta si los datos llegan según lo programado. Esas definiciones son operativamente distintas, y la guía de señales de Data Observability es útil al diseñar la taxonomía de métricas.
Los equipos pueden ejecutar estas comprobaciones directamente dentro de la base de datos, evitando movimientos de datos innecesarios y reduciendo la distancia entre la observación y la decisión. La ejecución de la Observability en la base de datos describe este modelo como la ejecución de pruebas directamente dentro del entorno de la base de datos, lo que se adapta a una tabla de sistema de métricas que almacena resultados compactos en lugar de datos de origen extraídos.
Cuando más métricas reducen la efectividad de la Observability
La cobertura parece segura hasta que la tabla de métricas se convierte en un catálogo de todo lo que se puede medir. En ese momento, los costos de las consultas aumentan, los flujos de alerta se vuelven difíciles de clasificar y las fallas importantes compiten con fluctuaciones inofensivas.
Un equipo puede realizar un seguimiento de un gran conjunto de estadísticas a nivel de columna mientras pasa por alto una falla de lógica comercial. También puede producir tantas notificaciones que los ingenieros las acepten sin investigar. El problema no es la medición en sí. El problema es tratar cada medición como igualmente accionable.
Priorizar por consecuencias
Comience con las señales que afectan la capacidad de un consumidor para usar los datos:
Timeliness de nivel uno: Monitoree si las tablas ejecutivas, regulatorias, de cara al cliente u operativas llegan cuando se esperan.
Volumen a nivel de tabla: Detecte cargas vacías, extractos parciales y cambios inesperados de origen antes de agregar comprobaciones granulares.
Compatibilidad de esquemas: Aplique monitoreo estructural a las rutas críticas donde un cambio de tipo o columna pueda romper los modelos.
Comprobaciones de columnas específicas: Añada comprobaciones de tasa de nulos, cardinalidad o distribución cuando una columna específica influya en un cálculo financiero, una característica de un modelo o un control de Compliance.
Esta secuencia mantiene la tabla del sistema de métricas como un libro de contabilidad operativo, no como un catálogo de datos completo. Un monitoreo más amplio a nivel de tabla puede cubrir Timeliness, desviación de esquema y anomalías de volumen sin requerir cientos de reglas para cada conjunto de datos, mientras que una validación más profunda sigue estando disponible para los activos de alto riesgo. La guía unificada de calidad de datos y Observability respalda ese enfoque por capas.
Retirar comprobaciones que no cambian las decisiones
Cada comprobación debe tener un propietario, una respuesta y una razón para permanecer activa. Si una métrica no ha producido ninguna respuesta accionable durante su período de revisión, pregúntese si el umbral es incorrecto, si el activo es de baja prioridad o si la comprobación ya no pertenece al monitoreo continuo.
Prueba operativa: Si una alerta no puede identificar a un equipo responsable y una acción siguiente, probablemente no debería alertar a nadie.
Utilice paneles de control para el contexto exploratorio y alertas para las decisiones. Una infracción de Timeliness a nivel de tabla puede notificar a un propietario. Un pequeño movimiento de distribución puede permanecer visible en el análisis de tendencias hasta que se combine con otra señal. La discusión de Snowflake sobre la remediación de la calidad de los datos refuerza el compromiso más amplio: la cobertura del monitoreo es útil solo cuando los equipos pueden actuar sobre el resultado, no cuando produce más resultados sin revisar. Consulte flujos de trabajo de corrección de calidad de datos.
El objetivo correcto no es el volumen máximo de métricas. Es el conjunto más pequeño de señales que detecta la degradación significativa a tiempo, respalda el diagnóstico y crea un registro defendible de lo que sucedió.
Instrumentación de tablas de métricas en plataformas empresariales
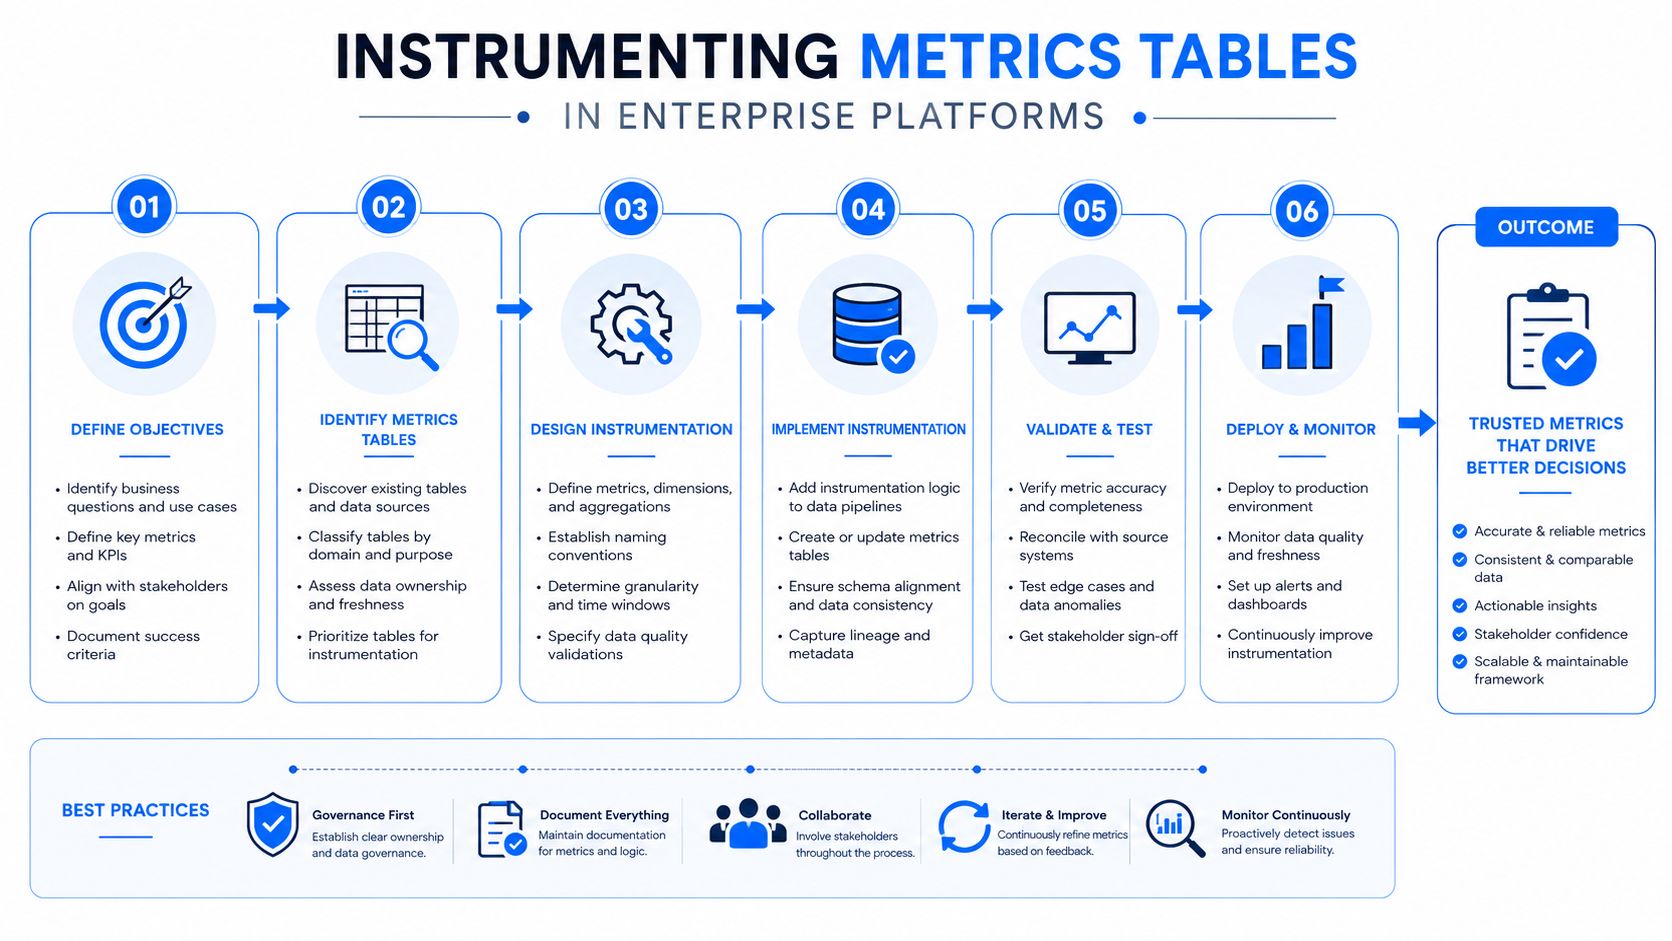
La instrumentación de producción debe ejecutarse cerca de los datos y residir en el control de versiones. Las tareas SQL programadas, los post-hooks de dbt, los procedimientos nativos del almacén y la orquestación de la plataforma pueden poblar una tabla de sistema de métricas sin exportar registros sin procesar a un servicio independiente.
La elección de la implementación depende de la comprobación. Una consulta de Timeliness puede ejecutarse después de la ingesta. Una instantánea de esquema puede ejecutarse antes de que se liberen los modelos descendentes. Un cálculo de distribución más pesado puede ejecutarse en un cronograma que coincida con su riesgo y costo. Lo importante es que el cronograma, la consulta, el umbral, el propietario y la política de retención se declaren juntos.
Un patrón de despliegue que se mantiene firme
Crear el libro de contabilidad. Añada la tabla de métricas, la tabla de configuración, los campos de propiedad y el mecanismo de retención antes de habilitar las alertas.
Registrar activos críticos. Registre los identificadores de tablas, el dominio comercial, la gravedad, el cronograma esperado y el equipo responsable.
Poblar desde la base de datos. Utilice SQL programado, hooks de dbt o tareas nativas para calcular agregados compactos en el sitio.
Establecer una línea base antes de alertar. Almacene observaciones el tiempo suficiente para comprender el comportamiento normal, luego establezca umbrales que reflejen el activo.
Enrutar resultados accionables. Envíe los incidentes aprobados a Slack, PagerDuty, paneles de gobernanza o una herramienta de Observability existente.
Adjuntar manuales de instrucciones. Almacene referencias de remediación con la configuración de la métrica para que una alerta se abra con contexto.
Una plataforma como Monte Carlo puede consumir señales de almacén, mientras que un servicio personalizado puede consultar el libro de contabilidad directamente. digna proporciona cálculo de métricas en la base de datos para recuento de registros, tasas de valores faltantes, estadísticas de distribución, agregaciones de KPI y desviaciones de puntualidad, con módulos para detección de anomalías, validación y seguimiento de esquemas.
Proteger el rendimiento
Indexe o agrupe por los campos que los operadores filtran con más frecuencia. Particione por fecha de observación donde se admita. Evite volver a calcular métricas costosas para cada tabla en cada ejecución y no permita que una consulta de alerta escanee todos los registros históricos cuando una partición reciente contiene la evidencia necesaria.
Mantenga las definiciones de comprobación en un repositorio y revise los cambios mediante el mismo proceso que el código de transformación. La lógica de los cuadernos y los scripts dispersos son difíciles de auditar, reproducir o retirar. Una configuración con control de versiones hace visibles los cambios de propiedad, las ediciones de umbrales y la evolución del esquema.
Governance y auditabilidad en industrias reguladas
En finanzas, atención médica, telecomunicaciones y el sector público, la evidencia de Observability debe sobrevivir más allá del incidente que la creó. Una tabla de sistema de métricas puede registrar que se ejecutó una comprobación, qué midió, qué versión se ejecutó, si se aprobó y quién era el propietario del resultado.
Ese registro respalda más que la respuesta a incidentes. Puede ayudar a un auditor a verificar que una tabla financiera crítica se validó antes de un proceso de informes, o que una columna sensible permaneció dentro de su rango de calidad esperado. El valor proviene de preservar la evidencia de ejecución y hacer que la evidencia sea explicable.
Separar a los redactores de los lectores
Las canalizaciones automatizadas deben ser las propietarias de las escrituras. Los auditores, los administradores de datos, los propietarios de controles y los ingenieros de plataformas deben recibir acceso de lectura delimitado. Evite otorgar permisos a los usuarios operativos para editar resultados históricos, ya que la evidencia mutable debilita la pista de auditoría.
Los campos de auditoría útiles incluyen:
check_executed_at, la hora en que se ejecutó la evaluación.observed_at, el tiempo representado por la métrica.check_version, que identifica la lógica utilizada.owner_team, que identifica la responsabilidad.lineage_reference, que conecta el resultado con los activos ascendentes y descendentes.result_statusyfailure_reason, que hacen que el resultado sea comprensible.remediation_status, que muestra si el problema fue revisado o resuelto.
Nombre de columna | Tipo de datos | Propósito | Requisito de retención |
|---|---|---|---|
|
| Identifica la comprobación gobernada | Retener con el registro de control |
|
| Prueba el tiempo de ejecución | Conservar para el período de auditoría |
|
| Identifica el estado de los datos medidos | Conservar con el resultado |
|
| Establece la responsabilidad | Retener mientras el control esté activo |
|
| Conecta el activo con las dependencias | Retener para investigación y revisión |
|
| Almacena el resultado observado | Conservar con la evidencia de control |
|
| Registra el estado de aprobación o falla | Conservar como evidencia inmutable |
|
| Apunta a artefactos de respaldo | Retener según la política |
La retención regulada puede extenderse mucho más allá de la ventana de consulta activa. Almacene evidencia reciente en el almacén para el acceso operativo, comprima particiones más antiguas y archive registros inmutables en un almacenamiento de objetos controlado cuando el acceso interactivo ya no sea necesario. Aplique cifrado, registro de acceso y políticas de eliminación que coincidan con la clasificación de datos gobernada.
Una tabla de sistema de métricas se convierte en infraestructura de gobernanza cuando sus registros son inmutables, atribuibles, reproducibles y están conectados con el linaje de datos subyacente. No debería limitarse a decir que falló una comprobación. Debería explicar qué comprobación se ejecutó, contra qué activo, bajo qué definición y qué sucedió después.
Referencia rápida para el diseño de tablas de sistema de métricas
Un diseño de producción debe ser fácil de inspeccionar durante un incidente. La siguiente tabla condensa los campos que suelen importar más.
Columna central | Tipo sugerido | Función operativa | Frecuencia de actualización |
|---|---|---|---|
|
| Identifica el activo medido | Cada observación |
|
| Identifica la señal | Cada observación |
|
| Almacena el resultado calculado | Según el cronograma de comprobación |
|
| Identifica el estado de los datos | Por observación de origen |
|
| Compara instantáneas estructurales | En la comprobación de esquema |
|
| Sigue el volumen de la tabla | Según el cronograma de carga o comprobación |
Patrones de consulta de producción
Comprobaciones de Timeliness: Filtre registros recientes de
metric_type = 'freshness'y compare la última observación con el límite de edad configurado para el activo.Anomalías de volumen: Utilice una ventana histórica acotada, funciones de ventana y una línea base específica de la tabla en lugar de comparar cada resultado con la ejecución inmediatamente anterior.
Alertas de desviación de esquema: Compare la instantánea de esquema actual con una línea base aprobada y clasifique las adiciones, eliminaciones y cambios de tipo por separado.
Monitores de tasa de nulos: Filtre por columna y tipo de métrica, luego evalúe la proporción actual frente al rango esperado de la columna.
Seguidores de latencia: Utilice
LAGsobre observaciones ordenadas para calcular brechas entre ejecuciones e aislar entregas retrasadas.
Los filtros listos para producción deben acotarse por table_name, metric_type y ventana de observación antes de aplicar los cálculos. Esa combinación admite la poda de particiones, el uso de índices y un menor costo de investigación.
Los umbrales necesitan contexto
No existe un SLA de Timeliness, rango de volumen o límite de tasa de nulos universal que se adapte a cada tabla empresarial. Una tabla de nivel uno puede necesitar una expectativa de entrega más estricta que un conjunto de datos exploratorio. Un origen diario puede tolerar un patrón de volumen diferente al de un flujo de eventos de alta frecuencia. Un cambio de esquema puede ser inofensivo para un consumidor y bloquear un Release para otro.
Utilice el comportamiento histórico para establecer una línea base, luego combine los umbrales con las consecuencias y la propiedad. Requiera múltiples señales relacionadas antes de escalar condiciones ruidosas y mantenga el registro de alertas lo suficientemente completo como para respaldar una transferencia. Revise las comprobaciones con regularidad, elimine las mediciones que no conduzcan a la acción y conserve la evidencia subyacente requerida para la gobernanza.
digna ayuda a los equipos a calcular y analizar métricas a nivel de tabla en la base de datos, monitorear la puntualidad y las anomalías, validar registros y realizar un seguimiento de los cambios de esquema sin mover los datos de producción fuera del entorno del cliente. Visite digna para ver cómo sus capacidades modulares de Observability pueden transformar una tabla de sistema de métricas en un flujo de trabajo gobernado para ingenieros, administradores y propietarios de plataformas de datos.
Preguntas frecuentes
¿Qué es una metrics system table?
Un libro mayor operativo de baja latencia con observaciones calculadas sobre activos de datos. Está deliberadamente separada de las tablas de negocio con entidades como pedidos, usuarios, eventos o siniestros, porque ambas cargas tienen formas y patrones de consulta distintos.
¿Por qué no bastan los scripts ad hoc?
Funcionan para la primera comprobación y dejan de escalar después. Una tabla centralizada da a los ingenieros una interfaz estable para la detección, la comparación con una línea base o un periodo previo, la escalada con severidad y responsable, y la evidencia de qué se comprobó, cuándo se ejecutó y qué resultado dio.
¿Qué debe contener cada registro?
Cuatro grupos: dimensiones como base de datos, esquema, tabla, columna, tipo de métrica, entorno y dominio de negocio; medidas como valor observado, filas afectadas o puntuación de anomalía; metadatos de ejecución como momento de cálculo, trabajo de origen y versión de la comprobación; y contexto de gobernanza como responsable, severidad, referencia de linaje y estado de remediación.
¿Cuándo es realmente operativa una métrica?
Cuando alguien puede consultarla, identificar a su responsable, decidir qué acción debe disparar y revisar su historial. Menos que eso es un número que se recoge, no un control que se ejecuta, y el estado de la canalización solo responde a si la tarea corrió.
¿Hay precedentes de este diseño?
Sí, en las tablas de sistema relacionales usadas como capa de metadatos. Oracle 10g introdujo tablas de métricas que calculaban deltas y tasas, simplificando preguntas como la tasa de E/S actual de la base, el mismo cambio arquitectónico de la inspección manual puntual al seguimiento estandarizado actual e histórico.


