Qué es un formato de tabla abierto y por qué importa
|
9
minuto de lectura

Si tu lago ya almacena archivos Parquet, ¿por qué eso no te da automáticamente una tabla?
Esa brecha desconcierta a muchos equipos. Tienen archivos, carpetas, particiones y motores SQL capaces de leerlos. Pero todavía no tienen una respuesta fiable a preguntas básicas de producción: ¿qué archivos componen la versión actual de esta tabla? ¿Qué pasa si dos trabajos escriben a la vez? ¿Puedo revertir una carga defectuosa sin reconstruir los datos a mano?
Índice de contenidos
Qué es un formato de tabla abierto
Si tu lago ya almacena archivos Parquet, ¿por qué las pipelines de producción siguen rompiéndose por algo tan simple como «cuál es la tabla actual»?

Los equipos que lanzan escrituras concurrentes de Spark sobre un prefijo Parquet particionado suelen aprender la respuesta por las malas. Los archivos existen, pero el estado de la tabla es confuso. Un motor puede leer una partición parcialmente actualizada, otro puede perderse archivos recién añadidos, y alguien de guardia acaba inspeccionando rutas de almacenamiento a mano para averiguar qué significa siquiera «actual».
Un formato de tabla abierto resuelve ese problema en la capa de metadatos. Define cómo una tabla registra sus archivos, versiones, cambios de esquema y operaciones de escritura para que varios motores traten los datos del almacenamiento de objetos como una tabla real y no como una convención de directorios suelta.
Esa distinción importa porque la decisión de fondo es arquitectónica, no la elección de un nuevo tipo de archivo. Los archivos de datos siguen siendo a menudo Parquet u ORC. Si quieres repasar la capa de almacenamiento que hay debajo, esta explicación del formato Parquet cubre esos cimientos. El formato de tabla abierto se sitúa sobre esos archivos y registra las reglas del estado de la tabla.
Una analogía útil es un almacén con contenedores de inventario etiquetados. Los archivos Parquet son las cajas en el suelo. Un formato de tabla abierto es el sistema de inventario que dice qué cajas pertenecen al envío actual, cuáles se reemplazaron, quién actualizó los registros y cómo era el almacén antes del último cambio desafortunado. Sin ese sistema de inventario, cada lector tiene que adivinar a partir de lo que ve en el almacenamiento.
En la práctica, esa arquitectura de metadatos te da un comportamiento de tabla que los archivos por sí solos no ofrecen con limpieza. Obtienes transacciones ACID, evolución del esquema y viaje en el tiempo porque el formato mantiene un registro coherente del estado de la tabla y de sus cambios en el tiempo. Por eso Apache Hudi, Apache Iceberg y Delta Lake suelen tratarse juntos. Son formas distintas de gestionar el mismo problema de fondo.
Los resultados operativos son la parte que los ingenieros notan. La deriva de esquema se controla mejor porque la tabla tiene un historial de esquema con autoridad. El coste de consulta baja porque los motores pueden usar metadatos en lugar de escanear cada archivo solo para descubrir qué existe. La observabilidad mejora porque puedes inspeccionar instantáneas, commits y cambios a nivel de archivo en vez de tratar un prefijo de almacenamiento como una caja negra.
Así que la definición más corta y precisa es esta: un formato de tabla abierto es una especificación abierta para gestionar metadatos y comportamiento de tabla sobre archivos en almacenamiento de objetos. Los archivos guardan los datos. El formato define cómo los sistemas se ponen de acuerdo sobre qué es la tabla.
La capa de metadatos que lo cambia todo
¿Por qué dos motores leen a veces el mismo lago y devuelven respuestas distintas?
La causa raíz no suelen ser los archivos. Es la ausencia de un registro compartido y con autoridad del estado de la tabla. Por eso los formatos de tabla abiertos se entienden mejor como una decisión de arquitectura de metadatos. Los archivos siguen importando, pero el comportamiento en producción depende sobre todo de cómo la capa de metadatos define la verdad.
El catálogo de una biblioteca es un buen modelo aquí. Los libros en las estanterías son tus archivos Parquet. El catálogo decide qué libros pertenecen a la colección, qué edición es la vigente, cuáles se retiraron y cómo era la colección ayer. Sin ese catálogo, cada lector recorre las estanterías y hace su propia conjetura.
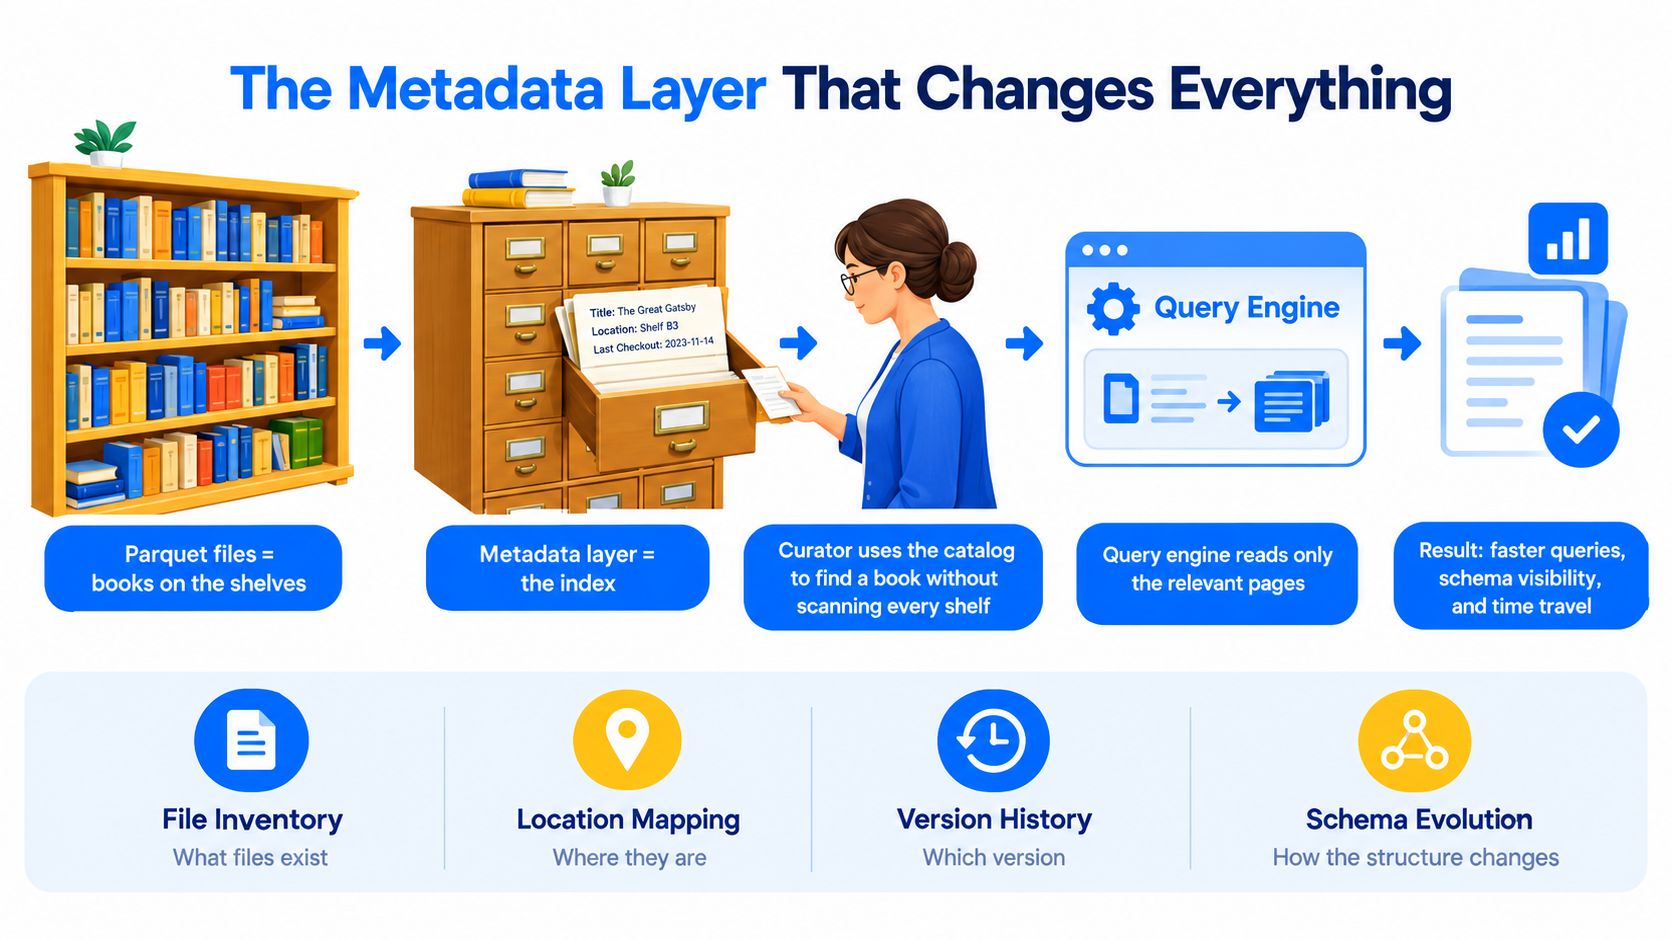
Esa distinción aparece rápido en la operación. El coste de consulta sube cuando los motores tienen que listar directorios e inspeccionar archivos solo para descubrir la tabla. La deriva de esquema cuesta más de contener cuando ningún sistema posee el historial. La observabilidad sigue siendo débil cuando un prefijo de almacenamiento es lo único que puedes inspeccionar.
Para un contexto más amplio sobre cómo los equipos organizan y gobiernan los metadatos, la guía de gestión de metadatos de digna cubre la disciplina que lo rodea.
Seis cosas que cambia la capa de metadatos
Las instantáneas crean una vista coherente de la tabla
Los lectores no interpretan «los archivos que existan ahora mismo» como la tabla. Leen desde una instantánea definida, lo que da a cada motor la misma respuesta sobre el estado actual en ese momento.El seguimiento de archivos abarata la planificación
En lugar de escanear un árbol de directorios completo, el motor puede consultar metadatos que ya listan los archivos relevantes y sus estadísticas. El efecto práctico es menor coste de consulta y una planificación más predecible, sobre todo a medida que las tablas crecen.Las transacciones evitan la visibilidad parcial
Una escritura se hace visible cuando el commit tiene éxito. Si un trabajo falla a medio camino, los lectores se quedan en la instantánea válida anterior en lugar de ver una mezcla de archivos viejos y nuevos.La evolución del esquema se vuelve explícita
Las adiciones, renombrados y cambios de tipo de columna se registran como cambios de metadatos de tabla. Eso te da una fuente de verdad para el historial de esquema en vez de depender de que cada motor infiera la estructura a partir de los archivos.El particionado pasa a ser una regla de la tabla
La disposición de directorios deja de cargar tanto significado. Los metadatos de la tabla pueden describir la lógica de partición directamente, lo que facilita gestionar cambios de disposición con el tiempo.El historial se vuelve inspeccionable
Las instantáneas antiguas siguen formando parte del registro de la tabla. Eso ayuda con la reversión, la depuración, las preguntas de auditoría y cuestiones simples como «¿qué cambió entre estas dos ejecuciones?».
Un modo de fallo concreto lo hace más fácil de ver.
Una pipeline por lotes escribe un nuevo día de datos en el almacenamiento de objetos. Un motor de consulta empieza a leer mientras la escritura sigue en curso. Otro motor lee unos minutos después, cuando ya han aterrizado más archivos. Ambos equipos dicen que consultaron «la misma tabla». No fue así. Consultaron listados de archivos distintos en momentos distintos.
Con un formato de tabla abierto, el commit publica un nuevo estado de tabla solo cuando está completo. Hasta entonces, los lectores siguen usando la instantánea anterior. Ese es el giro operativo. Dejas de tratar el listado de carpetas como el contrato y empiezas a tratar los metadatos como el contrato.
Regla práctica: si el contenido de las carpetas define tu tabla en el momento de lectura, el comportamiento de tu tabla sigue basándose en convenciones de almacenamiento.
Apache Iceberg deja ese contrato especialmente claro. Su especificación de tablas define los metadatos como un objeto JSON que registra esquema, especificaciones de partición, propiedades e instantáneas, con las instantáneas anotadas en los propios metadatos de la tabla, tal como describe la especificación de tablas de Iceberg.
Por eso esta capa cambia tanto en producción. Determina cómo los sistemas se ponen de acuerdo sobre la verdad de la tabla, y esa decisión afecta a la corrección, al coste y a la rapidez con que tu equipo puede explicar un resultado erróneo.
Apache Iceberg, Delta Lake y Apache Hudi comparados
Si los formatos de tabla abiertos son realmente una decisión de arquitectura de metadatos, y no solo de formato de archivo, la comparación cambia. No eliges entre tres formas de almacenar Parquet. Eliges tres formas de definir la verdad de la tabla, publicar cambios y coordinar lectores y escritores en producción.
Ese encuadre importa porque el dolor operativo aparece en sitios distintos. Un formato puede reducir la fricción entre motores. Otro puede encajar de forma más natural en una plataforma centrada en Spark. Un tercero puede facilitar la operación de actualizaciones frecuentes y pipelines de CDC. La pregunta práctica es simple: ¿dónde quieres que el sistema de metadatos cargue con el mayor peso?
Iceberg, Delta Lake y Hudi de un vistazo
Dimensión | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Origen | Desarrollado en Netflix en 2018, donado a Apache en 2019 | Liberado como código abierto en 2019 | Creado en Uber en 2016 |
Énfasis principal | Especificación de metadatos portable entre motores | Protocolo de tabla muy centrado en Spark e integración de plataforma | Upserts, procesamiento incremental y mantenimiento de tabla intensivo en streaming |
Modelo de metadatos | Árbol de metadatos basado en instantáneas y manifiestos | Registro de transacciones centrado en | Línea temporal de commits con servicios de tabla y mantenimiento orientado a registros |
Mejor encaje | Entornos lakehouse con varios motores | Estados muy orientados a Databricks o Spark | Pipelines de CDC y streaming con actualizaciones frecuentes |
Sensación operativa | Separación limpia entre archivos y metadatos de tabla | Flujo muy cohesionado para equipos ya estandarizados en herramientas Delta | Más servicios de tabla, más foco en la ruta de escritura |
La historia de origen importa menos que el centro del diseño. Cada formato responde a la misma pregunta de otra manera: ¿cómo debería una tabla registrar cambios, exponer el estado actual y permitir que los motores se pongan de acuerdo sobre lo que leen?
En qué se diferencian los diseños
Apache Iceberg centra la tabla en un árbol de metadatos. Eso suele atraer a equipos con varios motores porque el contrato de la tabla se define como una especificación portable y no por el comportamiento de una sola pila de procesamiento. En la práctica, eso puede significar menos sorpresas cuando Spark, Trino, Flink y otros motores necesitan leer los mismos datos sin inventarse convenciones separadas.
Delta Lake centra la tabla en un registro de transacciones. Para equipos ya estandarizados en Spark y Databricks, eso suele resultar natural porque la ruta de escritura, los controles de gobierno y las herramientas operativas encajan de cerca. La elección de metadatos se nota en el día a día. Los cambios de esquema, la reversión y el mantenimiento pueden sentirse más integrados cuando la plataforma ya asume semántica Delta.
Apache Hudi orienta mucho más su diseño a la operación con escrituras intensivas. Si tu dolor no es «muchos motores deben coincidir» sino «los registros cambian constantemente y los consumidores necesitan movimiento incremental», Hudi entra pronto en la conversación. Su arquitectura refleja ese sesgo. La especificación técnica de Hudi explica que los metadatos se guardan en una tabla gestionada internamente bajo la ruta de la especificación técnica de Hudi .hoodie/metadata, y que esa tabla de metadatos es a su vez una tabla Hudi con merge-on-read.
Una analogía útil es un sistema de inventario de almacén. Iceberg está diseñado para que muchos departamentos confíen en el mismo registro del catálogo. Delta está diseñado para que el almacén y su sistema operativo funcionen muy acoplados. Hudi está diseñado para un almacén donde los artículos se corrigen, reemplazan o reponen constantemente, y el inventario debe seguir ese ritmo.
Qué significan esas decisiones en producción
Los equipos suelen notar la diferencia primero.
Si la deriva de esquema es un problema recurrente, el modelo de metadatos importa porque la evolución del esquema no es solo una casilla de funciones. Determina si los trabajos posteriores fallan ruidosamente, leen supuestos mezclados o requieren manejo específico por motor.
Si el coste de consulta no deja de subir, importa la disposición de metadatos, porque la tabla tiene que ayudar al motor a evitar archivos innecesarios. Una ruta de planificación más limpia suele significar menos archivos escaneados y menos sorpresas caras en ejecución.
Si el problema son las lagunas de observabilidad, importa la elección de formato porque el historial de metadatos determina con qué facilidad tu equipo puede responder preguntas operativas básicas. ¿Qué instantánea introdujo los registros erróneos? ¿Qué commit cambió el comportamiento de partición? ¿Qué escritor publicó archivos incompatibles?
Por eso también acaban conectadas las decisiones de formato y los controles de calidad. En entornos muy orientados a Databricks, las prácticas de calidad de datos en Databricks suelen tener que diseñarse junto al comportamiento de las tablas Delta, no como una capa añadida después.
Una forma práctica de elegir
Usa Iceberg si la interoperabilidad entre motores es un requisito de primer orden y quieres que la propia especificación de tabla se mantenga lo más independiente posible de un runtime de proveedor.
Usa Delta Lake si tu plataforma ya se apoya mucho en Spark o Databricks y valoras una integración estrecha entre ruta de escritura, gobierno y operación diaria.
Usa Hudi si las actualizaciones frecuentes, la ingesta CDC y el consumo incremental definen la carga más que la portabilidad amplia entre motores.
Ningún formato gana en todas las categorías. Cada uno coloca el contrato de metadatos en un papel algo distinto. Esa decisión de diseño moldea cómo manejas corrección, coste y depuración de incidencias una vez la tabla está en producción.
Cómo llega realmente una consulta a los datos
¿Por qué la misma consulta SQL resulta barata en una tabla y dolorosamente cara en otra, aunque ambas apunten al mismo almacén de objetos?
La respuesta suele estar en los metadatos, no en Parquet.
SELECT * FROM sales WHERE order_date = current_date
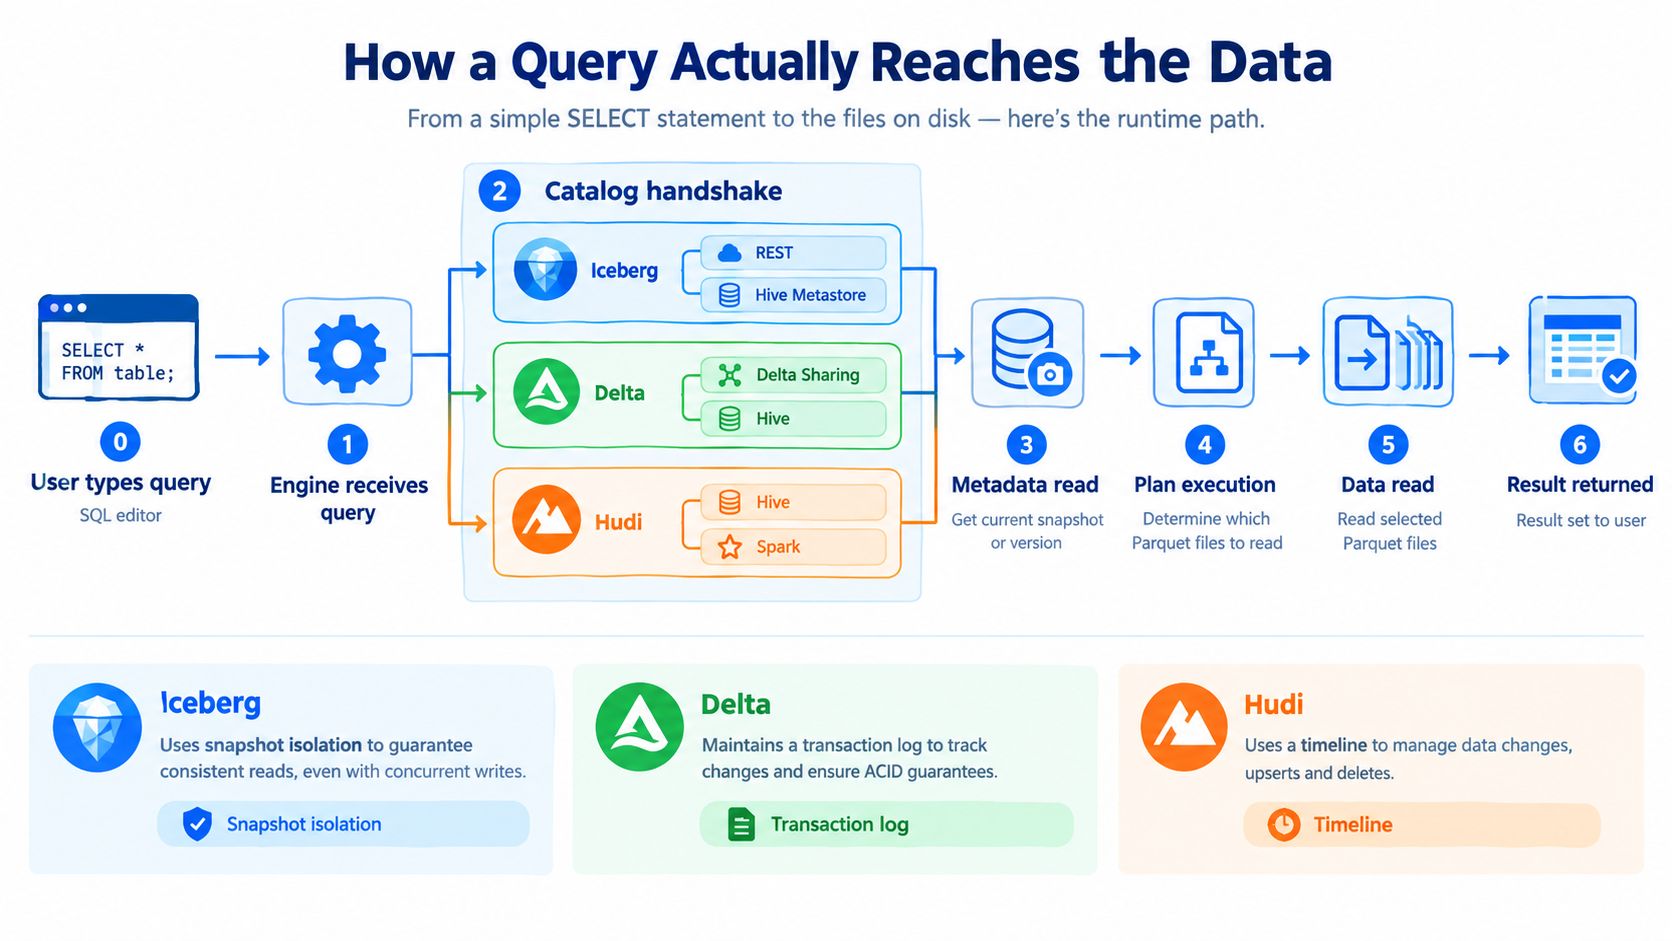
Una consulta así no empieza escaneando carpetas. Empieza preguntando: «¿qué significa esta tabla ahora mismo?». Ese es el modelo mental clave. Un formato de tabla abierto es una arquitectura de metadatos para responder a esa pregunta de forma fiable.
Primero, el motor pregunta por el estado actual de la tabla
El motor resuelve sales a través de un catálogo como Hive Metastore, AWS Glue, Unity Catalog o Nessie. El catálogo actúa como una recepción con la dirección actual, no como el almacén que guarda cada caja. Su trabajo es señalar al motor la entrada de metadatos vigente.
Ese detalle tiene consecuencias operativas reales. Si el catálogo apunta a metadatos obsoletos, el motor planifica contra un estado de tabla obsoleto. Si un trabajo de ingesta deja archivos directamente en el almacenamiento sin un commit válido, esos archivos pueden existir físicamente y permanecer invisibles en lo lógico.
Para una vista de arquitectura más amplia, este repaso de arquitectura de sistemas de datos ayuda a situar dónde encaja el catálogo respecto a almacenamiento y cómputo.
Luego el formato de tabla aporta el mapa de archivos
Una vez que el motor tiene la entrada de metadatos, el formato de tabla abierto toma el relevo:
Iceberg lee metadatos de tabla, manifiestos y la instantánea activa.
Delta Lake lee el registro de transacciones más cualquier estado con checkpoint.
Hudi lee su línea temporal y los metadatos de tabla para determinar la vista actual.
Mecánicas distintas, mismo propósito. El motor necesita un mapa de archivos con autoridad antes de leer ningún archivo de datos.
Ese es el cambio práctico entre un lago de datos plano y un formato de tabla abierto. Sin esta capa de metadatos, el motor suele tener que inferir el estado de la tabla a partir de carpetas y nombres de archivo. Con ella, el estado de la tabla se declara de forma explícita.
La planificación ocurre antes del escaneo
El coste de consulta empieza a divergir.
Cuando el motor sabe qué archivos pertenecen a la instantánea actual, puede acotar el trabajo con datos de partición, estadísticas de archivo y metadatos de commit. En vez de abrir cada archivo bajo una ruta y resolverlo tarde, puede descartar archivos irrelevantes durante la planificación.
Eso cambia el comportamiento en producción de formas que los ingenieros notan rápido:
Menor coste de consulta porque hay que abrir menos archivos
Menos confusión por deriva de esquema porque la ruta de lectura sigue metadatos de tabla confirmados, no los archivos que hayan aterrizado
Mejor depuración de incidencias porque puedes inspeccionar instantáneas, commits y pertenencia de archivos directamente
Menos puntos ciegos de observabilidad porque el estado de la tabla queda registrado como metadatos y no escondido en convenciones de carpeta
Si un panel se ve mal de repente, la pregunta de depuración se vuelve más precisa. ¿Qué instantánea leyó el motor? ¿Qué commit añadió esos archivos? ¿Qué cambio de metadatos alteró el comportamiento de partición o esquema?
Por eso los formatos de tabla abiertos se entienden mejor como un plano de control para tablas. La consulta alcanza los datos solo después de que los metadatos definan qué es la tabla, qué archivos le pertenecen y cuáles pueden ignorarse.
Beneficios reales y las concesiones con las que toparás
El primer sprint tras adoptar un formato de tabla abierto suele sentar bien. Las escrituras se vuelven más fiables. Los cambios de tabla dejan de parecer cirugía de carpetas. Los equipos recuperan la confianza de que una tabla significa una sola cosa coherente en un momento dado.
Luego aparece la realidad de producción.
Beneficios y concesiones de los formatos de tabla abiertos de un vistazo
Beneficio | Qué obtienes | Concesión que heredas |
|---|---|---|
Escrituras ACID | Los lectores no ven lotes a medio terminar | Ahora dependes de la coordinación de commits y de la salud de los metadatos |
Evolución del esquema | Cambios de columna controlados sin reescrituras constantes | Sigues necesitando disciplina sobre compatibilidad y contratos posteriores |
Viaje en el tiempo | Reversión y depuración más fáciles | La retención del historial debe gestionarse deliberadamente |
Portabilidad entre motores | Más flexibilidad con Spark, Trino, Flink y otros | La portabilidad del formato no garantiza un gobierno abierto |
Mejor planificación de consultas | Poda de archivos más eficaz y estado de tabla más limpio | El mantenimiento de metadatos pasa a ser parte de la operación de plataforma |
Cada beneficio crea una responsabilidad nueva
Las escrituras fiables eliminan una clase de fallos del lago, pero también crean una nueva frontera de caída alrededor de la ruta de metadatos y el catálogo.
El viaje en el tiempo ayuda cuando alguien publica datos erróneos, pero las instantáneas históricas no se gestionan solas. Si nunca expiras instantáneas antiguas ni limpias metadatos, el almacenamiento y la sobrecarga de planificación crecen.
La evolución del esquema reduce las reescrituras a la fuerza, pero no elimina la necesidad de contratos de datos. Una columna renombrada todavía puede romper a un consumidor que esperaba el nombre antiguo.
Para equipos que comparan patrones de lakehouse de forma más amplia, esta comparación entre data lake y data mart resulta útil porque destaca cómo la flexibilidad de almacenamiento y el consumo curado sirven a objetivos operativos distintos.
El coste oculto es el trabajo de mantenimiento
Esta es la parte que muchos diagramas de arquitectura se saltan. Las tablas abiertas autogestionadas siguen necesitando compactación, expiración de instantáneas, limpieza de metadatos y mantenimiento continuo. Sin ese trabajo, el rendimiento se degrada y los costes de almacenamiento crecen, como se comenta en el análisis de CDO Magazine sobre tablas abiertas e interoperabilidad.
El mismo texto hace otro apunte importante. Los formatos de tabla abiertos mejoran la portabilidad, pero no resuelven automáticamente la fiabilidad ni la observabilidad, sobre todo en entornos cambiantes y con varios motores.
Realidad operativa: los formatos de tabla abiertos reducen el caos de archivos. No eliminan la necesidad de disciplina de plataforma.
También hay una trampa de gobierno. Los equipos celebran a menudo que el formato de tabla sea abierto, mientras dejan el catálogo, las políticas de acceso, las reglas de enmascarado y el comportamiento de auditoría bajo el control de un proveedor. Comentarios recientes sostienen que, si esas capas siguen controladas por el proveedor, la arquitectura no es del todo abierta en la práctica, aunque los archivos y el formato lo sean, como explora la perspectiva de Onehouse sobre formatos de tabla abiertos y arquitectura lakehouse abierta.
Implementación práctica y consideraciones de migración
Las decisiones de migración van mejor cuando las tomas en el orden en que las afrontan los equipos de operación.
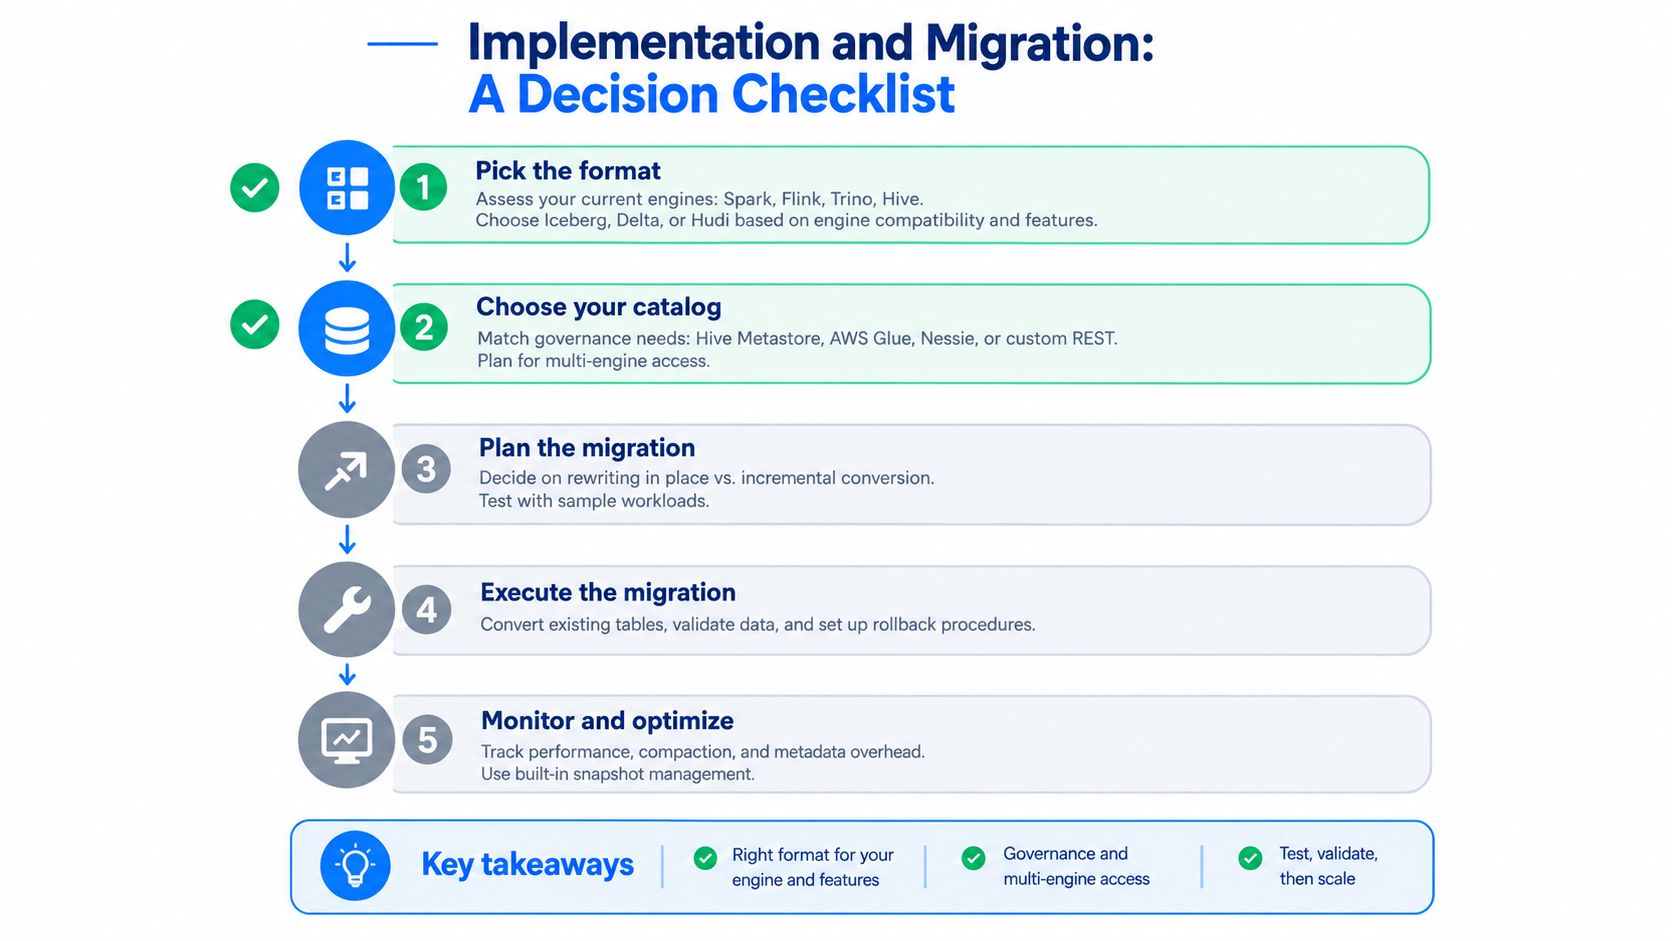
Empieza por los motores que ya ejecutas
Si domina Spark y tu equipo ya depende de flujos nativos de Delta, Delta puede ser la vía menos disruptiva.
Si tu entorno es multi-motor, Iceberg suele encajar más limpiamente con el modelo operativo.
Si tu requisito más duro son los upserts frecuentes desde CDC y streaming, Hudi merece una evaluación seria.
Elige el catálogo como si fuera infraestructura
Muchos equipos tratan el catálogo como un detalle de implementación. No lo es. Pasa a formar parte de tu plano de control.
Usa un catálogo sencillo si la prioridad es la simplicidad. Usa un catálogo integrado en la nube o gobernado por la plataforma si importan más la seguridad, el linaje y la política centralizada. Si esperas varios motores en varias nubes, elige una estrategia de catálogo que no atrape el gobierno en un solo runtime.
La migración suele ser menos lucida que el anuncio
Los patrones de migración habituales incluyen:
Reescribir en tablas nuevas: semántica más limpia, mayor movimiento inicial
Escritura dual durante un tiempo: corte más seguro, más complejidad temporal
Clonar o convertir cuando sea posible: más rápido, pero valida bien los supuestos
Despliegue por dominios en fases: mejor para estados grandes con cargas distintas
El riesgo silencioso no suele ser la conversión de archivos en sí. Es olvidar montar el mantenimiento desde el primer día.
Necesitas trabajos o servicios gestionados para compactación, retención y limpieza antes de que la primera tabla importante entre en producción. Si te lo saltas, la plataforma empieza a derivar de inmediato.
Una opción por defecto práctica
Una opción por defecto razonable es simple:
Elige Iceberg para SQL multi-motor y diseño lakehouse orientado al gobierno.
Elige Delta Lake si tu plataforma se apoya mucho en Databricks y Spark.
Elige Hudi cuando la ruta de escritura esté dominada por CDC, upserts y patrones de corrección en streaming.
Y si estás instrumentando la salud de las tablas desde el primer día, una opción es digna, que se ejecuta en el entorno del cliente y monitoriza cambios de esquema, Timeliness, anomalías y validación de registros en lagos, almacenes y pipelines.
Qué significan los formatos de tabla abiertos para la observabilidad
Los formatos de tabla abiertos no solo mejoran la semántica de almacenamiento. También exponen una superficie de metadatos que las herramientas de observabilidad pueden leer directamente.
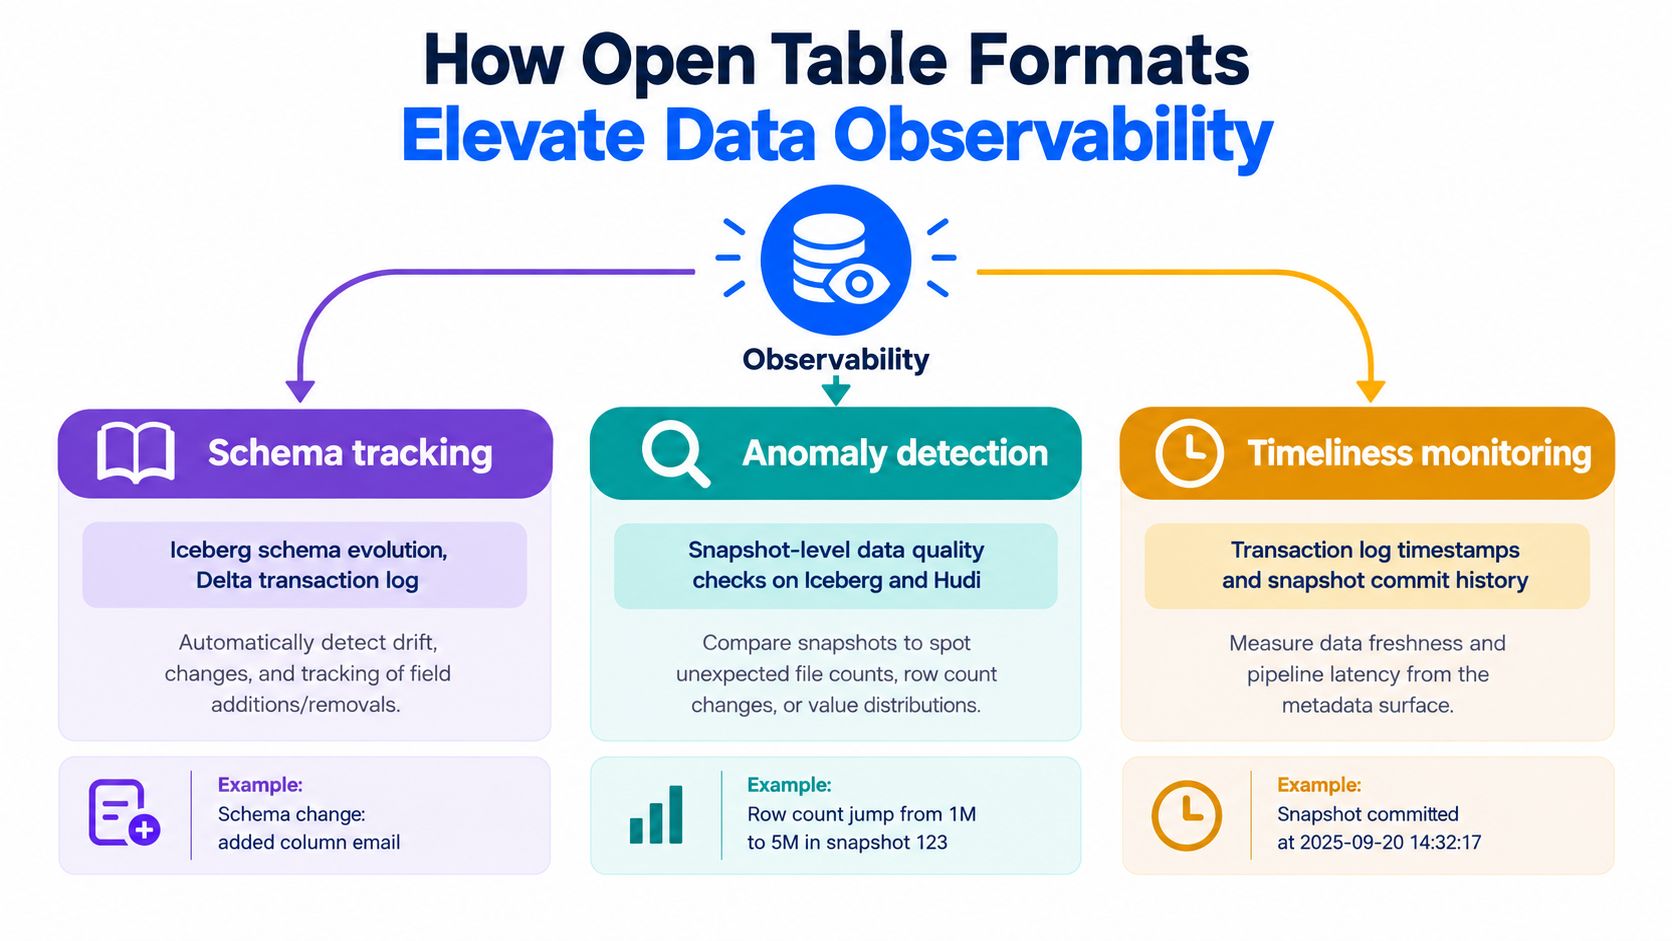
Los metadatos se vuelven telemetría
Las instantáneas de Iceberg, los registros de transacciones de Delta y los metadatos de commit de Hudi crean evidencia legible por máquina de los cambios de tabla. Eso importa porque muchas comprobaciones de calidad y fiabilidad no necesitan escanear conjuntos completos primero.
Una plataforma puede inspeccionar el historial de commits y preguntar:
¿Llegó un cambio de esquema inesperado?
¿La partición de hoy aterrizó más tarde de lo habitual?
¿Una escritura publicó muchos menos archivos de los que la pipeline suele producir?
¿La tabla dejó de avanzar aunque los trabajos anteriores se ejecutaran?
La observabilidad se acerca a la ruta de escritura
Eso cambia el modelo operativo de la monitorización. En lugar de depender solo de fallos de consulta posteriores o de quejas sobre paneles, los equipos pueden detectar problemas en el punto donde cambia el estado de la tabla.
Cuando los metadatos te dicen que la tabla cambió, la observabilidad puede probar ese cambio antes de que los usuarios descubran la rotura.
Esta es una razón por la que los formatos de tabla abiertos importan más allá del almacenamiento y la velocidad de consulta. Crean una superficie de control compartida que motores, sistemas de gobierno y herramientas de observabilidad pueden leer.
La advertencia es importante. Los metadatos ayudan a exponer señales. No las interpretan por ti. Los equipos siguen necesitando reglas, líneas base y flujos de incidencias que conecten el cambio de tabla con el impacto de negocio.
Cómo seguir desde aquí
Un formato de tabla abierto no es la meta. Es el cimiento de un lakehouse mejor educado.
Antes de dar la arquitectura por lista para producción, verifica unas cuantas cosas:
Resiliencia del catálogo: asegúrate de que el catálogo tiene disponibilidad suficiente para formar parte de tu plano de control.
Trabajos de mantenimiento: confirma que compactación, expiración de instantáneas y limpieza de metadatos están programados desde el primer día.
Política de retención: alinea el historial de viaje en el tiempo con las necesidades de cumplimiento y reversión.
Comportamiento de los motores: comprueba que los motores leen metadatos de tabla en vez de apoyarse en atajos de listado de directorios.
Cableado de observabilidad: monitoriza señales de commit e instantánea, no solo resultados de consulta.
Si estás evaluando Iceberg sobre un lago existente, empieza por una tabla que ya sufra deriva de esquema o acceso multi-motor.
Si estás incorporando Delta en una tienda muy centrada en Spark, empieza donde la seguridad transaccional pese más que los debates de portabilidad.
Si estás probando Hudi para cargas intensivas en CDC, elige una tabla donde los upserts y el consumo incremental ya sean la fuente del dolor operativo.
La pregunta útil no es solo qué es un formato de tabla abierto. Es si tu equipo está listo para operar la arquitectura de metadatos que llega con él.
digna ofrece a los equipos de datos una plataforma de calidad y observabilidad dentro de su entorno, lo que encaja de forma natural con los formatos de tabla abiertos porque gran parte de la señal útil vive en commits, cambios de esquema y metadatos de frescura. Si estás convirtiendo archivos crudos del lago en tablas gobernadas y orientadas a producción, visita digna para ver cómo monitoriza deriva de esquema, Timeliness, anomalías y validación sin sacar tus datos de tu entorno.
La capa de metadatos facilita el trabajo del planificador de consultas; hacer que esos mismos metadatos respondan preguntas operativas es lo que añade la observabilidad de plataforma de datos.
Preguntas frecuentes
¿Qué almacena realmente la capa de metadatos?
El esquema y su historial, la lista de archivos de datos que componen cada versión de la tabla, las definiciones de partición y estadísticas por archivo como rangos de valores y recuentos de nulos. Esto último es lo que permite a un planificador descartar archivos antes siquiera de abrirlos.
¿Cómo llega una consulta a los datos?
El motor pide al catálogo el puntero de metadatos vigente, lee el manifiesto para obtener la lista de archivos con estadísticas, descarta los archivos cuyas estadísticas no pueden satisfacer el filtro y solo entonces abre los archivos Parquet restantes. La mayor parte de la velocidad viene de los archivos que nunca abre.
¿Mejora un formato de tabla abierto la calidad de los datos?
Mejora la consistencia, no la corrección. El formato garantiza que cada motor vea la misma versión confirmada de la tabla con el mismo esquema; no afirma nada sobre si los valores son exactos, completos o frescos. Esas siguen siendo comprobaciones aparte, superpuestas al formato.
¿Qué se puede observar desde los metadatos de tabla?
La frecuencia de commits muestra si las cargas llegan a tiempo, las diferencias entre instantáneas muestran qué archivos tocó un cambio, y el historial de esquema muestra cuándo se movió el tipo de una columna. Estas señales detectan una clase de problema antes que las pruebas a nivel de fila, porque afloran antes de que nadie consulte los datos.
¿Tiene coste adoptarlo?
Sí, aunque es operativo y no de licencia. Heredas la expiración de instantáneas, la compactación de archivos y la disponibilidad del catálogo como cosas que hay que mantener, y la planificación de consultas gana un viaje extra a los metadatos. Para conjuntos pequeños y que cambian poco, Parquet simple con una disposición estable puede seguir siendo la respuesta correcta.



