¿Qué es la simulación de Montecarlo?
|
7
minuto de lectura

Está en una reunión con una fecha límite, un panel de control se tambalea y alguien le pide un número único. El propietario de la plataforma quiere un pronóstico para la latencia de las tuberías, el líder de finanzas necesita una vista de presupuesto para un lanzamiento y el gerente de logística observa con atención el tráfico, el clima y los retrasos en los muelles. Una única estimación parece ordenada, pero oculta la parte que más importa: la dispersión de los resultados plausibles.
La simulación de Montecarlo es el método que convierte esa única suposición en una distribución de futuros. Lo hace reemplazando la certeza con un muestreo aleatorio repetido, permitiendo luego que los resultados muestren lo que es probable, lo que es riesgoso y lo que es simplemente ruido. Es por eso que sigue apareciendo en las finanzas, la ingeniería y los sistemas de datos empresariales que tienen que tomar decisiones bajo incertidumbre.
Índice de contenidos
Una pregunta para la que ya necesita Montecarlo
Por qué esto cambia la conversación
La idea central detrás de la simulación de Montecarlo
Las matemáticas sin la niebla
Cómo se ejecuta realmente una simulación de Montecarlo
Los cuatro pasos en un lenguaje sencillo
Montecarlo frente a la forma cerrada y el análisis de sensibilidad
Una regla de decisión rápida
Dónde aparece la simulación de Montecarlo en el trabajo real
Los cuatro lugares donde se gana su lugar
Compromisos honestos y errores comunes
Los errores que distorsionan silenciosamente los resultados
Una lista de verificación de cuaderno que lo mantiene honesto
De las ideas de Montecarlo a la Data Observability empresarial con digna
Por qué la lente de Montecarlo se adapta a la Observability
Qué puede hacer un equipo primero
Una pregunta para la que ya necesita Montecarlo
A un propietario de equipo de plataforma se le pregunta por la latencia de fin de mes durante una revisión de liderazgo, pero el equipo solo tiene dos semanas de historial ruidoso. Un líder de finanzas tiene que defender si el lanzamiento de un producto se mantiene dentro del presupuesto mientras el gasto en publicidad y los tiempos de entrega de los proveedores siguen cambiando. Un gerente de logística necesita un tiempo de entrega estimado cuando el tráfico, el clima y la disponibilidad del muelle se mueven todos a la vez. En cada caso, una sola suposición suena segura y probablemente sea incorrecta.
La trampa es que la suposición colapsa todo el problema en un solo número. No dice nada sobre con qué frecuencia las cosas se retrasan, qué tan graves se vuelven los casos de retraso o si el resultado es lo suficientemente estable como para confiar en él. Una simulación de Montecarlo reemplaza ese número único con miles de futuros plausibles, todos extraídos de la misma incertidumbre.
Por qué esto cambia la conversación
Una vez que ve una distribución en lugar de una estimación puntual, la pregunta cambia. Deja de preguntar: "¿Cuál es la respuesta?" y comienza a preguntar: "¿Qué tan amplia es la banda de riesgo y qué la impulsa?" Esa es una mejor pregunta para presupuestos, cronogramas y SLA operativos.
El método es simple de describir, incluso si el modelado requiere cuidado. Define las entradas inciertas, toma muestras de ellas muchas veces, calcula el resultado cada vez y resume la dispersión. Si desea una introducción relacionada sobre cómo las distribuciones de datos sin procesar alimentan ese pensamiento, la distribución de datos importa antes de que cualquier simulación sea confiable.
Un modelo de Montecarlo no promete certeza. Le brinda una imagen más honesta de la incertidumbre que ya tiene.
La idea central detrás de la simulación de Montecarlo
Un buen modelo mental comienza con un blanco de dardos. Deje caer puntos aleatorios en un cuadrado, cuente cuántos caen dentro del círculo y use esa proporción para estimar π. Ese es el corazón del pensamiento de Montecarlo, los ensayos aleatorios repetidos pueden revelar algo difícil de calcular directamente. La historia temprana del método incluye ideas precursoras como la aguja de Buffon del siglo XVIII, luego el uso sistemático en el siglo XX para problemas difíciles de integración e incertidumbre PMC review.
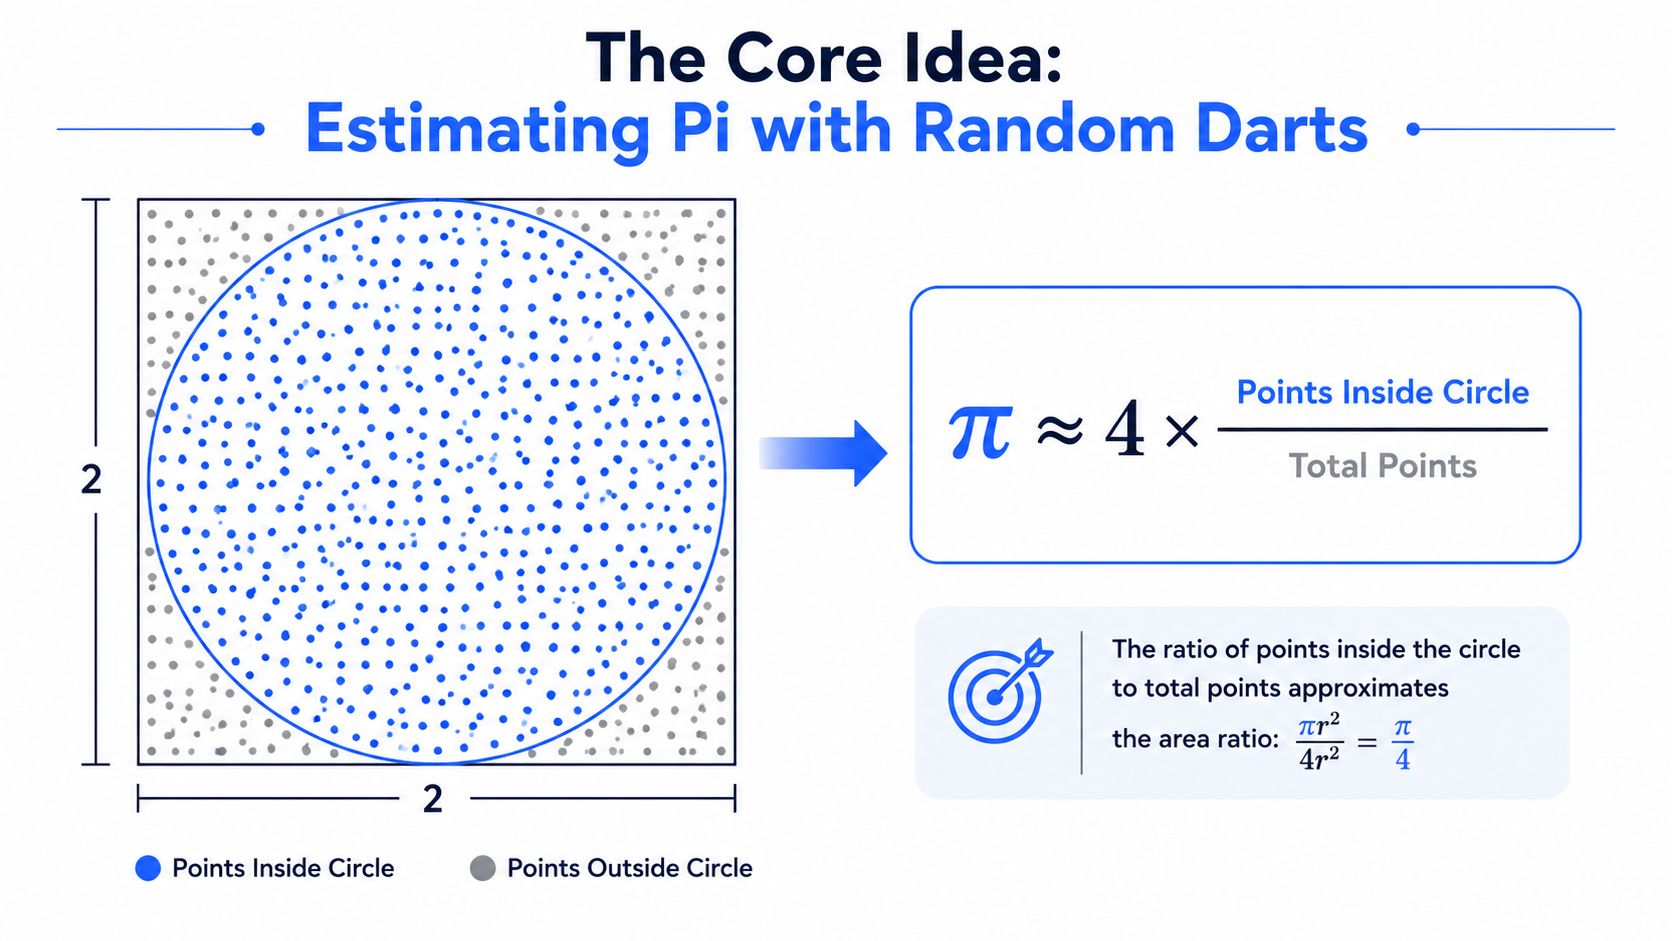
A nivel técnico moderno, la simulación de Montecarlo significa estimar una expectativa, escrita claramente como E[f(X)], extrayendo muchas muestras aleatorias de las entradas inciertas X, evaluando la función f cada vez y promediando los resultados. Esa es la misma idea central que se utiliza en las finanzas, la ingeniería, el análisis de confiabilidad y las ciencias físicas y sociales, donde la computadora ejecuta miles o millones de pruebas para estudiar la variabilidad PMC review.
Las matemáticas sin la niebla
No necesita una fórmula de forma cerrada para todo el sistema. Solo necesita dos cosas, una forma de muestrear las entradas y una forma de calcular la salida para cada prueba. Es por eso que Montecarlo es tan útil para modelos no lineales y sistemas complejos del mundo real, el método no depende de un álgebra elegante para funcionar.
La Ley de los Grandes Números dice que el promedio de los resultados simulados se mueve hacia la expectativa real a medida que crece el tamaño de la muestra. El Teorema del Límite Central ofrece la razón práctica por la que esto se siente estable, el error estándar se reduce aproximadamente con la raíz cuadrada del tamaño de la muestra. Las notas de clase de finanzas del MIT hacen que la escala sea clara, el error de estimación directa tiende a caer a aproximadamente σ/√n, por lo que la precisión mejora lentamente a medida que agrega más ejecuciones MIT OCW.
Regla práctica: si su problema se puede muestrear y evaluar, Montecarlo generalmente puede estimarlo, incluso cuando el álgebra exacta se vuelve incómoda o imposible.
Esa generalidad es el punto. El método existe porque muchos sistemas reales se niegan a colapsar en una fórmula limpia.
Cómo se ejecuta realmente una simulación de Montecarlo
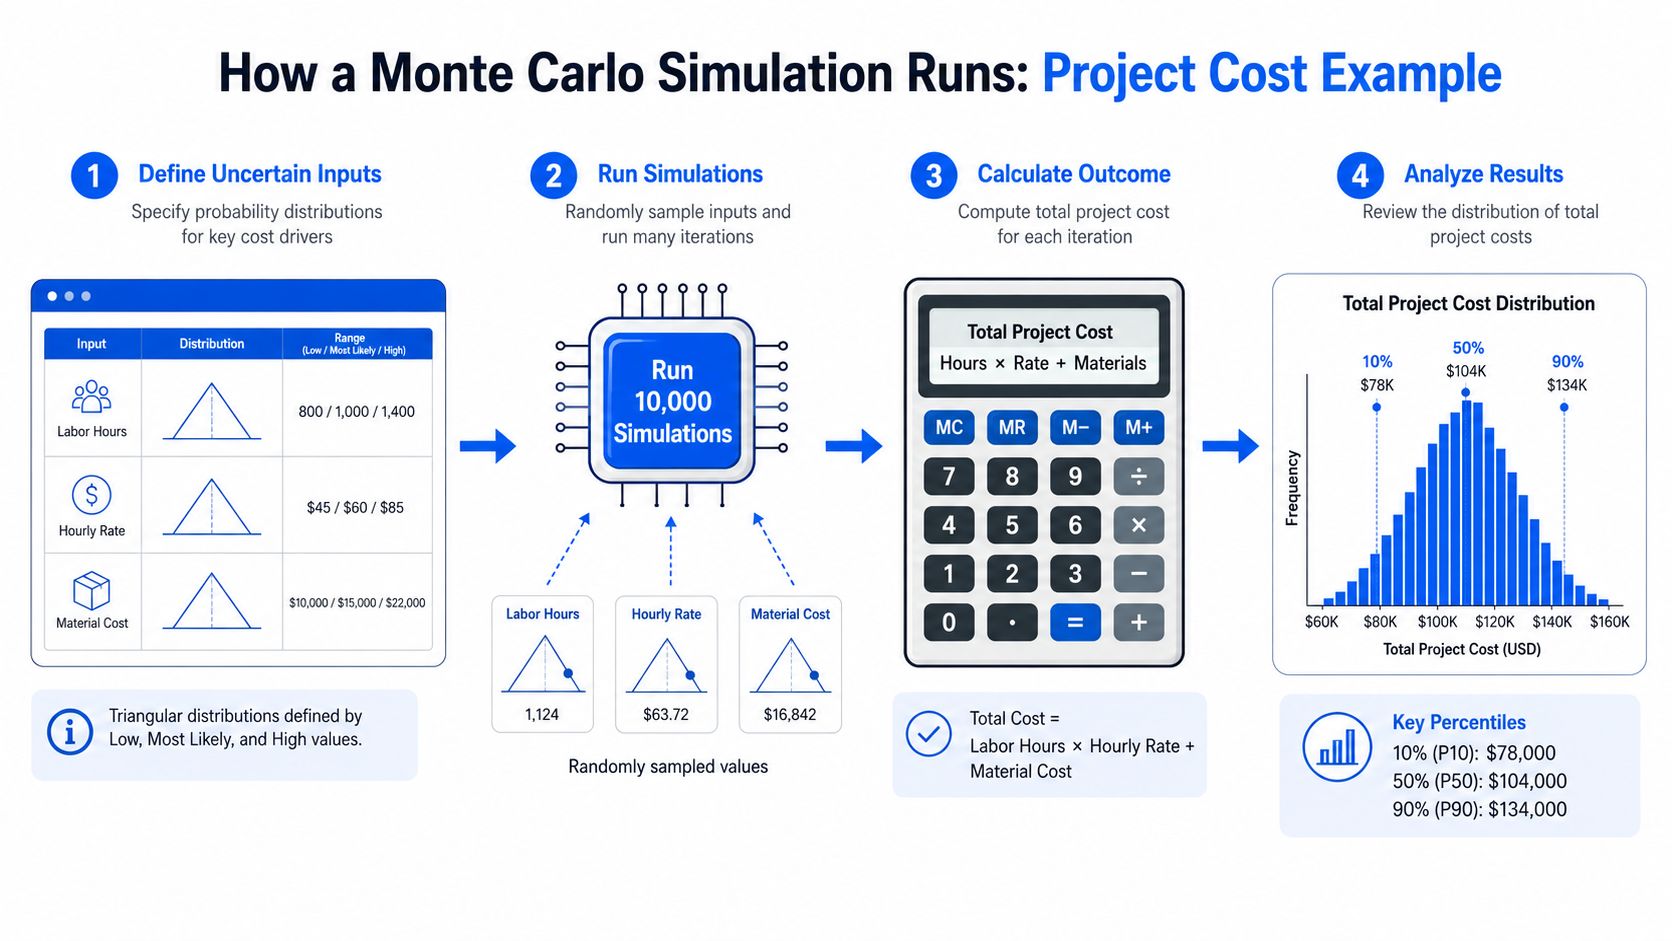
Un ejemplo práctico hace que el bucle sea más fácil de ver. Suponga que está estimando el costo total del proyecto y las piezas inciertas son las horas de mano de obra, la tarifa por hora y el costo de los materiales. No conoce una de esas entradas con exactitud, por lo que describe cada una como una distribución de probabilidad en lugar de un valor fijo, a menudo utilizando datos históricos, juicio de expertos o ambos.
Los cuatro pasos en un lenguaje sencillo
Primero, defina las entradas y elija las distribuciones que coincidan con ellas. Una distribución triangular es común en el trabajo de proyectos porque la gente a menudo conoce una estimación baja, probable y alta, incluso si no conocen una curva medida a la perfección.
Segundo, tome una muestra de cada distribución de entrada para construir un solo escenario. Ese único escenario se convierte en un mundo posible, y usted calcula la salida, aquí el costo total.
Tercero, repita el ciclo de extraer y evaluar muchas veces. Las fuentes modernas de enseñanza e investigación describen esto como un método experimental impulsado por computadora que puede generar miles o millones de ensayos aleatorios para estudiar distribuciones y riesgos PMC review.
Cuarto, resuma la lista de salidas como su propia distribución. Puede mirar la media, la mediana, el histograma y los percentiles que importan para una decisión, porque estos le dicen cómo se comporta el costo en todo el rango de resultados plausibles.
Hábito operativo: observe la media acumulada mientras se ejecuta la simulación. Si sigue moviéndose, probablemente no haya ejecutado suficientes ensayos para que la estimación se estabilice.
Un simple bosquejo de pseudocódigo se ve así:
Una versión mínima de Python es igual de directa:
Para una mirada más profunda sobre cómo se configuran las suposiciones de datos antes de que se ejecute un modelo, la página de métodos estadísticos para el análisis de datos es una compañera útil. La pregunta clave de implementación es la convergencia: cuando más muestras dejan de cambiar la respuesta de manera material, generalmente ha alcanzado un punto de parada utilizable.
Montecarlo frente a la forma cerrada y el análisis de sensibilidad
Un modelo de costo de proyecto se puede abordar de tres maneras diferentes, y cada una responde a una pregunta diferente. Las matemáticas de forma cerrada brindan una solución directa cuando las fórmulas son tratables. El análisis de sensibilidad perturba una variable a la vez para ver qué suposición impulsa el resultado. La simulación de Montecarlo ejecuta muchos escenarios completos y devuelve la dispersión de los resultados, incluida la posibilidad de un sobrecosto presupuestario.
Dimensión | Matemáticas de forma cerrada | Análisis de sensibilidad | Simulación de Montecarlo |
|---|---|---|---|
Pregunta principal | ¿Cuál es la respuesta exacta? | ¿Qué entrada importa más? | ¿Qué resultados son plausibles y con qué frecuencia? |
Entradas | Fórmulas fijas, a menudo exactas | Una variable cambia a la vez | Muchas entradas inciertas varían juntas |
Salida | Número único o expresión exacta | Influencia clasificada o dirección del cambio | Distribución completa de resultados |
Mejor uso | Modelos lineales y tratables | Aislar factores impulsores | Riesgo, comportamiento de cola, incertidumbre interactiva |
Punto débil | Se descompone cuando las matemáticas se complican | Omite las interacciones | Necesita muestreo, validación y cómputo |
Las matemáticas de forma cerrada son eficientes cuando el modelo es lo suficientemente simple. El análisis de sensibilidad es útil cuando necesita saber qué suposición corregir primero. Montecarlo es la herramienta adecuada cuando la incertidumbre proviene de muchas entradas que interactúan, las correlaciones importan o el modelo no es lineal.
Una forma limpia de pensar en ello es la compensación entre sesgo y varianza. Un atajo determinista puede ser ordenado pero engañoso, mientras que una simulación más rica puede capturar más de la realidad si las entradas son sólidas.
Una regla de decisión rápida
Si solo necesita una dirección aproximada, el análisis de sensibilidad puede ser suficiente. Si el modelo tiene una forma cerrada y las entradas son estables, use las matemáticas exactas. Si el resultado depende de muchos factores inciertos y la decisión depende de la cola, Montecarlo se gana su cómputo.
Para los equipos que crean flujos de trabajo de datos, se aplica la misma lógica a la revisión de anomalías. La página de métodos de identificación de valores atípicos es relevante cuando un solo punto defectuoso puede engañar a un modelo que de otro modo sería saludable.
Dónde aparece la simulación de Montecarlo en el trabajo real
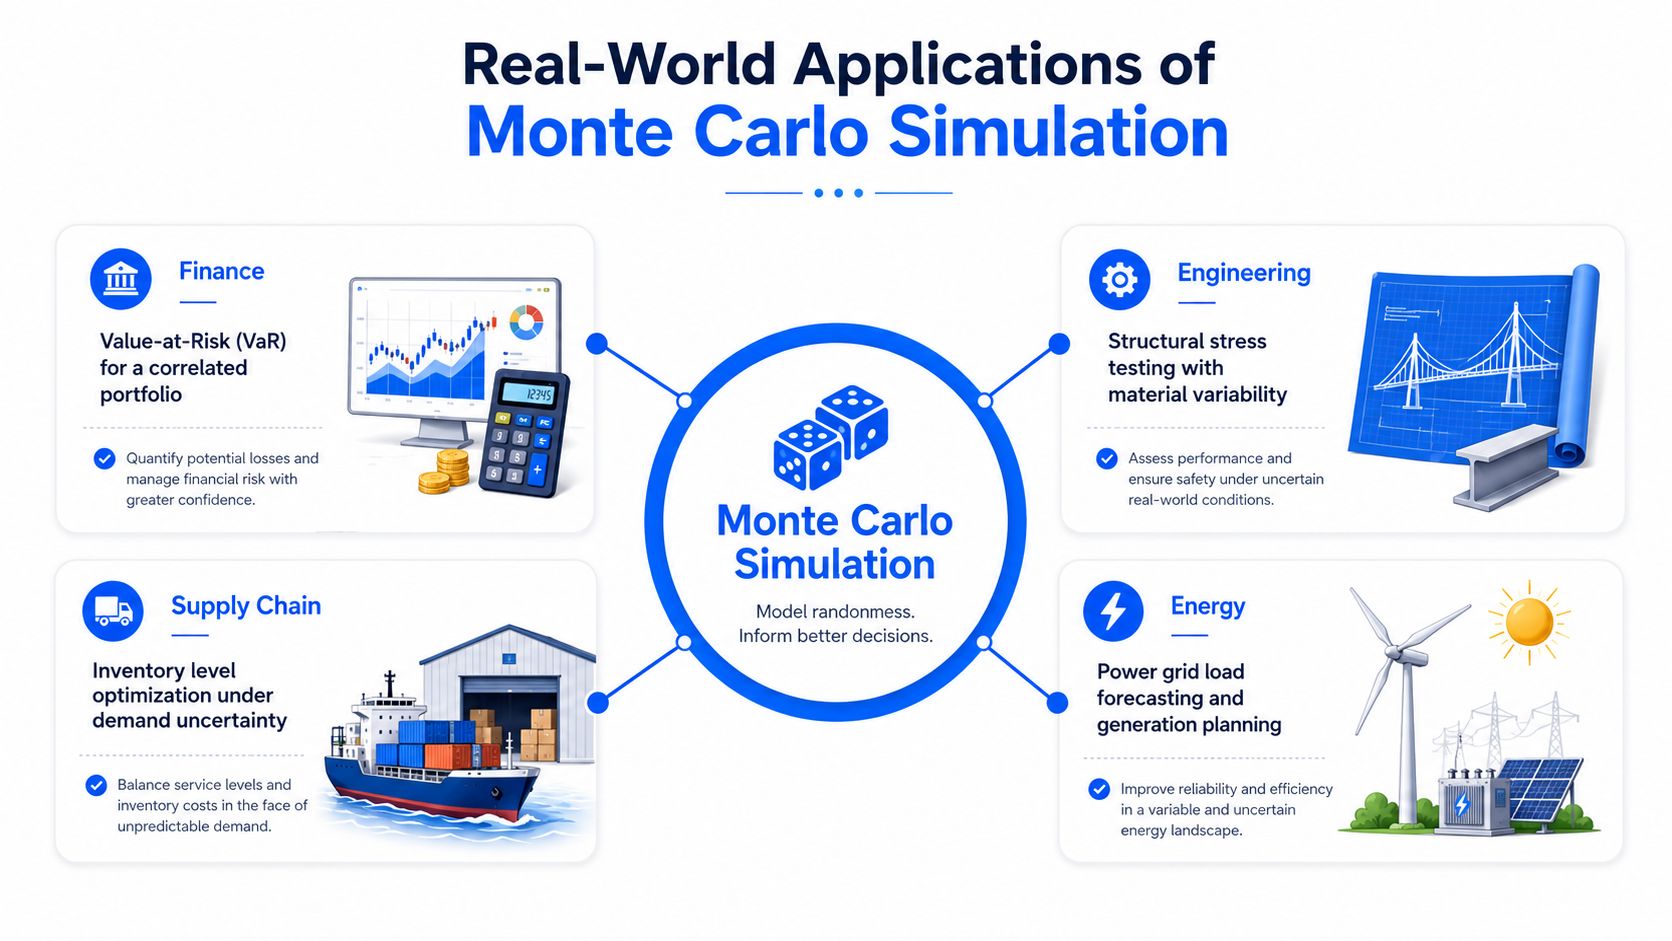
Los casos de uso más sólidos comparten todos la misma forma, la decisión depende de la cola, no solo de la media. En finanzas, Montecarlo respalda el Value-at-Risk en carteras de activos correlacionados, porque el comportamiento conjunto de esos activos impulsa la caída. En ingeniería, ayuda con el análisis de confiabilidad cuando diferentes componentes fallan a diferentes tasas, por lo que la vista del sistema importa más que cualquier parte individual.
Los cuatro lugares donde se gana su lugar
En la planificación de la Timeliness, un modelo de Montecarlo puede estimar la probabilidad de violar un SLA cuando cada etapa en la tubería tiene fluctuación. Eso es más útil que un único tiempo de llegada estimado, porque los operadores necesitan saber qué tan probables son los casos desfavorables.
En la Data Observability, la misma idea aparece en la detección de anomalías. Una plataforma puede tratar las señales de frescura, volumen y esquema como entradas inciertas, muestrear estados de métricas plausibles y estimar si una alerta refleja un incidente real o simplemente ruido. Eso se adapta de forma natural al trabajo de anomalías al estilo de Montecarlo de digna, y la página de detección de Data Anomalies en su plataforma de datos con simulaciones de Montecarlo se ajusta a ese caso de uso.
En la planificación de la cadena de suministro y la energía, el patrón se repite. La incertidumbre de la demanda, el riesgo de inventario y el pronóstico de carga se vuelven más fáciles de razonar una vez que el modelo devuelve un rango de resultados probables en lugar de un único pronóstico optimista.
Si la decisión cambia cuando la cola cambia, una estimación puntual suele ser demasiado frágil para confiar en ella.
También hay una lección importante sobre sistemas aquí. Montecarlo no es solo para científicos o analistas cuantitativos financieros. Cualquier equipo que tenga que responder: "¿Qué sucede cuando varias cosas inciertas se mueven juntas?" ya está en territorio de Montecarlo.
Compromisos honestos y errores comunes
Montecarlo es potente, pero no es magia. La limitación más importante es la escala lenta del error, el error de estimación directa cae con σ/√n, por lo que reducir el error a la mitad cuesta mucho más cómputo de lo que la gente espera MIT OCW. Es por eso que los métodos de reducción de varianza importan, reducen la varianza del estimador sin cambiar su valor esperado, lo que le brinda un intervalo más ajustado para el mismo presupuesto de CPU Frontiers in Physics.
Los errores que distorsionan silenciosamente los resultados
La primera trampa es la calidad de la entrada. Si las distribuciones no reflejan la realidad, la simulación solo produce una respuesta incorrecta más pulida. Una cola gaussiana puede parecer tranquilizadora en un modelo de riesgo mientras que el mundo real tiene colas mucho más pesadas.
La segunda trampa es la ceguera de la correlación. Los principiantes a menudo toman muestras de las entradas de forma independiente porque es más fácil, luego obtienen resultados que son demasiado suaves y demasiado favorables. Ese error es especialmente costoso en el trabajo de cartera, modelos de confiabilidad y cualquier sistema donde los factores compartidos se mueven juntos.
La tercera trampa es la convergencia que solo se ve bien a simple vista. Una media acumulada que se estabiliza visualmente aún puede ocultar inestabilidad en la cola, por lo que necesita una regla de parada, no solo una corazonada.
La cuarta trampa es la varianza silenciosa de eventos raros. Si el evento que le importa ocurre con poca frecuencia, muy pocas ejecuciones pueden pasarlo por alto por completo, lo que hace que el resultado parezca más seguro de lo que es. Montecarlo puede subestimar los extremos cuando las distribuciones elegidas son demasiado moderadas, especialmente en finanzas y contextos de riesgo sistémico Analytica on Monte Carlo in finance.
Una lista de verificación de cuaderno que lo mantiene honesto
Valide cada entrada con datos históricos o juicio de dominio antes de simular.
Incluya correlación donde los factores compartidos se mueven juntos.
Elija una regla de parada basada en la estabilidad del resultado, no solo en un recuento de ejecuciones arbitrario.
Informe una banda de confianza, no solo una única respuesta.
Trate el modelo como un conjunto de suposiciones entre varios, no como una verdad final.
La guía de estrategias de migración de ETL es un recordatorio útil de que los sistemas de datos posteriores también dependen de la calidad de las suposiciones. Si la forma ascendente es incorrecta, la respuesta descendente es ruidosa, sin importar cuán elegante se vea el cálculo.
De las ideas de Montecarlo a la Data Observability empresarial con digna
In enterprise observability, el enfoque de Montecarlo se muestra como aprendizaje de referencia y alertas probabilísticas. digna observa tablas, tuberías, patrones de frescura y métricas comerciales dentro del propio entorno del cliente, luego aprende cómo es el comportamiento normal sin obligar a los equipos a codificar reglas rígidas y frágiles. Eso importa porque los datos no solo llegan, sino que llegan con variación, estacionalidad y fallas ocasionales.
Por qué la lente de Montecarlo se adapta a la Observability
El paso útil es tratar la frescura esperada, el recuento de filas y las tasas de nulos como distribuciones, no como umbrales fijos. Una vez que una plataforma aprende esa línea de base, puede comparar los valores en vivo con el rango aprendido y estimar si el estado actual es inusual. Esa es la misma lógica que usa Montecarlo en otros dominios, muestreo repetido para comprender la dispersión de resultados plausibles.
El ciclo práctico es fácil de seguir. digna aprende una línea de base de frescura a partir del comportamiento histórico de llegada, toma muestras de los estados de retraso esperados de esa distribución aprendida y luego califica la observación actual contra esos estados para decidir si la latencia parece anómala. El resultado es una señal orientada a la confianza, no solo una alarma de sí o no.
Ese enfoque se adapta de forma natural al trabajo de migración y cambio de tuberías. Si un equipo está moviendo flujos de datos o reelaborando fuentes, la guía de estrategias de migración de ETL brinda el contexto operativo circundante, mientras que la Observability de estilo Montecarlo ayuda a juzgar si el nuevo comportamiento se está desviando.
Qué puede hacer un equipo primero
Active el aprendizaje de referencia para paneles de control y tuberías críticos, de modo que el sistema conozca el comportamiento normal antes de marcar excepciones.
Compare las distribuciones observadas con alertas de umbral estático, porque los umbrales por sí solos omiten la variación.
Use bandas de confianza para clasificar la investigación de guardia, de modo que las señales más ruidosas no dominen la cola.
Para los equipos que desean un solo lugar para conectar esas ideas, la página sobre la alternativa de datos de Montecarlo para la Data Observability empresarial muestra cómo este patrón se asigna al monitoreo operativo.
El punto más amplio es simple. El pensamiento de Montecarlo le ayuda a formular una mejor pregunta: "¿Qué tan probable es que este estado sea real?" En la Observability, esa pregunta a menudo importa más que si una métrica cruzó una línea fija.
Si está intentando tomar decisiones de confiabilidad de datos con menos conjeturas, visite digna y vea cómo el aprendizaje de referencia, el monitoreo de la Timeliness y la detección de Data Anomalies funcionan juntos en la misma plataforma de Observability. Es una forma práctica de aplicar el pensamiento de incertidumbre al estilo de Montecarlo a tuberías, paneles de control y métricas comerciales que no pueden permitirse alertas ruidosas.
Preguntas frecuentes
¿Qué es una simulación de Monte Carlo?
Estimar una esperanza, escrita sin más como E[f(X)], tomando muchas muestras aleatorias de las entradas inciertas X, evaluando la función f cada vez y promediando los resultados. En la práctica sustituye una conjetura por miles de futuros plausibles extraídos de la misma incertidumbre.
¿Por qué una distribución supera a un valor puntual?
Porque cambia la pregunta que se hace. Al ver una distribución en lugar de un número, uno deja de preguntar «¿cuál es la respuesta?» y empieza a preguntar «¿cómo de ancha es la banda de riesgo y qué la impulsa?», que es mejor pregunta para presupuestos, plazos y SLA operativos.
¿Por qué funciona el muestreo aleatorio repetido?
Por la ley de los grandes números: la media de los resultados simulados se acerca a la esperanza verdadera a medida que crece el tamaño muestral. Por eso una diana lanzada suficientes veces revela un área que sería incómodo calcular directamente.
¿Cuándo es Monte Carlo mejor que una fórmula cerrada?
Cuando el sistema se resiste al álgebra elegante. No hace falta una solución cerrada para todo el sistema, y justo por eso el método encaja con modelos no lineales y con el comportamiento desordenado del mundo real. Si un problema puede muestrearse y evaluarse, Monte Carlo suele poder estimarlo.
¿Da certeza Monte Carlo?
No, y tratarlo así es la trampa principal. Un modelo de Monte Carlo no promete certeza: cuantifica la incertidumbre bajo los supuestos que usted aportó, así que la salida honesta es una banda de riesgo con sus impulsores nombrados, no una cifra única y confiada.