Qué es la gestión de la calidad de los datos: una guía práctica para 2026
|
9
minuto de lectura

La gestión de la calidad de los datos es la práctica continua de medir, monitorear y mejorar la adecuación de los datos a lo largo de su ciclo de vida, utilizando dimensiones como la precisión, la completitud, la Timeliness, la consistencia, la validez y la unicidad. En una encuesta sectorial de 2024 resumida por Precisely, solo alrededor del 25% de las empresas miden y comunican de manera constante las métricas de calidad de los datos, y la puntuación media de madurez fue de 56 sobre 100, lo que sitúa a la organización típica en la etapa 3, Establecida, de 5. Resumen de tendencias de gestión de calidad de datos de 2024 de Precisely
Esa brecha es fácil de reconocer si alguna vez ha visto a un equipo de finanzas confiar en un panel de ingresos que era incorrecto. Un esquema de staging elimina una columna, los reembolsos se duplican en el conteo, la junta directiva recibe una cifra errónea, se daña la relación con un proveedor y se pierden tres días en conciliaciones. El problema no fue la falta de esfuerzo de limpieza. Fue la ausencia de un sistema de control vivo.
Tabla de contenidos
Cómo la gestión de la calidad de los datos se convirtió en una disciplina
El ciclo de vida de la calidad de los datos desde el origen hasta el consumidor
La gestión de la calidad de los datos se une a la Observability
Implementación de la gestión de la calidad de los datos en la práctica
Preguntas frecuentes sobre la gestión de la calidad de los datos
Una definición de trabajo que puede utilizar hoy mismo
Un equipo de datos puede quedarse mirando un panel limpio y aun así no entender lo esencial. La gestión de la calidad de los datos es el modelo operativo que mantiene los datos aptos para su uso desde el origen hasta el consumidor. Detecta los defectos a tiempo, los mide de la misma manera cada vez y soluciona la causa raíz en lugar de pulir un conjunto de datos roto después de que el daño se haya extendido.
Una definición práctica es directa: la gestión de la calidad de los datos es prevención, detección y remediación a lo largo del ciclo de vida de los datos. Cuando un equipo de plataforma solo limpia registros después de que los analistas se quejan, está haciendo mantenimiento. Cuando añade reglas, comprobaciones de frescura, propiedad y alertas en las tuberías de producción, está gestionando la calidad.
El modo de fallo cambia con la tubería. Un trabajo de atribución de marketing puede experimentar una desviación de esquema, mapear el campo incorrecto y enviar el gasto al modelo de canal equivocado. Un modelo de recuento de suscripciones puede permitir que claves duplicadas inflen los usuarios activos y empujen a los equipos de producto y finanzas a un debate sobre qué cifra es la real. Ambos casos representan el mismo tipo de problema: faltaban controles de calidad en el punto donde se movían los datos.
Regla práctica: si un problema de datos solo se puede solucionar a mano después de que los consumidores lo noten, el proceso de calidad llega demasiado tarde.
Para una referencia concisa sobre esta misma visión operativa, la descripción general de la calidad de los datos de digna enmarca el tema con claridad. El resto de esta guía convierte esa definición en controles que puede ejecutar en producción.
Cómo la gestión de la calidad de los datos se convirtió en una disciplina
La calidad de los datos solía tratarse como un trabajo de limpieza, algo que se hacía después de que un informe pareciera sospechoso. Ese modelo se desmorona cuando las tuberías se multiplican, los productos de datos cruzan los límites de los equipos y cada solución manual añade más retraso que el propio problema. La respuesta de la industria ha sido un cambio hacia la gobernanza, la medición repetible y la rendición de cuentas, porque el costo de esperar sigue aumentando.
El argumento económico para ese cambio es antiguo pero sigue siendo persuasivo. MIT Sloan Management Review reportó estimaciones de que los datos de mala calidad pueden consumir entre el 15% y el 25% de los ingresos de la mayoría de las empresas, y una síntesis citada por el artículo situó la pérdida anual de la economía estadounidense en $3.1 billones. Las directrices anteriores también utilizaban la ya familiar escala de costos de $1 para prevenir un problema de registro, $10 para corregirlo después de que ingresa a un sistema y $100 para subsanarlo después de que causa un evento posterior. MIT Sloan Management Review sobre el costo de los datos de mala calidad
Esa lógica convirtió la gestión de calidad de datos de una tarea de limpieza a una disciplina de ciclo de vida. Las directrices gubernamentales y del sector ahora tratan la calidad de los datos como algo que se monitorea a lo largo de la adquisición, almacenamiento, procesamiento, distribución y archivo, con estándares y rendición de cuentas asociados a cada entrega. Cuando un cambio de esquema, un flujo retrasado o una regla rota pueden invalidar paneles e informes regulatorios, la limpieza posterior a la carga no es suficiente.
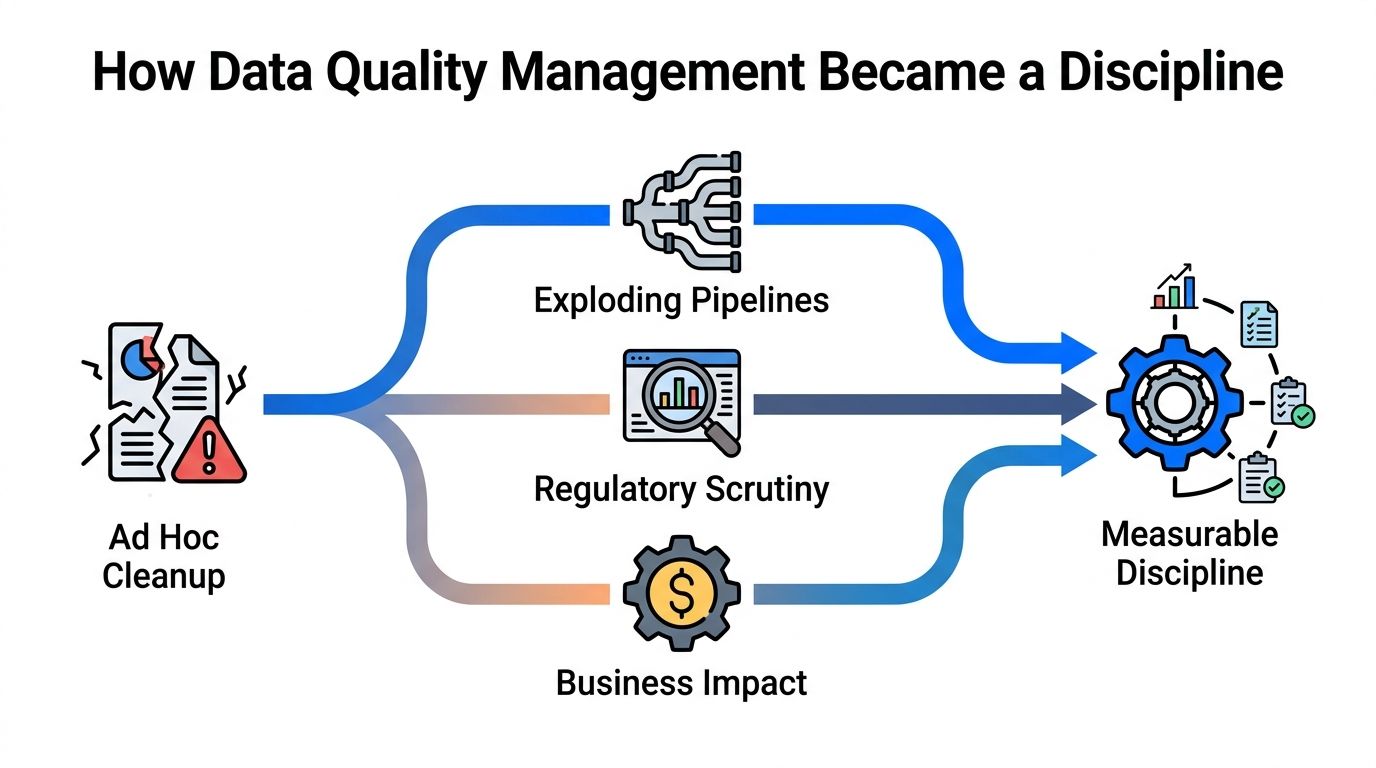
Qué cambió en la práctica
Limpieza reactiva: los equipos solucionan los errores visibles después de que los usuarios se quejan.
Monitoreo gobernado: los equipos definen controles, propiedad y escalamiento antes de que los defectos se extiendan.
Disciplina empresarial: los equipos miden la calidad, la comunican y tratan la desviación como un riesgo operativo.
El salto en la madurez importa porque cambia el lugar donde se realiza el trabajo. En lugar de pedir a los analistas que descubran datos erróneos, los programas sólidos hacen que la calidad sea visible cerca de la tubería, donde la solución es más barata y el radio de impacto es menor.
Las seis dimensiones que definen la calidad de los datos
Las seis dimensiones son útiles porque se asocian a diferentes modos de fallo. Un conjunto de datos puede ser preciso y aun así llegar demasiado tarde, o completo pero inconsistente con un sistema posterior. Si se trata la calidad como una única puntuación imprecisa, se pasa por alto el defecto real.
Dimensión | Ejemplo de modo de fallo | Comprobación operativa |
|---|---|---|
Precisión | Un geocodificador de direcciones devuelve la ciudad correcta pero el código postal incorrecto | Conciliar con una fuente de confianza y utilizar validación a nivel de campo |
Completitud | Un campo | Comprobación de campos obligatorios, campos completados divididos por campos obligatorios |
Timeliness | Un flujo diario llega después de la reunión matutina, por lo que técnicamente se cumple el SLA pero es operativamente inútil | Monitoreo de frescura frente a la ventana de entrega esperada |
Consistencia | El mismo ID de cliente se asocia a diferentes registros en el CRM y en facturación | Conciliación entre sistemas y comprobaciones de integridad referencial |
Validez | Un enum de estado acepta un error tipográfico que debería haber sido rechazado | Restricción de esquema o validación basada en reglas frente a valores permitidos |
Unicidad | Las filas duplicadas inflan los recuentos de usuarios activos mensuales | Regla de deduplicación, restricción de unicidad de clave, detección de duplicados |
Cómo leer las dimensiones en producción
La precisión comprueba si un valor refleja la realidad. Si un geocodificador etiqueta la ciudad correcta pero el código postal incorrecto, el problema no es el formato, es un desajuste entre el registro y el objeto del mundo real que describe. Eso generalmente requiere una conciliación con una fuente de verdad, no una transformación más estética.
La completitud se refiere a si los datos necesarios para un caso de uso están presentes. La medida operativa más limpia es simple: campos obligatorios completados divididos por el total de campos obligatorios, lo que aleja la conversación de la intuición y la orienta hacia la cobertura. Un desglose más profundo de las dimensiones de calidad de BatchData es útil si desea comparar definiciones entre equipos, y la guía de dimensiones de digna es una referencia interna muy práctica para los equipos de implementación.
La Timeliness tiene un significado concreto. Las directrices gubernamentales la definen como el tiempo transcurrido entre el final del período al que se refieren los datos y el momento en que están disponibles para satisfacer las necesidades del usuario, y también señalan que los datos son oportunos cuando están disponibles en el momento esperado y necesario. Directrices gubernamentales sobre la calidad de los datos
La validez es la conformidad con las reglas. No es una sensación, es si un registro se ajusta a un formato, tipo o regla de negocio predefinidos. La guía de dimensiones de calidad de datos de Dagster es explícita al respecto, razón por la cual las reglas de validación deben estar cerca de la tubería.
La consistencia y la unicidad es donde aparecen los problemas entre sistemas. Un registro puede superar las comprobaciones locales y aun así no coincidir con facturación, mientras que los duplicados pueden inflar los totales y la confianza al mismo tiempo.
El ciclo de vida de la calidad de los datos desde el origen hasta el consumidor
Un único registro de cliente puede indicarle dónde corresponde realizar el trabajo de calidad. Comienza en una API de SaaS, aterriza en la ingesta, se mueve a través del staging y la transformación, y finalmente se entrega a analistas, aplicaciones y modelos. Cada etapa necesita un control diferente, porque un defecto puede originarse aguas arriba y volverse visible solo aguas abajo.

Dónde deben ubicarse los puntos de control
En el aterrizaje, la validación de esquema detecta cambios de estructura que rompen el sistema antes de que se extiendan. En la ingesta, las comprobaciones de frescura indican si un flujo llegó cuando los usuarios lo esperaban, lo que importa mucho más que una señal genérica de "carga exitosa". En el staging, las auditorías de completitud detectan la falta de valores obligatorios antes de que las transformaciones hagan que las brechas sean más difíciles de rastrear.
En la transformación, la conciliación de precisión compara los datos derivados con la fuente de verdad. Ahí es donde suele aflorar una unión rota, una tabla de referencia obsoleta o una regla de negocio incorrecta. Antes de la entrega, las reglas de consistencia y la aplicación de unicidad evitan que los registros contradictorios o duplicados lleguen a la capa del consumidor.
Los roles de Data Governance se integran en esas entregas en lugar de situarse fuera de ellas. Un administrador de datos es propietario de las definiciones y el contexto de escalamiento, un ingeniero conecta las comprobaciones en la tubería y un analista advierte si los datos entregados son adecuados para la pregunta que se plantea. La descripción general de la tubería de ingesta de datos de digna encaja perfectamente en este patrón porque el ciclo de vida solo funciona cuando los puntos de control están cerca de los datos, no añadidos a posteriori.
La calidad de los datos mejora cuando cada entrega produce una señal, no solo un archivo.
El modelo mental más importante es que el ciclo de vida es circular. Las quejas de los consumidores, las desviaciones en los paneles y los errores de los modelos deben retroalimentar los contratos de origen, no solo una cola de soporte. Si el mismo problema aparece dos veces, el control pertenece a las etapas anteriores.
La gestión de la calidad de los datos se une a la Observability
La gestión de la calidad de los datos y la Observability ya no son conversaciones separadas. Las comprobaciones clásicas de calidad de datos se centran en reglas conocidas, mientras que la Observability vigila el comportamiento en tiempo de ejecución para detectar desviaciones desconocidas, cambios repentinos de esquema, variaciones extrañas en la tasa de nulos y fallos de frescura. La intersección es donde las plataformas modernas marcan la mayor diferencia.
La división útil es sencilla. La validación indica si un registro cumple con una regla de negocio. La Observability indica si el comportamiento del conjunto de datos ha cambiado de una manera que merece atención. Una plataforma que hace ambas cosas puede detectar un código de estado erróneo, una partición retrasada y una variación repentina en el recuento de filas sin obligar a cada equipo a diseñar a mano el mismo conjunto de controles.
Qué monitorear y cómo ejecutarlo
Dimensión | Señal de Observability | Patrón de ejecución |
|---|---|---|
Precisión | Desviación en la conciliación, valores de referencia no coincidentes | Comprobaciones en la base de datos en los límites de la transformación |
Completitud | Pico en la tasa de nulos, falta de columnas obligatorias | Perfilado estadístico en tablas de aterrizaje |
Consistencia | Desajuste entre sistemas, impacto en el linaje | Comprobaciones de reglas vinculadas al linaje dirigidas a los propietarios |
Timeliness | Llegada tardía, falta de carga, entrega anticipada | Monitoreo de frescura frente a cronogramas aprendidos |
Validez | Infracciones de formato, enums inválidos, transgresiones de rango | Validación determinista en el almacén o en la tubería |
Unicidad | Crecimiento de claves duplicadas, registros repetidos | Comprobaciones de deduplicación antes de la entrega |
Una plataforma como el módulo de Data Observability de digna tiene sentido en este modelo porque combina la detección de anomalías, el monitoreo de la frescura, el seguimiento del esquema y la validación en un solo flujo operativo. La elección de la arquitectura también importa. Ejecutar comprobaciones en la base de datos mantiene los datos en su lugar, reduce el movimiento y funciona mejor para cargas de trabajo sensibles a la privacidad que extraer muestras a una herramienta separada.
La contrapartida es real. Las comprobaciones basadas en muestras son más fáciles de iniciar, pero pueden pasar por alto casos límite y crear puntos ciegos en tuberías de alto volumen. La ejecución en la base de datos es mejor cuando importa la frescura, la residencia de los datos o el hecho de no duplicar registros sensibles fuera de los límites del almacén de datos.
Implementación de la gestión de la calidad de los datos en la práctica
Un despliegue de gestión de calidad de datos funciona mejor cuando comienza con un alcance estrecho y se gana la confianza. El primer objetivo deben ser los conjuntos de datos más críticos para los ingresos, aquellos que alimentan los paneles de control de la dirección, la facturación, el riesgo, los informes de clientes o los modelos sobre los que se actúa con rapidez. Una cobertura amplia suena impresionante, pero suele traducirse en alertas ruidosas y una biblioteca de controles a medio terminar.
Un patrón de despliegue que no se estanca
Seleccione primero los conjuntos de datos críticos. Comience donde un defecto perjudicaría al negocio, no donde la tabla sea más fácil de probar.
Asigne dimensiones por conjunto de datos. No aplique todas las comprobaciones en todas partes. Un flujo transaccional puede requerir más atención en la frescura y la unicidad, mientras que un conjunto de datos de referencia puede necesitar reglas de consistencia y validez más estrictas.
Establezca umbrales que sean lo suficientemente llamativos como para importar. Si la alerta no cambia el comportamiento, es solo ruido.
Conecte las comprobaciones en la integración continua (CI) para las transformaciones. Un contrato fallido debería bloquear un cambio perjudicial antes de que llegue a producción.
Utilice un despliegue privado para datos sensibles. Si se aplican reglas de información de identificación personal (PII) o de residencia, el plano de control debe respetar esas restricciones.
Las decisiones de arquitectura que dan resultados
El patrón más sólido consiste en coubicar las comprobaciones con el almacén o el lago de datos (lakehouse) para que las señales de calidad se calculen donde ya residen los datos. Eso mantiene baja la latencia y evita movimientos adicionales. Para las distribuciones que cambian con el tiempo, la detección de anomalías suele funcionar mejor que las reglas estáticas, porque los datos reales no se mantienen estables el tiempo suficiente como para que los umbrales fijos sigan siendo útiles.
El seguimiento del esquema debe situarse junto a ambos controles. Los equipos de origen cambian los nombres de las columnas, los tipos y las estructuras más a menudo de lo que creen, y así es como fallan los trabajos posteriores sin que se produzca un incidente visible en el sistema de origen. El enfoque de implementación de digna se alinea con este patrón porque trata el monitoreo, la validación y la desviación del esquema como un único modelo operativo en lugar de tres herramientas separadas.
El objetivo no es realizar más comprobaciones. Es tener menos sorpresas con una propiedad más clara.
Revise los falsos positivos con una cadencia regular. Si el equipo ignora la mitad de las alertas, el programa ya ha perdido credibilidad. Una buena ingeniería de calidad crea un ciclo en el que se ajustan las reglas, los propietarios están claros y cada incidente mejora el siguiente Release.
Errores comunes y mejores prácticas que realmente funcionan
La mayoría de los programas de gestión de calidad de datos no fallan por falta de herramientas en el equipo. Fallan porque el programa se convierte en una fábrica de alertas. Si cada anomalía envía una alerta a alguien, independientemente de la gravedad o la propiedad, el primer mes es ruidoso y el segundo mes se ignora.
Otro error común es medir únicamente el recuento de filas. Una tabla puede tener el volumen correcto y aun así contener valores plausibles pero incorrectos, registros retrasados o definiciones en conflicto. El defecto permanece oculto porque la métrica era demasiado imprecisa para detectarlo.
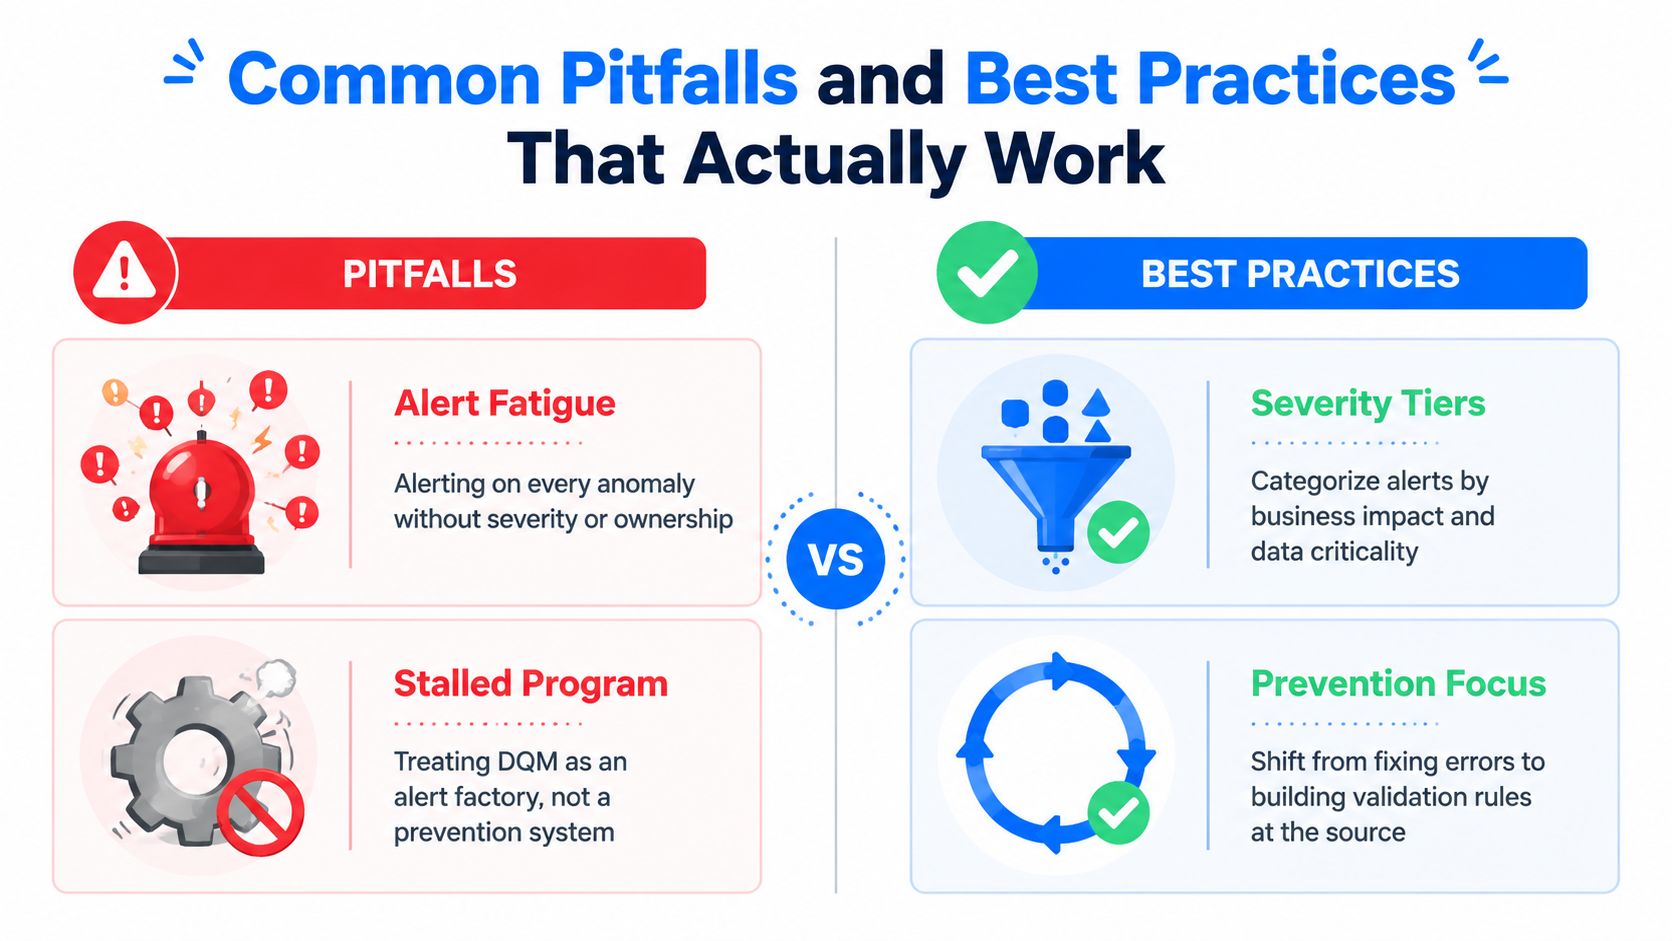
Qué evitar
Alertar sobre todo: si falta la definición de gravedad y propiedad, la gente deja de prestar atención.
Comenzar con todas las tablas: una cobertura amplia sin prioridad de negocio genera ruido.
Utilizar umbrales copiados: lo que funciona para un conjunto de datos puede ser incorrecto para otro.
Tratar la limpieza como la única solución: la prevención importa más que la limpieza a posteriori.
Permitir que las puntuaciones se conviertan en dogma: una puntuación de calidad sin contexto puede ocultar el verdadero modo de fallo.
Qué se mantiene realmente en pie
Los programas sostenibles se centran en los productos de datos críticos, no en todo el almacén de datos. Definen objetivos de nivel de servicio, dirigen los fallos a los propietarios responsables y revisan los resultados con los administradores de dominio para que los controles reflejen el negocio, no solo el esquema. También realizan un seguimiento de los aspectos que importan operativamente, como la tasa de defectos que escapan al control, el volumen de incidentes, el tiempo de detección, el tiempo de resolución, el cumplimiento de la frescura y los registros posteriores afectados.
He visto que la mayor mejora proviene de versionar las reglas, documentar las excepciones conocidas y eliminar las comprobaciones que nunca desencadenan ninguna acción. Eso mantiene la honestidad del sistema. El equilibrio adecuado es la prevención en la ingesta más la detección a través de la transformación y la entrega, porque ninguna capa por sí sola detecta todo.
Preguntas frecuentes sobre la gestión de la calidad de los datos
¿En qué se diferencia la gestión de calidad de datos de la limpieza de datos? La limpieza soluciona un conjunto de registros incorrectos específicos. La gestión de calidad de datos establece controles continuos para la prevención, detección, medición, propiedad y remediación a lo largo del ciclo de vida. Uno es una tarea de reparación; el otro es un modelo operativo.
¿Cómo se relaciona la gestión de calidad de datos con el Data Governance? El governance define las políticas, los estándares y las vías de escalamiento. La gestión de calidad de datos proporciona las comprobaciones, métricas y flujos de trabajo que aplican esas reglas en producción.
¿Quién es el propietario de la calidad de los datos? La administración de datos y la ingeniería de calidad realizan gran parte del trabajo diario, pero el propietario responsable suele ser el propietario del dominio o del producto de datos. Los equipos de plataforma deben proporcionar herramientas reutilizables y los propietarios del sistema de origen deben asumir las causas raíz que se originan aguas arriba.
¿Cómo se debe medir el ROI? Comience con una línea de base para los defectos, los incidentes, el esfuerzo manual y el impacto en el negocio, luego realice un seguimiento de la reducción de reprocesos, una detección más rápida, una recuperación más ágil, menos fallos en las etapas posteriores y una mejor reutilización. Si puede asociar un incidente evitado a un control automatizado, hágalo. Si no puede, mantenga la medición honesta y cualitativa en lugar de inventar una cifra.
La forma más sencilla de empezar sigue siendo la mejor. Elija un conjunto de datos crítico para el negocio, defina reglas de adecuación para el propósito, coloque comprobaciones donde los datos ingresan y cambian, asigne propietarios de respuesta y expándase solo después de que el primer flujo de trabajo demuestre su valor. Eso mantiene la gestión de calidad de datos conectada con las operaciones en lugar de convertirla en una presentación teórica.

Si está creando un programa de calidad de datos que tiene que funcionar dentro de tuberías reales, digna ofrece a los equipos una forma de ejecutar validaciones, detección de anomalías, monitoreo de frescura y seguimiento de esquemas en su propio entorno. Visite digna si desea una plataforma diseñada en torno a controles en la base de datos, despliegue privado y monitoreo de producción en lugar de limpiezas a posteriori.


