Pruebas de calidad de datos: guía práctica
|
7
minuto de lectura

En una encuesta sectorial de 2026, el 68 % de los encuestados dijo que detectar una incidencia de datos llevó cuatro horas o más, frente al 62 % de 2022. El tiempo medio para resolver una incidencia también subió un 166 %, hasta 15 horas por incidencia (encuesta de calidad de datos de Monte Carlo). Esas cifras cambian la forma en que debe evaluarse la prueba de calidad de datos. La pregunta no es solo si una regla puede identificar un valor inválido. Es con qué rapidez su equipo puede descubrir un fallo, entender su alcance e impedir que datos poco fiables lleguen a paneles, modelos y sistemas operativos.
Las pruebas SQL estáticas siguen teniendo su lugar. Son precisas, revisables y útiles para reglas de negocio estables. Pero las comprobaciones periódicas dejan huecos entre ejecuciones, y las reglas mantenidas a mano rara vez siguen el ritmo de esquemas, calendarios de entrega y comportamientos de datos cambiantes. Una prueba de calidad eficaz combina validación determinista con observabilidad continua, de modo que los equipos vigilen tanto la corrección como el tiempo que tardan en detectar y recuperarse de un fallo.
Índice de contenidos
El coste creciente de las incidencias de datos tardías
Una incidencia de datos se vuelve cara cuando la detección llega después de que los datos ya se usaran. Un panel roto, un KPI en entredicho o un modelo contaminado pueden desencadenar una investigación por pipelines y consumidores. Los ingenieros reconstruyen entonces el cambio, identifican los conjuntos afectados y deciden qué salidas hay que reconstruir.
El 68 % de los encuestados reportó tiempos de detección de cuatro horas o más, frente al 62 % de 2022, mientras el tiempo medio de resolución aumentó un 166 % hasta 15 horas por incidencia (hallazgos de la encuesta de Monte Carlo). Estas cifras describen tiempo de exposición, no solo rendimiento de las pruebas. Durante ese intervalo, información poco fiable puede circular por informes, extractos, aplicaciones y flujos de aprendizaje automático.
MTTD y MTTR pertenecen a la conversación sobre calidad
La prueba tradicional de calidad de datos comprueba si los registros cumplen condiciones como campos no nulos, tipos válidos o rangos aceptables. Esas aserciones miden la corrección en el momento en que se ejecutan. No muestran cuánto tiempo permaneció la organización sin saber que la condición había fallado.
El tiempo medio hasta detectar, o MTTD, mide la demora antes de que un equipo sepa que existe una incidencia. El tiempo medio hasta recuperar, o MTTR, mide cuánto se tarda en restaurar datos fiables o un pipeline sólido. Un conjunto de pruebas puede producir resultados correctos de aprobado o fallo y aun así exponer al negocio a un riesgo evitable si las alertas llegan tarde.
Regla práctica: Trate cada comprobación de calidad como una señal operativa. Registre cuándo cambió la condición, cuándo la detectó el sistema, quién recibió la alerta y cuándo volvieron a ser utilizables los datos afectados.
Las pruebas programadas dejan intervalos ciegos. Una fuente puede dejar de cargar, añadir una columna, cambiar un tipo o producir una distribución desconocida entre comprobaciones. La observabilidad continua estrecha ese intervalo evaluando frescura, esquema, valores y señales de plataforma mientras los datos se mueven, en vez de esperar a la siguiente ejecución.
La prioridad de la incidencia debe reflejar el impacto de negocio. Un KPI directivo retrasado, el fallo de un feed regulatorio y un problema en una tabla de staging sin uso no deben recibir la misma urgencia. El linaje, la propiedad y el uso aguas abajo ayudan a dirigir la atención a los fallos que pueden afectar decisiones o consumidores críticos. Los equipos también pueden usar una herramienta para cuantificar el coste operativo del tiempo de caída de datos al decidir qué controles y rutas de alerta merecen inversión.
El objetivo operativo es claro: la corrección sigue siendo necesaria, mientras que la latencia de detección determina hasta dónde viaja un fallo. La prueba de calidad de datos aporta más valor cuando da a los ingenieros evidencia a tiempo, contexto utilizable y un camino directo de la anomalía a la causa raíz.
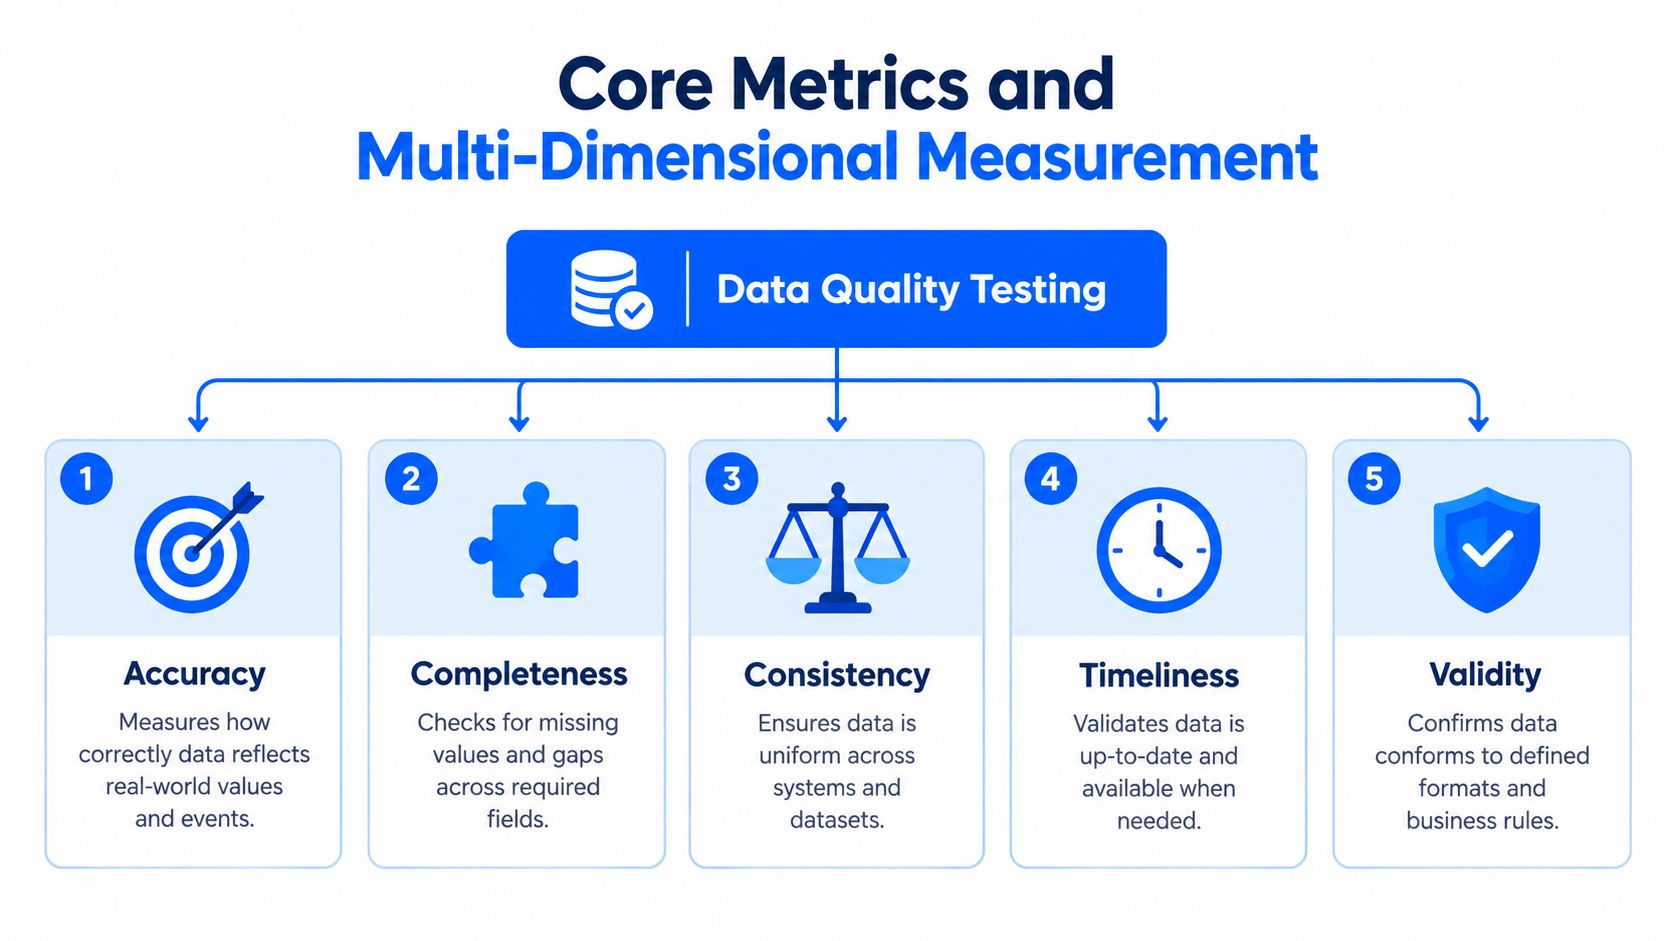
Métricas esenciales y medición multidimensional
Un programa de calidad fiable necesita más que un único porcentaje en un panel. El perfilado establece líneas base estadísticas, mientras que las dimensiones de calidad de datos muestran si un conjunto sigue siendo adecuado para su uso previsto. La cuestión operativa es con qué rapidez se hace visible una desviación significativa, no solo si una aserción programada acaba fallando.
Empiece por la forma de los datos
Perfile un conjunto antes de decidir qué controles aplicar. Salidas útiles incluyen:
Volumen y estructura: Los recuentos de filas y columnas exponen cargas ausentes, crecimiento inesperado y cambios estructurales.
Ausencias: Los porcentajes de nulos revelan si los campos requeridos están perdiendo completitud.
Cardinalidad: Los recuentos de valores distintos y duplicados identifican repetición, unicidad rota y problemas de identidad.
Distribución: Mínimo, máximo, media, mediana, desviación típica, asimetría y patrones de frecuencia muestran si los valores siguen encajando con su comportamiento esperado.
El estándar de calidad de datos de OpenMetadata incluye esas medidas de perfilado junto a indicadores operativos como la tasa de aprobado o fallo de pruebas y el tiempo medio hasta detectar y resolver incidencias. La combinación conecta dos vistas distintas. El perfilado describe qué cambió en los datos, mientras que las medidas operativas muestran si el equipo detectó y gestionó ese cambio con suficiente rapidez.
Pruebe más que el contenido
Las comprobaciones de esquema y completitud pueden pasar mientras el conjunto sigue siendo inadecuado para un modelo o un proceso de negocio. Los valores pueden tener tipos válidos y pocos nulos y, aun así, venir de una fuente poco fiable, representar condiciones caducadas o reflejar una población desequilibrada.
Un resumen del marco de ETSI recoge 18 métricas que abarcan calidad fundamental, usabilidad, equidad y privacidad. La cobertura del marco de ETSI es un resumen de TelecomTV y no la publicación del marco en sí. Su cobertura incluye completitud, exactitud, consistencia, linaje, trazabilidad, puntualidad, calidad de etiquetas y sesgo. Juntas, estas dimensiones definen la calidad por contenido, contexto y gobernanza.
Un diseño de medición por capas debe preguntar:
¿Están los datos presentes y son estructuralmente válidos?
¿Representan con exactitud los eventos o entidades previstos?
¿Se mantienen consistentes entre sistemas y transformaciones?
¿Llegaron dentro de la ventana de negocio?
¿Puede el equipo rastrear su origen, transformaciones, etiquetas y usos permitidos?
¿Sostienen una analítica o un desarrollo de modelos justos y respetuosos con la privacidad?
Los umbrales dependen del propósito. Un conjunto financiero puede exigir conciliación y trazabilidad estrictas. Un conjunto exploratorio puede tolerar campos incompletos y aun así necesitar frescura y linaje. Aplique solo las comprobaciones que puedan invalidar el uso previsto y luego vigile esas señales de forma continua, para que los fallos de calidad afloren antes de que decisiones aguas abajo dependan de ellos.
Pruebas basadas en reglas frente a observabilidad continua
Las reglas escritas a mano dan control. Una aserción SQL puede expresar una expectativa exacta, como exigir que una clave sea única o que un valor de estado pertenezca a una lista aprobada. Ese determinismo es valioso para lógica de negocio contractual, controles regulatorios y transformaciones cuyo comportamiento esperado se conoce.
El problema aparece cuando los equipos usan reglas estáticas como única línea de defensa. Cada nueva fuente, tabla, columna y excepción genera más mantenimiento. Los umbrales se quedan obsoletos, la cobertura de pruebas sigue concentrada en los conjuntos más visibles, y los ingenieros dedican tiempo a actualizar comprobaciones en lugar de investigar cambios significativos.
La distinción se evalúa mejor en paralelo:
Dimensión | Pruebas basadas en reglas | Observabilidad continua |
|---|---|---|
Mecanismo principal | Aserciones SQL explícitas y condiciones fijas | Telemetría, perfilado, líneas base y detección de anomalías |
Mejor encaje | Reglas de negocio estables y restricciones contractuales | Pipelines cambiantes y modos de fallo desconocidos |
Fortaleza | Transparente y determinista | Amplia cobertura con menos gestión manual de umbrales |
Debilidad | El mantenimiento crece a medida que cambian los sistemas | Las alertas requieren contexto y pueden exigir investigación |
Señal típica | Aprobado o fallo frente a una regla definida | Desviación del comportamiento esperado con el tiempo |
Respuesta a incidentes | A menudo empieza tras una comprobación fallida | Puede sacar antes a la luz cambios de frescura, esquema y distribución |
Use cada enfoque donde tiene palanca
Las reglas deterministas deben proteger invariantes. Los ejemplos incluyen integridad referencial, listas de códigos permitidos, lógica de conciliación y restricciones de campos obligatorios. Esas comprobaciones explican exactamente qué falló y por qué, lo que las hace adecuadas para puertas de release y evidencia de auditoría.
La observabilidad maneja comportamientos difíciles de codificar de forma exhaustiva. El aprendizaje de línea base puede identificar volúmenes inusuales, cargas ausentes, deriva de esquema o distribuciones de valores sin exigir que un ingeniero prediga cada variación válida. La investigación operativa citada en los análisis de monitorización de almacén y calidad de datos conecta la vigilancia de anomalías de volumen, esquema y valor con menores MTTD y MTTR, porque la telemetría saca a la luz los fallos más cerca de cuando ocurren.
Las reglas estáticas le dicen si falló una condición conocida. La observabilidad ayuda a revelar que el sistema se comporta de otra manera antes de que usted sepa qué condición escribir.
Eso no convierte la detección automática de anomalías en sustituto del criterio de ingeniería. Un cambio estacional puede parecer anómalo, y una adición legítima de esquema puede disparar una alerta. Los equipos siguen necesitando propiedad, linaje, contexto de incidente y flujos de supresión. El patrón práctico combina comprobaciones explícitas para obligaciones conocidas con monitorización adaptativa para cambios desconocidos.
Los ingenieros que trabajan a caballo entre fiabilidad de software y de datos pueden aprovechar también una mirada al trabajo de aseguramiento de calidad, en particular donde el diseño de pruebas, el triaje de defectos y la disciplina de release se solapan con la operación de pipelines de datos. Para un tratamiento centrado del modelo híbrido, vea reglas de validación de datos y calidad de datos continua.
Alinear las comprobaciones técnicas con el contexto de negocio
Un pipeline puede reportar una alta tasa de pruebas superadas y aun así socavar una decisión de negocio. El fallo suele empezar con un desajuste entre lo que miden los ingenieros y lo que los interesados entienden por «datos buenos».
Finanzas puede definir un registro de ingresos válido mediante estado de asiento, periodo contable, tratamiento de divisa y conciliación. Marketing puede preocuparse por consentimiento, resolución de identidad, atribución y frescura de campaña. Operaciones puede priorizar puntualidad de entrega, disponibilidad de inventario o cobertura completa de eventos. El mismo conjunto subyacente puede satisfacer la definición de un equipo y fallar la de otro.
Asigne comprobaciones a decisiones, no solo a tablas
Empiece por la pregunta de negocio y trabaje hacia atrás hasta las condiciones de datos que hacen fiable la respuesta. Para cada KPI o producto analítico importante, documente:
El consumidor: Identifique el equipo o proceso que depende de la salida.
La definición: Registre cómo se calculan términos como «cliente activo», «ingreso neto» o «entrega puntual».
La consecuencia del fallo: Describa qué pasa a estar mal si los datos llegan tarde, incompletos, duplicados o mal clasificados.
La evidencia: Especifique qué pruebas, registros de linaje, conciliaciones y logs de incidentes demuestran que la salida sigue siendo apta.
Esto crea un contrato de calidad con propósito. También evita que los equipos celebren una métrica que excluye justo los casos que importan a los interesados.
Haga visibles las definiciones cambiantes
Las definiciones de negocio cambian, y los esquemas de pipeline cambian con ellas. Una nueva columna de origen puede alterar un join, un campo renombrado puede romper un modelo aguas abajo, y una definición revisada de KPI puede exigir recargas históricas. El linaje basado en metadatos ayuda a identificar qué consumidores dependen de un campo o una transformación, mientras que la validación nativa del almacén mantiene las comprobaciones cerca de los datos que protegen.
Los paneles de calidad deben exponer el alcance, no solo el estado. Una puntuación aprobada necesita una definición de métrica visible, población, ventana temporal y política de exclusión. De lo contrario, los equipos pueden comparar resultados incomparables o confundir una cobertura estrecha con fiabilidad global.
Una puntuación de calidad solo es útil cuando su audiencia entiende qué incluye, qué excluye y qué decisión protege.
Los programas más sólidos dejan participar a los interesados en la priorización sin pedirles que escriban SQL. Los ingenieros de datos implementan controles, los analistas validan definiciones y los responsables de negocio aprueban las condiciones que importan. Esa división de responsabilidad convierte la prueba de calidad de datos, de una lista de ingeniería, en una práctica operativa de la que se responde.
La brecha de gobernanza en la gestión de datos de prueba
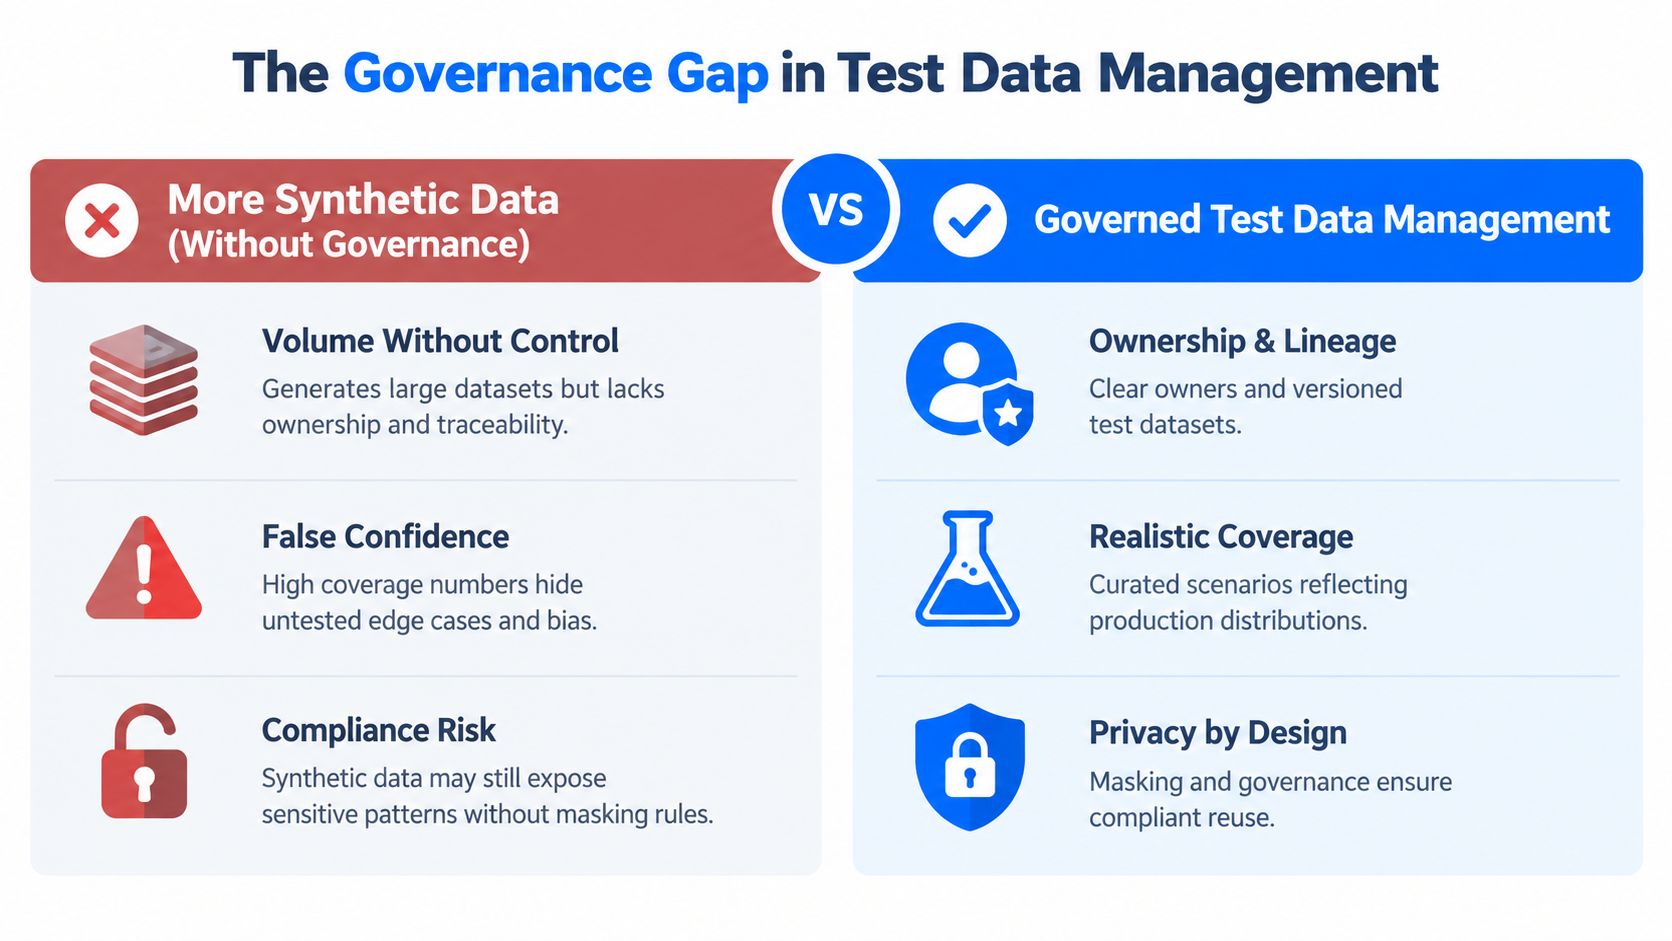
Los datos de prueba sintéticos pueden ampliar la cobertura de escenarios, pero el volumen por sí solo no crea pruebas fiables. Los equipos necesitan saber de quién es cada conjunto, qué características de producción representa, cómo se generó y si puede reutilizarse con seguridad.
El resumen del World Quality Report 2025 a 2026 indica que el 95 % de las organizaciones usa IA para generar datos de prueba, mientras que solo el 10 % ha integrado plenamente una gestión de datos de prueba guiada por IA y casi el 50 % carece de propiedad centralizada (resumen del World Quality Report). La misma fuente indica que el 35 % depende de datos sintéticos para más de una cuarta parte de sus datos de prueba. Juntos, estos hallazgos describen un problema de gobernanza, no meramente de generación.
Más datos pueden esconder menos cobertura
Los datos sintéticos sin gobierno parecen a menudo productivos porque producen muchos registros deprisa. Sin embargo, el volumen generado puede omitir combinaciones raras, distribuciones realistas, transiciones inválidas o los casos límite que causan fallos en producción. Un conjunto de pruebas puede así parecer amplio y seguir siendo débil justo donde se concentra el riesgo real.
Una gestión gobernada de datos de prueba necesita un modelo operativo claro:
Propiedad: Asigne responsabilidad sobre creación, aprobación, mantenimiento y retirada de conjuntos.
Trazabilidad: Registre características de origen, lógica de generación, transformaciones, versiones y escenarios de prueba previstos.
Aplicación de políticas: Aplique enmascaramiento, acceso, retención y reutilización de forma consistente.
Revisión de cobertura: Compare escenarios sintéticos con el comportamiento de producción y los modos de fallo conocidos.
Integración: Conecte los flujos de datos de prueba con los pipelines de entrega, los resultados de calidad y la remediación de incidentes.
La privacidad también exige más que etiquetar los datos como «sintéticos». Los registros generados pueden reproducir patrones sensibles o parecerse a distribuciones reales lo bastante como para crear exposición si los equipos se saltan el enmascaramiento y los controles de acceso. La gobernanza debe cubrir todo el ciclo de vida, desde la creación hasta el almacenamiento, la compartición, la ejecución y el borrado.
La conclusión contraintuitiva es práctica: más datos sintéticos no significan automáticamente mejores pruebas. Sin propiedad centralizada y trazabilidad, pueden añadir fragmentación, falsa confianza y puntos ciegos. Los equipos deberían optimizar escenarios representativos y reutilización responsable, no volumen de registros.
Construir un marco de pruebas por capas para ETL
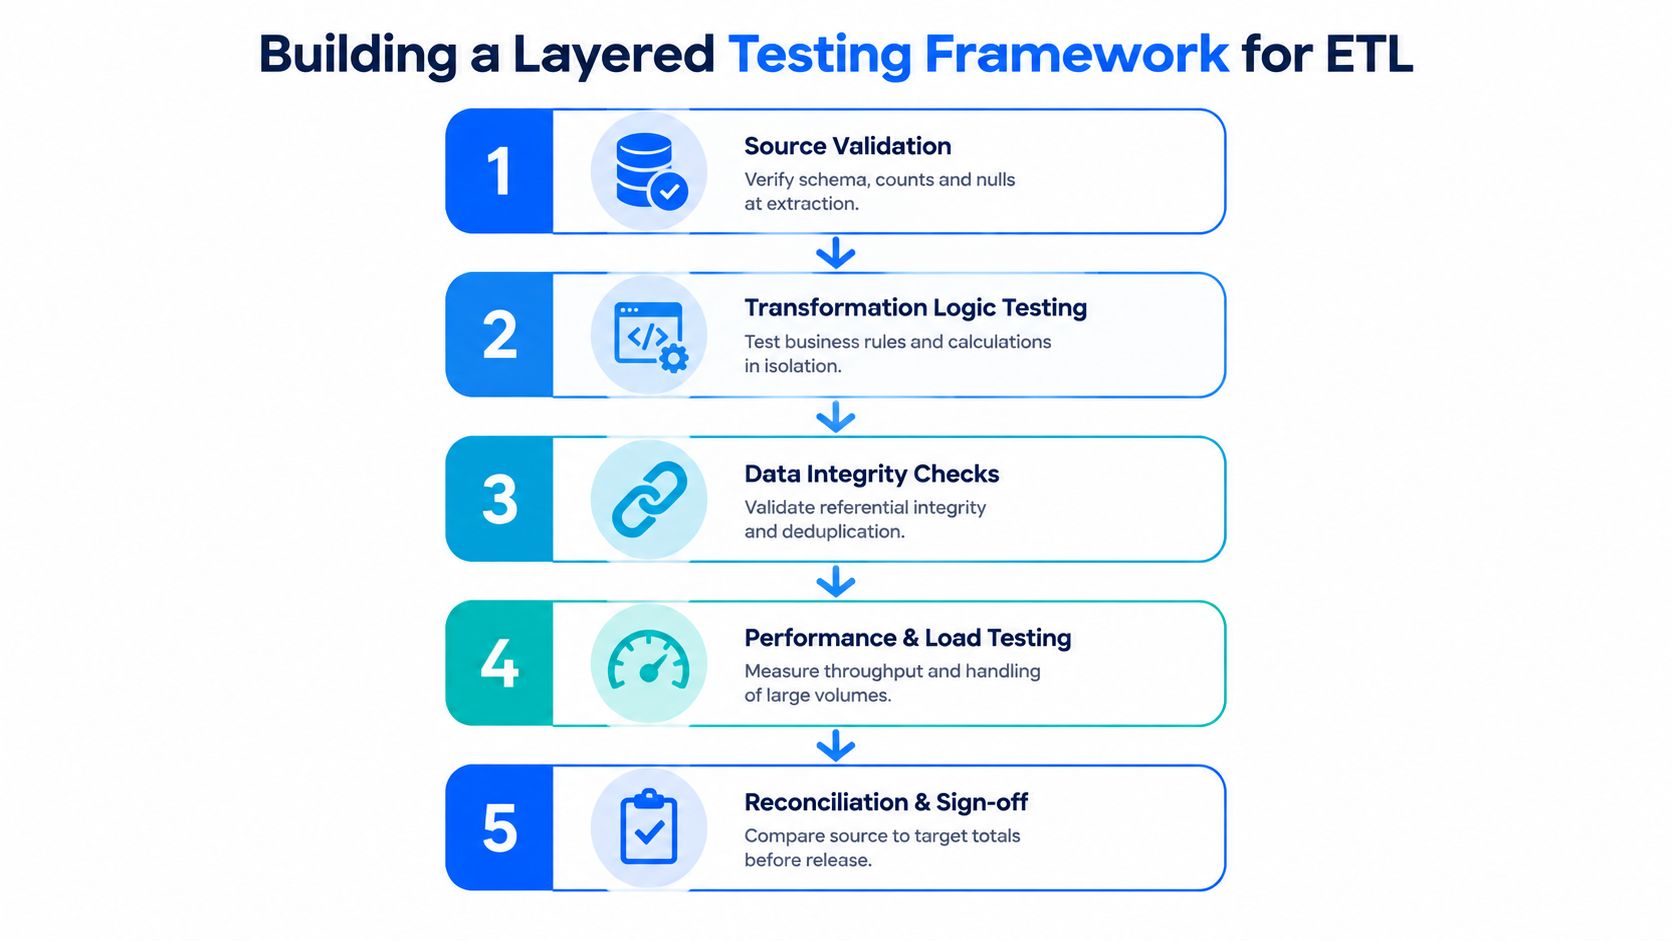
Un trabajo ETL debe considerarse no verificado hasta que supera las comprobaciones de frescura, esquema y nivel de registro. Ejecutar esos controles en secuencia da a los ingenieros una vía rápida para distinguir fallos de entrega de cambios estructurales y defectos de contenido.
Empiece por la entrega y la estructura
La frescura va primero. Confirme que la carga esperada llegó dentro de la ventana de negocio del conjunto. Una tabla técnicamente válida con los datos de ayer puede seguir siendo inservible para una decisión operativa. Las alertas de Timeliness deben dispararse cuando el retraso de entrega cruza esa ventana definida, en vez de apoyarse en un calendario genérico que ignora el contexto de negocio.
Después vienen las comprobaciones de esquema. Vigile columnas añadidas, columnas eliminadas y modificaciones de tipo de dato. Algunos cambios son compatibles e intencionados, mientras otros rompen transformaciones o alteran el significado aguas abajo sin aviso. La alerta debe incluir el objeto afectado, el tipo de cambio, el responsable y las dependencias aguas abajo.
Luego la validación a nivel de registro. Pruebe presencia de nulos, valores exactos, umbrales, rangos, listas de referencia, duplicados, relaciones y reglas de negocio. Mantenga esas comprobaciones cerca de la capa de transformación o destino, donde está disponible la semántica pertinente.
Para la implementación, use una puerta de release que registre cada capa de forma independiente:
Validación de origen: Confirme estructura, volumen y campos requeridos esperados antes de transformar.
Lógica de transformación: Pruebe cálculos, mapeos, filtros y reglas de negocio de forma aislada.
Validación de integridad: Compruebe relaciones referenciales, unicidad, deduplicación y conciliación.
Observación de rendimiento: Vigile el comportamiento de ejecución, el rendimiento y el manejo de la carga.
Aprobación de release: Compare la evidencia de origen y destino, luego registre la decisión y las excepciones aprobadas.
Calcule la corrección donde viven los datos
Las reglas de validación basadas en SQL pueden ejecutarse de forma nativa en el motor de cómputo de origen, evitando extracciones innecesarias para comprobaciones de registro. La documentación de Actian describe un cálculo concreto de corrección basado en el porcentaje de registros donde is_valid = 1 (validación de calidad de datos a nivel de registro). Lo útil no es la etiqueta en sí. Es la capacidad de calcular un resultado transparente a nivel de registro cerca del origen y conservar la evidencia de los registros fallidos para su remediación.
Para una visión de los conceptos de ETL aplicados a flujos de prueba, vea qué significa ETL en las pruebas de software. El detalle de implementación que más importa es el manejo de fallos. Una comprobación de frescura fallida debe detener o poner en cuarentena la publicación aguas abajo, mientras que un número pequeño de registros inválidos puede encaminarse a remediación según el riesgo del conjunto y la política de negocio.
Escalar la calidad con observabilidad en la base de datos
La prueba continua de calidad de datos se complica cuando cada métrica exige mover datos, infraestructura aparte y una interfaz distinta. La observabilidad en la base de datos cambia la arquitectura al calcular y analizar las señales de calidad dentro del entorno existente del cliente.
Ese diseño reduce movimientos innecesarios y mantiene los controles de acceso alineados con los sistemas que ya protegen los datos de producción. También permite a los ingenieros vigilar tablas de almacén, activos de lago y salidas de pipeline sin crear una copia paralela solo para el análisis de calidad. Para equipos con requisitos estrictos de seguridad o gobernanza, la distinción importa: la plataforma analiza los datos donde residen en lugar de exigir que los registros de producción salgan del entorno.
Combine estadística, reglas y contexto operativo
Una capa práctica de observabilidad debe unir varias formas de evidencia:
Líneas base estadísticas: Aprenda el volumen, las distribuciones y la volatilidad normales de cada conjunto.
Validación determinista: Haga cumplir reglas de negocio y restricciones a nivel de registro.
Monitorización de Timeliness: Detecte entregas tardías, ausentes o inesperadamente tempranas.
Seguimiento de esquema: Identifique columnas añadidas o eliminadas y cambios de tipo.
Linaje y propiedad: Conecte los incidentes con los consumidores afectados y los equipos responsables.
Estado compartido: Dé a ingenieros, analistas e interesados de negocio una vista común de la calidad.
El enfoque de ejecución de calidad de datos en la base de datos es útil cuando los equipos necesitan estos controles sin exportar datos sensibles de producción. La contrapartida es que la observabilidad sigue necesitando una configuración meditada. Las líneas base pueden producir alertas ruidosas si los equipos ignoran la estacionalidad, la propiedad no está clara o los consumidores no ven por qué importa un incidente.
El modelo operativo duradero trata la calidad de datos como un nivel de servicio para la información. Los equipos definen qué debe ser correcto, qué debe llegar a tiempo y qué cambios requieren revisión. La monitorización mide entonces no solo si la condición falló, sino también con qué rapidez la gente la detectó y resolvió.
La prueba de calidad de datos no es una tarea puntual de migración. Es una práctica continua que protege la analítica, el reporting y los sistemas de IA frente a cambios silenciosos y respuestas tardías.
digna aporta detección de anomalías en la base de datos, validación a nivel de registro, monitorización de Timeliness y seguimiento de esquema dentro de su propio entorno de datos. Visite digna para evaluar cómo su plataforma modular de observabilidad puede ayudar a su equipo a detectar antes los fallos de calidad y conectar los incidentes técnicos con los conjuntos y decisiones a los que afectan.
Las pruebas te dicen que una regla ha fallado; la observabilidad de plataforma de datos te dice qué cambio anterior lo provocó, que es lo que reduce el MTTR y no solo el MTTD.
Preguntas frecuentes
¿Cuánto se tarda hoy en detectar incidencias de datos?
Más que antes. En una encuesta sectorial de 2026, el 68 % de los encuestados dijo que la detección llevó cuatro horas o más, frente al 62 % de 2022, mientras el tiempo medio de resolución subió un 166 % hasta 15 horas por incidencia.
¿Por qué MTTD y MTTR pertenecen a un programa de calidad?
Porque la corrección por sí sola no acota el daño. El tiempo medio hasta detectar mide la demora antes de que un equipo sepa que existe la incidencia, y la latencia de detección determina hasta dónde viaja el fallo antes de que alguien lo pare.
¿Qué debe perfilar primero un conjunto de pruebas?
La forma de los datos: volumen y estructura para exponer cargas ausentes y cambios estructurales, ausencias mediante porcentajes de nulos, cardinalidad mediante conteos distintos y duplicados, y distribución mediante mínimo, máximo, media, mediana, desviación típica y asimetría.
¿Basta con probar el contenido?
No. Las comprobaciones de esquema y completitud pueden pasar mientras el conjunto sigue siendo inadecuado para un modelo o un proceso de negocio. Un resumen del marco de ETSI recoge 18 métricas que abarcan calidad fundamental, usabilidad, equidad y privacidad.
¿Dónde ganan las reglas y dónde la observabilidad?
Las reglas deterministas deben proteger invariantes y restricciones contractuales, donde importa la transparencia. La observabilidad cubre pipelines cambiantes y modos de fallo desconocidos, revelando cambios de frescura, esquema y distribución antes de saber qué condición escribir.



