Precisión en la calidad de los datos: métricas y monitoreo
|
8
minuto de lectura
La exactitud de los datos mide si los datos representan correctamente el objeto, evento o valor del mundo real que se pretende representar. Un resumen del sector de 2026 informa de que el 55 % de los conjuntos de datos presentan problemas de exactitud, y que dichos problemas cuestan a las empresas una media de 3,1 millones de dólares al año, según su resumen del Talend's 2023 Data Health Barometer.
Esa brecha entre los datos que parecen correctos y la realidad es donde empiezan muchos fracasos empresariales. Una transacción puede superar una comprobación de formato y contener un importe incorrecto. El registro de un paciente puede contener una fecha válida que pertenece a otra persona. Un valor de CRM puede estar completo y bien formado pero ya no describir con exactitud al cliente. En cada caso, la exactitud de la calidad de los datos es una afirmación que necesita pruebas, no una etiqueta asignada porque un campo haya superado la validación.
La edición revisada de DAMA-DMBOK® 2.0 trata la exactitud como una dimensión consolidada de la calidad de los datos, y el artículo de investigación de DAMA sobre las dimensiones de la calidad de los datos la define mediante la cercanía de los valores de los datos a los valores reales. Por lo tanto, un control fiable combina reglas de negocio, comparación con fuentes de confianza, señales de anomalías, controles estructurales, comprobaciones de puntualidad y trazabilidad. La tabla resumen que figura más adelante en este artículo compara esos métodos de control por tipo de evidencia, mejor uso, limitaciones e implantación empresarial.
Pensemos en la dirección de un cliente copiada incorrectamente de un sistema de origen a un almacén de datos. El cuadro de mando del almacén puede agregarla sin errores, mientras que un flujo de trabajo de IA utiliza la región equivocada para la segmentación. Por tanto, un único valor inexacto puede pasar por los informes, los modelos y las decisiones operativas antes de que nadie se pregunte si refleja la realidad.
Índice de contenidos
3. Detección estadística de anomalías y aprendizaje de referencia
6. Gestión de datos de referencia y gobierno de datos maestros
7. Linaje de datos y análisis de impacto para la trazabilidad de la exactitud
Convertir las señales de exactitud en decisiones de confianza
1. Validación de datos frente a reglas de negocio
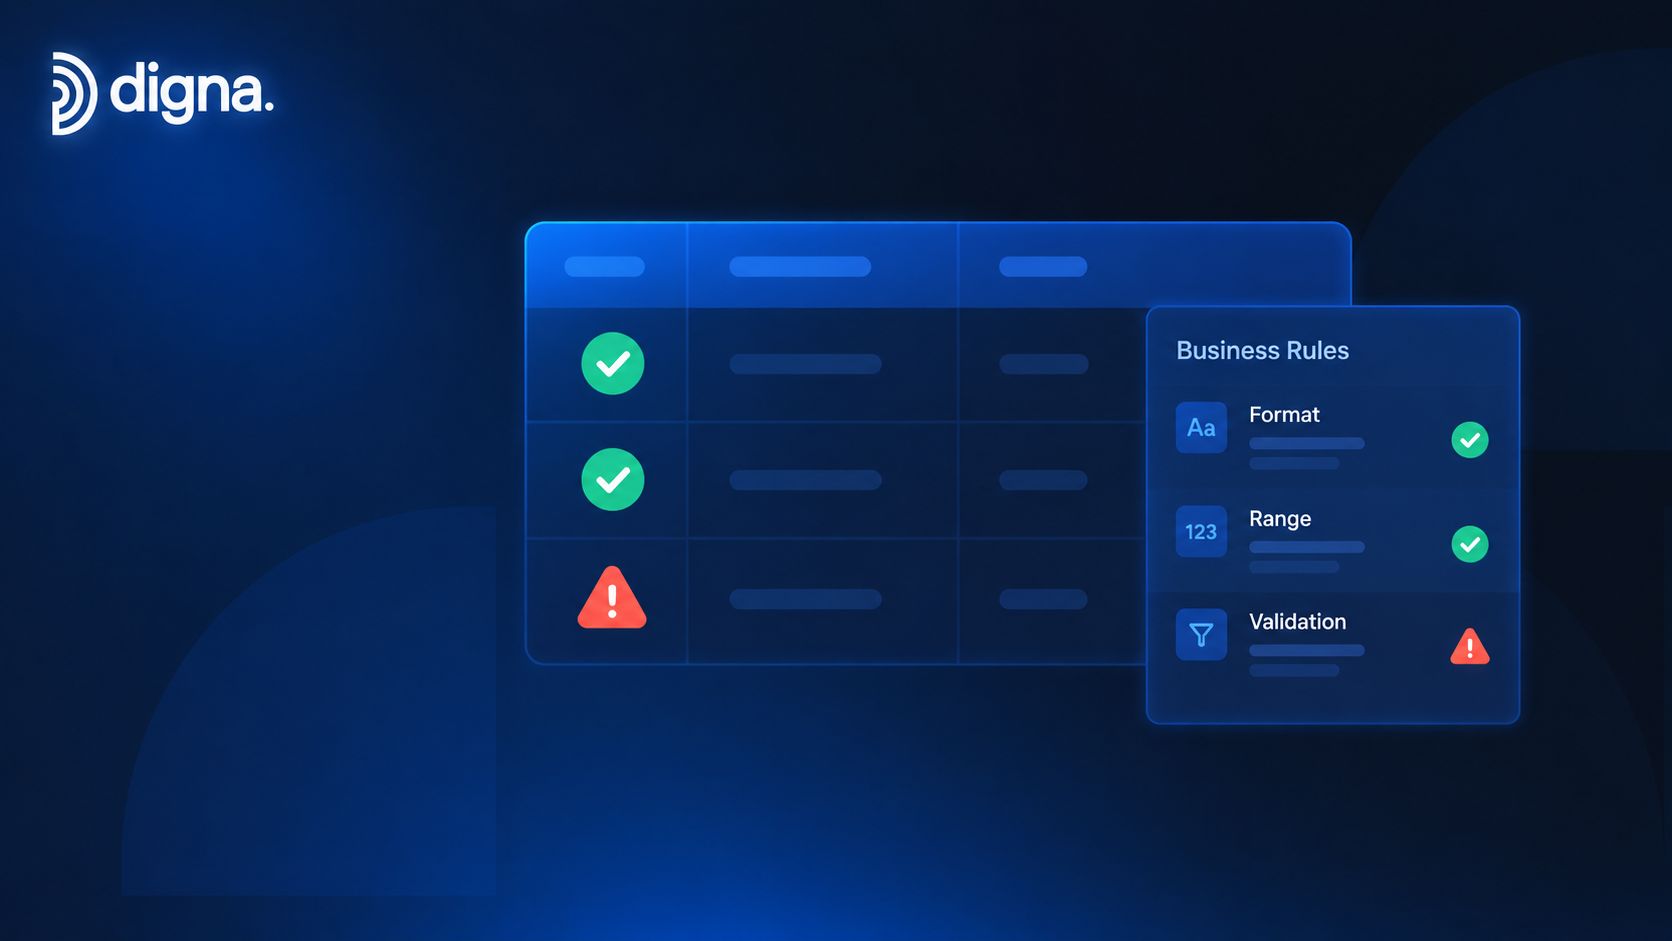
La validación de reglas de negocio proporciona evidencia de que un valor cumple con unas condiciones definidas, no la prueba de que representa el evento u objeto que describe. Aplica comprobaciones deterministas a registros, campos, relaciones y valores de referencia. Una regla puede exigir que el importe de una transacción sea positivo, que la fecha de ingreso sea anterior a la de alta o que un identificador de cliente exista en una tabla de referencia aprobada.
Estas comprobaciones son repetibles y auditables. Los equipos pueden documentar la regla, registrar el resultado e investigar los registros fallidos, lo que contribuye al cumplimiento normativo, los controles financieros y la revisión operativa. La validación también separa la validez de la exactitud. Una comprobación de rango muestra que un valor está permitido, pero no puede establecer que coincida con la transacción o el cliente subyacentes.
Regla práctica: Empiece con reglas vinculadas a decisiones, informes regulatorios, controles financieros o compromisos con clientes. No valide todas las columnas por igual antes de identificar sus consecuencias empresariales.
Una entidad financiera puede comprobar los importes de las transacciones con respecto a las condiciones del tipo de cuenta. Una organización sanitaria puede comprobar el orden de las fechas y confirmar que los identificadores clínicos coinciden con los conjuntos de códigos aprobados. Un proveedor de telecomunicaciones puede verificar los formatos de los números de teléfono y los ID de los clientes, mientras que un minorista puede comparar los precios de los productos con los datos del catálogo y rechazar las cantidades de pedido negativas. Estos controles detectan eficazmente los defectos definidos, pero siguen requiriendo investigación cuando el propio valor de origen es incorrecto.
Hacer útil la evidencia de la validación
Las implantaciones más sólidas combinan varias comprobaciones:
Lógica de negocio: Codificar condiciones que reflejen las políticas operativas, no solo los formatos técnicos.
Comparaciones de referencia: Utilizar datos maestros, tablas de búsqueda y listas aprobadas para confirmar que los valores pertenecen al dominio esperado.
Supervisión de fallos: Realizar un seguimiento de los fallos a lo largo del tiempo y por fuente, regla y proceso para identificar defectos recurrentes.
Control de versiones: Documentar y versionar las reglas para que los analistas puedan determinar qué control se aplicó cuando falló un registro.
La guía estadística oficial de Statistics Canada distingue la exactitud de las comprobaciones de conformidad de tipo validez. Esa distinción debe permanecer visible en los cuadros de mando de producción y en los flujos de trabajo de incidencias. digna Data Validation puede codificar reglas de negocio a nivel de registro, comprobaciones de referencias, umbrales y condiciones esperadas, con ejecución en la base de datos y seguimiento orientado a la auditoría.
Los equipos sanitarios también pueden conectar este enfoque de control con las ofertas de Verifai para el sector sanitario cuando los flujos de trabajo centrados en el dominio requieran comprobaciones y revisiones estructuradas.
2. Conciliación de datos y comparación entre sistemas
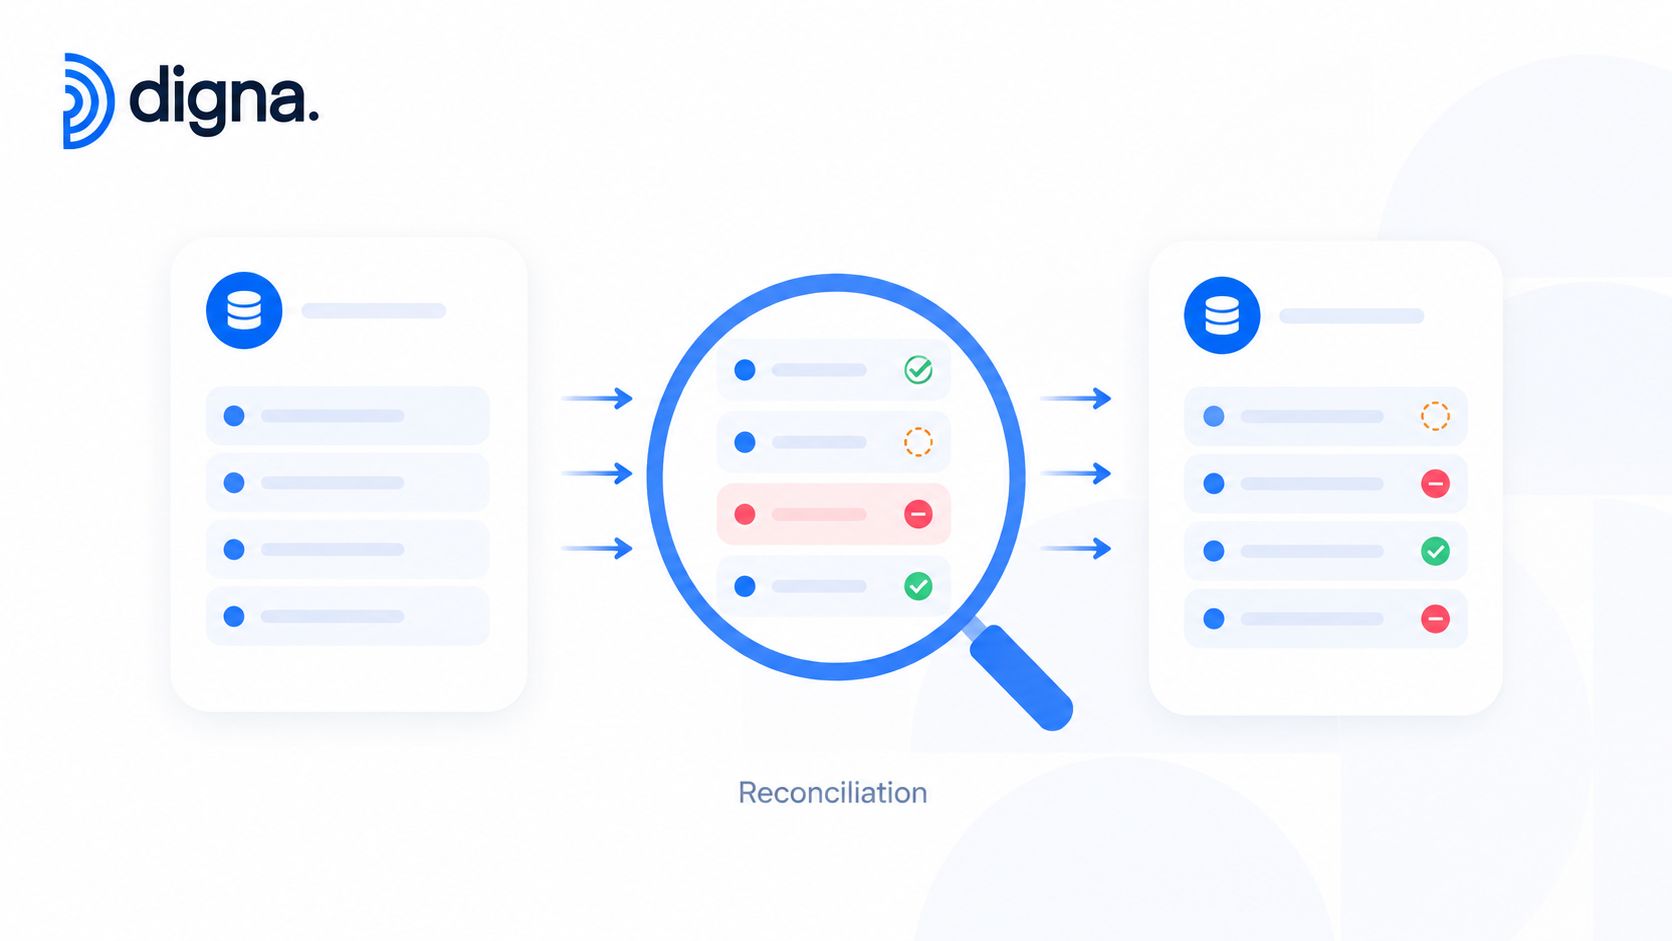
La exactitud se vuelve defendible cuando una organización puede demostrar la coincidencia de los datos con la misma realidad empresarial en todos los sistemas. La conciliación comprueba esa conexión comparando una fuente de confianza con un destino, informe, almacén o conjunto de datos derivado.
Una tubería de datos puede preservar formatos válidos mientras pierde registros, duplica transacciones, redondea importes de forma incorrecta o vincula a un cliente con una cuenta equivocada. Los procesos de replicación, migración, ETL y transformación crean estos riesgos. La comparación entre sistemas los expone al examinar si las representaciones separadas siguen coincidiendo.
La comparación depende del contexto empresarial. Un banco puede conciliar los recuentos e importes de las transacciones entre una plataforma de negociación y los libros de liquidación. Un proveedor de servicios sanitarios puede comparar los registros EHR de origen con los del almacén de datos. Un operador de telecomunicaciones puede comparar los datos de facturación heredados con un almacén en la nube tras la migración. Un equipo del sector público puede comprobar los registros de prestaciones en las bases de datos operativas, de informes y de auditoría.
Establecer el límite de comparación antes de automatizar
Los totales son útiles cuando la coincidencia agregada es significativa. También pueden ocultar errores de compensación, por lo que se requiere un emparejamiento a nivel de registro allí donde las discrepancias individuales afecten a las decisiones. Las claves naturales, las claves compuestas y la lógica de emparejamiento sensible a la transformación ayudan a distinguir los cambios legítimos de los defectos.
Una secuencia de control práctica incluye:
Comprobaciones de origen a etapa intermedia: Detectar pérdidas de ingesta y errores de análisis antes del procesamiento posterior.
Comprobaciones de etapa intermedia a almacén de datos: Aislar los defectos de transformación y carga.
Comparaciones de valores: Comprobar si hay discrepancias en importes, estados, fechas y clasificaciones.
Informes de excepciones: Clasificar las discrepancias por impacto empresarial y uso posterior.
La conciliación produce evidencia, no la verdad por sí misma. La coincidencia demuestra que dos representaciones concuerdan bajo unas reglas definidas. La discrepancia inicia una investigación sobre en qué fuente, transformación o interpretación se debe confiar.
Documente la fuente de verdad, programe las comparaciones en función del riesgo operativo y asigne responsables a los desfases no resueltos. Conserve las pruebas necesarias para reproducir cada resultado, incluidos el grano de comparación, la lógica de emparejamiento, el tiempo de ejecución y los registros afectados. digna Data Reconciliation admite comparaciones en la base de datos entre fuentes de confianza y sistemas de destino, limitando el movimiento innecesario de datos y manteniendo una vía de investigación.
3. Detección estadística de anomalías y aprendizaje de referencia
La exactitud es una afirmación defendible sobre la fidelidad con la que los datos representan la realidad. La detección estadística de anomalías ayuda a contrastar esa afirmación identificando comportamientos que se apartan de una referencia establecida. Resulta útil cuando las reglas fijas no pueden captar la estacionalidad, el crecimiento, la volatilidad o las relaciones entre campos.
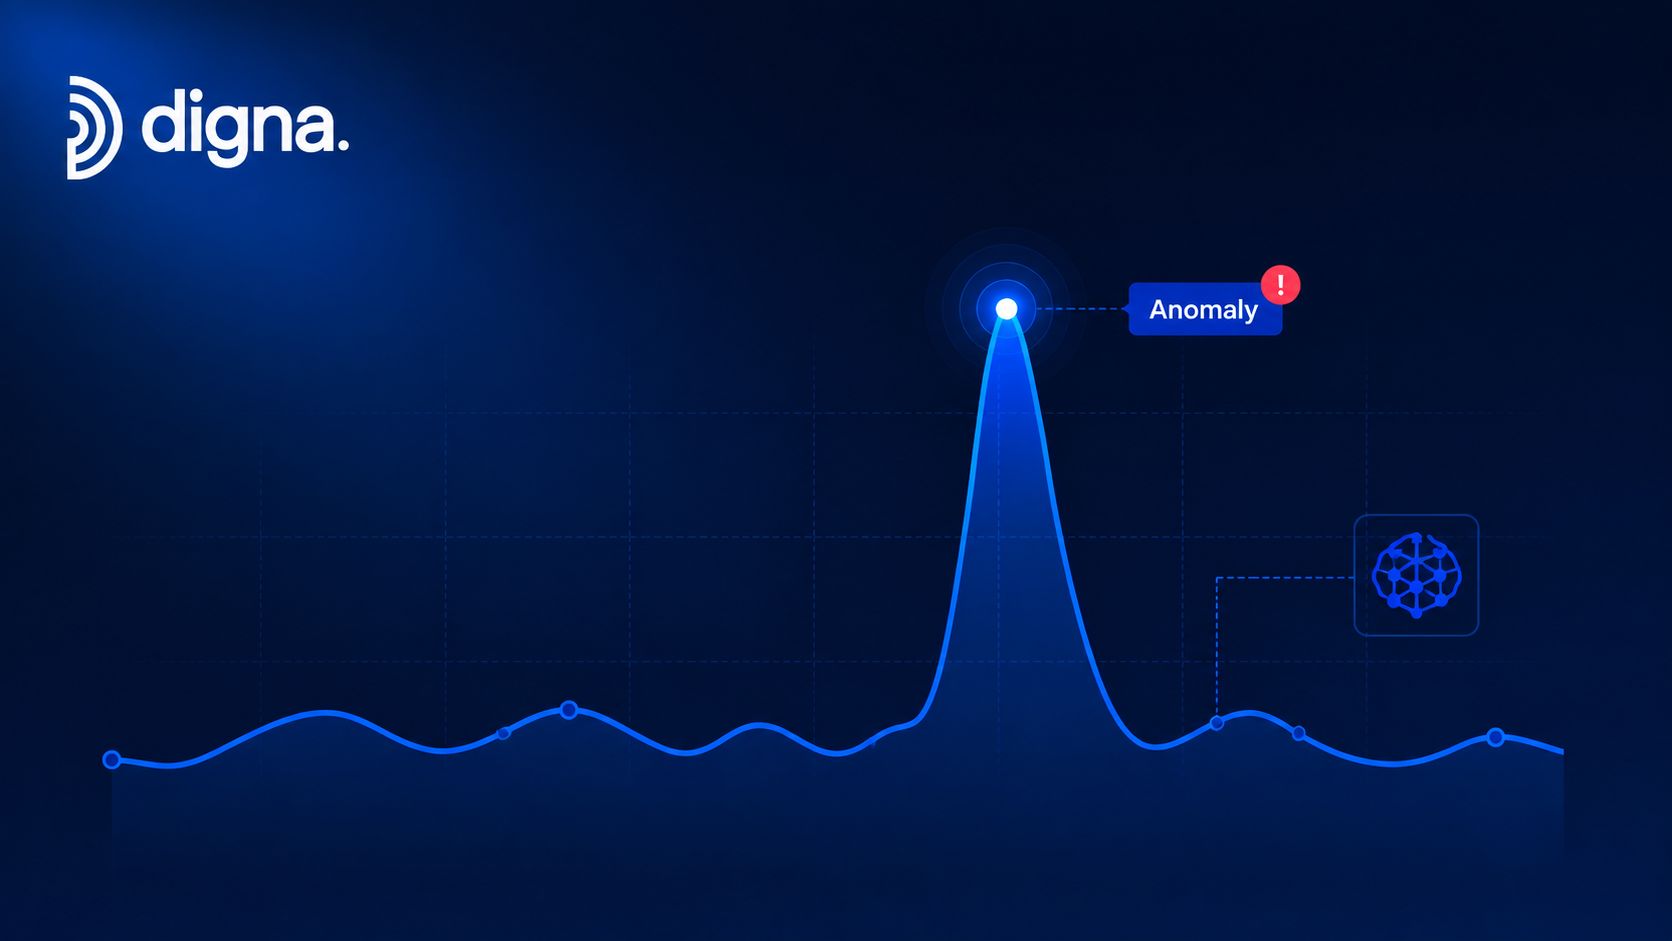
Una referencia puede realizar un seguimiento del volumen de registros, las distribuciones de valores, los patrones de entrega, las relaciones de campo y las métricas empresariales. Un cambio brusco en el volumen de negociación, los ingresos de pacientes, el uso de telecomunicaciones, las ventas minoristas o el inventario puede exponer un defecto de origen. También puede reflejar un evento operativo real, por lo que la alerta es una prueba para investigar, no un veredicto sobre la corrección.
Una promoción puede producir un pico de ventas legítimo. Un cambio de política puede alterar los ingresos hospitalarios, mientras que el lanzamiento de un nuevo producto puede reconfigurar el uso. Tratar cada desviación como un error crea falsas incidencias y puede ocultar cambios empresariales válidos.
Conectar las alertas con la investigación
Utilice las señales de anomalías para dirigir la atención y, a continuación, compruebe los registros subyacentes y el contexto:
Referencia aprendida: Modelar el comportamiento normal para el conjunto de datos en lugar de aplicar un único umbral universal.
Revisión empresarial: Preguntar a los responsables del proceso si el cambio coincide con un evento real, un lanzamiento planificado o un ajuste de política.
Confirmación de control: Aplicar validación y conciliación para determinar si los registros afectados contienen defectos o divergen de las representaciones de confianza.
Revisión de patrones: Examinar las alertas recurrentes por fuente, transformación, periodo de tiempo y métrica para identificar fallos sistémicos.
Cola priorizada: Clasificar las investigaciones por magnitud de la anomalía, impacto empresarial y uso posterior cuando la revisión manual no pueda abarcar la totalidad del conjunto de datos.
La guía de digna para detectar anomalías en series temporales describe cómo las señales de series temporales pueden respaldar este flujo de trabajo. digna Data Anomalies proporciona un aprendizaje de referencia impulsado por IA, lo que reduce la necesidad de definir cada umbral manualmente. digna Data Analytics ayuda a examinar las tendencias históricas, la volatilidad y los comportamientos recurrentes durante la investigación.
Despliegue referencias con umbrales versionados, decisiones de revisión documentadas y responsables para las alertas no resueltas. Supervise el volumen de alertas y los patrones recurrentes tras el despliegue, pero no trate la Observability como una prueba de que los valores son exactos. Muestra dónde se necesitan pruebas y si los controles se comportan como se espera.
4. Seguimiento de esquemas y validación estructural
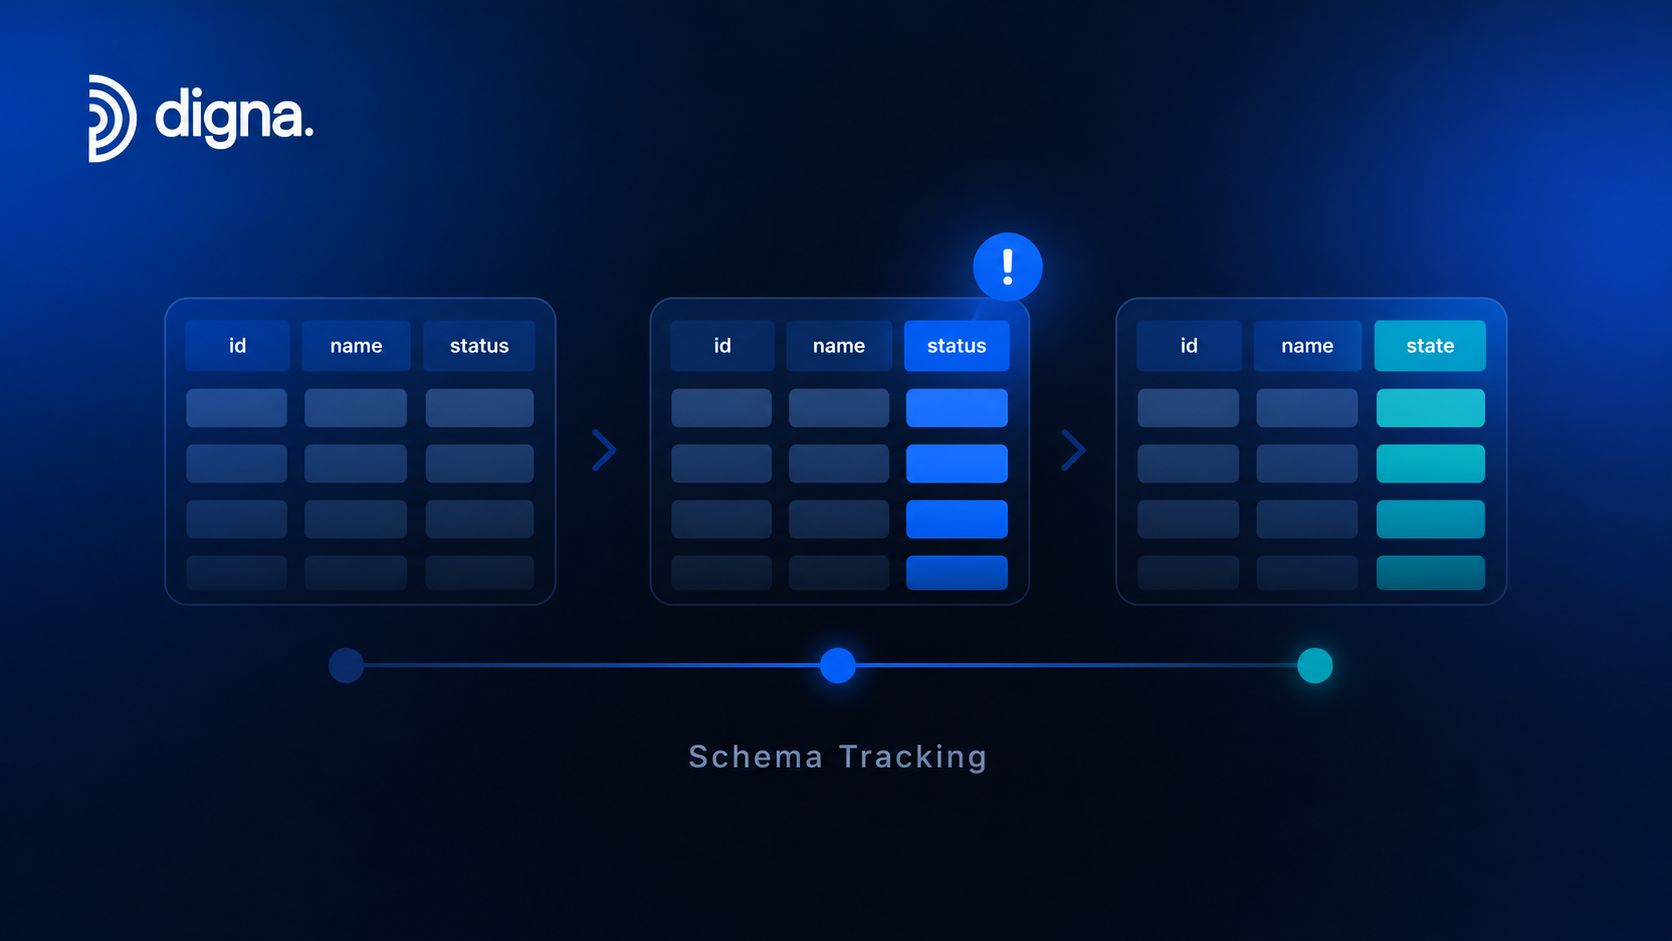
La exactitud depende tanto de la estructura como de los valores. Un tipo de columna, un nombre de campo, una clave o una relación entre tablas determinan cómo interpretan los datos de origen los sistemas posteriores. El seguimiento de esquemas registra esos elementos estructurales y expone los cambios antes de que distorsionen los informes, los modelos o los flujos de trabajo operativos.
Un nuevo campo regulatorio en un flujo financiero puede omitirse en los informes si no se actualizan las transformaciones. Cambiar un elemento clínico de texto a numérico puede interrumpir la ingesta o alterar su significado. Una tabla de referencia de clientes reestructurada puede producir uniones fallidas o incorrectas en los análisis de telecomunicaciones. Eliminar una columna de auditoría puede debilitar los informes del sector público mientras los valores restantes siguen pareciendo válidos.
Los fallos más difíciles son los silenciosos. Una ingesta permisiva puede aceptar una estructura modificada, y un cuadro de mando puede seguir ejecutándose con campos incompletos o registros mal unidos. La afirmación de exactitud resultante ya no es defendible porque los datos ya no representan las entidades y relaciones empresariales previstas.
Gobernar los cambios estructurales como eventos de despliegue
La supervisión de esquemas pertenece al mismo proceso de control que los catálogos de datos, el linaje, las aprobaciones de versiones y la comunicación con el consumidor. Cada cambio aprobado necesita un responsable, una fecha de entrada en vigor, una decisión de compatibilidad y un historial de versiones. Un cambio no aprobado debería crear una incidencia antes de llegar a un informe o modelo crítico.
Utilice las siguientes comprobaciones para hacer operativo el control:
Detección de cambios: Buscar campos añadidos, eliminados, renombrados y redefinidos.
Pruebas de compatibilidad: Verificar que las uniones, las transformaciones y las aplicaciones de consumo sigan interpretando la estructura correctamente.
Notificación al consumidor: Alertar a los equipos afectados antes de que un cambio aprobado entre en producción.
Clasificación de riesgos: Aplicar una revisión más estricta a los esquemas que respaldan flujos de trabajo regulatorios, financieros, clínicos o de IA.
Registros históricos: Conservar el historial de cambios para auditorías y análisis de causas raíz.
digna Schema Tracker detecta cambios estructurales, incluidas las modificaciones de columnas y tipos de datos. Estas comprobaciones demuestran que la estructura sigue siendo compatible. No determinan que cada valor sea correcto, por lo que la validación a nivel de valor y la conciliación siguen siendo necesarias.
5. Control de puntualidad y entrega de datos
La exactitud es una afirmación defendible sobre la fidelidad con la que los datos representan la realidad en el momento de tomar la decisión. Un valor puede ser correcto cuando se registra pero resultar engañoso si se entrega demasiado tarde. El control de puntualidad examina si los datos críticos llegan según lo esperado, si falta una carga y si su frescura se ajusta al caso de uso operativo.
El control es importante en la liquidación al final del día, los flujos de trabajo de alta de pacientes, las revisiones matutinas de telecomunicaciones y el inventario minorista por horas. Un cuadro de mando que muestre el inventario de ayer durante las ventas activas puede contener registros válidos, pero no representa el stock actual. Por tanto, los datos obsoletos limitan lo que la exactitud puede respaldar.
Establezca las expectativas de entrega con los responsables de negocio, no solo con los operadores de las tuberías de datos. Una tarea puede terminar a tiempo mientras entrega contenido incompleto, mientras que una carga tardía puede ser aceptable para un informe histórico e inadecuada para una decisión en tiempo real.
Utilice un registro de entrega que ayude a la investigación:
Entrega prevista: Definir cuándo debe llegar cada conjunto de datos crítico.
Llegada real: Registrar entregas anticipadas, a tiempo, tardías y omitidas.
Frescura: Comparar la antigüedad del registro con los requisitos de la decisión.
Integridad en la entrega: Confirmar que llegó el contenido previsto, en lugar de únicamente un archivo o tabla.
Patrones de incidencias: Examinar los retrasos recurrentes en el origen, las dependencias y las tuberías de datos.
Las capacidades de supervisión de datos en tiempo real de digna admiten los cálculos de entrega prevista y el seguimiento de programaciones. El módulo digna Timeliness utiliza patrones de entrega aprendidos para marcar retrasos, cargas omitidas y comportamientos de llegada inesperados. Estas señales proporcionan evidencia sobre el rendimiento de las entregas y ayudan a priorizar la investigación. Combínelas con la validación y la conciliación, ya que la frescura por sí sola no puede establecer la corrección. Los equipos de despliegue también deben definir la propiedad de las alertas, los umbrales de escalada y el punto a partir del cual deben retenerse los datos obsoletos para su uso operativo.
6. Gestión de datos de referencia y gobierno de datos maestros
La exactitud depende de si los datos de referencia representan la realidad empresarial que los registros operativos deben describir. Los catálogos de productos, los maestros de clientes, las taxonomías geográficas, las jerarquías organizativas, los conjuntos de códigos clínicos, las estructuras de libros de contabilidad general y las clasificaciones regulatorias proporcionan el contexto para interpretar los valores y ejecutar los controles de calidad.
Un precio de producto incorrecto en el catálogo puede hacer que la validación posterior apruebe transacciones incorrectas. Identificadores de proveedor diferentes pueden hacer que una unión correcta asocie un evento clínico con la entidad equivocada. Por tanto, los defectos de los datos de referencia se propagan por los sistemas dependientes y pueden hacer que otras señales de calidad parezcan tranquilizadoras sin demostrar su corrección.
Los requisitos de gobernanza varían según el dominio. Los equipos de servicios financieros pueden controlar las taxonomías de contrapartes y entidades regulatorias. Los equipos sanitarios pueden gestionar los identificadores de pacientes, las credenciales de proveedores y los conjuntos de códigos clínicos. Las organizaciones de telecomunicaciones pueden mantener jerarquías de clientes, catálogos de servicios y clasificaciones geográficas. Los departamentos del sector público pueden gobernar los registros de ciudadanos y los códigos de programas de prestaciones.
Crear una capa de referencia autorizada
Empiece por los dominios que influyen en las decisiones de gran impacto. Otorgue a cada uno un responsable rindiendo cuentas, reglas de aprobación, historial de versiones, fechas de entrada en vigor y un proceso de distribución controlado. Estos controles crean pruebas para la investigación y proporcionan una base defendible para decidir qué valores deben utilizar los consumidores.
Propiedad: Asignar la responsabilidad de aprobar, revisar y corregir los valores maestros.
Control de versiones: Preservar los cambios para que los registros históricos sigan siendo interpretables.
Sincronización: Distribuir los valores aprobados de forma coherente en todos los sistemas operativos y analíticos.
Uso de validación: Conectar las tablas de búsqueda con los controles a nivel de registro y documentar el dominio esperado.
Supervisión de la frescura: Identificar valores de referencia obsoletos o incompletos antes de su uso posterior.
«Maestro» es un estado de gobernanza, no una prueba de corrección. Los flujos de trabajo de aprobación, la conciliación y la revisión periódica siguen siendo necesarios. digna Data Validation puede aplicar listas de referencia y restricciones de negocio para marcar valores fuera del dominio previsto. Trate esas marcas como pruebas para su revisión y, a continuación, confirme el valor de referencia y su periodo de vigencia antes de modificar los datos de producción.
7. Linaje de datos y análisis de impacto para la trazabilidad de la exactitud
La exactitud es una afirmación defendible sobre la fidelidad con la que los datos representan la realidad, no una conclusión extraída de una única señal de calidad. El linaje muestra dónde se originó un valor, qué transformaciones lo modificaron y qué informes, cuadros de mando o modelos lo consumieron. El análisis de impacto identifica a las personas y los procesos que pueden requerir investigación tras una incidencia.
Un importe de gasto incorrecto en el cuadro de mando de un directivo ilustra la diferencia. Los investigadores pueden rastrear el valor desde el libro mayor a través de la etapa intermedia, la lógica de transformación y las tablas del almacén de datos, y luego revisar el resultado afectado. En el sector sanitario, el linaje puede identificar informes y modelos que dependen de cambios en los datos demográficos de los pacientes. En el comercio minorista, puede mostrar cómo llegan datos incorrectos de productos al inventario, a las previsiones y a los informes de pérdidas y ganancias.
El linaje no determina que un valor sea correcto. Aporta pruebas de procedencia para examinar la afirmación, incluidos su origen, historial de procesamiento y exposición posterior.
Hacer operativa la trazabilidad
Mapee primero los flujos de gran impacto. Capture los metadatos de origen, la lógica de transformación, la propiedad y las dependencias, y luego conecte los registros de linaje con las incidencias de calidad. Los defectos repetidos pueden orientar a los investigadores hacia una fuente o transformación de riesgo, pero la validación y la conciliación siguen determinando si el valor coincide con la realidad empresarial.
Utilice estos controles operativos:
Mapeo de flujos críticos: Priorizar los informes regulados, las métricas financieras, las operaciones con clientes y las entradas de IA.
Documentación de transformaciones: Registrar qué cambió, por qué cambió y quién lo aprobó.
Evaluación de impacto: Identificar los cuadros de mando, modelos y procesos que requieren revisión.
Priorización de la remediación: Corregir el defecto original antes de modificar repetidamente las copias posteriores.
Mantenimiento de cambios: Actualizar el linaje tras cambios en las tuberías de datos, esquemas o propiedad.
La perspectiva de digna sobre la combinación de linaje de datos y calidad de datos vincula la trazabilidad con la respuesta a incidencias. Las capacidades de catálogo e integración de digna pueden respaldar la documentación de linaje junto con los controles de validación, anomalías, puntualidad y esquemas.

Comparación de la exactitud de los datos en 7 puntos
Elemento | Complejidad de implementación 🔄 | Requisitos de recursos ⚡ | Resultados esperados 📊⭐ | Casos de uso ideales (mejor para) | Ventajas clave ⭐ | Consejos 💡 |
|---|---|---|---|---|---|---|
Validación de datos frente a reglas de negocio | Medio 🔄 | Medio ⚡ | Detección determinista de infracciones de reglas; resultados listos para auditoría | Cumplimiento normativo, controles regulatorios, aplicación a nivel de registro | Alta precisión y repetibilidad; pistas de auditoría ⭐ | Empiece con reglas de alto impacto; versione las reglas e involucre a las partes interesadas 💡 |
Conciliación de datos y comparación entre sistemas | Medio–Alto 🔄 | Alto ⚡ | Identifica registros perdidos/duplicados y discrepancias de valores; cuantifica las desviaciones | Entornos multisistema, migraciones, sectores regulados | Detecta pérdidas de datos silenciosas y errores de transformación; establece la rendición de cuentas ⭐ | Defina una única fuente de verdad; automatice las programaciones; concilie en múltiples etapas 💡 |
Detección estadística de anomalías y aprendizaje de referencia | Bajo–Medio 🔄 | Medio ⚡ | Alertas de anomalías adaptativas y detección de desviaciones; señales de alerta temprana | Conjuntos de datos grandes y complejos; datos estacionales/con tendencias; supervisión proactiva | Detecta patrones nuevos/inesperados sin reglas manuales ⭐ | Permita un periodo de entrenamiento de la referencia; combine con comprobaciones de reglas; recurra a expertos en la materia para la interpretación 💡 |
Seguimiento de esquemas y validación estructural | Bajo 🔄 | Bajo ⚡ | Detección en tiempo real de desviaciones de esquema (columnas/tipos); evita fallos silenciosos | Plataformas heterogéneas; cambios frecuentes de esquema; estabilidad de las tuberías de datos | Evita interrupciones posteriores; respuesta rápida a incidencias; pista de auditoría ⭐ | Integre con catálogos; implemente control de cambios y alertas previas a los cambios 💡 |
Control de puntualidad y entrega de datos | Bajo–Medio 🔄 | Bajo–Medio ⚡ | Detecta cargas tardías/omitidas/adelantadas; cumplimiento de SLA y menor tiempo de descubrimiento | Informes urgentes, SLA, operaciones en tiempo real | Reduce la latencia en el descubrimiento de incidencias; alertas proactivas ⭐ | Establezca SLA claros; supervise también la integridad; gestione el desfase horario y de reloj 💡 |
Gestión de datos de referencia y gobierno de datos maestros | Alto 🔄 | Alto ⚡ | Única fuente de verdad para valores válidos; exactitud posterior coherente | Consistencia empresarial, dimensiones de cliente/producto/maestro | Evita inconsistencias entre sistemas; respalda el gobierno de datos y las auditorías ⭐ | Priorice los maestros críticos; controle las versiones y automatice la sincronización 💡 |
Linaje de datos y análisis de impacto para la trazabilidad de la exactitud | Medio–Alto 🔄 | Alto ⚡ | Rastreo rápido de la causa raíz y evaluación del impacto posterior; procedencia para auditorías | Sectores regulados, tuberías de datos complejas, grandes empresas | Acelera la remediación y la evaluación de riesgos; muestra la procedencia ⭐ | Automatice la captura de metadatos; empiece con flujos críticos; mantenga el linaje actualizado 💡 |
Convertir las señales de exactitud en decisiones de confianza
La exactitud se pregunta si los datos reflejan la realidad. La validez se pregunta si los datos se ajustan a los formatos, dominios o reglas definidos. La razonabilidad se pregunta si un valor parece plausible en su contexto. Esas dimensiones se solapan, pero no son intercambiables.
Una fecha puede ser válida porque sigue el formato exigido y razonable porque se sitúa dentro de un periodo plausible, y aun así ser inexacta si pertenece al registro equivocado. Un número de teléfono puede superar una comprobación de patrón sin conectar con el cliente indicado. Una cifra de ingresos declarada puede parecer plausible omitiendo a una población del sistema de origen. Tratar cada comprobación superada como prueba de exactitud genera una falsa confianza.
La guía de Statistics Canada describe la exactitud a través de la diferencia entre una estimación y el valor real de la población, siendo el sesgo y la varianza factores que contribuyen a la inexactitud. También señala umbrales de fiabilidad basados en el coeficiente de variación, incluidos valores inferiores al 16,6 % para la fiabilidad general, valores entre el 16,6 % y el 33,3 % que deberían llevar una advertencia, y valores superiores al 33,3 % considerados poco fiables para su contexto estadístico guía oficial. Los equipos de las empresas no deben copiar esos umbrales a ciegas en la calidad de los datos operativos. Deben definir tolerancias adecuadas al propósito basándose en la decisión, el riesgo y las pruebas disponibles.
Una secuencia operativa práctica de la exactitud
Definir la realidad: Identificar el objeto, evento o valor y los campos que lo representan.
Nombrar la evidencia autorizada: Establecer fuentes de confianza, datos de referencia o métodos de comparación aprobados.
Aplicar controles deterministas: Utilizar reglas de validación para la lógica de negocio, dominios, relaciones y restricciones.
Conciliar representaciones: Comparar el origen, la etapa intermedia, el almacén de datos, los informes y los conjuntos de datos derivados cuando proceda.
Supervisar el comportamiento: Añadir la detección de anomalías, las comprobaciones de puntualidad y la supervisión estructural para capturar condiciones inesperadas.
Rastrear e investigar: Utilizar el linaje, los análisis históricos y la propiedad para localizar las causas y documentar las decisiones.
Remediar y recalibrar: Corregir el origen o la transformación y, a continuación, revisar si el control sigue coincidiendo con el uso previsto.
¿Cómo puede digna ayudar a la exactitud de los datos?
digna Data Validation admite comprobaciones deterministas frente a reglas de negocio, datos de referencia, valores exactos, umbrales, rangos y condiciones esperadas. digna Data Reconciliation compara fuentes de confianza y sistemas de destino para identificar discrepancias en conjuntos de datos internos de la base de datos. digna Data Anomalies identifica desviaciones inesperadas que pueden indicar datos inexactos, pero sus alertas son señales para investigar, no pruebas. digna Data Analytics ayuda a los equipos a examinar patrones históricos, la volatilidad y los comportamientos recurrentes en torno a esas señales.
La plataforma ejecuta el cálculo de métricas y el análisis dentro de las bases de datos del cliente, con despliegue en nube privada o local dentro de la nube, VPC o centro de datos del cliente. Ese diseño mantiene los datos en su sitio al tiempo que ofrece a los ingenieros, analistas y equipos de gobierno una visión compartida de las incidencias y tendencias. Un cuadro de mando del rendimiento de un operador de transporte ilustra el tipo de informes operativos que dependen de medidas subyacentes fiables, aunque la confianza en el cuadro de mando sigue requiriendo pruebas sobre los datos de origen.
Preguntas frecuentes
¿Qué es la exactitud en la calidad de los datos?
La exactitud es el grado en que los datos representan de forma correcta o factual el mundo, objeto, evento o valor que pretenden describir. El artículo sobre las dimensiones de calidad de datos de DAMA la define como la cercanía a los valores, evaluada a menudo frente a una fuente correcta conocida o fuente de verdad.
¿Cómo se mide la exactitud de los datos?
Los equipos miden la exactitud de los datos comparando los valores muestreados o supervisados con fuentes autorizadas, mediciones repetidas, pruebas de validación interna, datos de referencia o expectativas cuidadosamente definidas. Una métrica común es la tasa de exactitud de los datos, calculada como los valores correctos divididos por el total de valores muestreados, tal como describe esta referencia de métricas de calidad de datos. Cuando no existe un estándar de oro externo, los equipos deben documentar el tipo de evidencia y sus limitaciones en lugar de presentar una puntuación como verdad absoluta.
¿Cuál es la diferencia entre exactitud y validez?
La validez comprueba si los datos se ajustan a un formato, rango, dominio o regla definidos. La exactitud comprueba si el valor representa la realidad. Un valor puede ser válido y plausible y, sin embargo, estar asignado al cliente, evento, producto o periodo de tiempo equivocado.
¿Cómo se puede supervisar la exactitud de los datos de forma continua?
La supervisión continua combina la validación a nivel de registro, la conciliación con fuentes de confianza, las comprobaciones de datos de referencia, las señales de anomalías, el seguimiento de esquemas, el control de puntualidad y la investigación respaldada por el linaje. La guía de operaciones de calidad de datos también distingue las comprobaciones de exactitud frente a fuentes autorizadas de las comprobaciones de validez, como las expresiones regulares y las reglas de rango.
¿Qué herramientas pueden supervisar la exactitud de los datos?
Las organizaciones suelen utilizar herramientas de validación de datos, conciliación, datos de referencia, Observability, detección de anomalías, seguimiento de esquemas, linaje y análisis histórico. digna reúne estas capacidades a través de digna Data Validation, digna Data Reconciliation, digna Data Anomalies, digna Data Analytics, puntualidad, seguimiento de esquemas, catálogo, integraciones y ejecución en la base de datos. Las herramientas pueden hacer emerger pruebas y priorizar la investigación, pero los responsables de negocio siguen necesitando confirmar si los valores reflejan la realidad prevista.
Un informe de investigación de Observability de 2025 informa de que el 76 % de las organizaciones han formalizado, implementado u optimizado programas tanto para la calidad de los datos como para la Observability de las tuberías de datos, mientras que el 68 % utilizan métricas cualitativas o cuantitativas para medir el éxito informe de investigación. Ese camino es práctico: la exactitud funciona mejor como una disciplina operativa con pruebas documentadas, propiedad asignada y retroalimentación continua, no como un proyecto de limpieza puntual.
digna proporciona validación de datos, conciliación de datos, detección de anomalías de datos, análisis de datos, puntualidad y control de esquemas en la base de datos para conjuntos de datos empresariales críticos. Visite digna para explorar una plataforma modular de calidad de datos y Observability que se ejecuta en su propio entorno y ayuda a los equipos a convertir las señales de exactitud en decisiones investigadas y trazables.


