Por qué la calidad de datos es importante para una organización
|
8
minuto de lectura

Un equipo directivo empieza la mañana con una rutina conocida. Finanzas revisa el panel de ingresos, operaciones comprueba los volúmenes de entrega, ventas estudia el pipeline y atención al cliente se prepara para la demanda del día. Por la tarde, alguien descubre que una fuente entregó tarde, otra cambió el nombre de un campo y una tercera contiene registros de clientes duplicados. El panel parecía preciso, pero la organización estaba decidiendo a partir de una imagen incompleta.
El problema rara vez es un fallo espectacular de base de datos. Es un campo que falta, un extracto obsoleto, una definición inconsistente o un cambio de esquema que nadie advirtió. Esos defectos viajan hasta las previsiones, los informes regulatorios, los flujos de trabajo con clientes y los sistemas de IA antes de que nadie los relacione con la fuente original.
Por eso por qué la calidad de datos es importante para una organización es una pregunta de negocio y no solo técnica. Los datos fiables ayudan a decidir, actuar, explicar y cumplir con confianza. Los datos deficientes obligan a los equipos a cuestionar informes, repetir trabajo, retrasar iniciativas y defender cifras que no pueden trazar del todo. Esta guía explica cómo la calidad de datos genera control organizativo sobre las decisiones, el cumplimiento y el riesgo de la IA, y cómo los líderes pueden convertirla en una capacidad operativa duradera. Para una visión práctica de su valor de negocio, consulte los beneficios organizativos de la calidad de datos.
Tabla de contenidos
Introducción: por qué la calidad de datos determina el éxito organizativo
Qué significa la calidad de datos dentro de una organización
El coste real de la mala calidad de datos para las organizaciones
Cómo la mala calidad de datos socava decisiones, confianza e IA
Cómo construyen las organizaciones una calidad de datos y observabilidad fiables
Ejemplos reales del impacto de la calidad de datos por sector
Introducción: por qué la calidad de datos determina el éxito organizativo
Una previsión puede fallar aunque el cálculo sea correcto. Supongamos que un equipo de planificación espera un aumento de pedidos y programa inventario, personal y transporte en consecuencia. La previsión usa un modelo válido, pero un sistema regional envía tarde las transacciones del día anterior y otro registra devoluciones bajo una categoría modificada. El equipo de planificación no mira un disparate. Mira datos que ya no representan al negocio en su conjunto.
Esa distinción importa. La mayoría de las decisiones organizativas dependen de que varios sistemas encajen: registros de clientes, pedidos, pagos, inventario, interacciones de servicio, datos de personal e información externa. Un defecto en un flujo puede alterar el significado de un resultado combinado. Finanzas puede ver ingresos que no cuadran, atención al cliente puede contactar con la persona equivocada y la dirección puede dedicar una reunión a debatir qué hoja de cálculo tiene razón en lugar de decidir qué hacer.
Los problemas de calidad cruzan las fronteras funcionales
La calidad de datos afecta a todos los equipos que consumen información:
Finanzas la usa para cierres, planificación, controles e informes.
Operaciones depende de registros completos y puntuales para coordinar el trabajo.
Ventas y marketing necesitan datos de clientes y cuentas consistentes para priorizar oportunidades.
Atención al cliente depende de identidades, historiales y detalles de casos exactos.
Riesgo y cumplimiento requieren evidencia trazable que respalde obligaciones formales.
Los equipos de datos e IA necesitan entradas fiables para paneles, modelos y flujos automatizados.
El equipo de datos puede detectar el defecto, pero a menudo es el negocio quien absorbe la consecuencia. Una entrega tardía se convierte en una decisión operativa perdida. Una cuenta duplicada se convierte en un trato confuso al cliente. Una columna renombrada puede hacer que un informe posterior muestre una medida vacía o engañosa sin producir un error evidente.
Regla práctica: trate cada conjunto de datos crítico como parte de un proceso operativo, no como un activo técnico pasivo.
Las organizaciones suelen iniciar el trabajo de calidad tras un incidente visible. Un informe se rompe, un regulador pide evidencia o un modelo produce un resultado inverosímil. Esa reacción es comprensible, pero deja a los responsables pagando el descubrimiento, la investigación, la corrección y la comunicación en el punto más caro del ciclo de vida.
Un enfoque más sólido plantea las preguntas antes. ¿Quién es propietario de los datos? ¿Qué significa «completo» para este caso de uso? ¿Cuán frescos deben ser? ¿Qué cambios deben detener un pipeline y cuáles solo generar un aviso? Una vez explícitas esas respuestas, la calidad de datos pasa a ser algo que la organización puede gestionar en lugar de algo que solo puede debatir.
Qué significa la calidad de datos dentro de una organización
Piense en los datos corporativos como en un sistema de suministro de agua. La información nace en muchas fuentes, pasa por puntos de tratamiento y distribución y llega finalmente a un grifo donde alguien la usa. Un vaso de aspecto limpio no demuestra que toda la cadena de suministro esté sana. La organización también necesita saber si el agua llegó a tiempo, si entraron contaminantes aguas arriba y si la presión basta para el uso previsto.
Con la calidad de datos ocurre lo mismo. Un conjunto de datos es idóneo cuando reúne las características que exige una decisión o un proceso concretos. Un informe estratégico mensual puede tolerar un breve retraso, mientras que un proceso de fraude o una alerta operativa no. Un conjunto de entrenamiento de IA puede requerir un linaje sólido y etiquetas consistentes además de las cualidades esperadas en un panel.
Seis comprobaciones hacen práctica la calidad
Empiece por las dimensiones que describen si los datos pueden sostener un uso con seguridad:
Exactitud significa que el valor refleja aquello que representa en el mundo real. La dirección actual de un cliente debería indicar dónde se le puede localizar.
Completitud significa que no falta información crítica. Un pedido sin identificador de producto puede existir en el sistema, pero no sostiene un análisis de producto fiable.
Consistencia significa que los sistemas relacionados usan valores y definiciones compatibles. Si un equipo marca a un cliente como activo y otro mantiene un estado contradictorio, el registro combinado no se puede interpretar con confianza.
Puntualidad significa que la información llega y se mantiene vigente cuando el proceso la necesita. Un valor correcto entregado después de la ventana de decisión puede ser igualmente inútil en la operación.
Validez significa que los datos siguen los formatos, rangos y reglas de negocio exigidos. Una fecha, un identificador o una categoría pueden estar presentes y aun así incumplir las reglas necesarias para procesarlos.
Unicidad significa que la organización no cuenta varias veces la misma entidad real. Los registros duplicados de clientes o transacciones pueden distorsionar volumen, valor y priorización.

La idoneidad importa más que la perfección
Ninguna organización necesita que todos los campos sean perfectos antes de operar. La pregunta útil es si los datos son lo bastante fiables para su propósito, con limitaciones conocidas y responsables identificados. Un flujo de atención al cliente puede priorizar la exactitud y la completitud de la identidad, mientras que un informe de tendencias para dirección prioriza la consistencia y la comparabilidad histórica.
Por eso los requisitos de calidad deberían definirse con los usuarios de negocio. Pregunte qué decisión sostienen los datos, cuánto costaría un fallo, con qué rapidez debe detectarse un problema y qué evidencia necesitan los usuarios para confiar en el resultado. El significado de la calidad de datos se aclara cuando los equipos conectan cada dimensión con un proceso real en lugar de tratarla como una puntuación abstracta.
El coste real de la mala calidad de datos para las organizaciones
La mala calidad de datos genera pérdidas visibles, como pagos incorrectos o informes fallidos. Su mayor coste suele aparecer como fricción acumulada. Los analistas concilian archivos a mano, los ingenieros investigan cambios inexplicables en los pipelines y los responsables retrasan decisiones mientras los equipos verifican cifras. Los equipos comerciales pierden la confianza en registros que deberían guiar su acción.
IBM cita una investigación de Gartner que estima que las organizaciones pierden una media de 12,9 millones de USD al año por la mala calidad de datos, según recoge el análisis de IBM sobre el coste de la mala calidad de datos. El mismo análisis señala que el 43 % de los directores de operaciones sitúa los problemas de calidad de datos como su prioridad de datos más importante. Más de una cuarta parte de las organizaciones estima pérdidas anuales superiores a 5 millones de USD, mientras que un 7 % declara pérdidas de 25 millones de USD o más.
Estas cifras describen una exposición de escala empresarial, pero el mecanismo resulta familiar en organizaciones de cualquier tamaño. Un registro defectuoso genera retrabajo. El retrabajo consume capacidad, y la capacidad perdida retrasa iniciativas que deberían generar valor. Los equipos también pueden estimar su exposición con esta calculadora del coste del data downtime.
La factura va más allá de la corrección
El informe ejecutivo de 2024 de Anomalo indica que el 95 % de los directivos había sufrido un problema de calidad de datos con impacto directo en los resultados del negocio, según el State of Enterprise Data Quality report. El impacto puede adoptar varias formas:
Esfuerzo manual: los equipos comparan extractos, reparan registros y explican discrepancias en lugar de mejorar productos o servicios.
Fuga de ingresos: una información incorrecta de cliente, producto o cuenta puede impedir que la oferta, la factura o el seguimiento correctos lleguen al lugar adecuado.
Latencia en las decisiones: los responsables esperan a la conciliación antes de aprobar acciones, lanzamientos o inversiones.
Freno a la transformación: los programas de modernización se atascan cuando las definiciones antiguas y las plataformas nuevas producen resultados contradictorios.
Costes de control: los equipos de cumplimiento y auditoría dedican más tiempo a reunir evidencia e investigar excepciones.
Un informe de 2025 sobre gestión de datos de CRM halló que el 76 % de las organizaciones consideraba que menos de la mitad de sus datos de CRM eran exactos y completos. El mismo informe señala que un 37 % identificó la mala calidad de datos como causa directa de pérdida de ingresos y otro 37 % afirmó que retrasó iniciativas clave generadoras de ingresos, según la nota de Validity sobre el State of CRM Data Management 2025.
Por qué los costes se acumulan
Los defectos de datos rara vez se quedan en el sistema donde nacen. Un identificador ausente puede romper un join, distorsionar una métrica, alterar una previsión e influir en una decisión de plantilla o inversión. Cada equipo posterior puede entonces aplicar su propia corrección, multiplicando el esfuerzo original.
Investigación independiente citada en literatura reciente reporta pérdidas medias anuales de unos 12,9 millones de dólares por organización. Otros estudios estiman que los datos defectuosos pueden consumir entre el 15 % y el 25 % de los ingresos en muchas empresas mediante retrabajo, corrección de errores, oportunidades perdidas y decisiones erróneas, como se expone en la investigación publicada sobre los costes de la calidad de datos.
La pregunta de inversión es por tanto más amplia que el coste de una plataforma de calidad. Las organizaciones también financian trabajo de corrección recurrente, decisiones retrasadas, actividad de control y la exposición creada cuando la propiedad, la puntualidad o los cambios de esquema pasan inadvertidos.
Cómo la mala calidad de datos socava decisiones, confianza e IA
Un panel financiero muestra ingresos al alza, así que la dirección aprueba nuevas contrataciones. Más tarde, el equipo descubre que una tabla de origen llegó tarde y excluyó transacciones recientes. Nada parecía roto en pantalla. Aun así, la decisión se apoyó en evidencia incompleta.
Un informe puede representarse con normalidad mientras su significado ha cambiado. Un campo renombrado, un esquema alterado o una definición de negocio revisada pueden atravesar el pipeline sin error evidente. El resultado es más peligroso que un informe vacío, porque las cifras familiares animan a actuar antes de que nadie investigue.
Entonces la confianza se debilita en toda la organización. Los directivos cuestionan las métricas oficiales, los analistas defienden cifras que no crearon y los equipos mantienen hojas de cálculo propias o explicaciones verbales para cubrir huecos. La calidad de datos se ha convertido en una cuestión de control organizativo, no en una simple preocupación de panel.
Los fallos silenciosos dañan la confianza
Varias vías de fallo merecen atención:
Los datos obsoletos hacen que las condiciones actuales parezcan históricas.
La deriva de esquema cambia campos, tipos o estructuras que los usuarios posteriores pueden interpretar mal.
La entrega incompleta elimina parte de una población o de un periodo de reporte de una medida.
Los cambios de distribución no observados hacen que los datos se comporten de forma distinta a la línea base que usa un informe o un modelo.
Las definiciones inconsistentes permiten que dos equipos creíbles den respuestas distintas a la misma pregunta de negocio.
La investigación y la literatura del sector asocian los datos defectuosos con menor exactitud en las decisiones, menor confianza en los informes y respuestas más lentas. Una fuente basada en encuestas identificó la calidad de datos como la segunda barrera más citada para obtener valor de los datos y la analítica. Otra indicó que el 91 % de los líderes afirmó que invertir en calidad de datos influyó positivamente en el crecimiento del negocio, según resume O'Reilly en su análisis de la calidad de datos.
Estos fallos también crean lagunas de control. Si nadie es propietario de una definición, vigila la frescura o revisa los cambios de esquema, la organización puede ser incapaz de explicar por qué cambió una cifra o de demostrar qué datos respaldaron una decisión.
La IA eleva el listón
Los sistemas de IA reutilizan datos a gran velocidad y escala. Un modelo puede aprender de registros incompletos, un agente puede consultar una columna renombrada y un flujo automatizado puede actuar sobre un estado obsoleto. La salida puede sonar segura mientras su evidencia es errónea. Para una explicación práctica de esta dependencia, vea por qué los modelos de IA dependen de la calidad de datos.
ISO/IEC 5259-5:2025 presenta la gobernanza de la calidad de datos como un marco organizativo a lo largo del ciclo de vida del dato para analítica y aprendizaje automático, tal como describe la presentación de la norma ISO/IEC 5259-5:2025. La pregunta ejecutiva va por tanto más allá de la exactitud del panel: quién gobernó los datos, qué controles se aplicaron y si siguieron siendo idóneos para el entrenamiento, la inferencia y la evidencia regulatoria.
Idea de gobernanza: el riesgo de la IA empieza aguas arriba, donde los equipos definen, recogen, transforman, describen y aprueban los datos que usará un sistema automatizado.
La calidad funciona como un plano de control que conecta la corrección operativa, la confianza en las decisiones, la evidencia de cumplimiento y la responsabilidad sobre la IA. Vigilar solo las salidas del modelo o la disponibilidad del panel equivale a observar la última etapa cuando los fallos previos ya pueden haber pasado inadvertidos.
Cómo construyen las organizaciones una calidad de datos y observabilidad fiables
La limpieza reactiva y la observabilidad proactiva resuelven problemas distintos. La limpieza repara defectos conocidos después de que lleguen a un consumidor. La observabilidad ayuda a los equipos a entender qué cambió, cuándo cambió, qué activos están afectados y si el comportamiento difiere de una línea base esperada.
Un programa sostenible usa ambas, pero sitúa la prevención y la detección temprana más cerca del origen. El objetivo no es crear reglas sin fin. Es explicitar las expectativas importantes, vigilarlas de forma continua y dirigir los fallos a quienes pueden corregirlos.
Empiece por la propiedad y el propósito
Asigne un propietario a cada dominio de datos crítico. Ese propietario debería trabajar con ingenieros de datos, analistas, equipos de riesgo y usuarios operativos para definir la calidad aceptable de los procesos que dependen de los datos.
Un registro de propiedad útil incluye:
Propósito de negocio: ¿qué decisión, interacción con el cliente, control o modelo usa el conjunto de datos?
Expectativas de calidad: ¿qué campos deben ser completos, válidos, consistentes, únicos, exactos o puntuales?
Nivel de impacto: ¿qué ocurre si el conjunto de datos es erróneo o llega tarde?
Vía de respuesta: ¿quién investiga, quién aprueba una solución temporal y quién confirma la resolución?
Evidencia: ¿qué comprobaciones, detalles de linaje y registros de incidentes demuestran el control?
Sin propiedad, la monitorización se convierte en un servicio de notificaciones. Llegan alertas, pero nadie tiene la autoridad ni el contexto para decidir si el problema importa.
Compare la limpieza reactiva con el control continuo
Limpieza reactiva | Calidad y observabilidad proactivas |
|---|---|
Encuentra defectos después de que un informe o un usuario los note | Detecta comportamientos inusuales antes del uso posterior |
Se centra en registros concretos o reglas conocidas | Combina la validación con señales de frescura, volumen, linaje y esquema |
Repara síntomas aguas abajo | Ayuda a los equipos a corregir problemas en el origen |
Produce explicaciones puntuales | Construye evidencia repetible para gobernanza y auditoría |
Mide incidentes tras la interrupción | Sigue patrones y degradación a lo largo del tiempo |
Las comprobaciones continuas deberían cubrir reglas de negocio a nivel de registro, tiempos de entrega, comportamiento del volumen y cambios estructurales. La ejecución dentro de la base de datos también permite mantener los datos en el entorno del cliente mientras las métricas y los análisis se ejecutan donde los datos ya residen.
Use la observabilidad como capa operativa compartida
digna ofrece una plataforma modular de calidad de datos y observabilidad que se ejecuta dentro del propio entorno del cliente. Sus capacidades incluyen detección de anomalías, análisis histórico de métricas, monitorización de Timeliness, validación a nivel de registro, seguimiento de cambios de esquema, ejecución en base de datos, despliegue privado u on-premises y un panel compartido para ingenieros de datos, analistas y partes interesadas. Los equipos pueden conocer más sobre la observabilidad de datos como disciplina operativa y evaluar después qué controles encajan con su arquitectura y su perfil de riesgo.
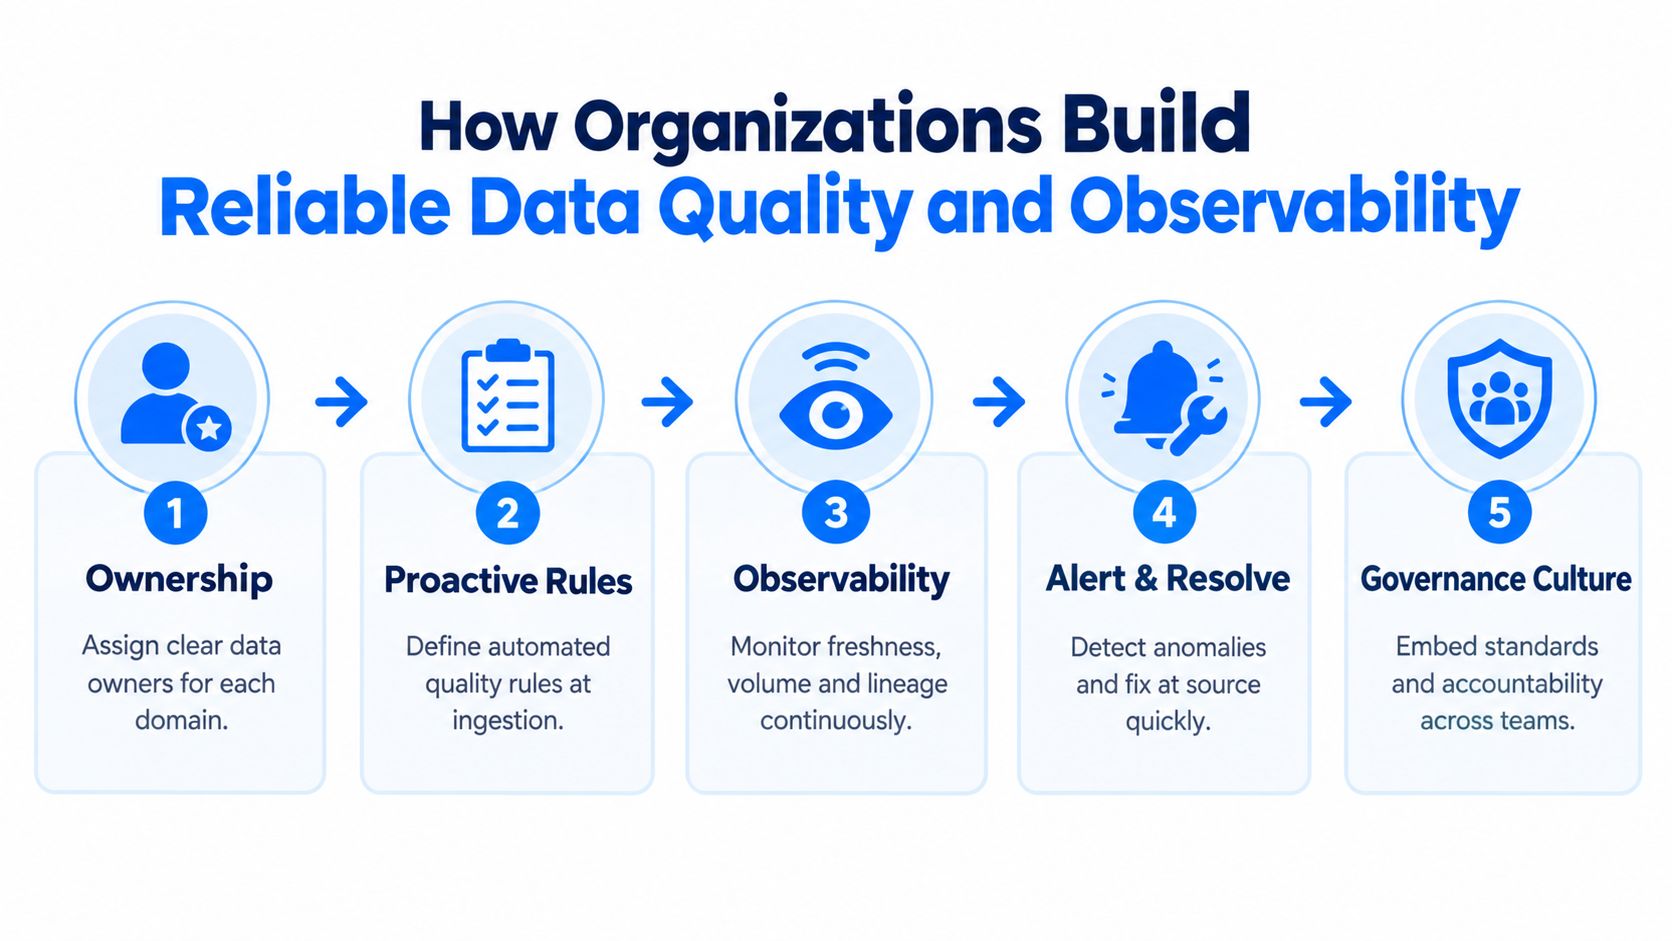
La plataforma es solo una parte del programa. Los líderes siguen necesitando definiciones claras, acuerdos de respuesta e incentivos que premien la prevención en lugar de la reparación silenciosa aguas abajo. La observabilidad da visibilidad a las personas. La gobernanza les da autoridad y responsabilidad.
Ejemplos reales del impacto de la calidad de datos por sector
Las mismas dimensiones de calidad crean riesgos distintos según el sector. Un feed de transacciones tardío puede afectar a los informes de riesgo en servicios financieros, mientras que un valor clínico ausente puede afectar a la coordinación asistencial en sanidad. El patrón de control sigue siendo reconocible, pero cambian la consecuencia de negocio y la evidencia exigida.
Servicios financieros
Un banco puede depender de datos de transacciones, clientes, riesgo y regulación que atraviesan varias plataformas. Si un cambio de esquema altera el tipo de un campo o un feed llega tarde, los equipos de reporting concilian cifras a mano mientras los de riesgo dudan de si usan la misma población. Los controles de calidad deben validar reglas de negocio, seguir las entregas, detectar patrones inusuales y conservar evidencia de qué cambió y cómo respondió la organización.
Sanidad
Las organizaciones sanitarias combinan registros clínicos, administrativos, de facturación y operativos. Los identificadores inconsistentes pueden separar eventos relacionados, mientras que la información incompleta o retrasada dificulta entender a un paciente o un episodio asistencial. Aquí la completitud y la consistencia sostienen una coordinación segura, mientras que la puntualidad y la trazabilidad sostienen los procesos operativos y regulatorios.
Telecomunicaciones
Los equipos de telecomunicaciones trabajan con datos de clientes, red, facturación y uso de gran volumen. Un cambio repentino en el volumen de registros puede indicar un problema de pipeline, un cambio en el sistema de origen o un movimiento real de la actividad. Vigilar la entrega esperada, el comportamiento inusual y los cambios estructurales ayuda a distinguir el movimiento del negocio del fallo de datos antes de que informes o flujos operativos reaccionen mal.
Sector público
Las organizaciones del sector público suelen necesitar combinar registros entre departamentos preservando la auditabilidad y definiciones consistentes. Una laguna en el linaje puede dificultar la explicación de cómo se produjo una cifra. La validación, la propiedad y la evidencia importan porque quienes deciden pueden tener que justificar no solo el resultado, sino también el proceso que lo produjo.
Principio sectorial: el control de calidad adecuado es el que está ligado a una decisión, una obligación o un resultado de servicio reales.
Estos ejemplos muestran también por qué una única puntuación corporativa rara vez cuenta toda la historia. Un conjunto de datos puede ser aceptable para un análisis amplio de tendencias e inadecuado para un cálculo regulado. Los programas de calidad deberían clasificar los datos por uso, riesgo y respuesta exigida en lugar de aplicar un umbral universal.
Construir una mentalidad de calidad de datos duradera
Un programa duradero de calidad de datos se apoya en tres hábitos: propiedad, visibilidad continua y responsabilidad de negocio.
Propiedad significa que cada conjunto de datos crítico tiene una persona o un equipo nombrados como responsables de su definición, su condición aceptable y su vía de resolución. Esa responsabilidad no debería desaparecer cuando los datos pasan de un sistema operativo a un almacén, un lago, un panel, un modelo o un flujo de IA.
Visibilidad continua significa que los equipos vigilan más que reglas de aprobado o suspenso. Observan frescura, volumen, completitud, validez, comportamiento inusual y cambio estructural. También conservan suficiente linaje y contexto de incidentes para explicar a qué consumidores puede afectar.
Responsabilidad de negocio significa que las medidas de calidad se conectan con resultados. En lugar de informar solo de que una comprobación falló, los equipos deberían explicar si el fallo amenaza un proceso de cliente, un control financiero, una presentación regulatoria, una previsión o un caso de uso de IA.
Una lista práctica de arranque tiene este aspecto:
Elija los activos críticos: identifique los conjuntos de datos que sostienen decisiones y obligaciones importantes.
Defina la idoneidad: acuerde qué significan exacto, completo, consistente, válido, único y puntual para cada uso.
Asigne la respuesta: establezca quién recibe las alertas y quién puede resolver los problemas en el origen.
Monitorice de forma continua: detecte la degradación antes de que llegue a informes, modelos o acciones automatizadas.
Revise el valor: mida la reducción del retrabajo, la resolución más rápida, una evidencia más sólida y una mayor confianza en la analítica.
La lección central es sencilla. La calidad de datos no es un pulido final antes de informar. Es la capa de control que ayuda a una organización a decidir de forma responsable, demostrar cumplimiento y usar IA sin ceder el criterio a entradas poco fiables.
digna ayuda a las organizaciones a monitorizar el comportamiento de los datos, validar registros, seguir la Timeliness, detectar cambios de esquema y observar métricas de negocio y de plataforma dentro de su propio entorno. Visite digna para ver cómo su plataforma modular de calidad de datos y observabilidad puede sostener una base más fiable para la analítica y la IA.
Para el modelo operativo que convierte estas expectativas en controles continuos en lugar de limpiezas periódicas, consulte la gestión de la calidad de datos.
Preguntas frecuentes
¿Qué cuesta la mala calidad de datos a una organización?
IBM cita a Gartner con una pérdida media de 12,9 millones de USD al año. Más de una cuarta parte de las organizaciones estima pérdidas anuales superiores a 5 millones de USD y un 7 % declara 25 millones o más, mientras que el 43 % de los directores de operaciones sitúa la calidad de datos como su mayor prioridad.
¿Por qué causan tanto daño los defectos pequeños?
Porque viajan. Un campo ausente, un extracto obsoleto, una definición inconsistente o un cambio de esquema inadvertido llega a previsiones, informes regulatorios, flujos con clientes y sistemas de IA antes de que nadie lo relacione con el origen. La pérdida visible es el retrabajo; la mayor, la fricción acumulada y las decisiones retrasadas.
¿Son lo mismo la calidad de datos y la observabilidad de datos?
Responden a preguntas distintas. La limpieza repara defectos conocidos cuando un consumidor ya los ha visto, mientras que la observabilidad explica qué cambió, cuándo, qué activos se ven afectados y si el comportamiento difiere de una línea base esperada. Un programa duradero usa ambas, pero acerca prevención y detección al origen.
¿Por dónde debería empezar una organización?
Por la propiedad, no por las reglas. Asigne un propietario a cada dominio de datos crítico y registre después el propósito de negocio, las expectativas de calidad por campo, el nivel de impacto si los datos son erróneos o tardíos y la vía de respuesta que nombra a quien investiga, quien aprueba una solución temporal y quien confirma la resolución.
¿El riesgo es distinto según el sector?
Las dimensiones de calidad se mantienen; la consecuencia no. En servicios financieros, un feed tardío o un tipo de campo alterado obliga a conciliar a mano en los informes de riesgo. En sanidad, los identificadores inconsistentes separan eventos relacionados y retrasan la coordinación asistencial. La evidencia que debe conservarse la marca el regulador, no el pipeline.



