Orquestación de pipelines: Una guía práctica para datos confiables
|
6
minuto de lectura

Puede tener un almacén lleno de datos, un programador que nunca se pierde un cron y, aun así, despertarse con un panel ejecutivo desactualizado. El archivo llegó tarde. Un trabajo ascendente falló a medias. Nadie se dio cuenta hasta que alguien preguntó por qué los números de anoche no coincidían con la realidad de esta mañana. Esa brecha entre "el trabajo se ejecutó" y "el resultado es confiable" es donde la orquestación de pipelines comienza a importar.
Solo después de un incidente muchos equipos reconocen esa brecha. Para entonces, el problema ha crecido más allá de una ejecución perdida, porque los informes, modelos y alertas descendentes se han construido sobre datos incompletos o tardíos. La orquestación coordina los pasos, las dependencias, los reintentos y el monitoreo que mantienen la coherencia de un pipeline cuando la pila está distribuida y la falla es parcial, no total, razón por la cual se convirtió en un elemento central a medida que los flujos de trabajo de datos se extendieron por los sistemas en la nube y de analítica (Atlan sobre patrones de orquestación de pipelines).
Tabla de contenidos
El problema del pipeline de las 3 a. m. que ya conoce
Un panel se desactualiza y la primera reacción suele ser culpar al almacén, a la capa de BI o al analista que lo notó. El problema principal suele ser más mundano: una carga ascendente llegó tarde, faltaba un archivo o una partición nunca se rellenó. Si nada en la pila está vigilando esa condición, el pipeline puede parecer saludable mientras produce un resultado incompleto.
Esa es la razón por la que la gente busca la orquestación de pipelines después de un incidente. El orquestador se sitúa entre los trabajos sin procesar y los resultados confiables, y decide qué se ejecuta, qué espera, qué se reintenta y qué se detiene cuando algo se rompe en una etapa anterior. En los sistemas de producción, esa capa de control preserva el estado del ciclo de vida a través de los pasos distribuidos, gestiona los reintentos y rellenos, y bloquea las transformaciones descendentes cuando los datos prerrequisito no están listos (DataOps School sobre orquestación de pipelines).
Regla práctica: si un consumidor descendente no puede distinguir entre "tarde", "faltante" y "fallido", su plano de control es demasiado delgado.
Aquí también es donde muchos equipos sobreestiman lo que les ofrece su programador actual. Un temporizador que lanza un trabajo no es lo mismo que un sistema que hace cumplir las dependencias, maneja fallas parciales y registra el historial de ejecución de una manera en que los operadores puedan actuar. El modelo mental correcto es simple: la orquestación es la capa de coordinación, no la capa de transformación, y esa distinción importa cuando la pila está bajo estrés.
Definición de orquestación de pipelines
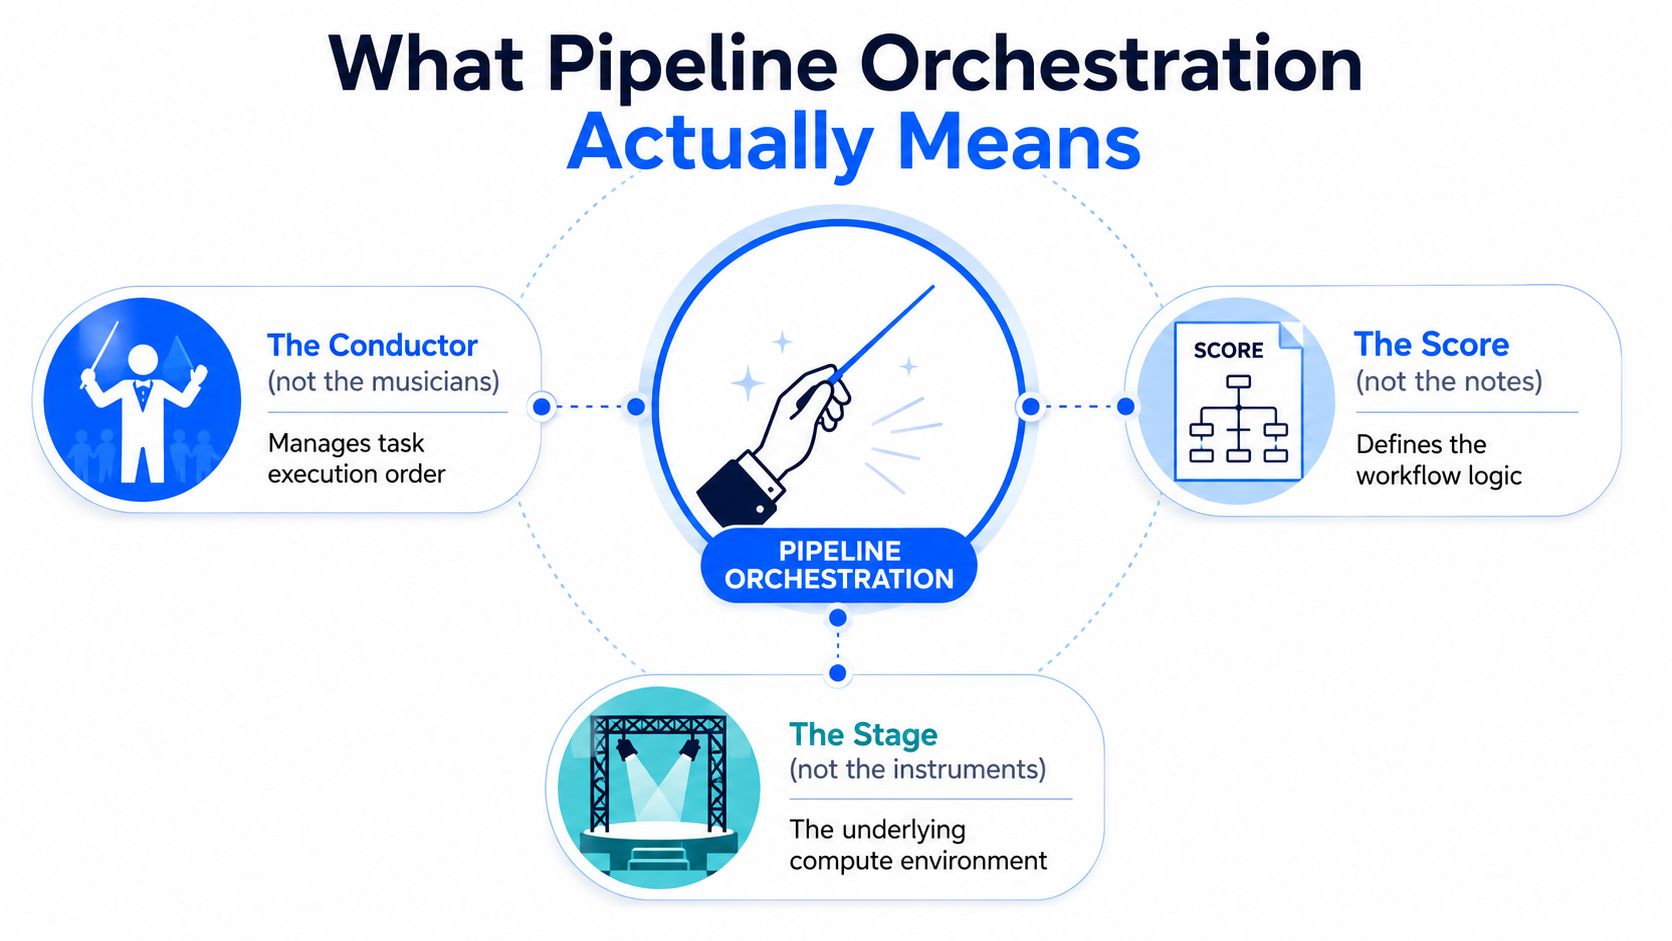
Un pipeline puede mover datos y aun así fallarle al negocio. Un archivo llega tarde, se omite una partición o un modelo descendente comienza antes de que termine la carga ascendente, y el panel sigue pareciendo normal hasta que alguien confía en él. La orquestación es la capa de control que decide qué paso se ejecuta, qué paso espera y qué paso se detiene cuando la condición ascendente no es la adecuada.
La definición práctica de la orquestación de pipelines es la capa que decide cuándo, en qué orden y bajo qué condiciones se ejecuta cada paso de un pipeline de datos, al tiempo que aplica dependencias, gestiona fallas y monitorea la ejecución en todos los sistemas conectados (Beta Systems sobre orquestación de pipelines de datos). Se sitúa por encima de los motores de ejecución como Spark, dbt o los trabajos nativos del almacén, y por debajo de la lógica de negocio que depende de datos confiables.
Una forma útil de separar las piezas es esta. La orquestación coordina el trabajo, mientras que la observabilidad les dice a los operadores si el trabajo produjo datos en los que pueden confiar. En entornos de nube privada y locales, esa división importa aún más porque el acceso a los datos gestionado por el proveedor suele ser limitado, por lo que la plataforma tiene que extraer el estado de salud de los registros, el estado de las tareas, las comprobaciones de frescura, las comprobaciones de recuento de filas y otras señales que se pueden recopilar dentro de su propio límite. Si esas señales no se diseñan juntas, el orquestador puede saber que un trabajo terminó, mientras que el equipo aún no puede saber si el resultado es seguro de usar.
Lo que hace y lo que no hace
Las tareas principales son sencillas. Programa el trabajo, espera las dependencias ascendentes, reintenta las tareas fallidas, rellena rangos históricos y reacciona a eventos externos como la llegada de un archivo o un mensaje en una cola. Esos son problemas de coordinación, no de transformación.
La separación importa en producción porque los equipos a menudo intentan que una sola herramienta lo haga todo. El resultado son DAGs frágiles, trabajos de gran tamaño y fallas que toman demasiado tiempo en diagnosticarse. Un mejor diseño mantiene la orquestación centrada en el flujo de control, permite que los motores de cómputo manejen la transformación y le da a la capa de observabilidad un trabajo claro: identificar si los datos están actualizados, completos y consistentes antes de que actúen los consumidores descendentes.
La orquestación responde a la pregunta: "¿debería ejecutarse este paso ahora?". No responde a: "¿son los datos lo suficientemente buenos como para confiar en ellos?".
Los componentes principales de un orquestador
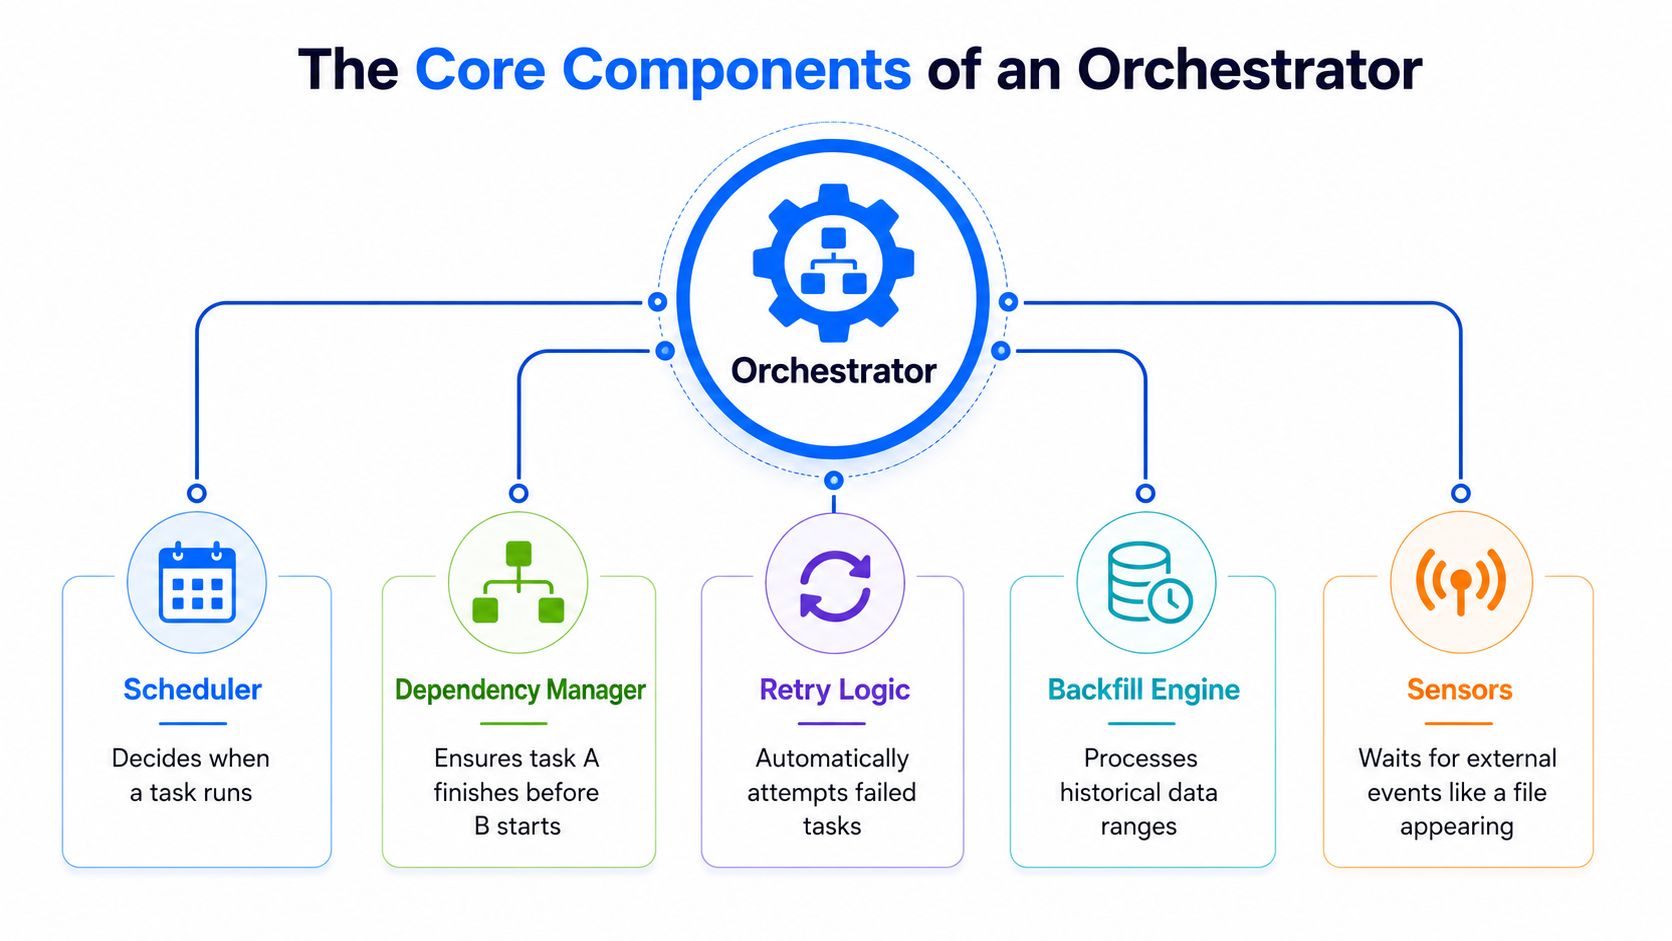
Un pipeline puede estar lleno de trabajos y aun así fallar en el punto que importa: la producción. Lo que separa a un calendario de un orquestador es el estado, el conocimiento de las dependencias y la gestión de fallas. En la práctica, eso significa que el plano de control tiene que saber qué se ejecutó, qué está bloqueado, qué se puede reintentar de manera segura y qué debería esperar a una partición ascendente tardía antes de contaminar el resultado descendente.
Esa elección de diseño importa aún más en entornos de nube privada y locales, donde no se puede confiar en el acceso a los datos gestionado por el proveedor para explicar qué sucedió después del hecho. Los equipos necesitan señales que puedan recopilar dentro de su propio límite, por lo que la orquestación y la observabilidad tienen que diseñarse juntas. Si el orquestador solo sabe que una tarea finalizó, pero la plataforma no puede confirmar la frescura, la completitud o la consistencia, los operadores terminan adivinando a las 3 a. m.
Programación y gestión de dependencias
La programación decide cuándo una tarea pasa a ser apta para ejecutarse. La gestión de dependencias decide si se le permite ejecutarse. En un pipeline de almacén, la ingesta de datos brutos debe terminar antes de que comience la transformación, y la transformación debe terminar antes de que un paso de publicación escriba en el esquema de informes. Eso suena simple hasta que aparece una partición tardía en medio de una ventana de lanzamiento.
El valor de control aquí es causal. Si una extracción ascendente falla, el trabajo descendente se puede bloquear o reprogramar en lugar de producir una tabla parcial que parece válida a primera vista. Esa es la diferencia entre un sistema de control y un montón de trabajos independientes.
Reintentos, rellenos (backfills) y sensores
Los reintentos son para fallas transitorias, no para ocultar defectos de diseño. Un reintento controlado puede salvar una ejecución cuando una dependencia falla una vez. Si el mismo paso falla todas las noches, el problema está en el diseño del pipeline o en el sistema de origen, no en la política de reintentos.
Los rellenos (backfills) manejan la corrección histórica sin tener que volver a ejecutar todo el gráfico. Esto importa cuando los datos que llegan tarde afectan a un rango de fechas limitado, porque la solución más limpia suele ser recalcular solo las particiones afectadas.
Los sensores cierran la brecha entre la orquestación basada en el tiempo y la basada en eventos. Pueden esperar un archivo, un objeto u otra señal externa antes de desencadenar el trabajo descendente. En un patrimonio mixto, eso importa porque los flujos de lotes, microlotes y en tiempo casi real rara vez comparten la misma tolerancia a la latencia.
Un orquestador moderno debería admitir tanto desencadenadores basados en el tiempo como desencadenadores basados en eventos, porque los patrimonios que mezclan cargas de almacén, entradas de streaming y llegadas de archivos necesitan ambos estilos de coordinación, y los equipos que comparan opciones de planos de control aún terminan sopesando dbt vs Airflow en esa ruta de decisión (DataOps School sobre orquestación de pipelines).
Patrones y arquitecturas comunes de orquestación
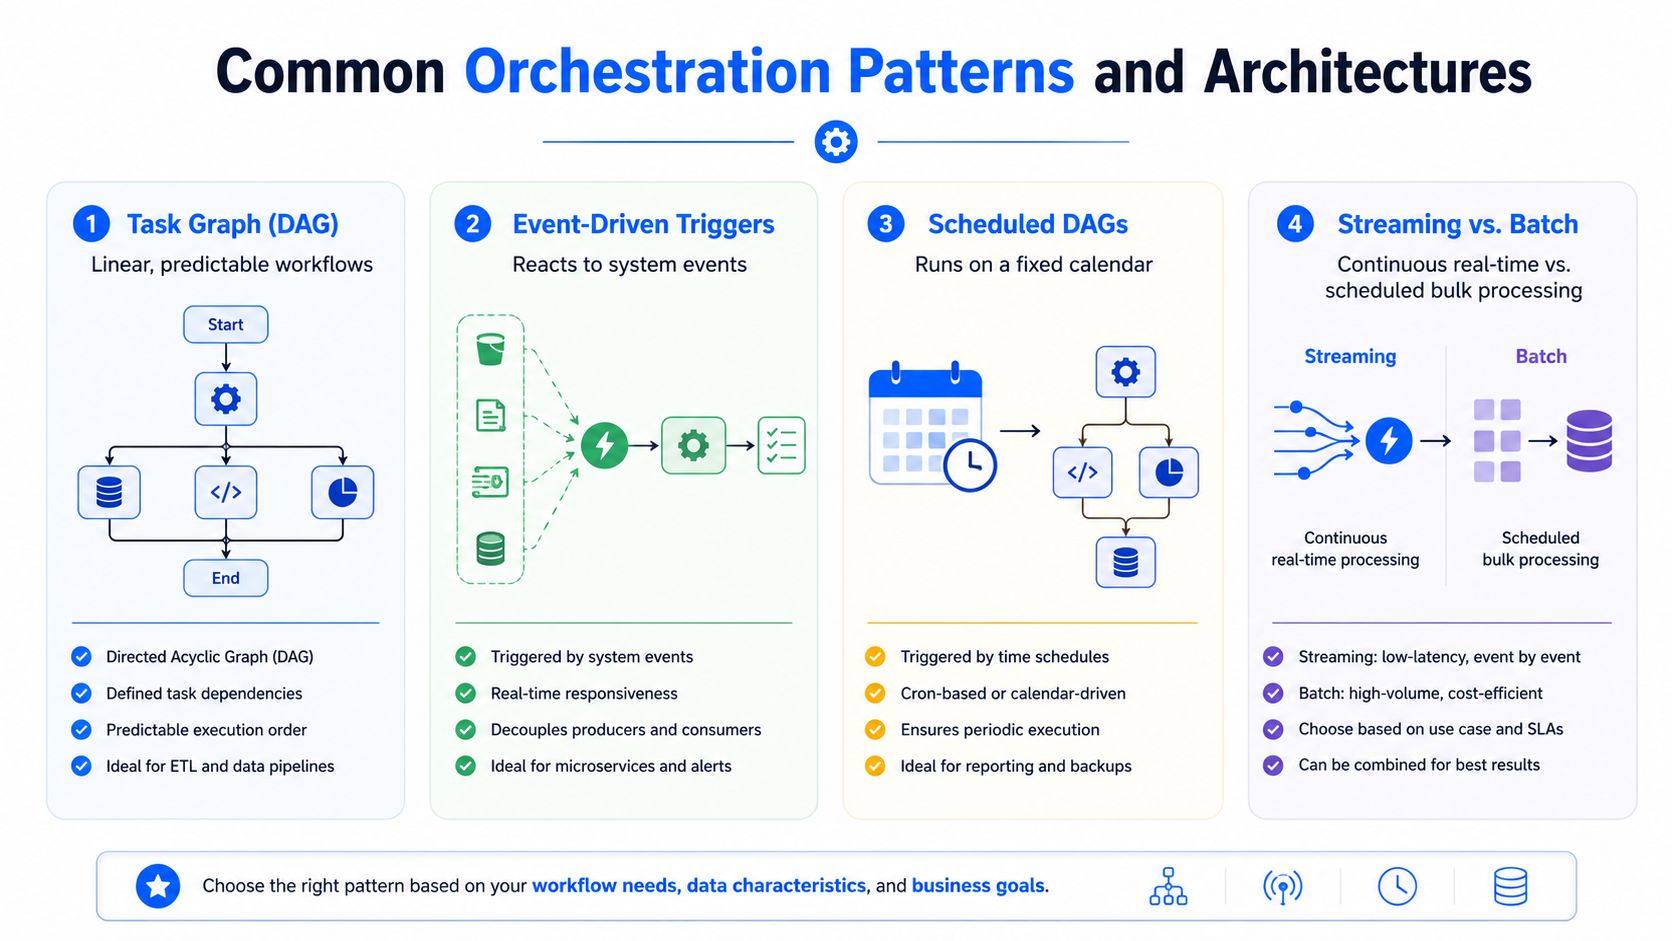
Diferentes formas de pipelines necesitan diferentes patrones de orquestación. Una cadena ETL estrechamente acoplada quiere un orden predecible. Un sistema que reacciona a las llegadas de archivos o mensajes de cola quiere desencadenadores basados en eventos. Una plataforma que mezcla trabajos de almacén y flujos de streaming necesita ambos, a veces en el mismo entorno.
Gráficos de tareas y programación basada en DAG
Los gráficos de tareas funcionan mejor cuando el flujo de trabajo es explícito y el orden importa. Es por eso que los DAG se convirtieron en el modelo mental por defecto para muchos ingenieros de datos: hacen visibles las dependencias y facilitan el razonamiento sobre las fallas. Apache Airflow impulsó ese patrón hacia el uso generalizado, y la mayoría de las pilas de orquestación maduras todavía toman prestada la misma lógica de gráficos incluso cuando la implementación es diferente.
La ventaja práctica es la trazabilidad. Cuando un nodo falla, los operadores pueden ver exactamente qué tareas descendentes se bloquearon y por qué.
Basado en eventos, streaming y lotes (batch)
La orquestación basada en eventos brilla cuando el sistema debe reaccionar a las llegadas de datos en lugar de a un reloj. Un archivo llega, aparece un mensaje, se activa un webhook y el pipeline responde. Ese patrón también es común en configuraciones de nube privada y locales, porque el evento desencadenante a menudo ocurre dentro del límite del cliente, no en un plano de control gestionado por el proveedor.
El streaming cambia la presión del diseño. Los lotes pueden tolerar la latencia a cambio de simplicidad, mientras que el streaming se preocupa por el movimiento continuo y una retroalimentación operativa más estrecha. La mayoría de los patrimonios reales combinan ambos, por lo que el orquestador necesita admitir el comportamiento basado en el tiempo y en eventos de forma simultánea.
Si está comparando el control del flujo de trabajo para sistemas con gran carga de transformación, vale la pena analizar detenidamente la compensación entre el modelado al estilo dbt y el control centrado en la orquestación, y esta guía interna es muy útil: comparación de dbt vs Airflow de digna.
Aspectos operativos que deciden si funciona
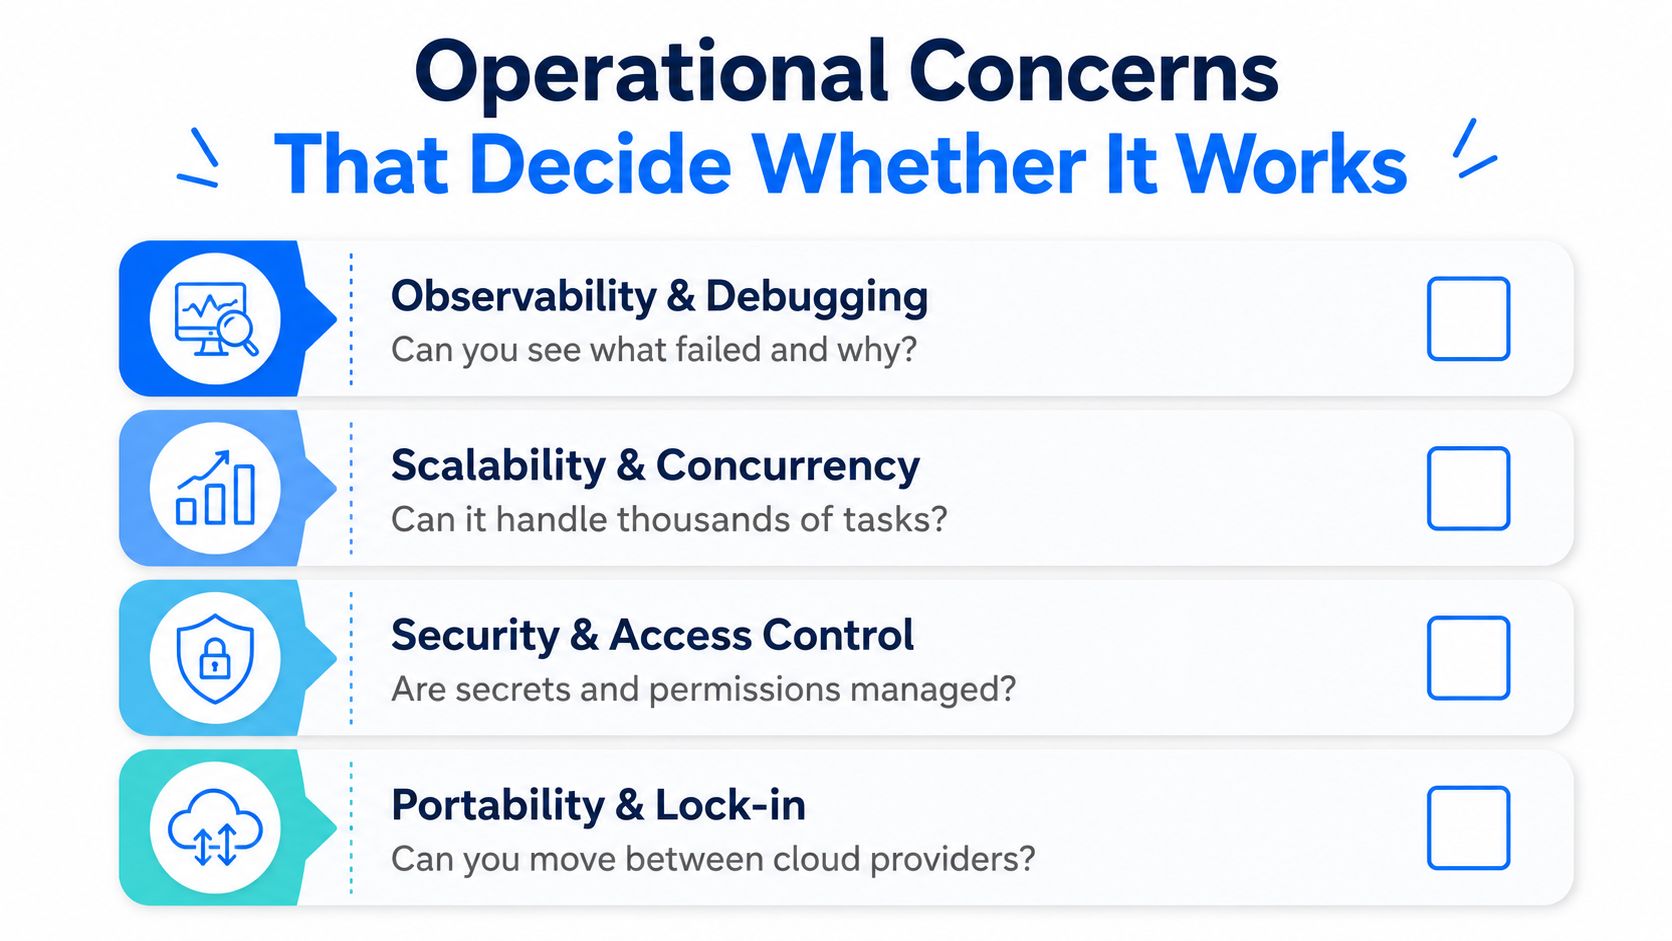
Una herramienta puede lanzar trabajos y aun así fallar como plataforma. La diferencia se nota en cuatro aspectos: escalabilidad, observabilidad, seguridad y multiinquilino (multi-tenancy). En entornos de nube privada y locales, cada uno de ellos tiene bordes más afilados porque no puede recurrir a un plano de control gestionado por el proveedor cuando algo sale mal.
Scalability y Observability
La escalabilidad tiene que ver con cómo se comporta el orquestador cuando el gráfico se vuelve grande, ruidoso o con picos de actividad. Algunos sistemas gestionan bien un puñado de trabajos seleccionados y luego tienen dificultades cuando los equipos añaden docenas de pipelines, sensores y rellenos (backfills). La respuesta no suele ser "más reintentos", sino un mejor control sobre la concurrencia, el estado y el aislamiento de tareas.
La Observability es donde se suele confiar demasiado en muchas pilas de orquestación. El orquestador puede mostrar el historial de ejecución, los registros, el estado del SLA y las alertas en un solo lugar, pero eso aún no le dice si los datos eran correctos. La sección siguiente sobre observabilidad importa porque la orquestación y la confianza en los datos están relacionadas, pero no son idénticas.
Seguridad y despliegue multiinquilino (multi-tenant)
La seguridad tiene que encajar con el modelo de red e identidad que ya utiliza. En despliegues locales y de nube privada, esto significa que las cuentas de servicio, los secretos y las políticas de acceso deben vivir dentro de los límites existentes, no en un plano de control SaaS independiente que ve los datos de producción de forma predeterminada.
La multiinquilinidad se convierte en una preocupación de diseño real una vez que varios equipos comparten la misma capa de orquestación. Los horarios, las credenciales y la visibilidad operativa necesitan un aislamiento claro; de lo contrario, el relleno de un equipo se convierte en el incidente de otro. En la práctica, la arquitectura más segura es la que mantiene el radio de impacto pequeño y los datos de producción residiendo donde la política lo requiere.
Si está construyendo el lado de la observabilidad de ese plano de control, esta referencia interna mapea bien el espacio del problema: data observability de digna.
Por qué la orquestación por sí sola no es suficiente
La orquestación puede decirle que una carga terminó. No puede decirle si la carga terminó con datos erróneos. Esa es la brecha que la mayoría de las guías de pipelines dejan abierta, y es por eso que una plataforma confiable necesita una segunda capa para la calidad y la observabilidad.
La puntualidad es el primer punto ciego. Un pipeline puede ejecutarse con éxito y aun así llegar demasiado tarde para el panel, modelo o informe que alimenta. Los cambios de esquema son otro punto ciego, porque un cambio de tipo de columna o un campo faltante pueden pasar a través de un DAG saludable y solo fallar más tarde en el consumo. La detección de anomalías y la validación detectan diferentes clases de fallos, cambios en la distribución de métricas clave y violaciones de reglas a nivel de registro, los cuales pueden ser invisibles solo para la orquestación.
El patrón de integración práctica es simple. El orquestador emite metadatos de ejecución y señales de contrato, luego una capa de observabilidad de datos consume esas señales y verifica la llegada, la estructura y la calidad antes de que los usuarios descendentes vean el resultado. Esa separación es especialmente importante en despliegues de nube privada y locales, donde los análisis deben realizarse dentro del entorno del cliente y el proveedor no obtiene acceso directo a los conjuntos de datos de producción.
Regla práctica: deje que la orquestación decida si el pipeline se ejecutó y deje que la observabilidad decida si los datos merecen ser publicados.
Aquí también es donde los equipos evitan la falsa confianza. Un DAG en verde no es lo mismo que un conjunto de datos confiable. Si la tabla de origen se retrasa, si el esquema se desvió o si un registro viola una regla de negocio, la respuesta correcta es detener la promoción o poner en cuarentena el resultado, no felicitar al programador por terminar a tiempo.
Ejemplos de arquitectura empresarial que puede adaptar
Una arquitectura útil comienza con el lugar donde viven los datos, no con la herramienta que desea utilizar. En patrimonios nativos de la nube, el orquestador a menudo desencadena transformaciones, emite metadatos y entrega los resultados a una capa de observabilidad que vigila la frescura, el esquema y las anomalías. En entornos regulados, el mismo patrón generalmente tiene que ejecutarse dentro de la infraestructura controlada por el cliente.
Lakehouse nativo de la nube
In un entorno lakehouse, los sistemas de origen depositan los datos en el almacenamiento de objetos o en un área de preparación del almacén. El orquestador coordina el paso de transformación y luego emite metadatos sobre la ejecución, las entradas y la tabla o partición de salida. Esos metadatos son los que utilizan las herramientas de observabilidad para realizar el seguimiento de la frescura y el linaje.
El hábito de diseño importante es no tratar al orquestador como la única fuente de verdad. Debe producir señales que el monitoreo descendente pueda leer, mientras que la capa de calidad valida el resultado de manera independiente.
Nube privada y local (on-prem)
Las arquitecturas locales necesitan el mismo flujo de control, pero el límite es más estrecho. El orquestador y la plataforma de observabilidad tienen que ejecutarse dentro de entornos controlados por el cliente, y los datos de producción deben permanecer allí. Esa es la razón por la que plataformas como digna están diseñadas para ejecutar análisis dentro de la base de datos del cliente, de modo que la puntualidad, los cambios de esquema, las anomalías y la validación a nivel de registro permanezcan dentro del límite.
El patrón también se aplica a los pipelines de ML. La generación de características, la orquestación del entrenamiento, la promoción del registro de modelos y el despliegue necesitan transferencias controladas. Si la transferencia no es confiable, el modelo hereda la misma fragilidad que el almacén.
Un buen diseño empresarial hace que la transferencia sea explícita. Uno débil asume que un trabajo exitoso significa que la siguiente capa puede consumir el resultado de manera segura.
KPIs, prácticas de manuales de procedimientos (runbooks) y cómo es una buena gestión
Una configuración de orquestación confiable debe medirse, no solo admirarse. Los KPIs que más importan son la frescura, la tasa de éxito, la tasa de reintentos, el tiempo medio de detección y el número de infracciones de SLA. La frescura suele reflejar la observabilidad y la puntualidad. La tasa de éxito y la tasa de reintentos reflejan la estabilidad del pipeline. El tiempo medio de detección y las infracciones de SLA muestran si los operadores pueden ver los problemas con la suficiente antelación como para actuar.
KPI | Qué mide | Aspecto operativo | Dónde mirar |
|---|---|---|---|
Frescura | Qué tan actualizados están los datos | Observability | Comprobaciones de llegada, ventanas de entrega |
Tasa de éxito | Con qué frecuencia las ejecuciones se completan limpiamente | Escalabilidad | Historial de ejecución del orquestador |
Tasa de reintentos | Con qué frecuencia las tareas necesitan otro intento | Confiabilidad | Registros de tareas y patrones de fallas |
Tiempo medio de detección | Qué tan rápido se percata de un problema | Observability | Alertas y paneles de anomalías |
Número de infracciones de SLA | Con qué frecuencia la entrega no cumple con la ventana acordada | Puntualidad | Estado de SLA e informes de ejecución |
Antes de un relleno (backfill), verifique el rango de fechas afectado, las dependencias ascendentes y si los consumidores descendentes necesitan una pausa coordinada. Después de una falla, verifique la primera tarea fallida, la forma de los datos ascendentes y si el problema es transitorio o estructural. Si un cambio de esquema está a punto de implementarse, llévelo adelante con comprobaciones de contrato y validación activas, no después de que se rompa el panel.
Los equipos que se mantienen fuera de problemas hacen algunas cosas de manera constante. Mantienen la orquestación y la observabilidad separadas. Limitan el radio de impacto en los despliegues locales y de nube privada. Hacen que los reintentos sean deliberados, no automáticos. También mantienen los datos de producción dentro del entorno al que pertenecen según las políticas.
Si sus pipelines aún dependen de transferencias frágiles, alertas faltantes o un programador que no puede explicar qué se rompió, digna encaja de forma natural en esa brecha. Se ejecuta dentro de entornos controlados por el cliente, vigila la puntualidad, los cambios de esquema, las anomalías y la validación en conjunto, y ofrece a los equipos una forma de confirmar que un pipeline orquestado produjo datos confiables. Visite digna si desea comparar ese modelo con la pila que está ejecutando hoy.



