Optimización de consultas T-SQL: Una guía práctica de rendimiento
|
7
minuto de lectura

Una consulta lenta de SQL Server no suele aparecer con una explicación clara. Llega a producción en forma de un panel que agota el tiempo de espera, un procedimiento almacenado que antes funcionaba bien o un informe que solo falla cuando coincide con el cliente o el rango de fechas adecuado. Por eso, la tsql query optimization funciona mejor cuando empieza con pruebas, no con una reescritura.
Tabla de contenidos
Lectura de planes de ejecución y comprensión del comportamiento del optimizador
Reescritura de consultas con patrones basados en conjuntos y filtrado temprano
Diseño de índices y estrategias de mantenimiento de estadísticas
Resolución de desafíos de Parameter Sniffing y forzado de planes
Abordar la presión de memoria y las restricciones de recursos de la plataforma
Implementación de monitoreo continuo con Observability en la base de datos
Empezar con diagnósticos antes de reescribir nada
La forma más rápida de perder el tiempo es cambiar el SQL antes de saber qué es lo que va lento. En producción, una consulta puede parecer culpable cuando el problema real es la contención compartida, estadísticas desactualizadas o un mal plan almacenado en caché a partir de un valor de parámetro diferente. Un proceso de optimización disciplinado comienza capturando la carga de trabajo exacta, incluidos los parámetros reales, y midiendo la consulta antes de que cambie nada.
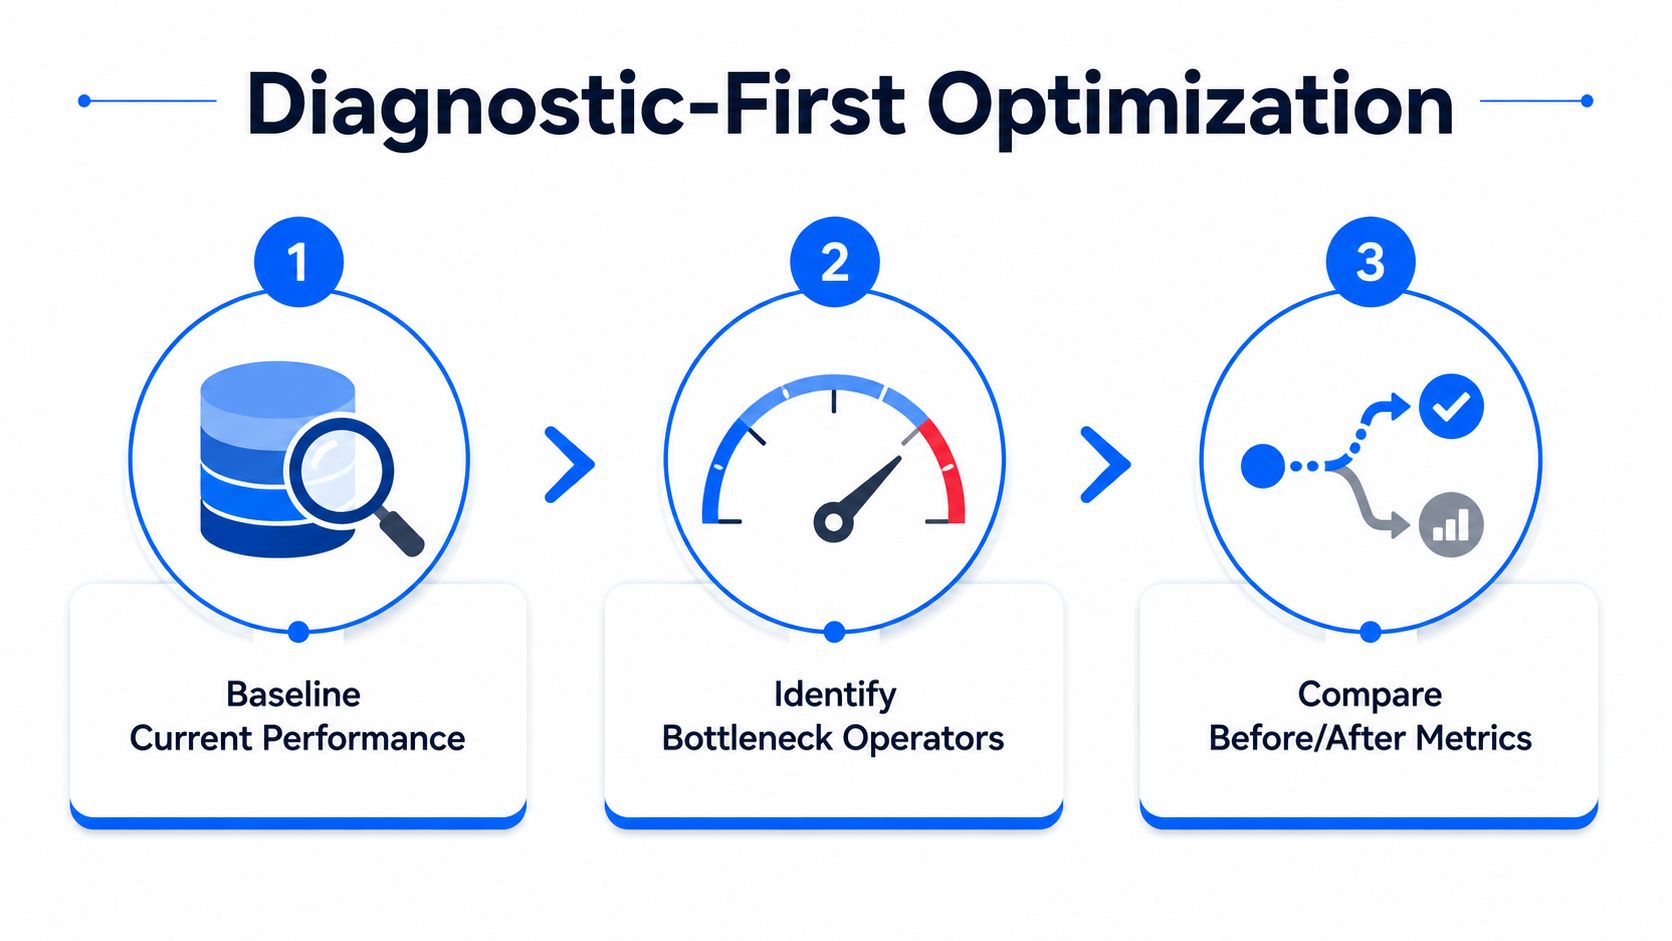
Primero establecer una línea base, luego tocar el SQL
La línea base no es opcional. Un ciclo de optimización práctico comienza con el tiempo de ejecución, las lecturas lógicas y la CPU, luego captura el plan y la carga de trabajo circundante para poder determinar si un cambio ayudó o simplemente trasladó el costo a otra parte, que es el mismo flujo de trabajo recomendado en las guías de optimización de SQL Server porque mantiene visibles la causa y el efecto (tuning workflow guidance).
Regla práctica: si no puede explicar el operador que causa el cuello de botella antes de la reescritura, probablemente aún no comprenda el problema.
Eso es especialmente cierto cuando el síntoma es un tiempo de respuesta lento pero la causa está fuera del texto de la instrucción. El análisis de esperas a nivel de servidor, la correlación de colas y luego la inspección a nivel de base de datos o de consulta es la secuencia que evita perseguir el problema equivocado, porque la carga de trabajo puede estar bloqueada por E/S, memoria o presión de concurrencia antes de llegar a la consulta candidata a reescritura (instance-to-query tuning sequence).
Cambiar una sola cosa a la vez
La optimización de una variable a la vez suena lenta, pero es la única forma de confiar en el resultado. Si cambia el texto de la consulta, el índice y la actualización de las estadísticas en el mismo paso, no sabrá qué palanca fue la que importó. Peor aún, una reescritura puede mejorar las lecturas lógicas al tiempo que aumenta la CPU o hace que el plan sea más frágil bajo un conjunto de parámetros diferente.
Un buen flujo de trabajo se parece a esto:
Capturar el texto exacto de la consulta y los parámetros. El mismo procedimiento almacenado puede comportarse de manera muy diferente con diferentes entradas.
Encontrar el operador que causa el cuello de botella. Las ordenaciones, los escaneos y las búsquedas de claves (key lookups) suelen ser donde se acumula el costo.
Aplicar un único cambio específico. Luego, vuelva a ejecutar la misma carga de trabajo bajo las mismas condiciones.
Comparar con la línea base. Vuelva a verificar las lecturas, la CPU y el tiempo transcurrido antes de continuar.
Ese método suena simple porque lo es. Lo difícil es resistir la tentación de "arreglar" todo a la vez. Si la consulta realmente sufre por la contención de recursos compartidos, la primera solución útil puede estar fuera de la consulta misma, por lo que los administradores de bases de datos experimentados no consideran el texto SQL como el único lugar donde buscar.
Lectura de planes de ejecución y comprensión del comportamiento del optimizador
Una mala consulta a menudo parece correcta en el editor de texto y aun así se desmorona en tiempo de ejecución. SQL Server no ejecuta las instrucciones en el orden en que se escriben. El optimizador se basa en el costo y en las estadísticas, por lo que evalúa los planes posibles, estima los recuentos de filas y elige la ruta que considera que costará menos (cost-based optimizer overview). En la tsql query optimization, eso convierte la lectura de planes en la primera habilidad de diagnóstico real, no en una ocurrencia tardía.
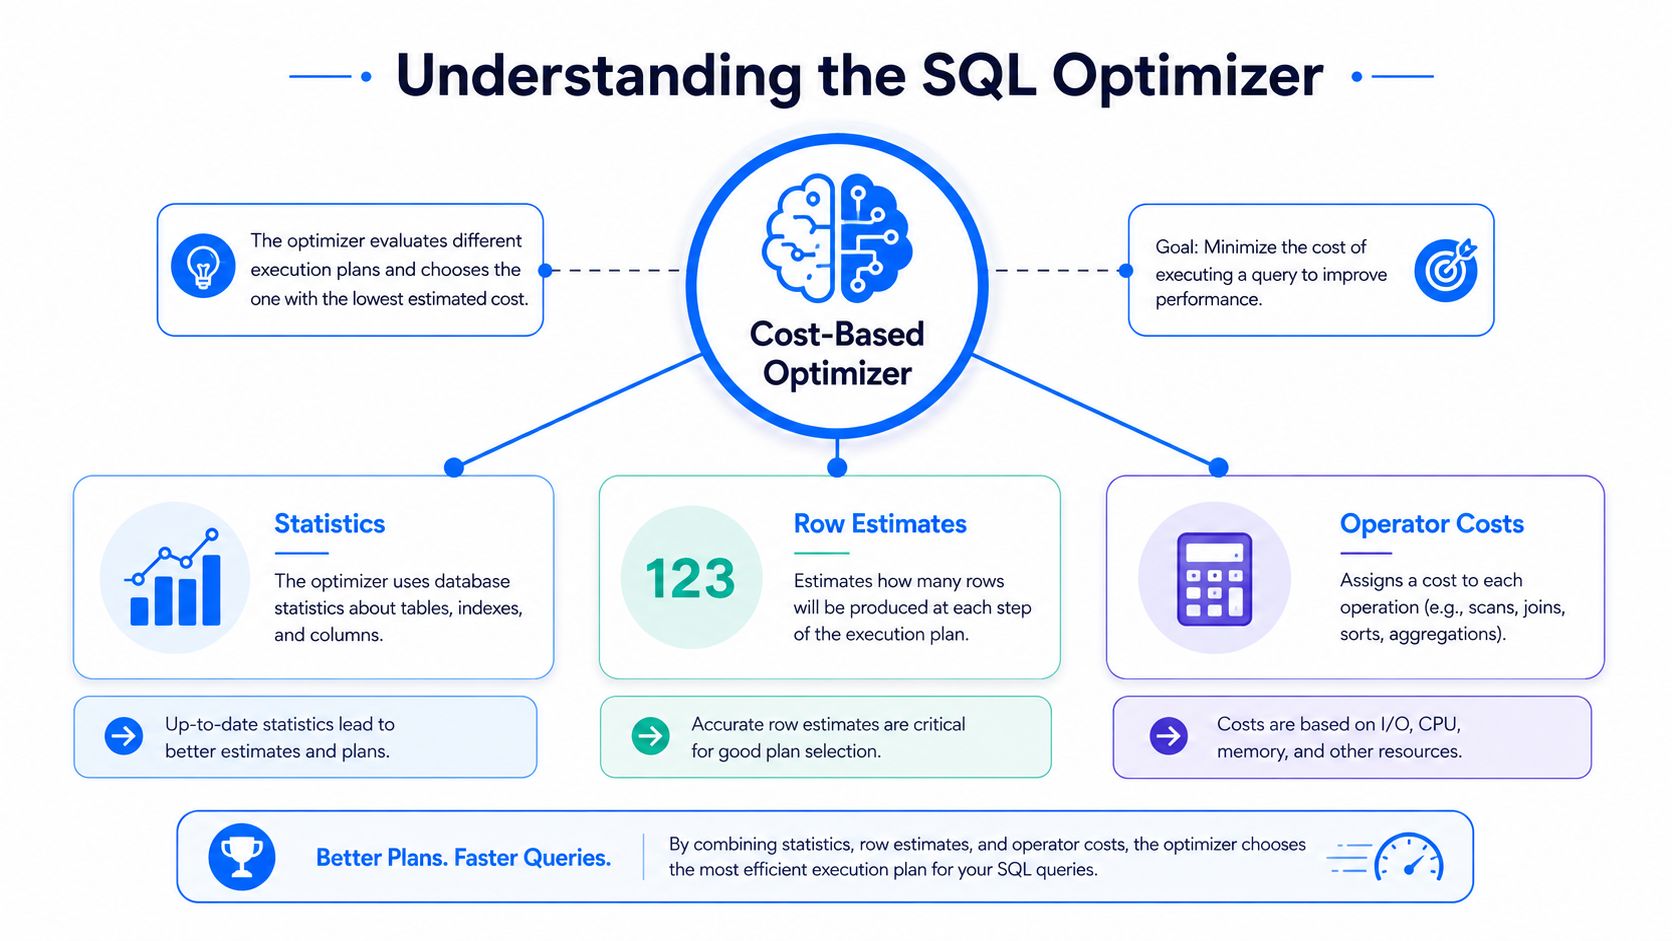
Leer el plan desde las hojas hacia arriba
Comience en las hojas, no en la raíz. Los operadores de hoja muestran dónde entran las filas al plan, y la hoja más costosa, a menudo la que tiene el mayor costo de bucles por tiempo, suele señalar el primer lugar donde el plan empieza a fallar. Si un escaneo alimenta a una combinación (join) y luego a una ordenación, el escaneo suele ser el problema principal, incluso cuando la ordenación domina el tiempo transcurrido.
Ese hábito de lectura se vuelve más útil cuando se conecta con las entradas del optimizador. DBCC SHOW_STATISTICS expone las estadísticas que SQL Server está utilizando para una tabla o vista indexada, incluyendo STAT_HEADER, DENSITY_VECTOR y HISTOGRAM (Microsoft documentation). Esos objetos importan porque el optimizador realiza su estimación de cardinalidad antes de decidirse por un plan. La información de densidad es especialmente útil para filtros de múltiples columnas en la misma tabla, donde la intuición simple sobre el recuento de filas suele fallar.
Si el plan parece sospechoso, lo comparo con una lista de verificación práctica para optimización, como how to optimize SQL queries with execution plan analysis. Ese tipo de paso mantiene la revisión basada en los operadores reales, no en meras conjeturas sobre el texto de la consulta.
Filas estimadas frente a filas reales
Lo primero que compruebo en un plan defectuoso es la diferencia entre las filas estimadas y las reales. Cuando estos números divergen drásticamente, el optimizador está trabajando a partir de una imagen distorsionada, y el resto del plan suele construirse sobre ese error. Un artículo de VLDB de 2025 descubrió que los errores de estimación de cardinalidad están muy extendidos y a menudo son el factor dominante detrás de los planes deficientes (VLDB 2025 paper), lo que coincide con lo que se observa en producción cuando las distribuciones sesgadas o los predicados correlacionados empujan al motor hacia el método de acceso o la combinación incorrectos.
Si el optimizador piensa que van a llegar 10 filas y en realidad llegan 10,000, el plan no está ligeramente desviado, sino que está resolviendo el problema equivocado.
Por eso también las estadísticas desactualizadas merecen atención desde el principio. Las estadísticas frescas no garantizan un plan perfecto, pero las desactualizadas hacen que una mala estimación sea mucho más probable. Para las tablas optimizadas para memoria, Microsoft señala que el optimizador sigue manteniendo estadísticas en las columnas de clave de índice y puede crear estadísticas adicionales en columnas que no son clave cuando sea necesario, por lo que esas cargas de trabajo siguen dependiendo de la misma imagen de cardinalidad.
Reescritura de consultas con patrones basados en conjuntos y filtrado temprano
Una vez que el cuello de botella es real y visible, reescriba el SQL con un propósito claro. Los cambios de mayor valor suelen ser aquellos que reducen la cantidad de datos que el motor tiene que tocar, no los que hacen que la consulta parezca inteligente. Filtrar temprano, proyectar menos columnas y mantener los predicados sargables ayuda al optimizador a usar los índices de manera más efectiva y reduce la presión de E/S y memoria (optimization techniques guide).
Hacer que el motor toque menos datos
Las victorias más sencillas suelen ser las que los equipos pasan por alto por parecer demasiado básicas. Evite SELECT * cuando la consulta no necesite todas las columnas, porque las columnas proyectadas adicionales ensanchan las filas y aumentan la E/S. Coloque filtros selectivos en la cláusula WHERE antes de las combinaciones (joins) siempre que pueda, porque eso reduce el volumen de datos que el motor tiene que arrastrar durante el resto del plan.
Algunos patrones son consistentemente importantes:
Utilizar predicados sargables. Si el predicado no se puede comparar de manera eficiente con un índice, el optimizador tiene menos margen de maniobra.
Preferir
UNION ALLcuando no sea necesario eliminar duplicados.UNIONañade un trabajo adicional de ordenación o eliminación de duplicados.Recortar subconsultas que solo reformatean datos. La lógica anidada que no reduce filas a menudo añade sobrecarga sin ayudar al plan.
Hacer coincidir los índices con los filtros reales. Un índice específico ayuda cuando se alinea con la ruta de acceso que utiliza la consulta.
Una buena reescritura reduce el trabajo que el optimizador debe considerar, no solo las líneas de SQL que usted tuvo que leer.
Utilizar objetivos de fila y sugerencias con moderación
Microsoft documenta sugerencias de consulta (query hints) que pueden alterar el comportamiento de ejecución, incluido el comportamiento del objetivo de fila (row goal), donde después de que se devuelve el primer número especificado de filas, la consulta continúa ejecutándose para producir el conjunto de resultados completo (query hints documentation). Eso puede ser útil cuando obtener una salida inicial rápida importa más que el rendimiento total, pero cambia el criterio de compensación del optimizador. Un plan que es excelente para un conjunto de resultados pequeño puede ser una mala opción para uno grande.
Por eso trato las sugerencias como una corrección de último recurso, no como una primera respuesta. Si la consulta sigue siendo lenta después del filtrado temprano y la limpieza basada en conjuntos, la siguiente pregunta suele ser si la ruta de acceso está en conflicto con la forma de los datos o las estadísticas que los respaldan.
Diseño de índices y estrategias de mantenimiento de estadísticas
Los índices no son interruptores mágicos de rendimiento. Son entradas para el modelo de costos del optimizador y solo ayudan cuando se adaptan al patrón de consulta y a la distribución de datos. Si la ruta de acceso no coincide con la forma en que la consulta filtra, combina o proyecta las columnas, el motor aún puede elegir un escaneo, un plan con muchas búsquedas (lookups) o una ordenación con tendencia a desbordarse a disco (spill).
Diseñar para la consulta que realmente se ejecuta
El mejor índice en teoría y el mejor índice en producción rara vez son el mismo. En la práctica, se buscan índices que coincidan con los patrones de acceso más costosos y repetitivos, especialmente los filtros que aparecen en las consultas más lentas. Un índice de cobertura (covering index) puede eliminar las búsquedas de claves cuando la consulta necesita un conjunto pequeño y estable de columnas, pero también puede añadir sobrecarga de escritura y costos de almacenamiento, por lo que el diseño necesita una carga de trabajo real, no una suposición.
El modelo de estadísticas de Microsoft es importante aquí porque el optimizador estima la cardinalidad a partir de esos objetos antes de seleccionar un plan (DBCC SHOW_STATISTICS). Si las estadísticas están desactualizadas, incluso un índice bien construido puede ser ignorado o mal utilizado. Por eso, un buen diseño de índices y un buen mantenimiento de estadísticas van de la mano.
Mantener las estadísticas lo suficientemente actualizadas para confiar en ellas
El mantenimiento de estadísticas no es una tarea de limpieza rutinaria, es parte de la calidad del plan. Cuando las distribuciones de filas cambian, el optimizador puede seguir pensando que la tabla se ve como ayer o el mes pasado, y esa imagen obsoleta puede provocar malas elecciones de combinaciones, métodos de acceso deficientes y un uso inesperado de la memoria. En el caso de las tablas optimizadas para memoria, Microsoft sigue manteniendo estadísticas en las columnas de clave de índice y puede añadir más en las columnas que no son clave cuando sea necesario, lo que demuestra la importancia central de las estadísticas en todos los modelos de almacenamiento.
Una postura práctica de mantenimiento es simple:
Actualizar las estadísticas cuando los planes sufran regresiones. No espere a que el problema se vuelva sistémico.
Vigilar los patrones repetidos de búsqueda de claves (key lookup). A menudo muestran dónde ayudaría un índice de cobertura.
Utilizar reconstrucciones y reorganizaciones con un propósito claro. El mantenimiento debe respaldar la carga de trabajo, no realizarse en piloto automático.
Revisar el uso de índices con regularidad. Un índice que parecía inteligente hace seis meses puede ser ahora un peso muerto.
Las sugerencias de índices faltantes pueden ayudar a identificar brechas obvias, pero no constituyen una estrategia de diseño por sí solas. Las trato como sugerencias y luego las comparo con la carga de trabajo y el costo de mantenimiento. El optimizador solo puede elegir entre las formas que usted le proporcione, y unas estadísticas desactualizadas pueden hacer que incluso una buena forma parezca mala.
Resolución de desafíos de Parameter Sniffing y forzado de planes
Algunas de las peores sorpresas en producción no tienen nada que ver con el texto de la consulta. Ocurren porque un mismo procedimiento almacenado obtiene planes muy diferentes según el primer valor de parámetro que ve el optimizador, y luego ese plan se reutiliza para llamadas posteriores que no coinciden con la forma original. Por eso, el comportamiento de planes sensibles a parámetros debe ocupar un lugar destacado en cualquier manual serio de tsql query optimization.
Cuando el cached plan es el problema
La guía de Azure SQL de Microsoft menciona explícitamente RECOMPILE, OPTIMIZE FOR, OPTIMIZE FOR UNKNOWN, el forzado de planes y la división de procedimientos como soluciones específicas cuando una consulta funciona bien para algunos valores de parámetros y mal para otros (Microsoft training guidance). Eso es importante porque el texto de la consulta puede ser correcto, pero el plan almacenado en caché puede ser inadecuado para la carga de trabajo actual.
El síntoma práctico es familiar. El procedimiento funciona rápido para un cliente, va lento para otro y cambia constantemente tras modificaciones en la caché o reinicios. En ese caso, el problema de optimización consiste realmente en controlar la variabilidad del plan, no en reescribir una consulta perfectamente legible en algo imposible de mantener.
Elegir el remedio que coincida con el modo de fallo
RECOMPILE es útil cuando la consulta necesita un plan adaptado a los parámetros actuales y la sobrecarga es aceptable. OPTIMIZE FOR es mejor cuando conoce un valor representativo y desea orientar el plan hacia él. OPTIMIZE FOR UNKNOWN puede ser un camino intermedio más seguro cuando ningún valor de parámetro individual refleja bien la carga de trabajo. El forzado de planes ayuda cuando ya se ha identificado una forma de plan que se comporta de manera confiable.
La solución correcta para el parameter sniffing no siempre es un mejor índice. A veces es una elección de plan más honesta.
Los controles operativos más nuevos también son importantes. Las directrices modernas de Microsoft incluyen DISABLE_RESULT_SET_CACHE, lo que demuestra que la optimización de consultas ahora debe tener en cuenta el comportamiento de la caché, además de la indexación y las reescrituras. Ese es un recordatorio útil de que el rendimiento inconsistente a menudo se debe a la interacción entre los datos, la caché y los valores de los parámetros, y no solo al SQL en sí.
Abordar la presión de memoria y las restricciones de recursos de la plataforma
Una consulta puede estar bien escrita, correctamente indexada y aun así ser lenta. Cuando eso sucede, el cuello de botella suele ser la presión de memoria, el comportamiento de desbordamiento a disco (spill) o límites más amplios de la plataforma, en lugar del texto de la consulta en sí. Muchas guías de optimización pasan por alto esta realidad, a pesar de que a menudo es la razón por la que una consulta "corregida" sigue decepcionando.
Separar el costo de la consulta local de la presión de recursos compartidos
Comience con el análisis de esperas y el monitoreo de recursos antes de culpar a una sola instrucción. Una consulta que se desborda a disco, compite por concesiones de memoria (memory grants) o experimenta contención en tempdb puede parecer una mala candidata para la reescritura cuando el problema de fondo es la presión del sistema. Las guías de Microsoft sobre el procesamiento de consultas y la observabilidad de Azure SQL apuntan hacia herramientas como el monitoreo de recursos, Database Watcher, Query Performance Insights y las métricas de capacidad de Fabric para ver si la carga de trabajo está limitada por la propia plataforma (platform observability guidance).
Si toda la instancia está bajo presión, una reescritura de SQL local puede parecer ineficaz incluso cuando está haciendo exactamente lo que debería.
Por eso importan los tipos de espera (wait types). Muestran si el cuello de botella es la saturación de la CPU, el retraso de E/S, bloqueadores de concurrencia o algo completamente distinto. Una consulta que reduce las lecturas lógicas pero sigue desbordándose a disco puede mejorar una métrica pero dejar la experiencia del usuario casi sin cambios.
Escalar a la planificación de capacidad cuando la carga de trabajo lo requiera
Llega un punto en el que la optimización de consultas deja de ser la palanca adecuada. Si la carga de trabajo sigue luchando contra los límites de memoria, almacenamiento o concurrencia, la solución puede ser la planificación de capacidad, el aislamiento de cargas de trabajo o el rediseño de la plataforma, en lugar de otra reescritura. Esa es la diferencia práctica entre resolver un problema a nivel de instrucción y resolver un problema a nivel de sistema.
Para los equipos que trabajan en entornos administrados, esa distinción importa aún más porque la plataforma puede ocultar parte de la presión subyacente hasta que la carga de trabajo se vuelve ruidosa. Si sus correcciones siguen reduciendo un poco el costo de la consulta pero los usuarios siguen percibiendo la lentitud, la siguiente pregunta no es qué SQL ajustar, sino qué recurso compartido sigue saturado. Ahí es también donde ayuda un enfoque de ingeniería de confiabilidad de bases de datos, porque vincula el comportamiento de las consultas con comprobaciones operativas repetibles y evita que las regresiones relacionadas con la memoria se traten como sorpresas puntuales. Consulte database reliability engineering practices para conocer el modelo operativo más amplio que respalda este tipo de trabajo.
Implementación de monitoreo continuo con Observability en la base de datos
La optimización puntual es útil, pero no detiene la siguiente regresión. Los datos crecen, las distribuciones cambian, las cargas de trabajo se desvían y el plan que funcionó el trimestre pasado puede envejecer mal sin previo aviso. Por eso, el monitoreo continuo es la única forma sensata de evitar que el rendimiento de las consultas se convierta en una emergencia recurrente.
Vigilar las desviaciones antes de que lo hagan los usuarios
El cambio útil consiste en pasar de la reacción a la detección. Las plataformas de Observability en la base de datos pueden monitorear las métricas de rendimiento de las consultas, los cambios en los patrones de ejecución y las señales de Timeliness sin mover los datos fuera del entorno, lo que resulta fundamental cuando las normas de seguridad o de governance hacen que el movimiento de datos sea costoso o indeseable. Data Platform Observability de digna es un ejemplo de ese modelo, con un monitoreo que permanece dentro del entorno del cliente y realiza un seguimiento de la salud de la carga de trabajo, los patrones de consumo y las métricas relacionadas con el rendimiento en todo el entorno de datos (digna data observability).
Ese tipo de monitoreo basado en líneas base es valioso porque detecta comportamientos anormales antes de que falle el panel o se incumpla el SLA. El objetivo no es reemplazar la optimización, sino hacer que esta sea proactiva en lugar de reactiva.
Utilizar la Observability para cerrar el ciclo
El monitoreo continuo hace que el flujo de trabajo de diagnóstico anterior sea sostenible. En lugar de diagnosticar una lentitud una vez y olvidarse de ella, los equipos pueden comparar el nuevo comportamiento con el plan anterior, detectar regresiones a tiempo y mantener la carga de trabajo cerca de la línea base que se demostró eficaz en producción. digna también publica una guía de SQL query optimisation que se alinea con este patrón, enfocándose en parámetros reales, planes de ejecución, nodos con cuellos de botella, actualización de estadísticas y comparación de planes.
Esa es la parte que me gusta operativamente. Las correcciones a nivel de consulta son reales, pero decaen a menos que alguien siga vigilando la carga de trabajo después de que se implemente el cambio. La Observability convierte eso en una rutina, no en una misión de rescate.
Si se enfrenta a un procedimiento almacenado lento, a un plan que cambia constantemente o a una consulta que parecía corregida hasta que los datos volvieron a cambiar, visite digna y evalúe si la Observability en la base de datos puede proporcionarle la línea base, la detección de anomalías y el monitoreo de la carga de trabajo que necesita para mantener el rendimiento estable. El proceso de optimización adecuado no termina con la reescritura, sino que sigue vigilando el sistema para que la próxima regresión no sorprenda a su equipo.


